
Pineconeのシステム開発は、要件整理・選定・設計開発・テスト・稼働・定着の6フェーズで進みます。業務データとKPIを先に整理し、検索層として既存システムに組み込んだうえで、検証から定着まで段階を踏むと、本番移行で起きる問題を減らせます。
▼全体ガイドの記事
・Pineconeのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Pineconeのシステムの全体像
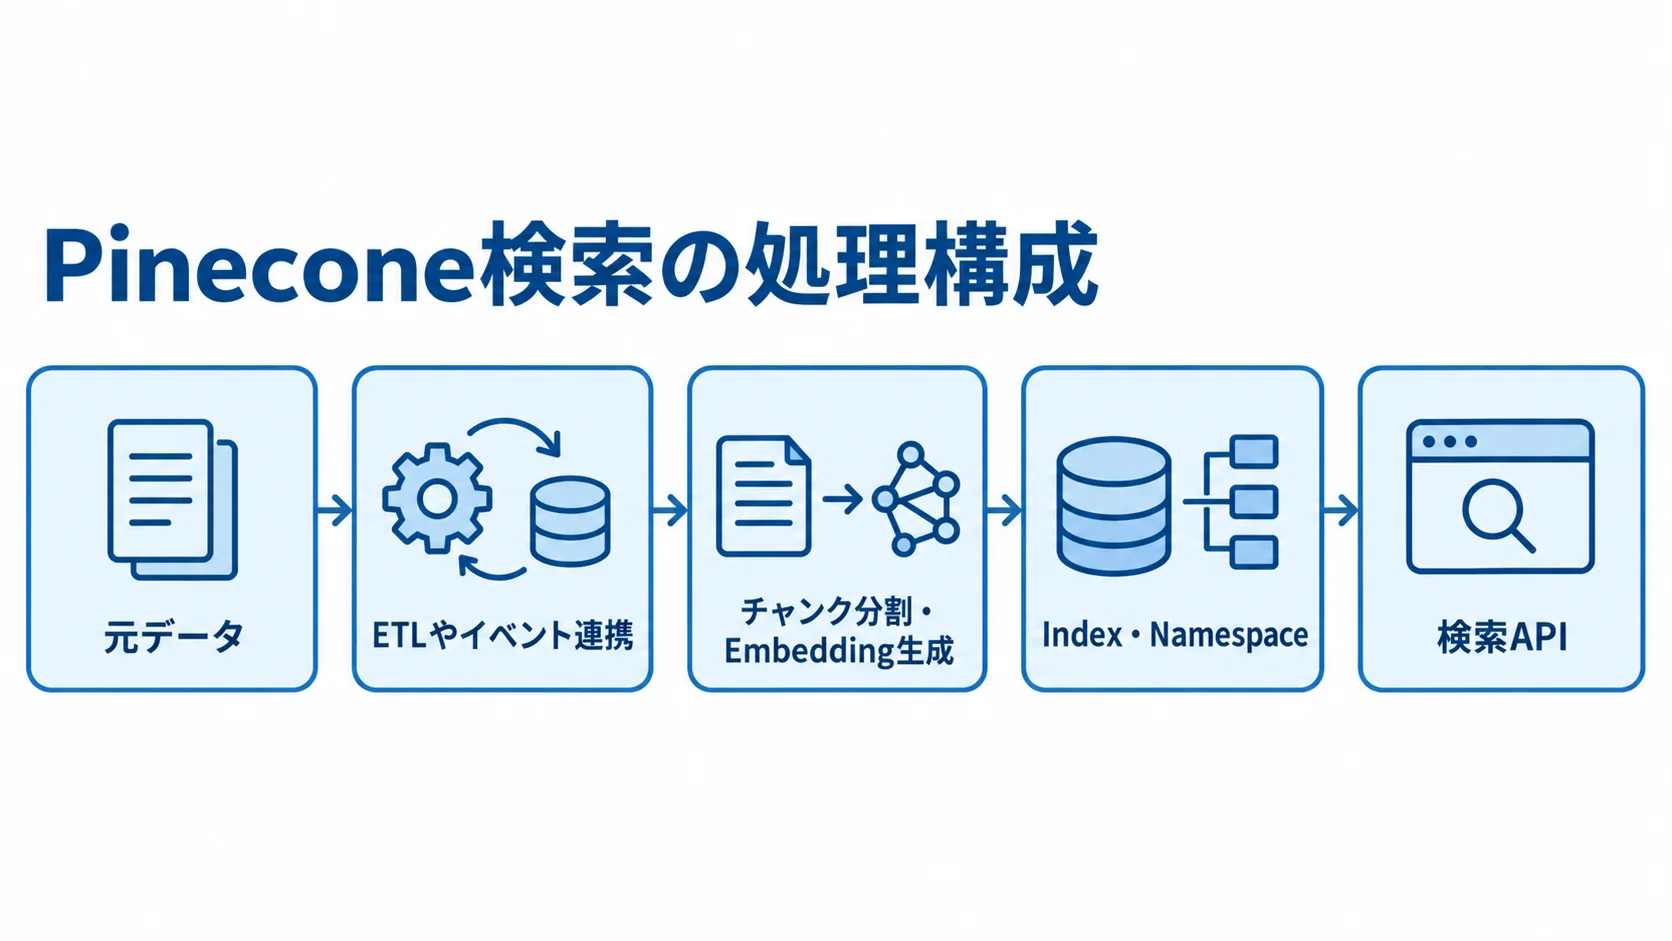
設計は、どの業務データを誰に、どの精度と速度で届けるかを起点に組み立てます。元データはETLやイベント連携で取り込み、そのうえで、チャンク分割とEmbedding生成を行います。
生成したデータはPineconeのIndexやNamespaceに保存し、検索APIで候補を取り出します。候補は、必要に応じてリランキングやLLMを通したうえで、EC画面・店舗端末・社内検索・問い合わせ窓口へ返されます。
AIアプリケーションの検索層としての役割
Pineconeはデータをベクトルに変換して保存し、入力文と意味が近い情報を検索します。扱えるデータには、商品説明・FAQ・レビュー・社内文書・顧客の行動履歴などがあります。
- 自然文検索:キーワードが完全一致しない質問にも対応します。
- 類似検索:商品や文書の類似候補を探すときに使います。
- RAG・推薦:チャットボットやレコメンドの候補抽出に使われます。
たとえば「軽い靴を探したい」「返品できる商品を教えてほしい」といった検索に向いています。
Pinecone公式のRAG説明でも、意味的に関連する情報を取得してLLMへ渡す構成が示されています(出典: Pinecone公式「Retrieval-Augmented Generation」、2026年確認)。
Pineconeは検索を担うため、SKUの完全一致・価格や在庫の現在値・注文確定・決済・会計仕訳は、正規システムが責任を持ちます。商品DBや受注・在庫DB、決済基盤が、それぞれ正規の責任を担います。
検索結果の商品IDや文書IDで正規DBに照会し、最新の価格・在庫・注文状態を確かめる二段構成にすると、古い情報を直接表示するリスクを抑えられます。
EC・オムニチャネルでの用途の絞り込み
用途が変わると、入力データ・許容できる誤り・成功指標・更新頻度も変わります。そのため、最初から全データを一つのIndexに入れず、対象の用途を決めて評価します。
- 商品検索・推薦:自然文検索と、閲覧・購買履歴をもとにした推薦に使います。
- FAQ・類似検索:商品・店舗・配送のFAQ検索と、画像や説明文から類似商品を探す用途です。
- 異常パターン検知:不正注文や問い合わせの類似パターンを検知します。
業務アクションを自動で実行する場合は、人による確認を残しておきます。あわせて、対象ユースケースを一つに絞り、利用者の権限を検索結果へ引き継げるかを確かめます。
削除や非公開が何分以内に反映されるか、検索結果から正規データへ戻れるか、精度と事業成果を測る評価データがあるかも点検します。
KPIは用途ごとに決めます。商品検索では検索成功率・ゼロ件率・クリック率・購入率を、FAQでは正答率・根拠提示率・有人転送率を指標に置きます。
Pineconeのシステム開発の進め方と6フェーズ
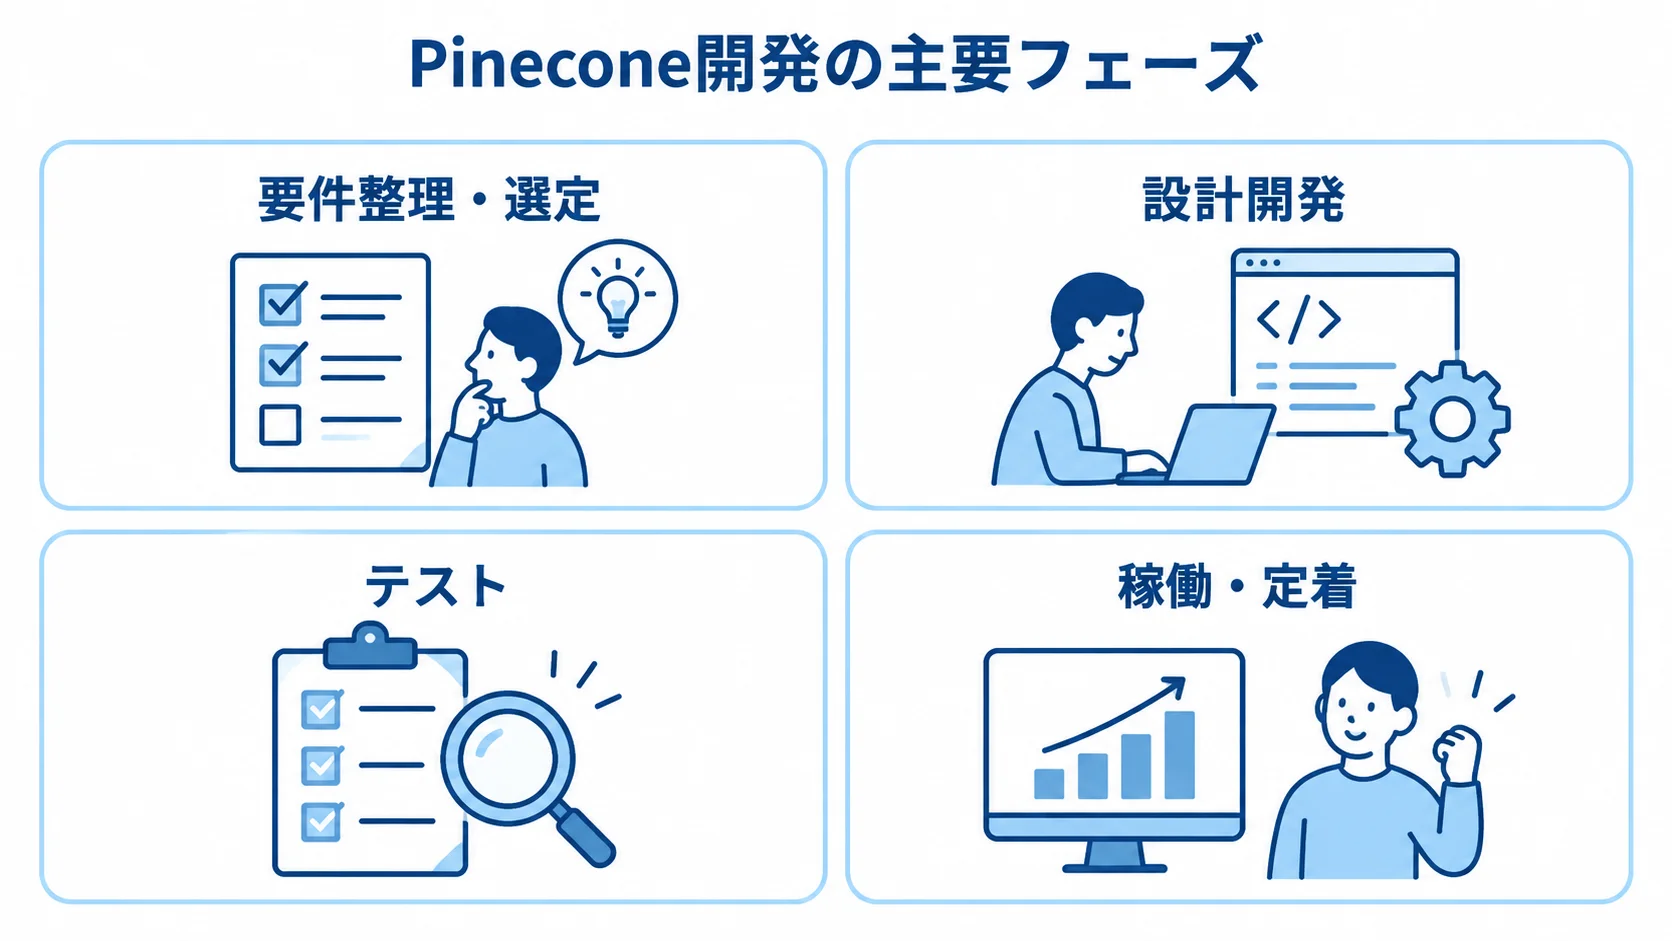
開発は6フェーズで進みます。要件整理と選定の後に、設計開発とテストを行い、稼働と定着へ進みます。各フェーズの終了条件は、着手する前に発注側と開発会社で合わせておきます。
データ品質・アクセス権・検索評価・運用担当者まで含めて判断すると、PoCから本番へ移れない問題を減らせます。
フェーズ1:要件整理(業務・データ・KPIの洗い出し)
まず、商品マスタ・在庫・価格のデータ源を一覧にします。さらに、カテゴリ・店舗・FAQも同じ一覧に加えます。レビュー・顧客属性・注文履歴も含めたうえで、データと利用条件を次のように書き出します。
- データの管理情報:管理者、更新頻度、1日あたりの更新件数、保存期間。
- データの扱い:個人情報の有無と、削除方法や公開範囲を記録します。
- 利用条件:誰がどの画面で質問し、何秒以内に何件返すか。
- 終了条件:対象業務・データ、評価クエリ、数値化したKPIと受入基準を定めます。
- 受入チェック:検索成功率、ゼロ件率、P95、同時検索数、反映遅延、有人対応、RTO・RPO、予算上限、責任者を含めます。
「検索精度を上げる」といった抽象的な要件のまま選ぶと、開発会社ごとに完成イメージが変わります。そのため、要件は数値と評価条件で書いておく必要があります。
フェーズ2:選定(Pineconeと代替方式の比較)
選定では、Pineconeを候補の一つとして、代替方式と並べて検討します。比べる前に、評価の前提と確認事項を揃えておきます。
- 候補方式:pgvector、Elasticsearch系、Weaviate、Milvus、クラウドのマネージドサービス。
- 運用と統合:データ配置、ネットワーク、料金、既存クラウドとの統合、検索方式の自由度を見ます。
- 評価条件:同じ評価データとEmbeddingモデルで、精度、P95・P99、更新反映、障害復旧、メタデータフィルタ、ハイブリッド検索、リランキングを比べます。
- Pineconeの構成:プラン、Namespace単位、Private Endpoint・BYOCの要否を確認します。
- ベンダー確認:試験条件、未達時の改善、削除実装、保守時間、障害時の責任の範囲を質問します。
Serverlessで始めるか、StandardやEnterpriseの機能が必要かは、要件に応じて判断します。
Pineconeはマネージド運用で検索を組み込みやすい方式です。一方で、pgvectorを運用できるチームは、分散先を増やす利点と運用負荷を比べます。
フェーズ3:設計開発(Index・データ連携・権限の作り込み)
設計では、チャンク分割、Embeddingモデル、Indexの次元数とメトリックを決めます。
さらに、dense・sparse・hybrid検索の方式と、Namespaceの扱いを決めます。そのうえで、検索対象ごとのメタデータを設計し、top_kとリランキングの有無も定めます。
- 商品検索:商品ID、SKU、ブランド、カテゴリ、価格帯、販売地域、公開状態、販売期間をメタデータとして持たせます。
- FAQ・社内文書:文書ID、版、作成日、公開範囲、部署、アクセス権の情報。
- データ連携:初期取込に加えて、追加、更新、削除、非公開化、権限変更、Embedding再生成の流れを設計します。
- 連携の再実行:再送、重複、順序逆転、部分失敗、レート制限、移行差分に備え、構造化ID、処理ステータス、再実行キー、監査ログを用意します。
- アプリ・LLM:アプリ連携の制御と、LLMの安全策の実装です。
APIキーの保管に加えて、タイムアウト・リトライ・キャッシュ・サーキットブレーカーも実装します。
ログはマスキングし、LLMは取得したコンテキスト以外を根拠に断定しないよう設計します。引用元の表示や回答できない場合の分岐、プロンプトインジェクション対策も、あわせて設けます。
FAQや社内文書では、権限のない情報が検索結果に混ざらない構造にします。
文書IDとチャンク番号を組み合わせた構造化IDにすると、部分更新や削除対象を追跡しやすくなります。
検索失敗の原因を追跡できるようにしておき、削除はPineconeとキャッシュの両方へ反映させます。
フェーズ4:テスト(精度・性能・安全性の検証)
機能、検索精度、負荷のテストは、分けて実施します。障害、セキュリティ、データ照合は、別の試験として行います。代表クエリで正しい商品や文書が上位に出るかは、検索精度の試験の中で確かめます。
- 検索精度:対象外の類似情報、ゼロ件時の代替案、RAGの引用と回答不能時の対応。
- 性能:平均値だけでなく、P95・P99、ピーク同時検索数、更新中の検索、再インデックス時間、APIエラー率を測ります。
- 安全性:利用者の権限、削除済み商品、非公開FAQ、期限切れ価格、退職者の文書、顧客別Namespaceの試験。
- 運用上の安全性:APIキーの過剰権限、ログの個人情報、外部LLMへの送信範囲、バックアップ保持期間の確認。
- 再試験:問題が見つかったときの再試験条件を残します。
Pinecone Serverlessのクエリは、対象Namespaceのサイズに応じてRead Unitsが計算されます。1GBあたり1RUが基準で、最低0.25RUが適用されます(出典: Pinecone公式「Understanding cost」、2026年8月確認)。
また、メタデータで検索対象を絞る設計は、性能と料金の両方に影響します。
フェーズ5:稼働(段階切り替えとロールバックの準備)
全利用者へ一度に公開するより、社内ユーザー・限定店舗・特定カテゴリ・一定割合のトラフィックへ段階的に広げるほうが安全です。
- 初期データの件数と代表レコードを照合します。
- 差分更新を流してから、検索APIの接続先を切り替えます。
- EC検索では旧検索をフォールバックに残し、クリック率やゼロ件率を比べてから対象範囲を広げます。
手順書には、実施時刻と担当者、監視項目、利用者への告知を書きます。エラー時の判断者や旧方式へ戻す条件、再同期方法も記載します。
- ロールバック:接続先に加えて、Pineconeの差分、キャッシュ、イベントキュー、分析ログの扱いを決めます。
- 稼働判定:機能、性能、精度、権限、料金予測、バックアップ、アラート、問い合わせ窓口。
フェーズ6:定着(評価・監視・改善の継続)
稼働後は、利用量と検索の成果を追い、事業指標と照らしながら、検索や運用を続けて改善します。
- 利用状況:検索回数、Read Units、Write Units、保存量、Embedding・リランキング量を追います。
- 検索と事業成果:応答時間、エラー率、ゼロ件率、クリック率、購入率、有人転送率。
- 改善:失敗クエリをもとに、チャンク長、メタデータ、Embedding、top_k、リランキング、プロンプトの仮説を立てます。
- 事業評価:問い合わせ削減や購入率などの事業KPIと検索精度を結び、改善の優先順位を説明します。
- 新機能:Dedicated Read Nodesは2026年に一般提供され、大規模Index向けにStandard・Enterpriseで選べます。
Pinecone Assistantの料金は2026年4月から利用量ベースへ変更されています(出典: Pinecone公式「2026 release notes」、2026年確認)。
新機能を採用するなら、料金モデルと利用上限、SDK対応を確かめます。監視方法や既存設計への影響も見ておきます。
契約更新や仕様変更の責任者は、あらかじめ決めておきます。そのうえで、月次のコストレビューや失敗クエリの改善会を開き、再インデックスや削除依頼、権限変更への対応手順も整えます。障害時のランブックも、あわせて用意します。
モデルを更新したときは再評価し、現場向けの研修も行います。データマッピングやIndex設定、ETLといった開発の成果は、評価データやダッシュボード、IaCとあわせて後任の担当者へ引き継ぎます。
秘密情報の更新方法と保守窓口も共有し、特定の担当者しか分からない状態を避けます。
Pineconeのシステム開発の費用相場とコストの内訳
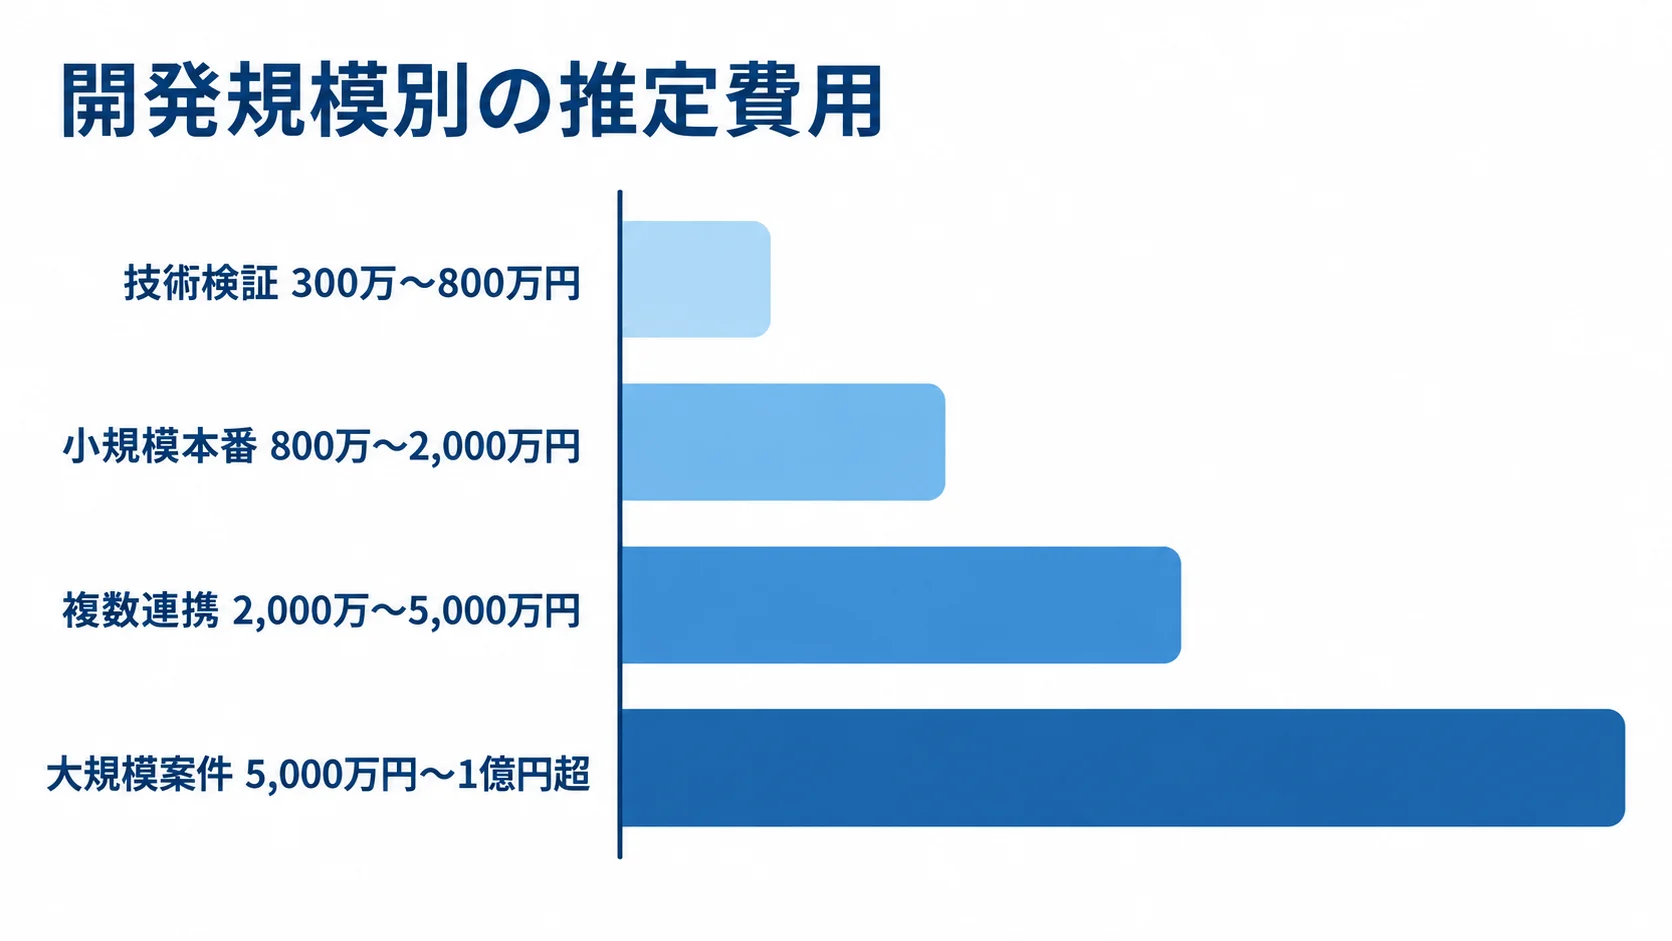
Pineconeのシステム開発費は、検証の規模、連携の範囲、運用の要件によって変わります。技術検証の300万〜800万円から、大規模案件の5,000万円〜1億円超までが推定幅です。
費用には、Pinecone利用料のほか、Embedding、リランキング、LLMの利用料が含まれます。さらに、データ取込やアプリ開発も含まれ、監視と保守もあわせて見込みます。
Pinecone単体の日本円による開発相場を示す公的統計は確認できません。そのため、開発費はEC検索、RAG、データ連携に近い案件からの推定レンジです。
正式な予算は、データ量と連携本数、画面を定義してから見積もります。加えて、精度評価、セキュリティ、運用時間も定めておきます。
Pineconeの公開料金(プランと従量課金の区別)
料金は、プランごとの最低額と、利用量に応じた課金を分けて把握します。
- プラン料金:Starterは無料、Builderは月額20ドルです。
- 最低利用額:Standardは月額50ドル、Enterpriseは月額500ドルです。
- 従量課金:StandardとEnterpriseでは、利用量に応じた課金が加わります。
- 別費用:Embedding、リランキング、Assistant、初期取込、LLM、アプリ基盤、監視は、別途かかる場合があります。
公式表示では、Write Unitsは100万単位で約4〜4.50ドル、Read Unitsは約6〜6.75ドルです。
1ドル=150円の比較用換算では、Builderは約3,000円、Standardは約7,500円、Enterpriseは約7万5,000円からです(出典: Pinecone公式Pricing、2026年8月確認)。
これは実際の請求額や契約条件を保証しない概算です。
料金はクラウドやリージョンによって変わるため、見積もり時点のPricingと計算機で確認してください。
開発費の目安(PoC・小規模本番・連携範囲)
RAGやEC検索、推薦の案件に加えて、データ連携の類似案件をもとに、規模別の推定レンジを示します。
- 技術検証:300万〜800万円が目安です。
- 小規模本番:商品検索や社内ナレッジは800万〜2,000万円です。
- 複数連携:EC・POS・CRM・在庫やWMSとの連携は2,000万〜5,000万円です。
- 大規模案件:複数ブランド・地域、厳格な監査、Private EndpointやBYOC、24時間運用では5,000万円〜1億円超の可能性があります。
- 期間の目安:1データ源のPoCは1〜3か月、小規模本番は3〜6か月、複数連携は6〜12か月、高可用性・多地域は9〜18か月です。
これらはPineconeの公式見積ではなく、要件や案件の条件で変わる推定レンジです。
期間は、検索の実装だけでなく、データの洗い出しや重複・欠損の修正、権限設計によっても変わります。既存APIの改修や評価クエリの作成も、期間を左右します。
利用者テストや教育、切り替えリハーサルも期間に影響します。データが整理されていないなら、開発前の準備期間も予算に含めておきます。
ランニングコストの内訳(AI・転送・監視・保守)
月額費用は、費目ごとに分けて管理します。
- 利用料とAI費:Pineconeのプラン・従量課金・保存量、Embedding、リランキング、LLM入出力を計上します。
- 実行・運用費:アプリ、ログ・監視、バックアップ、ネットワーク転送、保守を分けます。
- 月ごとの差:初期取込のWrite UnitsやEmbedding生成の増加も考慮して、平常月と更新月を分けて見ます。
- 従量課金の対象:Read Units、Write Units、保存量で、利用量に応じて変わる部分。
- 保守の範囲:監視、障害対応、再インデックス、精度改善、評価・モデル更新、月次レポートを確認します。
初期インポート時は、Write UnitsやEmbedding生成だけが一時的に増える場合があります(出典: Pinecone公式「Understanding cost」、2026年8月確認)。
また、Read UnitsはQuery・Fetch・List、Write UnitsはUpsert・Update・Deleteに関係します。保存量も課金要素です。
類似案件では、クラウド実費を除く運用支援が月額30万〜150万円程度の場合があります。その金額は、対応時間やSLA、対象環境によって変わります。改善回数も影響するため、固定料金とは限りません。
見積書では、Pinecone利用料と保守人件費を分けて書き、利用量の請求と委託範囲の増加を区別して確認します。
Pineconeのシステム開発で見積もりを取る際のポイント
「Pineconeを使った検索を作る」という一言だけで頼むより、データ・画面・連携・精度を分けて伝えます。セキュリティや運用も、別々に書いて渡します。
同じ前提で比較できるよう、評価用データと現行API仕様を共有します。利用者数、ピーク時検索数、更新件数も、あわせて渡します。
希望のリリース時期と予算上限、社内で担える作業も、候補の会社に示します。
要件定義書の記載事項(データ・評価・責任の範囲)
RFPや要件定義書では、データと評価条件を明確にします。あわせて、納品物と責任の範囲も記載します。
- データ・検索条件:データ源、件数、次元数、更新頻度、メタデータ、Namespace、権限、保持期間、削除期限、検索条件。
- 性能・評価:top_k、許容レイテンシ、同時実行数、評価クエリ、正解データを明記します。
- 用途別条件:商品検索の優先順位、FAQの回答方針、推薦で除外する条件。
- 納品物:設計図、データ項目表、Embedding・チャンク方針、Index・連携・API仕様、各種試験結果、運用手順、連絡先を指定します。
- 責任の範囲:Pinecone、LLM、EC画面、在庫DB、監視基盤それぞれの範囲と、データ品質の修正担当。
要件定義で範囲を明確にすると、精度改善やデータ連携、管理画面が後から追加請求されるリスクを抑えられます。
開発会社の選び方(連携力と運用力)
開発会社には、Pineconeの知識に加えて、連携を扱う力も求められます。EC・POS・CRM・WMSとの連携、商品マスタやイベント連携を扱えるかを確かめます。
公開されている技術記事は参考になりますが、導入実績や成果は、根拠を示せるかを確かめます。
- 実務の対応力:検索評価、個人情報保護、運用保守まで一体で扱えるかどうか。
- 検証・体制:評価クエリでの検証、設計書、障害対応時間、担当者の経験、保守契約。
- 比較条件:要件定義、データクレンジング、精度保証、責任の範囲、クラウド実費、追加単価、引き継ぎやすさを比べます。
- PoC後の扱い:成果物を本番設計へ再利用できるか、本番化しない場合に何が残るか。
PoCの費用が安くても、本番では認証、監査、監視が別見積もりになることがあります。削除やピーク負荷への対応も、別に見積もられる場合があります。
セキュリティ要件の見積もりへの組み込み
顧客情報や社内文書を扱う場合は、利用目的と委託先、国外移転の有無を整理します。そのうえで、保存リージョンと削除請求、アクセス権を決めます。監査とログ保存期間もあわせて定めます。
- 公式の機能:AES-256暗号化、TLS 1.2、APIキー認証、Private Endpoint、CMEK、Enterpriseの監査ログ。
- 見積項目:BYOC、SSO、脆弱性診断、レッドチーム、匿名化、削除試験、バックアップ・復元試験を分けます。
- 受入試験:権限逸脱、古い価格、プロンプトインジェクション、ログへの個人情報混入を含めます。
AWS PrivateLinkやAzure Private Linkを使い、Private Endpointを構成できます(出典: Pinecone公式「Security overview」、2026年8月確認)。
自社の権限設計やLLMへの送信制御は、Pineconeの機能だけでは整いません。
上位のプランを選んでも、それだけで安全とは限りません。どの脅威を、どの機能と運用で抑えるかを記録しておきます。
よくある質問(FAQ)
導入前によくある疑問に、開発計画と見積もりの観点から答えます。料金や機能は更新されるため、契約前に公式のPricingとドキュメントを確認してください。
料金は、自社のデータ量と利用量で再計算します。
Pineconeは商品データベースやRDBの代わりになりますか?
Pineconeは意味検索や候補抽出を担うもので、原則として、RDBや商品DBをすべて置き換えるものではありません。
正確性とトランザクションが必要な処理(価格・在庫・注文・決済・会計など)は、既存の正規DBに残します。検索結果の商品IDや文書IDを使い、正規データへ照会する構成が現実的です。
Pineconeのシステム開発にはいくらかかりますか?
開発費は規模や連携範囲によって異なります。案件別の推定レンジを示します。
- 技術検証:300万〜800万円が目安です。
- 小規模本番:800万〜2,000万円の範囲です。
- 連携・大規模:EC・POS・CRM・在庫連携は2,000万〜5,000万円、大規模・高可用性は5,000万円〜1億円超です。
- 個別見積もり:利用料、Embedding、LLM、アプリ、監視、保守を分け、件数・更新量・検索数を伝えます。
これはPineconeの公式価格ではなく、RAGや検索、データ連携に近い案件からの目安です。
Pineconeは最初から本番環境に導入すべきですか?
最初は、一つのユースケースと、一つか少数のデータ源、代表的な評価クエリに絞ったPoCが適切です。
PoCでは、検索精度、応答時間、更新反映を確認します。権限、費用、障害復旧も見ておきます。本番のKPIと運用体制が定まってから、対象範囲を広げます。
全社データを先に投入すると、データ品質や権限の問題が見えにくくなります。その結果、精度改善と原因調査の費用が膨らみやすくなります。
Pineconeに顧客情報や社内文書を保存しても安全ですか?
安全性は、Pineconeの機能に加えて、保存データと権限、ネットワークの設計で評価します。鍵やログ、LLMへの送信範囲、削除手順も、合わせて見ます。
Pineconeには、暗号化、APIキー、Private Endpointといった選択肢があります。CMEKやEnterpriseの監査ログも用意されています。自社の利用目的や委託先の管理、アクセス権の設計は、別途必要です。
顧客別Namespaceやメタデータフィルタを使う場合は、本番前に権限テストと削除テストを実施します。
Pineconeのシステム開発は何か月かかりますか?
期間はデータ源やシステム連携の範囲で変わります。規模別の目安を示します。
- 技術検証・小規模本番:1データ源は1〜3か月、小規模本番は3〜6か月です。
- 複数システム連携:6〜12か月が目安です。
- 高可用性・多地域:9〜18か月です。
- 期間の確認:データサンプルと業務カレンダーを渡し、工程ごとの成果物と終了条件を求めます。
期間は、Pineconeの設定よりも、データクレンジングや既存API改修で変わります。権限確認や評価データの作成も影響します。
利用者テストや教育、切り替えリハーサルも、期間に影響します。
まとめ
まとめると、Pineconeのシステム開発は、要件整理から定着までの6フェーズで進みます。
Pineconeを検索・推薦・RAGのどこに置くかを決め、価格・在庫・注文などの正規データは既存システムに残します。
検索精度だけでなく、KPI・データ鮮度・権限・削除を定めます。性能や費用、運用責任まで決めておくことが、成功の条件です。
発注前に確認したい6つの終了条件
発注前には、要件整理で対象業務・データ・KPIが決まっているかを確かめます。選定では、代替方式と本番条件を比べます。
設計開発では、Index・Namespace・連携・権限・削除を定義したかを確かめます。テストでは、精度やP95・P99、障害、安全性を検証します。
稼働前は、段階切り替えとロールバックを用意します。定着後は、検索ログやRead Units・Write Units・保存量、事業KPIを見ながら、月次で改善できる体制を整えます。
一つの用途を小さく検証する進め方
全社のEC・POS・CRM・在庫・問い合わせデータを一度に統合せず、商品検索やFAQなど一つの用途から始めます。
小さく始めると、検索精度・データ反映・権限・利用料・運用負荷を把握しやすくなります。Pineconeは、データ品質や権限設計の不足を自動で解決しません。
不足している知見を整理し、業務システム連携と本番運用まで支援できる開発会社へ相談します。現実的な範囲や投資対効果を見極める材料にもなります。
見積もりの比較(利用料と開発・運用費の区分)
費目を分けて提示してもらうと、利用量と開発・運用の範囲を比べられます。
- 費目:Pinecone利用料、AI、開発、連携、セキュリティ、運用を分けます。
- 金額の扱い:300万〜800万円、800万〜2,000万円、2,000万〜5,000万円は予算検討用のレンジです。
- 契約前の確認:前提、除外事項、性能未達時の対応、追加費用の条件。
内訳には、Read Units・Write Units・保存量、Embedding・リランキング・LLMを含めます。
アプリ開発やデータ連携、セキュリティ試験、監視・保守も分けて記載します。
これらは要件確定前の目安で、正式な金額ではありません。
▼全体ガイドの記事
・Pineconeのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。