
Pineconeのシステムは、検索、業務データとの連携、更新と権限の設計を分けて組むと、EC検索やレコメンド、RAGに活用できます。
商品検索、レコメンド、社内FAQなど、用途によって使い方は変わります。
▼関連記事一覧
・Pineconeのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Pineconeのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Pineconeのシステム開発の見積相場や費用/コスト/値段について
・Pineconeのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Pineconeのシステムの全体像
Pineconeは、テキストや画像をベクトルに変換して保存するマネージド型のベクトルデータベースです。入力と意味が近いデータを探すため、キーワードが完全に一致しなくても、文脈や概念の近さから候補を見つけられます。特に、自然文の商品検索や社内FAQの検索に向いています。
AIの記憶ではなく検索層としてのPinecone
Pineconeを検索層として使う場合、回答の生成と業務データの管理は、別々の役割に分けて考えます。
- 導入時の前提:データを入れるだけでAIが正しく答えると考えると、期待とのずれが生じやすくなります。
- Pineconeの応答:近いベクトルとメタデータを返すまでが役割で、最終回答や推薦順位は検索API、ロジック、LLM、画面側アプリが決めます。
- 業務データ:価格、在庫、注文状況の正本はPineconeに置かず、商品DBや受注・在庫システムに照会します。
- 検索候補:商品説明やFAQを保存し、商品ID、販売地域、公開状態、カテゴリをメタデータとして付けます。
- 最新情報:検索結果の商品IDを使い、正規データベースから価格と在庫を取得すると、検索の利便性と業務データの正確さを両立できます。
典型的なシステム構成の6つの層
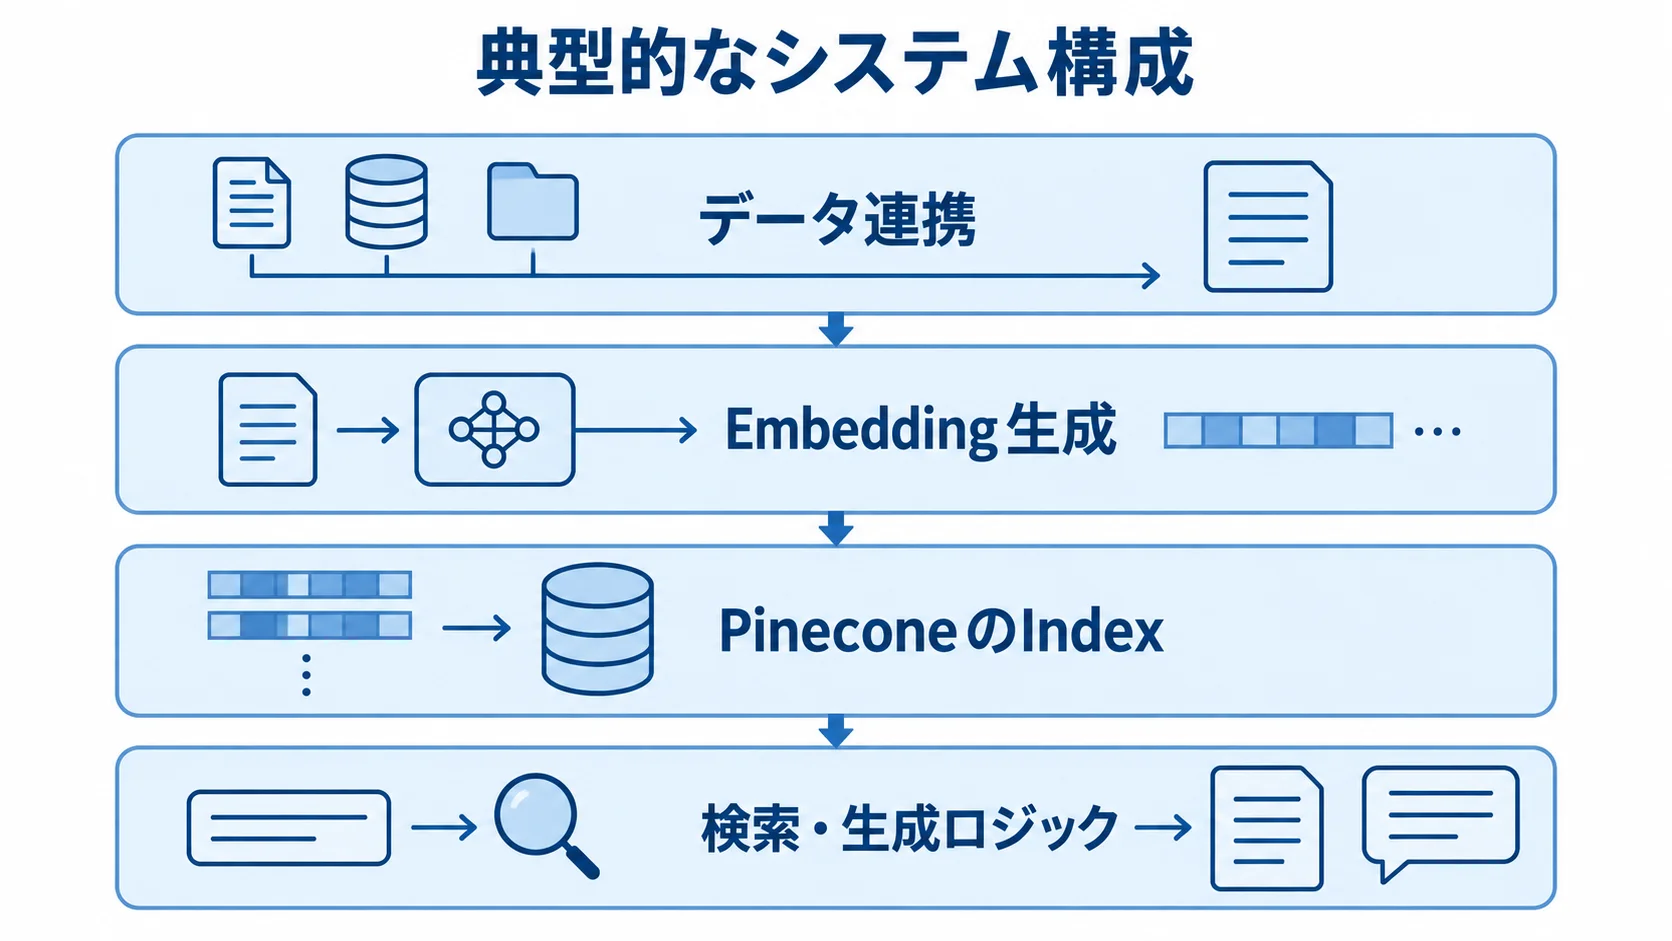
システムは、元データから利用画面まで6つの層に分けて組みます。
- 元データ:商品マスタ、カタログ、レビュー、店舗情報、顧客向けFAQ、社内文書
- データ連携:ETLやイベント連携で追加・変更・削除を反映
- Embedding生成:文章を分割してベクトルを生成
- PineconeのIndex:生成したベクトルを保存
- 検索・生成ロジック:候補を処理し、LLMや推薦ロジックへ渡す
- 利用画面:検索や回答、推薦結果を提示
検索時は、入力文も同じ方式でベクトル化してPineconeに問い合わせます。そのうえで、候補にメタデータ条件を適用し、必要に応じてキーワード検索やリランキングを組み合わせます。
回答や推薦結果には、商品ID、文書ID、引用元などの根拠を持たせておきます。そうすると、内容を後から検証できます。
EC・オムニチャネルで使えるPineconeの種類と活用方法
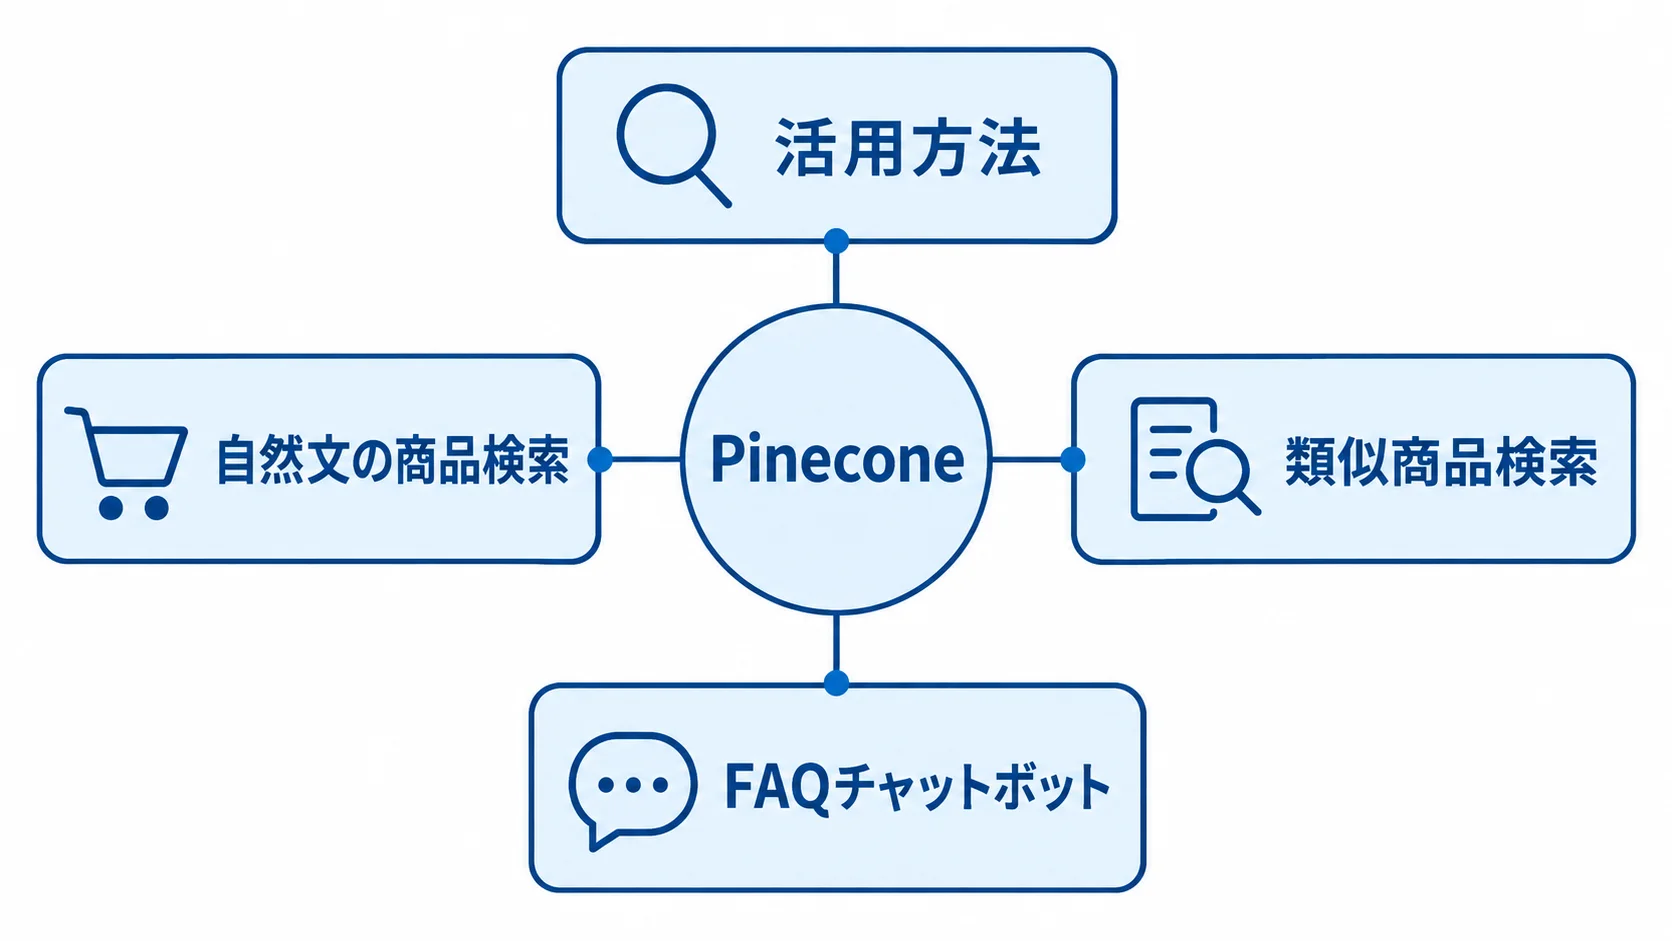
活用方法は目的によって変わります。商品検索では商品の意味的な近さを、レコメンドでは商品や行動履歴の近さを手がかりにします。RAGは、文書を取得して生成AIの回答材料にします。
いずれも、データの更新頻度、権限、評価指標に応じた周辺システムと組み合わせて使います。
自然文の商品検索と類似商品検索
「雨の日に通勤で使える軽い靴」のような検索では、商品名に書かれていない条件も拾う必要があります。商品説明やレビューをベクトル化すると、キーワードだけでは見つけにくい候補も提示できます。サイズや素材、用途も対象に含められます。
画像もベクトル化できるため、似た色や形の商品を探す画像検索にも応用できます。一方で、SKUや型番の完全一致には、メタデータフィルタや既存検索を併用します。価格帯、在庫店舗、販売期間の条件も、同じように扱います。
意味の近さだけで検索すると、在庫切れや対象地域外の商品が候補に混ざります。そこで、候補を取得したあとに業務条件を適用し、ゼロ件率と検索後のクリック率を継続して確認します。
レコメンドと顧客ごとの候補提示
レコメンドでは、行動データの使い方、候補の順位付け、個人データの扱いを設計します。
- 行動データ:商品特徴に加えて、閲覧やカート投入、購入、返品の履歴を活用します。
- 推薦条件:季節や価格、在庫、会員ランク、店舗、同時購入の制約を反映します。
- 順位調整:Pineconeで候補を探したあと、業務ルールや売上施策に沿って、アプリ側で並べ替えます。
- 個人データ:顧客IDを本文に埋め込まず、目的と権限を確かめたうえで、匿名化や仮名化をします。
- アクセス制御:権限、検索条件、返却項目をAPIで制限します。
顧客単位やテナント単位でNamespaceを分ける方法もあります。その分割は、アクセス制御の一部として位置づけます。
FAQチャットボットと社内ナレッジ検索
RAGの回答品質は、文書の取得方法、根拠の示し方、チャンクとメタデータの設計によって変わります。
- 関連文書:アプリがPineconeから文書を取得し、文脈をLLMへ渡して回答を生成します。
- 検索対象:商品仕様、配送条件、返品規約、店舗案内を対象にすると、再学習をせずに文書の更新を反映できます。
- 回答の根拠:文書名や更新日を添え、裏づけがない場合は「確認できない」と返します。
- チャンク分割:単位の大きさは精度を左右します。短すぎると前後関係が失われ、長すぎると無関係な情報が入ります。
- メタデータ:見出しや商品ID、適用地域、公開期間、閲覧権限を持たせ、改訂時に古いチャンクを確実に消せるIDを設計します。
Pineconeのシステム開発の進め方と5段階の流れ
全社検索を最初から作るより、目的と評価方法を絞ったPoCから始めると、本番化の可否を判断しやすくなります。データを入れて回答を見るだけでは、本番化の可否までは判断できません。
事前に、検索成功率やゼロ件率、クリック率などの指標を決めておきます。購買率や根拠提示率、有人対応への転送率なども、評価の対象になります。
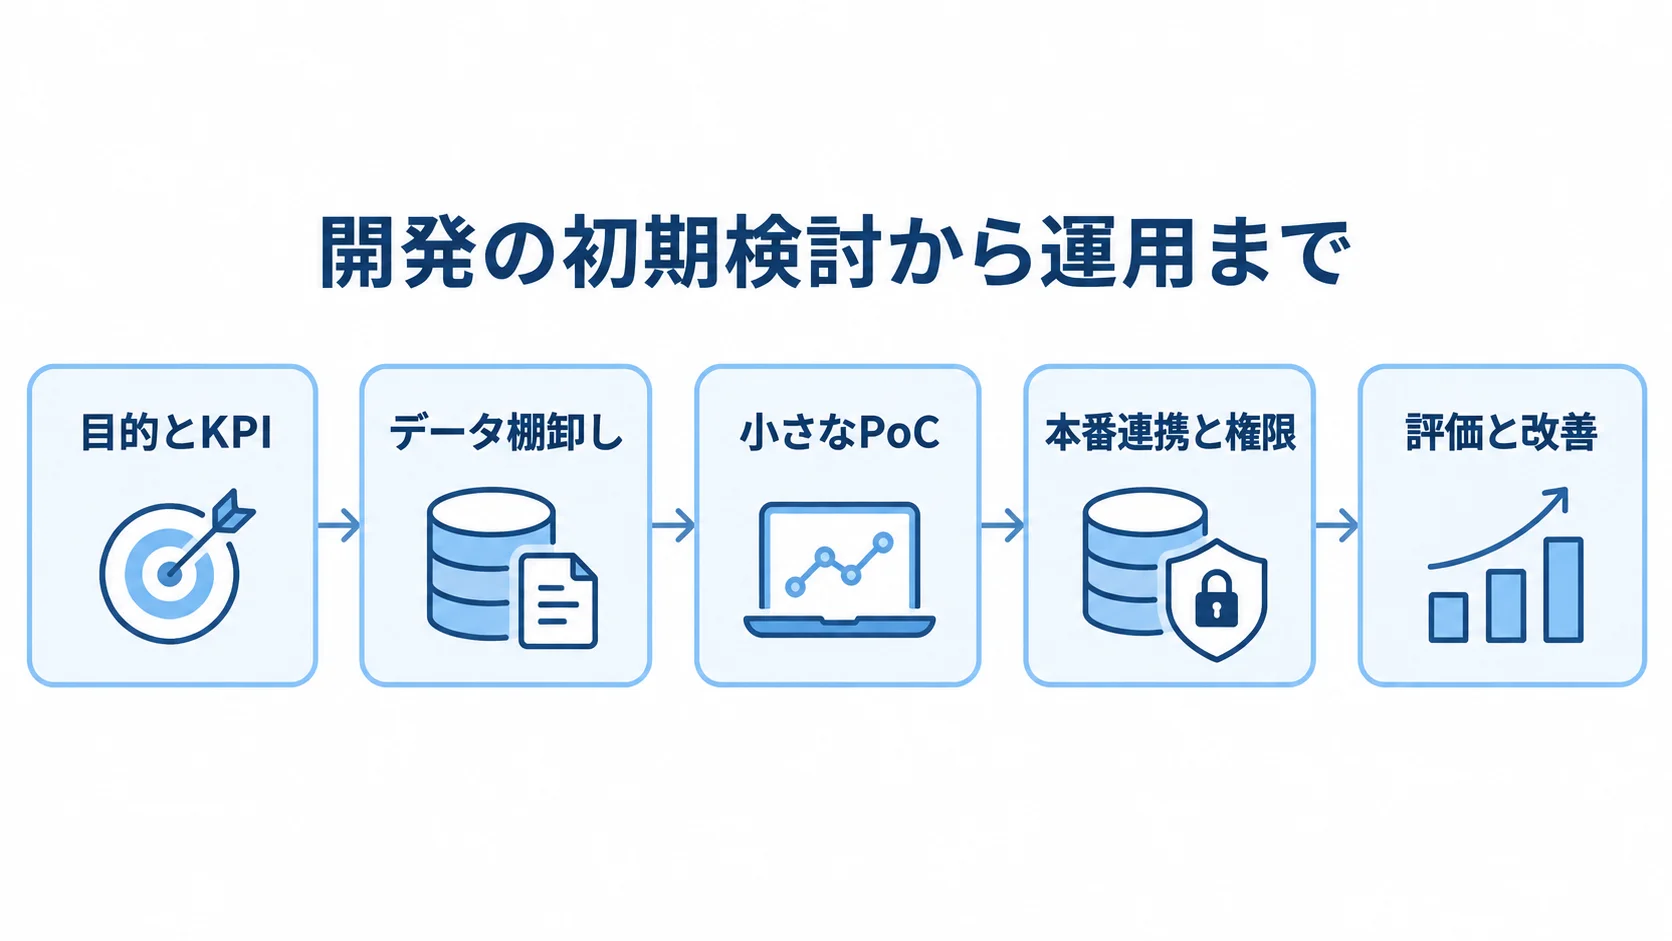
開発は、初期検討から運用まで5つの段階で進めます。
- 目的とKPIを定める
- データを棚卸しする
- 小さなPoCで検索方式を比較する
- 本番連携と権限を設計する
- リリース後の評価と改善を運用に組み込む
▶ 詳細はこちら:Pineconeのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
1. 目的・KPIの設定と、データの洗い出し
まず、解決したい課題と測定方法を定め、利用するデータの状態を確認します。
- 課題:「AI導入」を目的にせず、解決する業務課題を一つに絞ります。
- 商品検索KPI:検索後のクリック率や購入率
- FAQのKPI:正答率、根拠提示率、問い合わせ削減数、有人転送率
- 悪化指標:誤回答や問い合わせの再発も測り、売上だけで判断しないようにします。
- データの洗い出し:商品マスタ、在庫、価格、注文、顧客属性・文書・ログの所有者・更新頻度・保存期間・個人情報・削除対応を確認します。
Pineconeに保存する項目と、参照時に取得する項目は分けておきます。データ品質が低いままだと、誤検索の原因を特定しにくくなります。
2. 小さなPoCによる検索方式の比較
PoCでは、検索方式と運用面を同じ条件で比べます。
- 対象:商品検索やFAQなど一つの用途に絞り、データ源も一つか二つにとどめます。
- 評価用データ:代表的な質問を集め、評価の対象にします。
- 検索方式:意味検索、キーワード検索、ハイブリッド検索、RDBのベクトル拡張
- 質問内容:表記揺れ、型番、略語、固有名詞、否定表現を含む問い
- 評価項目:レイテンシ、検索結果の関連性、Embedding作成費、データ更新の遅延、運用担当者の作業量
採用理由が導入の速さか、検索性能と運用機能かを明確にすると、将来の構成変更も説明できます。
3. 本番連携と権限設計
本番運用に向けて、構成と更新方式、権限、可用性を決めます。
- 構成:Index・Namespace・メタデータ型・Embedding・チャンクと、再試行・キャッシュ・バックアップ・監視の設計
- 更新方式:夜間一括で足りるか、価格や在庫を数分以内に反映するか
- 権限:画面、API、データ連携の三層での確認。店舗と顧客で価格が異なる場合は、検索時のフィルタに加えて返却後も認可します。
- 可用性・分離:必要に応じて、専用読み取りノード、Private Endpoint、顧客管理鍵、BYOCを照合します。
削除イベントを逃すと、非公開商品や退職者向けの文書が残ってしまいます。そのため、追加や更新だけでなく、削除もテストします。
4. リリース後の評価と改善の仕組み
本番後は、失敗したクエリや利用量を追い、安全確認と改善を運用の流れに組み込みます。
- 失敗分析:無関係な検索結果、未登録文書、厳しすぎるメタデータ条件、LLMの回答生成ミスに分けて改善します。
- 利用状況:精度、レイテンシ、Read Unit、書き込み量、Embedding・リランキングの使用量
- 人の承認:注文変更、返金、契約判断、高額商品の購入は自動実行せず、Human in the Loopで扱います。
- 改善責任:判断者、根拠、実行結果の記録と、改善責任者、月次レビュー頻度の決定
Pineconeの費用相場と、利用料・開発費・運用費の内訳
Pineconeの費用は、利用料に加えて、Embedding・リランキング・LLMのAPI費を見ます。さらに、取込とアプリ開発費、監視・精度改善・保守費も含めて合算します。
月額と初期費用は分けて見積もります。
ここに示す金額は、2026年8月時点の公開価格と、類似する検索・RAG・データ連携案件からの編集部推定による目安です。
▶ 詳細はこちら:Pineconeのシステム開発の見積相場や費用/コスト/値段について
公開されているPinecone利用料の目安
利用料は、プランごとの基本料金に加えて、従量課金や周辺サービスの費用がかかります。
- プラン料金:Starterは無料、Builderは月20ドル、Standardは月最低50ドル、Enterpriseは月最低500ドルです。
- 円換算:1ドル150円なら、Builder約3,000円、Standard約7,500円、Enterprise約75,000円からです。
- 従量課金:StandardとEnterpriseは、最低額を超えると利用量に応じて課金されます。
- 変動要因:クラウドやリージョン、保存量、Namespaceの大きさ、クエリ回数、転送量によって変わります。
- 公式例:5万商品・各10KBのメタデータ・1,024次元Embedding、または約3万文書の意味検索はStarterの想定です。
無料のStarterは、小規模な検証や学習の入口として使えます。公開料金では、書き込みは100万Write Unitsあたり約4〜4.50ドルです。
読み出しは100万Read Unitsあたり約6〜6.75ドルです(出典: Pinecone公式料金表、2026年8月確認)。
1ドル150円での円換算額は、為替や契約条件、クラウドやリージョンで変わります(出典: Pinecone公式料金表・公式コストガイド、2026年8月確認)。
Embedding、リランキング、Assistant、初期インポートは別途費用がかかり、公式例にも含まれません。自社の検索回数と更新量で試算します(出典: Pinecone公式料金表、2026年8月確認)。
日本での開発費の幅(300万円〜1億円超)
開発費は、機能や連携範囲、監査や運用の要件によって変わります。
- 技術検証:一つのデータ源、簡易検索、少量評価で300万〜800万円程度、1〜3か月です。
- 小規模本番:認証、管理画面、1〜3本の連携を含み、800万〜2,000万円程度、3〜6か月です。
- 複数システム:EC・POS・CRM・在庫・WMS連携と検索・推薦・RAG・監視を含みます。2,000万〜5,000万円程度、6〜12か月の可能性があります。
- 大規模案件:複数ブランド・地域、厳格な監査、Private Endpoint、BYOC、24時間運用で5,000万円〜1億円超、9〜18か月のケースもあります。
ここに示す金額は類似案件からの推定で、Pineconeの公式見積ではありません。連携本数とデータ品質が費用を左右します。
精度改善と監視を含む運用費
運用費は、作業範囲とクラウドの実費、従量課金を分けて見積もります。
- 運用作業:ログ監視、障害対応、再インデックス、評価更新、失敗分析、検索条件の改善
- 月額目安:軽い監視と月次改善なら月30万〜60万円程度、複数システム等を含むと月60万〜150万円程度です。
- 初期作業:要件定義、データ整備(洗い出し・匿名化・ETL・Embedding・Index)、API・画面・連携、評価、セキュリティ試験、保守
- 従量課金:利用量に応じた費用と、課金上限の確認
Pinecone利用料、Embedding・LLM・リランキング費、アプリ基盤費、監視費は、分けて記載します。検索回数や更新件数、平均データサイズ、許容レイテンシも示しておくと、費用の前提を比べやすくなります。
複数システムや高頻度更新、有人サポートまで含む場合は、上の月額目安を参考に運用の範囲を広げて見ます。初期開発費が安くても、更新や評価の仕組みが別料金だと、本番後の負担が増えます。
Pinecone導入で確認すべきセキュリティと失敗リスク
ベクトル化したデータも、元の文章を保存しない場合には、顧客情報や社内機密と結びつく可能性があります。そのため、保存内容や保管地域、検索権限、削除請求や契約終了時の消去方法を決めておきます。
生成AIの入力やログに個人情報を含める場合は、利用目的、委託、第三者提供、国外移転について、社内ルールとの整合を確認します。
権限継承とデータ保護の設計
文書の閲覧権限は、検索前の絞り込みと、検索後の返却確認の両方に反映します。
- 権限属性:社内文書の閲覧権限を検索結果とLLMの文脈に引き継ぎ、部署などをメタデータに持たせます。
- 検索前後:利用者の権限で事前に絞り込み、権限外の文書名やスニペットが漏れていないかを確かめます。
- 保護機能:要件に応じて、認証・監査・暗号化の機能を選びます。
- 追加機能:バックアップ、Private Endpoint、顧客管理鍵も案内されています。利用できる機能はプランによって異なります。
- 運用確認:必要な監査証跡、鍵の管理主体、ネットワーク経路、退職者アカウントの無効化
公式資料では、APIキー、RBAC、SSO、監査ログが案内されています(出典: Pinecone公式Security overview、2026年8月確認)。
さらに、保存時のAES-256暗号化とTLS 1.2通信も案内されています(出典: Pinecone公式Security overview、2026年8月確認)。
誤検索・プロンプトインジェクション・古い情報のテスト
精度と安全性を確かめるため、運用上の失敗と攻撃シナリオをテストします。
- 検索品質:更新漏れ、チャンクやメタデータの不備、上位件数の過多、LLMの根拠なき補完
- 変動情報:価格や在庫を静的文書だけで回答させず、更新日時と正本を紐づけます。
- 攻撃シナリオ:プロンプトインジェクション、別利用者の文書取得、データ改ざん、根拠のない回答を試します。
- レッドチーミング:RAGの手順と成果物例を含むガイドの改訂版が、2025年4月に公開されました(出典: AIセーフティ・インスティテュート、2025年)。
- テスト工程:計画、攻撃、結果の整理、改善後のフォローアップまでを一連の工程にすると、検証漏れを抑えられます。
2026年の動向:検索基盤からAIエージェントの知識基盤へ
公式発表では、AIエージェント向けの知識基盤へ広げる動きが示されています。
- Pinecone Nexus:企業データと連携して、タスクごとの構造化されたコンテキストを作る方向です。
- 初期評価:2026年6月に、トークン95%以上削減、実行30倍高速化、完了率90%超が紹介されました。自社で保証される数値ではありません。
- 機能の動向:権限付きの知識取得、引用、更新の自動反映、利用量の確認が、今後の焦点になります。
- 採用時の確認:一般提供かプレビューか、保存場所、監査要件、対象プラン(出典: Pinecone公式ニュースリリース、2026年6月)
新機能の提供状況や対象プランは、今後変わる可能性があります。
Pineconeの開発会社・サービスの選び方
Pineconeを扱えるかどうかだけで発注先を選ぶと、商品マスタや在庫、顧客権限、画面、運用までつながらない恐れがあります。そこで、業務要件からデータ連携、評価、セキュリティ、リリース後の改善まで、一つの責任範囲として説明できる会社やサービスを選びます。
検索技術と業務システム連携の両面の確認
候補先の提案は、検索技術と業務連携の両面で比べます。
- 検索設計:Embeddingの選定理由、日本語評価、チャンク分割、ハイブリッド検索、リランキング、メタデータフィルタ
- 運用設計:Namespace、キャッシュ、バックアップ、障害時の切り戻し方法
- システム連携:EC、POS、CRM、在庫、WMS、問い合わせ管理との接続経験
技術資料のサンプルに加えて、実際の評価レポートを見せてもらうと、選定の判断材料になります。
検索成功率やゼロ件率、レイテンシなどの計測方法を確かめます。クリック率や購買率、根拠提示率、誤回答率も確かめる対象に含めます。
自社データを外部に出せない場合は、匿名化した評価データや、同じ条件で再現できるテスト手順を求めます。
見積の比較:作業範囲と従量課金の前提
見積の条件をそろえるため、RFPには前提と費用項目を明記します。
- 利用条件:対象用途、データ件数、1日の検索回数・更新件数、平均文書サイズ
- 性能・連携:許容レイテンシ、想定ピーク、接続先、権限、保存地域、削除要件
- 評価と時期:評価指標と希望リリース時期も記載します。前提が曖昧だと、金額だけでは比べられません。
- 見積項目:要件定義、PoC、データ整備、実装、テストに分けます。セキュリティ、移行、保守も別の項目にします。
- 費用と上限:従量費の上限とアラート、開発会社の追加作業単価
Pinecone利用料、Embedding・LLM・リランキング費、アプリ基盤費、監視費は、別欄に記載します。毎月の変動費を説明できる提案が望ましいです。
契約前に確認する保守体制と責任分界
契約前に、担当範囲や障害対応、本番移行の基準、継続レビューを決めておきます。
- 運用責任:精度改善、更新失敗の検知、PineconeやLLMの障害復旧の担当者
- 障害・契約終了:対応時間や窓口、バックアップ復元、再インデックス、脆弱性対応、データ返却と消去をSLAなどに記します。
- 本番移行基準:PoCの成功条件に含める検索成功率、根拠提示率、最大レイテンシ、更新反映時間
- 継続改善:月次レビューで費用とKPIを同時に見直せる体制
評価クエリの基準を関係者で合意しておくと、「動くものができた」だけで本番化する事態を防げます。
▶ 詳細はこちら:Pineconeのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Pineconeのシステム開発の発注/外注/依頼/委託方法について
よくある質問(FAQ)
Pineconeのシステムを検討するときによく挙がる疑問を、料金や既存システムとの違い、導入期間、セキュリティの面から取り上げます。
Pineconeは通常のデータベースや検索エンジンと何が違いますか?
Pineconeは、意味の近さを使うベクトル検索に強く、自然文の検索や類似商品、RAGの文書検索に向いています。一方で、SKUの完全一致や在庫・価格の更新、注文処理は、既存のRDBや業務システムが担います。
両者を組み合わせ、用途ごとに役割を分ける設計が基本です。
Pineconeは月額いくらから利用できますか?
2026年8月時点の公開価格では、Starterは無料、Builderは月額20ドルです。Standardは月額最低50ドル、Enterpriseは月額最低500ドルです。
読み書きや保存、転送の費用がかかります。さらに、Embedding、リランキング、LLMの費用が加算され、初期取込も加わります。利用料だけでなく、開発費や運用費も含めて試算します。
小規模なPoCは無料枠で検証し、本番の要件が固まってからプランを選ぶ進め方が適しています。
Pineconeのシステム開発にはどのくらいの期間がかかりますか?
技術検証は1〜3か月、小規模な本番導入は3〜6か月、複数の業務システムをつなぐEC・オムニチャネル案件は6〜12か月程度が目安です。
データ整備や権限設計、評価データの準備にも時間がかかります。そのため、実装期間だけで判断しないでください。
一つの用途でPoCを行い、データ更新と評価の難易度を確かめると計画を立てやすくなります。
顧客情報や社内文書をPineconeに保存しても安全ですか?
安全性は、保存データや権限、ネットワーク、契約、運用の設計によって変わります。サービス名だけで判断しないことが大切です。
RBAC、暗号化、監査ログ、Private Endpoint、顧客管理鍵などを要件に応じて選び、利用者の権限をアプリ側でも検証します。
個人情報を扱う場合は、利用目的、委託や第三者提供、国外移転、削除請求、ログへの混入を法務・セキュリティ担当と確認してください。
まとめ:既存システムにAI検索・推薦を加える基盤としてのPinecone
Pineconeは、商品や文書、行動履歴などを意味で検索できるようにし、EC検索やレコメンド、FAQチャット、類似検索を支えます。
在庫、価格、注文の管理は、正規DBや顧客・店舗システムが担います。Pineconeはそれらと連携し、検索候補と最新情報を分けて扱います。
導入前に押さえる3つのポイント
目的とKPIを定め、検索成功率や購買率、根拠提示率などを測れる状態にします。
Pinecone利用料、Embedding・LLM費、初期開発費、運用保守費を分け、利用量の前提と上限を見積に記載します。
権限継承と削除、監査ログを、本番前のテスト項目に入れます。プロンプトインジェクションや、古い価格や在庫の混入も対象です。
まずは一つのユースケースでのPoC
全社データを移行せず、商品検索やFAQなど成果を測りやすいテーマを一つ選びます。そのうえで、代表的な評価クエリとデータ更新のシナリオを用意します。
Pineconeと他方式を比べたうえで、本番の連携範囲とセキュリティ要件を固めます。
発注時には、データ連携や業務理解、評価、保守まで担当できるかを確かめます。
▼関連記事一覧
・Pineconeのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Pineconeのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Pineconeのシステム開発の見積相場や費用/コスト/値段について
・Pineconeのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。