
Prometheusのシステム開発は、発注形態を選び、要件を整理したうえでRFPで条件をそろえ、PoCで運用に合うかを確かめてから、契約と運用へ進めます。この順で進めると、障害の早期発見につながります。
全体像は、Prometheusのシステム開発の完全ガイドでも確認できます。
▼全体ガイドの記事
・Prometheusのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Prometheusのシステム開発を発注する前に知っておきたい全体像
納品物をPrometheus Serverだけに絞ると、本番運用で計測や通知が不足しやすくなります。そのため、発注の前に、何を測り、誰が見て、異常時に誰が動くかを決めておきます。
データを何カ月残すか、月額費用をいくらまで許容するかも要件に含めます。これらは、発注先と一つの設計課題として整理します。
Prometheusの役割:監視データの収集と異常の通知
Prometheusは、サーバーやコンテナ、Kubernetes、データベース、Webアプリが公開する数値を定期的に収集します。
収集したデータは、時系列データとして保存されます。
- 集計:PromQLの結果を、記録ルールやアラートルールで利用
- 通知:Alertmanagerから、メール、Slack、PagerDutyなどへ送信
- 特徴:HTTPのPull型収集、ラベル付き時系列データ、PromQLに対応
- 用途:障害調査や傾向把握(会計データの原本には使わない)
Prometheus公式Overviewは、単一サーバーで自律して動ける点も挙げています(出典:Prometheus公式 Overview、2026年8月確認)。一方で、取引明細や請求金額のように一件も欠落させられないデータには向きません。会計データや監査証跡の原本を置き換えられないためです。
発注範囲の収集・可視化・通知・運用までの分け方
発注書では、収集・可視化・通知・保存を別々の作業項目に分けます。あわせて、運用時の担当と対応も決めます。
- 収集:Prometheus Server、Exporter、アプリ計装を分けて扱う
- 可視化・保存:GrafanaとRemote Writeまたは長期保存基盤を指定
- 通知・運用:Alertmanager、重大度、通知先、当番、サイレンスの決定
- 業務指標:CPUやメモリに加えて、注文成功率や決済エラー率も監視
Grafanaは、ダッシュボードを作る可視化の層です。
Prometheus本体とは役割が異なります。
復旧確認まで定義しておかないと、グラフは表示されていても、現場が対応できるとは限りません。また、在庫連携の遅延、バッチ完了時刻、キュー滞留数も、業務指標の候補です。
サービス責任者と運用担当者も参加して、通知後の対応を確認します。
Prometheusの発注形態の選び方
発注形態は、自社運用、マネージドサービス導入支援、一括委託から選びます。判断の基準になるのは、対象規模と社内体制です。
OSSでも、担当者の時間やクラウド料金、障害対応、アップデートの負担は発生します。そのため、誰が負担するかで適した形が変わります。
自社運用:小さく始めて技術を蓄積したい企業向け
まず、自社にKubernetesやクラウドの運用基盤と担当者がいるかを確認し、構築と運用を担える範囲を見極めます。
- 体制:オンコールやSRE担当者がいれば、自社構築を選べます
- 構成管理:設定と画面をGitで管理し、各環境へ段階的に反映
- 費用:ライセンス費を抑えやすい一方で、運用作業は自社が担う
構成には、Prometheus、Alertmanager、Grafanaを組み合わせます。また、ストレージや冗長化、バックアップに加えて、更新、脆弱性対応、障害復旧も自社の担当です。一方で、初期の計測とアラート設計だけを外注する方法もあります。
ラベルの命名、高カーディナリティ対策、業務指標は、後から直すと影響が広がります。そのため、PoCの段階で専門家にレビューを依頼できます。
マネージドサービスの特徴:運用負荷と規模拡大の不安の軽減
AWS、Google Cloud、Azure、Grafana Labsなどは、保存基盤の拡張やサーバー更新を担います。
マネージドサービスでは、一定の可用性設計も任せられます。
- サービス側の運用:基盤の拡張やサーバー更新を任せられる
- 互換性と保持:Google CloudはPrometheus互換の収集とPromQLに対応
- 自社の要件:収集対象、scrape間隔、フィルタ、ラベル、アラートルール、Grafana権限を自社で決める
- 費用比較:課金単位が異なるため、同じ条件での試算を依頼
Google Cloud Managed Service for Prometheusは、標準で2年間のメトリクス保持を掲げています(出典:Google Cloud公式 Managed Service for Prometheus、2026年8月確認)。
データの所在地と解約時の持ち出し方法も、要件に含めます。
課金単位は、samples、active series、クエリ量、ホスト時間などに分かれます。
一括委託:設計から運用引き継ぎまで任せたい企業向け
専門人材が足りない場合や、複数のクラウドとオンプレミスを横断する場合、障害対応まで整えたい場合は、一括委託が候補になります。
- 委託範囲:要件整理、構築、テスト、移行、運用設計までを依頼
- 調整力:アプリ、インフラ、情報システム、セキュリティ部門との調整も見る
- 責任分界:アラートの意味や復旧手順を対象に含める
- 納品と保守:設定、PromQL、画面、テスト、手順、教育、窓口を明記
業務システムでは、部門間の調整が必要です。
技術力に加えて、プロジェクト管理力も委託先選びに含めます。
納品後の責任分界が曖昧だと、障害が起きたときに、どこから先を委託先が担うのか分からず困ります。
Prometheusの発注で最初に整理する要件
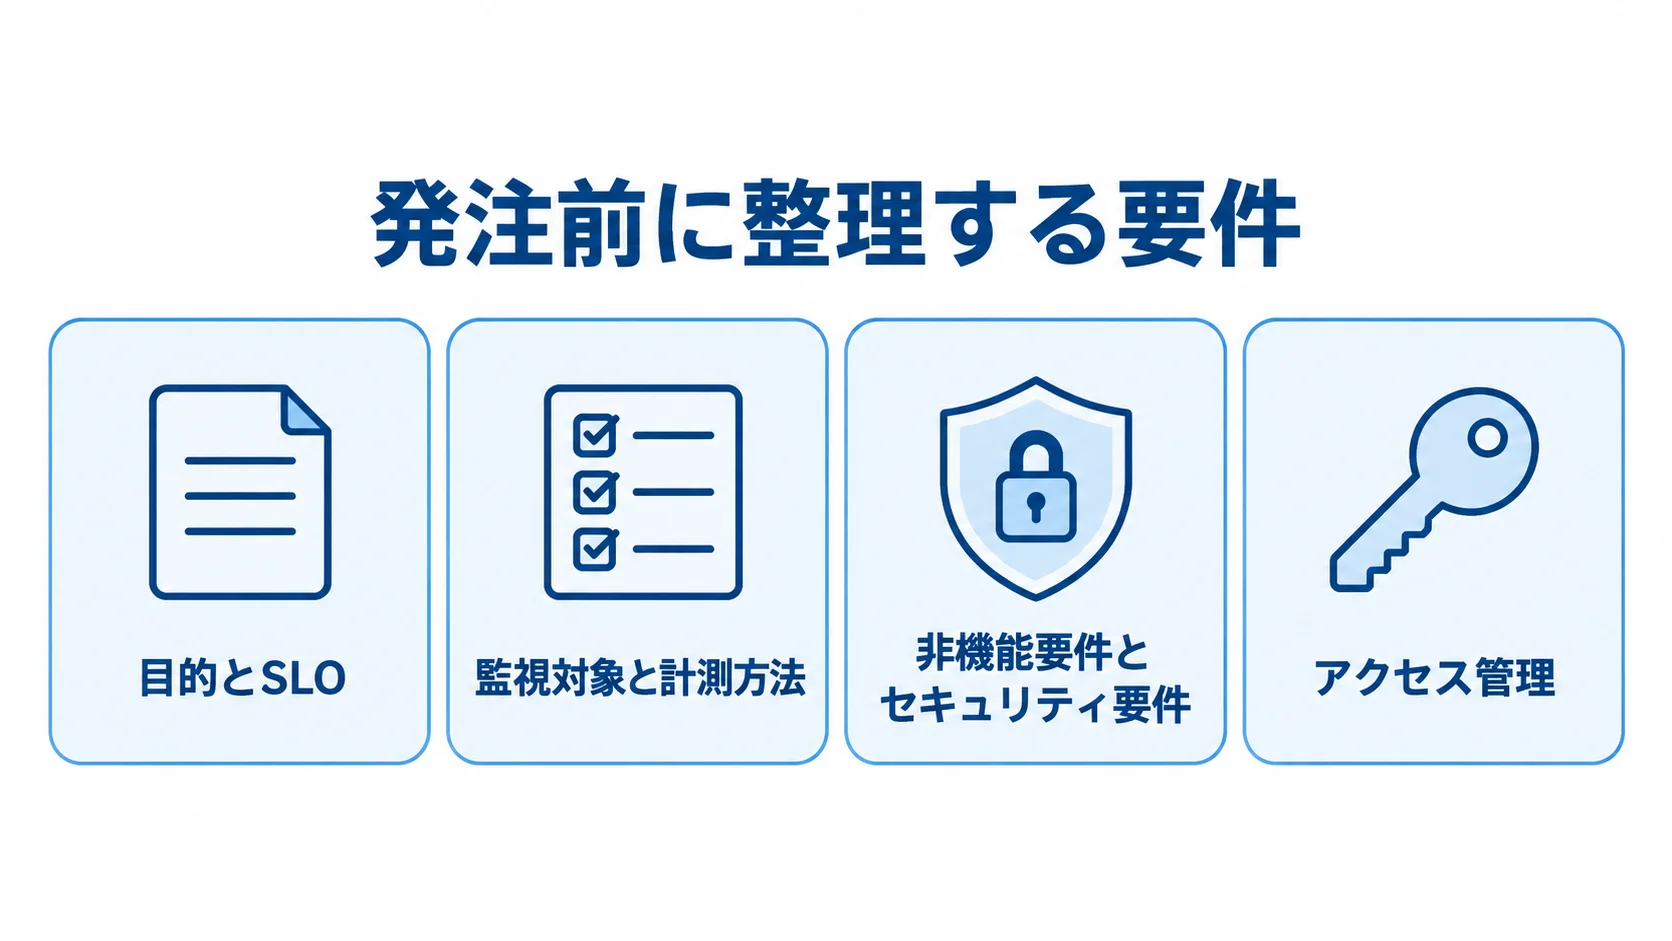
要件定義は、業務上の困りごとから考えます。そのうえで、課題を観測できる指標に置き換えます。
RFPには、監視対象、環境、利用者を記載します。業務影響、通知条件、保持も書き込みます。また、セキュリティや運用体制、予算と納期も明記すると、各社が同じ前提で提案できます。
業務指標による目的とSLOの書き方
「サーバーを監視したい」とだけ書くと、成果物が委託先ごとに変わります。そこで、測定値や閾値、継続時間を組み合わせます。通知先や対応時間も、あわせて書き添えます。
- 注文API:エラー率が5分連続で1%を超えたら担当チームへ通知
- 在庫連携:遅延が10分を超えたら業務部門にも通知
- 月次バッチ:予定時刻までに未完了なら当番へエスカレーション
SLOを定めると、必要なメトリクスとアラートを絞り込めます。
指標は、可用性やレイテンシから処理件数、エラー率、連携遅延まで、優先順位に応じて選びます。
アラートの作成そのものを成果とはしません。通知を受けた担当者が、手順書に沿って復旧できることを受入条件にします。
監視対象と計測方法の一覧
監視対象と計測方法は、インフラから業務処理までの範囲と、記録する情報に分けて整理します。
- 対象:インフラ、Kubernetes、ミドルウェア、アプリ、業務処理を洗い出す
- 計測元:Node Exporter、kube-state-metrics、アプリ計装などから選ぶ
- 一覧項目:メトリクス名、単位、収集元、間隔、ラベル、保持、閲覧者、アラートの有無
- ラベル:有限の分類に絞り、無制限に増える値は避ける
たとえば、CPUやメモリ、ディスク、ネットワークにはNode Exporterなどを使い、PodやDeploymentにはkube-state-metricsを使います。
また、自社アプリはクライアントライブラリやOpenTelemetry Collectorで計測できます。対象は、リクエスト数、エラー数、処理時間です。
ユーザーIDや注文番号、URL全文、リクエストIDは、高カーディナリティになり得ます。一方で、service、environment、region、status_code、operationのような有限の分類なら、性能と料金を管理しやすくなります。
非機能要件とセキュリティ要件の早期決定
非機能要件とセキュリティ要件は、性能・可用性と情報保護の両面から決めます。
- 性能・可用性:間隔、遅延、同時クエリ、保持、RTO・RPOの定義
- 運用基盤:バックアップ、冗長化、リージョン、削除、監査ログの決定
- 情報保護:個人情報や秘密情報を含めないためのデータマッピング
- アクセス管理:権限、保存地域、委託先、通知、削除手順の決定
Prometheus公式は、/metrics、各種API、pprofを不用意に公開しないよう注意しています。あわせて、TLS、認証、管理APIの制御についても説明しています(出典:Prometheus公式 Security model、2026年8月確認)。
メトリクスやラベル、URL、サービスディスカバリの情報から、顧客や従業員、環境を推測できる場合があります。
Grafanaの画面権限とデータソース権限は同一とは限らないため、実行可能なPromQLも確認します。
RFPを作成してPrometheusの発注を進める手順
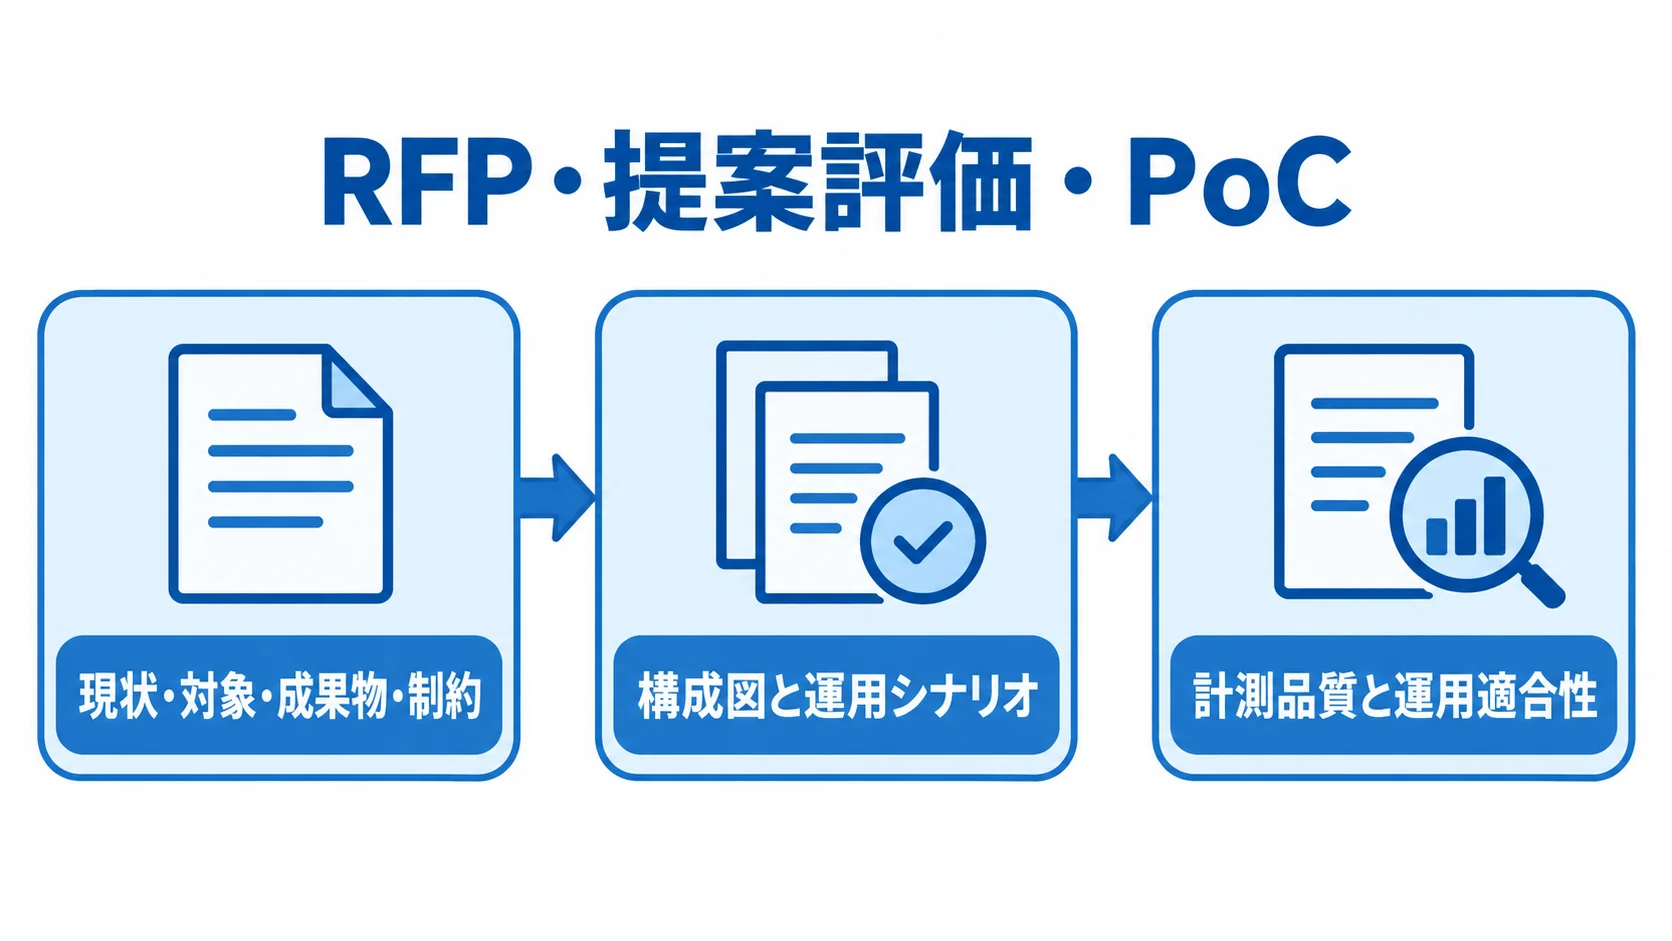
RFPは、各社から比較可能な提案を集めるための共通条件です。作業を丸投げする文書とは違います。
RFPには、現状の構成図や監視対象、業務課題をまとめます。さらに、期待するSLOや環境制約を示したうえで、納品物、予算、期限も書きます。
未確定の事項は「提案で決めたい事項」として示し、判断の理由も回答してもらいます。
RFPに記載する現状・対象・成果物・制約
RFPでは、現状と監視対象を分けて記載し、成果物と発注上の制約も別々に書きます。
- 現状:クラウド・オンプレミスの構成、Kubernetesクラスタ数、アプリ数、既存監視を記載
- 連携:インシデント管理やチャットとの接続も示す
- 対象量:メトリクス・時系列数、ラベル増加、間隔、想定クエリ量を記す
- 成果物:設計、設定、計装、PromQL、アラート、画面、テスト、運用資料を指定
既存監視には、Zabbix、Datadog、CloudWatchなどを含めます。
台数の記載だけでは足りないため、可能な範囲で数値も書き添えます。
成果物は、要件定義書や基本設計書、テスト仕様書と結果のように、文書名まで挙げて指定します。
納品物には、Exporterと計装コードを含めます。加えて、障害連絡フローや教育資料、ソースと設定の引き渡しも求めます。
納品形式や著作権・利用権、リポジトリ管理者、秘密情報の扱いも、あらかじめ決めておきます。
構成図と運用シナリオによる提案書の評価
提案書は、構成図と障害時の運用シナリオから確認します。
将来対応や前提条件の観点も、あわせて見ます。
- 構成:Exporterから通知先までのデータフロー
- 運用:通知、切り分け、エスカレーション、復旧確認の評価
- 拡張:個別開発との境界、クラスタ追加、容量・料金対策の確認
- 移行:既存ダッシュボードを移せるかどうか
データフローには、Prometheus、Remote Write、PromQLを含めます。さらに、AlertmanagerとGrafanaも含めてもらいます。
障害シナリオを使うと、製品名だけでは分からない運用力を比べられます。
前提やリスク、代替案、発注側に残る作業が明確な提案であれば、実行時の認識のずれを抑えられます。
PoCによる計測品質と運用適合性の確認
全社展開の前に、重要な一つのサービスまたはKubernetesクラスタで、小さく運用適合性を確かめます。
- 計測:既存Exporter、REDメトリクス、業務KPI、ラベル設計の試行
- 運用:ダッシュボード、通知、障害訓練の検証
- 期間:発注目安として2〜6週間程度を置くケースがある
特に、合否は画面表示だけでなく、必要な障害を検知できるかで判断します。加えて、不要な通知を抑えられるか、担当者が手順を実行できるかも確かめます。
想定費用も算出します。ただし、期間は公的な平均ではなく、記事用の推定です。
既存環境とアプリ計装、承認とセキュリティ審査を含むかどうかで、期間は変わります。そのため、RFPでは期間だけでなく、対象数と検証項目も定めます。
Prometheusの外注で選ぶ契約形態と責任分界
契約形態は、要件の確定度と成果の測り方で選びます。PoCや要件定義は準委任、仕様が固まった構築は請負が候補です。
構築後の監視改善や問い合わせには、保守・運用契約を組み合わせます。なお、法律上の判断には、自社の法務確認が必要です。
技術発注では、発注側が何をもって完了とするかを先に決めます。
準委任:調査・設計・伴走型の作業
作業量や検討結果が環境によって変わる業務では、準委任が使いやすい傾向があります。調査・設計・伴走型の作業が、その候補になります。
- 調査・設計:既存調査、対象の洗い出し、SLO設計、RFP作成の支援
- 検証・改善:PoCと、導入後の運用改善
- 契約条件:稼働時間、役割、会議体、報告、納品、時間外対応の取り決め
- 作業記録:議事録、課題、判断、設定案、レビュー、次の計画
作業の中身が途中で変わりやすいため、月次の到達点を合意し、何をいつまでに決めるかを明確にします。
請負:範囲と受入条件が固まった構築
成果物と完成条件を明確にできる構築は、請負契約の候補になります。
発注側は、受入条件と変更管理も定めます。
- 構築対象:Prometheus、Alertmanager、Grafana、指定のExporter
- 実装対象:ダッシュボードとアラートルール
- 受入条件:指定間隔の収集、異常通知、権限、復旧手順の検証
- 変更管理:追加対象、24時間対応、長期保持、既存監視との統合
クラスタや業務メトリクスの追加は、発注後に要件が増える典型例です。そのため、追加費用と納期の計算方法も決めておきます。
見積もりでは、工程別の工数と単価、前提と除外事項を提示してもらいます。
保守契約の対応時間と改善範囲の具体化
保守契約は、対応時間と改善作業の範囲を分けて決めます。
- 保守作業:更新、脆弱性、容量、アラート、画面改修、障害調査、報告
- 対応体制:営業時間、夜間休日、受付と復旧の担当、SLA、連絡手段
- 改善枠:月の改修時間と未使用時間の扱い
- 定例確認:通知、誤検知、未対応、利用状況、メトリクス量、請求
初期構築のあとも、アラート件数やクラウド請求などは定例で見直します。
保守費は、初期開発費の年10〜20%程度とする一般論があります。ただし、これはPrometheus専用の統計ではなく、対応時間や24時間体制によって変わる推定です。
Prometheusの開発・導入費用相場とランニングコスト
Prometheus本体はApache 2.0ライセンスのOSSで、ライセンス購入費はかかりません。
一方で、設計、アプリ計装、Exporterには費用がかかります。インフラやダッシュボードの構築、通知とセキュリティの整備にも、費用が発生します。さらに、テスト、教育、保守も費用の対象です。
「無料」が指すのはソフトウェアの利用料です。総保有コストまで無料という意味ではありません。
初期費用の決まり方:対象範囲と運用設計の深さ
自社運用型の初期費用と期間は、対象規模・構成に応じた推定レンジで見ます。
- 検証・小規模PoC:50万〜200万円程度、2〜6週間。
- 小〜中規模の本番:200万〜600万円程度、1〜3カ月。
- 複数クラスタ・長期保持:500万〜1,500万円程度、3〜6カ月。
- 大規模な業務メトリクス・データ連携:1,000万〜3,000万円超、期間は6カ月以上。
金額は全国統計ではなく、記事用の目安です。要件定義や設計、計装の作業量から置いています。設定やテストに加えて、移行や引き継ぎの作業量も同じように含めています。
既存のKubernetesやExporterが整っていれば、期間は短くなります。反対に、オンプレミスや複数クラウド、審査、業務アプリ改修を含むと長くなります。
見積書では、金額と期間がどの対象範囲に対応するかを確認します。
マネージドサービスの課金単位をそろえた比較
主要サービスは、課金単位や無料枠が異なります。そのため、公式例の条件と含まれる費用を確認して比べます。
- Amazon Managed Service for Prometheus:取り込み・保存・クエリ、Collectorの収集量や稼働時間に応じた従量課金。
- Grafana Cloud Free:月額0ドル、10,000 active series、14日保持。
- Grafana Cloud Pro:月19ドルから、10,000 active series込み。超過は1,000 seriesあたり6.50ドルから。
- Google Cloud:最初の500億samplesまで0.060ドル/100万samples。
AWS公式例は10ノード、各1,000メトリクス、30秒間隔、月744時間で、取り込み・保存・クエリの合計が月81.75ドルです。
この公式試算には、EKSやGrafanaの費用が含まれません。さらに、ネットワーク、税、サポート費も対象外です(出典:AWS公式 Amazon Managed Service for Prometheus Pricing、2026年8月確認)。
Grafanaの料金は公式Pricingに基づきます(出典:Grafana公式 Pricing、2026年8月確認)。また、Google Cloudはsamplesと読み取りAPIを中心に課金します。
料金は更新されるため、発注時点の料金表と同じ入力条件で再計算します。
メトリクス量と収集間隔の設計によるコスト抑制
費用を抑えるには、見積もり項目、収集設計、利用量の管理を分けて確認します。
- 見積もり:指標、時系列、ラベル、間隔、保持、画面更新、クエリ、Collector・エージェント費用の分割
- 収集設計:間隔やラベルの調整と、不要なメトリクスの除外
- 費用管理:上限通知、日次確認、環境別タグ、利用量の画面の用意
- 感度分析:月額の通常時に加えて、対象数2倍、収集間隔半分、保持延長時の費用を試算
ダッシュボードの更新頻度や、ログ・トレースの費用も確認します。たとえば、重要指標を15秒間隔、参考値を60秒間隔にすると、samples数が変わります。
高カーディナリティのラベルを減らすと、費用と性能の両方に効きます。また、感度分析を使うと、従量費の増加リスクを見つけやすくなります。
Prometheusの委託先選定と見積比較のポイント
委託先は、PromQLの扱いだけでなく、アプリ計装やKubernetes、クラウドIAMを担えるかで評価します。さらに、ネットワーク、セキュリティ、SRE運用まで担えるかも見ます。
また、業務部門との調整力も確認します。資格やサービス名だけでなく、似た規模・構成・体制での経験と、本番障害への対応を担当者に尋ねます。
実装と運用の具体例による技術力の確認
技術評価では、計装や拡張、設計を具体例で確かめます。あわせて、障害対応やセキュリティも具体例で見ます。
- 計装と拡張:Exporterで不足する対象と、HA・Remote Writeへの移行条件
- 設計・復旧:ラベル、抑制、権限、バックアップ、復旧方法
- セキュリティ:HTTPエンドポイントを公開せずに守る設計か
- 業務理解:在庫連携停止を検知する指標と通知方法
/metrics、Prometheus API、Grafana、Alertmanager、Pushgatewayを、どのネットワークに置くかを確認します。
TLSや認証、認可、管理APIの有効化も確認します。
秘密情報と個人情報を除外できているかも確かめます。
たとえば、注文処理は成功していても在庫連携だけが止まる例を示し、候補者に検知方法を説明してもらいます。
公式資料も注意を促しています。委託先には、ネットワーク図と脅威・対策を提示してもらいます。
見積書の内訳と前提の比較
見積書は、作業内訳、費用前提、契約後の対応を分けて比較します。
- 作業内訳:要件、設計、構築、計装、Exporter、画面、テスト、移行、教育、保守の各工程
- 前提:工数、単価、担当、期間、成果物、発注側作業、除外事項
- 従量費:指標、時系列、間隔、保持、クエリ、リージョンの前提を共通化
- 契約後:サポート、追加単価、夜間対応、駆け付け、データ出力
「導入一式」とだけ書かれていると、追加費用の条件が分かりません。
金額が高い場合は、含まれるリスク対策や作業を確認します。
ベンダーロックインと引き継ぎ条件の事前確認
将来の保守先変更やサービス移行に備え、所有する資産と解約条件を確認します。
- 依存の確認:独自画面、専用エージェント、独自クエリ、非公開の手順
- 自社保有:PromQL、画面定義、アラート、コード、IaC、設定、テスト、運用文書
- 終了条件:出力形式、API、保持、削除、地域、猶予、料金改定通知
- 移行性:Grafana資産やRemote Write、OpenTelemetryを使った移行
設定や成果物を自社のリポジトリに納品してもらえば、将来の保守先変更に備えられます。
Grafana資産の再利用やデータ移行は、PoCで試しておくと、契約後の選択肢を残しやすくなります。
発注後に失敗しないPrometheusの運用設計
導入時は問題がなくても、数カ月後に失敗が表れることがあります。たとえば、アラートが過多になる場合や、担当者が異動する場合があります。
ラベルの増加でメモリや料金が増えたり、未利用の画面が残ったりすることもあります。
障害時に通知先が不在になることもあります。そのため、発注時点で、運用責任者と定例改善の方法を決めておきます。
アラートの重大度と対応手順の組み合わせ
アラートには、重大度や対象のサービス、環境、地域を定義します。さらに、担当チームや当番、原因候補、一次対応、エスカレーション先も決めます。そのうえで、通知先は重大度に応じて分けます。
- 高重大度:電話やオンコール
- 中程度:チャット
- 低重大度:日次レビュー
同じ原因で通知が増える場合は、Alertmanagerのグルーピングや抑制を使います。通知疲れを防ぐためです。
受入テストでは、CPU逼迫やディスク枯渇、APIエラー、DB接続増加を再現します。
注文停止や連携遅延も、受入テストの検証対象です。
通知だけでなく、誤検知や復旧後の解消、手順書による復旧まで確認します。
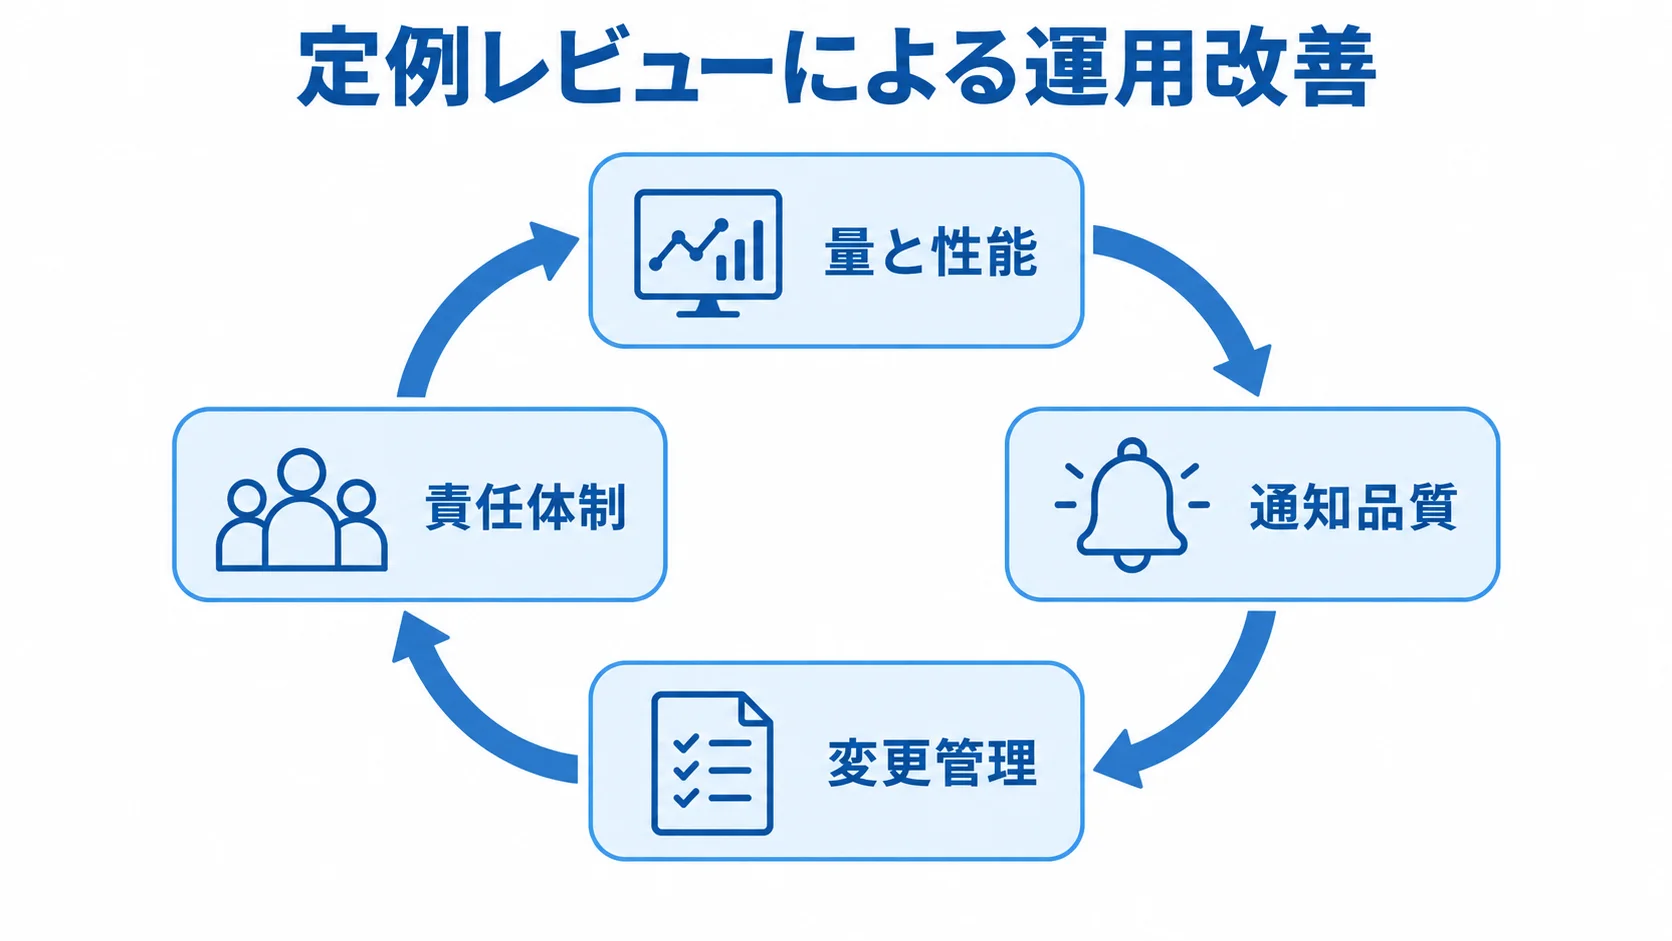
定例レビューによるメトリクスと費用の改善
月次または四半期のレビューで、指標・性能・通知・費用を確認し、運用を更新します。
- 量と性能:メトリクス、active series、収集失敗、クエリ遅延、ストレージ
- 通知品質:アラート件数、誤検知、未対応時間
- 変更管理:新サービスの対象とラベル、画面や閾値の更新
- 責任体制:報告、改善時間、障害レビュー担当と社内担当者の決定
クラウド請求も確認します。
ダッシュボードや閾値は、業務の変化に合わせて削除・統合・追加します。
社内にも、Prometheusを理解する担当者を一人以上置きます。そのうえで、設定変更の承認やアクセス権、緊急連絡を自社でも管理します。
完全に委託すると、委託先の変更や障害時の判断が難しくなります。
Prometheusの発注・外注でよくある質問
発注前によく寄せられる疑問に答えます。規模やクラウド環境によって答えが変わるため、同じ条件で試算を依頼します。
Prometheusは無料で導入できますか?
Prometheus本体はOSSで、ライセンス購入費なしで利用できます。ただし、設計やサーバー、ストレージには費用がかかります。計装や画面、通知、セキュリティ、保守も費用の対象です。
マネージドサービスでは、従量課金の仕組みも確認します。課金の対象は、samples、active series、クエリ、保存、Collectorなどです。
PrometheusとGrafanaは一緒に発注する必要がありますか?
一緒に発注しなくても進められます。Prometheusで収集・保存・検索し、Grafanaで可視化する構成は一般的です。
Prometheusの画面や別のツールを使う方法もあります。ただし、ダッシュボードや権限、通知、既存資産の移行まで考えるなら、両方の経験がある委託先に相談すると比べやすくなります。
Prometheusの発注費用はどのくらいですか?
小規模PoCは50万〜200万円程度、小〜中規模の本番導入は200万〜600万円程度という、記事用の推定レンジです。
HAや複数クラスタ、長期保持、業務アプリ計装、24時間対応を含むと、500万〜1,500万円程度またはそれ以上になる可能性があります。
対象数や収集間隔、保持に加え、アラートやセキュリティ、保守も見積もりに含めます。全国一律の相場ではありません。
委託先を選ぶときに最も重要な確認項目は何ですか?
技術構築だけでなく、業務指標やアラート対応、セキュリティ、費用管理、引き継ぎまで説明できることです。
構成図や障害シナリオ、見積内訳を確認します。納品物や保守SLA、ソースや設定の所有権、データ持ち出しも確認します。そのうえで、実際の担当者とも話します。
まとめ:運用まで見据えたPrometheusの発注
発注前に確認する目的・費用・責任分界
OSSだから無料と考えず、体制全体を一つの設計として見ます。収集や保存、検索、可視化に加え、通知やセキュリティ、保守も含めます。
業務上守りたいSLOを決め、監視対象とメトリクスを一覧にします。そのうえで、PoCにより計測品質とアラートの有効性を確かめます。
導入後の定例によるアラートと料金の改善
RFPから運用改善まで、発注条件と責任の境界を一貫して管理します。
- RFP:量、ラベル、間隔、保持、クエリ、所在地、SLA、納品物の明示
- 見積・選定:工程、工数、単価、従量費、保守の区分と、実績の比較
- 契約・引き継ぎ:責任分界、設定・コード・画面・手順書の納品
- 導入後:通知、カーディナリティ、利用状況、料金の定例での見直し
委託先は、PromQLだけでなく、アプリやクラウド、セキュリティの実績で比べます。障害対応や引き継ぎの実績も、あわせて確認します。
運用の定例改善を続けると、Prometheusを障害の早期発見や業務影響の縮小に役立てやすくなります。
▼全体ガイドの記事
・Prometheusのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。