
Prometheusのシステム開発は、監視対象、収集量、保持期間、運用体制によって、構成も運用の負担も変わります。
構成、導入方式、進め方、費用、開発会社の選び方の順に要点を押さえます。各テーマの詳細は、下の関連記事でご覧いただけます。
▼関連記事一覧
・Prometheusのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Prometheusのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Prometheusのシステム開発の見積相場や費用/コスト/値段について
・Prometheusのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Prometheusのシステムの概要
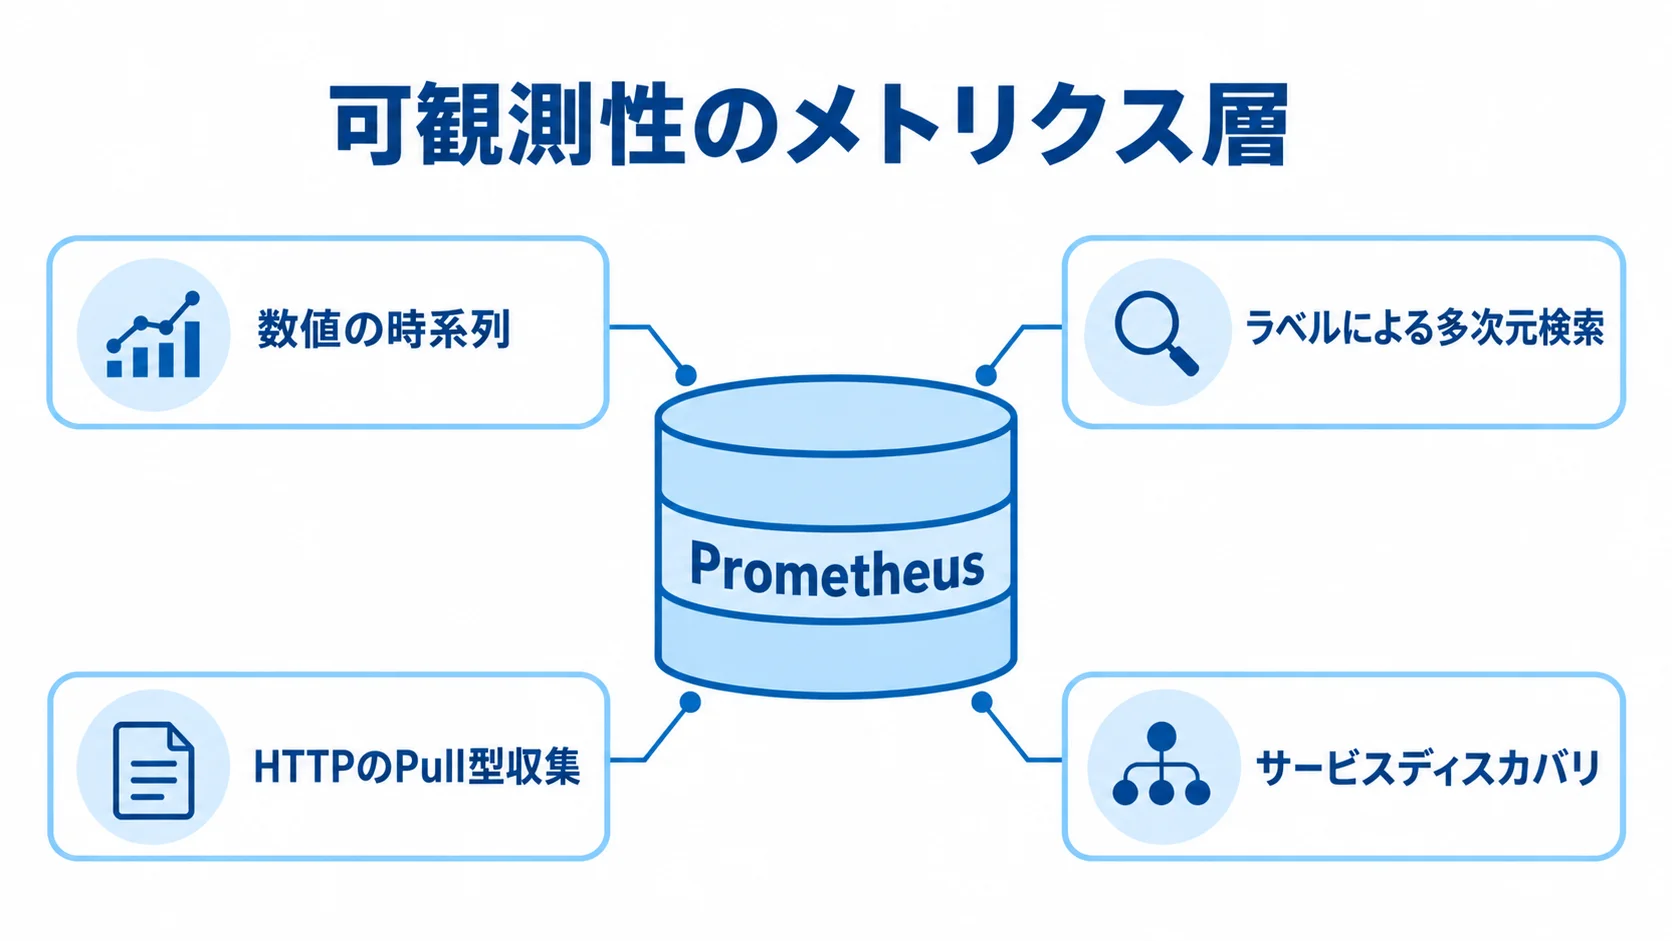
Prometheusは、監視対象のメトリクスを一定間隔で取得し、時系列データとして保存する仕組みです。保存したデータは、PromQLで集計し、記録ルールやアラートルールで傾向と異常を判断できます。
Prometheusは、業務システムの安定稼働を支える可観測性のメトリクス層です。販売管理や会計のように取引明細を処理する業務システムとは、役割が異なります。
公式Overviewは、数値の時系列、ラベルによる多次元検索、HTTPのPull型収集、サービスディスカバリを特徴に挙げています(出典: Prometheus公式Overview、2026年8月6日確認)。
業務システムではなく監視基盤
Prometheusが記録するのは、リクエスト数、エラー数、処理時間、キューの長さ、メモリ使用量などです。一方で、請求書の明細や注文履歴のように、1件ごとの完全性が求められるデータの保存には向きません。
決済成功率の監視には使えますが、課金額の確定や取引証跡の原本管理は任せない設計にします。
向いているシステムと向いていないシステム
監視対象と合うかは、データの性質と必要な分析方法を見て決めます。
- 数値の横断分析:サービス名や環境名のラベルを使い、まとめて集計できます。
- 既存環境:オンプレミスや社内業務アプリも、Exporterやアプリ計装で監視対象に含められます。
- ログ・原本管理:数値化しにくい業務状態、ログ全文検索、監査証跡の原本は、別基盤と分担します。
マイクロサービス、コンテナ、Kubernetes、クラウド、仮想マシンが混在する環境でも、分析できます。
Prometheusのシステム構成と各コンポーネントの役割
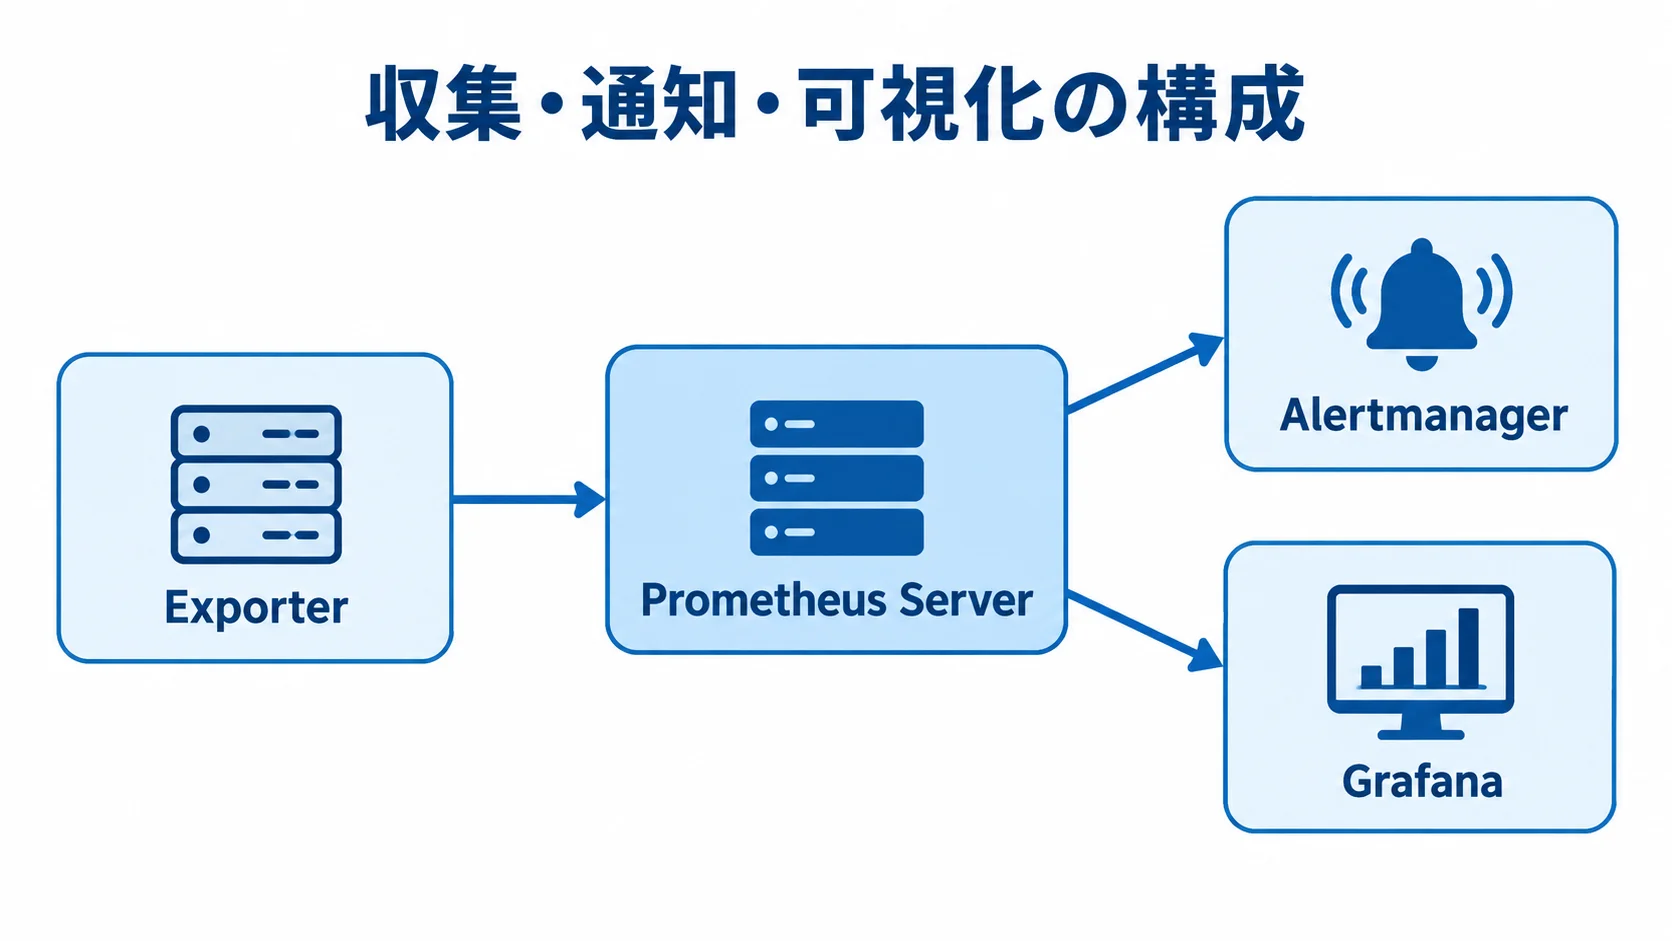
まず、アプリやExporterがメトリクスを公開し、Prometheus Serverがそれを取得して、ローカルの時系列DBに保存します。次に、PromQLやルールの判定結果をもとに、Alertmanagerが重大度やサービス単位で通知します。また、Grafanaなどの可視化ツールは、Prometheusに保存されたデータをグラフやダッシュボードで表示します。
ServerとExporterによるメトリクス収集
Serverは、監視対象のHTTPエンドポイントにアクセスして、メトリクスを取得します。
- Node Exporter:OSのCPUやディスクの測定。
- 各種Exporter:Kubernetes、データベース、Webサーバーの監視。
- 自社アプリ:クライアントライブラリやOpenTelemetry Collectorによる計装。
アプリ側では、リクエスト数、エラー数、処理時間などを計装します。また、既存製品は大きく改修せず、監視範囲を広げられます。
Alertmanagerと可視化ツールによる運用への接続
アラートルールには、エラー率が一定値を超えた場合や、処理遅延が一定時間続いた場合などを定義します。Alertmanagerは、通知をまとめ、低優先度の通知を抑え、担当チーム別に振り分けます。
重大度、環境、サービス、担当者のラベルを付けておくと、初動に役立ちます。通知先は、メール、チャット、オンコールサービスから選べます。
Prometheusでもクエリ結果は確認できますが、日常の運用では、可視化ツールのダッシュボードを使うのが一般的です。
通知先や可視化ツールの役割は、次のように整理できます。
- Prometheus:収集・保存・検索・ルール評価を担います。
- Grafana:主にグラフやダッシュボードで可視化します。
PrometheusとGrafanaを一つの製品のように扱うと、責任範囲を誤りやすくなります。そのため、ライセンスと権限、バックアップと更新の役割を分けて扱います。
Prometheusのシステムの種類と選択肢
導入方式は、自社運用、パッケージ、マネージドサービス、個別開発に分けられます。自社運用は単一環境で行い、パッケージはKubernetes用のチャートなどを使います。マネージドサービスには長期保存・冗長化が含まれ、個別開発は既存接続を対象にします。
まずは小さく始め、監視対象数とメトリクス量を測ってから拡張すると、費用と運用負荷を抑えられます。
自社運用型の自由度と運用責任
自社運用型は、Server、Exporter、Alertmanager、可視化ツールを自社の環境に配置する方式です。
- 制御:ネットワーク、保存先、認証、データの持ち出しを自社で調整できます。
- 費用:ライセンス費を抑えやすい方式です。
- 運用:冗長化、容量、バックアップ、更新、復旧まで自社の担当になります。
監視基盤そのものが障害時の参照先になるため、業務システムと同等以上の復旧手順を準備します。
パッケージ型の標準構成と導入の始めやすさ
Kubernetesでは、Prometheus関連のコンポーネントをまとめたHelmチャートなどを利用できます。Exporterや標準ダッシュボードも一度に導入できるため、検証を始めやすいのが利点です。
ただし、標準アラートが業務SLOに合うとは限りません。そのため、不要なメトリクスや優先順位を見直し、バージョン固定とロールバックも調整します。
マネージド型と周辺の個別開発の組み合わせ
マネージドサービスを使うと、クラウド上の運用負荷を下げられます。また、Prometheus本体は再実装せず、個別開発の範囲を限定します。
- マネージド型:長期保存、複数クラスタ検索、冗長化、容量拡張、更新の一部を任せられます。
- 課金単位:取り込みsamples、active series、クエリ量、保持期間はサービスごとに異なります。
- 複数環境:PromQL互換性、Remote Write、ダッシュボード移行性、データ所在地の比較。
- 個別開発:計装、特殊Exporter、チケット・通知、KPI表示、テナント権限、マスキングへの絞り込み。
独自機能が増えすぎると、担当交代や製品更新時に保守が難しくなります。そのため、標準機能との境界を設計書に明記しておきます。
Prometheusのシステム開発・導入の進め方
導入では、計測対象、異常時の担当者、データ保持期間を先に決めておきます。そのうえで、小規模なPoCから本番へ移し、計測量と運用実績を根拠に構成を広げていきます。
要件定義、技術検証、本番移行の順に進めれば、技術検証の結果を経営や現場の判断につなげられます。
▶ 詳細はこちら:Prometheusのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
要件定義での監視目的とSLOの設定
障害を検知したい対象と業務への影響を整理し、その対象に応じた指標を決めます。
- Webサービス:リクエスト数、エラー率、応答時間、DB接続数。
- 業務システム:注文成功率、決済エラー率、在庫遅延、バッチ時刻、キュー滞留数。
CPUが正常でも、注文処理は止まることがあります。そのため、技術メトリクスだけでなく業務KPIも定義しておく必要があります。
アラートでは、閾値や継続時間、重大度を決めます。そのうえで、通知先と時間外対応、復旧確認も決めておきます。たとえば、決済サービスの本番環境でエラー率が5%を超え、5分間続いた場合は当番へ通知します。
RTO、RPO、許容遅延、保存期間、同時クエリ数も、非機能要件に記載します。
PoCでのメトリクス設計とアラート品質の検証
PoCでは、代表的な対象を選び、計測の設計と通知後の対応を検証します。
- 対象選定:開発・ステージングから数台〜数十台程度を選び、Exporterと計装を入れる。
- 測定対象:RED(Rate・Errors・Duration)またはUSE(Utilization・Saturation・Errors)の観点で整理。
- 設計確認:メトリクス名、単位、ラベル、欠損時の扱い、ダッシュボード利用者の確認。
- 障害検証:障害を起こし、検知、通知、担当者の確認、復旧判定まで実測する。
検証の結果をもとに、通知の必要性を見直します。さらに、高カーディナリティや短すぎる収集間隔、不要な指標を削ります。
本番移行後の運用と改善の定着
本番では、設定管理と復旧準備、定期改善、運用ルールを整えます。
- 設定管理:コードで管理し、版、変更者、承認者、ロールバック方法を追跡する。
- 復旧準備:停止時の代替確認、容量対応、バックアップからの復旧時間の点検。
- 定期改善:月次または四半期ごとに、アラート、誤検知、未対応時間、利用状況、メトリクス量を見直す。
- 運用ルール:異動やサービス追加に備えて、命名規則とレビュー手順を決める。
担当者が自力で調査と復旧を行える状態を、導入の完了と考えます。加えて、Prometheus本体からExporter、Alertmanager、ダッシュボード、通知連携まで、更新計画も作ります。
Prometheusのシステムの費用相場とコストの内訳
Prometheus本体はApache 2.0ライセンスのOSSなので、ライセンス購入費はかかりません。
ただし、要件定義や設計、計装には費用が発生します。Exporterやダッシュボード、通知の整備に加え、インフラやセキュリティ、保守にもコストがかかります。
「無料」が指すのは、ソフトウェアの利用料だけです。総保有コストまで無料になるわけではありません。
▶ 詳細はこちら:Prometheusのシステム開発の見積相場や費用/コスト/値段について
▶ 詳細はこちら:Prometheusのシステム開発の発注/外注/依頼/委託方法について
初期費用の目安と規模・設計範囲による違い
初期費用は、検証か本番か、監視対象と設計範囲がどこまで広がるかで段階が分かれます。段階ごとの金額と導入期間は、下の箇条書きで確認できます。
- 検証・小規模PoC:50万〜200万円程度。
- 小〜中規模の本番:200万〜600万円程度。
- 複数クラスタ等:高可用性・長期保存込みで500万〜1,500万円程度。
- 大規模構成:大規模業務指標、複数リージョン、24時間運用、監視統合を伴い、1,000万〜3,000万円超の場合もあります。
- 導入期間:PoCは2〜6週間、本番1〜3カ月、複数クラスタ等は3〜6カ月程度。
この数字は、ノード数、メトリクス量、保持期間、通知要件をもとに置いた推定で、全国統計ではありません。
計装やネットワークの変更、権限審査、24時間運用の引き継ぎがあると、期間は延びます。なお、見積書は工程ごとに分け、工数と単価を確認します。
工程は、要件定義から設計、計装、構築を経て、テスト、移行、教育、保守の順に並べます。
月額費用とsamples・active seriesの影響
自社運用では、基盤費と保守費がかかります。基盤費には、サーバーやバックアップ、通信に加え、可視化や通知、人件費などが含まれます。一方、マネージド型は計測量などによって費用が変わります。
- 小規模:インフラ費は月1万〜10万円程度。
- 小〜中規模:月5万〜30万円程度が仮置きの目安。
- 複数クラスタ等:長期保持・冗長化を含み月30万〜150万円程度。
- 年間保守:初期開発費の15〜20%程度が目安。
- マネージド型:samples、active series、保存量、クエリ量、Collector稼働時間を単位に課金。
保守費は、脆弱性対応やオンコール、SLAの範囲によって変わります。
公式例では、10ノードが各1,000メトリクスを30秒間隔で744時間収集します。この条件で、取り込み・保存・クエリは月81.75ドル、Collector込みでは月113.47ドルです。
別の例では、100コンテナが1,000時系列を15秒間隔で送ると月1,051.20ドル、60秒間隔なら月262.80ドルです(出典: 主要マネージドサービス公式料金ページ、2026年8月6日確認)。
コストを抑える収集設計の見直し
メトリクス名とラベルの組み合わせ1つが、1本の時系列にあたります。
- 避ける値:ユーザーID、注文番号、リクエストID、URL全文。
- 有限の分類:service、environment、region、status_code、operation。
- 集約:必要に応じて記録ルールで集計データを保存する。
値が無制限に増えるラベルは、active seriesとメモリを増やします。さらに、個人情報や機密情報の混入にもつながります。
次に、秒単位で検知したい指標と、数分単位でよい指標を分けて、収集間隔を設計します。
保持期間、利用者、クエリ範囲、ヒストグラムのバケット数を定めて、月次の使用量を確認します。
料金は、為替やリージョン、無料枠、契約条件によって変わります。そのため、1ドル=150円は試算であり、発注前に公式価格で再計算します。
Prometheusの開発会社・サービスの選び方
選定では、PromQLの対応だけでなく、計装やKubernetes、ネットワーク、認証、SRE運用、障害対応まで確かめます。
知名度だけで決めると、通知漏れや未使用のダッシュボード、想定外の費用につながることがあります。そのため、提案内容と検証の結果から、自社の業務影響や運用体制との適合性を判断します。
構成と検証内容による技術力の確認
見積もりや技術検証、サービス条件を確認して、提案が自社に合うかを判断します。
- 見積もり:対象、指標数、間隔、保持、通知要件を渡し、時系列数と費用の算出法を聞く。
- 設計・試験:ラベル、欠損・遅延、記録ルール、アラート、負荷、復旧の確認。
- アプリ計装:言語対応ライブラリ、テスト方法、リリース時の互換性の評価。
- サービス比較:PromQL、Remote Write、再利用性、保持、横断検索、所在地、削除、SLA、サポートの確認。
- 料金内訳:取り込み、保存、クエリ、可視化、ログ・トレース、Collector、通信費の区分。
契約終了時にデータや設定を持ち出せるかも確認しておくと、将来の選択肢を残せます。
納品物と保守範囲の契約前の確定
成果物と保守条件は契約前に明記し、引き継ぎできる状態にしておきます。
- 設計・設定:要件書、対象一覧、メトリクス・ラベル、構成図、設定、ルール、ダッシュボード。
- 運用資料:テスト仕様、障害対応、復旧手順、教育資料。
- 個別開発:ソース、ビルド手順、ライセンス、変更履歴。
- 保守範囲:営業時間、一次回答、復旧目標、脆弱性、更新、容量、改修、月次報告、オンコール。
特に、担当会社の環境にしか設定が残らない契約は、引き継ぎ時のリスクになります。
初期費用の10〜20%という保守費の目安だけでなく、作業時間と対応水準も確かめます。同じ前提で複数社から見積もりを取り、「一式」の金額だけで比べないようにします。
提案依頼時に確認する質問
提案時には、運用、情報管理、規模変化、移行条件を確認します。
- 運用:検知後の担当者と対応時間、KPIの計装方法は明確か。
- 情報管理:ラベルに個人情報や秘密情報が混入しないか。
- 規模変化:時系列数が倍になった場合の料金と性能はどう変わるか。
- 継続性:通知失敗時の代替経路、既存資産の再利用、解約時の持ち出しは可能か。
回答が抽象的な場合は、小さな検証を依頼します。たとえば、欠損や通知の重複、権限、表示速度、通知時間を実測してもらいます。
▶ 詳細はこちら:Prometheusのシステム開発でおすすめの開発会社/ベンダー6選と選び方
セキュリティ対策と導入時に多い失敗
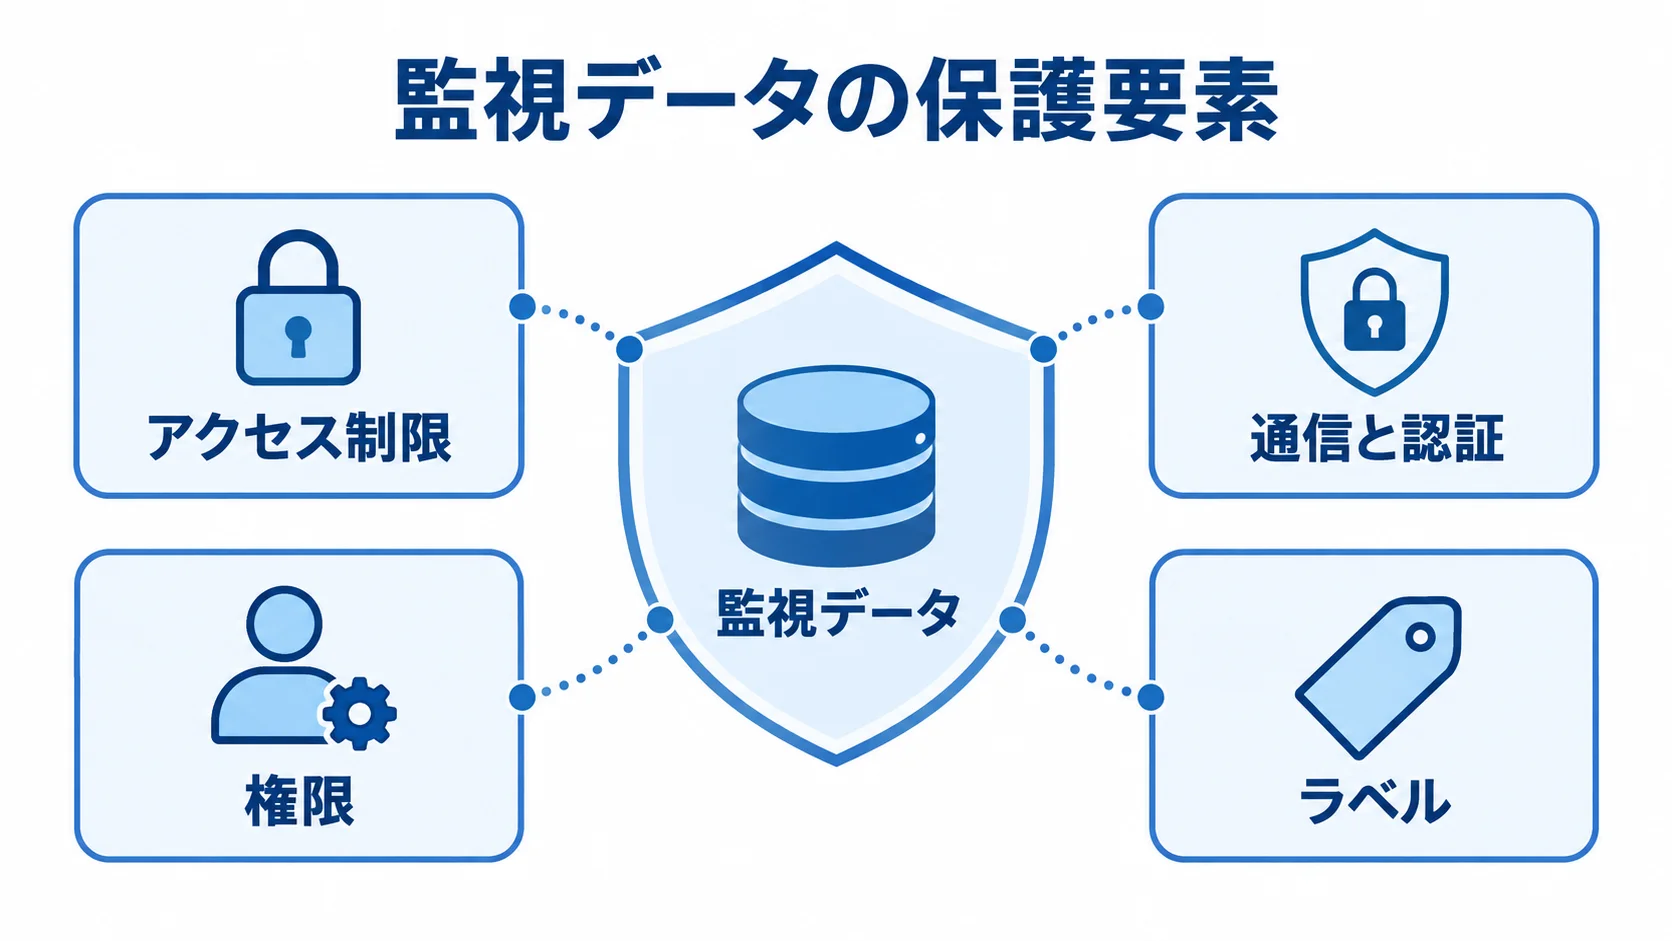
監視データには、サービス名やホスト名、URL、利用者識別子、障害状況が含まれることがあります。
公式のセキュリティモデルは、/metrics、API、pprofを公開せず、TLSや認証を使い、管理APIを不用意に有効化しないよう示しています(出典: Prometheus公式Security model、2026年8月6日確認)。
ネットワーク・権限・秘密情報の分離
アクセスや通信、API、閲覧権限、ラベル値は、それぞれ分けて管理します。
- アクセス制限:閉域網や踏み台を使い、接続元を絞る。
- 通信と認証:TLSを使い、認証情報を設定やダッシュボードに不用意に書かない。
- 管理API:必要なときだけ有効にし、プロキシやネットワークACLでも保護する。
- 権限:閲覧と任意のPromQL実行を分け、他部署データや高負荷クエリの確認。
- ラベル:ID、メール、注文番号、URLパラメータ、トークンを避け、業務分類に変換する。
アラート過多と業務KPI不足の防止
通知の質と業務指標を見直し、障害時に役立つ監視に調整します。
- 通知過多:標準アラートを一斉に有効化すると、重要な通知を見落とすことがあります。
- 通知調整:重大度、継続時間、担当を決めたうえで、実際の障害で通知経路を試す。
- 改善運用:誤検知と未対応時間を記録し、不要なアラートを削る。
- 業務指標:注文成功率、決済失敗率、在庫遅延、バッチ時刻の監視。
CPUやメモリだけでは、業務処理の停止を検知できない場合があります。そのため、指標を増やしすぎず、障害時の判断を変えるものから優先します。
高カーディナリティと長期保持の後付けの回避
ラベル値や保存要件を早めに設計して、性能と費用の急増を防ぎます。
- ラベル値:リクエストIDやURL全文は、時系列を増やして性能や料金を悪化させる。
- 増加対策:本番拡大の前に値をレビューし、集約やログへ分離する。
- 保存期間:障害調査、傾向分析、監査・法令で必要な期間を分けて考える。
- 長期保存:Remote Write等も検討し、出力、削除、リージョン、復旧時間を決める。
特に、数年分の保存を後から求められると、保存方式や費用の変更が大きくなります。
Prometheusのシステムに関するよくある質問
Prometheusは、Exporter、Alertmanager、可視化、長期保存、通知体制を組み合わせて利用します。
Prometheusは無料で利用できますか?
本体はOSSなので、ライセンス購入費なしで利用できます。一方で、サーバーとストレージ、通知と計装、設計と保守には費用がかかります。
マネージド型は、samples、active series、保存、クエリなどの従量課金を含めて見積もります。
PrometheusとGrafanaは何が違いますか?
Prometheusは、収集や時系列保存、PromQL検索、記録・アラートルールを担います。一方、Grafanaはデータソースに接続し、グラフやダッシュボードで可視化します。
両者は役割が違うものとして扱い、採用や権限、バックアップ、更新の責任を分けます。
PrometheusはKubernetes専用ですか?
Kubernetes以外にも、仮想マシンやオンプレミス、DB、ネットワーク機器、業務アプリが監視対象になります。
Exporterや計装を使い、複数環境のラベル、Remote Write、権限、所在地をそろえます。
開発会社へ依頼するとき何を準備すればよいですか?
まず、監視対象と環境数、ノード・コンテナ数を整理しておきます。未確定の事項はPoC計測と本番要件に分け、業務指標とセキュリティ要件も用意します。そのうえで、データの取り方と扱いも決めておきます。
- 指標:何を測るか。
- 間隔:データを集める間隔。
- 保存期間:データを残しておく期間。
- 通知先:アラートを受け取る相手。
要件書や設計書、設定について、納品の範囲を確認します。
- ダッシュボード:可視化の画面。
- テスト結果:検証で得た記録。
- 運用手順:日々の対応の手順。
- ソース:プログラムの本体。
まとめ
Prometheusは数値指標を収集・保存し、PromQLやルール、Alertmanager、可視化を通じて障害対応につなげます。
Grafanaの役割分担、業務KPI、ラベル、収集間隔、保持期間の設計が、現場で使える監視を支えます。
導入判断での監視体制全体の比較
まず、OSSにするかマネージド型にするかを決め、設計、通知、復旧の担当や、保存期間と費用も定めます。そのうえで、PoCで高カーディナリティと通知品質を試し、必要であれば可用性や長期保存を加えます。
会社選びでは、PromQLに加えて、計装、セキュリティ、運用、引き継ぎの実績を確認します。
Prometheus導入の目的と復旧できる体制
目的は、異常を早く見つけて業務影響を抑え、担当者が情報をもとに復旧できる体制をつくることです。費用や性能、セキュリティ、運用を要件に落とし込み、アラートと指標を見直します。
▼関連記事一覧
・Prometheusのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Prometheusのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Prometheusのシステム開発の見積相場や費用/コスト/値段について
・Prometheusのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。