
Prometheusのシステム開発は、要件整理から始めて、方式の選定、設計・開発、テスト、稼働、運用の定着へと進みます。この6段階の流れで進めると、業務への影響を捉えて復旧できる体制につながります。
全体像は、Prometheusのシステム開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・Prometheusのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Prometheusのシステムの全体像
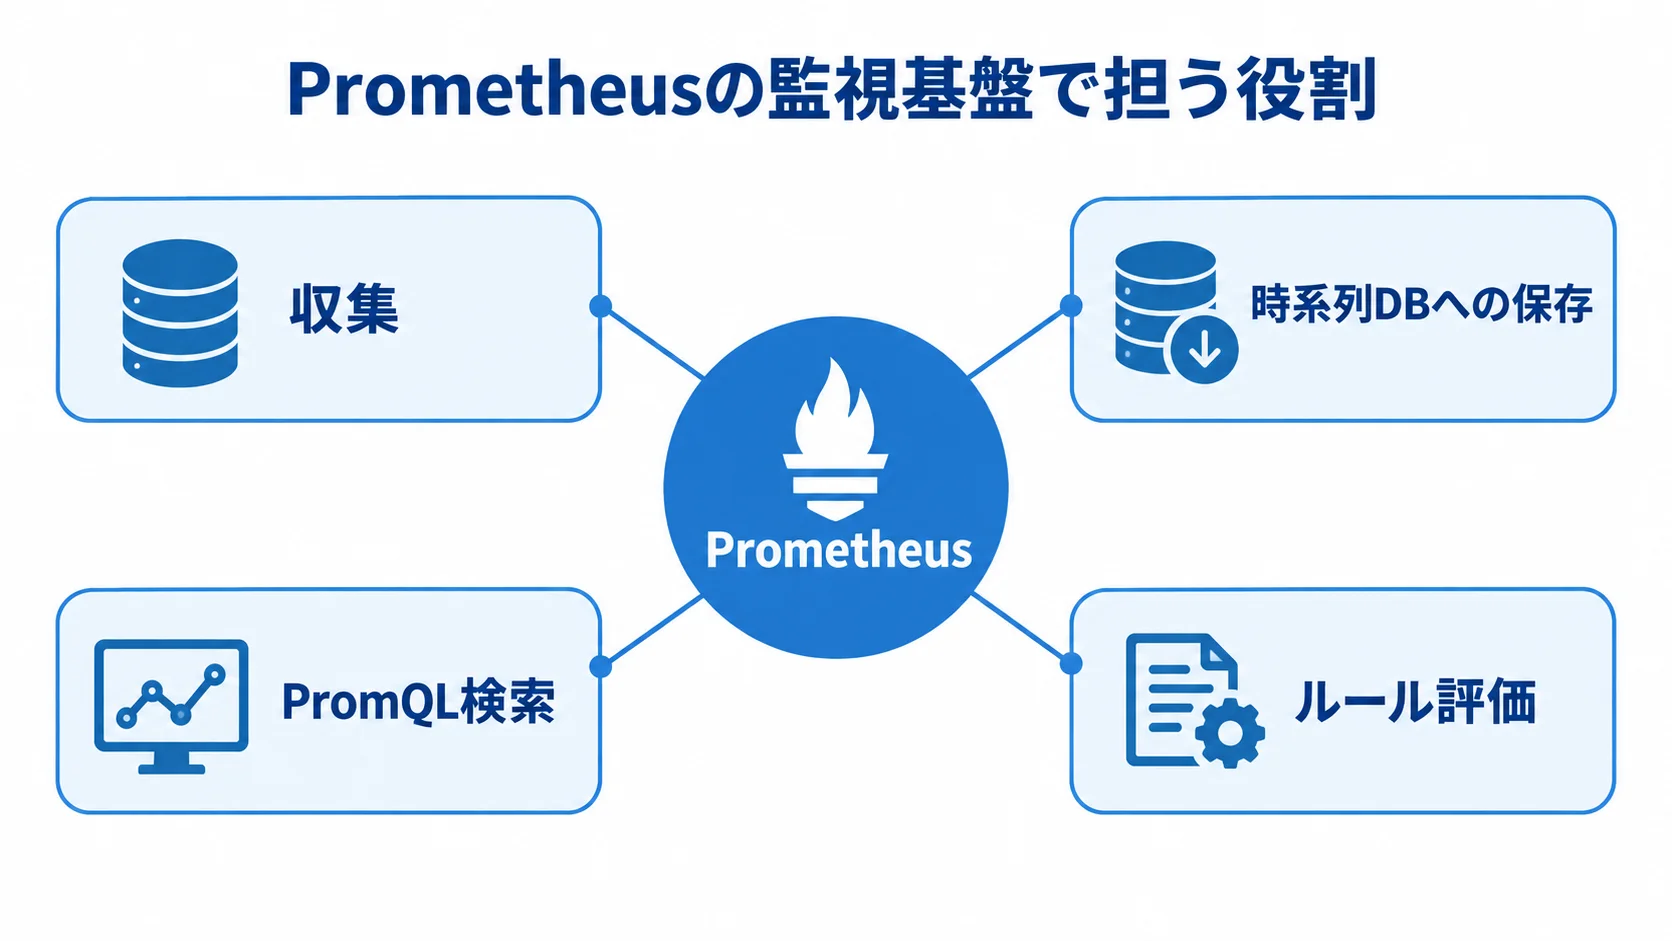
Prometheusは、サーバーやコンテナ、Kubernetesなどが出す数値メトリクスを収集する監視基盤です。ミドルウェアやアプリの値も対象になり、集めたデータは時系列データとして保存・検索し、通知にも使います。
ここでいうPrometheusは、Prometheus Groupなどの設備保全製品ではなく、CNCFがホストするオープンソースの監視基盤です。公式ドキュメントでは、メトリクス名とラベルで時系列を識別し、PromQLで集計すると説明されています。また、通常はHTTP経由のPull方式で収集します(出典: Prometheus公式「Overview」、2026年8月確認)。
Prometheusの役割とGrafanaとの違い
監視の要件は、ツールごとに役割を分けて書き出すと、担当範囲がつかめます。
- Prometheus:収集、時系列DBへの保存、PromQL検索、ルール評価を担います。
- AlertmanagerとGrafana:通知の振り分けと、データの画面表示。
- 標準構成:Exporterが公開した値をPrometheusが収集・加工し、通知と可視化に進みます。
- 追加構成:短命のバッチにはPushgateway、長期保存にはRemote Writeを使えます。
- 導入範囲:監視設計はPrometheus、見やすい画面はGrafanaが受け持つため、両方を組み合わせて考えます。
業務システムでのインフラと業務KPIの監視
CPUやメモリだけを見ていると、注文処理やデータ連携の停止を見逃すことがあります。サーバーが稼働していても、業務が止まる場合があるためです。
- EC:注文受付の成功率、決済エラー率、在庫同期の遅延を測ります。
- 基幹連携:バッチ完了時刻、キューの滞留、API応答時間が指標になります。
指標は、業務部門が「数値が悪化すると何が止まるか」を説明できるものから選びます。
請求額のように一件ごとの完全性が求められる台帳には、Prometheusは向きません。公式でも、100%の正確性が要るリクエスト単位の課金データには、別の収集・分析基盤を使う考え方が示されています。
そのため、最初の設計判断として、監視用の集計値と業務記録の明細を分けます。
OSS・パッケージ・マネージドの選び方
自社運用とマネージドでは、構築と保守の担当範囲が異なります。まず必要な運用要件を整理し、そのうえで選びます。
- 小規模な検証:Prometheus、Alertmanager、Exporter、GrafanaのOSS構成が候補です。
- Kubernetes:Helmチャートで導入を早められますが、SLOや通知体制との適合を確認します。
- 自社運用:バージョン固定、コード管理、更新、ロールバック、バックアップを、誰が担当するかを決めます。
- マネージド:複数クラスタ、長期保持、冗長化、クラウド横断検索の場面で比べます。
- 運用設計:ラベル、アラート品質、権限、通知後の対応は、ツールが自動で整えてくれるものではありません。
候補には、Amazon Managed Service for Prometheusがあります。さらに、Google Cloud Managed Service for PrometheusやAzure Monitor managed service for Prometheusも候補です。また、Grafana Cloudも比較できます。
Prometheusのシステム開発の進め方と6フェーズ
開発は、監視ツールの導入順ではなく、業務目的から運用の定着までを一続きにとらえて進めます。進め方は6段階で、要件整理から始めて、方式を選び、設計・開発を行い、テストと稼働を経て、定着で締めくくります。各段階の成果物を残しておくと、担当者が替わっても、メトリクスや通知を設けた理由を説明できます。
1. 要件整理:監視で守る業務と目的
目的を「障害を見つける」で終わらせず、業務への影響を何分以内に検知するかを、業務部門とともに決めます。あわせて、誰がどの手順で復旧するかも具体的にしておきます。
決済APIならエラー率とレイテンシ、夜間バッチなら完了時刻と処理件数を要件に含めます。Kubernetesでは、Pod再起動数とDeploymentの状態も対象になります。
対象システム、環境、利用者、営業時間、障害の重大度を一覧にします。そのうえで、復旧目標時間(RTO)、許容データ損失(RPO)、保持期間も書き添えます。
- 業務要件:サービスオーナー、重要業務、SLO、測定単位とその意味を決めておきます。
- 判定と対応:異常と判定するまでの継続時間、一次対応者、エスカレーション先。
- 連絡と情報:営業時間外の連絡方法と、機密情報をラベルに入れないルール。
- 権限と保管:保存地域とアクセス権限を確かめます。
夜間の通知先に対応者がいるかを確かめておかないと、アラートが届いても復旧にはつながりません。
2. 選定:自社運用とマネージドサービスの比較
候補は、自社運用のOSS、マネージドPrometheus、統合オブザーバビリティ製品です。費用と運用条件も、同じ前提で比べます。
- クラウド固定:IAM、ネットワーク、Kubernetes連携を優先して見ます。
- マルチクラウド:PromQLやGrafanaの資産を再利用できるか、データ所在地、移行のしやすさ。
- 運用要員が限られる場合:更新、容量拡張、障害サポートの範囲も評価に入れます。
- 見積もり比較:候補を3社程度に絞り、同じ前提で月額と増加時の単価を並べます。
課金単位は製品ごとに異なり、ノード数のほか、samplesやactive seriesが費用を左右します。データポイント数、クエリ量、保持期間、Collector稼働時間も、費用に効く要素です。
見積もりを依頼する際は、対象数、メトリクス数、収集間隔、保持期間、月間クエリ量を開発会社に渡します。
3. 設計・開発:ラベル、収集、通知の実装
設計・開発では、収集対象から通知の経路までを一貫して決めます。
- 監視設計:対象、命名規則、ラベル値、収集間隔、保持期間、記録・アラートルールを決めておきます。
- ラベル:集約には有限の値を使い、ユーザーIDのように無制限に増える値は避けます。
- 計装:既存Exporterで基盤を測り、アプリにはRED(Rate・Errors・Duration)や業務KPIを組み込みます。
- 画面と納品:SLOや遅延を追える画面の作成と、独自開発物を含む納品範囲の決定。
たとえば、serviceやregionなどは、集約に使う有限の分類です。一方で、ユーザーID、注文番号、リクエストID、URL全文は時系列数を急増させます。それが、メモリやストレージ、クラウド料金、クエリ性能にも影響します。
既存のExporterには、Node Exporterやkube-state-metricsがあります。画面は、担当者が最初の5分で状況を把握できる構成にします。全体SLO、エラー率、遅延を含め、依存先と直近のデプロイも追えるようにします。
独自のExporterやチケット・チャット連携を作る場合は、ソースコードや設定ファイル、テスト仕様書、運用手順も納品範囲に含めます。
4. テスト:異常時の通知と復旧の確認
メトリクスの収集だけでなく、異常の検知、担当者への通知、復旧後のアラート解消まで確かめます。
- 異常検知:CPU・ディスクの閾値、5xx、遅延、Pod再起動、Exporter停止を試します。
- 障害時の通知:Prometheus停止、通知先の障害、ネットワーク分断、クラウドAPIの失敗を想定します。
- アラート条件:継続時間、重大度、担当、エスカレーション、復旧、誤検知抑制の各条件の動作を確かめます。
- 基盤の確認:promtool、クエリ、負荷時の取りこぼし、保存容量、権限を確認します。
テストの結果と未解決の既知問題は一覧にし、運用を始めてよいかを判定する人を明確にします。
5. 稼働:小さな範囲から本番への段階移行
本番稼働は、影響の大きいサービスと少数の環境から始めます。その後の判断は、実測した結果をもとに行います。
- 段階導入:全システムを一度に監視せず、対象を絞る形にします。
- 初期計測:最初の1〜2週間で、通知と復旧の時間、誤検知、未通知、画面の利用を測ります。
- 運用調整:担当者の利用を確かめ、閾値や通知先を調整してから、対象を広げます。
- 構成拡張:実測量と運用負荷をもとに、HAなどへ移行する条件を決めます。
移行の契機には、クエリ遅延、複数クラスタの横断検索、監視基盤そのものを失うリスクの上昇があります。移行先としては、HA構成、フェデレーション、Remote Write、マネージドサービスが挙げられます。
6. 定着:アラートを業務改善につなげる運用
定期的な振り返りと引き継ぎによって、通知を受けたあとに対応できる状態を保ちます。
- 定期確認:週次または月次で、上位の原因、未対応時間、誤検知、重複通知を振り返ります。
- ルール改善:長期サイレンスや画面の閲覧状況を見て、不要なルールを削除します。
- 障害後の更新:検知の遅れや過剰な通知が業務影響とどう結びついたかを踏まえ、SLOとアラートを改めます。
- 引き継ぎ:設定、画面、ルール、ラベル規約、変更・復旧手順、連絡網を、次の担当者と共有します。
ランブックには、通知を受けたあとに見る画面と連絡先を記録しておきます。こうしておくと、担当者の退職や組織変更のあとも運用を続けられます。
Prometheusのシステム開発にかかる費用相場と内訳
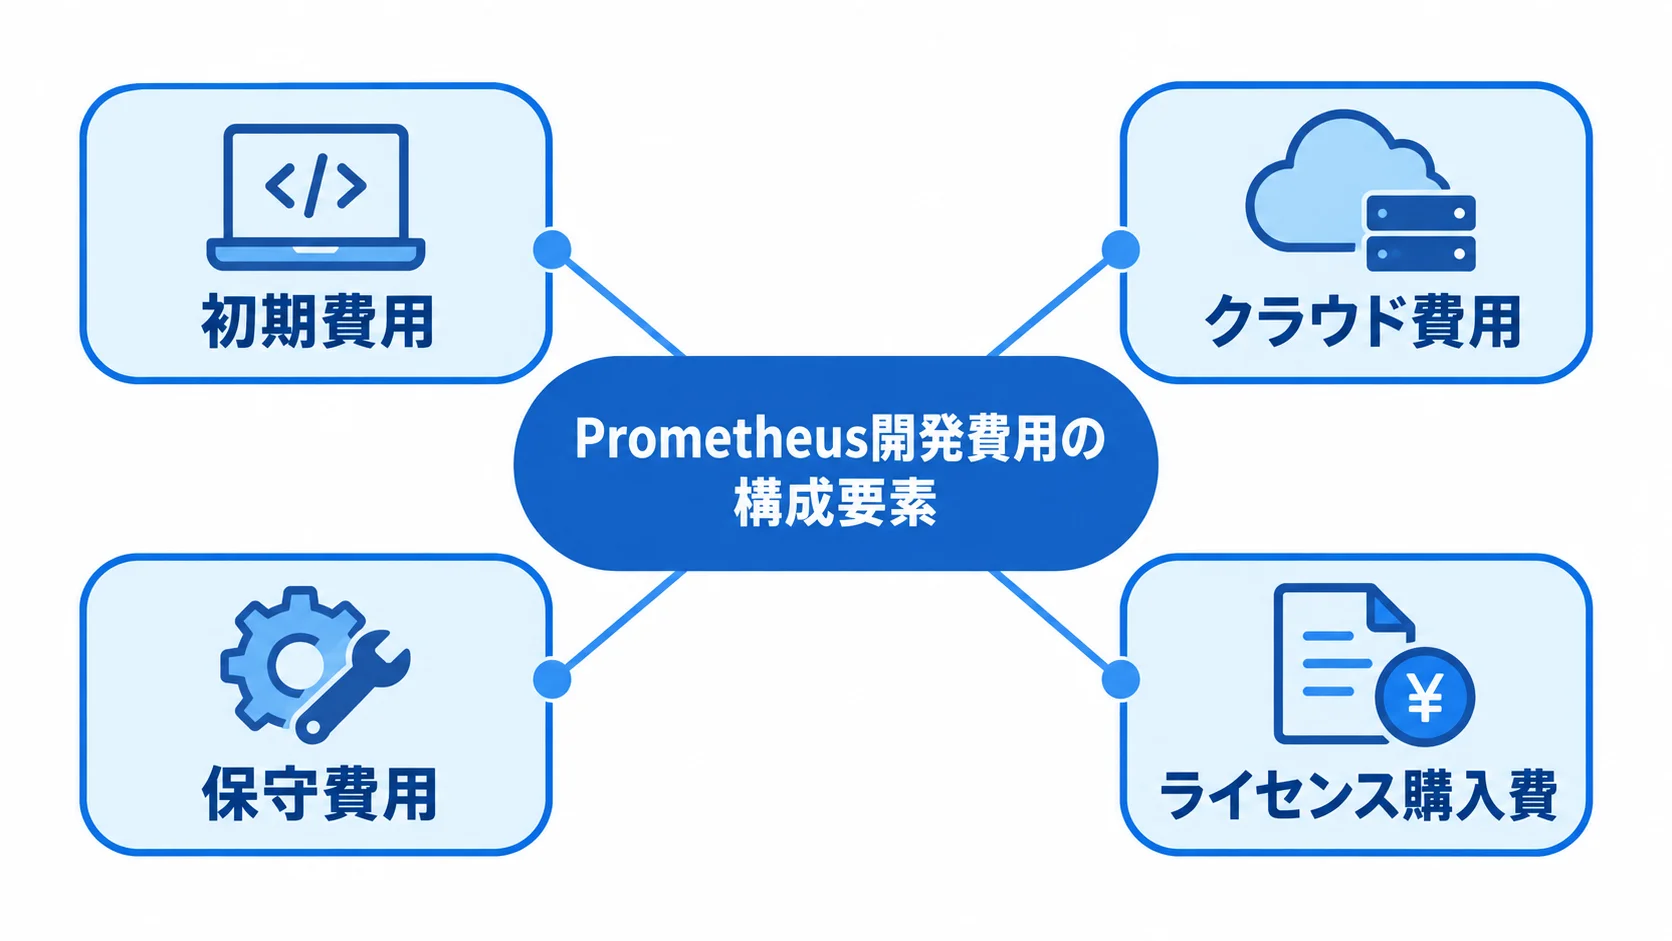
Prometheus本体はApache 2.0ライセンスのOSSで、ライセンス購入費はかかりません。
要件整理、アプリ計装、Exporter、クラウド基盤には費用がかかります。また、画面、通知設計、テスト、教育、保守にも費用がかかります。
ここで示す自社運用費は、Prometheus単体の全国統計ではありません。対象規模と一般的な監視基盤の作業量から置いた、記事用の推定レンジです。
初期費用の幅:50万円〜3,000万円超
金額は規模と構成によって変わるため、対象の条件ごとに推定レンジを確認します。
- 小規模PoC:1環境、数台〜数十台、既存Exporter、基本ダッシュボードで50万円〜200万円程度です。
- 小〜中規模本番:複数サービス、アラート運用、権限、バックアップ、引き継ぎを含め200万円〜600万円程度です。
- 複数クラスタ:HA、Remote Write、長期保持、SLO設計で500万円〜1,500万円程度も想定されます。
- 大規模環境:多数テナント、複数リージョン等を含み1,000万円〜3,000万円超の可能性があります。
上記の金額は、多数の業務メトリクスや高カーディナリティ対策、チケット・CMDB・セキュリティ基盤との連携、24時間運用の設計を含む場合の推定です。
ノード数だけでは判断できないため、対象サービス数、メトリクス数、独自計装の有無、非機能要件を分けて見積もります。
クラウド費用の決まり方(samples・active series・保持期間)
クラウド料金は、取り込み量、active series、保持期間、クエリ量で変わります。そのため、各社の料金例を並べて比べます。
- AWS:初期費用やコミットメントなしで、取り込み・保存・クエリ・Collector量に応じて課金されます。
- Grafana Cloud:Free、Pro、Enterpriseでseries数や保持条件、最低契約額が異なります。
- Google Cloud:収集間隔が短いほどsamplesが増え、料金例にも差があります。
- 設計時:重要度別に間隔を分け、高カーディナリティを絞ります。
AWSの例では、10ノード、各1,000メトリクス、30秒間隔、月744時間の条件で、合計は月81.75米ドルです。1米ドル=150円なら約1万2,000円です。ただし、EKS、Grafana、ネットワーク、税、サポート費用は含みません(出典: AWS「Amazon Managed Service for Prometheus pricing」、2026年8月確認)。
Grafana Cloud Freeは、月10,000 active seriesまでで、保持は14日です。Proは月19米ドルからで、10,000 active seriesと13カ月の保持を含みます。
Pro超過分は1,000 seriesあたり6.50米ドルからです。Enterpriseの年間最低コミットメントは25,000米ドルです。
保持期間やseriesが増えると、費用は変わります。無料枠で本番の長期保持やサポートまで賄えるとは限りません(出典: Grafana公式「Pricing」、2026年8月確認)。
Google Cloudの例は、100コンテナ、各1,000時系列です。15秒間隔では月17,520百万samplesで1,051.20米ドル、60秒間隔では月4,380百万samplesで262.80米ドルです。1米ドル=150円なら、約15万8,000円と約3万9,000円になります。
短い間隔では検知性能が上がる場合もあります。一方で、全てを15秒にすると費用が膨らむため、重要度で間隔を分けます(出典: Google Cloud「Pricing examples for Google Cloud Observability」、2026年8月確認)。
保守費用の決まり方(更新・容量・アラート改善の範囲)
保守の範囲と契約時間は、分けて確認します。
- 定期保守:PrometheusやExporterの更新、脆弱性対応、ラベル見直し、容量予測、バックアップを含むかを確認します。
- 運用対応:アラート変更や障害問い合わせを含むかどうかの確認。
- 年間費の目安:NotebookLMの業務システム調査では、初期開発費の15〜20%程度が一般的な目安です。
- 追加体制:24時間365日の有人監視、オンコール、SLA、緊急対応時間を付けると、目安を超える可能性があります。
この割合はPrometheus固有の統計ではないため、あくまで目安として見てください。
クラウドの従量費はメトリクス量で変わり、保守費は契約時間や対応範囲で変わります。両者は分けて見積もります。
保守費は、契約時間に加えて、月次の容量レポート、改善工数、受付時間の条件で決まります。
- 初動時間:対応を始めるまでの時間を明記します。
- 更新回数:契約期間中に行う更新の回数を明記します。
- 契約終了後の設定・画面の引き渡し条件:契約が終わったあとの引き渡しの条件を明記します。
Prometheusのシステム開発で見積もりを取るポイント
各社の見積もりは、工程別の作業費とクラウド従量費に分けてもらうと比べやすくなります。「監視基盤一式」の一行だけでは、中身を比べられません。
見積もりに入れる作業は、次の5つにまとめると、各社の作業範囲をそろえて比べられます。
- 要件整理・選定支援:要件の整理と、候補を絞り込む作業。
- 設計・計装・Exporter開発:設計と、アプリとExporterへの組み込み。
- 画面・アラート:見やすい画面の作成と、通知条件の設定。
- テスト・移行:テストと、既存環境からの移し替え。
- 教育・保守:利用者への説明と研修、更新と障害対応。
前提を揃えておくと、作業範囲、単価、体制の違いを判断できます。
依頼書に書く項目(メトリクス数と運用条件)
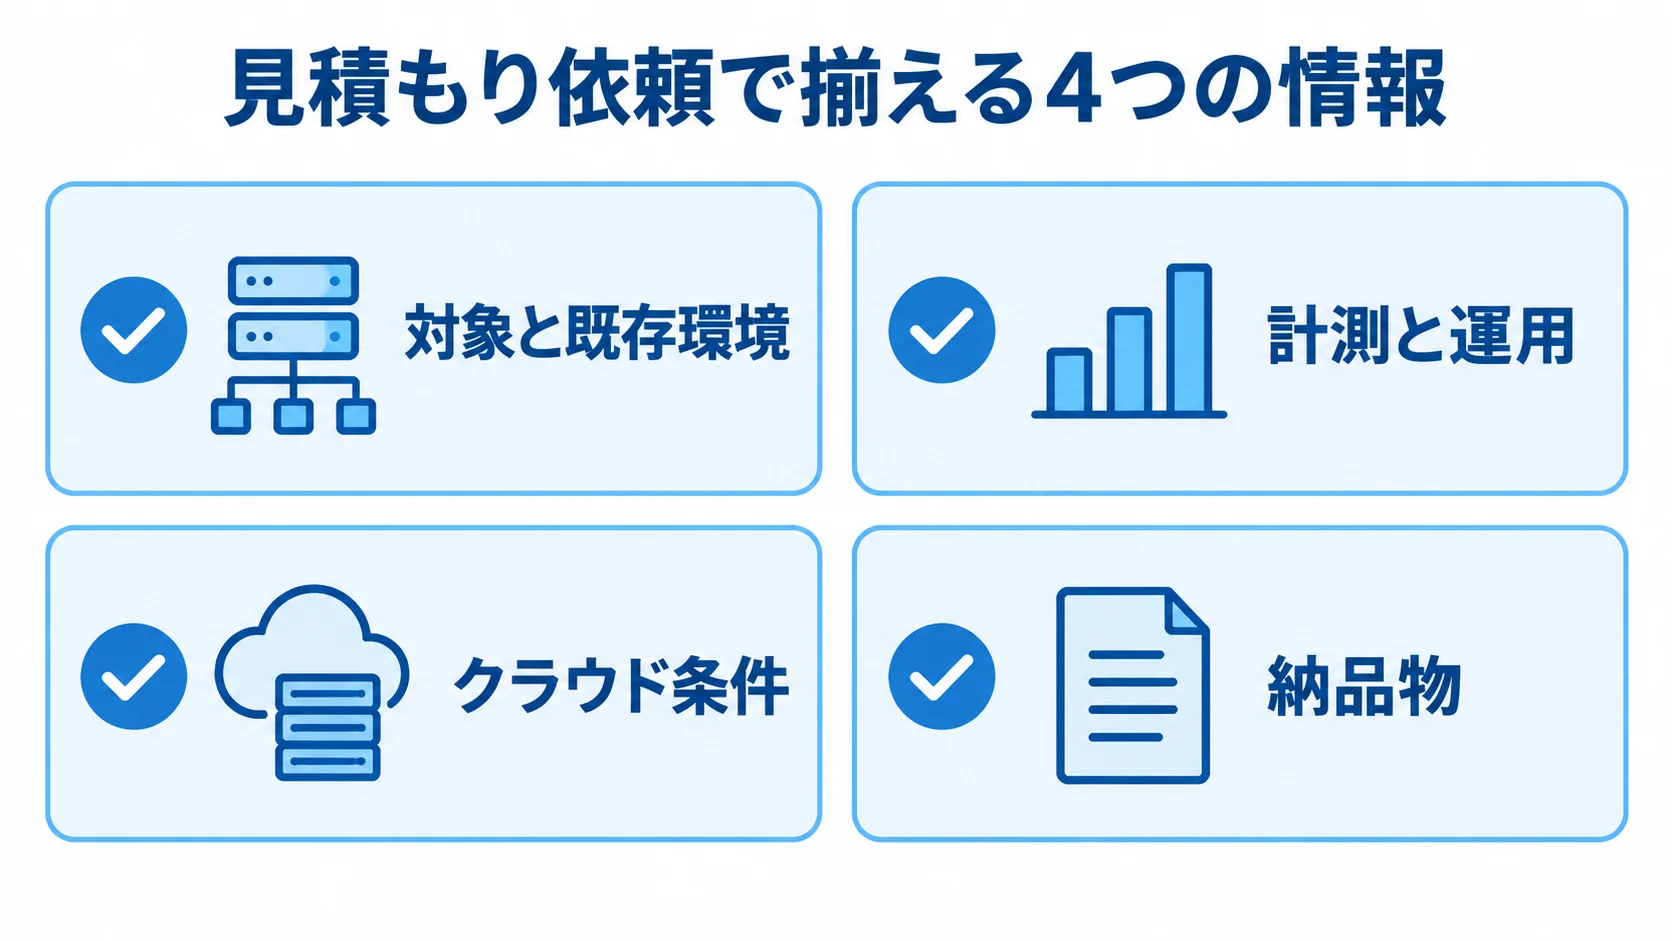
見積もりの条件と納品物を事前に揃えておくと、各社の提案を比べられます。
- 対象と既存環境:環境、ノード・Pod・サービス数、既存監視ツール、Prometheus互換の利用可否を記載します。
- 計測と運用:計装対象、Exporter開発数、時系列数、間隔、保持、月間クエリ量、画面・アラート数を記します。
- クラウド条件:リージョン、所在地、IAM、通信、暗号化、バックアップ、SLAを示します。
- 納品物:設計、構成図、定義、コード、テスト結果、ランブック、教育資料を指定します。
画面上の設定だけでは、環境を再構築できません。そのため、コードや定義ファイルの管理方法も確認します。
納品物では、要件定義書と基本・詳細設計書に加えて、次の成果物を求めます。
- メトリクス・ラベル一覧:収集する値とラベルの対応をまとめたもの。
- PromQLと記録・アラートルール:集計の問い合わせ文と、記録ルール・通知条件。
- Grafanaダッシュボード定義:画面の定義ファイル。
- Exporter・計装のソースコードとテスト仕様書:具体的に示します。
- 設定のバックアップとリストアの手順:納品物に加えます。
複数社の比較の前提と実装者の経験
同じ要件を各社に示し、技術経験と運用条件をそろえて比べます。
- 見積もり:複数社へ同じ要件で概算・詳細見積もりを依頼します。
- 技術経験:PromQL、Grafana、Kubernetes、クラウド、オンプレミス、計装を見ます。
- 運用品質:カーディナリティ対策、HA、セキュリティ、所在地、サポートを比べます。
- 費用変動:量が2倍・5倍の場合や保持延長時の料金も尋ねます。
- 責任分界:契約終了時の持ち出しや、更新・障害対応の担当を確認します。
日本語対応、24時間運用、契約終了時のデータ持ち出しも比べます。営業資料だけでなく、設計や障害対応を担う人が打ち合わせに加わるかも確認します。
価格を公開していないマネージドサービスや統合監視製品は、公開情報だけで導入費を判断できません。対象規模を伝えて、見積もりを依頼します。
自社運用の場合は、更新や障害対応が誰の工数になるかも確かめます。
セキュリティと契約責任の確認事項
Prometheus公式のセキュリティモデルでは、エンドポイントを外部から守る前提が示されています。
- 公開制限:/metrics、各コンポーネントのAPI、Go製コンポーネントの/pprofなどを、インターネットへ公開しません。
- 接続と権限:TLS、認証、ネットワーク分離、管理API・ライフサイクルAPIの無効化、Grafanaのデータソース権限を確認します。
- 情報管理:個人情報などをラベルに入れず、目的、保存、権限、削除の扱いを確かめます。
- 契約責任:設定変更の承認者、脆弱性対応の期限、障害時の責任分界、終了時の削除・持ち出しを定めます。
Grafana画面の権限を制限しても、データソース側で任意のPromQLを実行できる場合があります。そのため、両方を別々に評価します(出典: Prometheus公式「Security model」、2026年8月確認)。
ユーザーID、メールアドレス、顧客番号、IPアドレス、URLパラメータは、ラベルや値に入れないルールとして契約仕様に含めます。アラート通知に含まれる機密情報も確かめます。
混入の可能性があれば、データマッピング、利用目的、保存期間、権限を確かめます。さらに、委託先や海外保存、削除手順、監査ログも見ておきます。
よくある質問(FAQ)
Prometheusのシステム開発では、OSSの扱い、既存監視との違い、導入期間、運用負荷についての質問が多く寄せられます。発注前に判断しやすいよう、各質問の結論を先に示します。
Prometheusは無料で導入できますか?
Prometheus本体はオープンソースのため、ライセンス購入費なしで利用できます。ただし、サーバーやストレージ、ネットワーク、Exporters、アプリ計装の費用は発生します。ダッシュボードやアラート設計、テスト、保守の費用も、別に見込む必要があります。
無料なのは、ソフトウェアのライセンス部分です。運用を含めた総保有コストは、別に見積もります。
Prometheusのシステム開発にはどのくらいの期間がかかりますか?
検証や小規模PoCは2〜6週間、小〜中規模の本番導入は1〜3カ月が推定の目安です。複数クラスタのHA、長期保持、業務KPI、運用の引き継ぎを含む場合は、3〜6カ月程度になります。
既存アプリへの計装、セキュリティ審査、ネットワーク申請、24時間運用の合意、データ移行があると、期間は長くなります。
対象を絞ったPoCでメトリクス量とアラート品質を測ってから本番の範囲を決めると、期間と費用のぶれを抑えられます。
PrometheusとGrafanaは両方導入する必要がありますか?
両方を入れることは必須ではありません。Prometheusを収集・保存・検索・アラートの中核に、Grafanaを画面の可視化層に置く構成が一般的です。
Prometheusの式ブラウザやAPIを使う方法もあります。一方で、複数サービスを横断する画面や権限、注釈、アラート表示が必要なら、Grafanaを比べます。
Grafanaを入れる場合も、画面の権限とPrometheusのデータソースの権限は、別々に設計します。
オンプレミスや一般的な業務システムでも使えますか?
オンプレミスや一般的な業務システムでも使えます。Exporterやアプリ用ライブラリを組み合わせて、監視できます。
- 収集手段:Node Exporter、DB・Web向け、SNMP・Blackbox系Exporterを使えます。
- アプリ計測:アプリケーションのクライアントライブラリを使えます。
- 監視対象:VM、オンプレミス、ネットワーク機器、社内業務アプリを監視できます。
対象が増えるほど、ネットワーク経路、認証、Firewall、ラベル統一、保存容量、障害時の責任分界を先に確認します。
まとめ
Prometheus開発の目的は、業務への影響を早く把握し、担当者が復旧できる監視体制を作ることです。導入そのものは、目的ではありません。
要件整理ではSLOと業務KPIを定め、選定では課金単位と責任分界を比べます。設計・開発ではラベルと通知を決め、テスト、稼働、定着の各段階で改善します。
業務影響の大きいサービスから始めるPoC
全社の監視を一度に完成させず、注文・決済・在庫連携・重要バッチなど、障害時の影響が大きい対象を1つ選びます。
収集メトリクスとラベル、収集間隔を小さく作ります。保持期間やアラート、通知後のランブックも同じ範囲で用意し、誤検知と運用負荷を実測します。
結果をもとに、単一のPrometheusで続けるか、HA、Remote Write、マネージドサービスへ広げるかを判断します。
見積もりの構築費と運用費の比較
見積もりの前提を揃え、構築費と運用費を分けて比べます。
- 提示条件:対象、メトリクス、時系列、収集間隔、保持、クエリ、SLO等を伝えます。
- 費用内訳:「一式」ではなく、工程、工数、単価、クラウド従量費に分けて示してもらいます。
- 実装経験:Prometheus・Grafana、計装、Kubernetes、IAM、ネットワーク、アラート対応、教育を確認します。
通知先、セキュリティ、納品物、保守範囲も、発注の時点で示しておきます。
▼全体ガイドの記事
・Prometheusのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。