
PyTorchのシステム開発費は、データ整備、業務連携、GPUと運用の範囲によって変わります。目安は、小規模PoCで300万〜800万円、全社基盤で5,000万円〜1億円超です。
▼全体ガイドの記事
・PyTorchのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
PyTorchのシステムの概要
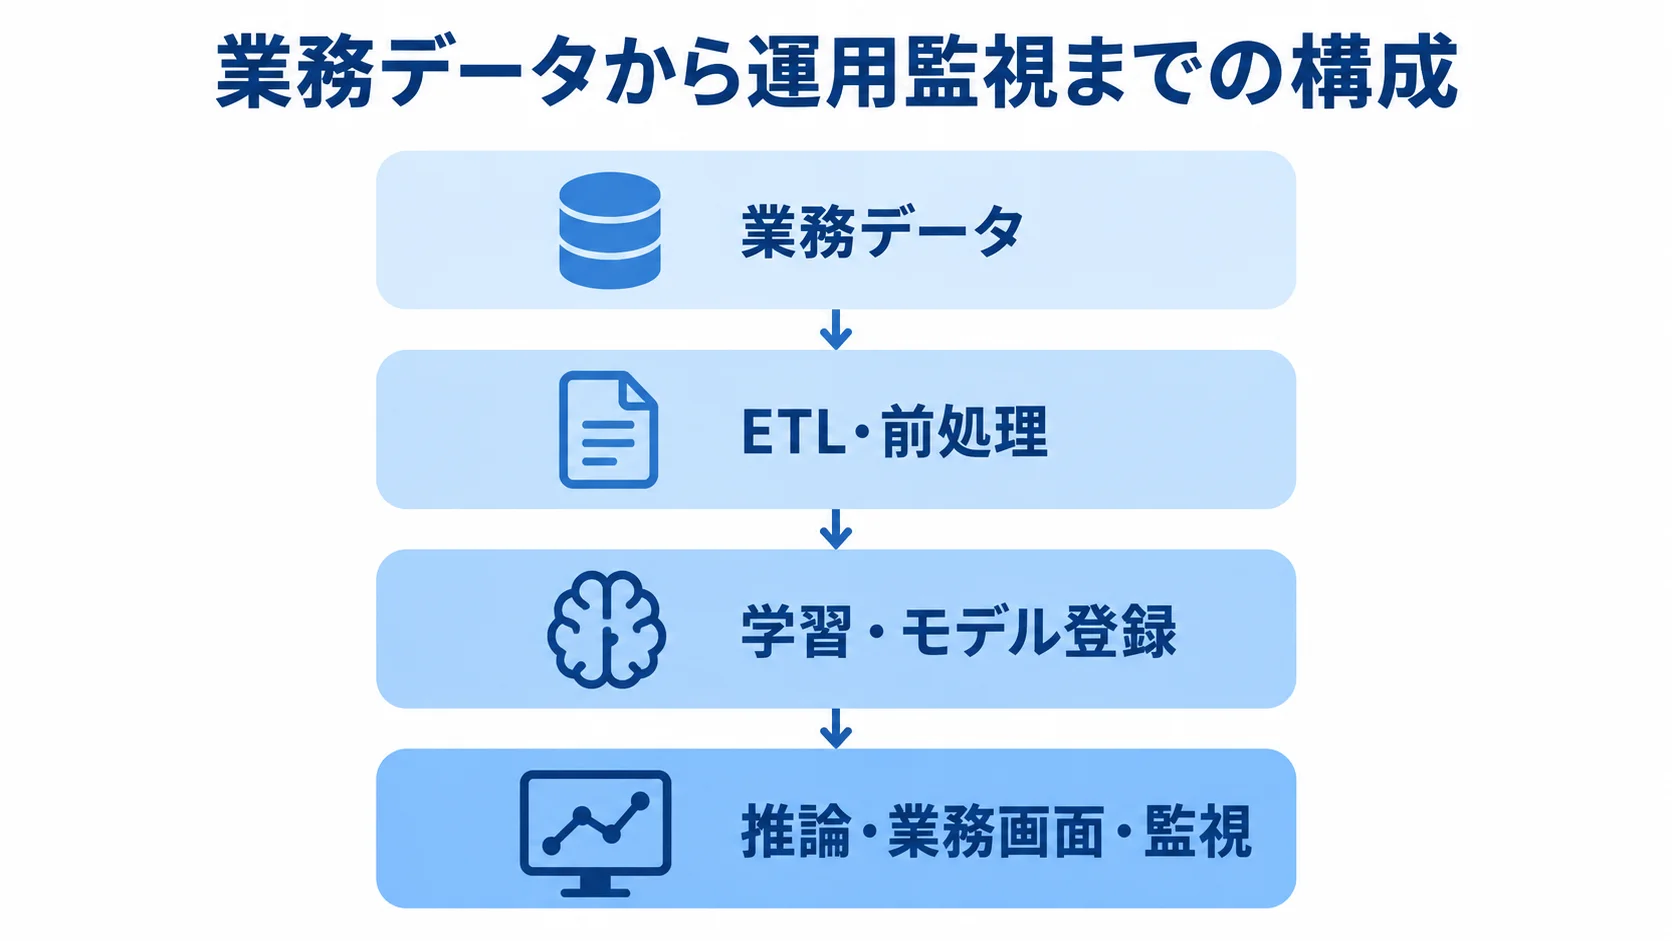
PyTorchのシステムは、販売管理やCRM、IoT、文書、画像などの業務データを取り込みます。
PyTorchのシステムは、PyTorchで開発したAIモデルを、業務画面や既存システムから利用できるようにする仕組みです。
ただし、フレームワークを導入するだけでは、業務システムは完成しません。データ処理から運用監視までを一体で設計する必要があります。
PyTorchが担う役割とシステムの構成
業務データはETLや前処理で整えます。そのうえで、PyTorchの機能や活用先に合わせて、必要な構成を整理します。
- 機能:テンソル計算、自動微分、ニューラルネットワーク、データローダー、分散学習を提供
- 用途:画像分類、異常検知、需要予測、自然言語分類、音声認識、生成AIの社内活用
- 構成:データ処理、匿名化、ラベル付け、学習、モデル登録、推論、業務画面、監視、権限管理
構成の要素は多いため、費用はAIモデルの開発費だけで判断せず、データ処理や業務画面も含めて見積もります。
業務によって必要な作業は異なります。たとえば、画像検査では撮影条件の統一や教師データのアノテーションに工数がかかります。需要予測では販売実績と販促情報を合わせる必要があり、文書処理ではOCRと個人情報のマスキングが必要になります。
特に、AIの精度が高くても、業務データを安定して取り込めなければ本番運用にはつながりません。
PyTorchに向く業務と向かないケース
独自モデルを使うかどうかは、扱うデータの特性と、既製サービスで要件を満たせるかで考えます。
- 向く業務:自社データに合わせた改善や、既製AIで対応しにくい画像・音声・文書・時系列データの処理
- 独自モデルを避ける場合:定型問い合わせや一般的な文字起こしで、既製SaaS・APIの品質と価格が十分なとき
既製SaaSやAPIで要件を満たせるなら、独自モデルを作らない方が、初期費用と運用負担を抑えやすいです。
採用の判断では、正解率だけでなく、導入前後の作業時間、見逃し率、誤検知率を確認します。さらに、1件あたりの推論コスト、応答遅延、現場での修正可否、再学習の日数も見ておきます。
まず、改善したい業務KPIを決めておくと、AI導入の費用対効果を判断しやすくなります。
PyTorchのシステム開発費用の相場
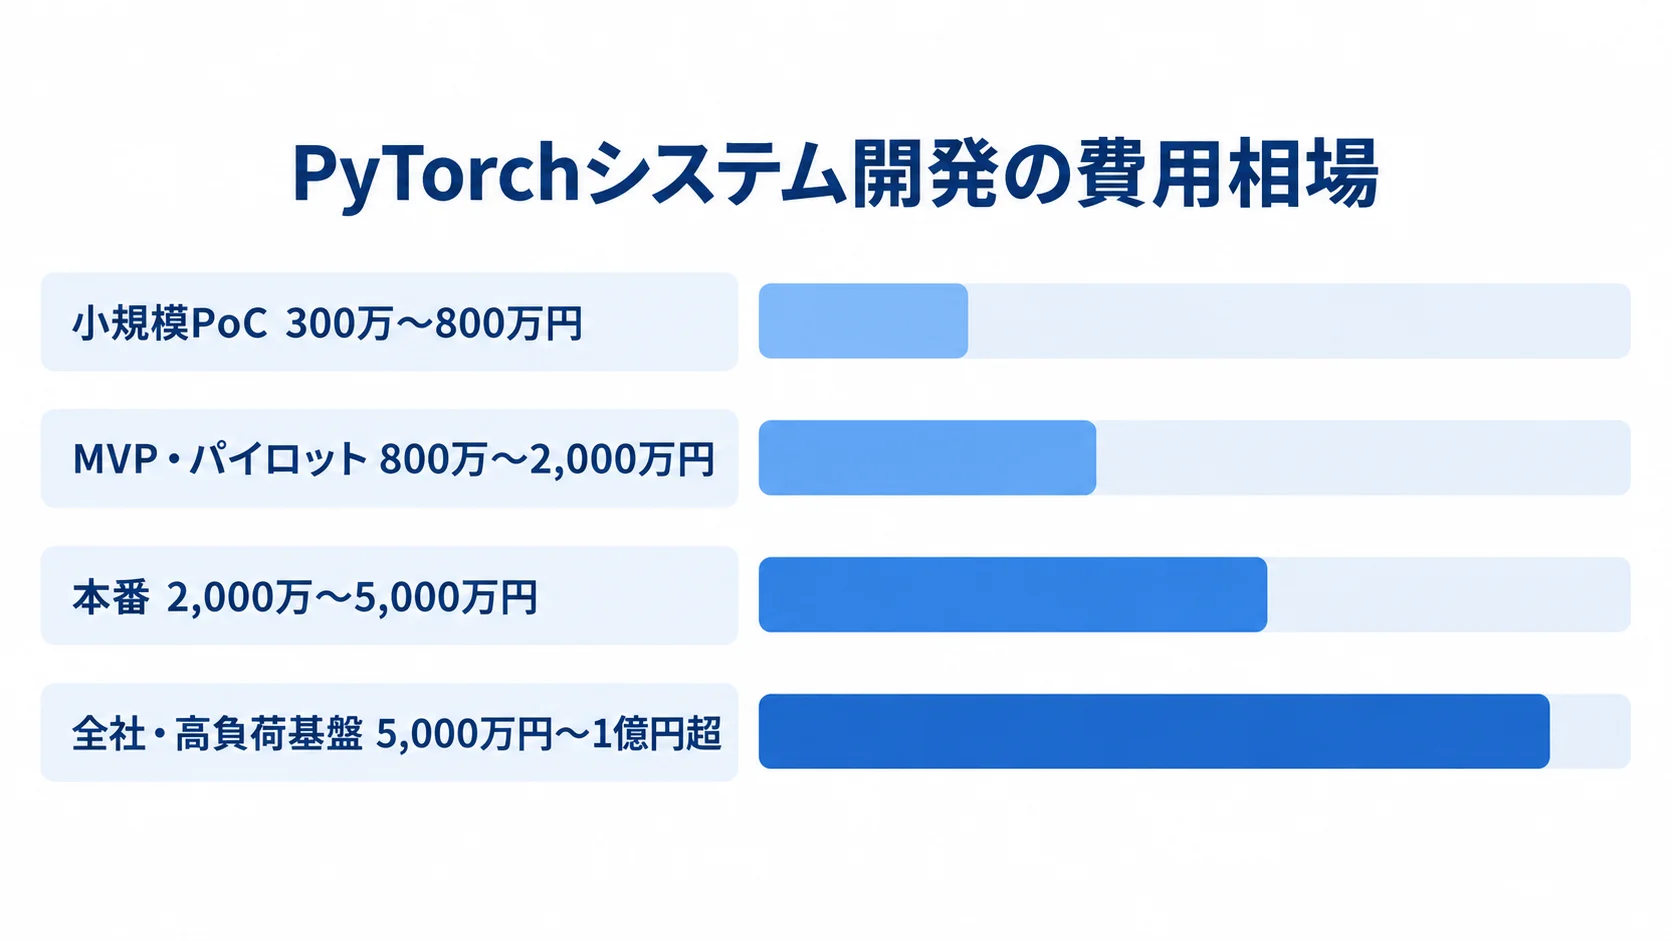
初期費用の目安は、小規模PoCで300万〜800万円、MVP・パイロットで800万〜2,000万円、本番で2,000万〜5,000万円です。
複数拠点、閉域接続、冗長化などを求める全社基盤は、5,000万円〜1億円超になる可能性があります。既存基幹連携や24時間運用を求める場合も、この範囲に入ります。
これは、公開された業務システム相場と機械学習基盤の構成をもとにした、予算取り用の推定です。正式な見積額ではありません。
調査・小規模PoCは300万〜800万円
小規模PoCでは、検証対象を絞り、費用に含める作業と本番判断に必要な成果物を定めます。
- 対象:1業務、1種類のデータ、1モデル程度に絞り、既存データで精度と適合性を検証
- 成果物:データ作成方法、採用モデル、再現手順、誤判定の傾向
- 本番判断の材料:処理時間、推論リソース、量産化時の追加課題
データの棚卸しから学習、評価画面、簡単なレポートまでを含めるなら、300万〜800万円程度が予算検討の出発点です。
データに欠損がある、ラベルがない、評価基準が未定の場合は、モデル開発より調査とデータ整備の比率が高くなります。
成果物に処理時間や追加課題まで含めて契約すると、本番見積もりの不確実性を減らせます。
MVP・パイロットは800万〜2,000万円
MVPでは、限定利用に必要な実装と、現場での確認や引き継ぎを含む運用面を見積もります。
- 実装範囲:データ連携、学習パイプライン、推論API、簡易業務画面、権限管理、ログ、基本監視
- 運用確認:結果を確認・修正できる画面、失敗時の引き継ぎ手順、データ更新頻度
1部門や限定ユーザーが実務で使える状態を目指します。
PoCより連携とテストの費用が増えるため、800万〜2,000万円程度が目安です。
限定運用で見つかった誤判定や遅延は、本番の要件に反映できます。
最初から大規模なGPU基盤を構築せず、必要な範囲に絞ると、投資判断がしやすくなります。
本番業務システムは2,000万〜5,000万円
本番化の費用には、業務機能だけでなく、モデルの継続運用と障害への備えも関わります。
- 業務機能:複数データソース、業務画面、認証認可、監査ログ、CI/CD
- モデル運用:モデルレジストリ、再学習、精度・遅延・データドリフトの監視
- 継続運用:バックアップ、障害時のロールバック
複数モデルや複数部門で使う場合は、2,000万〜5,000万円程度を中心に考えます。
要件の組み合わせによって費用は上下します。特に、既存基幹との複雑な連携が加わると、費用は膨らみやすくなります。個人情報の閉域処理や高可用性、厳格なSLAも、費用を押し上げる要因です。
現場ごとに異なる業務ルールも、費用に影響します。見積書は「AI開発一式」とせず、項目ごとに分けてもらいます。モデルやデータ、インフラなどの区分で、どこにいくらかかるかが見えるようにします。
全社・高負荷基盤は5,000万円〜1億円超
全社展開では、高負荷に耐える基盤と運用体制が必要です。開発期間も含めて規模を見積もります。
- 基盤要件:複数拠点のネットワーク、GPU冗長化、アクセス集中へのスケール、災害対策
- 運用要件:24時間監視、複数モデルのライフサイクル管理
- 開発期間の目安:PoCは1〜3か月、MVPは3〜6か月、本番は6〜12か月、全社基盤は12〜24か月以上
この規模では、5,000万円〜1億円超も想定されます。
利用量や既存設備の再利用可否によって金額は変わります。そのため、金額だけで優劣を判断することはできません。
期間に応じて人数を単純に増やすより、データ準備とモデル開発を並行して進められる体制が大切です。
業務連携やセキュリティ審査も、同じ時期に進められるかを確認します。
PyTorchのシステム費用の内訳と変動要因
費用は、人件費やデータ整備、インフラに分けると見通しやすくなります。加えて、モデル開発やアプリ連携、テスト、セキュリティ、保守も、項目ごとに分けて見ます。
PyTorch案件では、モデル作成よりデータ準備、本番業務との接続、継続評価の作業が大きな割合を占めることがあります。
データ整備・モデル開発の費用
データの状態や作業方法に加えて、担当する職種と期間によって費用は変わります。
- データ整備:抽出、欠損・重複処理、匿名化、ラベル付け、学習・評価分離、品質検査
- アノテーション:対象件数、判定ルール、二重チェックの有無で工数が変動
- 人件費目安:業務システム案件で、プロジェクトマネージャーは月90万〜150万円
- システムエンジニアは月65万〜110万円、プログラマーは月50万〜90万円
- 専門職:大手SIerや専門性の高い機械学習エンジニアは、月150万〜200万円程度の場合もある
個人情報や機密文書を扱う場合は、マスキングとアクセス権を含めます。保管期間や削除手順も、見積もりに入れます。
単価は職種や専門性で変わり、地域や契約形態でも差が出ます。そのため、人数と期間の根拠を必ず確認します。
GPU・クラウド・ストレージの費用
NVIDIA T4はGoogle CloudのオンデマンドGPU料金の具体例です。稼働時間と周辺サービスも含めて、費用を確認します。
- 利用形態:学習時の短期利用か、推論用の常時起動かでGPU費用が変動
- T4の公開価格:1GPUあたりオンデマンドで1時間0.35米ドル
- 730時間利用:GPU部分だけで約255.5米ドル。VM等は別料金
- 付帯費用:データ保存、バックアップ、レジストリ、ログ、監視、APIゲートウェイ
Google Cloudの公開価格です(出典: Google Cloud「GPU pricing」、2026年8月確認)。
実際の円換算額は、為替とリージョンで変動します。
AWSは2025年6月、P4・P5などNVIDIA GPU対応EC2の価格を最大45%引き下げると発表しました(出典: AWS News Blog「Announcing up to 45% price reduction for Amazon EC2 NVIDIA GPU-accelerated instances」、2025年)。
引き下げの条件は、対象インスタンス、リージョン、オンデマンドかSavings Plansかで異なります。
セキュリティ・テスト・保守の費用
本番利用では、テストと安全対策に加えて、ソフトウェア更新やAI運用の保守費も見積もります。
- 本番テスト:機能、精度、負荷、再現性、権限、脆弱性、障害復旧を確認
- 環境保守:PyTorch、CUDA、ドライバー、コンテナ、依存関係を固定し、更新時に再評価
- 保守運用費:初期開発費の年15〜25%程度を置く方法がある
- 費用範囲:再学習、データ追加、精度劣化への対応、問い合わせ、障害監視、脆弱性対応を含む範囲で変わる。サーバー保守とAI運用は分けて記載
NVDは、PyTorch 2.5.1以前に脆弱性CVE-2025-32434があると報告しています。これは、weights_only=Trueでモデルを読み込む際のリモートコード実行の脆弱性です。2.6.0で修正されました(出典: NIST National Vulnerability Database、2026年6月更新)。
信頼できないモデルファイルは読み込まないことが大切です。また、依存パッケージの固定・更新と、検証環境でのスキャンを最初から予算に含めます。
PyTorchのシステム開発の進め方
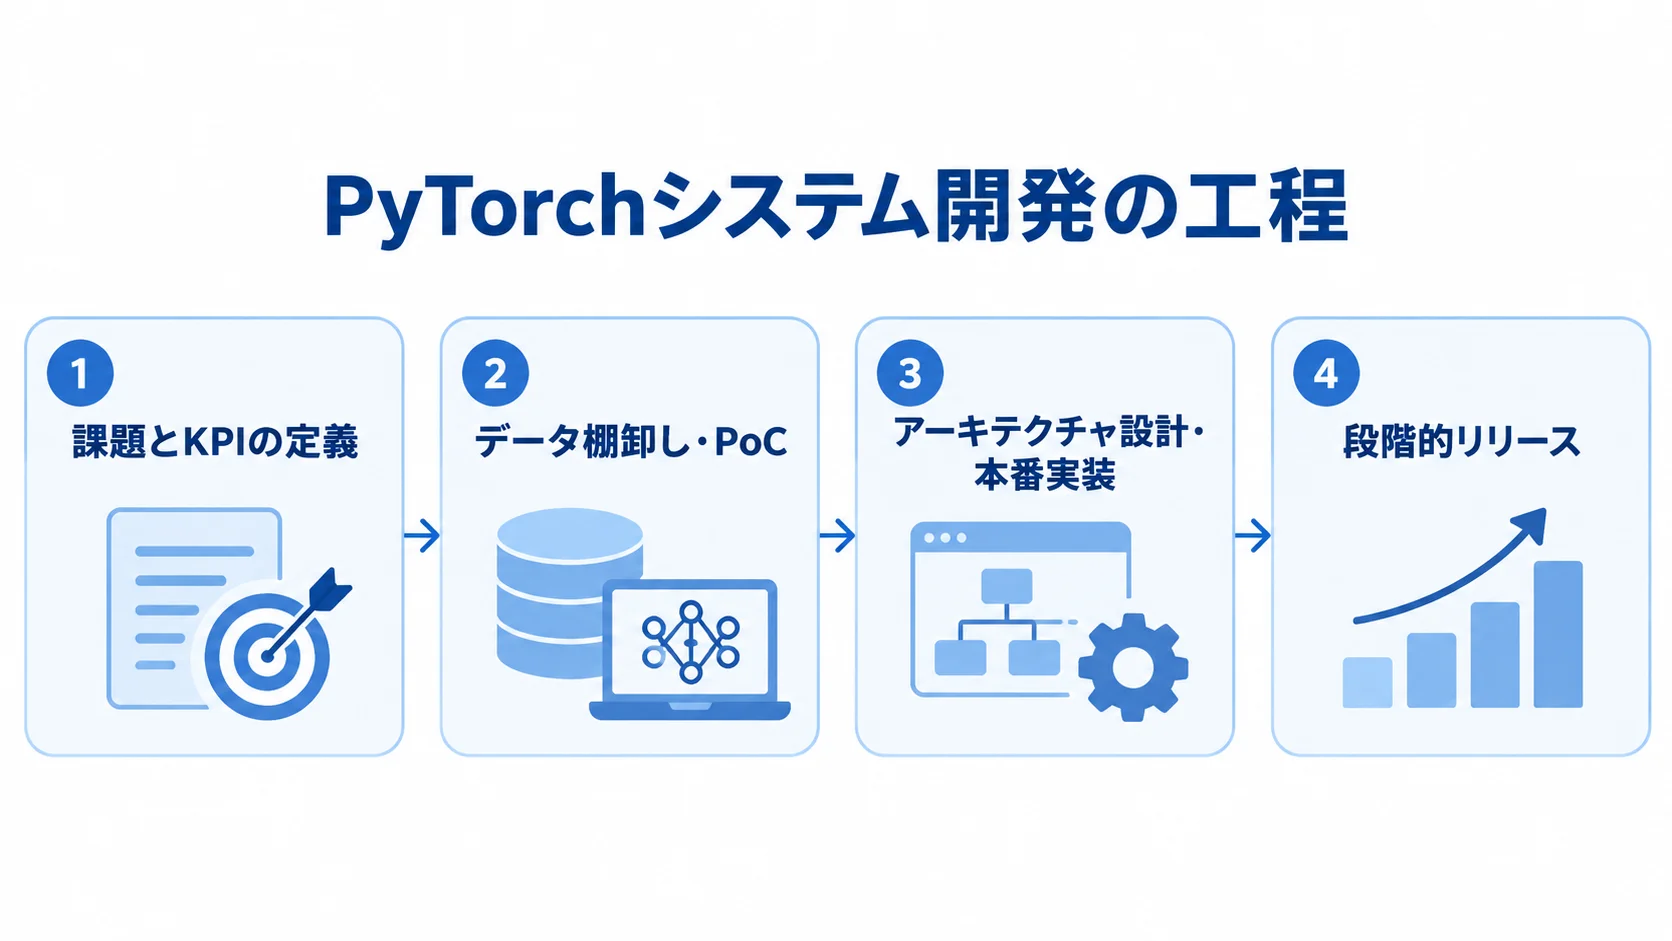
開発は、課題とKPIの定義から始めます。その後、データの棚卸しとPoCを行い、アーキテクチャ設計と本番実装へ進んで、段階的にリリースします。
各工程の成果物と判断基準を決めておけば、精度が出ないまま開発を広げるリスクを抑えられます。運用費の見落としも防げます。
要件定義とKPIの設定
まず、「AIを導入する」ことより先に、何を改善するかを決めます。改善内容を測れる形にしたうえで、品質・性能の基準や運用条件と合わせてKPIを定めます。
- 改善目標:検品時間を何%減らすか、問い合わせ分類の正解率をどこまで求めるか
- 品質・性能:需要予測の誤差範囲、応答時間を何秒以内にするか
- 業務KPI:現場の確認・修正時間、1件あたりの推論費用
- 運用条件:利用者、データ所有者、個人情報、既存API、保存期間、停止時間、監査要件
要件が曖昧なまま発注すると、後から画面や連携先が増えて費用が膨らみます。要件定義を独立したフェーズとして見積もると安全です。
データ準備と小規模PoC
データに欠損や偏り、重複がないかを確認し、学習データと評価データを分けます。
データが少ない場合は、大規模モデルを作らず、転移学習やルールとの組み合わせを試します。
PoCでは、精度や誤判定の種類、処理時間を記録します。GPU使用量や現場の作業時間も残しておきます。特に、精度だけで合否を決めると、本番で使えない結果になりがちです。
- 人の確認:誤判定時に、人が確かめられるか
- 改善の見込み:データを足して精度を改善できるか
- 再現性:再学習を同じ手順で再現できるか
- 本番移行:本番化に必要な追加費用も洗い出す
本番設計・テスト・段階リリース
本番化では、環境と責任範囲を設計し、再現できる実装を段階的に利用者へ届けます。
- 学習・推論環境、GPU・CPU、クラウド・オンプレミスを選ぶ
- モデルレジストリ、データ連携、認証認可、ログ、監視、バックアップ、ロールバック、再学習について、どこまでを誰が受け持つかを仕様に含める
- PoCのノートブックだけを移さず、再現可能なパイプラインを実装する
- シャドー運用、限定ユーザー、カナリアリリース、全社展開の順に公開する
NECは、スパコンでPyTorchモデルを学習し、専用のAWS環境で推論します。SageMakerとTriton Inference Serverを使います。AWSの事例にも、この構成が載っています(出典: AWS「PyTorch on AWS – Customer Stories」、2026年8月確認)。
学習と推論を分ける設計は、セキュリティとGPU費用の管理に役立ちます。
PyTorchのシステム開発で見積もりを見るポイント
複数社に同じ前提条件を渡し、金額だけでなく成果物や期間を比べます。体制、リスク、保守範囲も、同じ条件で並べて確認します。
PyTorch案件では、モデルの難易度と業務システムの複雑さが別々に変動します。総額だけでは差の理由が分かりにくいため、項目ごとの比較が必要です。
見積もりの対象範囲の分解
見積もりを比べられるよう、作業項目と前提条件をそろえ、納品される成果物も具体化します。
- 見積項目:要件定義、データ抽出・加工、アノテーション、モデル開発、評価
- 開発範囲:API、業務画面、既存連携、クラウド・GPU、セキュリティ、テスト、移行・研修、保守
- 内訳の前提:担当者、工数、前提、対象外作業、追加時の単価を各項目に記載
- 納品物:ソースコード、学習済みモデル、学習データ加工、環境設定、IaC、テストコード
- 運用資料:モデル評価レポート、運用手順書、監視ダッシュボード、再学習手順
成果物の所有権や利用権が曖昧だと、将来の内製化や別会社への切り替えで、追加費用が発生しやすくなります。
発注先の技術力と運用体制
発注先は、技術の範囲と実績を中心に、支援体制や方式の提案力も合わせて評価します。
- 対応範囲:PyTorch、データ基盤、API、クラウド、GPU、MLOps、セキュリティ、業務定着
- 実績・体制:近い業界・データの実績、本番化件数、更新方法、障害連絡、再委託先
- 責任分界:受託SI会社とクラウド基盤ベンダーの役割、全体責任者
- 方式選定:同じデータ量・同時アクセス数を前提に、CPU、GPU、専用推論チップ、バッチ処理の選定理由を説明してもらう
AWS事例には、PyTorchモデルをInferentiaへ移し、GPUと比べてコスト削減やスループット向上を実現した例があります。
効果はモデルと負荷条件に左右されます。そのため、自社データに近いベンチマークができる会社を優先します。
不確実性と契約上のリスクの管理
PoCの不確実性と契約上の権利・責任を整理し、安全な開発条件を定めます。
- 開発上の不確実性:PoCの精度不足、データ追加、学習時間超過、GPU確保
- 権利・委託:データ・モデルの権利、目的外利用、個人情報、再委託、秘密保持
- 責任・安全:脆弱性、障害責任、SLA、コード・IaCの引き渡し
- 生成AI利用時:機密情報の入力制限、出力確認、ログ保存、誤判断の訂正手順
全工程を最初から固定価格で約束するより、調査・PoCと本番を分け、各ゲートで継続・修正・中止を判断できる契約が適しています。
PyTorchのシステム費用の最適化方法
まず、必要な精度と応答性能を定義します。そのうえで、学習費や推論費を分けて測るのが基本です。データ保管費と運用費も、同じ考え方で別に把握します。
高価なGPUの常時稼働が、必ずしも最適とは限りません。利用頻度が低い業務なら、バッチ処理やCPU推論で足りる場合があります。
学習と推論の環境の使い分け
学習と推論では計算量や稼働時間が異なるため、用途に合う実行環境を選びます。
- 学習:短期間に大量計算するため、GPUは必要な期間だけ起動
- 推論:CPU、量子化モデル、専用推論チップ、低頻度時の縮小を比較
- バッチ処理:リアルタイム性が不要な需要予測や集計は夜間処理も選択肢
2026年7月のAWS発表では、ECS Managed InstancesのGPU・アクセラレータ向け管理手数料が改定されました。
Gシリーズは35%、PシリーズとTrainiumは60%の引き下げです(出典: AWS「Amazon ECS Managed Instances reduces GPU management fees by up to 60%」、2026年)。
これは特定のAWS実行方式の改定です。GPU本体、ストレージ、ネットワークの費用は、この改定で無料になるわけではありません。アプリ運用費も、別に見積もる必要があります。
データとモデルの効率化
費用を抑えるには、データ量とモデルの処理効率を見直し、品質への影響も確かめます。
- データ品質:低品質のまま件数を増やすと学習時間・保管費が増える場合がある
- データ量:重複を除き、評価に効くサンプルを優先し、ラベル規則を揃える
- モデル:精度と遅延を比べ、小型化、量子化、蒸留、キャッシュを検討
- 品質確認:固定した評価データで精度、誤判定、時間、メモリ、1件費用を比較
記録を取らないままインスタンスを小さくすると、業務損失がインフラ削減額を上回る可能性があります。
運用指標の計測と再開発の防止
稼働後は、費用と品質を同時に追い、再学習や復旧の条件を決めておくことが大切です。
- 監視指標:ダッシュボードで推論件数、GPU・CPU使用率、平均・最大遅延、エラー率、データドリフト、精度、再学習回数、月額費用を追う
- 費用と品質:費用だけを見て精度劣化を放置すると手戻り・顧客対応が増え、精度だけを追うと過剰なインフラを維持する
- 再学習条件:一定期間ごとか、ドリフト・誤判定の増加検知時だけかで運用費が変わる
- 復旧準備:モデル、データ、コード、環境の版を記録し、旧モデルへ戻せると復旧・原因調査を短縮できる
PyTorchのシステム開発でよくある質問
費用は、データ、業務画面、インフラ、セキュリティ、運用体制の組み合わせで決まります。モデルの種類は、その要素の一つです。発注前によく聞かれる点を、予算と実装の両面から取り上げます。
PyTorchのシステム開発は最低いくらから依頼できますか?
既存データが整い、対象業務を1つに絞った調査・小規模PoCなら、300万〜800万円程度が目安です。
ラベル付け、個人情報の匿名化、外部連携が必要な場合は、追加費用が発生します。
目的とデータ件数を整理し、評価指標と期待する成果物も添えて相談します。
PyTorchのシステムには高価なGPUが必ず必要ですか?
必ずしも必要ではありません。低頻度の需要予測や小さな分類モデルは、CPUやバッチ処理で足りる場合があります。
学習時だけクラウドGPUを使う構成も選べます。画像や大規模モデルでリアルタイム性が必要な場合は、GPUを検討します。
利用量、遅延、モデルサイズを測ったうえで機種を選びます。
PoCと本番開発の費用はどのくらい違いますか?
小規模PoCは300万〜800万円、MVP・パイロットは800万〜2,000万円、本番業務システムは2,000万〜5,000万円が目安です。
本番では、業務画面や認証、監査などが加わります。負荷試験や監視も見ておく必要があります。さらに、再学習や障害対応、運用手順も加わるため、モデル開発だけのPoCより費用が高くなります。
PyTorchのシステムは内製と外注のどちらがよいですか?
社内のデータや業務知識の担当者と、PyTorch・MLOps・クラウドに詳しい外部パートナーを組み合わせる方法が現実的です。
完全内製は長期的な技術蓄積に向きますが、初期の採用と環境整備に時間がかかります。
外注時は、ソースコードやモデル、運用手順などを引き渡してもらいます。データ加工の手順、IaC、評価レポートも引き渡してもらうと、特定の会社への依存を抑えられます。
まとめ
費用は、PoCで300万〜800万円、MVP・パイロットで800万〜2,000万円、本番で2,000万〜5,000万円です。
全社・高負荷基盤は5,000万円〜1億円超が目安です。
これは、公開単価や一般的な業務システム相場から整理したレンジです。データ品質やモデルの難易度、連携範囲などによって変わります。そのほか、GPUやセキュリティ、SLAによっても変わります。
費用を左右する要点
見積もりでは、モデル開発だけでなくデータ整備と業務連携も分けて確認します。GPU・クラウド、テスト、セキュリティの費用も、項目ごとに分けて見ます。
モデル監視や再学習、保守も対象になります。
学習と推論の環境を使い分け、データとモデルを効率化したうえで、精度や遅延、費用を測ることが、最適化につながります。
発注前の準備事項
まず、対象業務と、データの種類や件数を整理します。個人情報の有無、利用者数、成果物の形もあわせて伝えます。
目標KPI、許容遅延、予算上限も決めておくと、各社の提案を比べやすくなります。PoCと本番を分けた提案を、複数社から取ります。そのうえで、技術力や運用体制、契約条件を比べます。セキュリティや将来の内製化についても確かめると、自社に合うPyTorchシステムを選びやすくなります。
▼全体ガイドの記事
・PyTorchのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。