
PyTorchのシステムは、既製AI、クラウド基盤、独自開発のどれを選ぶかで、構成も費用も変わります。
その判断は、扱うデータと業務の条件、運用体制によって決まります。全体像から開発の進め方、費用、開発会社の選び方、運用までを、順を追って説明します。
▼関連記事一覧
・PyTorchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・PyTorchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・PyTorchのシステム開発の見積相場や費用/コスト/値段について
・PyTorchのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
PyTorchのシステムの全体像
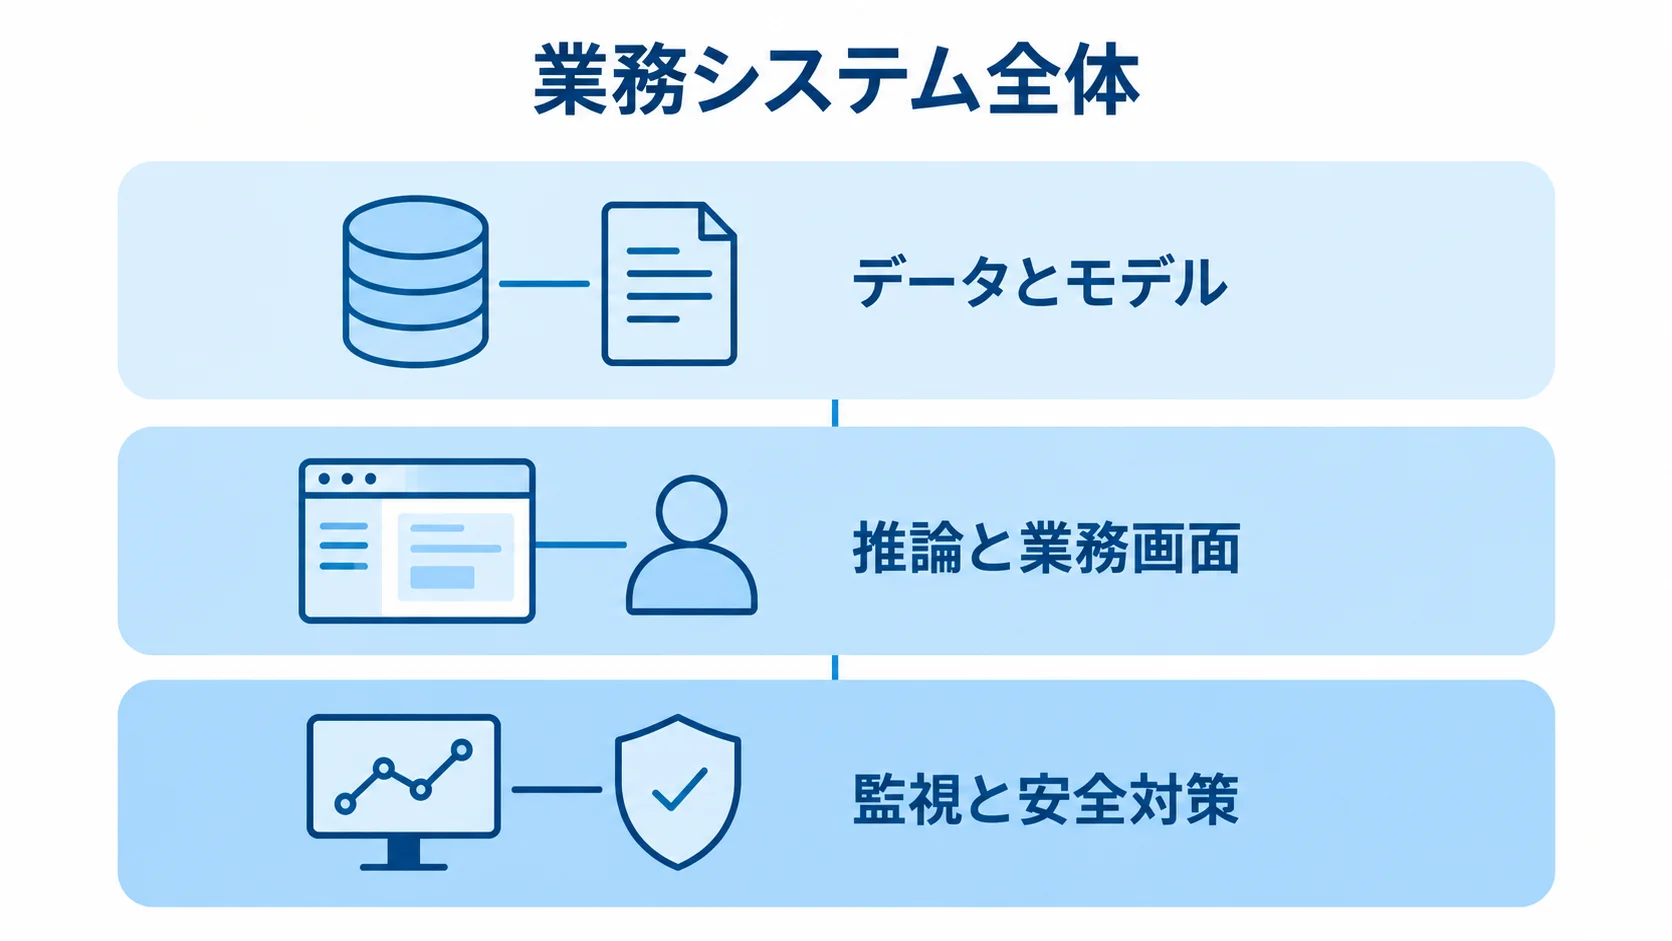
PyTorchのシステムは、AIモデルを業務システムに組み込んだ構成です。完成済みの販売管理パッケージとは異なり、組み込む先の業務に合わせた作り込みが必要です。
モデル部分と業務アプリケーション部分は、分けて設計します。正解率が高くても、現場で入力や確認、修正ができなければ定着しません。
AIエンジンとしてのPyTorchの位置づけ
PyTorchは、テンソルと呼ばれる多次元データを扱い、ニューラルネットワークの学習・評価・推論を実装する、オープンソースの深層学習フレームワークです。
- 開発環境:Pythonを中心に、自動微分やニューラルネットワークの部品を利用できます。
- 学習計算:データローダー、GPUでの計算、分散学習などの機能を備えています。
- 業務機能:顧客マスタ、受注、権限、ワークフロー、請求は、フレームワークとは別に設計・開発します。
2026年7月公開のPyTorch 2.13では、分散学習向けの通信バックエンドが追加されました(出典: PyTorch Foundation「PyTorch 2.13 Release Blog」、2026年)。
Apple Silicon向けFlexAttention、GPUメモリを抑える損失計算、Safetensorsの直接読み込みも加わりました(出典: PyTorch Foundation「PyTorch 2.13 Release Blog」、2026年)。
研究用途から、本番の学習・推論基盤へと利用範囲が広がっています。そこで採用時は、番号だけで決めず、GPU、Python、CUDAやROCm、周辺ライブラリの組み合わせを検証します。
業務システム全体の8つの層
典型的な構成は8層です。前半はデータソース、データ加工、モデル開発、実験管理で、後半は推論、業務アプリケーション、監視、セキュリティです。
データソースには、販売管理やCRM、IoTセンサーのデータを使います。画像、音声、文書なども対象です。
データ加工では欠損補完や匿名化を行い、正規化やラベル付けも加えます。そのうえで、モデル開発では学習・検証・評価と実験記録を進めます。
学習済みモデルは、モデルレジストリなどで版を管理し、推論APIや定期バッチから呼び出します。業務画面では、結果の根拠を確認したり誤りを直したりできるようにします。さらに、修正したデータを次の学習に戻す流れも設計します。
監視対象には、正解率や誤検知率、処理時間、エラー率を含めます。データ分布、GPU使用率、1件あたりの費用も対象です。
- データとモデル:入力データを加工し、学習と評価を経たモデルを版ごとに記録します。
- 推論と業務画面:APIやバッチで予測を出し、業務担当者が結果を確かめて修正します。
- 監視と安全対策:精度や費用、稼働状況、アクセスの変化を継続して追います。
画像・文書・予測・異常検知での活用先
PyTorchの活用先は、業務データや判断内容によって異なります。画像、文書、予測、異常検知などが代表的な例です。
- 画像・文書:画像検査や文書の分類・抽出、音声認識に使えます。
- 予測・推薦:需要予測やレコメンドに活用できます。
- 言語処理:自然言語処理のほか、社内向けの生成AIにも利用できます。
たとえば、製造画像を判定する場合は、画像を前処理してモデルへ送り、判定と信頼度を検査画面に返します。加えて、担当者の確認結果も保存します。
学習データが少なく、正解ラベルも定義できず、予測を使う業務判断もない場合は、効果が出にくくなります。
既製OCRや検索、分類、チャットボットで目的を達成できるなら、独自モデルを作る前に既製サービスと比べます。採用の判断は、業務KPIを改善できるかで決めます。
PyTorchのシステムの構成方式の種類
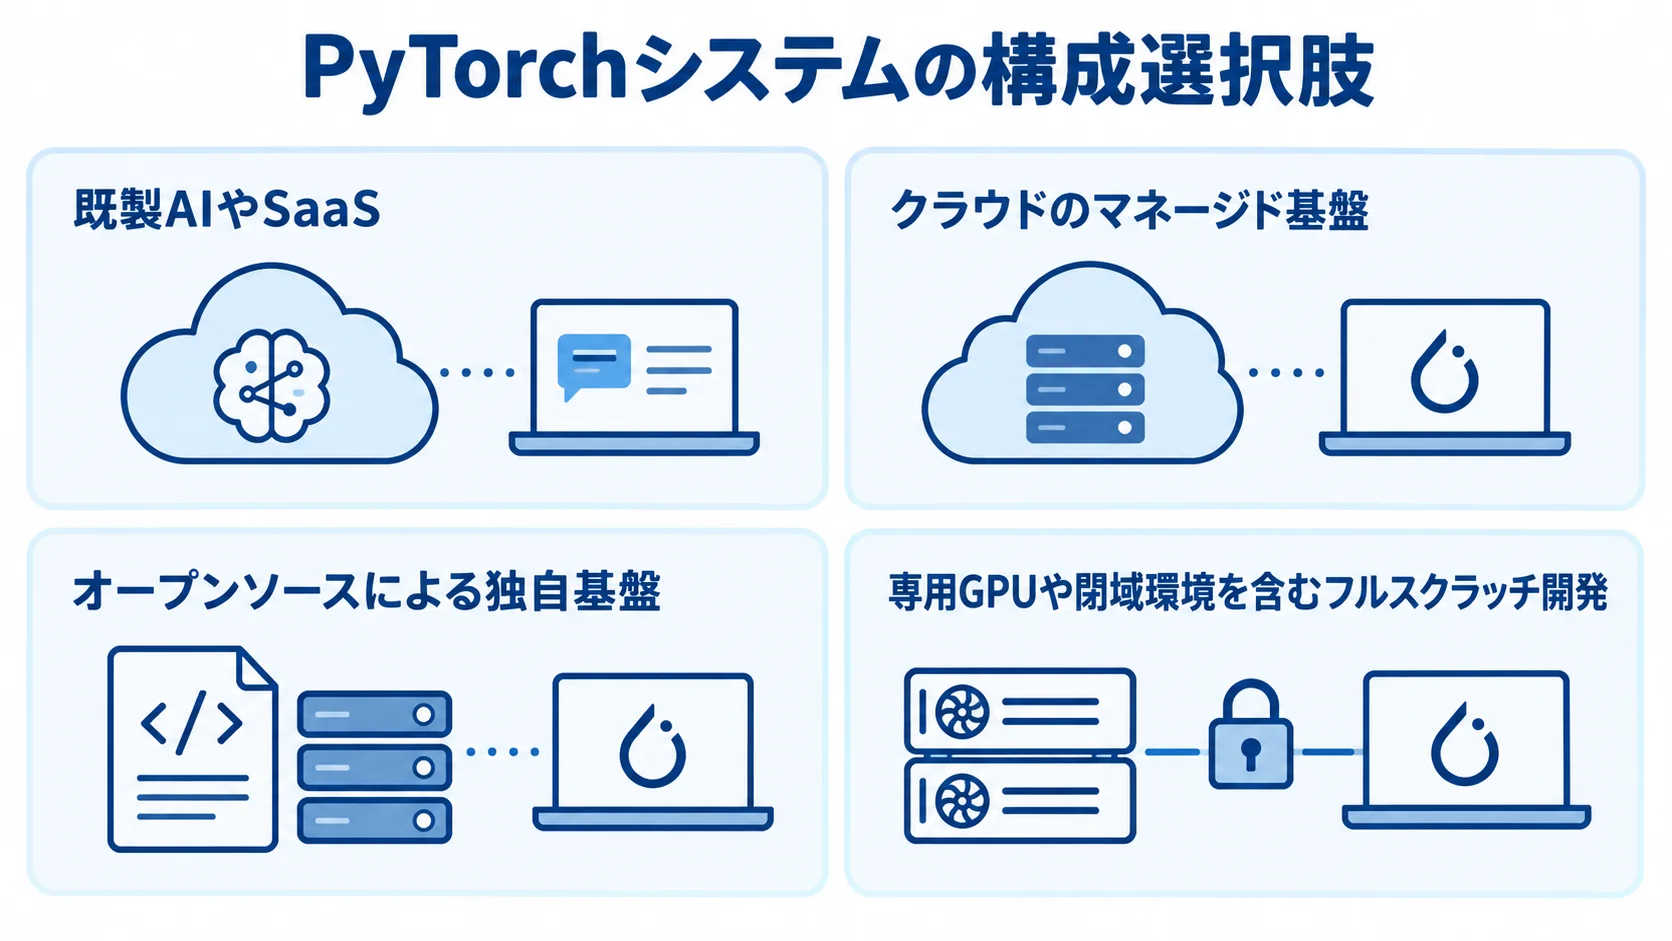
選択肢は、既製AIやSaaSから、クラウドのマネージド基盤、オープンソースによる独自基盤、専用GPUや閉域環境を含むフルスクラッチ開発まで幅があります。
自由度が高いほど、運用の責任も増えます。そこで、データの機密性や処理量、更新頻度を見て、現場の体制とあわせて構成を絞ります。
既製AIやSaaSで足りるケース
文字起こしや一般的な要約は、既製AIやSaaSで短期間に始められる可能性があります。標準的なOCRや問い合わせの一次分類も、この範囲に含まれます。
自社で学習させないため、GPUの調達や学習基盤は不要で、初期費用も抑えやすくなります。
導入前に、データを外部へ渡せるかと、出力を業務で検証できるかを確かめます。
既製サービスの精度が業務要件に届かない場合でも、まずは人手の確認を組み合わせた運用で価値を測ります。その際は、月間処理件数、作業時間、誤判定の許容範囲も確かめます。
独自開発を急がず、差別化が必要な部分だけをPyTorchで作る構成も有効です。
- 外部データの扱い:保存期間と再学習利用の可否を見ます。
- 業務適合性:出力を検証できるか、誤りを人が直せるかで判断します。
- 費用対効果:処理件数と作業削減をもとに、利用料と独自開発費を比べます。
クラウドのマネージド基盤を使うケース
クラウド基盤はGPUを必要な時間だけ借りられるため、PoC用サーバーの購入を避けられます。
- 基盤機能:学習ジョブやモデル登録、推論エンドポイント、ログ、監視を組み合わせて使えます。
- 拡張性:データが増えたときの拡張や、複数環境の分離を設計できます。
- 利用条件:採用前に、従量課金の上限、GPU自動停止、開発・検証・本番のアカウント分離、利用可能なリージョン、閉域接続の要件を決めます。
料金は、VMやストレージ、ネットワークにかかります。さらに、ログやデータ転送、推論の待機にも発生します。ただし、クラウドを使っても、モデル精度の評価やデータ責任の範囲までは自動化されません。
独自モデル・閉域環境を作るケース
既製AIでは差がつかないため、自社固有のデータを活かせる独自モデルを検討します。
- 独自化の対象:固有の画像や専門用語、設備データ、顧客履歴を使います。
- 実行環境:閉域接続、専用テナント、オンプレミスGPU、社内データセンターから選べます。
- 処理方式:リアルタイムか夜間バッチかによって、GPUやAPIの構成が変わります。
モデル学習コードに加え、データの版管理や推論環境、依存ライブラリも、資産として管理します。バックアップ、障害復旧、再学習の手順も、管理の対象に含めます。
特定のGPUやドライバーに依存すると、交換費用や移行期間が増えます。そのため、CPU、異なるGPU、量子化モデルで早めに測り、移植性を確かめます。
PyTorchのシステム開発の進め方
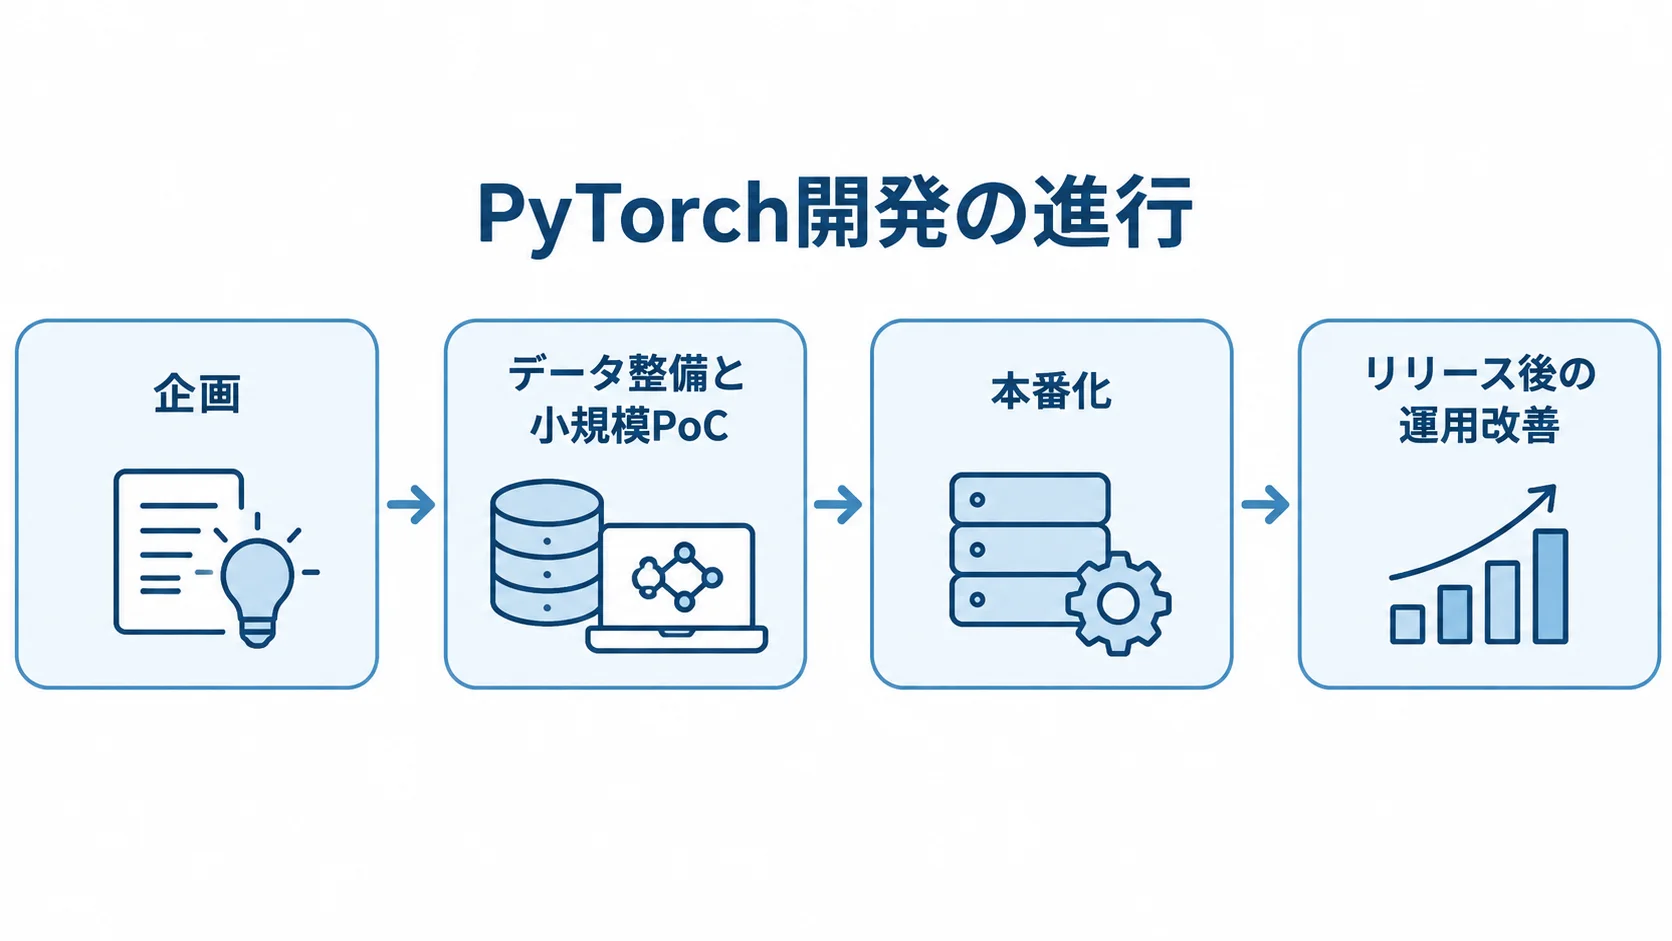
まず企画を立て、データを洗い出し、小規模PoCで実現性を確かめます。そのうえで本番設計に進み、段階リリースと運用改善へとつなげます。
精度だけでなく、業務成果につながるKPIを定義します。たとえば、作業時間や見逃し率、誤検知率、問い合わせ対応時間が挙げられます。さらに、予測誤差や1件あたりの推論コストも指標になります。
企画での課題とKPIの定義
「AIを導入したい」という要望は、検品担当者の確認時間を30%短縮する、担当者1人が問い合わせを1日100件振り分ける、といった目標に置き換えます。
正解率が高くても、確認に時間がかかる、誤検知が多い、結果を説明できない場合は失敗です。そこで、結果を誰が承認し、誤りを誰が直すかも決めます。
対象業務の範囲を決めたら、データの所有者や利用目的、保存期間、個人情報の扱いを確認します。また、既存API、教師データと評価データの分離も見ます。
納品するものには、要件定義書とKPI定義を含めます。
- 業務目標:確認時間や処理件数など、成果を測れる指標にします。
- 対象範囲:1部門、1製品、1帳票などに限定します。
- 準備資料:データ一覧、リスク一覧、概算費用、PoCの合格条件を整理します。
データ整備と小規模PoCによる実現性の確認
データは件数だけでなく、品質や偏りも調べます。その後、小規模PoCで実現性を確かめます。
- データ品質:ラベルの一貫性や欠損、重複、季節性、現場ごとの偏りを確認します。
- 画像・文書:不良品比率が実際の発生割合と合うか、照明やカメラの差、ラベルの違い、個人情報のマスキングを調べます。
- PoC評価:精度や推論速度、現場の修正時間、再現性を測ります。学習時間、GPU利用量、1件あたりのコストも見ます。
- 予算と期間:調査・小規模PoCは300万〜800万円、1〜3か月が目安です。
費用はアノテーション量や既存システムとの接続範囲で変わるため、モデル開発だけの金額とは限りません。
本番化でのモデルと業務システムの一体設計
本番設計では、環境と運用責任を整理したうえで、段階的にリリースします。
- 環境の分離:学習と推論の環境を分けたうえで、モデルレジストリやAPI、認証認可の責任範囲を決めます。
- 計算資源:学習は一時的な高性能GPU、推論はCPUや低コストの推論用アクセラレーターなど、処理特性に合わせて使い分けます。
- 公開の順序:まずシャドー運用で様子を見てから、限定ユーザー、カナリアリリース、全社展開の順に広げます。
- 切り戻しの備え:旧モデルとの比較、ロールバック、更新の承認者を決めておきます。
シャドー運用では、業務判断をすぐに自動化しません。障害時の手動運用も用意し、精度低下や想定外の出力に備えます。ログと監視、バックアップも同じ考え方で決め、CI/CDと再学習も対象に含めます。
リリース後の精度・費用・データの変化への対応
本番稼働後は、評価データを定期的に採取します。製品仕様や顧客層、季節、設備、入力形式が変わると、データドリフトが起こります。
- 精度の確認:正解データが後から得られる業務では、一定期間後に予測と実績を照合します。
- 運用KPI:正解率やF1値、処理時間、APIエラー率を追います。月間GPU費や更新日数、手動修正率も確かめます。
- 継続判断:精度と費用、現場の修正時間を合わせて見たうえで、モデルを続けるか既製サービスへ戻すかを決めます。
照合結果をもとに、再学習の条件を決めます。ただし、精度が1ポイント上がっても、GPU費が倍になり現場の修正時間も増えるなら、全体として最適とはいえません。
月次や四半期のレビューで、運用を続けるかどうかを判断します。
PyTorchのシステム開発費用相場とコストの内訳
PyTorch専用の一律価格表は、ほとんどありません。費用は、モデルの難易度やデータ量と品質、アノテーション、GPU台数で変わります。さらに、既存連携、セキュリティ、可用性、保守範囲によっても変わります。
予算を立てる段階の推定レンジは、次のとおりです。正式な見積では、要件定義の後に作業範囲と納品物を分けて、改めて計算します。
▶ 詳細はこちら:PyTorchのシステム開発の見積相場や費用/コスト/値段について
規模別の初期費用と期間の目安
開発規模ごとの費用と期間は、対象範囲や本番要件で変わります。
- 小規模PoC:300万〜800万円、1〜3か月が目安です。
- MVP・パイロット:800万〜2,000万円、3〜6か月が目安です。
- 本番業務システム:2,000万〜5,000万円、6〜12か月が目安です。
- 全社基盤:5,000万円〜1億円超、12〜24か月以上の場合があります。
小規模PoCは、1業務・1モデルに絞り、少量の既存データを使って評価画面まで作る想定です。
MVPやパイロットには、データ連携、学習パイプライン、推論API、簡易監視を含みます。
本番業務システムでは、複数モデルや業務画面、権限、監査を含めると作業が増えます。CI/CDや再学習も含めると、作業はさらに膨らみます。
全社基盤では、複数拠点や閉域接続、冗長化が求められる場合があります。基幹連携や24時間運用を要することもあります。
一般的な業務システムの相場は、PoCなどの開発段階とは別の規模区分で示されており、小規模区分は300万〜1,000万円です。
PyTorch案件には、データ整備、アノテーション、モデル評価、GPU環境、MLOpsも加わるため、画面数だけでは見積もれません(出典: 業務システム開発の公開Q&A・相場情報、2026年確認)。
見積書の工程別の内訳
発注側は、見積書を工程と担当体制に分けてもらい、作業範囲を比べられる形にします。
- 工程:要件定義、データ整備、アノテーション、モデル開発、学習基盤、推論APIを分けて書きます。
- システム作業:業務画面や既存連携、テスト、セキュリティ、移行、研修、保守を確認します。
- 担当者:プロジェクトマネージャー、機械学習・データ・アプリケーションの各エンジニア、インフラ担当、業務側検証担当の役割を明示します。
モデル開発費が安くても、データ整備や本番運用が別見積になっていれば、総額は変わります。そこで、工程ごとの前提データや回数、納品物、検収条件を確認します。
人月から逆算する場合も、各役割の工数を分けて見積もる必要があります。レビュー、セキュリティ審査、現場テスト、再学習、障害対応にも工数がかかります。
担当領域を削ると、納品後に不足分を自社で補うことになります。
GPU・クラウド・保守のランニングコスト
GPU費は、学習用と推論用を分けて考えます。クラウド価格表の例では、T4の料金は1GPUあたり0.35米ドル/時間です。
- GPU利用料:730時間では255.5米ドル、1ドル155円換算で約4万円です。
- 別料金:VMやディスク、ネットワーク、監視、転送にも料金がかかります。
- 稼働の工夫:常時GPUを起動する設計は、価格改定後も安いとは限りません。低頻度推論のバッチ化やアイドル時停止、CPUや量子化モデルで抑えます。
- 保守費:初期開発費の年15〜25%程度が目安で、更新や脆弱性対応、再学習などを含みます。
実際の請求額は、リージョン、契約、割引、稼働率で変わります(出典: 主要クラウドの公式GPU価格表、2026年8月確認)。
2025年にはGPU向けインスタンス料金を最大45%引き下げ、2026年7月にはGPUを使うコンテナ管理料金を最大60%引き下げる発表がありました(出典: 主要クラウドの公式料金改定発表、2025〜2026年)。
保守には、PyTorchやPython、CUDAやROCm、コンテナ、周辺パッケージの更新が含まれます。さらに、脆弱性対応や精度劣化の調査、再学習、データ追加、問い合わせ、障害対応も対象です。
契約には、対応時間や受付時間、復旧目標を明記します。再学習回数と追加開発単価も、あわせて明記します。
PyTorchの開発会社・ベンダーの選び方
選ぶ相手は、PyTorchを業務に組み込み、納品後も運用できる会社です。会社の種類は、受託SI、機械学習に強い会社、クラウド基盤支援、GPUや推論基盤に詳しい会社など様々で、役割も異なります。
まず候補の種類を分け、必要な工程をどこまで任せるかを決めます。
近い業務とデータの実績
AI案件の有無だけでなく、自社に近いデータ形式や業界規制、処理量、業務フローの経験を確認します。特に、画像や文書、時系列、音声では前処理と評価方法が異なります。
可能であれば、PoCだけでなく、本番後の精度や推論遅延、再学習、障害対応について聞きます。守秘義務があっても、課題やデータ件数の桁、更新頻度、利用者数は確認できます。SLA、納品物、運用期間も確かめられます。
失敗の条件や、採用しなかった方式まで説明できる相手は、要件を見極められる可能性があります。
モデル以外のMLOps・セキュリティ力の評価
学習コードやデータ加工、モデルレジストリを確認します。API化、コンテナ、CI/CD、監視、ロールバックも見ます。
納品範囲に、データ加工の処理とモデル評価レポートが含まれるかも確認します。
提案時には、平均推論値に加えて、同時アクセス数やメモリ使用量を確かめます。
機密データでは、MFA、暗号化、秘密情報の分離、環境分離を要件にします。バックアップも要件に加えます。また、モデルと依存パッケージの検査を担う人も確認します。
- 開発資産:コードや評価、環境定義、テスト、手順書について、納品範囲を確認します。
- 性能と復旧:ピーク時の遅延や障害時の復旧時間を確認します。
- 安全管理:最小権限、監査ログ、脆弱性対応、更新担当を決めます。
契約・権利・運用体制の事前整理
契約では、権利と納品後の役割を明確にします。価格や技術、体制も、同じ条件で比べます。
- 権利と納品:ソースコードや学習済みモデル、学習・評価データの範囲を記します。アノテーション、IaC、設定、ログ、文書も含めます。
- 契約条件:第三者ライセンスや再委託、目的外利用、終了時の消去を確認します。他社へ移る際の協力範囲も見ておきます。
- 担当者:開発責任者、機械学習・データ・アプリ・インフラ担当、業務側窓口を明確にします。
- 運用条件:担当変更時の引き継ぎ、受付時間、障害優先度、再学習条件、追加費用の扱いを決めます。
これらが曖昧なままだと、運用開始後に判断が止まる場合があります。
▶ 詳細はこちら:PyTorchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:PyTorchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
▶ 詳細はこちら:PyTorchのシステム開発の発注/外注/依頼/委託方法について
PyTorchのシステムのセキュリティと運用の設計
データ保護とモデル更新の安全対策は、一体で考えます。個人情報や機密文書を扱う場合は、利用目的、アクセス権、保存期間、匿名化、委託先管理を定めます。
モデルもコードと同じように版管理し、作成者や学習データ、通過した評価結果を追跡できるようにします。
モデルファイルと依存関係の安全な扱い
2025年に公表されたCVE-2025-32434では、torch.loadのモデル読込に脆弱性が報告されました。対象はPyTorch 2.5.1以前で、2.6.0で修正されています。
- 依存関係:信頼できないモデルは読み込まず、依存関係は固定と更新を行い、検証環境でスキャンします。
- 保存形式:コード実行のリスクや読込速度、互換性、周辺ツールの対応で比べます。
- 配布とリリース:アップロード権限、署名やハッシュ値、検証済みレジストリを使い、本番反映には承認を通します。
NISTの脆弱性データベースでは深刻度9.8のCriticalです(出典: NIST National Vulnerability Database、2026年6月更新)。
開発環境から本番環境へ、モデルファイルを直接コピーしない運用にします。
監視でのデータドリフトと費用の確認
予測値だけでは劣化を見つけにくいため、カテゴリの増減や予測の信頼度も記録します。
正解が後から得られる業務では、予測時点のログと実績データを結合し、一定期間ごとに評価します。
GPUメモリやCPU使用率、キュー長も監視します。
誤検知が増えたときは、モデルだけでなく、センサー、カメラ、入力画面、前処理、業務ルールの変更も調べます。
- モデルとデータ:分布、欠損、偏り、正解判明までの時間を記録します。
- 性能と費用:応答、タイムアウト、資源使用量、推論費を追います。
- 対応体制:通知で終わらせず、担当者や一次対応、ロールバック、再学習の判断条件を手順書に記します。
法務・権利・人の確認の仕組み
法務や権利の確認に加えて、人が結果を見直せる仕組みを用意します。
- 個人情報:利用目的、本人への説明、委託先、保管場所、保存期間、削除方法を確認します。別目的での再学習では、契約と社内規程を見ます。
- 人の判断:人の評価や取引に使う場合は、異議申立てや再確認の手順を設けます。
- 権利関係:画像・文書の著作権や第三者データの許諾を確認します。モデルの出力や成果物の著作権、翻案権、再利用範囲は、契約に記します。
重要な判断には人の確認を残し、誤判断の訂正と記録を可能にします。
PyTorchを採用しない方がよいケース
すべてのAI案件にPyTorchが必要なわけではありません。たとえば、既製APIやSaaSでKPIを達成できる場合、教師データを用意できない場合、予測結果を使う業務が定まらない場合は、独自開発を急がない方が安全です。
技術の導入そのものを目的にせず、費用、運用負荷、改善効果を比べます。
既製サービスで費用対効果が合う場合
月間処理件数が少なく、入力形式が標準的で、多少の誤りを人が直せる場合は、従量課金サービスが合理的です。
独自モデルには、データ準備や学習、評価に加えて、API、監視、更新も必要です。そのうえで、利用料や作業削減時間、外部にデータを預けるリスクを並べ、3年間の総費用を比べます。
データや運用体制が整っていない場合
データや運用体制が不十分な場合は、モデル開発より先に、実務の基盤づくりに取り組みます。
- データ品質:正解データと統一されたラベル基準を用意し、入力品質を安定させます。
- 記録と確認:入力ルール、データ保存、誤りを残す方法、現場での確かめ方を用意します。
- PoCの時期:数か月分の実績がたまってから進める方法もあります。
- 運用担当:監視・修正の担当者、予算、レビュー時間を確保します。
モデルはデータや業務の変化に合わせて更新します。そのため、体制を確保できない場合は、本番化を急がず運用負荷の低い方式を選びます。
単純なルールや集計で解ける場合
条件分岐、集計、検索、しきい値だけで説明できる場合は、通常の業務システムや統計処理の方が保守しやすいことがあります。
PyTorchは、複雑なパターンをデータから学ぶ場面で力を発揮します。一方で、ルールで足りる業務に導入すると、説明責任や脆弱性対応、再学習の負担が増える可能性があります。
PyTorchのシステムに関するよくある質問
PyTorchのシステムを検討する際によく出る疑問に、順に答えます。
PyTorchを導入すればAIシステムが完成しますか?
いいえ。PyTorchはモデルを学習・推論するフレームワークのため、業務画面やデータ連携、権限、監視、保守は別途必要です。
業務データを用意してモデルを評価し、推論結果を業務フローに組み込んで、初めてシステムとして使えます。
PyTorchのシステムには必ずGPUが必要ですか?
GPUが有効なのは、大規模画像・言語モデルの学習や高頻度のリアルタイム推論の場合です。逆にいえば、そうでない場合は必須とはいえません。
低頻度の需要予測や小規模分類をバッチ処理する場合は、CPUで足りることがあります。そこで、PoCではCPU、低価格GPU、クラウドGPUを、処理時間と費用で比べます。
PyTorchのシステム開発費用はどのくらいですか?
調査・小規模PoCは300万〜800万円、MVP・パイロットは800万〜2,000万円、本番業務システムは2,000万〜5,000万円が目安です。
大規模な閉域基盤や基幹連携では、5,000万円〜1億円超になる場合があります。データ整備やGPU費、セキュリティ、保守をどこまで含むかで総額が変わるため、工程別の見積を取ります。
開発会社へ相談するときに何を準備すればよいですか?
業務課題、対象データ、作業時間、目標KPIを整理します。利用者数、更新頻度、個人情報、既存システム、希望時期、予算上限も、あわせて伝えます。
正解データがあれば、サンプルを用意します。渡せない場合も、件数や形式は共有します。そのうえで、求める成果物として、コード、モデル、評価レポート、手順書、保守体制を伝えます。
まとめ
PyTorchのシステムは、モデルだけでなく、データや推論、業務画面を含む業務基盤です。監視やセキュリティ、契約、運用も、その一部として設計します。
採用時は、精度のほか、作業削減、人手確認、推論遅延を評価します。さらに、GPU費や再学習日数、モデルファイルの安全性も見ます。
成功しやすい導入の要点
業務KPIを決めたうえで、データを洗い出し、小さなPoCで精度と費用、現場の使いやすさを測ります。
本番では学習と推論の環境を分け、モデルと依存関係を版管理し、シャドー運用から段階的に展開します。
費用は開発費だけでなく、GPU、データ、セキュリティ、保守を含めた総額で判断します。
次に行うこと
導入を相談する前に、業務の前提を整理しておきます。そのうえで、次の順に進めます。
- 対象業務を一つに絞ったうえで、入力データや正解データ、目標KPIを整理します。利用者、処理頻度、機密性、納品物も書き出します。
- 整理した内容をもとに、PoCの合格条件と工程別の見積を作り、複数の候補に示して比べます。
導入の基準として重要なのは、導入後に業務成果を継続して出せるかです。PyTorchを使うこと自体は、その手段にすぎません。
▼関連記事一覧
・PyTorchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・PyTorchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・PyTorchのシステム開発の見積相場や費用/コスト/値段について
・PyTorchのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。