
PyTorchのシステム開発を発注するには、業務とデータを定め、PoCで確かめ、契約後に開発と運用へ進むのが基本の流れです。
この流れで進めると、PoCで確かめた内容を契約後の開発に生かせるため、業務利用につながります。発注形態から委託先の選び方まで、順に説明します。
▼全体ガイドの記事
・PyTorchのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
PyTorchのシステムを発注・外注する前に知るべき全体像
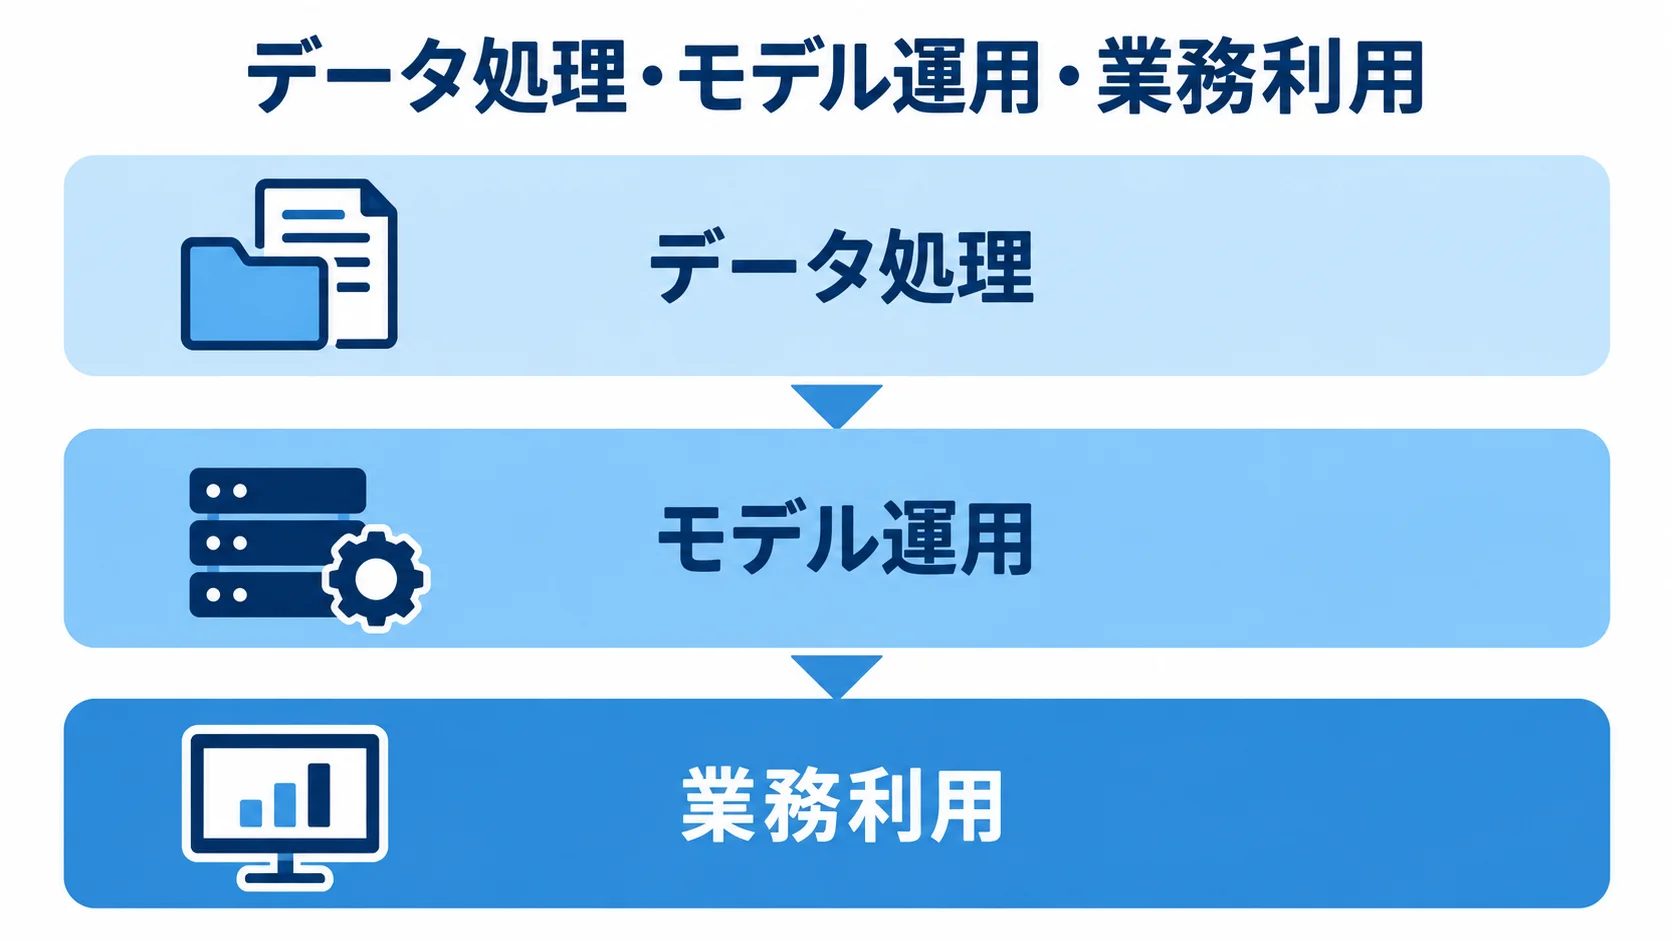
PyTorchのシステムは、前処理したデータでモデルを学習・評価し、その結果を業務画面や既存システムへ返す仕組みです。
コードだけの納品を受けると、データ更新や精度確認、障害時の切り戻し、再学習を自社だけで続けにくくなります。発注する前に、発注側と委託先のどちらがどこまでを担うか、稼働後の運用方法を決めておきます。
PyTorchの位置づけ:AIエンジン
PyTorchは、PythonやC++でテンソル計算やニューラルネットワークの学習・評価・推論を実装するOSSです。画像認識や需要予測、異常検知に使えます。さらに、文書分類やレコメンド、生成AIにも使えます。
販売管理や顧客管理のような完成済みの機能は含まれていないため、委託先が業務システムに必要な構成要素を組み合わせて作ります。
- データ処理:データベース、ETL、前処理、ラベル付け
- モデル運用:モデルレジストリ、推論API、ログ、監視
- 業務利用:業務画面、認証、権限
2025年8月公開のPyTorch 2.8では、限定的な安定libtorch ABIが紹介されました。さらに、Intel CPUでの量子化LLM推論、Wheel Variants、ROCm 7の新GPU対応も含まれます(出典: PyTorch Foundation「PyTorch 2.8 Release Blog」、2025年)。
発注側は、委託先にPyTorchの経験があるかに加えて、CPU・NVIDIA・AMD間の移植性と、バージョン更新の検証方法も確かめます。
発注範囲:モデル開発から運用まで
最初に、データを洗い出し、匿名化と欠損・偏りの確認を行ったうえで、学習用と評価用に分けます。
- モデルを開発し、推論用APIとして公開します。
- 業務画面や既存システムとつなぎ、権限設定、テスト、デプロイまでを担います。
- 運用後の精度劣化、データドリフト、推論遅延、GPU費用、再学習を管理します。
納品物には、コードや学習済みモデル、データ加工処理を含めます。さらに、学習・評価データの定義と評価レポートも納品の対象になります。
API仕様、インフラ設定、テスト・監視項目も求められます。そのほか、再学習・切り戻し手順と運用マニュアルも用意します。
成果は精度だけでなく、入力時間、見逃し率、誤検知率でも測ります。加えて、1件あたりの推論費用と再学習日数も指標にします。
発注形態の選び方|PoC・請負・準委任
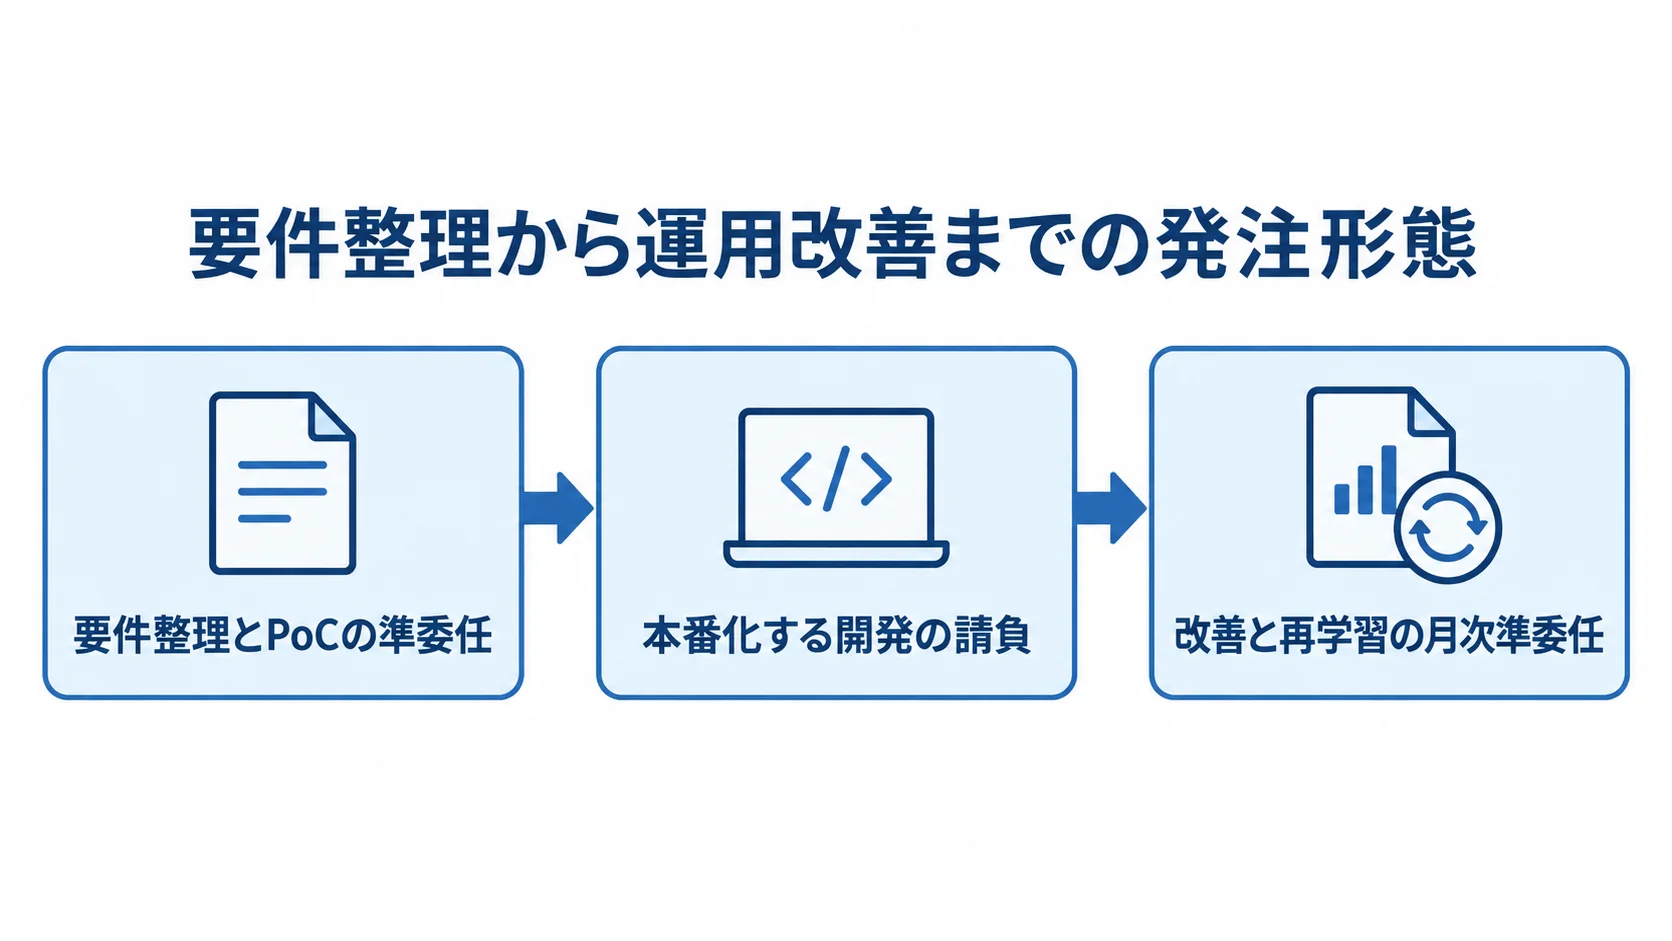
発注形態は、データの品質や実現性、納期を固定するかどうか、発注者がどこまで判断するかで決めます。
初めてAIシステムを作る場合は、検証と本開発を分けると、予算やリスクを段階ごとに管理しやすくなります。
不確実性が大きい場合のPoC
データ量やラベルの一貫性、業務で許容できる精度が不明なら、PoCで代表データを検証します。また、対象は1部門、1製品、1帳票などに絞り、現場の担当者が推論結果を確かめられる画面まで作ります。
- 評価条件:使用データ、評価指標、誤判定の傾向
- 実行条件:推論時間、必要なGPUやCPU
- 次工程:再学習方法、本番化の課題、後続工程の概算
終了条件は、「精度が何パーセント以上」「1件の推論が何秒以内」「担当者が結果を修正できる」など、判定できる形にします。
要件が確定した部分の請負
入力データやモデルの役割などが確定した範囲は、成果物と納期を定める請負で発注できます。
- 成果物:モデル、コード、設計書、テスト結果、評価レポート、インフラ設定、マニュアル
- 変更時の扱い:データ・モデル・利用者・連携先を追加する場合は、費用や納期を見直す
- 精度改善:「精度を上げる」を、対象データ、評価方法、改善回数、性能条件に分けて考える
- 変更基準:業務ルールの変更は追加改修、仕様に合わない場合は瑕疵対応にあたる
要件整理や改善を伴う案件の準委任・ハイブリッド
データ調査や課題整理を、モデル選択や評価指標の設計とあわせて共同で進める場合は、準委任が適しています。
発注側のプロダクトオーナーが優先順位を決め、委託先はデータサイエンスやMLOps、API開発を支援します。
- 要件整理とPoCは準委任で進めます。
- 本番化するモデルや画面の開発は請負で行います。
- リリース後の改善と再学習は、月次の準委任とします。
契約を分けても、権利やモデル・データの引き渡し、障害窓口、統括責任者は、契約の間で途切れないようにします。
RFPと要件整理|PyTorchの外注範囲の決め方
RFPは、候補会社に同じ条件で伝えるための文書です。伝える内容は、目的や利用者、データ、本番品質です。
機能一覧だけを示すと、候補会社ごとに工程の範囲が異なり、安い見積もりにデータ整備や運用が含まれていない場合もあります。
業務課題とKPIの記載
RFPの冒頭には、「AIを導入する」といった目的より先に、現状の業務課題と測定値を書きます。
- 作業時間:画像検品、問い合わせ分類、文書検索にかかる時間
- 業務差:需要予測と実績の差、異常発見までの時間
- 対象範囲:部門、拠点、利用者の役割、処理件数、繁忙期
KPIには、適合率や再現率、見逃し率、誤検知率を含めます。さらに、応答時間と担当者の確認時間、1件あたりの推論費用、再学習日数も測ります。そのうえで、誤判定が起きたときに人が直すか、自動処理を止めるかを決めておきます。
データとモデルの要件の分け方
発注側は、データ要件とモデル要件を分け、候補会社が見積もれる形で記載します。
- データの基本情報:所有者、保存場所、形式、件数、期間、欠損、重複、ラベル
- データの利用条件:個人・機密情報、利用目的、保存期間、学習・評価データの分離
- データ固有の条件:画像の解像度・撮影条件、文書の帳票・文字崩れ、需要予測の季節性・休日
- モデルの要件:入力・出力、候補、評価方法、許容誤判定、推論頻度、同時実行数、許容遅延
- モデル運用:再学習周期、版管理、切り戻し、再評価と本番反映の担当者
連携・非機能・セキュリティの別紙記載
連携条件、非機能要件、セキュリティ条件は、RFPの別紙に分けて具体的に書きます。
- 既存連携:対象システム、方式、方向、頻度、データ量、テスト環境、再送、改修担当
- 見積範囲:連携元の改修費やデータ移行費を含めるか明記する
- 非機能:可用性、応答時間、同時利用者数、バックアップ、復旧目標、ログ保存期間
- セキュリティ:暗号化、MFA、最小権限、保管地域、脆弱性スキャン、環境分離
- モデル管理:脆弱性対応もRFPの要件に含める
PyTorch 2.5.1以前のtorch.loadには、脆弱性CVE-2025-32434があります。なお、NISTのNVDによると、2.6.0で修正されています(出典: NIST National Vulnerability Database「CVE-2025-32434」、2026年6月更新)。
そのため、モデルファイルと依存パッケージも管理対象です。発注側は、信頼できないモデルを避け、依存関係を固定し、更新を検証環境で試す条件をRFPに入れます。
PyTorchのシステム開発の進め方|発注者が参加する工程
開発は、企画とデータ調査、PoCの順に始まります。そのあと、設計と実装、テストとリリースを経て、運用改善へ進みます。
発注者は、優先順位やデータの利用可否、受入条件を判断します。委託先は、モデルとシステムを実装します。
企画とPoCでの対象業務と成功条件
全社の業務を一度に扱うのではなく、効果が大きく、データにアクセスでき、現場の評価者を確保できる業務から絞ります。
- 対象例:画像検査、問い合わせ分類、帳票項目の抽出、需要予測
- 定義:入力と出力を定め、現場が評価できる形にする
PoCでは、正常なデータだけでなく、欠損や重複、古い形式のデータも試します。さらに、権限のない利用者による利用も試します。
APIのタイムアウトや、予測しにくい季節変動も検証します。ただし、精度が目標を満たしていても、確認時間や費用が大きければ、設計を見直します。
設計・開発でのモデルと業務システムの分離
本番運用へ安全に引き継ぐため、設計の段階で、構成や再現性、誤判定への対応、会社間の責任を決めます。
- システム構成:データの流れ、学習環境、モデルレジストリ、推論API、業務画面、認証、監視、バックアップ
- 再現性:学習・本番データを分け、モデル版、依存ライブラリ、学習条件を記録する
- 誤判定への対応:修正画面、低信頼度結果の保留、処理履歴、旧モデルへの切り戻しを設ける
- 会社間の責任:別会社が開発する場合、API、データ形式、障害切り分けを定める
画像や文章の推論結果をそのまま自動で確定させると、誤判定が業務事故につながる場合があります。
テスト・リリース・運用での品質確認
テストでは、評価指標やAPIの応答時間、同時実行、データ整合性を確かめます。権限や監査ログ、バックアップ・復旧、依存ライブラリの脆弱性も試験します。そのうえで、担当者が代表業務を通して受入確認を行います。
AIの結果を人が修正したとき、その内容が後続の処理や学習データに正しく反映されるかも確かめます。
- シャドー運用で結果を確かめます。
- 限定ユーザーに広げます。
- カナリアリリースを経て、全社に展開します。
運用後は、精度や誤判定、データドリフト、遅延を記録します。さらに、GPU・CPUの使用率、推論費用、障害件数も残します。
保守では、監視時間や一次対応、再学習回数をSLAに定めます。報告書と対応時間も、SLAに含めます。
モデル更新の前後で、これらの指標を比べ、更新の影響を確かめます。
契約形態と責任分界を決めるポイント
契約では、成果物と、データ準備や合否判断を担う者を定めます。障害や精度低下への対応範囲も、契約に書いておきます。
学習データやモデル、コードの扱いが曖昧だと、内製化や移管が難しくなります。クラウド環境やOSSの扱いも、あらかじめ契約で決めておく必要があります。
請負契約の成果物と検収条件
「AIシステム一式」では検収しにくいため、成果物と合格条件を契約に具体的に記します。
- 成果物:対象データ、モデル機能、API、画面、権限、性能、テスト・評価レポート
- 引き渡し物:操作マニュアル、環境設定、ソースコード
- 検収条件:代表データでの評価方法、許容誤差、応答時間、エラー処理、受入テスト
- 追加対応:仕様不具合は無償修正、業務ルール変更は追加開発、データ追加や新帳票は別見積もり
- 精度保証:評価データ、測定期間、データ分布の変化、除外条件を含める
準委任契約の体制と作業範囲
準委任は、精度や本番稼働を保証せず、合意した人材が合意した作業を行う契約です。
- 対象作業:データ分析、特徴量検討、モデル比較
- 技術支援:コードレビュー、MLOps設計
- 契約条件:稼働時間、担当者、成果物頻度、定例会、報告、追加単価
発注者は、業務データの提供と評価の判断、関係部署の承認を担います。
社内に意思決定者とデータ管理者を置くのは、委託先に任せきりだと、作業時間が増えても成果の基準が定まらないためです。
権利・再委託・SLAの契約条件
将来の内製化や移管、運用の責任を明確にするため、契約に、利用や移管、運用費に関する条件を含めます。
- 権利とデータ:利用目的、個人情報の委託、保管場所、モデル所有権、コード・IaCの利用権
- 利用条件:OSSライセンス、汎用部品、生成AI利用時の入力制限
- 移管:アノテーションと前処理コードも引き渡し、他社でも再現できるようにする
- SLA:稼働時間、障害重要度、一次応答、復旧目標、事故報告、更新、再学習
- 運用費:脆弱性対応、バックアップ、監査ログ、再委託条件を定め、保守料と従量料金を分ける
発注側は、月額保守に含む作業と、GPU・クラウドの従量料金の負担者を分けて見積もります。
PyTorchのシステムの費用相場と見積内訳
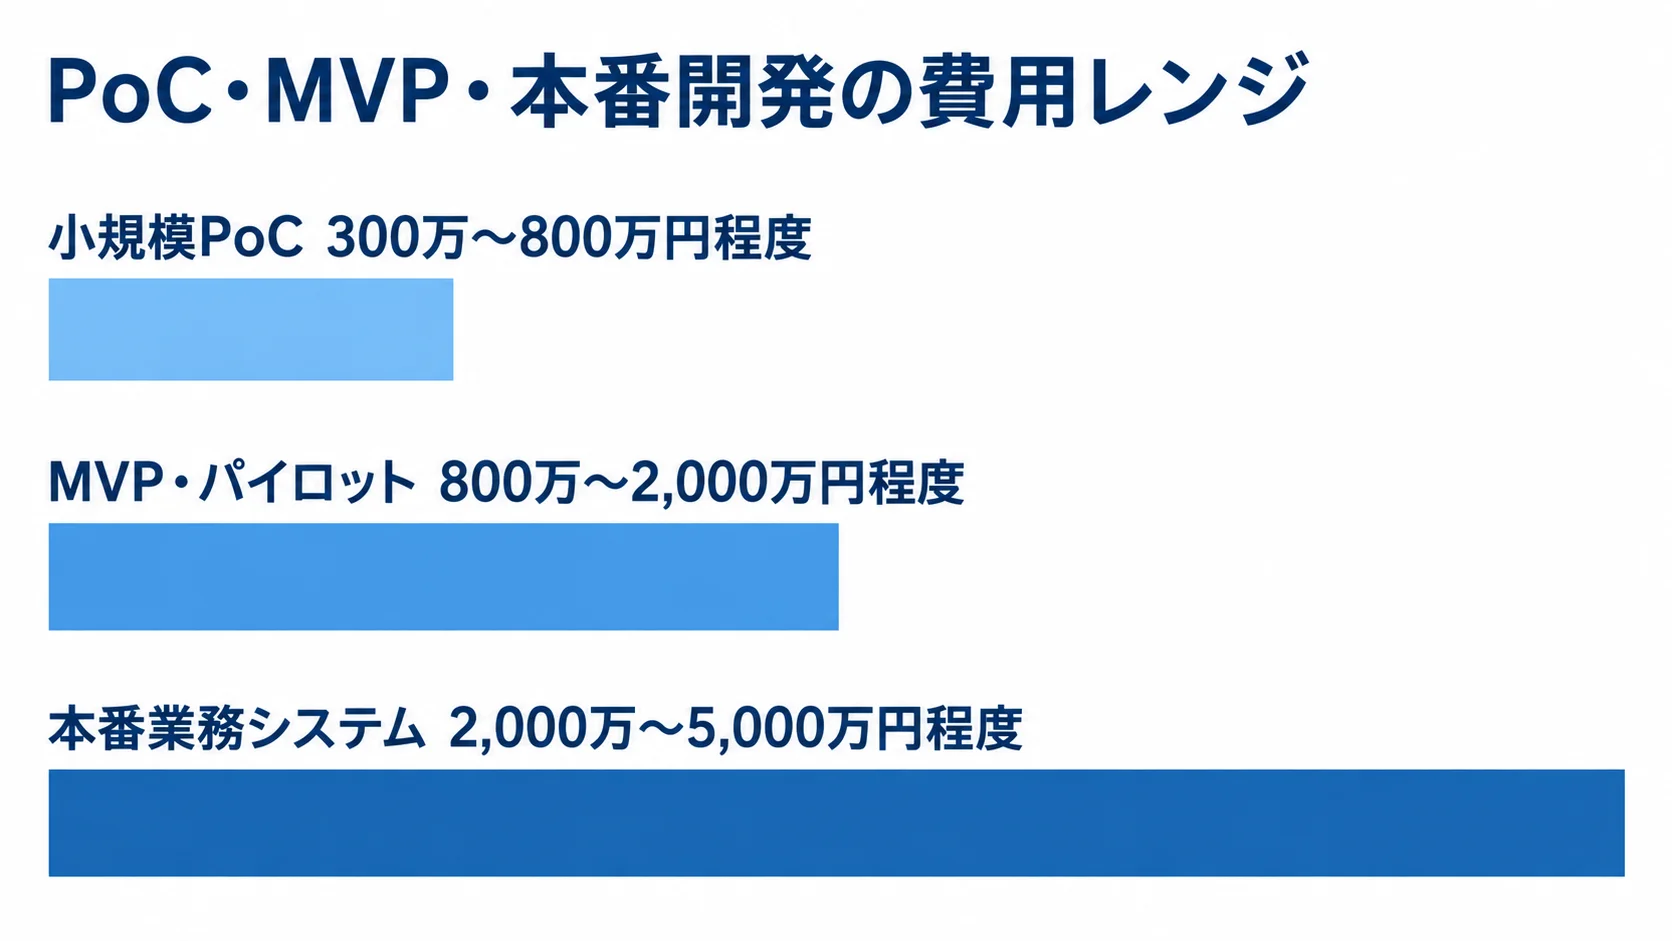
PyTorch専用の受託価格表は、ほとんど公開されていません。費用は、モデルの難易度やデータの量・品質に左右されるほか、GPUの台数や既存連携によっても変わります。
個人情報や可用性、運用体制も、費用に影響します。ここに示す金額は、業務システムの相場にデータ整備・評価・MLOpsの工程を加えた、2026年時点の推定です。予算取りに使う目安として見てもらい、正式な見積もりは要件定義の後に再計算します。
PoC・MVP・本番開発の費用レンジ
費用と期間は、対象範囲や運用条件によって変わります。
- 小規模PoC:1業務・1モデル・既存データの一部・評価画面で300万〜800万円程度、約1〜3か月
- PoCの追加範囲:匿名化、アノテーション、複数モデル比較、既存API連携で上限を超える場合がある
- MVP・パイロット:学習パイプライン、推論API、簡易監視を備え、800万〜2,000万円程度、3〜6か月
- 本番業務システム:画面、複数モデル、権限、監査、CI/CD、再学習、基幹連携を含み、2,000万〜5,000万円程度、6〜12か月
- 全社基盤:複数拠点、閉域接続、冗長化、24時間運用
全社基盤は5,000万円〜1億円超、期間は12〜24か月以上になる場合があります(出典: リサーチノートで収集した業務システム費用Q&Aと工程別試算、2026年)。
見積書のデータ・開発・連携・運用への分解
見積書は、要件定義、データの洗い出しと整備、モデルの設計・学習・評価に分けて作ってもらいます。
API、業務画面、既存連携は、別項目にします。インフラやセキュリティ、テストも、別々の行で示してもらいます。移行や研修、保守は、独立した行として並べてもらいます。
データ整備を発注者が担う前提なら、作業量と担当者を書き、社内の工数も含めて総額で捉えます。
- 作業量が増えやすい項目:ラベル付け、例外処理
- 環境・連携:既存改修、性能試験、機密データの閉域化
- 運用:モデル更新の自動化
画面数やモデル数だけで比べず、作業単位や前提、対象外作業をそろえます。加えて、追加単価や納品物、検収条件も、同じ基準で比べます。
GPU・クラウド費用の試算
Google Cloud価格表ではNVIDIA T4は1GPUあたりオンデマンド0.35米ドル/時間です。
これはGPU部分だけの料金で、VMやディスクに加え、ネットワークや監視は別料金です(出典: Google Cloud「GPU pricing」、2026年8月確認)。
730時間連続で稼働すると、GPU部分だけで約255.5米ドルになります。実額は、リージョンやマシンに加え、契約や割引によって変わります。さらに、利用時間でも変動します。
- 低頻度のバッチ推論:CPUや、必要なときだけ起動するGPUを検討する
- 常時稼働のAPI:推論向けのGPUや専用チップも候補になる
- 費用の分け方:学習と推論を分けると、費用を抑えやすくなります
円換算の金額は断定せず、料金計算機で確かめます。
AWSは2025年6月、一部のNVIDIA GPU搭載EC2の価格と利用モデルを更新しました。P5などでは最大45%の値下げを発表しています(出典: AWS「Pricing and usage model updates for Amazon EC2 instances accelerated by NVIDIA GPUs」、2025年6月5日)。
割引やリージョンで条件が異なるため、通常料金と割引前提を分けて見積もります。停止中の費用やデータ転送料も、別の項目として扱います。
委託先の選定と見積比較で確認すべきポイント
委託先には、受託SIやデータサイエンスに強い会社のほか、クラウド基盤やGPU・推論基盤に強い会社があります。
クラウド会社と、業務課題や画面を担う受託会社では役割が異なります。そのため、必要な工程を定めてから選びます。
不足する役割は、別会社で補うか、一気通貫の会社に任せるかを検討します。
近い業務の実績と運用体制
業務との近さと運用実績を確かめ、技術名だけに頼らないようにします。
- 案件の近さ:データ形式、業界、利用者数、同時実行数、機密性、既存連携
- 運用実績:PoCで終わったか、本番運用を継続しているか
- 確認資料:評価レポート、監視画面、障害対応、再学習の実績を、匿名化したうえで見せてもらう
AWSの事例では、NECが社内AIスーパーコンピューターでモデルを学習し、専用AWS環境のSageMakerとTriton Inference Serverで推論しています(出典: AWS「PyTorch on AWS Customer Stories」、2026年8月確認)。
学習と推論の場所を分ける構成もあります。ただし、自社での効果は、PoCでデータ量や遅延、セキュリティ、費用を確かめる必要があります。
同じ前提・成果物での見積比較
候補会社には同じ条件を示し、金額差の理由まで確かめて比較します。
- 共通前提:業務、データ件数、モデル・利用者数、連携先、納期、クラウド、セキュリティ、保守期間
- 見積項目:要件定義、データ準備、学習、評価、API、画面、インフラ、テスト、移行、研修、保守
- 含有範囲:項目ごとの含有有無と前提を記録し、GPU、アノテーション、連携改修、試験、監視、再学習、障害対応の抜けを探す
- 総額とデモ:追加費用込みで比較し、同じサンプルデータと評価条件でデモを依頼する
- 提案会:結果に加え、失敗時の説明と改善計画を確認する
納品物と移管可能性の選定基準
移管できる成果物と、運用上の問題に対応できる体制を確かめます。
- モデル・データ:学習済みモデル、コード、前処理・アノテーション、データ辞書、評価レポート
- システム:API仕様、IaC、コンテナ定義、テストコード、監視設定、操作・再学習手順
- 移管性:環境変数や手作業の設定が特定担当者に依存しないこと
- 障害対応:PyTorch・CUDA更新、脆弱性、情報漏えい、精度低下、API停止、GPU不足への対応
- 体制:質問への回答、確認ログ、判断者、復旧手順・時間、再委託先、経験、引き継ぎ、窓口
提案書の見栄えより、質問への回答が具体的かを見ます。
PyTorchのシステム発注・外注でよくある質問
初めての発注では、技術やデータ、契約に加えて、費用や運用にも疑問が生じやすくなります。そこで、よくある質問に答えます。
PyTorchのシステムはどのような会社へ外注すればよいですか?
候補になるのは、データ整備や業務連携、推論APIの構築に加えて、監視や保守まで対応できる会社です。近い業界やデータ形式での本番実績と納品物を確認します。
MLOpsやセキュリティ、再学習、障害対応も、あわせて確かめます。クラウド事業者と受託開発会社は、役割を分けて評価します。
PyTorchのシステム開発費はどのくらいですか?
小規模PoCは300万〜800万円程度、MVP・パイロットは800万〜2,000万円程度が目安です。
本番業務システムは2,000万〜5,000万円程度ですが、データ整備や連携、GPUの扱いで変わります。セキュリティや監視、再学習によっても変動します。工程や運用費ごとに、含む範囲を分けて比べます。
GPUは購入とクラウドのどちらがよいですか?
PoCのように利用頻度が低い場合や、学習時だけ大きな計算資源が必要な場合は、クラウドの従量利用で初期投資を抑えやすくなります。
常時稼働や閉域接続が必要な場合、社外に出せないデータを扱う場合、長期利用が明確な場合は、オンプレミスや専用環境も比べます。GPUの保守や電力、交換のリスクに加えて、ドライバー更新や容量不足も含めたうえで、総額で判断します。
PyTorchなら必ず高い精度のAIを作れますか?
PyTorchは開発フレームワークであり、精度を自動では保証しません。結果は、データの量や品質、ラベルの一貫性で変わります。さらに、モデルや評価データ、許容誤判定、運用後の再学習によっても左右されます。
PoCで自社データを試し、精度だけでなく処理時間と費用も含めて採用を判断します。
まとめ|PyTorchのシステム発注は運用まで含めた比較
委託先は、技術名や精度だけで決めず、業務課題とKPIを定めたうえで、データを洗い出します。必要ならPoCで確かめ、RFPにモデルやAPI、画面、連携の要件を記します。認証や監視、再学習、障害対応も、あわせて書いておきます。
発注前に確認する項目
発注形態と費用項目を整理したうえで、前提や対象外作業を含めた総額で判断します。
- 契約形態:不明点はPoCや準委任で検証し、確定した成果物は請負で発注する
- 予算目安:PoCは300万〜800万円程度、本番は2,000万〜5,000万円程度
- 費用範囲:データ整備、GPU・クラウド、連携、セキュリティ、保守を分ける
運用・移管・安全性まで確認した選定
委託先を選ぶ際は、長期運用に備えて、移管や契約、継続運用の条件を確かめます。
- 移管用の成果物:データ加工、評価、コード、IaC、テスト、監視、再学習、ロールバック
- 契約と安全性:更新・脆弱性対応、責任分界、権利、再委託、SLAを明記する
- 継続運用:作業時間と推論費用を測り、PoC後も業務で使える状態にする
▼全体ガイドの記事
・PyTorchのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。