
PyTorchのシステム開発は、業務課題とKPIを整理する要件整理から始めます。そのあと、方式と開発会社を選び、設計開発、テスト、段階稼働を経て、業務への定着につなげる流れで進みます。
▼全体ガイドの記事
・PyTorchのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
PyTorchのシステム開発の全体像
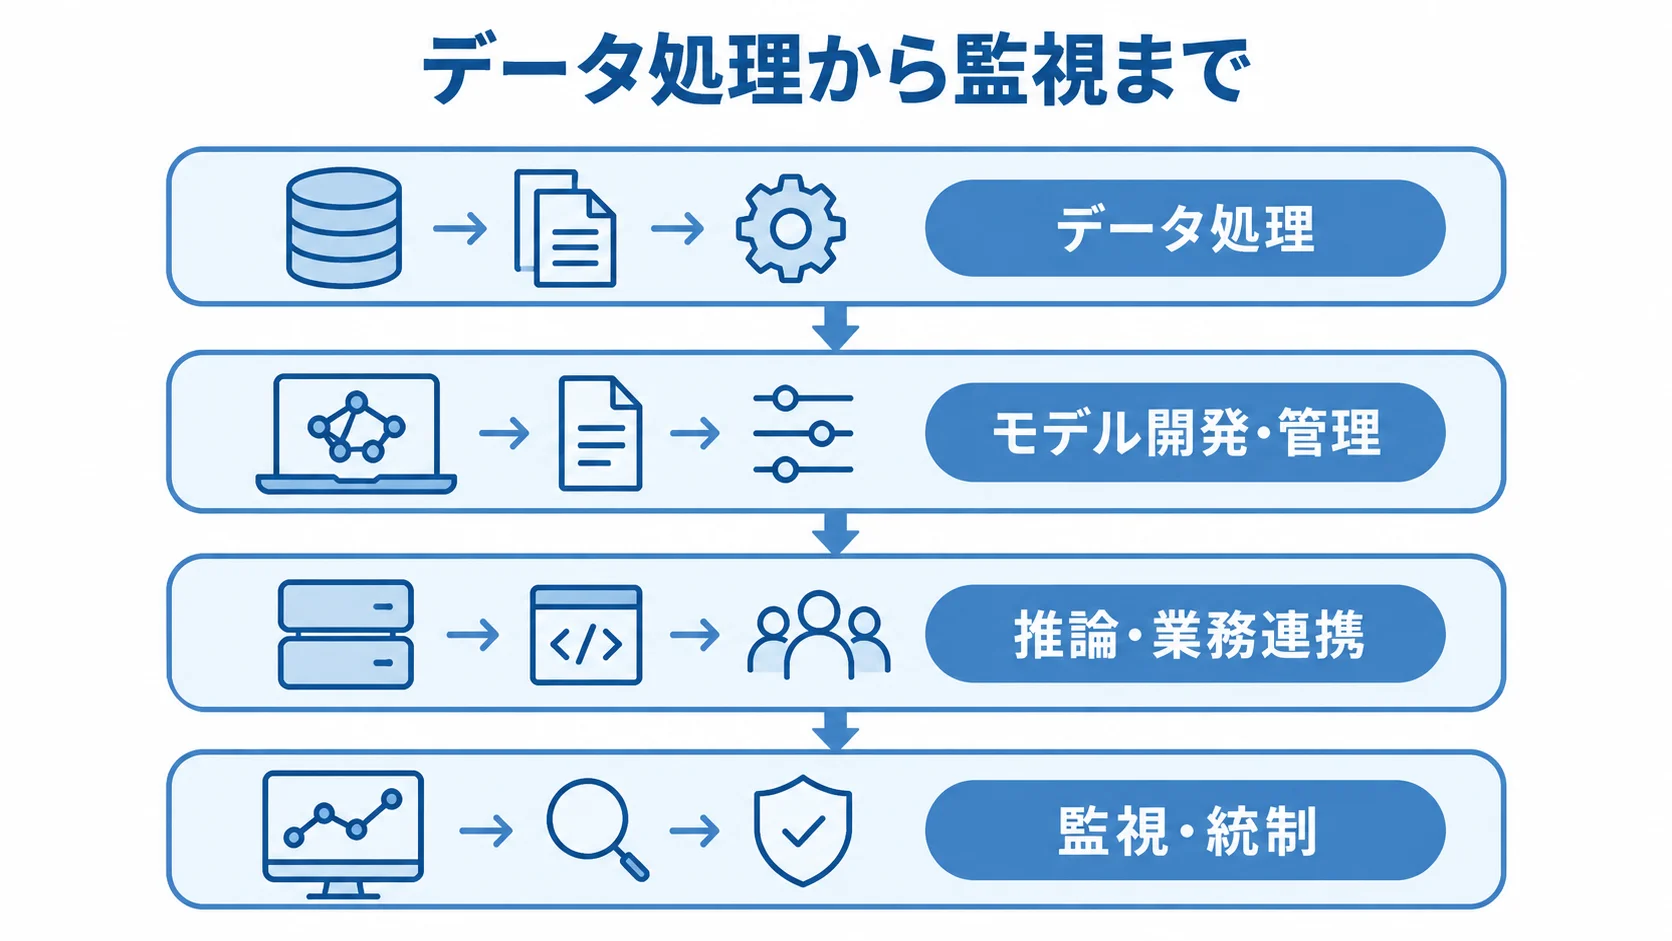
PyTorchのシステムは、データを集めて整形し、学習済みモデルを業務画面や既存システムから使える仕組みです。
開発範囲は、モデルのコードだけでなく、データ処理、推論API、監視まで含みます。ほかに、次の4つも開発範囲に入ります。
- 版管理
- 認証
- 再学習
- バックアップ
AIエンジンとしてのPyTorchの位置づけ
PyTorchは、PythonやC++でテンソル計算やニューラルネットワークを扱う深層学習フレームワークです。受注画面や在庫台帳まで完成して届く業務パッケージとは、性格が異なります。
そのため、業務データをモデルの結果へつなぐには、前処理から現場での対応まで設計が要ります。設計の焦点は業務によって変わるため、4つの観点から見ていきます。
- データ準備:販売管理、CRM、IoT、画像、文書などをETLと前処理で整え、ラベルを付けます。
- 画像検査:画像を取り込み、対象を切り出して良品・不良品にラベルを付け、判定を検査記録へ保存する流れです。
- 需要予測:販売履歴や季節性を特徴量にし、予測値を発注や生産計画へ渡します。
- 現場対応:正解率だけでなく、見逃し時の人手確認、判定時間、再処理の手順も設計の対象にします。
業務で動くシステムの層構成
業務で動くシステムは、データの取り込みから業務への接続まで、5つの層が連なって成り立ちます。開発範囲の抜け漏れを防ぐには、各層が何を担うかを確かめておくことが役立ちます。
- データソース:基幹システム、CSV、センサー、画像、文書からデータを取り込みます。
- 前処理:匿名化、欠損補完、ラベル付け、データ分離の工程です。
- モデル開発・管理:学習コードや実験条件を残し、データセットや評価結果も記録して、採用モデルの版を管理します。
- 推論・業務連携:APIまたはバッチでモデルを提供し、認証付きで業務画面や既存システムと接続します。
- 監視・統制:精度、遅延、エラー率、ドリフト、GPU・CPU使用量、1件あたりの推論コストの確認。
PyTorch 2.8では限定的なlibtorch ABI、Intel CPUでの量子化LLM推論、ROCm 7の新アーキテクチャ対応が示されています。
出典は、PyTorch Foundationの「PyTorch 2.8 Release Blog」(2025年)です。
NVIDIA GPUだけを前提にせず、将来の実行環境も比較します。
PyTorchのシステム開発の進め方
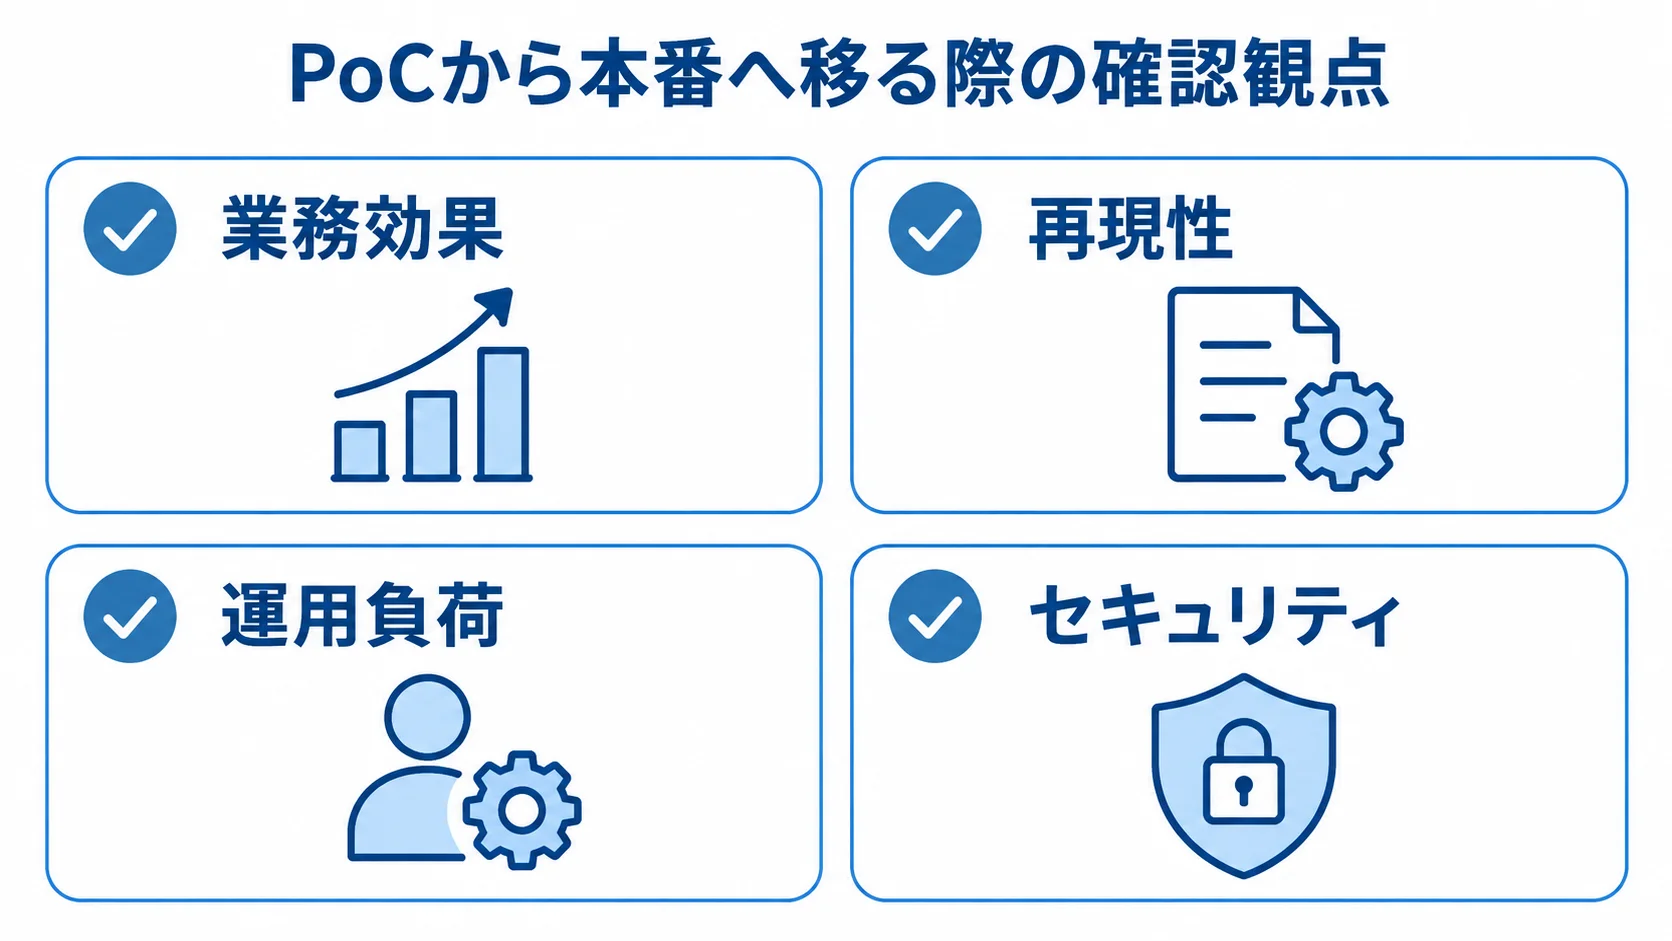
PyTorchのシステム開発は、要件整理から定着までを6フェーズに分けて進めます。
各フェーズには、次の段階へ進むための判定基準を置きます。
PoCから本番へ移るときは、業務効果と再現性に加えて、運用負荷、セキュリティ、費用も同時に確認します。
フェーズ1:業務課題とKPIの要件整理
まず、業務上の変化をKPIへ落とし込みます。評価には、正解率のほかに業務への効果を測る指標も必要です。
- 検品:1件あたりの確認時間を何分短縮するかの目標
- 問い合わせ分類:人手の振り分けを何割減らすかの目標
- 需要予測:予測誤差をどの水準まで抑えるかの目標
測定対象には、誤検知の確認時間や予測値の修正時間も含めます。
対象業務と利用者を整理し、入力データと出力先も確かめます。
現行作業や例外処理、許容できない誤判定の洗い出しも欠かせません。
目標値と測定方法、責任者も決めます。
個人情報や機密文書が含まれるかどうかも確認します。
学習データをクラウドに置けるかどうか、既存APIやファイル連携の有無も見ておきます。
対象を1部門・1製品・1帳票などに絞ると、PoCの目的が明確になります。
フェーズ2:方式と開発会社の選定
利用方式と開発会社は、必要な独自性や運用条件に合わせて選びます。
- 既製AI・SaaS:既製機能で業務要件を満たせる場合に検討します。
- マネージドML:クラウドの機械学習基盤を使う方式です。
- OSS:複数のオープンソースを組み合わせる構成です。
- 専用GPU・オンプレミス:実行環境やデータの条件に合わせて選びます。
- フルスクラッチ:個別要件に合わせてシステムを開発します。
独自データで差別化しない場合は、既製APIのほうが早く安定する可能性があります。一方で、検査基準が自社固有で、学習データや推論ロジックを資産として管理するなら、独自モデルが候補になります。
開発会社は、PyTorchの実装力のほかに、データ整備やAPI化の実績を確認します。
開発会社に、コンテナやクラウド・オンプレミス、MLOpsの実績があるかも見ておきます。
業務連携、セキュリティ、運用保守の実績も確認します。
納品物については、各社に同じ条件で質問します。
納品物は、学習済みモデル、ソースコード、データ加工処理を確認します。加えて、IaC、評価レポート、テストコード、運用手順書も対象に含めます。
受託SI会社とクラウド基盤ベンダーでは役割が異なります。そのため、業務要件と運用責任を誰が担うかを明記します。
フェーズ3:データ・モデル・業務連携の設計開発
設計に入る前に、学習と推論の環境、データの取り込み時期、モデルの更新単位を決めます。
- データ:スキーマ、前処理コード、ラベル定義を用意します。
- モデル:学習設定や評価用データを含めて、モデルの版を管理します。
- 連携:推論API仕様、認証認可、ログ項目を定めます。
- 運用:監視閾値とロールバック手順の整備。
学習は一時的にGPUを多く使う一方で、低頻度の推論はCPUやバッチも候補になります。
高頻度の推論にはGPUや専用基盤を検討します。ただし、常時GPUは低利用時の固定費を増やします。
個人情報や機密データには、匿名化、アクセス制御、暗号化などの方式を定めます。
保存期間と削除手順も決めておきます。
学習用・評価用・本番用のデータは分けて扱います。さらに、信頼度が低い判定を人が確認する分岐も設計に含めます。
フェーズ4:精度と業務シナリオのテスト
モデルの評価とシステムの挙動は分けて確認し、その結果を業務KPIに結び付けます。
- 機能:単体、データ処理、API連携、受け入れの各段階で試験します。
- モデル:適合率、再現率、F1値、混同行列を確認します。
- 性能と安全性:負荷とセキュリティの試験。
正解率に加えて、対象カテゴリ別の偏りも確認します。
業務の条件も評価に含めます。たとえば、画像検査では許容する見逃しの水準を定めます。文書分類では、誤分類を人が何秒で修正できるかを条件にします。
本番に近いデータ量と同時アクセス数の条件で、推論遅延、タイムアウト、キュー詰まりを測ります。
GPUメモリやログ量、費用も測定します。モデルを更新するときは、旧モデルとの比較評価も行います。
精度が落ちたときに旧モデルへ戻せるかを確認します。なお、本番データは無断でテストへコピーしません。
テストには、匿名化データか、利用条件を確認した検証用データを使います。
フェーズ5:限定稼働から本番への段階移行
稼働範囲は、次の順番で段階的に広げます。
- シャドー運用でAIの結果と人手判断を比較します。
- 限定ユーザーで、修正内容や処理時間、エラー、問い合わせを記録します。
- KPI達成を確かめてから対象範囲を広げ、カナリアリリースを経て全社展開します。
シャドー運用では、AIの結果を業務判断に反映させず、人手判断と比べて実績を集めます。
本番前に、責任者や監視担当、問い合わせ窓口、障害時の連絡先を決めておきます。
旧システムとの併用期間とロールバック条件も定めます。バックアップや復旧目標も、あわせて決めます。
停止したときに、手作業や旧ルールへ戻せるか、誤判定を訂正できるかを確認します。
監査ログで変更者と変更内容を追えるようにしておきます。稼働の可否は、精度、遅延、可用性、コスト、利用率で判定します。
フェーズ6:運用と現場定着の仕組み
納品後も、モデルと業務の状態を継続して確認します。そこで、監視する指標を先に決めておきます。
- 品質:データドリフトと精度低下の確認。
- 性能:推論遅延と利用率の確認。
- 現場:修正率の確認と、定着状況の把握。
季節変動や商品の変更でデータの分布が変わる場合は、再学習の条件と頻度を決めます。
学習データ、コード、環境は、再現できる状態に保ちます。
月次レビューや四半期ごとの更新評価も候補になります。
現場には、AIの信頼度や根拠を見る画面と修正欄を用意します。あわせて、問い合わせ先と、手作業へ戻す手順も決めておきます。
管理者向けには、モデルの承認や権限変更を記録する画面や手順書を用意します。記録の対象には、データ削除、再学習、リリース、ロールバックも含めます。
保守契約では、更新作業、脆弱性対応、精度改善を分けて記載します。更新作業には、PyTorch、CUDA、ドライバー、コンテナの更新が含まれます。
障害対応と問い合わせ対応の範囲、SLAも明記します。
PyTorchのシステム開発費用相場とコストの内訳
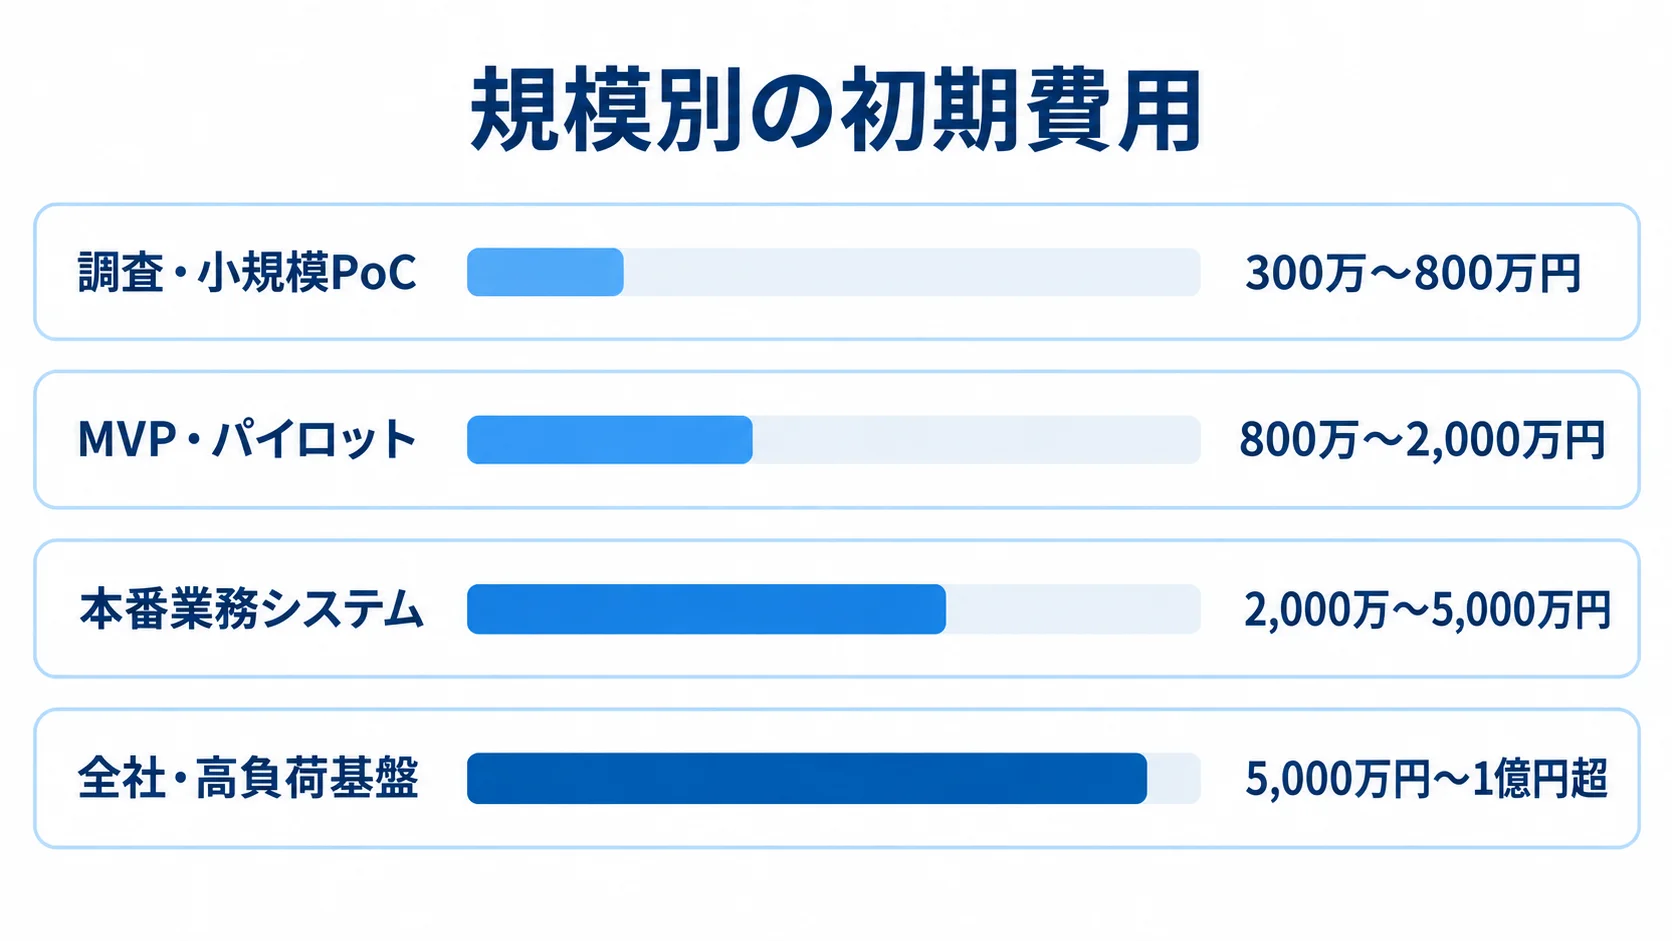
PyTorch専用の国内受託開発価格表は、ほとんど公開されていません。そこで、予算取りに使える推定レンジを次に示します。
この推定は、業務システムの規模別の相場、機械学習基盤に近い案件構成、人月単価をもとにしています。
金額は、データ量やラベル品質、モデルの難易度によって変わります。GPU台数や連携、個人情報、SLAによっても変わるため、金額を確約するものではありません。
正式な見積もりは、要件整理とPoCの結果をもとに再計算します。
規模別の初期費用と期間の目安
初期費用と期間は、開発範囲によって異なります。予算取りには、次の推定レンジが使えます。
- 調査・小規模PoC:300万〜800万円程度、1〜3か月程度。
- MVP・パイロット:800万〜2,000万円程度、3〜6か月程度。
- 本番業務システム:2,000万〜5,000万円程度、6〜12か月程度。
- 全社・高負荷基盤:5,000万円〜1億円超、12〜24か月以上のケースがあります。
PoCは、1業務・1モデルを対象に、既存データを少量使って評価画面までを想定します。
MVPには、データ連携、学習パイプライン、推論API、簡易監視が含まれます。
これらは、NotebookLMの業務システム相場情報を追加工程へ当てはめた推定です(出典: NotebookLMリサーチノート「業務システム全般_15」、2026年8月整理)。
本番システムの目安は、複数モデルや業務画面、権限、監査に加えて、CI/CDや再学習まで含めた場合です。
全社基盤では、複数拠点と閉域接続を想定します。冗長化や基幹連携、24時間運用も含めます。
各レンジは、対象範囲を限定した金額です。ただし、データ整備やアノテーションの作業が大きい場合は、金額が上振れします。
見積書の開発費と実行環境費の内訳
開発費と実行環境費を分けておくと、見積もりを比べやすくなり、運用予算も把握できます。
- 開発費:要件整理、データ棚卸し・整備、モデル、API・画面、連携、テストを含めます。
- 実行環境費:GPU・CPU、ストレージ、転送、監視、ログ、バックアップの費用です。
開発費には、クレンジングやラベル付けの費用も計上します。セキュリティや移行、研修、ドキュメントの費用も含めます。
データ不足の案件では、モデル開発よりデータ整備と評価設計が工数を占めることがあります。
人月見積もりでは、PM、データ・ML・アプリケーションエンジニア、インフラ、QAそれぞれの役割と期間を確認します。
環境費は、GPU・CPUのVMとストレージ、データ転送に分けて考えます。監視やログ、コンテナ、モデルレジストリ、バックアップ、サポートも、それぞれ個別に確認します。
Google Cloudの公開価格では、NVIDIA T4は1GPUあたり0.35米ドル/時間です(出典: Google Cloud「GPU pricing」、2026年確認)。
T4の単価で730時間のGPUを使うと、GPU利用部分は約255.5米ドル/月になります。ただし、VM、ディスク、ネットワークは別料金です。
AWSは2025年6月、P5のオンデマンド価格を最大45%引き下げました。
出典はAWSで、資料名は「Pricing and usage model updates for Amazon EC2 instances」です。資料名の後半は「accelerated by NVIDIA GPUs」で、2025年の資料です。
料金は、リージョンやOS、契約方式によって変わります。そのため、発注時点の料金表で再計算します。
CPUや低頻度バッチの小規模推論であれば、月数万円〜数十万円を、クラウド実行費の試算の起点にできます。
一方で、常時GPU推論や大規模学習、複数環境、ログ保管、閉域接続があると、月数十万〜数百万円以上になる可能性があります。
これらは公開単価からの推定です。利用率と契約条件で変わるため、学習・推論・検証・待機の費用を分けて見積もります。
保守運用は、初期開発費の年15〜25%程度を目安にします。そのうえで、含まれる作業を明記します。
PyTorchのシステム開発で見積もりを取るポイント
発注前に、業務やデータ、利用者、判断内容を1枚にまとめておくと、見積もりの精度が上がります。
モデルの種類を示すより、入力や出力、許容誤差、例外処理、利用頻度を示すほうが、構成と費用を比べやすくなります。
RFPに書くデータ・KPI・非機能要件
RFPには、業務範囲と月間データ件数を書きます。ファイルやAPIの形式、保存期間、欠損やラベルの状態も記載します。
- データ:件数、形式、保存期間、欠損、ラベル、個人情報の有無。
- 利用条件:利用者数、ピーク時の同時アクセス、稼働時間。
- 品質・運用:許容遅延、復旧目標、監査ログ、データ所在、認証方式。
画像の場合は解像度と1日あたりの枚数、文書の場合は形式とページ数を示します。
予測の場合は、予測単位と更新頻度も記載します。また、対象業務と対象外業務を明確にします。
受け入れ条件は、評価指標や業務KPIに加えて、処理時間、費用上限、現場の修正時間で定めます。
受け入れ条件の例としては、対象カテゴリごとの再現率、95パーセンタイルの推論遅延、APIエラー率、1件あたりの推論費用などが挙げられます。
低信頼判定の人手確認率も候補になります。あわせて、測定データや判定者、期間、再測定の条件を決めておきます。
条件を具体的に書いておくと、納品時の認識違いを減らせます。
複数社の比較と納品物の確認
複数社には同じ条件を渡し、費用だけでなく、各段階の成果物と契約範囲も比べます。
- 比較条件:サンプルデータや評価指標、対象範囲、稼働条件をそろえます。
- 段階見積:要件整理、PoC、MVP、本番化ごとの成果物を確認します。
- 移行条件:権利、データ利用、再委託、終了後の引き渡しを契約に記します。
各段階の判定基準も比べます。別料金の項目を含めると、総額の大小が逆転する場合があります。
データ整備、クラウド、監視、保守、再学習が見積もりに含まれるかも確認します。
納品物は、ソースコードや学習済みモデル、データ加工処理を確認します。データ辞書と評価用データも、納品物に含まれるかどうかを見ます。
実験履歴や環境定義、CI/CD、IaCの資料も確認します。API仕様とテスト結果も、あわせて見ておきます。
脆弱性スキャンの結果、運用手順書、障害時の復旧手順も、納品対象に含めます。
コードとモデルの権利、学習データの利用範囲、第三者ライセンスは、契約に記載します。
別の会社へ移行する際は、開発会社がどこまで協力するかも確認します。
セキュリティと技術的負債の見積項目
モデルファイルと依存パッケージの扱いは、見積段階から確認します。
- 安全な読み込み:信頼できないモデルファイルは読み込まない。
- 検証と更新:検証環境でモデルをスキャンし、依存関係やCUDA・ドライバーを固定・更新する。
- 実行管理:最小権限で動かし、秘密情報をイメージへ埋め込まない。
- 監査:監査ログを保存し、責任分担を明記する。
PyTorch 2.6では、torch.loadのweights_onlyパラメータの既定値が変更されました。
出典は、PyTorch Foundationの「PyTorch 2.6 Release Blog」(2025年)です。
NISTのCVE-2025-32434は、PyTorch 2.5.1以前のtorch.loadを介したリモートコード実行の脆弱性です。
出典は、NIST National Vulnerability Database「CVE-2025-32434」(2026年確認)です。
この脆弱性は2.6.0で修正されています。2.6.0以降を使うことに加えて、対策を誰が担うかも定めておきます。
開発会社、自社インフラ担当、保守契約のどこが対応するかを分けておかないと、納品後に責任の空白が生まれます。
GPUを買うかクラウドを使うかは、単価だけでなく利用率で判断します。学習が月数回であれば、従量課金やスポットも候補になります。
常時推論であれば予約や専用環境を、機密データで外部クラウドが難しい場合は閉域接続やオンプレミスを比べます。
候補会社には、GPU障害時の代替策や、NVIDIA以外の選択肢、PyTorchとドライバーの更新計画を質問します。加えて、環境移行の可否も確認します。
PyTorchのシステム開発でよくある質問
発注前によくある質問に、判断の基準を添えて答えます。
PyTorchのシステム開発費用はいくらですか?
いずれの費用も、予算取りのための推定です。正式な金額は、要件整理のあとに項目別の見積もりを取って確かめてください。
- 小規模PoC:300万〜800万円程度が目安です。
- MVP:データ連携と推論APIを含み、800万〜2,000万円程度です。
- 本番業務システム:2,000万〜5,000万円程度です。
- 見積もり条件:GPU・クラウド、データ整備、既存連携、セキュリティ、保守の有無で変わります。
PyTorchのシステムにはGPUが必須ですか?
GPUが必要かどうかは、用途によって分かれます。低頻度の予測や軽量な分類をバッチで処理するなら、CPUで十分な場合があります。
学習や、高頻度の画像・生成AI推論では、GPUが有力です。データ量やモデルサイズも判断材料になります。
許容遅延や同時アクセス、利用頻度も測定します。そのうえで、CPU、GPU、専用推論チップを同じ評価データで比べます。
PoCで精度が出れば本番導入できますか?
判断は、精度に加えて、現場の作業時間が減るかどうかや、遅延と費用が許容範囲に収まるかどうかで行います。
データ更新と再学習を再現できるか、低信頼の判定を人が確認できるかも検証します。
障害時に旧運用へ戻せるかも確認します。また、PoCの終了条件と本番化の条件をあらかじめ合意しておくと、長期化を防げます。
学習データをクラウドに置いても安全ですか?
安全性は、クラウドかオンプレミスかだけでは決まりません。次の観点を確認します。
- 管理条件:データ分類、利用目的、権限、暗号化、ログ、保存期間の評価。
- 委託・接続:委託先管理とネットワーク分離の確認、必要に応じた匿名化や閉域接続の検討。
- 環境・契約:専用テナントや学習・本番環境の分離、契約へのデータの所在と削除方法の明記。
- ファイル検証:外部取得したモデルファイルや依存パッケージの検証。
まとめ
PyTorch開発では、データを安全に扱い、業務判断へつなげ、運用で改善していく仕組みを作ります。
要件整理でKPIとデータ利用条件を決めたうえで、業務連携やMLOps、セキュリティ、保守体制も含めて方式を選びます。
小規模検証を経た本番化の判断
費用の推定レンジは、小規模PoCで300万〜800万円程度、MVPで800万〜2,000万円程度です。
本番業務システムは2,000万〜5,000万円程度です。データ整備や連携、GPU・クラウド、セキュリティ、保守は、それぞれ分けて見積もります。
PoCの終了条件と本番化の判定基準を先に決めておくと、予算と納期の不確実性を抑えられます。
納品後の監視と定着を含む契約範囲
監視や更新、契約範囲、移行時の引き渡しまで決め、運用を業務に定着させます。
- 本番監視:精度、遅延、エラー率、ドリフト、利用率、推論コスト、現場の修正率の確認。
- 運用契約:再学習とモデル更新を管理し、権利、データ、脆弱性対応、障害復旧、運用SLAを明記します。
- 定着・移行:別会社への引き渡しを決め、6フェーズごとの成果物と判断基準を確認します。
▼全体ガイドの記事
・PyTorchのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。