
RAG導入の失敗や課題は、データ品質、検索の仕組み、生成AI特有のリスクや脅威に大きく分けられます。
PoC(概念実証)後の本番不調や精度の停滞、利用離れは典型例です。こうした失敗は共通の原因から起きるため、把握しておくと回避につながります。全体像はRAG構築の完全ガイドもご覧ください。
▼全体ガイドの記事
・RAG構築の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
最大の失敗要因「データ品質」による頓挫とその構造
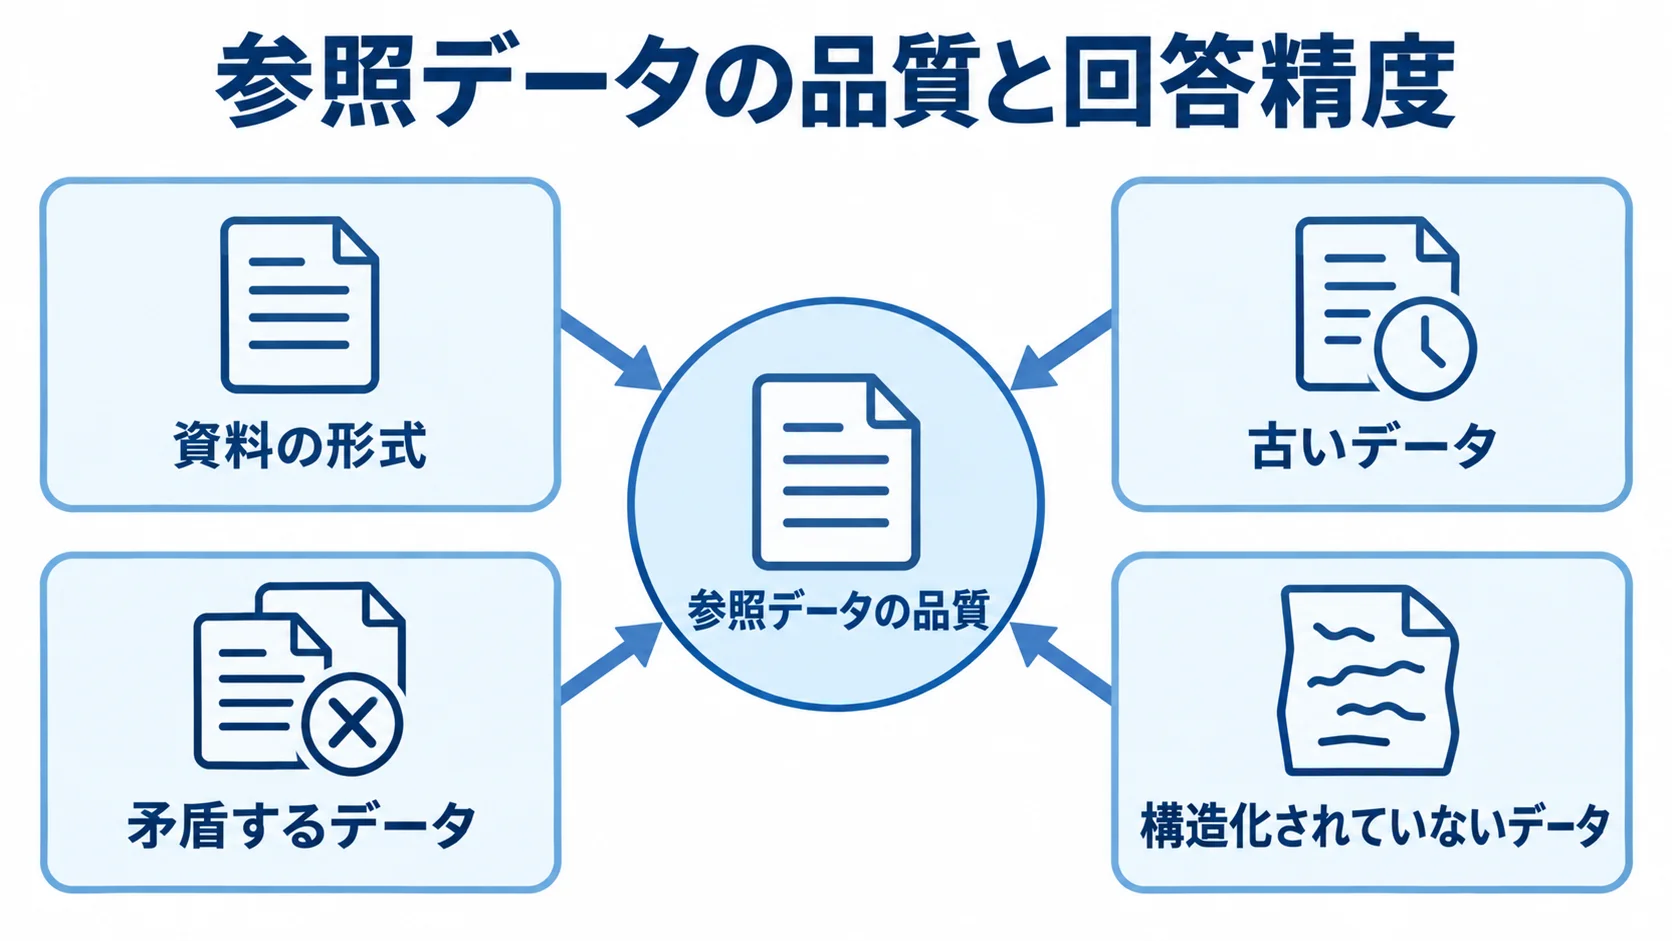
RAG導入の失敗原因の筆頭は、参照する社内データの品質の低さです。回答の精度はデータの質に強く左右され、データが整わなければ、高性能なモデルでも的確な回答は生まれません。その構造は、具体的な調査データからも確かめられます。
調査データが示す「データ不足」という壁
複数の調査から、データ品質がAI導入の成否を左右することが分かります。その傾向は、調査結果の数字にも表れています。
- AIプロジェクトのデータ不足:Gartnerは、2026年までに60%が失敗すると予測しています(出典:Gartner)。
- RAG事例の成功率:228件のうち、成功(Good)と判定されたのは33%です(出典:キヤノンITソリューションズ)。
- 主な失敗原因:回答品質が46%、データ連携の不備が42%でした。
Gartnerの予測は、AI活用が進む一方で、土台となるデータ整備が追いつかない企業が大多数であることを示しています。これらの数字からは、RAGの失敗の多くが構造的に予測でき、回避も可能であることが読み取れます。
キヤノンITソリューションズの調査では、成功と評価されたのは33%で、残る3分の2は期待した成果に届きませんでした。失敗原因の中心は、AIの賢さよりもデータの準備と連携にあります。
古いデータや矛盾するデータ、構造化されていないデータでは、最新モデルでも正確な回答は困難です。そのため、発注側と開発会社は、モデル選定より先にデータ整備を進めます。
優先順位の取り違えによる失敗
多くの失敗は、優先順位を逆に捉えることから起きます。たとえば、「最新AIなら賢く答える」と考えてデータ整備を後回しにすると、PoCで精度が出ません。原因に気づいたころには、予算と期間の大半を使っていることもあります。
古い規程類や、手書きをスキャンしたPDF、表とテキストが混在したExcelは、そのままではRAGが正確に読み取れません。このため、開発会社と発注側は、これらを参照しやすい形に整え、構造を揃える作業から始めます。
データ品質は、プロジェクトの最初に向き合うべき課題です。華やかなAI開発より地道な前処理が成否を分けることは、関係者全員で共有しておくとよいでしょう。
「PoC死」を招く検索精度とチャンキングの落とし穴
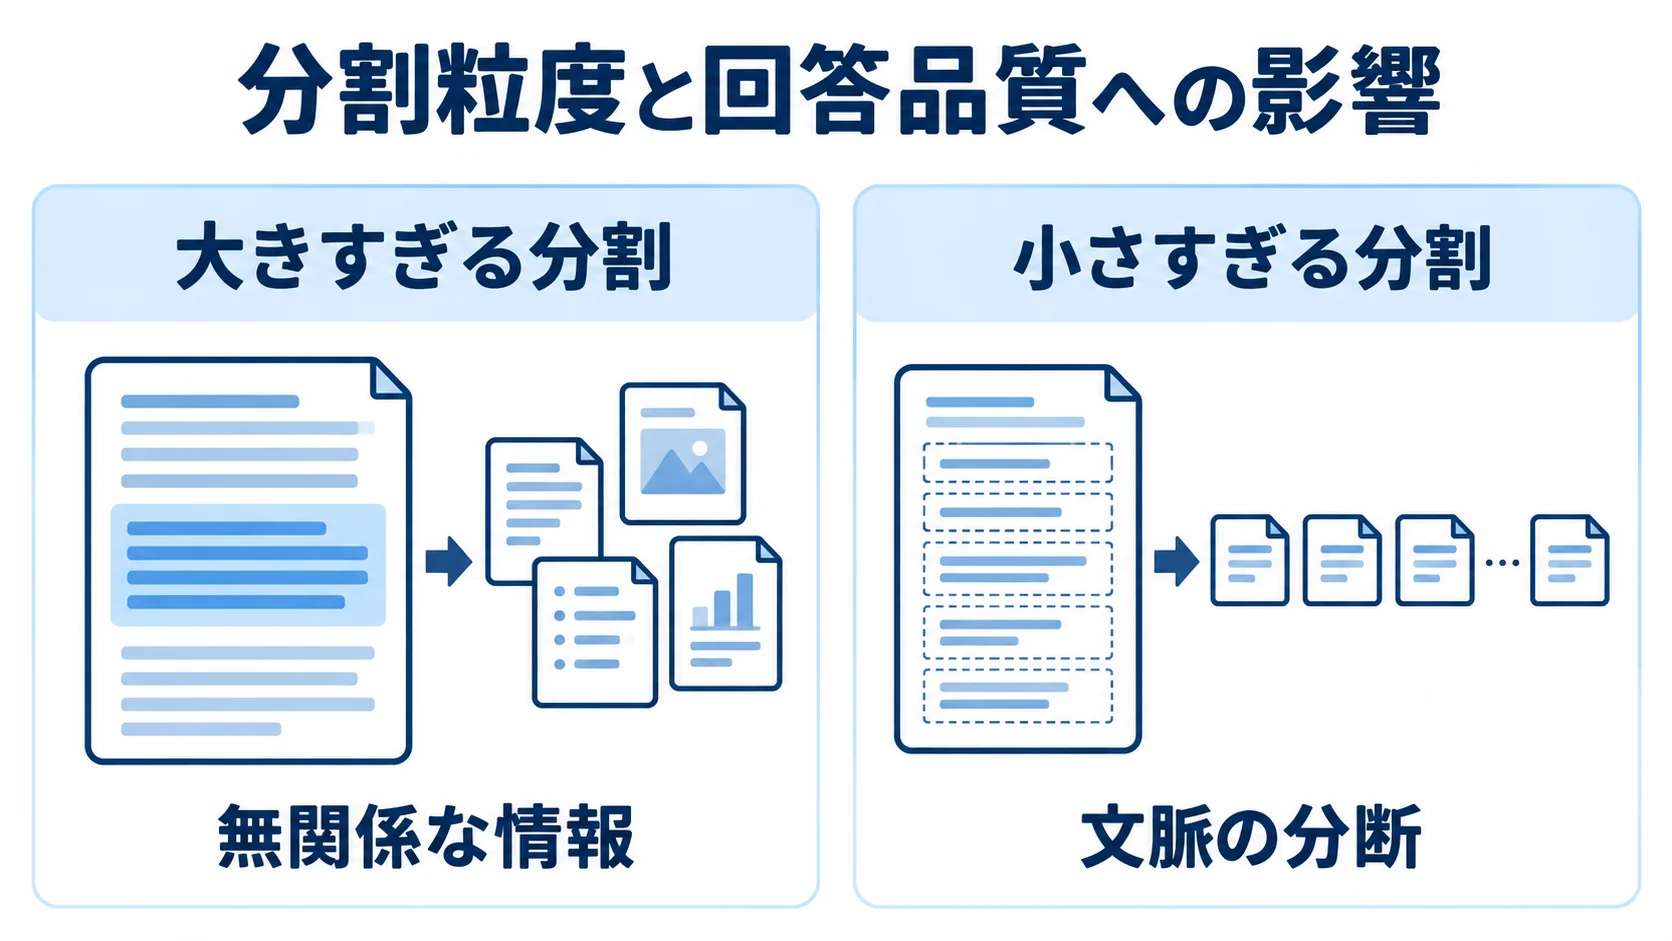
データを用意しても、PoC(概念実証)では動いたのに本番では使えず頓挫する「PoC死」が起きることがあります。これは典型的な失敗で、その構造的な要因は、チャンキング(文書分割)の不適切さと検索精度の低さです。
不適切なチャンキングによる精度の低下
チャンキングは、長文を検索しやすい単位に分ける処理です。分割の粒度がRAGの精度を左右します。粒度が合わないと、分割が大きすぎても小さすぎても、回答に問題が生じます。
- 大きすぎる分割:無関係な情報が混ざるため、生成AIが本質を捉えにくくなります。
- 小さすぎる分割:文脈が分断されます。手続きの条件と例外規定が別々に分かれると、片方だけが検索され、不完全な回答につながります。
- 調整不足:失敗したプロジェクトの多くは既定値のまま放置しています。文書の種類や構造に合わせて調整することが、PoC死を避ける対策です。
利用者の目には誤答に見えても、その原因は分割の設計にあります。
検索精度の低さによる回答品質の低下
RAGは「検索(Retrieval)」と「生成(Generation)」の2段階で動きます。適切な文書を検索できるかどうかで、後段の生成モデルの性能を活かせるかが決まります。
- 回答品質への影響:キヤノンITソリューションズの調査では、回答品質が失敗原因の46%を占めました。
- 誤情報の参照:質問と異なる文書を参照すると、ずれた前提で回答してしまい、ハルシネーション(もっともらしい誤情報)を招きます。
- 検索品質の評価:数値で測らないと原因を特定できず、PoCから先へ進めないことがあります。
回答品質の失敗は、多くの場合、検索段階でのつまずきが原因だと考えられます。
Ragasによる失敗原因の定量的な切り分け
PoC死を避けるうえで最も実践的な対策は、失敗の原因が検索と生成のどちらにあるかを特定することです。原因が曖昧なままモデルやプロンプトを変えてしまうことは、陥りやすい失敗です。
Ragasなどの評価フレームワークを使うと、RAGの品質を複数の指標で定量評価できます。代表的な指標は、検索側と生成側をそれぞれ測るものです。
- Context Precision(コンテキスト適合率):質問に関連する文書を、検索段階で正しく取り出せたかを測ります。
- Faithfulness(忠実性):回答が検索文書の内容に沿っているか、ハルシネーションが混じっていないかを示す指標です。
Context Precisionが低ければチャンキングや検索を、Faithfulnessが低ければ生成段階の制御を見直します。数値をもとに改善を重ねることが、本番運用へ進む条件です。
見落としやすい生成AI特有のリスク(情報漏洩・著作権・ハルシネーション)
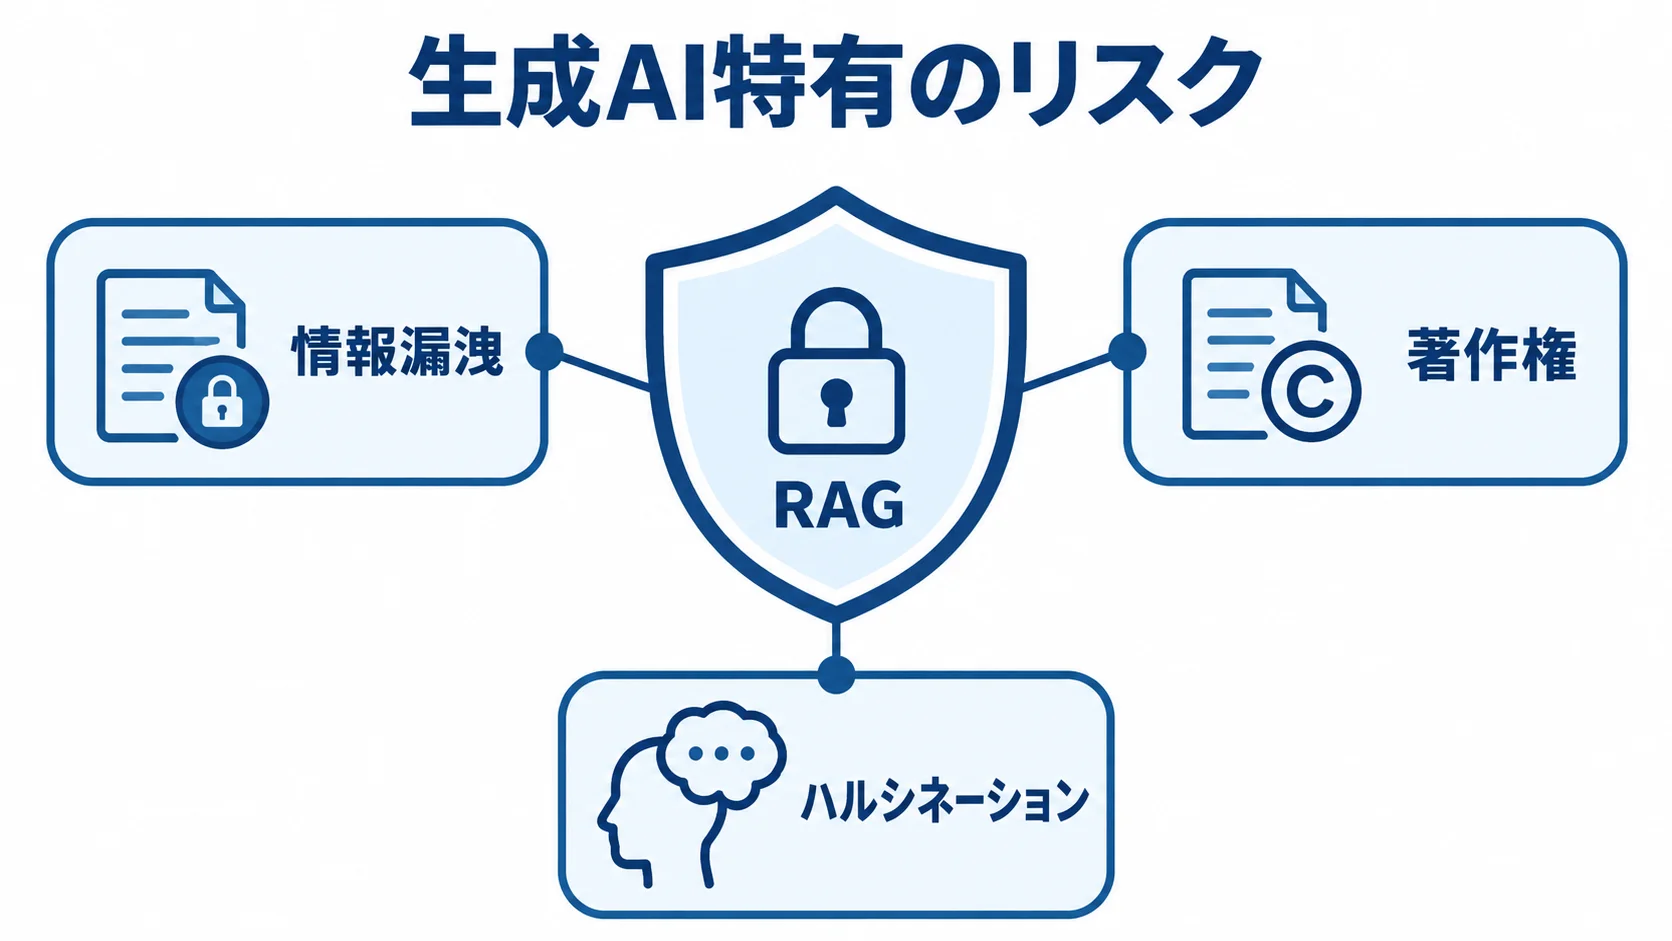
RAGの失敗には、精度の問題に加えて、業務で使う際の情報漏洩、著作権、ハルシネーションのリスクがあります。
これらは精度が上がっても消えず、導入を急ぐと重大なトラブルを招きます。さらに、それぞれの仕組みを理解して備えることが、致命的な失敗を避けることにつながります。
情報漏洩とアクセス権限の設計ミス
RAGは社内文書を参照するため、アクセス権限の設計を誤ると情報漏洩につながるおそれがあります。権限管理では、共有範囲、検索時の制御、取り込み時の扱いに注意が必要です。
- 共有範囲の誤り:全社員が同じデータを参照すると、人事評価や経営情報、部門限定の文書が、権限のない社員の質問にも回答されてしまうことがあります。
- 検索時の権限制御:構築の初期から利用者ごとに参照範囲を絞っておかないと、生成AIが情報を横断して答えてしまいます。
- 取り込み時の懸念:取り込みの際に、元の文書管理システムの権限の境界が失われるおそれがあります。
著作権リスクとハルシネーションへの備え
外部の記事や他社の文書を無断でRAGに取り込み、その内容をほぼそのまま回答に使うと、著作権侵害につながるおそれがあります。そのため、発注側と開発会社で、参照データの権利関係を確認し、利用が許諾された範囲に限って取り込むことが求められます。
生成回答を外部に公開する前には、内容を慎重に確かめます。RAGはハルシネーションを抑えられます。ただし、生成AIである以上ゼロにはできず、検索が外れたり情報が不足したりすると、誤情報を出すことがあります。
「RAGだから安全」と過信しないことが大切です。回答には参照元(出典)を併記して、利用者が真偽を確かめられるようにします。特に、業務上重要な判断では、人間が最終確認する運用もあらかじめ設計しておきます。
新たな脅威「データポイズニング」とセキュリティ対策
近年注目されているのが、RAG特有の脅威であるデータポイズニング(データ汚染)です。参照データベースに悪意ある情報を混入させ、生成AIの回答を意図的に操作するものです。
RAGは外部データを信頼して回答に反映するため、その信頼を逆手に取られると、検索精度やモデル性能とは関係なく、システムが乗っ取られたような挙動を示します。
BadRAG攻撃が示すわずかな汚染の脅威
BadRAG研究では、ごく一部のデータ汚染でもRAGの回答を操作できることが示されました。幅広い社内文書を取り込むと、出所の曖昧な文書や外部データが混じる余地も生まれます。
特に深刻なのは、攻撃に必要な汚染がごくわずかで済む点です。
- 攻撃成功率:検索対象データの0.04%を汚染した場合、プロンプトインジェクション(悪意ある指示の注入)は98.2%に達しました。
- 混入の影響:膨大なデータのごく一部に細工するだけで、RAGをほぼ思いのままに操れる可能性があります。
- 想定される被害:誤回答や情報の誘導、内部情報の盗み出しにつながるおそれがあります。
わずかな汚染で攻撃が成立するため、「データ量が多ければ一部の汚染は影響しない」という考えは、RAGでは当てはまりません。
データ源の信頼性を担保する対策
基本の対策は、RAGに取り込むデータの出所と内容を厳格に管理し、汚染されたデータの混入を防ぐことです。
- データソースを限定:信頼できる正規の社内システムに絞り、出所不明の文書は安易に混ぜない。
- 外部データを検証:不自然な指示文や異常な記述がないかを確かめてから取り込む。
- 書き込み権限を管理:誰がどの文書を追加・更新できるかを制御する。
また、生成AIに渡す前後の入出力を監視し、不審な指示や回答を検知する仕組みも有効です。精度を上げる対策とは別に、データの信頼性を守る備えが必要です。
精度対策を優先してセキュリティ設計を後回しにすると、本番運用後に重大なインシデントを招くことがあります。そのため、構築の初期段階からデータの信頼性確保をセキュリティ要件に含めることが、失敗の回避につながります。
まとめ
RAG構築・導入で起きやすい失敗や課題、注意点、リスクを見てきました。まず押さえたいのは、データ品質の整備です。
Gartnerは2026年までにAIプロジェクトの60%がデータ不足で失敗すると予測しています。
キヤノンITソリューションズの調査では、228件中33%が成功でした。失敗原因では、回答品質が46%、データ連携の不備が42%でした。
不適切なチャンキングや検索精度の低さも、PoC死につながります。RagasのContext PrecisionやFaithfulnessを使えば、原因が検索側と生成側のどちらにあるかを数値で切り分けられます。
情報漏洩、著作権、ハルシネーションには、権限設計と権利確認に加え、出典の併記や人による確認で備えます。BadRAGでは、検索対象データの0.04%を汚染しただけで、攻撃成功率が98.2%に達しました。
データ源の信頼性を守るセキュリティ設計も欠かせません。データ整備を先に進め、評価指標で原因を見極めたうえで、セキュリティ対策を構築の初期から組み込むことが、失敗の回避につながります。
ここで挙げた失敗パターンを事前に把握し、同じ轍を踏まないプロジェクト設計につなげてください。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。