
Rancherのシステム開発は、要件整理から定着までの6段階で進みます。対象業務と運用責任を先に決め、障害復旧や更新を試してから段階的に移行すると、安全な運用につながります。
▼全体ガイドの記事
・Rancherのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Rancherのシステム開発の全体像
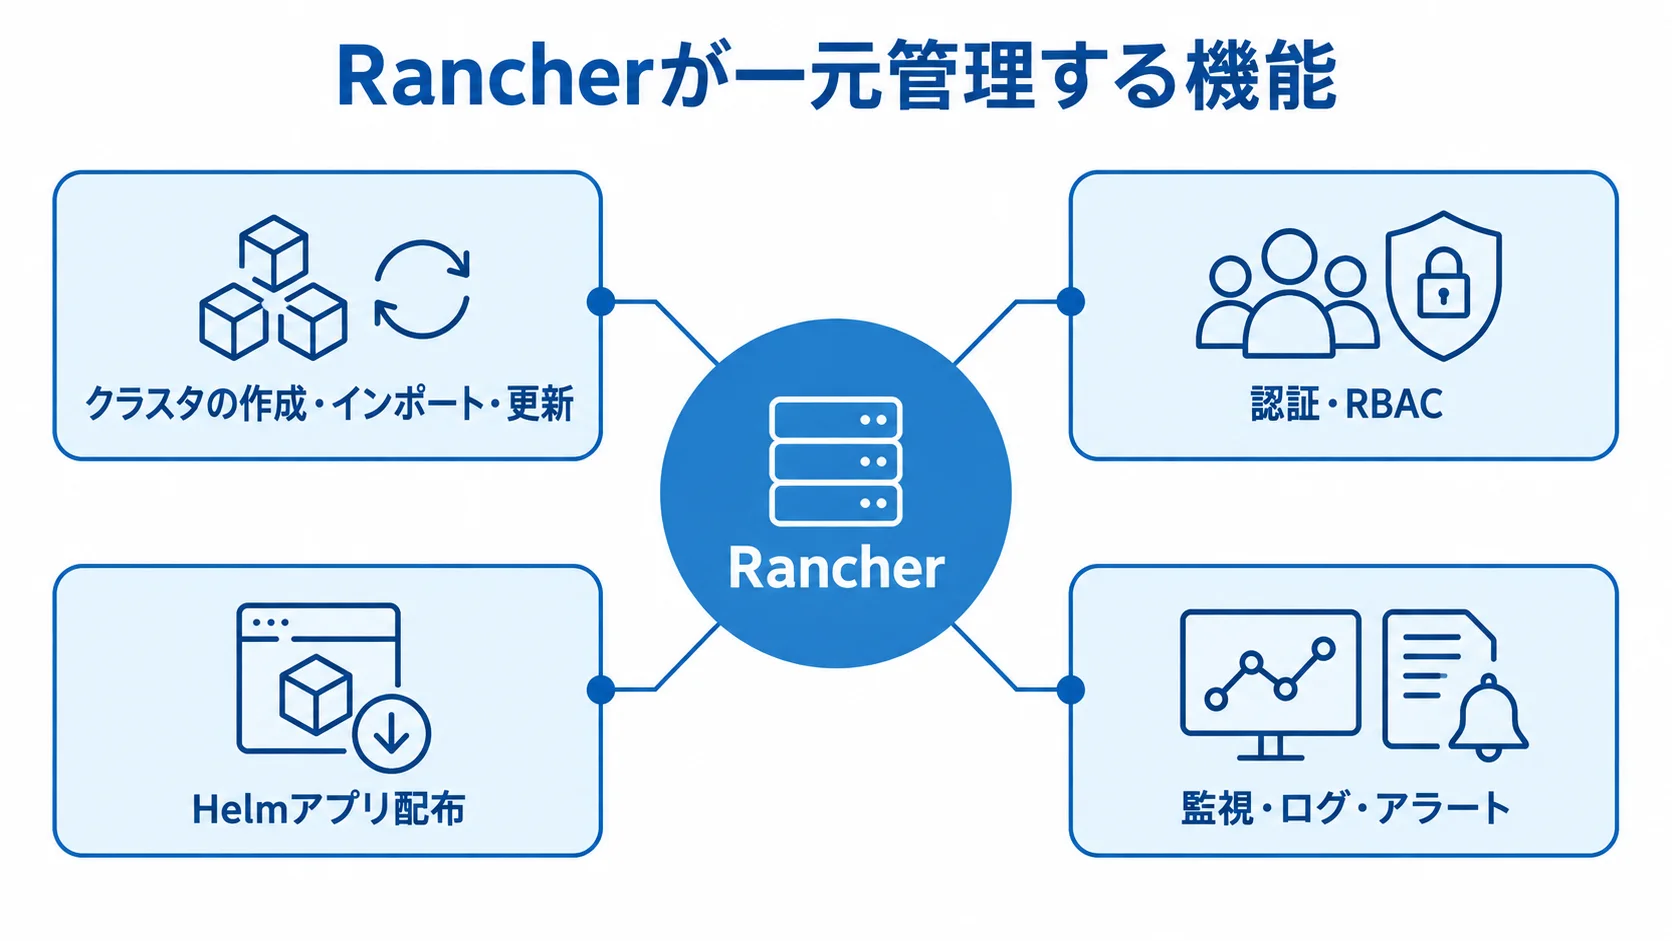
Rancherを導入するときは、クラスタとアプリ、ネットワーク・データ、権限と担当者を一体で設計する必要があります。先に管理対象と止められない業務を決めておくと、技術選定や見積もりの範囲がぶれにくくなります。
Rancherの位置づけ:業務アプリではなくKubernetesの管理基盤
販売管理や会計、顧客管理などの業務機能は、Rancherが直接提供するものではありません。Rancherを業務アプリと同じ扱いにすると、見積もりの範囲がずれやすくなります。
- 管理機能:クラスタの作成・インポート・更新、認証とRBAC、Helmアプリ配布、監視・ログ・アラートを一元的に扱う機能
- 開発の対象:管理基盤の構築に加えて、業務アプリのコンテナ化や移行が含まれる場合があります。
- 見積もりの区分:Rancher基盤、アプリ改修、データ移行、継続運用を、別々の作業として区分
公式Overviewでは、RKE2やK3sのほか、Amazon EKS、Microsoft AKS、Google GKEなどを管理できると説明されています。また、既存クラスタも対象に含まれます(出典:SUSE Rancher Manager公式Overview、2026年確認)。
管理クラスタと業務ワークロードの分離
本番構成では、管理機能と業務ワークロードの配置を分けて設計します。
- クラスタを分離:Rancher Manager用と業務アプリ用の下流クラスタを分けます。
- 障害範囲を分ける:同じ障害ドメインに置くと、アプリと管理機能が同時に止まるおそれがあります。
管理クラスタには、認証やRBAC、クラスタ情報と設定、継続的デリバリーの管理データが集まります。そのため公式は、本番の管理サーバーにHA構成とロードバランサーを推奨しています。
単一のDockerコンテナで動かすと、ノード障害時に管理データを失うおそれがあります。PoCは単一ノードでもかまいません。ただし、本番の前にHA、TLS、バックアップと復旧手順を検証します。
Rancherのシステム開発の進め方
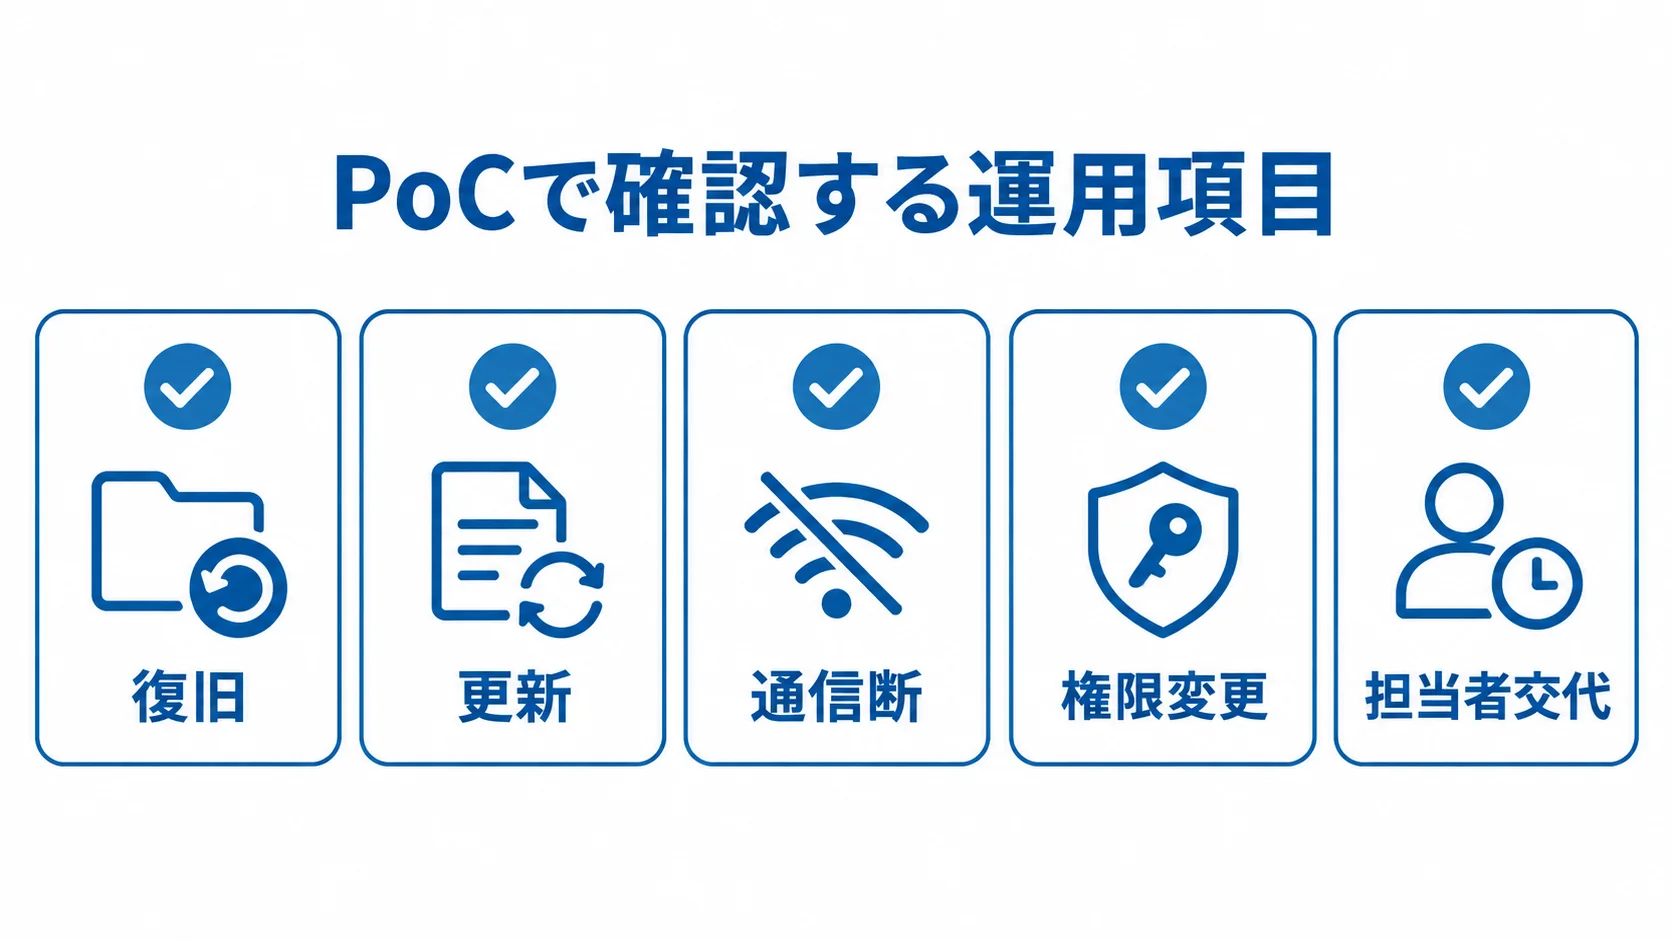
導入は6段階で進めます。まず要件整理を行い、製品・基盤選定と設計開発に進みます。その後は次の順に進みます。
- テスト
- 稼働
- 定着
PoCでは、画面操作に加えて、復旧と更新、通信断、権限変更、担当者交代を試し、運用性を確かめます。
フェーズ1:要件整理と対象業務・運用責任の決定
最初に、クラスタを増やす目的を業務上の成果として言葉にしておきます。
- 複数クラウド:環境の一元管理
- 工場のエッジアプリ:拠点ごとに同じ手順での更新
- チームの権限:役割ごとの分離
- 障害復旧:復旧時間の短縮
要件整理では、クラスタ数と拠点、ノード数とCPUを確認します。クラウドかサーバーか、アプリとデータベースの構成も見ておきます。
障害時にどこまで止めてよいかは、この段階で決めておく必要があります。そのため、許容停止時間、目標のRTO・RPO、通信断の扱いを先に揃えます。また、個人データの保管場所、利用者・管理者の役割、監査ログの保存期間も決めます。
障害が起きたときに誰がどこまで対応するかが曖昧だと、監視があっても復旧が進まない状態になるおそれがあります。そこで、クラウドからアプリまでの担当範囲を、自社と委託先のどちらが受け持つかで決めておきます。
フェーズ2:Rancherのエディションと実行基盤の選定
Community版、SUSE Rancher Prime、マネージドサービスは、費用と社内の運用体制の両面から比べます。
- Community版:ライセンス料を抑えやすい一方、設計や更新、障害対応を自社で担います。
- Prime:サポートやエンタープライズ向け契約を含めて検討します。
- マネージドサービス:24時間対応や運用人材が課題なら候補になります。
実行基盤は、AWS・Azure・Google CloudのマネージドKubernetes、自社サーバーや仮想基盤上のRKE2、拠点向けのK3sから選びます。
RKEは2025年7月31日にEOLを迎えました。そのため、2026年の新規設計では旧RKEを前提にせず、RKE2、K3s、クラウドKubernetesのサポート状況を確認します(出典:SUSE Product Support Lifecycle、2026年8月確認)。
フェーズ3:管理クラスタ、下流クラスタ、アプリの設計開発
構成図では、管理クラスタと下流クラスタを分けて描きます。利用者やIdPからは、ロードバランサーとTLS終端を経て、HA構成のRancher管理クラスタへ接続します。
- 下流クラスタ:検証・本番・エッジ環境を配置し、Ingressやレジストリ、CI/CD、監視・ログを接続します。
- 運用機能:永続ストレージ、秘密情報管理、バックアップも、下流側に接続する対象です。
- 構成の再現:Terraform、Helm、Fleet、GitHubやGitLabなどで設定を再現できる形にします。
- 独自機能の追加:ポータルや承認画面はRancher本体を改変せず、APIやGitOps上に拡張します。
公式の推奨は、本番の管理サーバーを下流のユーザークラスタから分け、HAクラスタとロードバランサーで単一障害点を減らす考え方です。
設計書には、ノード障害時の動作、etcdなどの管理データの保存先、証明書の発行と更新の方法を記載します。加えて、DNSとポート、ファイアウォールの設定、監視対象も決めておきます。一方で、画面操作に依存すると、環境差分の調査や再構築に時間がかかります。
フェーズ4:障害・復旧・更新を含むテストの実施
テストでは、画面表示やアプリの配備に加えて、障害と復旧の動きも確認します。
- 障害試験:ノード停止、Ingress障害、証明書切れを中心に、レジストリとストレージの障害も対象です。
- 復旧・更新:外部IdPとの通信断、バックアップ復元、Kubernetesのマイナー更新の試験
- セキュリティ:外部認証やRBAC、最小権限を中心に、ネットワークポリシー、TLS、監査ログも確認します。
- データ保護:個人情報や製造データを扱う場合は、法令と社内基準に照らして、ログの保管場所と期間、委託先からのアクセス、報告を確認します。
各テストでは、検知の方法と一次対応者を決めておきます。そのうえで、復旧目標時間、ロールバック条件、記録の方法も定めます。
セキュリティ面では、イメージの脆弱性スキャンと、CIS Kubernetes Benchmarkに基づく自己評価を行います。公式にも、Rancher Managerと下流クラスタを守るセキュリティガイドやHardening Guideが用意されています。
フェーズ5:段階移行による稼働開始と切り戻しの準備
本番稼働は一度に行わず、段階的に始めます。
- 移行順:低重要度のサービス、検証環境、限定ユーザー、非クリティカル拠点から始めます。
- 移行確認:VM・Docker Composeの設定とログ、永続ボリュームを中心に、外部接続やバッチ、DBも確認します。
- 切替計画:日時と担当、データ同期、告知、成功判定、切り戻しの期限と手順を決めます。
- 現場の受入:エッジの通信断対応と遠隔更新を確認します。
製造ラインや店舗では、クラスタが動いていても業務が止まれば、移行は失敗です。そのため、受入基準は業務部門と一緒に決めます。さらに、イメージを作って起動するだけで終えると、運用上の依存関係が残ったままになる場合があります。
フェーズ6:運用の定着と担当者交代への備え
稼働後は、日次・週次・月次の作業を決めておきます。
- 日次:アラート、ノード、Pod、ディスク、証明書、バックアップの成否を確認
- 週次:脆弱性、ログ、リソース予測、デプロイ履歴を確認
- 月次:パッチ、更新候補、権限の洗い出し、復旧訓練、クラウド料金を見直す
更新は、まず検証環境で互換性を確かめてから、本番へ進めます。
納品物には、構成図やパラメータシート、Gitリポジトリのほか、Terraform・Helmコード、テスト仕様書・結果を含めます。
引き継ぎ資料には、バックアップ・復旧手順、障害の一次切り分け表、権限一覧が含まれます。さらに、更新方針と連絡先、エスカレーション表も引き継ぎます。
運用担当者が自力で復旧できるかは、ハンズオンで確かめます。引き継ぎの完了は、説明会の実施ではなく、手順に沿った復旧訓練に合格することと定めると、運用が定着しやすくなります。
Rancherのシステム開発の費用相場とコストの内訳
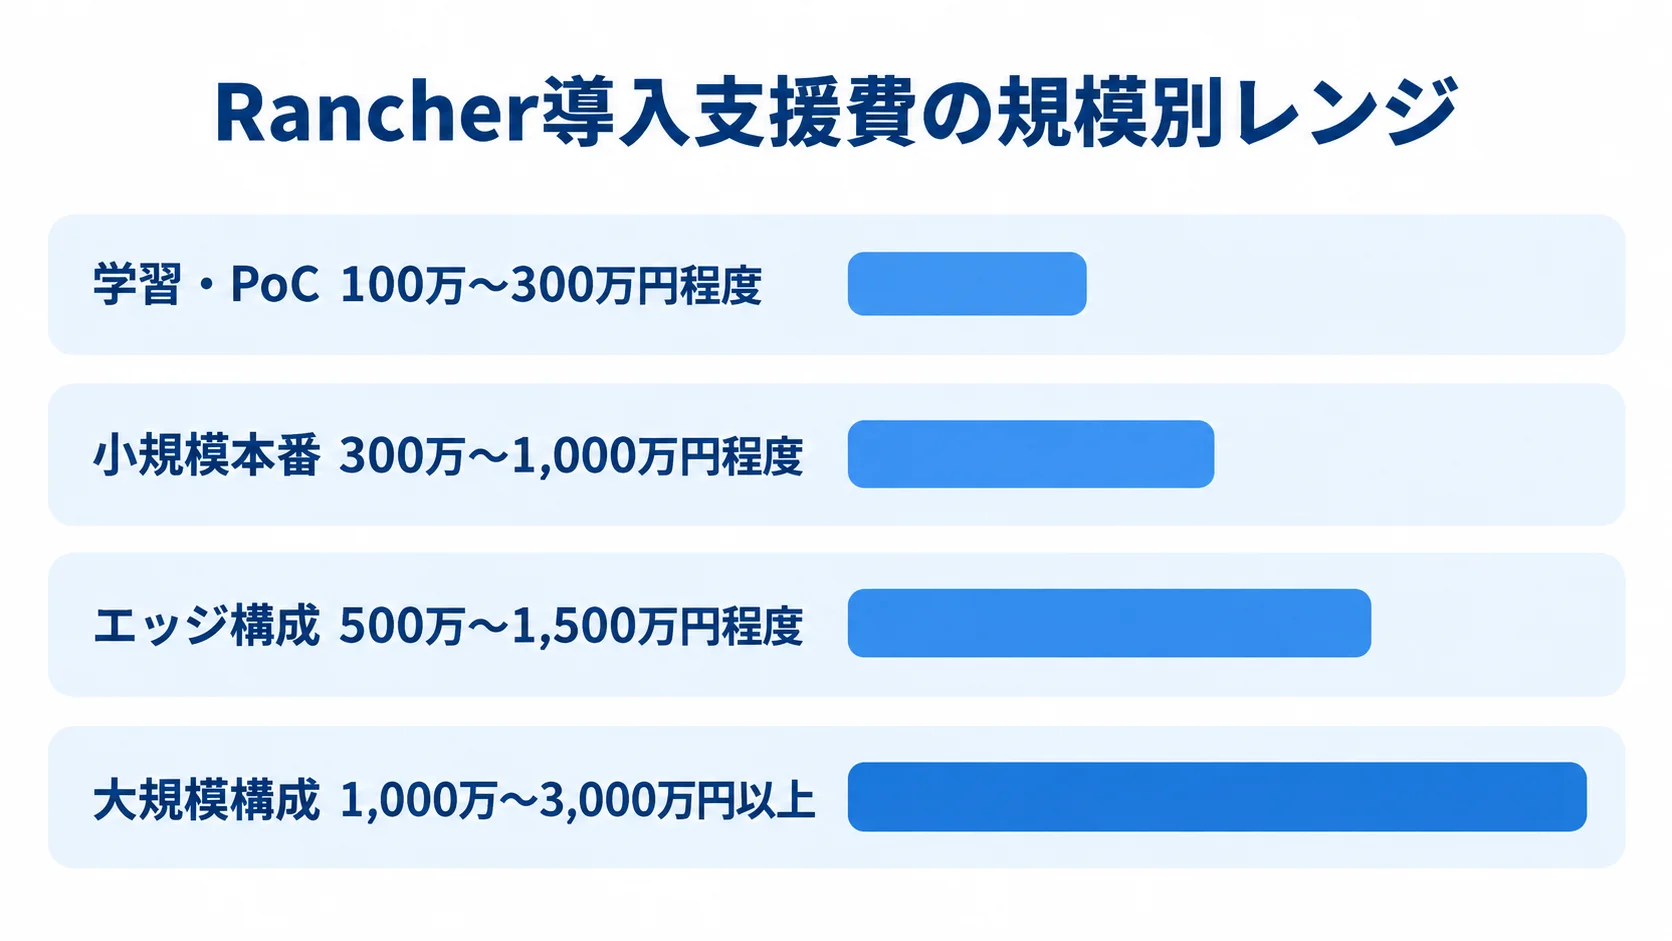
Rancherの費用は、ライセンス料に加えて、動かす基盤、導入の支援、導入後の運用も発生するため、4つの区分に分けて見ます。
- ライセンス:Community版またはPrime
- 基盤:クラウド・サーバー、ストレージ、ロードバランサー
- 導入支援:設計・構築・移行
- 継続運用:アプリ改修、監視、保守
ここで示す導入費は、要件と一般的な基盤構築の工数から作った推定レンジです。Rancher専用の国内一律価格ではない点に注意が必要です。
ライセンス費の考え方:Community版とPrimeの違い
Rancher Communityはオープンソースとして提供されているため、Primeとはライセンスの考え方が異なります。
- Community版:ライセンス料は0円ですが、基盤、構築、監視、バックアップ、脆弱性対応、人件費は別途必要です。
- 自社での更新:担当者と確認時期、更新条件を決め、セキュリティアドバイザリを確認し、アップグレードを検証します。
- Primeの価格:2 Coreまたは4 vCPU・1年は、Standardが2,175米ドル、Priorityが2,900米ドルです。
- 大容量契約:1〜2 Socket・最大64 Core・1年契約です。
- 換算の目安:1米ドル150円なら約33万〜131万円です。為替、契約期間、対象定義、販売店、サポート条件で変わります。
SUSE公式ショップは、Primeの大容量契約のMSRPを、Standardが6,525米ドル、Priorityが8,700米ドルで掲載しています(出典:SUSE Rancher Prime公式ショップ、2026年8月確認)。
導入支援費の規模別の目安
導入支援費は、構成の規模と、どこまでの作業を含めるかで幅が出ます。
- 学習・PoC:管理1台、下流3〜5ノード、簡易CI/CD、操作教育を含めて100万〜300万円程度
- 小規模本番:HA管理クラスタ、下流3〜20ノードの構成で300万〜1,000万円程度
- 別建てになりやすい費用:大幅なアプリ改修、データ移行、商用ライセンス、クラウド利用料
- エッジ構成:複数拠点のK3s・RKE2、通信断対策、遠隔更新、障害訓練で500万〜1,500万円程度
- 大規模構成:複数クラウド、DR、監査、GitOps、セキュリティ、データ移行で1,000万〜3,000万円以上の可能性
小規模本番の範囲には、SSO・RBACとTLSの設定が含まれます。このほかに、次の作業も範囲に入ります。
- 監視・ログ
- バックアップ
- 移行リハーサル
PoCの後にHAや監視などを足すと予算が膨らむため、最初から本番候補の要件を示しておきます。
運用保守費を左右する対応時間と責任範囲
運用保守費は、対応時間と責任範囲をもとに見積もられます。
- 最低ラインの参考:初期開発費の年15〜20%ですが、Kubernetes基盤では不足する場合があります。
- 対応時間:平日日中の問い合わせ対応か、24時間365日の監視・障害対応かで工数が変わります。
- 小規模環境:運用支援は月20万〜60万円程度が目安です。
- 大規模環境:24時間365日対応では月50万〜200万円以上の可能性があります。
- 費用の推定条件:ノード数、SLA、夜間・脆弱性対応、更新回数をもとに推定します(一律価格ではありません)。
見積書では、監視対象とアラートの対応時間、一次切り分けと復旧作業、月次レポートを確認します。さらに、更新検証とバックアップ復旧テスト、CVE対応と証明書更新は、個別に含まれるかを確かめます。
クラウドの従量課金は、月額が変わる要因になるため、別に管理します。コンピュート、ディスク、転送、ロードバランサー、ログ保管などが対象です。
Rancherの見積もりを取る際のポイント
見積もりは価格だけでなく、どのリスクを誰が担うかを比べる資料として使います。そのため、依頼書にはクラスタ数やSLA、用途、稼働後の更新と復旧の担当を書いておきます。
見積もり依頼書の記載内容:クラスタ数と運用条件
依頼書は、見積もりの前提になる条件を、分かる範囲で書いておくものです。
- 基盤条件:クラスタ数と環境、ノード数、CPU・メモリ、クラウドかオンプレミスか、拠点数
- 技術情報:RKE2・K3s・EKS・AKS・GKEなどの基盤種別、既存アプリとDB、レジストリ、CI/CD・監視・バックアップ、認証基盤
- 未確定事項:要件整理や現状調査を先行フェーズとして見積もりに含める
- 運用条件:許容停止時間、RTO・RPO、24時間対応、データ区分、納品物、切替希望日
- 責任分担:社内・委託の作業、通知、原因の切り分け、復旧、アプリ担当への連絡範囲
ベンダーの役割別の比較と担当エンジニアとの確認
候補は、知名度よりも役割・経験・運用体制を満たすかで比べます。
- 相談先:製品元、設計・構築SI、クラウド・監視MSP、サーバー・ライセンスを扱うOEMがあります。
- 必要な役割:製品元の支援、AWS・Azure統合、工場・店舗展開のうち、どれが必要かを照らし合わせます。
- 技術経験:Prime直接サポート、RKE2・K3s・クラウドKubernetes、アプリのコンテナ化実績を尋ねます。
- 運用体制:エッジ・オンプレミス実績、24時間365日対応、納品書類、更新担当の確認
- 担当者との確認:設計・障害対応のエンジニアに構成図と障害時の連絡経路を聞きます。
見積もりの除外項目と変更条件
合計金額と合わせて、どの作業が含まれないかを確認しておきます。
- 費用・契約:クラウド料金、Primeライセンス
- 移行・切替:アプリ改修、データ移行、夜間切替、現地作業
- 運用・定着:復旧訓練、CVE対応、証明書更新、ログ保管、教育
作業単位と成果物、検収・前提・追加費用の条件を一覧にしておくと、発注後の認識違いを減らせます。また、Kubernetes・Rancherの版、ノード・クラスタ数、接続先が変わった場合に再見積もりする条件も、あらかじめ明記しておきます。
SUSEのライフサイクルでは、Rancher 2.14.xのEOMが2026年10月30日、EOLが2027年10月10日と案内されています(出典:SUSE Product Support Lifecycle、2026年8月確認)。
採用する版のサポート期限は、見積もりと更新計画に含めておきます。そうすれば、短期間での再構築を避けられます。
Rancherのシステム開発でよくある質問
無料で使えるかという無料・有料の違い、EKSやAKSなどクラウドKubernetesとの関係、業務アプリの移行範囲は、よくある質問の代表例です。
Rancherは無料でシステム開発に使えますか?
Community版はライセンス料が0円でも、システム全体が無料になるとは限りません。クラウドやサーバー、ストレージ、構築に費用がかかります。さらに、監視、バックアップ、セキュリティ更新、障害対応にも費用がかかります。
商用サポートや契約上のSLA、ライフサイクル管理が必要なら、Primeやマネージドサービスも比べます。
EKSやAKSを使う場合もRancherを導入する意味はありますか?
複数のクラウドやチームをまたいで、認証・RBAC、可視化・ポリシー、アプリ配布・監視を統一したい場合は、導入する意味があります。
単一クラウドの小規模なサービスでは、EKSやAKSの運用が安定していて管理レイヤーが不要なら、Rancherの運用コストが利点を上回る可能性があります。
導入するかどうかは、その理由を統合・標準化、権限制御、引き継ぎのどこに置くかで判断します。
既存の業務アプリをRancherへ移行すれば、そのまま動きますか?
VM・Docker Compose前提の設定、ローカル保存、固定IPは、Kubernetes向けに見直す必要があります。さらに、バッチや外部ファイル、認証、DB接続、ログも確認が必要です。そのため、そのまま動くとは限りません。
非重要なサービスからコンテナ化し、データ同期と性能、監視、バックアップと切り戻しを試します。そのうえで、重要業務へ広げます。
Rancherの見積もり前に社内で準備する資料は何ですか?
見積もりの前には、現状の構成と運用状況が分かる資料を揃えておきます。
- 構成資料:ネットワーク図、サーバー・クラウド、VM・コンテナ、アプリとDBの依存関係。
- 運用資料:ユーザー・権限、監視・バックアップの現状、障害履歴。
- 移行条件:目標停止時間とRTO・RPO、移行対象と希望時期、クラスタ数・ノード数、運用時間帯。
- 不明点:未整理でも分かる範囲と不明点を分け、現状調査を見積もりに含めます。
条件がはっきりしているほど、各社の提案を同じ土台で比べられます。
まとめ:導入後の運用まで設計するRancher開発
Rancher開発は、要件整理から定着までの6段階で進めます。
目的と対象業務を決めたうえで、管理クラスタと下流クラスタを分けます。そのうえで、セキュリティ(HA、TLS、RBAC)と運用(監視、バックアップ、復旧、更新)を設計します。
PoCでは、動作の確認に加えて、障害から戻せるか、担当者が変わっても運用を続けられるかを確かめます。
成果の考え方:導入ではなく安全な継続運用
費用は、ライセンスと基盤、導入支援とアプリ改修、継続運用の各面から見ます。OSSのライセンスは0円でも、クラウドや人材、セキュリティと障害対応、復旧訓練の費用は必要です。
見積もりでは、金額とあわせて、成果物と責任分界、SLA、除外項目、バージョンのサポート期限を確認します。
最初の一歩:現状の整理と運用条件の明確化
開発の準備は、現状と運用条件を整理し、構成を選んでから、必要に応じてPoCで検証する流れです。
- 現状整理:インフラ(クラスタ、拠点)、アプリとデータ、権限、監視・バックアップ、停止と復旧の条件(許容停止時間、RTO・RPO)の一覧づくり
- 構成比較:社内運用の整理と、Community版、Prime、マネージドサービスと各基盤の比較
- PoC:必要に応じて障害復旧と更新を試し、業務チームが使い続けられる基盤を目指す
▼全体ガイドの記事
・Rancherのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。