
scikit-learnのシステム開発は、業務要件とデータを整理し、委託範囲を決め、PoCから本番運用へ進めると業務成果につながります。
発注では、発注形態を選び、RFPと契約を固め、費用と委託先を比べたうえで、段階的に進めます。
▼全体ガイドの記事
・scikit-learnのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
scikit-learnのシステム開発を発注する前の全体像
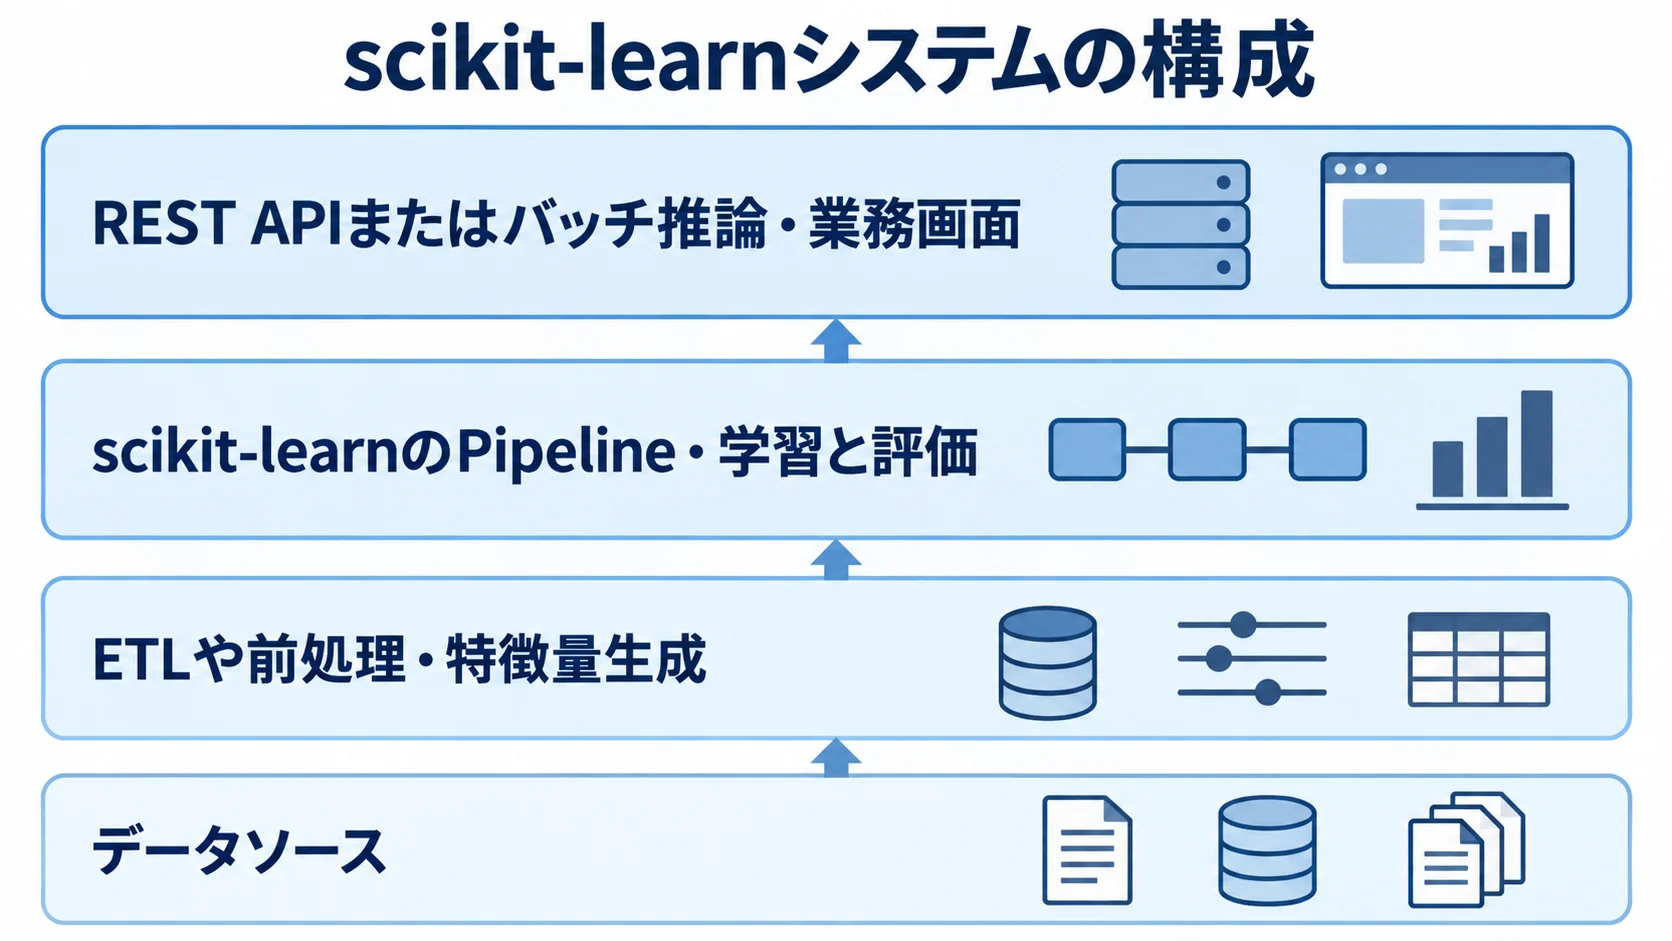
scikit-learnのシステムは、Pythonで作った機械学習モデルを業務データと業務フローに組み込む仕組みです。ライブラリの導入と学習だけでは、現場で使える形にはなりません。業務で使える形にするには、データの取り込みや業務画面への組み込みが必要です。
発注では、データソースから予測結果を業務で使うまでを一連の流れとして見ておく必要があります。
発注対象は、モデルではなく業務システム全体
典型的な構成は、データソースから取り込んだデータを前処理・特徴量生成し、scikit-learnのPipelineで学習と評価を行って、モデルを登録する流れです。さらに、REST APIまたはバッチ推論による予測の提供、業務画面・通知・帳票、監視と再学習までを含めて考えます。
データソースには、販売管理、CRM、IoT、ログなどがあります。たとえば需要予測では、予測値を表示するだけでなく、発注担当者が推奨量を確認・修正し、その結果を次回の学習に使う流れまで設計します。
表形式データに強いライブラリと併用の判断
scikit-learnは、表形式データを扱う業務と相性がよいライブラリです。たとえば、売上予測や解約予測、与信スコアリングのような業務が該当します。問い合わせ分類や異常検知、製造品質予測も含まれます。
対象業務が画像や音声、大規模な自然言語処理、GPU前提の深層学習、数億件規模の分散学習が中心なら、他の技術との併用を検討します。
併用の候補には、PyTorchやTensorFlow、Sparkのほか、クラウドのマネージドサービスがあります。選ぶときは、データ規模と予測頻度に加えて、説明のしやすさや社内の運用スキルを基準にします。
発注形態の選び方:内製・伴走支援・一括委託
発注形態を決めるときは、まず社内にPython・データ分析・インフラの人材がいるかを確認します。そのうえで、業務要件を言語化できるか、既存システムとの連携があるかを見ます。
公開後の運用を誰が担うかも、あらかじめ決めておく必要があります。最初にすべてを任せず、検証と本番化で依頼範囲を変えながら段階的に発注すると、費用と責任分界を管理しやすくなります。
内製:データと業務知識を社内に残す形
内製が向くのは、対象業務が一つで、データが整理され、社内にPythonを扱える担当者がいるケースです。
内製を進める場合でも、外部会社に初期設計のレビューや特徴量の作り方、評価方法を依頼できます。API化やセキュリティ確認を頼むこともできます。
業務知識とモデルの判断理由は社内に蓄積しやすい反面、担当者の異動や退職で作業が止まることもあります。そのため、学習コードやデータ定義を文書にして残し、依存ライブラリや再学習手順もあわせて書いておきます。
伴走支援:内製化と専門性の両立
伴走支援では、発注者が業務整理や一部の実装を進めます。外部会社は、設計レビューやPoC、コードレビューに加えて、MLOpsやクラウド・運用設計まで支えます。
社内に業務担当者がいて、将来は開発会社を変えられる状態を目指す企業に適しています。
契約前に、相談時間だけでなくレビュー対象と成果物を決めておくと、支援の価値を判断する材料になります。会議の頻度や回答期限、納品コードの利用範囲も、あらかじめ決めておきます。
一括委託:本番運用までの責任分界
一括委託では、企画から保守までの工程を一社などへ任せます。データ整備やモデル開発、APIや画面の実装に加え、テストやリリース、教育も含まれます。
IT人材が不足する企業に向いています。認証や基幹連携、監査ログ、高可用性をまとめて整える必要がある企業にも合います。
ただし、発注者が業務の判断を任せきりにすると、精度が高くても現場が使わないシステムになる恐れがあります。そこで、社内の業務責任者と承認者、受入担当者を必ず置きます。
RFPと要件整理:業務・データ・運用の具体化
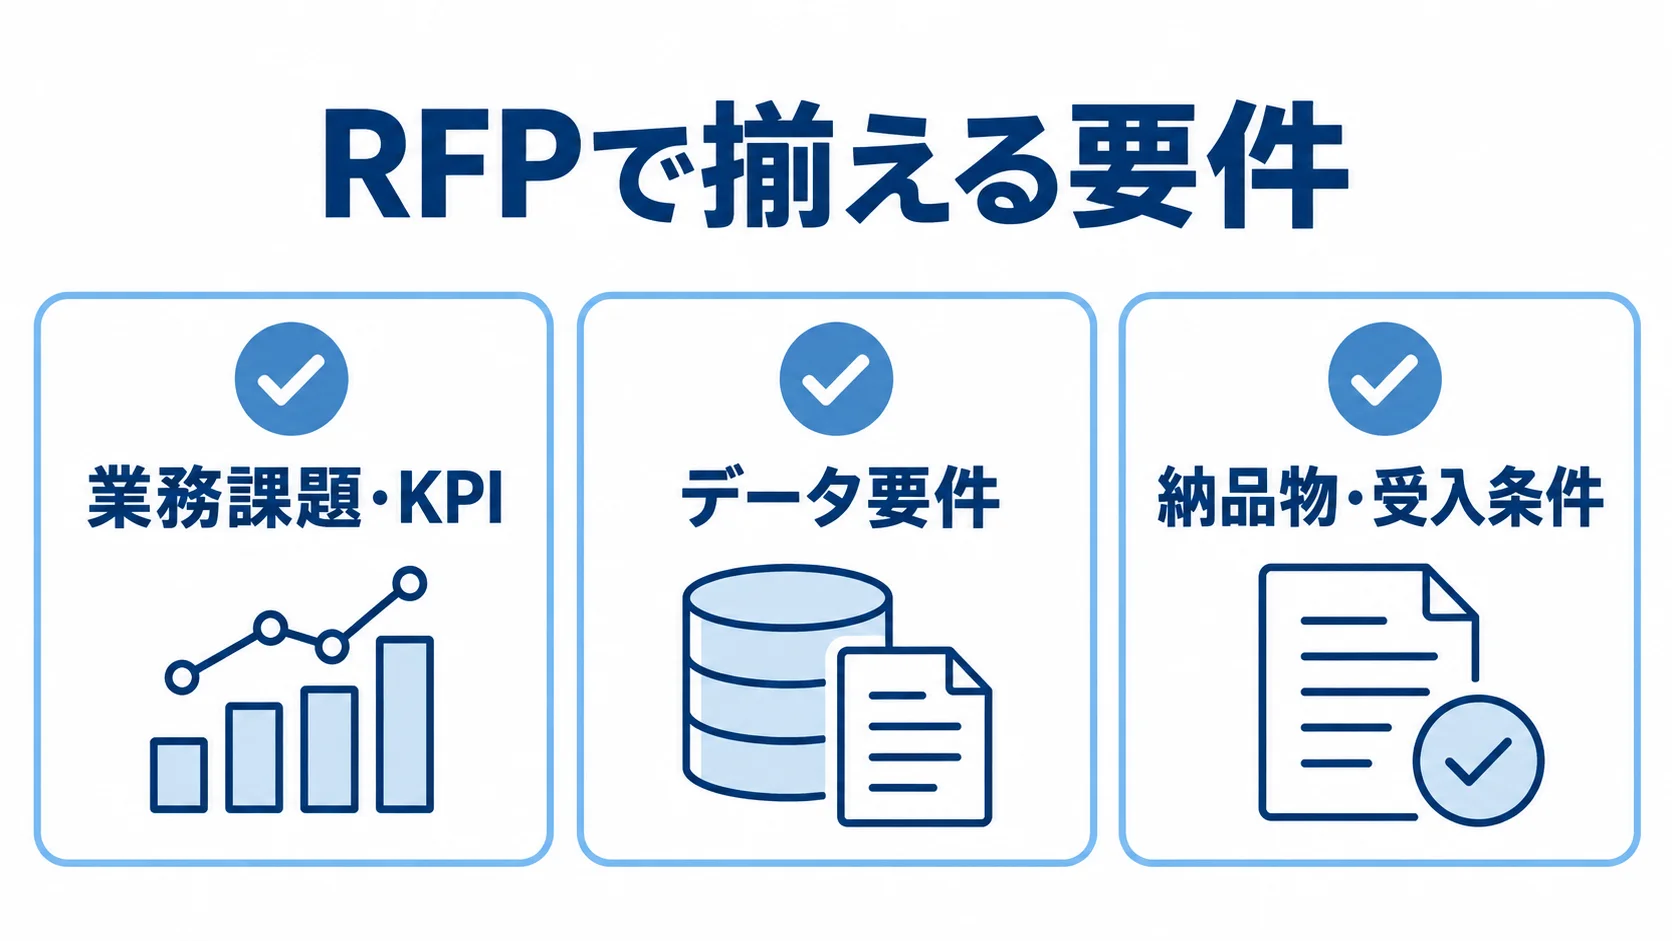
RFPは、開発会社へ希望を伝える資料であると同時に、自社の課題を整理する設計図でもあります。「AIで効率化したい」という段階から一歩進めて、誰がどのデータを使い、どの判断を支援し、導入後に何を変えるかを記載します。
IPAの資料は、RFP・提案書・見積書を基礎に、個別契約で定める考え方を示しています。作業範囲や契約類型、納期のほか、役割と納入物、委託料と検査も、個別契約で定めます(出典:IPA「システム開発の健全化に向けて」、2025年)。
業務課題とKPIの設定
RFPには、まず背景と対象部門を書きます。そのうえで、現状の作業時間や困っている判断、期待する業務効果を具体的に示します。
需要予測では、モデルの正解率だけでなく、業務側のKPIに分けて設定します。たとえば、欠品率を下げることや、発注作業を週あたり何時間減らすこと、担当者が例外を確認できることが挙げられます。
分類では、誤検知率や見逃し率、確認時間も書いておきます。予測のあとに取る業務アクションまで定義しておくと、PoC止まりを防ぎやすくなります。
データ要件:件数・期間・品質・利用目的
まず、データソースと期間、件数を整理し、項目一覧も用意します。欠損や重複、ラベル定義を確認し、更新頻度も決めておきます。個人情報の有無と保存先も、あわせて整理します。
学習データに、予測の時点では使えない情報が混じるリーケージも確かめます。期間の偏りや、担当者ごとの入力差にも注意が必要です。
データが未整備なら、モデル開発の前に、クレンジングや名寄せ、ラベル作成を発注範囲へ含めます。匿名化が必要なら、それも発注範囲に加えます。
RFPの段階で揃える納品物と受入条件
「AIモデル一式」と書いただけでは、何を受け取るのかが分かりません。データ定義や前処理・特徴量の仕様、Pipelineコードは、それぞれ分けて書きます。評価結果とモデルファイルも、別の納品物として記載します。
- 納品物:API・画面の仕様、テスト結果、Dockerやインフラ設定、監視項目、再学習と切り戻しの手順、管理者資料を、明記しておきます。
- 評価基準:指定したデータで評価指標が基準を満たし、推論時間が目標の範囲に収まることです。
- 異常時の条件:異常入力を拒否でき、ログが残ることです。
契約形態の選び方:要件の確定度と変更の多さ
機械学習の案件は、データを確認して初めて実現性が見えるため、完成物を最初から固めにくい傾向があります。そのため、要件定義やPoC、公開後の監視・改善は準委任が、仕様が確定した後のAPI・画面・バッチ開発は請負が現実的です。
契約名がどうであれ、何をいつまでに、どの基準で確認するかを決めておきます。
請負契約:成果物と検収基準
請負契約は、合意した成果物を完成させ、発注者が検収する工程に向いています。モデル推論APIやバッチ処理、業務画面など、完成条件を具体化できる場合に適します。
データ連携や権限設定、テスト結果も、完成条件として具体化しておきます。
途中で学習データや評価指標を変えると、費用と納期の調整が必要になります。そこで、変更要求の影響範囲と追加工数、契約変更の承認者を、あらかじめ決めておきます。
準委任契約:調査・伴走・継続改善
準委任契約は、専門家の作業や助言を一定期間受ける形に向いています。
現状分析やデータの洗い出し、モデル候補の比較に使えます。PoCと内製支援のほか、精度劣化への対応、再学習、クラウド費の見直しにも使えます。
優先順位が変わりやすい業務にも適します。その場合は、月次計画と成果報告、課題一覧を決めておきます。あわせて、レビュー日や終了条件、翌月への持ち越し事項も定めます。
モデル・コード・データの権利と安全管理
契約では、権利の範囲と個人データの管理を分けて確かめます。
- 権利の対象:学習済みモデルや学習コード、特徴量定義、データ、汎用部品が対象です。
- 利用範囲:自社での再学習、他社への引き渡し、共通部品の利用を、契約書と仕様書に記載します。
- 個人データの管理:利用目的、アクセス権限、保存期間、再委託、削除、事故時の連絡と監査の方法を定めます。
個人情報保護委員会の通則ガイドラインは、委託先の選定や契約、取扱状況の把握を含めた監督の考え方を示しています。そのうえで、再委託先や業務内容、取扱方法の事前の報告と承認も重要です(出典:個人情報保護委員会「個人情報の保護に関する法律についてのガイドライン(通則編)」、2026年8月確認)。
安全管理は、scikit-learn固有の契約条項というより、データの種類と利用目的に応じて設計します。
scikit-learnのシステム開発費用の相場(段階別)
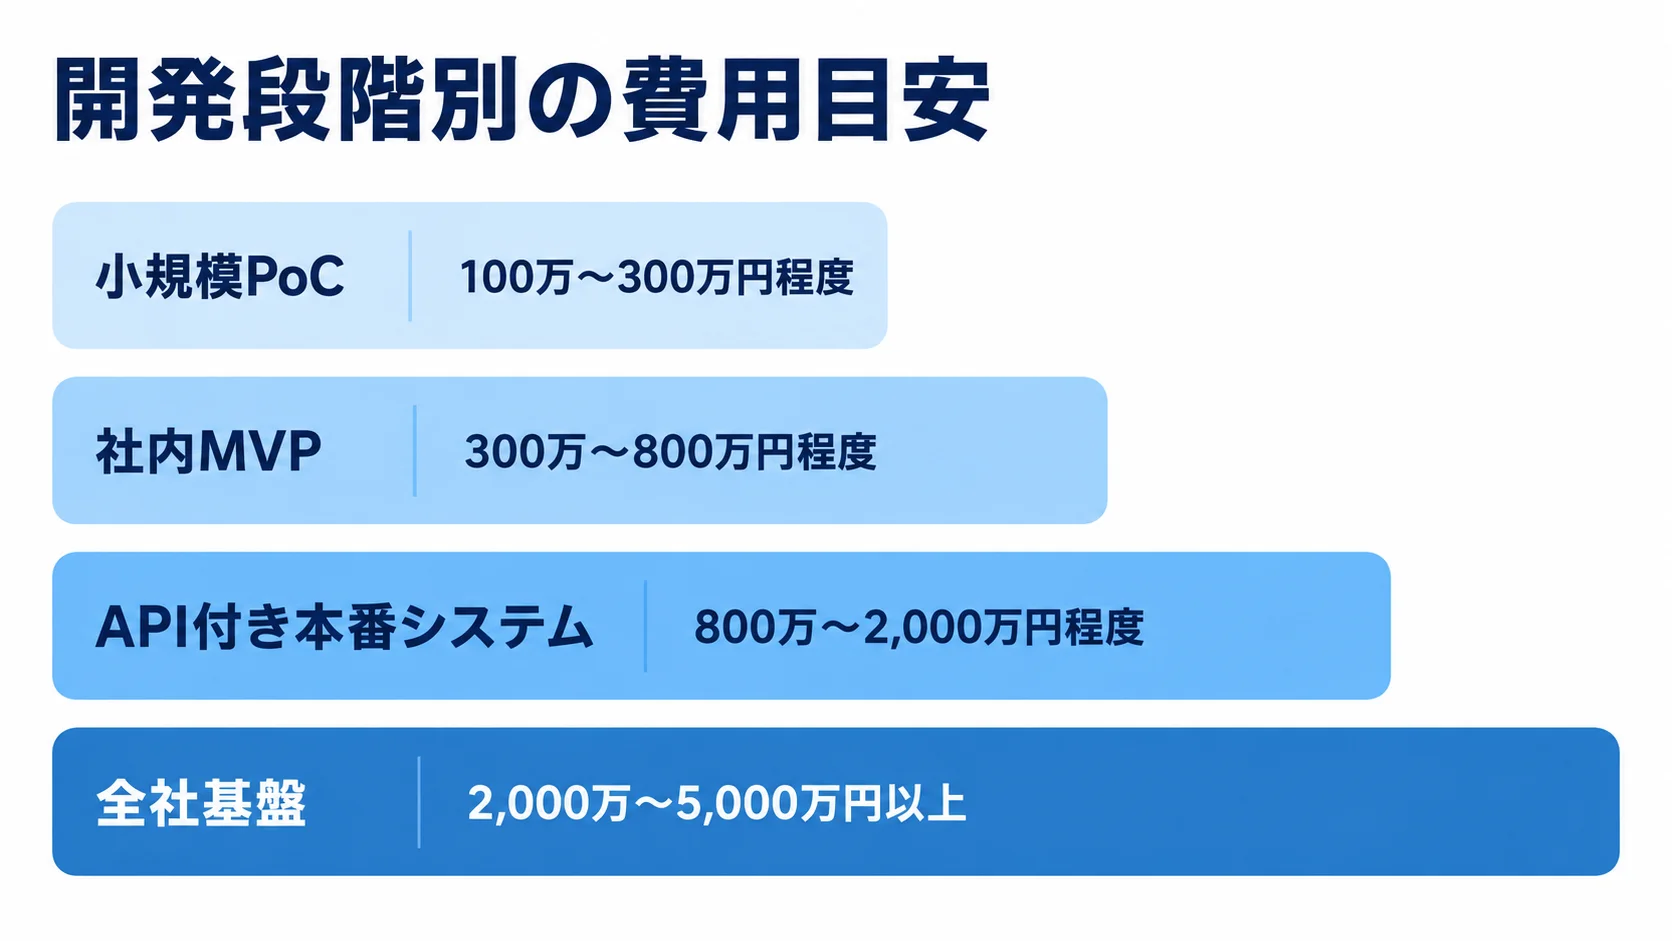
scikit-learnはオープンソースのため、基本的なライセンス費は抑えやすいライブラリです。一方で、業務システムの費用は、データ整備やモデル開発、API・画面の作り込みで決まります。さらに、連携やクラウドの範囲に加えて、テストや監視、保守も費用を左右します。
これは、リサーチノートで整理した一般的な業務システム相場と、機械学習・API開発の工数から組み立てた、発注前の推定レンジです。scikit-learn案件の公的な価格統計ではないため、正式な予算は同じRFPで複数社へ確認します。
小規模PoCの初期目安:100万〜300万円程度
データ1〜2種のオフライン学習や、ベースライン比較、精度評価、簡易レポートを含むPoCは、100万〜300万円程度、期間は1〜3か月程度が目安です。
この目安は、データを取得でき、ラベル定義も済んでいることが前提です。画面や本番APIは含みません。
欠損やラベル作成の負担が重い場合は、PoCの前にデータ整備費として100万〜500万円程度が別途必要になる可能性があります。
社内MVPの検討レンジ:300万〜800万円程度
ETLやPipeline、定期バッチを含む社内MVPは、300万〜800万円程度、期間2〜4か月程度が目安です。権限付き画面やCSV連携、再学習手順も含みます。
費用は、画面の数やデータクレンジングの有無で変わります。認証連携や受入テスト、教育を含めるかどうかも、金額に影響します。
PoCの成果物は、そのまま本番へ移せるとは限りません。そのため、コード整理やテストの自動化、監視は、別の項目として確認します。バックアップと障害時の運用も、別々に見ておきます。
API付き本番システムの費用の幅
本番化の構成ごとに、費用と期間の目安が異なります。
- API付き本番:複数DB・API連携とREST推論を含みます。加えて、画面や権限、ログ、テスト、再学習手順も入ります。
- 費用・期間:上記を含む場合は、費用が800万〜2,000万円程度、期間が4〜8か月程度です。
- 全社基盤:全社DWH、モデルレジストリ、CI/CD、精度・データドリフト監視を含みます。冗長化や監査対応、複数モデルにも対応します。
- 費用・期間:これらを求める場合、費用は2,000万円から5,000万円を超えることがあり、期間は6〜12か月以上になる可能性があります。
これらは発注前の推定です。なかでも、連携数と非機能要件が費用を大きく左右します。
クラウド費は、学習と推論、ストレージやログ、監視やデータ転送の費用に分けて見積もります。AWSを使う場合は、推論の方式と課金条件を、利用状況に合わせて確認します。
- 推論方式:SageMaker AIには、リアルタイムとサーバーレスのほか、非同期推論とバッチ変換があります。
- 課金条件:リアルタイムはインスタンスの利用時間、サーバーレスは実行時間などに応じます。
- 方式の選択:日次予測ならバッチ、アクセスが増減する業務ならサーバーレスなど、方式の選択が月額を左右します。
この課金条件は、AWSの料金情報に記載されています(出典:AWS「Amazon SageMaker AI pricing」、2026年8月確認)。
委託先の選定と見積比較:技術以外の確認項目
委託先は、コードを実装する力と業務データの扱い、既存連携、モデルの維持で比べます。公開事例の精度や手法からは、PoCと本番運用の区別がつきにくいため、同じRFPで前提と対象外、成果物、保守範囲をそろえます。
本番稼働したモデルと業務連携の実績
実績を確かめるときは、モデルと業務運用の両面から質問します。
- モデル実績:稼働したモデルの種類と推論方式、データ件数、利用者数を確認します。
- 運用実績:画面連携や障害対応、再学習の頻度について質問します。
可能であれば、匿名化した画面や構成図、納品ドキュメントのサンプルを見せてもらいます。
株式会社ビープラウドは、流通業務の優先度スコアリングに、scikit-learn、pandas、NumPyを使った開発事例を公開しています。Python実装を業務へつなげた実績を確かめる材料になります(出典:株式会社ビープラウド「データ分析・機械学習システム開発事例」)。
データ・アプリ・インフラを横断する体制
まず、データサイエンティストやMLエンジニアの担当者がいるかを確認します。加えて、バックエンドやインフラ、PM、業務コンサルタントの担当者も、体制に含まれているかを見ます。
モデル担当とAPI・画面担当が別々の場合は、データ形式やエラー処理、リリース責任が分断されない体制が必要です。障害時の連絡先も、途切れないように決めておきます。
再委託がある場合は、会社名と担当範囲を確認します。個人データへのアクセスや管理責任者、契約終了時の返却・削除も、あわせて確かめます。
見積の比較:工程・前提・対象外
見積は、工程と追加条件に分けて読みます。
- 要件・データ・モデル:要件定義とデータ調査・整備、ラベル作成、モデル開発・評価を、別々の項目にします。
- 実装・運用:APIや画面、連携、インフラ、セキュリティを一つの区分にまとめます。テストや移行、教育、保守は、別に分けます。
- 追加条件:データ不足や連携先の仕様変更、精度未達は、追加条件として見ます。モデル更新と障害対応、月次再学習、クラウド従量課金も、追加条件として確認します。
「AI開発一式」とだけ書かれた見積では、精度検証や画面があるのか、再学習やクラウド費が含まれるのかが分かりません。
各社の見積を同じ項目に並べ、金額の差より、含まれる作業の差を見るとよいです。
安い見積が、PoCだけで本番運用を含まない場合もあります。そのため、前提と対象外をRFPと照らし合わせ、抜けた工程を洗い出します。
scikit-learnのシステム発注・外注を進める手順
発注者側の体制と成果物を明確にしながら、次の流れで進めます。
- 相談と現状の確認を行い、RFPを提示する。
- 提案と見積を比べ、契約と要件定義へ進む。
- PoCまたは試作を経て、本開発と受入テストを行う。
- 移行と教育を済ませ、運用を開始する。
発注者側に意思決定者と業務責任者を置き、工程ごとに承認者と成果物を決めておくと、認識のずれを早く見つけられます。
発注前のデータ・KPI・社内体制の準備
まず、対象業務と予測・分類の目的、利用者を決めます。そのうえで、データの所在や想定件数、更新頻度を整理します。個人情報の有無、希望時期、予算の考え方も、あわせて書き出しておきます。
データを外部に渡せない場合は、サンプル化やマスキングを検討します。オンプレミス環境の利用や、秘密保持契約が必要かどうかも確認します。
社内には、業務判断者、IT・セキュリティ担当者、法務・調達担当者を置きます。それぞれが何を決めるのかも、あらかじめ明確にしておきます。
PoCと本開発の境界の決め方
データ品質や実現性が不明なら、まず代表データを使います。ベースラインや候補モデルを比べ、評価指標と業務効果を確かめたうえで、本番化を判断します。
PoCの成果物には、精度結果だけでなく、利用データと採用しなかった方法を含めます。再現手順や残課題、MVPへ引き継ぐコードとデータ定義も、あわせて残しておきます。
PoCの終了条件と本開発への移行基準を契約に含めておくと、目的のない追加開発を抑えられます。
受入テストと運用引き継ぎ
受入テストと引き継ぎでは、入力パターンと運用条件を確かめます。
- テスト入力:正常データに加えて、欠損や異常値、想定外カテゴリを試します。通信失敗や閾値付近の推論結果も含めます。
- 運用条件:精度や推論時間、同時利用数、権限を確認します。ログやバックアップ、復旧、手動判断への切り戻しも見ておきます。
現場の担当者が予測結果を見て行動できるかも、検証しておきます。リリース前には、データとモデルの版、Python・scikit-learnの依存関係を記録します。
- 保存ファイルの信頼性:pickle、joblib、cloudpickleの形式では、信頼できない提供元のファイルを避けます。
- 互換性と形式:異なるscikit-learnのバージョン間での読み込みは、正式にはサポートされていません。skops.ioやONNXも検討の候補になります。
信頼できるモデルだけを読み込む仕組みを、発注条件にします。ハッシュや署名、アクセス制御、サンドボックスも、あわせて条件に加えます。
この注意点は、scikit-learnの公式ドキュメント「Model persistence」に記載されています(2026年8月確認)。
クラウドを使う場合は、既存環境のサポート期限も確かめます。Microsoft Learnによると、Azure Machine Learning SDK v1のサポートは2026年6月30日に終了し、v2への移行が推奨されています。
2026年8月時点でAzureを選ぶ場合は、SDK・CLI v2や現在の監視方式を確かめます。移行費用と担当者のスキルも、あわせて見ておきます。
出典はMicrosoft Learn「SDK および CLI(v1)- Azure Machine Learning」です(2026年8月確認)。
よくある質問(FAQ)
社内会議やベンダーとの相談で出やすい質問に、順に答えます。
費用や契約の条件は案件によって変わります。一般論だけで予算や法的な判断をすると、自社の条件と合わなくなるおそれがあるため、自社のデータと要件に照らして確認します。
scikit-learnのシステム開発は無料でできますか?
ライブラリの導入費は抑えられても、データ整備からモデル、API・画面、保守まで、人件費や利用料がかかります。まずは小さなPoCでデータとKPIを確かめ、本番化の費用は段階ごとに見積もるのが現実的です。
発注時に予測精度を何%保証してもらえますか?
将来のデータや入力の品質に左右されるため、精度の絶対値を無条件に保証できるとは限りません。
そのため、評価用データの期間やベースライン、指標を発注前に合意しておきます。誤検知と見逃しの許容範囲、再評価の頻度も決めておきます。精度が下がったときの通知と再学習、業務KPI、人による確認も受入条件に含めます。
個人情報を含むデータの学習を外注できますか?
外注できる場合はありますが、その前に、利用目的や安全管理、権限を確認します。再委託や保存場所、削除、事故時の連絡も、あわせて決めておきます。
実データを渡さずに進める方法もあります。匿名化や仮名化、サンプルの利用が考えられます。オンプレミス環境を使う方法もあります。
適法性や国外への移転については、個人情報保護委員会の最新のガイドラインと、法務担当者に確認します。
開発会社は何社に見積を依頼すればよいですか?
比較できるRFPを使い、複数社へ依頼します。前提と対象外もそろえておきます。候補は、Python・scikit-learn実装型とクラウドMLOps型に分けられます。基幹連携SI型や数理モデル型も含めて、型ごとに比べます。
価格に加えて、PoCから本番までの体制と納品物を確認します。再学習や保守、データ返却、再委託の条件も、あわせて確かめます。
まとめ:scikit-learnのシステム発注は業務成果からの逆算
発注では、まず業務課題から整理し、利用データ、予測後の行動、導入後のKPIを順に決めていきます。そのうえで、小規模PoC、社内MVP、本番基盤と段階を分け、実現性と効果を確かめながら投資を広げられます。
発注前に確認する項目の一覧
まず、業務とKPI、データの所在や品質、利用目的を確認します。次に、PoCと本番の条件、API・バッチ・画面の方式を確かめます。さらに、安全管理や契約・納品・受入基準、保守・再学習を押さえます。加えて、モデル・コードの権利、再委託、契約終了時の返却も見ておきます。
見積は、データ整備やモデル、アプリ、クラウドの区分で見ます。テストや教育、運用の区分も確かめて、金額の大小より前提の違いを比べます。
最初の一歩:小さなRFPと相談
完璧な仕様書は不要です。まずは、業務課題とデータサンプル、期待するKPIを一枚にまとめます。利用者や希望時期、社内で担える範囲も、あわせて書いておきます。
データから業務システム、運用まで相談できる会社に、提案を依頼します。PoCの結果を本番へつなぐ条件を先に決めておくと、追加費用と手戻りを抑えやすくなります。
▼全体ガイドの記事
・scikit-learnのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。