
scikit-learnのシステムは、データから予測モデルを学習させ、その結果を業務で使える形にして運用する仕組みです。データの準備や監視、再学習まで含めて設計します。
各テーマの詳しい内容は、下の関連記事で確認できます。
▼関連記事一覧
・scikit-learnのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・scikit-learnのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・scikit-learnのシステム開発の見積相場や費用/コスト/値段について
・scikit-learnのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
scikit-learnのシステムの全体像
scikit-learnを使うだけでは、業務システムは完成しません。
データを加工してモデルを学習し、予測を業務で使える形にして品質を管理する仕組みが、あわせて必要になります。
ライブラリ単体と業務システムの違い
業務システムでは、ライブラリのモデル処理に加えて、利用者が予測結果を業務で使うための機能を組み込みます。
- ライブラリの処理:データ読込、特徴量作成、分類・回帰モデルの学習と評価。
- 業務での利用:販売管理や顧客管理から取得し、権限確認後に画面・CSV・通知へ出力。
本番では、学習時と推論時の前処理をそろえ、モデルのバージョンを管理します。
入力の異常や精度の低下も、本番で検知します。
特に、モデル開発だけで止めると、PoCに成功しても業務システムとして使えない状態になりやすいです。
得意な業務領域と苦手な領域
表形式データを扱う場合は、次のような業務や分析が活用候補になります。
- 表形式データ:分類・回帰・クラスタリングに適し、売上・需要・解約の予測や与信スコアリングの候補になります。
- 分類・検知:問い合わせのカテゴリ分類、製造品質の予測、設備の異常検知にも活用できます。
- 分析機能:前処理、特徴量選択、交差検証、評価指標、ハイパーパラメータ探索。
画像・音声、大規模NLP、GPUを使う深層学習、数億件規模の分散学習では、別の技術を併用します。
常時更新のストリーミングでは、別の基盤が候補になります。
scikit-learnを使うこと自体を目的にせず、データの形と量、更新頻度、業務上の応答時間から判断します。
scikit-learnのシステムでできることと活用例
活用例を考えるときは、「予測する」で終わらせず、予測結果を見た担当者が何を変えるのかまで定義します。
たとえば在庫を減らしたいなら、予測値に加えて発注候補、信頼区間、確認が必要な商品を画面に出し、発注業務につなげる設計が欠かせません。
需要予測・売上予測のシステム
過去の販売数、価格、販促を特徴量にして、商品や店舗ごとの需要を推定します。さらに、曜日、季節、天候、在庫も特徴量に加えます。
日次や週次の発注に使う場合は、夜間にバッチで予測し、翌朝の発注画面に反映する方式が現実的です。
需要予測では、セールや新商品のように、過去に十分なデータがない条件も発生します。そのため、次の3点を業務画面と評価に組み込みます。
- 手動補正:担当者が数値を直せる欄を業務画面に持たせ、モデルの数字を絶対視しないようにします。
- 代替ルール:予測を使わない場合に従う取り決めを用意します。
- 業務KPI:予測誤差を追うだけでなく、欠品率や廃棄率も見ると、精度を競うだけの状態から抜け出せます。
分類・解約予測・異常検知のシステム
分類・解約予測・異常検知では、扱うデータに応じて、次に取る業務上の行動を決めます。
- 分類:問い合わせを部署へ振り分け、取引をリスクの区分に分けます。
- 解約予測:利用頻度、契約期間、問い合わせ履歴から、フォロー対象を抽出します。
- 異常検知:設備の温度・振動や取引金額などで、通常パターンからの逸脱を検知します。
分類の問題では、正解率だけを見ると危険です。見逃しを減らすのか、誤検知による確認の手間を減らすのかで、適切な評価指標が変わります。
どの誤りを許容するかは、再現率、適合率、F1スコア、ROC-AUCなどを業務上の損失と結びつけて、事前に合意します。
顧客分類・次元削減などの分析システム
正解ラベルがないデータも、クラスタリングや次元削減を使い、初期分析に活用できます。
- グループ化:顧客や商品を行動傾向でまとめ、営業施策の対象を整理します。
- 次元削減:多数の指標を少数の要素にまとめ、データの偏りを探します。
クラスタ番号そのものには、業務上の意味がありません。そこで、各グループの特徴を人が確認し、施策名や運用ルールに置き換える工程が必要です。
分析結果は、そのまま自動配信する前に、仮説検証と現場ヒアリングを組み合わせて確かめます。
scikit-learnのシステム構成
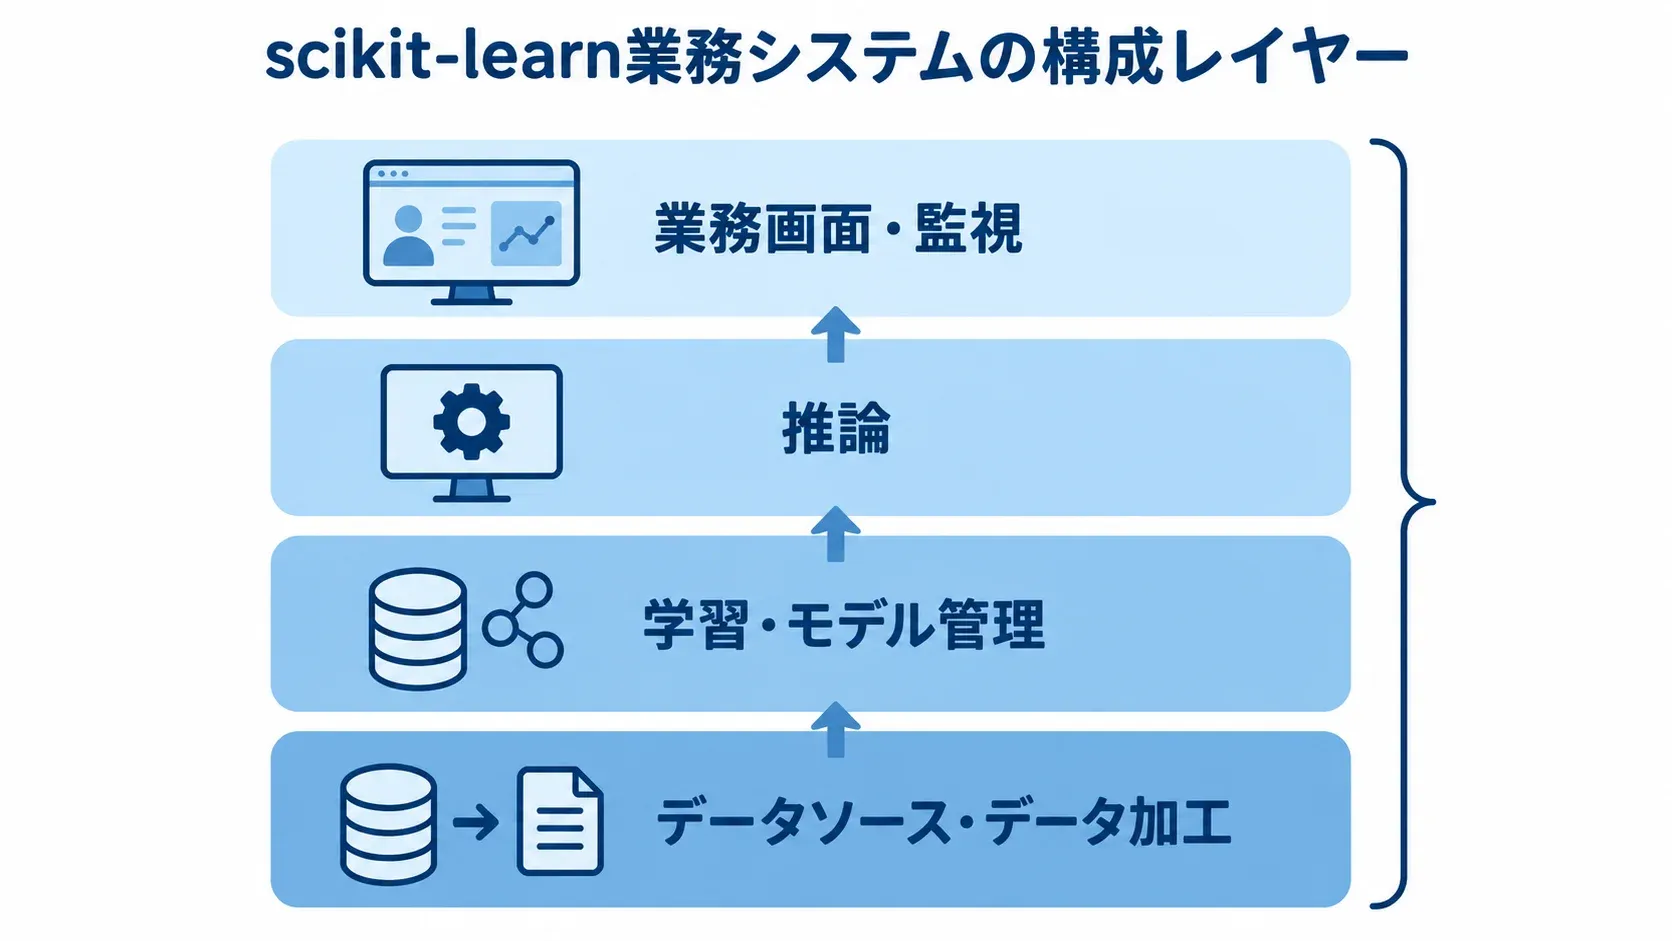
典型的な構成は7層です。データソース、データ加工、学習の層でモデルを作り、モデル管理、推論、業務画面、監視の層で業務に使える形にして運用します。
小さなPoCでは、一つのPython環境にまとめても構いません。
本番化する段階では、学習処理と利用者向けの推論処理を分けておくと運用が楽になります。
データ収集・前処理・特徴量生成の層
データ準備では、取得元と品質を確かめたうえで、学習時にしか得られない情報を推論に使わないようにします。
- 取得元:販売管理、CRM、IoT、ログ、帳票からデータを集めます。
- 品質調整:欠損、重複、異常値、単位、日付のずれを整えます。
- リーケージ防止:推論時に得られない情報を、学習に混ぜないようにします。
データリーケージは、PoCでの高い精度を本番で再現できない原因になります。
前処理とモデルを別々に管理すると、学習時に標準化した値を、推論時に未処理のまま使ってしまう事故が起きます。
前処理とモデルをPipelineにまとめ、入力スキーマと変換ルールをテストしておけば、再現性を確保できます。
モデル管理・API・バッチ推論の層
モデルと評価条件を記録したうえで、必要な応答時間に応じて推論方式を選びます。
- モデル管理:評価結果、学習期間、Python・ライブラリ版、特徴量定義を記録します。
- バッチ推論:日次・週次など、まとめて処理できる業務に使います。
- オンライン推論:画面操作から数秒以内の応答が必要ならREST APIを選びます。
APIでは、入力値の型・範囲・必須項目を検証します。
APIでは、タイムアウトやモデル未稼働時の代替処理も設けます。
予測だけでなく、モデル版、判定日時、信頼度、処理結果をログに残しておくと、後から説明する際の材料になります。
業務画面・監視・再学習の層
業務画面では、人が結果を確かめられる作りにしておきます。
データや正解ラベルの変化による精度低下にも備えます。
- 利用画面:予測結果を見て承認・修正・保留できるようにします。
- 監視項目:件数、エラー率、処理時間、入力分布、判明後の精度、業務KPI。
- モデル更新:条件を超えた場合の再学習、承認、リリース、旧モデルへの復帰を決めます。
scikit-learnのシステム開発の5段階の進め方
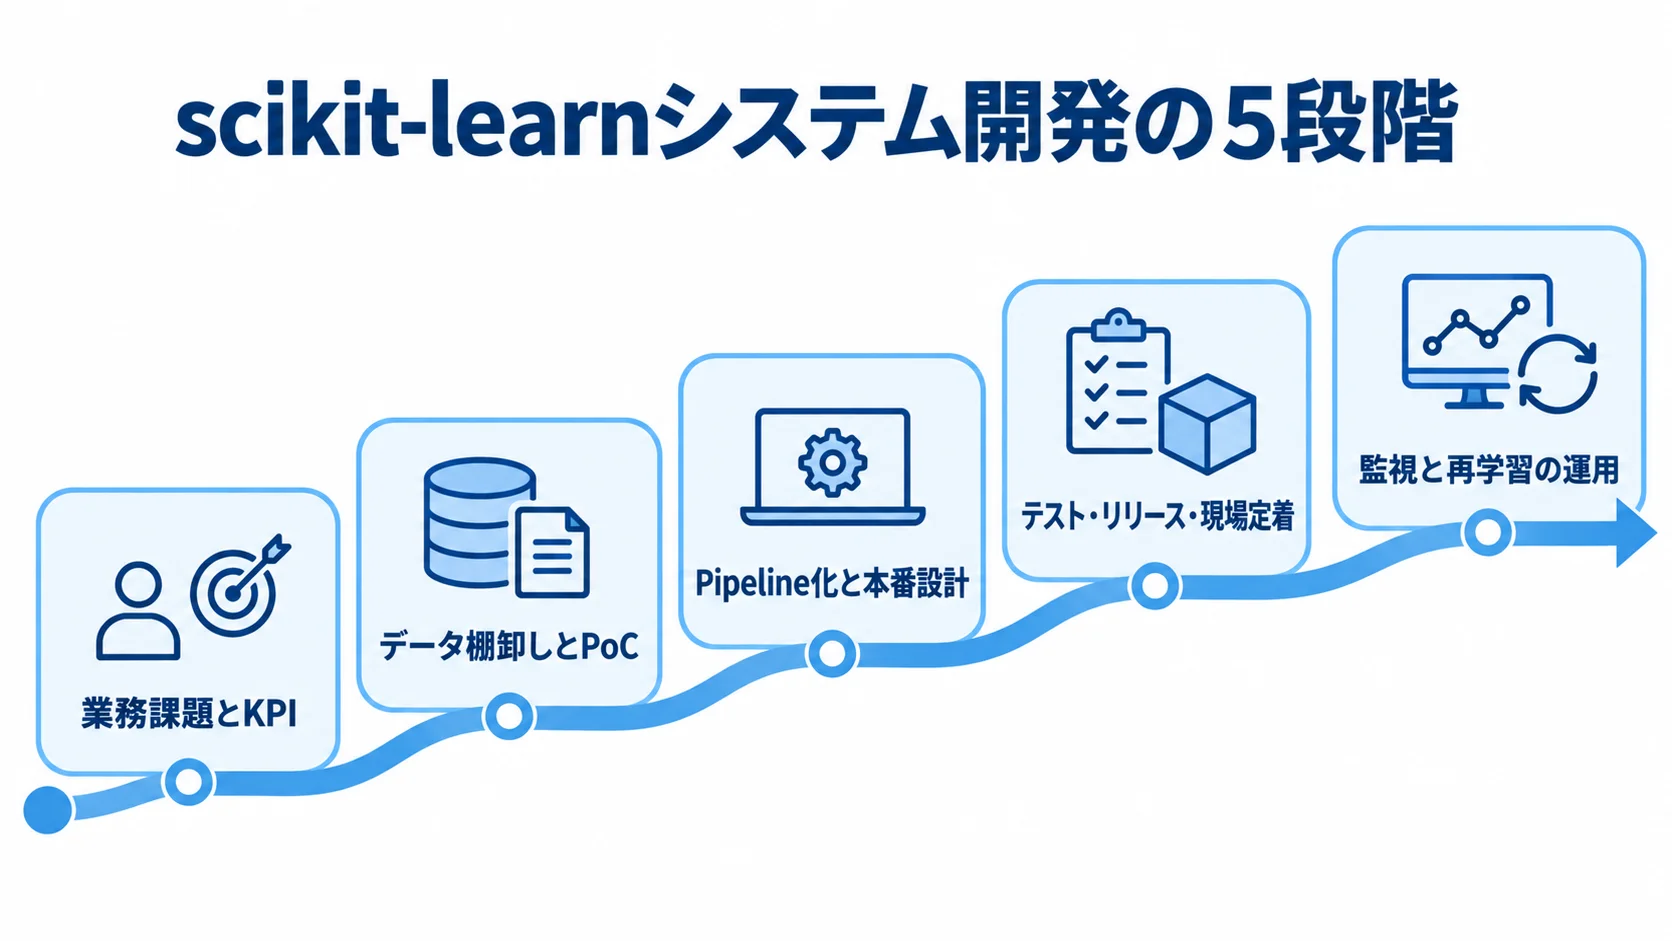
開発では、モデルの精度を上げることだけでなく、業務課題、データ、予測の使い方、運用責任を順番に固めていきます。そのうえで、PoCから本番へ段階的に進めると、無駄な開発を抑えられます。
▶ 詳細はこちら:scikit-learnのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
1. 業務課題とKPIの定義
完成条件を決めるには、「AIで業務を効率化する」という目標を、現場の成果と行動まで具体的に書き直す必要があります。予測を使う担当者や判断の場面も、要件に含めます。
- 成果:欠品率、一次振り分け時間、異常の見逃しを改善対象にします。
- 利用方法:誰が、いつ、どの画面で予測を見て判断するか決めます。
機械学習の指標と業務KPIは、分けて定義します。たとえば、平均絶対誤差を下げても、発注担当者が予測を見なければ業務成果は変わりません。
誤検知1件と見逃し1件のそれぞれの損失、許容できる処理時間、説明が必要な利用者を、初期の段階で確認します。
2. データの確認とPoCの実施
次に、利用できるデータの期間、件数、項目、欠損、更新頻度、正解ラベルの有無を確認します。個人情報や機密情報を含む場合は、利用目的、アクセス権限、委託範囲、保存場所を整理したうえで、検証用データを作ります。
PoCでは、いきなり複雑なモデルを選ぶのではなく、まず単純なルールやベースラインと比べます。
学習データと評価データの分け方、未来の情報が混ざっていないか、対象期間に偏りがないかを確認します。さらに、精度と処理速度、説明のしやすさを記録し、業務KPIの変化も残します。
3. Pipeline化と本番設計
PoC後は、前処理からモデル保存までを再実行できるようにし、同じ条件を再現できる記録を残します。
- 再実行:前処理、学習、評価、モデル保存を一連の処理にします。
- 記録:学習データの版、コード、依存版、評価結果、承認者を残します。
日次ならバッチ、即時応答ならAPI、外部送信できないデータならオンプレミスやエッジを候補にします。
予測結果を保存するか、都度計算するかによって、データベースと監査ログの設計も変わります。
4. テスト・リリース・現場定着
テストでは、正常系に加えて入力異常や通信障害も扱います。続いて、精度と速度、権限を確認し、個人情報の扱いや手動運用もあわせて確かめます。
- 入力・通信:欠損、異常値、未知カテゴリ、極端値、タイムアウトを確認します。
- 運用・安全:精度、速度、権限、マスキング、障害時の手動対応を試します。
リリース後は、いきなり全社へ展開せず、一部の部署や商品群で試すのが安全です。
まずは人が予測を確認し、問題がなければ自動化の範囲を広げていきます。違和感や補正の履歴も記録しておきます。
5. 監視と再学習の運用ルール
精度の確認頻度を定め、正解がすぐ分からない場合は代替指標も監視します。
- 確認頻度:月次または一定件数ごとなど、運用に合わせて決めます。
- 代替指標:入力分布、予測の偏り、修正率、業務KPIを追います。
誤ったデータで自動更新されるのを避けるため、再学習の候補作成と、評価・承認・公開を分けます。復帰も含めて、担当者とSLAを定めます。
scikit-learnのシステム開発費用の相場と内訳
scikit-learn自体はBSD 3-Clauseライセンスのオープンソースで、基本的なライセンス費は無料です。
ただし、システム化の総額は、データ整備、人材、既存システム連携で決まります。APIや画面の開発、クラウド、監視、保守も、総額に含めて考える必要があります。
以下の金額は、一般的な業務システムの工数と機械学習PoCの範囲から組み立てた、2026年時点の初期推定です。scikit-learn案件の公開統計ではありません。
▶ 詳細はこちら:scikit-learnのシステム開発の見積相場や費用/コスト/値段について
規模別の初期費用と期間の目安
初期費用と期間は、規模ごとに分けて見ておくと比べやすくなります。小規模PoCや分析ダッシュボードは、オフラインで検証し、簡易レポートにまとめる範囲です。
- 小規模PoC:100万〜300万円、1〜3か月。データ1〜2種類が対象です。
- 社内MVP・バッチ予測:300万〜800万円、2〜4か月。ETL、Pipeline、定期処理、権限付き画面またはCSV連携を含みます。
API付きの業務システムは、800万〜2,000万円、4〜8か月程度が目安です。複数のDB・API連携と画面、ログ、テストに加えて、再学習の手順も整えます。
全社向けの高信頼基盤は、2,000万〜5,000万円以上、6〜12か月以上になる場合があります。データ基盤や監視、冗長化、監査なども含みます。
データ整備・連携・開発による費用の違い
追加費用は、データ整備と既存連携の範囲、開発体制によって変わります。
- データ整備:100万〜500万円程度です。
- 基幹連携:200万〜1,000万円程度です。
- フリーランス:人月50万〜80万円を仮置きする場合があります。
- 中小規模の開発会社:人月80万〜120万円を仮置きする場合があります。
- 大規模SI体制:人月150万〜200万円を仮置きする場合があります。
単価は固定ではなく、データの状態、接続先の数、担当領域、契約形態によって変わります。
見積もりは、役割ごとに人数と期間を分けて行います。データサイエンティストやMLエンジニア、バックエンド、インフラ、PMなどが対象です。
クラウド費用と保守費用
クラウド費用は、学習、保存、推論、監視、転送、ログの利用量によって変わります。
- 料金条件:月1,000万回、1回100ミリ秒、入出力10GBです。
- 料金例:40.16米ドルです。
この試算は、マネージド機械学習推論サービスの公式料金例です(出典:マネージド機械学習推論サービス公式料金例、2026年確認)。
リージョンやメモリ、常時稼働の有無で費用は変わるため、米ドルの金額を日本円へ単純換算しないことが大切です。
常時稼働が要らない場合は、バッチ推論や自動停止で計算資源を抑えられます。
保守費は、初期開発費の年15〜25%を仮置きします。また、更新、脆弱性対応、監視、再学習、問い合わせ対応は、それぞれ分けて考えます。
パッケージ・クラウド・スクラッチの選び方
導入期間や運用の範囲に合わせ、次の構成から候補を選びます。
- パッケージ・AutoML:標準的な予測を短期間で導入します。
- マネージドMLOps:学習、モデル登録、推論、監視を早く整えます。
- スクラッチ構成:Python、コンテナ、DB、CI/CDで業務ルールに合わせます。
バッチ・API・オンプレミスの使い分け
日次や週次の需要予測なら、決まった時間に入力データを集めて結果を保存するバッチ方式が適しています。利用者の入力に対して即時にスコアを返す必要があるなら、API方式を選びます。
工場設備や機密データを扱い、外部へデータを送信できない場合は、オンプレミスや閉域環境で推論する構成を検討します。
API方式は便利ですが、同時リクエスト数、応答時間、障害時の再試行、認証、レート制限まで設計が必要です。一方で、バッチ方式は応答の即時性が低いものの、処理量をまとめられ、常時稼働のインフラ費を抑えやすいです。
他の機械学習技術との比較
データや処理要件に応じて、適した機械学習技術を選びます。
- scikit-learn:表形式データ、CPU利用、説明やモデル比較を重視する場合。
- 深層学習:画像、音声、複雑な自然言語処理、GPUを使う場合。
- 分散処理:大規模データの処理やストリーミングが必要な場合。
判断するときは、データ規模、学習頻度、推論遅延を基準にします。さらに、説明可能性、担当者のスキル、既存のPython資産も考慮します。
scikit-learn公式リリースノートは、1.8でPython 3.14対応を案内しています(出典:scikit-learn公式リリースノート、2025年12月)。
公式リリースノートは、free-threaded環境向けホイールも記載しています。ただし、採用するときは、本番のPythonと依存ライブラリの対応状況を必ず検証します。
セキュリティ・再現性・法規制の注意点
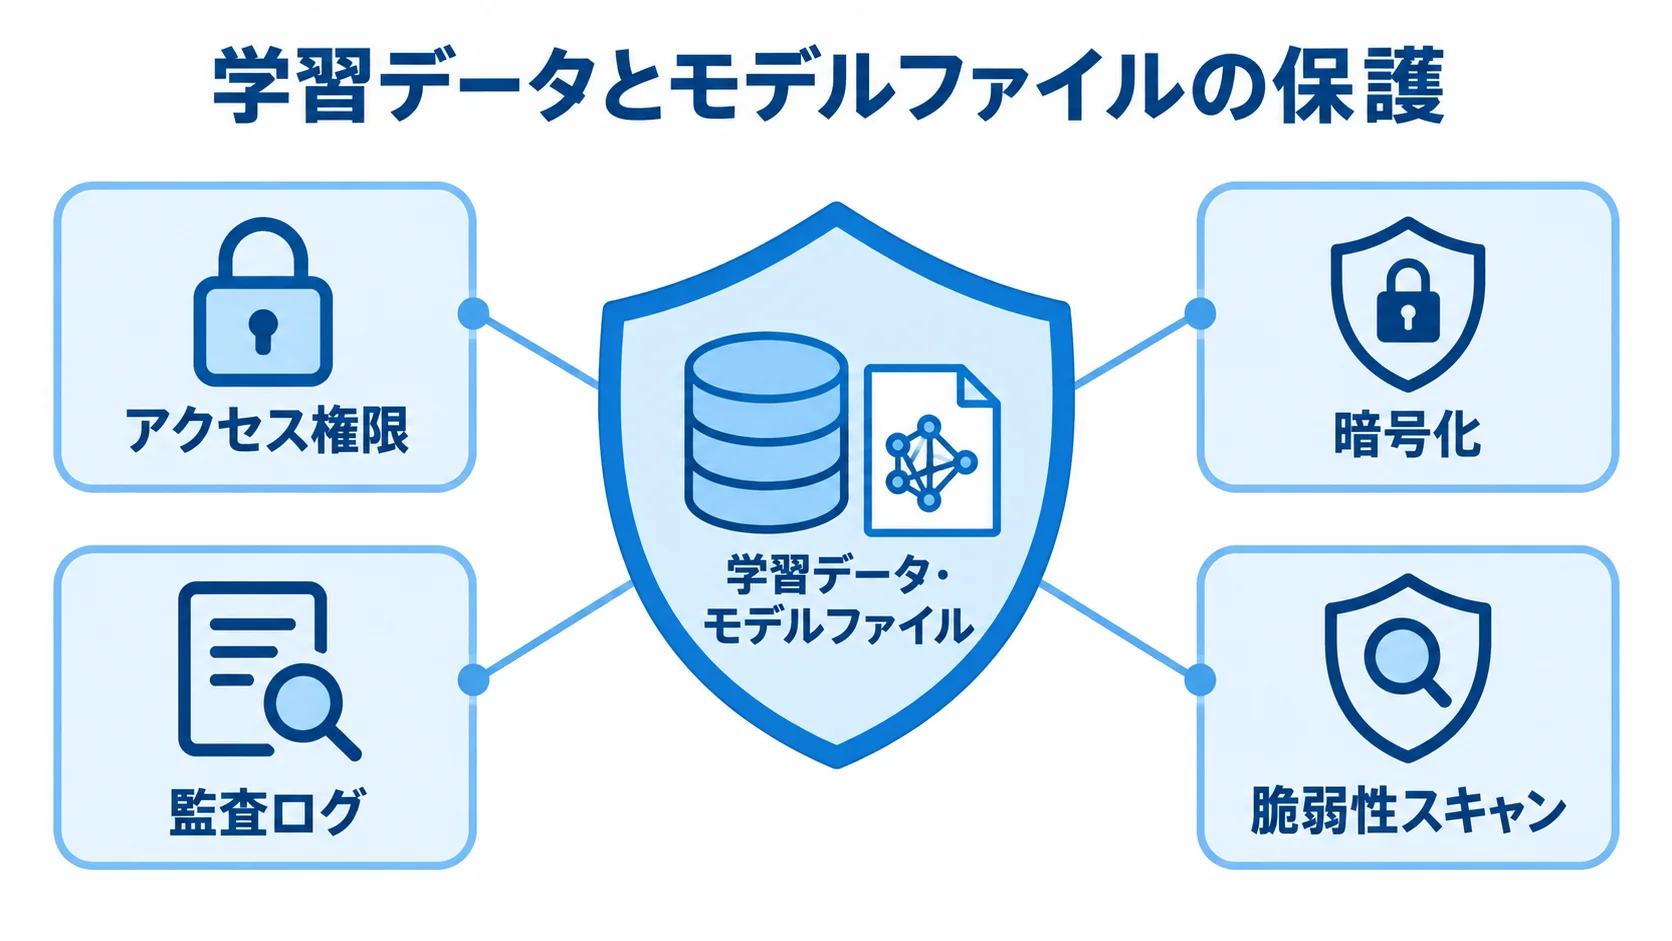
機械学習システムでは、個人情報を含む学習データだけでなく、保存したモデルファイルも保護対象です。
想定すべき脅威は、モデルの盗難や改ざん、推論APIへの過剰なリクエスト、学習データへの不正アクセスです。これらに備えて、アクセス権限や暗号化、監査ログ、脆弱性スキャンを設計します。
pickle・joblib・ONNX・skops.ioの安全な扱い
pickle、joblib、cloudpickleは、信頼できないファイルを読み込むと、任意のコードが実行される可能性があります。
- 読込元:信頼できる送信元のファイルだけを読み込みます。
- 検証:モデルの出所、署名、ハッシュを確かめ、権限を絞って読み込みます。
公式資料も、pickle、joblib、cloudpickleを信頼できる送信元のファイルだけに使うよう注意しています(出典:scikit-learn 1.9.0公式ドキュメント「Model persistence」、2026年確認)。
skops.ioはPythonオブジェクトの調査に、ONNXはPython環境から分離した推論の候補になります。
ONNXには非対応の推定器やカスタム処理があるため、注意が必要です。skops.ioは、信頼する型の確認が必要です。方式は、移植性、安全性、対応モデル、性能を比べて選びます。
バージョン固定と再現可能な学習
異なる版で学習したモデルを読み込むことは、正式にはサポートされていません(出典:scikit-learn公式モデル永続化ドキュメント、2026年)。
- 環境固定:Python、scikit-learn、NumPy、SciPyの版を固定します。
- 環境統一:コンテナやロックファイルで学習環境と本番環境をそろえます。
モデルファイルに加えて、データの不変スナップショットや依存版、特徴量定義を保存します。さらに、コードや交差検証の結果、承認記録も残します。
個人情報・公平性・説明責任の要件
個人情報では、利用目的と委託先、第三者提供の有無を確認します。保存期間や削除方法、権限も確かめます。
- 影響の大きい用途:採用、融資、保険、医療では人の確認を設けます。
- 説明と異議:予測だけで不利益を確定せず、異議申立てと説明を記録します。
正確さに加えて、安全性や公平性を確認します。プライバシー、セキュリティ、透明性、検証可能性も対象です。
公的な評価資料は、関連する10項目を整理しています(出典:IPA「AIセーフティに関する評価観点ガイド」第1.10版、2025年)。規制を一律に当てはめるより、用途と影響に応じて管理します。
scikit-learnの開発会社/ベンダーの選び方
選ぶべき相手は、Pythonのコードを書けるだけでなく、データを業務システムへ組み込み、運用まで設計できる開発会社やベンダーです。
候補は、機械学習実装型、クラウドMLOps型、大規模SI型、データ分析・数理型などに分けると比べやすいです。
PoCから本番運用までの経験の確認
実績では、モデル精度だけでなく、データ品質から障害時の復帰まで確認します。
- 本番対応:データ改善、DB・API連携、画面、監視、再学習、手動復帰。
- 運用実績:類似案件の指標とモデル更新頻度を確認します。
提案では、Pipelineや保存形式、依存版の扱いを確認します。テストやログ、権限、クラウドとオンプレミスの分担も見ておきます。サンプルコードだけで、連携や監視の説明がない提案には注意が必要です。
同じRFPによる提案内容と見積もりの比較
同じ条件で比べられるよう、RFPに要件と納品物を具体的に記載します。
- 要件:入力、予測対象、KPI、想定リクエスト数、個人情報、時期、予算。
- 納品物:コード、モデル、Docker等の環境、インフラ定義、テスト結果、操作・再学習手順、監視設定。
見積もりは、要件定義やデータ整備、モデルとアプリの開発、連携ごとに分けてもらいます。テストやクラウド、保守も別の項目にします。
見積もりが一式で書かれていると、範囲を判断しにくくなります。そのため、目標未達時の追加検証、データ不足時の費用、終了時のデータ・モデル返却の条件も確認します。
知財・再委託・保守の責任分担
学習データや特徴量、コード、モデル、評価結果、画面の権利は、契約で区別しておきます。
- 利用と委託:自社データの別案件利用を禁じ、再委託先を明記します。
- 保守責任:脆弱性対応窓口とモデル更新の責任者を決めます。
保守の対象に、精度劣化やデータドリフト、ライブラリ更新が含まれるかを確認します。さらに、再学習や承認、ロールバックまで含まれるかも確かめます。
自社で運用する場合は、説明や運用手順、コードレビュー、引き継ぎ期間を発注範囲に含めます。
▶ 詳細はこちら:scikit-learnのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:scikit-learnのシステム開発の発注/外注/依頼/委託方法について
scikit-learnのシステム開発で起きやすい失敗例
失敗の多くは、アルゴリズムの選び方よりも、目的やデータ、運用の境界が曖昧なことから起きます。そのため、PoCの段階で確認すべき点と、本番化の段階で追加すべき点を分けておくことが大切です。
モデルを作れば完成と考える失敗
高い精度のモデルができても、現場が予測を見ない、入力データが毎日そろわない、結果を業務画面に反映できないなら、価値は出ません。
最初の段階で、業務上の行動、例外時の手動処理、利用者の権限、結果の保存方法を決めておきます。
PoCの精度と本番の精度の混同
学習期間と評価期間が混ざっていたり、予測時点では入手できない未来の情報が特徴量に含まれていたりすると、精度は実態より高く見えます。
そこで、学習と評価を時系列で分け、実際に予測する時点で利用できるデータだけを使います。ベースラインとも比べます。
再学習・監視・担当者を決めないままの公開
公開直後は動いていても、商品の構成や顧客の行動、設備の状態が変わると、モデルは劣化していきます。そのため、誰が精度を確認し、どの条件で再学習し、誰が承認して公開するのかを決めておく必要があります。
保守契約に含まれる範囲と、社内で担当する範囲を、運用フローとして書き出しておきます。
scikit-learnのシステムに関するよくある質問
導入前によく寄せられる質問に、順に答えます。ライセンス、開発期間、精度の考え方を先に確認しておくと、相談のときに要件を整理しやすくなります。
scikit-learnは商用システムで利用できますか?
基本的には、商用利用しやすいBSD 3-Clauseライセンスのオープンソースです。
ただし、scikit-learn以外の依存ライブラリや学習データ、モデル、組み込むソフトウェアは、それぞれライセンスを別に確認する必要があります。配布や改変、著作権表示の扱いは、法務や担当者と確かめてから公開します。
scikit-learnのシステム開発には何か月かかりますか?
小規模PoCなら1〜3か月、社内MVPなら2〜4か月、APIや既存システム連携を含む本番開発なら4〜8か月が目安です。
期間は、データの整備状況や正解ラベルの作りやすさ、連携先の数、セキュリティ審査、利用者テストによって変わります。期間を短くするには、最初に対象業務とデータを絞り、機能を段階的に増やすとよいです。
どの程度の精度なら本番導入できますか?
合格となる精度は、一律には決まっていません。誤検知と見逃しのコスト、現場が確認できる件数、既存ルールとの比較、導入後の業務KPIをもとに判断します。
精度が高くても説明できず、入力データが安定せず、担当者が結果を使えないなら、本番導入には不十分です。逆に、人が確認する補助用途であれば、限定した範囲で段階的に導入できる場合があります。
クラウドを使わずに構築できますか?
クラウドを使わなくても構築できます。社内サーバーや閉域環境で学習・推論するオンプレミス構成や、端末や設備内で推論するエッジ構成も選べます。
ただし、サーバーの調達やバックアップ、監視、OSやライブラリの更新、障害対応を自社で担う範囲が増えます。そのため、機密性だけでなく、運用人材と5年間の総保有コストまで比べて決めます。
scikit-learnのシステム開発で押さえるべきポイントまとめ
scikit-learnのシステムは、データを業務で使える予測や分類に変換し、継続して安全に運用する仕組みです。モデルを作ることは、その一部にすぎません。
表形式データを使う需要予測や解約予測、問い合わせ分類、異常検知では、前処理とモデルをPipelineにまとめることが出発点になります。これにより、学習時と推論時の差をなくせます。
導入前に確認する5つの原則
導入前には、費用や業務効果に加えて、再現性、安全性、運用責任を確認します。
- 第一に、モデル開発費とシステム化費を分けます。
- 第二に、業務KPIと現場の行動も受入条件にします。
- 第三に、Pipeline、版固定、評価履歴で再現性を確保します。
- 第四に、モデルファイル、個人情報、権限、監査ログを保護します。
- 第五に、監視、再学習、承認、復帰の責任者を決めます。
小さく検証してから本番へ投資する進め方
段階投資では、PoCでデータとKPIを確かめてから、MVP、本番基盤へ進みます。
- PoC:100万〜300万円程度でデータとKPIを検証します。
- MVP:効果が見えたら300万〜800万円程度で進めます。
- 本番基盤:連携数、可用性、監査要件に応じて2,000万円以上も検討します。
本番基盤の費用は推定で、データ品質やモデルの難易度に加えて、画面やAPI、クラウド利用量、保守範囲でも変わります。
開発会社やベンダーは、scikit-learnの実装経験に加えて、データ整備や業務連携も同じRFPで比べます。
セキュリティ、MLOps、引き継ぎを含め、PoC後の本番化と導入後の改善を担える体制か確認します。
▼関連記事一覧
・scikit-learnのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・scikit-learnのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・scikit-learnのシステム開発の見積相場や費用/コスト/値段について
・scikit-learnのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。