
scikit-learnのシステム開発は、要件整理からPoC、本番化、運用改善へと段階を踏んで進めると、予測を業務判断につなげやすくなります。
仕組みから6段階の進め方、費用と見積もりまでを順に説明します。全体像はscikit-learnのシステム開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・scikit-learnのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
scikit-learnのシステム開発の全体像
scikit-learnのシステムは、Pythonの機械学習モデルを既存の業務システムやデータ基盤へ組み込む仕組みで、単独の業務アプリとは性質が異なります。学習から予測、現場の判断、結果記録、モデル更新までを一続きにつなげるのが特徴です。
scikit-learnで実現しやすい業務課題
適用範囲は、扱えるデータ、業務課題、分析機能の3点から判断できます。
- 扱えるデータ:売上、在庫、顧客、製造実績、問い合わせ履歴などの表形式データと相性がよいです。
- 業務課題:解約可能性の分類、需要予測、製品測定値による異常検知に使えます。
- 分析機能:分類、回帰、クラスタリング、次元削減を備えます。前処理、特徴量選択、交差検証、探索機能も含みます。
scikit-learn公式は、予測データ分析ツールと説明し、BSDライセンスで商用利用可能としています(2026年6月時点)。
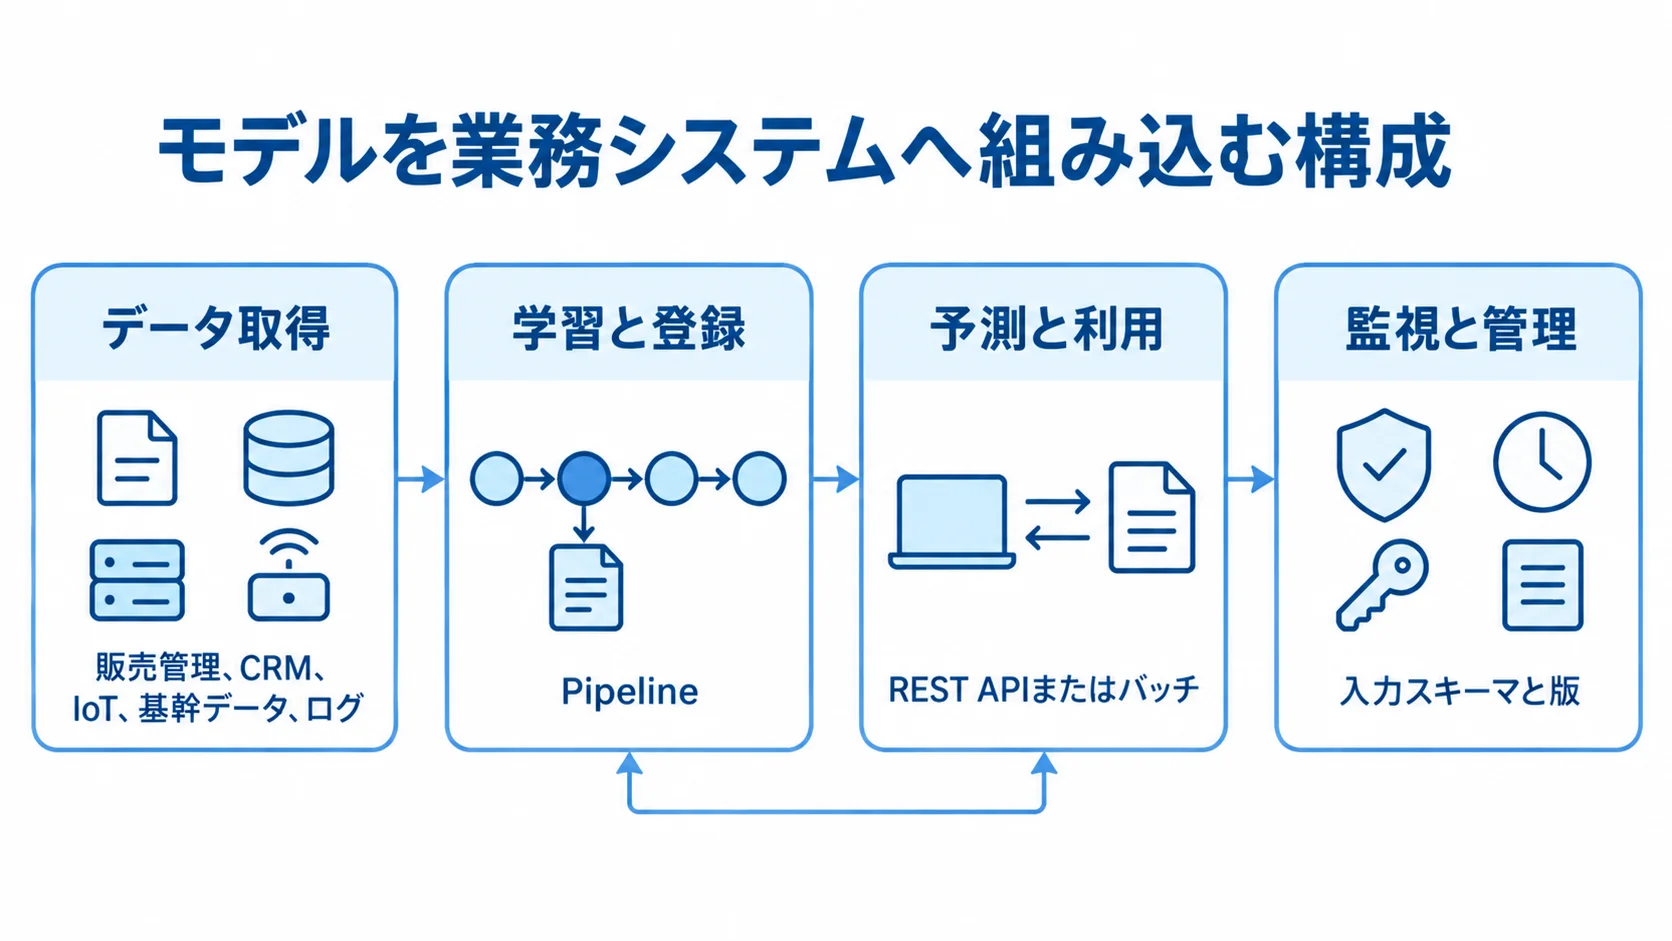
モデルを業務システムへ組み込む構成
構成を決めるときは、データ取得から監視までの流れをそろえます。学習時と推論時で加工が違うと、本番で予測結果が崩れてしまうからです。
- データ取得:販売管理、CRM、IoT、基幹データ、ログを、ETLや前処理へ渡します。
- 学習と登録:Pipelineで学習し、精度評価を経てモデルを登録します。
- 予測と利用:REST APIまたはバッチで推論し、結果を業務画面や通知へ返します。
- 監視と管理:精度劣化やデータドリフトを監視し、入力スキーマと版を管理します。
欠損補完、標準化、カテゴリ変換の処理をモデルとあわせてPipelineにまとめると、学習と推論の加工をそろえられます。
採用しないほうがよいケース
画像や音声が中心の場合や、数億件規模の分散学習、GPU前提の深層学習が必要な場合は、PyTorch、TensorFlow、Sparkなどとの併用を検討します。
秒単位のオンライン学習や常時最新化も、scikit-learn単体では要件を満たしにくい場合があります。ただし、前処理や評価、表形式データのベースラインにscikit-learnを使い、別の基盤へ移す構成も可能です。
選ぶときは、データ量と予測頻度、許容遅延を先に見ます。そのほか、説明しやすさや運用担当者のスキルも判断材料になります。
scikit-learnのシステム開発の進め方
開発は6つのフェーズに分けると、AI特有の不確実性を管理できます。まず、データとKPIを小さなPoCで検証し、効果が確認できた範囲をMVPへ広げます。特に、各段階の移行条件を先に合意しておくと、精度が出ないまま画面開発へ進む失敗を防げます。
フェーズ1:要件整理とKPI定義
最初に、業務の困りごとと予測後の行動を決めます。「AIで精度を上げる」という目標を、対象者、時期、行動、指標まで具体化します。
- 需要予測:欠品率、廃棄率、発注作業時間を受入条件に含めます。
- 分類:正解率のほか、見逃し率、誤検知率、確認時間も決めておきます。
- 業務行動:毎週月曜の発注候補の確認や、解約リスク顧客へ48時間以内に連絡する行動。
予測対象とデータ保有部署、利用目的、個人情報の扱いを確認します。さらに、頻度や応答時間、誤判定時に人へ戻す方法、責任者、業務KPIも押さえます。
データリーケージも調べます。たとえば、解約後に更新された顧客状態を特徴量にすると、検証では高精度に見えても、本番では使えません。
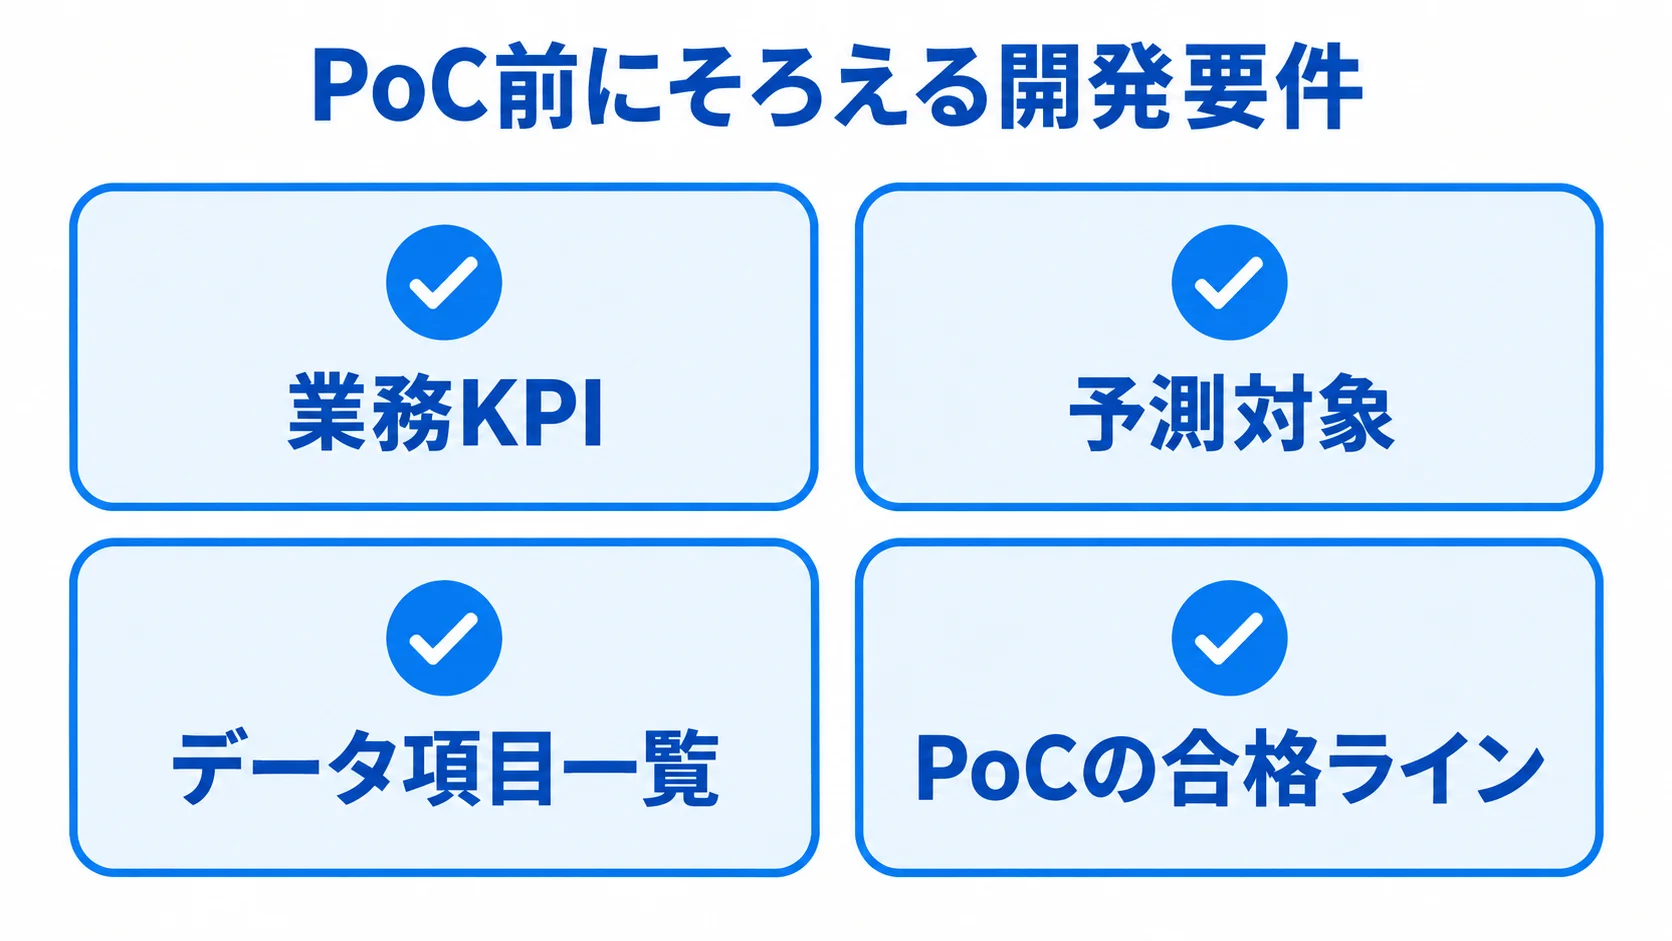
成果物として、業務フロー、データ項目一覧、KPI定義、PoCの合格ラインを残します。
フェーズ2:技術・実行方式の選定
実行方式は、予測頻度や応答時間、データ制約に合わせて選びます。たとえば、日次や週次の予測であれば、夜間に処理するバッチ方式が費用を抑えやすいです。
- 即時応答:数秒以内に画面へ返す場合は、REST APIを選びます。
- 機密データ:社外へ出せない場合は、オンプレミスかハイブリッドを検討します。
- 繁忙期の変動:アクセスが増える場合は、サーバーレスや自動スケールも候補になります。
データの保管先や認証、ログの扱いを確認します。モデル登録、再学習の起動方法、障害時の切り戻しも押さえます。
AWS SageMaker AIには、リアルタイム、非同期、バッチ、サーバーレスの4種類の推論方式があり、方式によって課金が変わります(AWS公式料金ページ、2026年確認)。
Azure Machine Learningを利用する場合、SDK v1は2026年6月30日にサポートが終了します。そのため、新規開発はCLIまたはSDK v2を前提に提案できる会社を選ぶ必要があります(Microsoft Learn、2026年3月更新)。
フェーズ3:データ・モデル・アプリの設計開発
設計では、データ処理、モデル、推論口、業務画面を分けて定義します。そのうえで、入力の型や単位、欠損時の扱いを決めます。さらに、更新時刻や個人情報のマスキング、学習・推論期間も決めておきます。
まず、単純なルールや過去平均をベースラインとして用意します。次に、交差検証、評価指標、許容誤差、説明方法を決めます。ベースラインを上回らないモデルは採用しないと決めておけば、精度競争の行き過ぎを防げます。
- 共通実装:前処理とモデルをPipelineにまとめ、コード、設定、依存ライブラリ、モデルファイルを分けます。
- API方式:入力JSON、認証、タイムアウト、エラーコード、信頼度を定める。
- バッチ方式:抽出条件、実行時間、再実行、重複登録を決めます。
- 業務画面:対象期間、更新時刻、信頼度、判断要因、担当者の修正結果を示します。
予測を見ても現場が行動できない画面は、技術的に動いても定着しにくいです。
フェーズ4:精度・システム・受入テスト
テストでは、モデル精度だけでなく、システム全体を対象にします。データとAPI、画面の確認に加え、権限、性能、障害対応も含みます。
- 精度:学習・評価データを分けて、期間、店舗、顧客属性別に性能を見ます。重要群の見逃しも確認します。
- 入力異常:未知カテゴリ、欠損、極端値、空リクエストの処理を自動化します。
- システム:ETL遅延、二重推論、APIタイムアウト、ピーク同時接続、権限外参照、ログへの個人情報混入の確認。
- 受入:実業務で発注やフォローができるかを、担当者のシナリオで確かめます。
合格条件は、F1値だけで決めないようにします。さらに、担当者が所定の処理を終えられることや、誤判定時に手動へ切り替えられることも、書面にして残します。
フェーズ5:稼働と安全なモデル提供
本番では、モデルの保管先と読み込みを決めます。リリース、監視、切り戻しの方法も決めておきます。Pythonと依存ライブラリは、コンテナで固定します。
モデルと一緒に、学習データの版、コード、交差検証スコアを保存します。加えて、scikit-learnとNumPyの版も残します。
異なる版のモデル読み込みは、公式に保証されていません。そのため、版が違う場合は、再現可能な手順から再学習する設計が安全です(scikit-learn公式「Model persistence」、2026年確認)。
pickleやjoblibは、ロード時に任意のコードを実行する可能性があります。このため、信頼できないファイルは読み込みません(公式ドキュメント)。
- 保管と配備:保管先を限定し、ハッシュや署名、アクセス制御、脆弱性スキャンを行います。
- 承認:承認済みアーティファクトだけをデプロイします。
- 形式選択:Python不要ならONNX、内容確認後のロードにはskops.ioを候補にし、推定器と運用条件を検証します。
フェーズ6:定着と継続改善
稼働後は精度だけでなく、入力や利用状況も見ながら、再学習と現場の支援を続けます。
- 監視:精度劣化、入力分布、欠損率を見ます。推論遅延やエラー率、利用率、業務KPIも対象です。
- 評価時期:正解ラベルに数週間かかる場合、先にドリフトと欠損を監視し、ラベル確定後に精度を評価します。
- 再学習条件:定期実施のほか、誤差超過、新商品や制度の追加、データ分布の一定割合の変化も条件にします。
- 役割と振り返り:予測確認、例外承認、誤判定のラベル付け、再学習承認をRACIなどで定め、1・3・6か月後に利用率と業務KPIを見ます。
- 現場支援:問い合わせ窓口、操作手順、障害時の手動運用を用意します。画面が使われて初めて、精度向上が投資効果につながります。
scikit-learnのシステム開発の費用相場
scikit-learnはBSDライセンスのオープンソースで、ライセンス料は基本的にかかりません。一方で、費用はデータ整備、モデル、APIや画面の開発で変わります。連携、クラウド、監視、保守も、費用に影響します。
ここで示す金額は、リサーチノートの業務システム相場と、機械学習PoC・API開発工数をもとにした初期目安です。公開統計ではありません。
金額は、データ品質、連携数、可用性、個人情報の有無で変わります。そのため、予算取りの幅として扱います。
規模別の初期費用と期間の目安
金額を比べるときは、規模、含む機能、期間をそろえて確認します。前提がそろうと、見積もりを比べられます。
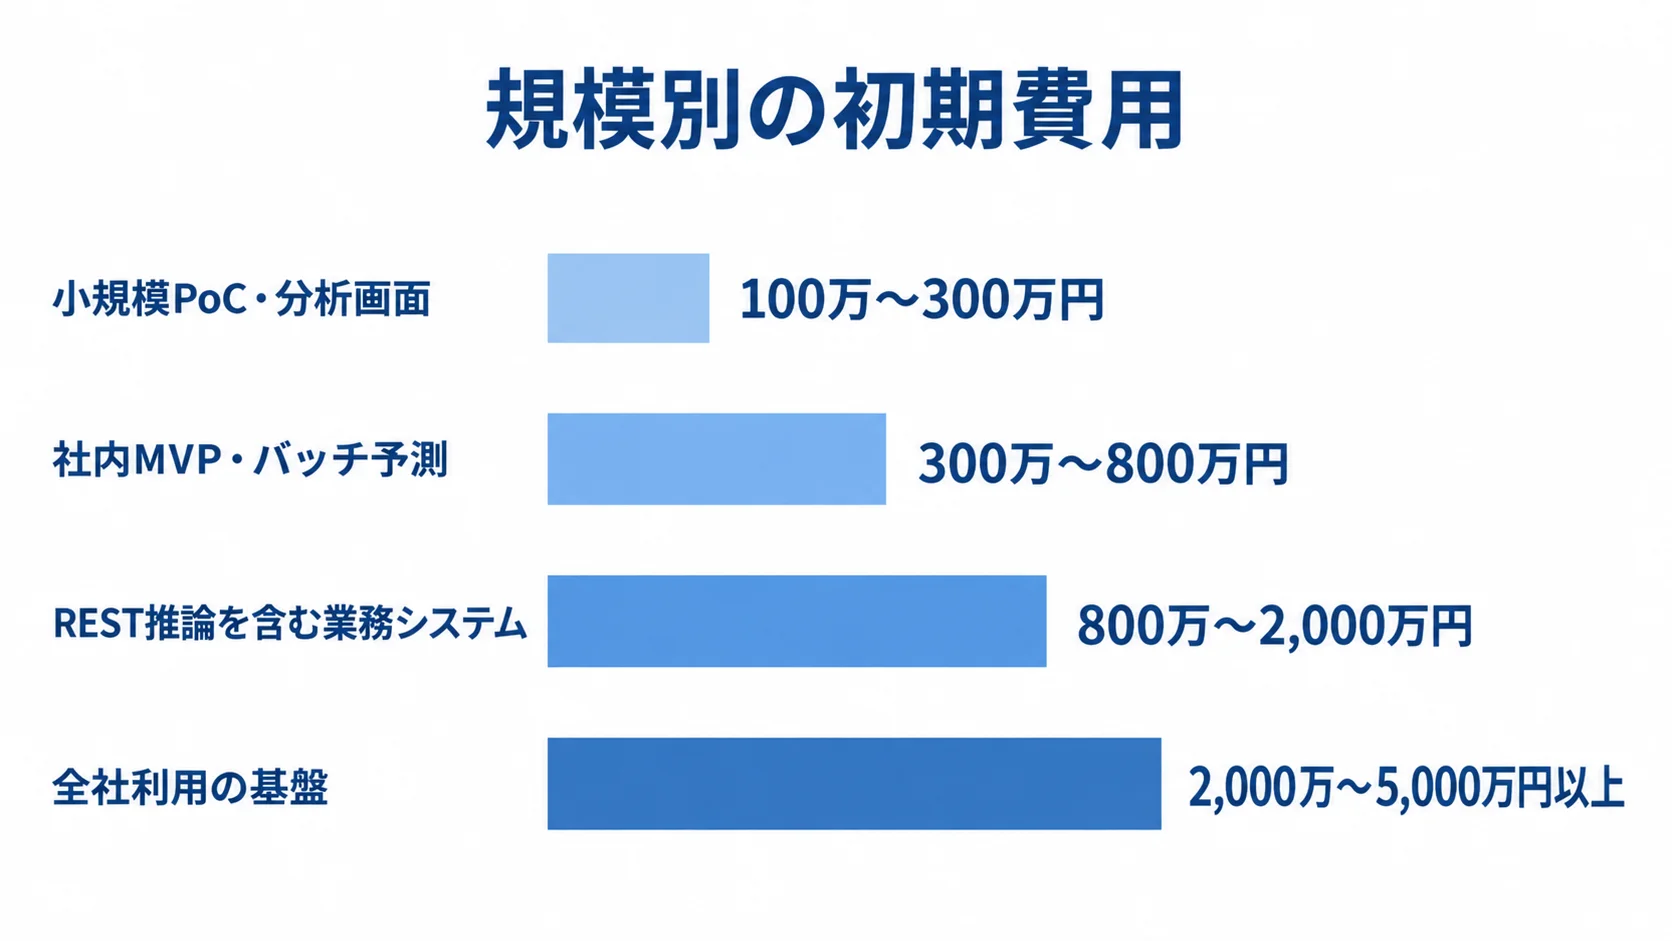
- 小規模PoC・分析画面:100万〜300万円程度、1〜3か月。データ1〜2種類でオフライン精度を検証し、簡易レポートや画面で確認します。
- 社内MVP・バッチ予測:300万〜800万円程度、2〜4か月。ETL、Pipeline、定期実行、権限付き画面、CSV連携を含みます。
- REST推論を含む業務システム:800万〜2,000万円程度、4〜8か月。複数DB・API連携、画面、ログ、再学習手順、総合テストが対象です。
- 全社利用の基盤:2,000万〜5,000万円以上、6〜12か月以上。モデル登録、CI/CD、監視、冗長化、監査、複数モデルを含む場合があります。
小規模PoCやMVPには、本番の高可用性や複雑な基幹連携が含まれないことが多いです。なお、大規模案件は基幹改修やデータガバナンスの対応でも、費用と期間が増えます。
費用が増える主な要因
費用は、データクレンジングやラベル作成、複数システム連携で増える場合があります。個人情報の権限設計やリアルタイム推論の可用性、再学習と監視も影響します。
データ整備や基幹連携の金額は、PoCから本番へ進む際に上乗せされる額を想定した推定レンジです。
- データ整備:欠損や表記揺れの修正、正解ラベル作成で100万〜500万円程度が追加になるケースを想定します。
- 基幹連携:既存基幹システムとの接続で200万〜1,000万円程度が追加になる場合があります。
- 人月単価:リサーチノートでは、フリーランス50万〜80万円、中小開発会社80万〜120万円、大手SIer150万〜200万円が目安です。
- 保守:初期開発費の年15〜25%を仮置きし、再学習、ライブラリ更新、脆弱性対応、監視、問い合わせを分けて考えます。
人月費は、データサイエンティストやMLエンジニア、バックエンド、インフラ、PMを何人月置くかで変わります。そのため、対象件数やデータ状態を見ずに追加額を固定しないようにします。
クラウド費は利用量に応じて変わります。常時稼働APIと低頻度バッチは、分けて試算します。
クラウド料金を見積もるときの考え方
料金を比べるときは、試算する項目と、その金額が当てはまる条件を分けて捉えます。
- 見積項目:学習用計算、データ保存、推論エンドポイント、監視、ログ、ネットワーク転送に分けて見積もります。
- AWS公式例:リアルタイム推論2台と監視は月305.881米ドル、サーバーレス例は月40.16米ドルです。
- 金額の条件:特定のリージョン、インスタンス、処理量を前提にした例で、日本案件の費用ではありません(AWS公式SageMaker料金ページ、2026年確認)。
- 段階導入:ローカル、小規模VM、低頻度バッチから始め、必要に応じて常時稼働や冗長化へ広げます。
scikit-learnのシステム開発で見積もりを取るポイント
見積書は「AI開発一式」ではなく、要件定義やデータ整備、PoC、モデル開発を含む工程ごとに分けてもらいます。アプリ開発、連携、テスト、インフラ、保守も、別々に記してもらいます。
項目が分かれていれば、精度検証だけを先行するのか、APIまで作るのかを比べられます。一方で、成果物や前提が曖昧な一式見積もりでは、データ整備や監視が後から追加費用になりやすいです。
発注前に整理する情報
相談の前に、予測条件とデータの状態を整理し、納品物や契約条件もそろえておきます。
- 予測要件:対象、頻度、利用者、既存システムに加え、データ期間や正解ラベル、KPIも整理します。納期と予算も含めます。
- データ情報:サンプルと項目名、型を添えます。件数や欠損率、更新頻度も示し、個人情報の有無も明記します。
- 応答条件:月次、1日数回、1秒以内のAPIなど、頻度や応答時間を明確にします。
- 納品物:コード、Pipeline、依存定義、Dockerfile、API仕様を記します。テスト、評価、辞書、更新・監視・復旧手順、構成、マニュアルも含みます。
- 契約条件:知財帰属、データとモデルの所有者、再委託、第三者ライセンス、終了後の引き渡しを確認します。
開発会社を比較する判断基準
開発会社は、コードを書けるかに加えて、データ基盤や業務連携、セキュリティ、運用まで担えるかで比べます。
- 本番実績:稼働モデル、利用画面、監視・再学習、障害時の切り戻しを確認します。
- 類似事例:可能であれば、導入前の課題、業務変更、導入後KPI、保守体制を聞きます。
- 提案条件:同じRFPをもとに、品質前提やPoC合格、本番条件を比べます。体制、期間、費用、除外事項も同じ条件で並べます。
- 運用責任:再学習、脆弱性更新、誤判定対応の担当が、契約と運用設計に明記されているかを見ます。
MLエンジニア、バックエンド、インフラ、PMの役割分担も見ます。Pythonやscikit-learnの経験に加えて、この分担から運用体制を判断します。
失敗しやすい見積もりと対策
見積もりでは、初期開発の範囲だけでなく、本番移行と運用の条件も確かめます。モデルは、説明が難しいか、入力の変化で結果が大きく変わるか、データ更新が止まるおそれがあるかを見て選びます。
- 避けたい見積もり:PoC精度を本番品質とみなす、データ整備を無償扱いする、画面やAPIを後回しにする、再学習や監視を保守から外す。
- 受入条件:ベースラインを作り、データ調査を独立した成果物にして、業務シナリオも合否の判断に含めます。
- 契約条件:PoCと本番を別契約にする場合、本番移行条件と追加単価を先に合意します。
- モデル選定:前段の3つの点があるため、短期スコアだけで選びません。
- 安全対策:低信頼度は保留し、人の確認、手動切替、監査ログを設けます。
評価軸には、安全性と公平性、プライバシー、セキュリティ、透明性を含めます(IPA AIセーフティ・インスティテュート、2025年4月改訂ガイド)。
scikit-learnのシステム開発でよくある質問
scikit-learnのライセンス費用はかかりますか?
scikit-learnはBSDライセンスのオープンソースで、ライブラリ自体の費用は基本的にかかりません。ただし、商用利用では表示条件を確認します。ほかのPythonパッケージやOS、クラウドのライセンスも、別に確認します。
一方で、費用の中心はデータ整備、人材、業務連携、クラウド、監視、保守です。
PoCと本番システムの違いは何ですか?
PoCは、手元のデータで課題を解けるか、目標KPIを達成できそうかを検証する段階です。本番では、定期的なデータ取込や権限管理に加えて、異常入力や障害への対応、安全な更新、業務結果の記録が必要です。
精度が高くても、データ更新や業務行動が続かなければ効果は出ません。そのため、PoCの終了時に本番条件と追加費用を確認します。
再学習はどのくらいの頻度で必要ですか?
再学習の頻度は、毎月や毎週と一律に決めず、正解ラベルが確定するまでの期間、データの変化、許容誤差から決めます。
季節性の強い需要予測は繁忙期の前に学習します。また、顧客行動が変わる解約予測は、ドリフトを見て必要なときに学習します。
新旧モデルは同じ評価データで比べ、承認されたモデルだけを段階的に配備します。問題が起きたときは、旧版へ戻せるようにしておきます。
個人情報を使って予測できますか?
利用の可否は、個人情報の種類や目的、委託先、第三者提供の有無から判断します。さらに、保管場所や権限、保存期間、予測の影響も見ます。
個人情報保護法と社内規程を確認したうえで、必要な同意を取り、匿名化や仮名化、最小権限、暗号化、監査ログを設計します。
採用、融資、保険、医療の分野では、説明可能性や人の最終判断、公平性、異議申立てを要件にします。そのうえで、法務や専門家の確認を受けます。
開発会社へ相談する前に何を準備すればよいですか?
業務課題と予測後の行動、現行フローを整理します。データの項目と件数、更新頻度を押さえます。
個人情報の有無とKPIも伝えます。希望時期と予算感も添えます。
完璧な仕様書や大量のデータは不要です。ただし、匿名化サンプルと担当者への聞き取りをもとに、データ調査、PoC、本番化の段階提案を比べます。
まとめ
scikit-learn開発は、データとKPIを整え、予測を現場の行動につなげ、監視と再学習を続ける取り組みです。要件整理、方式選定、設計開発、テスト、稼働と安全な提供、定着と改善の6段階で進めると、PoCと本番の差を管理できます。
費用は、ライセンス料ではなく、データ整備やモデル、APIや画面の開発で変わります。連携、クラウド、監視、保守も費用に影響します。
初期目安は、小規模PoCで100万〜300万円、社内MVPで300万〜800万円です。API付きの業務システムは800万〜2,000万円、全社利用の基盤は2,000万〜5,000万円以上です。
これらは公開統計ではなく、リサーチノートによる推定です。成果物、前提、除外事項、再学習と脆弱性対応の担当を確認したうえで、小さく検証して本番へ段階的に投資します。
▼全体ガイドの記事
・scikit-learnのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。