
Sentryは、アプリケーションの問題を修正まで追いやすくするための監視サービスです。監視対象、データの送り方、運用の責任を分けると、導入の全体像が見えてきます。
機能、導入の進め方、費用、構成と運用の注意点を順に説明します。各テーマの詳しい内容は、関連記事をご覧ください。
▼関連記事一覧
・Sentryのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Sentryのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Sentryのシステム開発の見積相場や費用/コスト/値段について
・Sentryのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Sentryのシステムの概要
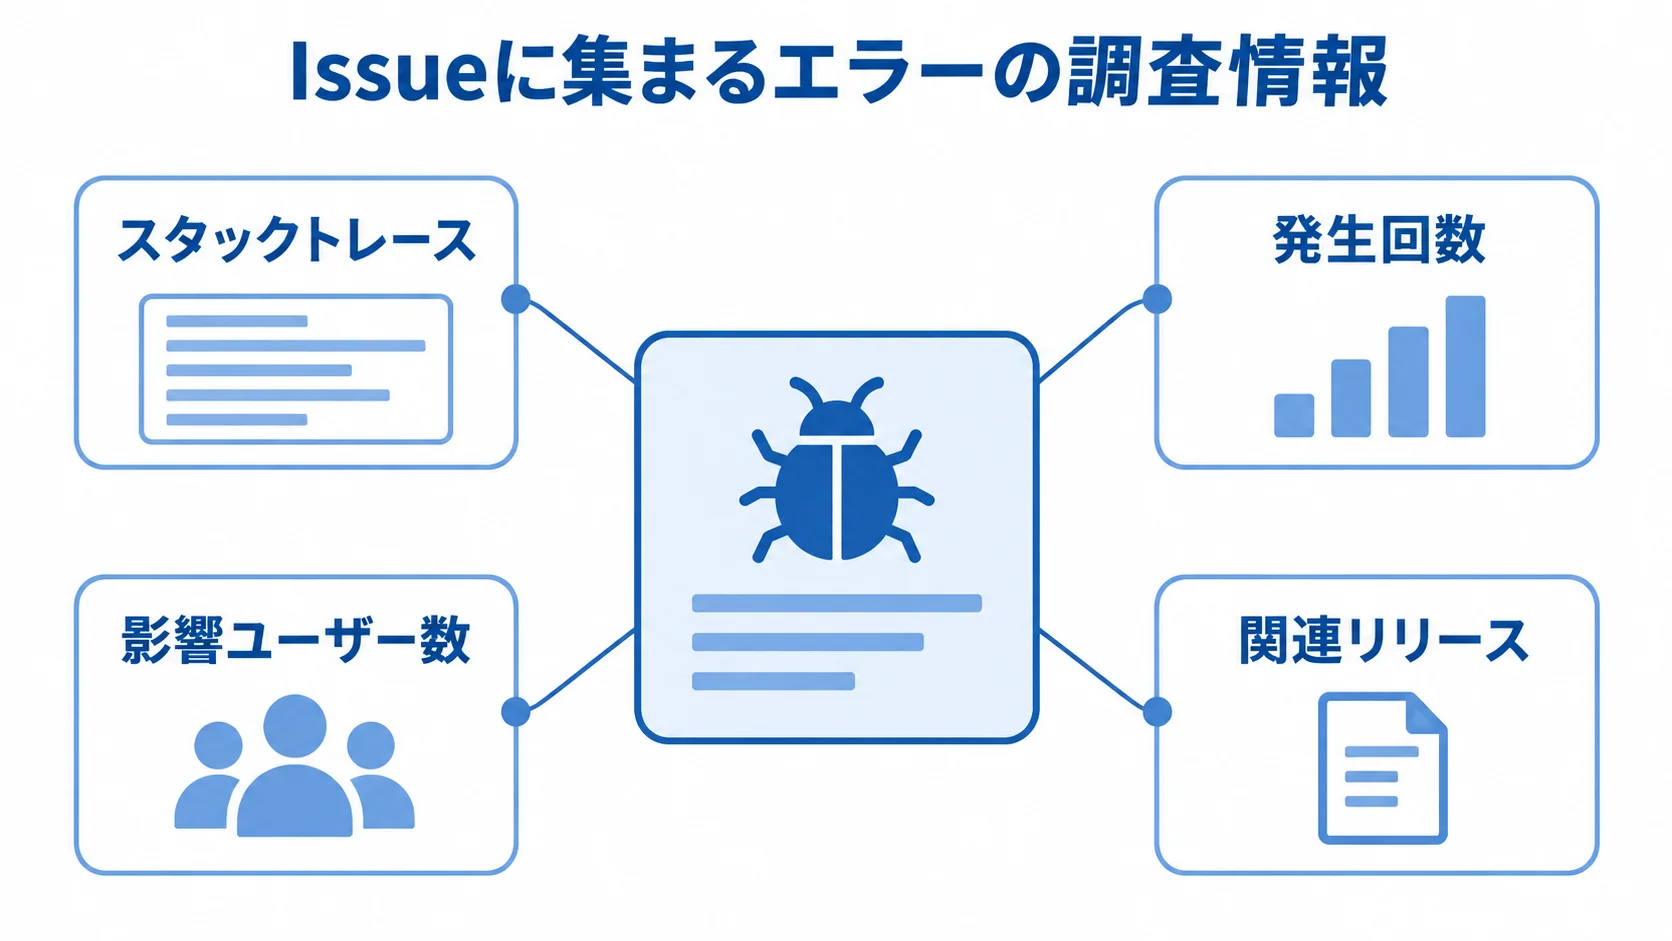
Sentryは、アプリケーション内部で起きた問題を、開発者が修正に使える情報へ変換するサービスです。発生箇所、リリース、環境、ユーザーへの影響、処理の流れをまとめるので、対応の優先順位を決める材料になります。
サーバー監視と異なるアプリケーション監視
監視する層と対象を分けると、Sentryの役割がはっきりします。
- インフラ監視:CPU、メモリ、ディスク、ネットワーク、プロセスの状態
- Sentry:アプリケーションコードに近い層で、ログイン、検索、申請、受注、決済、在庫更新の流れを調べる
サーバーが正常でも、画面が白くなる、特定のブラウザでボタンが動かない、外部APIの遅延で処理がタイムアウトするといった問題は起こります。Sentryは、こうした問題を捉えやすい仕組みです。
Sentryを導入しても、インフラ監視が不要になるわけではありません。基盤の状態、アクセスログ、アプリケーションのエラーや性能は、それぞれの仕組みで確認します。
SDK・イベント・Issueによる問題の追跡
まず、対象言語やフレームワークに対応するSDKをアプリケーションへ組み込みます。そのうえで、Sentryでの追跡は次の二つの単位で進みます。
- イベント:例外、処理状況、環境、リリース番号などの情報
- Issue:似たエラーをまとめた単位で、スタックトレース、発生回数、影響ユーザー数、直前の操作、関連リリースを表示
似たエラーがまとまります。そのため、担当者は大量のログを一行ずつ読む負担を減らせます。
調査に十分な情報を残すには、ソースマップを安全に登録し、本番コードとビルド前のコードを対応させておきます。環境名はdevelopment・staging・productionに分け、コミットとリリース番号も一貫して付けます。こうした設定をCI/CDのリリース処理に組み込むと、障害と変更履歴を結び付けやすくなります。
成果の見方:検知件数より修正までの時間
エラー収集数だけで成果を評価すると、通知が増えただけで終わる可能性があります。そのため、効果は複数の指標で確認します。
- 対応時間:検知、原因特定、修正完了までの時間と再発率
- 品質:リリース後のクラッシュフリー率
- 早期発見:顧客の問い合わせ前に発見できた割合
Sentry公式の顧客事例には、週次クラッシュを60分の1に減らした例や、平均検知時間を99%短縮した例があります(出典:Sentry公式Customer Stories、2026年8月確認)。
ただし、これらは各組織の開発体制や改善施策を含む事例で、導入だけで同じ効果が得られる保証はありません。自社では導入前の対応時間を測り、導入後と比べます。
Sentryでできることと監視対象
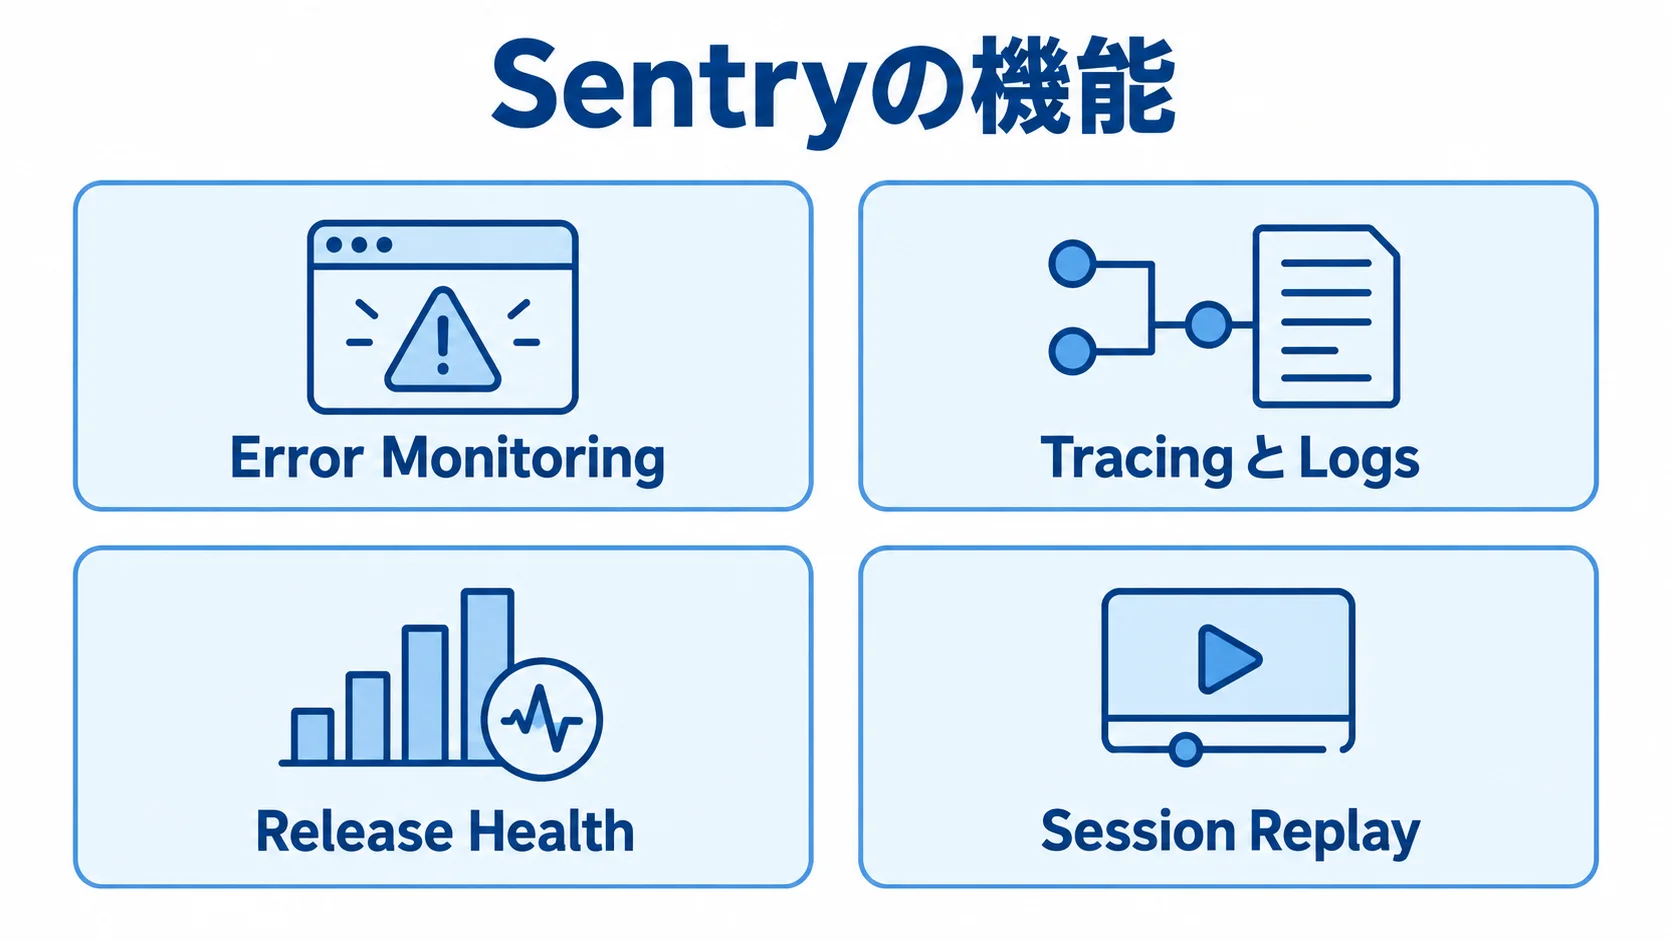
Sentryの機能は、エラー記録から性能、ログ、リリース、ユーザー体験、通知、AIによる調査支援まで広がっています。事業上重要な処理から段階的に導入すると、費用と通知ノイズを抑えながら効果を確かめられます。
Error Monitoringによる例外と影響範囲の把握
Error Monitoringは、フロントエンドのJavaScript例外やAPIの500エラーを収集します。モバイルアプリのクラッシュやバッチ処理の失敗も対象に含まれます。
同じ原因のイベントはグルーピングされ、一つの問題として扱えます。業務上の重要度は、タグや担当ルールに反映します。
- 収集対象:JavaScript例外、API 500、モバイルクラッシュ、バッチ失敗
- 確認情報:発生回数、影響ユーザー、初回日時、正常リリース、増加傾向
- 会員管理:ログイン失敗後の画面エラー
- 受発注:注文確定処理の失敗
- 物流:在庫更新のタイムアウト
売上や顧客体験への影響が大きいものから順に扱います。本番の注文確定失敗や過去1時間の利用者増加が分かる通知にしておくと、初動が速くなります。
TracingとLogsによる遅い処理の経路の追跡
画面表示やAPI応答が遅いと、エラーがなくても利用者は離脱します。Tracingは処理の流れをたどり、時間がかかった区間を示します。
- 追跡経路:ブラウザやモバイルからAPI、DB、外部サービスまで
- 調査対象:遅いSQL、外部APIの待ち時間、サービス間通信の偏り
LogsやApplication Metricsも併用する場合は、Trace ID、サービス名、環境名、リリース番号を共通の検索軸にそろえておきます。
目指すのは、Issueから遅延したTrace、関連ログ、直前のリリースへ移動できる状態です。
Sentry公式料金ページには、TeamとBusinessの基本枠が示されています。その内容は、Logs 5GB、Tracing 500万span、Session Replay 50件などです(出典:Sentry公式Pricing、2026年8月確認)。ただし、必要量はサンプリングや利用状況によって変わります。
Release Health・Replay・通知連携による修正の定着
リリース番号とエラーを結び付けると、リリース単位で問題の出方を追えます。
- Release Health:新機能公開後のクラッシュやエラー増加
- Session Replay:問題に至る操作の再現
- 通知連携:メール、チャット、チケット、ソース管理、オンコールとの連携
画面情報や入力値が記録される可能性があるため、Replayではマスキングと取得範囲の設計が欠かせません。すべてのIssueを即時通知すると、重要な障害が埋もれてしまいます。
本番で顧客影響が大きいもの、急増中のもの、決済や認証に関わるものは即時通知し、低優先度の問題は日次や週次でまとめます。
Sentryの種類と構成の選び方
「Sentryの種類」は、料金プランだけでなく、監視する層、データの送り方、運用責任の置き場所に分けて検討します。
小規模なWebサービスと、複数の業務システムを持つ企業とでは、必要な権限や保存期間、通知設計、データ管理が異なります。
小さく始める場合のSaaS標準構成
クラウド型は、SentryのアカウントとSDKを使い、ダッシュボードや通知を利用する方式です。自社でサーバーを用意せずに始められます。
- 向く場面:1サービスのPoC、少人数チーム、早期の品質可視化
- 始め方:無料枠でイベント量を測ってから、必要な機能を見て有料化
導入前には、外部へ送るデータと保存期間、利用者の権限を確認します。さらに、国外への移転や契約上のセキュリティ条件も確かめておきます。
標準構成には、SDKでの送信前フィルタとサーバー側のマスキングを含めます。アクセス権限と監査ログも、同じ標準構成の中で定義します。
インフラ監視と組み合わせる構成
業務システムでは、アプリケーション層のSentryと、他の監視を組み合わせて使います。
- 組み合わせる監視:インフラ、アクセスログ、DB、合成監視
- 相関情報:Trace ID、サービス名、環境、リリース、業務トランザクションID
- ログ管理:障害調査用と長期保管用の監査ログを分けること
たとえば、Issueで注文処理の失敗を把握し、同時刻にDB接続数が上限に達したことを確認できれば、切り分けが速くなります。さらに、監視を連携させると、費用と検索性を両立しやすくなります。
企業向け構成で先に決める権限・リージョン・運用
複数部署やリージョンで使う場合は、権限や保持期間などの条件を導入前に設計しておきます。
- 組織と権限:組織・プロジェクト・チーム、閲覧権限、SSOやSCIM
- 運用条件:保持期間、費用上限、監査、異常検知、サポート
- データ管理:リージョン、Relay、契約上の保護措置
Business相当以上が必要かは、利用者数だけでなく、データレジデンシーなどの要件で判断します。
セルフホストや完全な内製運用を前提にする場合は、機能の差やアップグレード、脆弱性対応の範囲を調べます。さらに、バックアップと障害時の責任分界も確認します。古い情報だけで「完全に自由なOSS」と判断しないようにします。
Sentryのシステム開発・導入の進め方
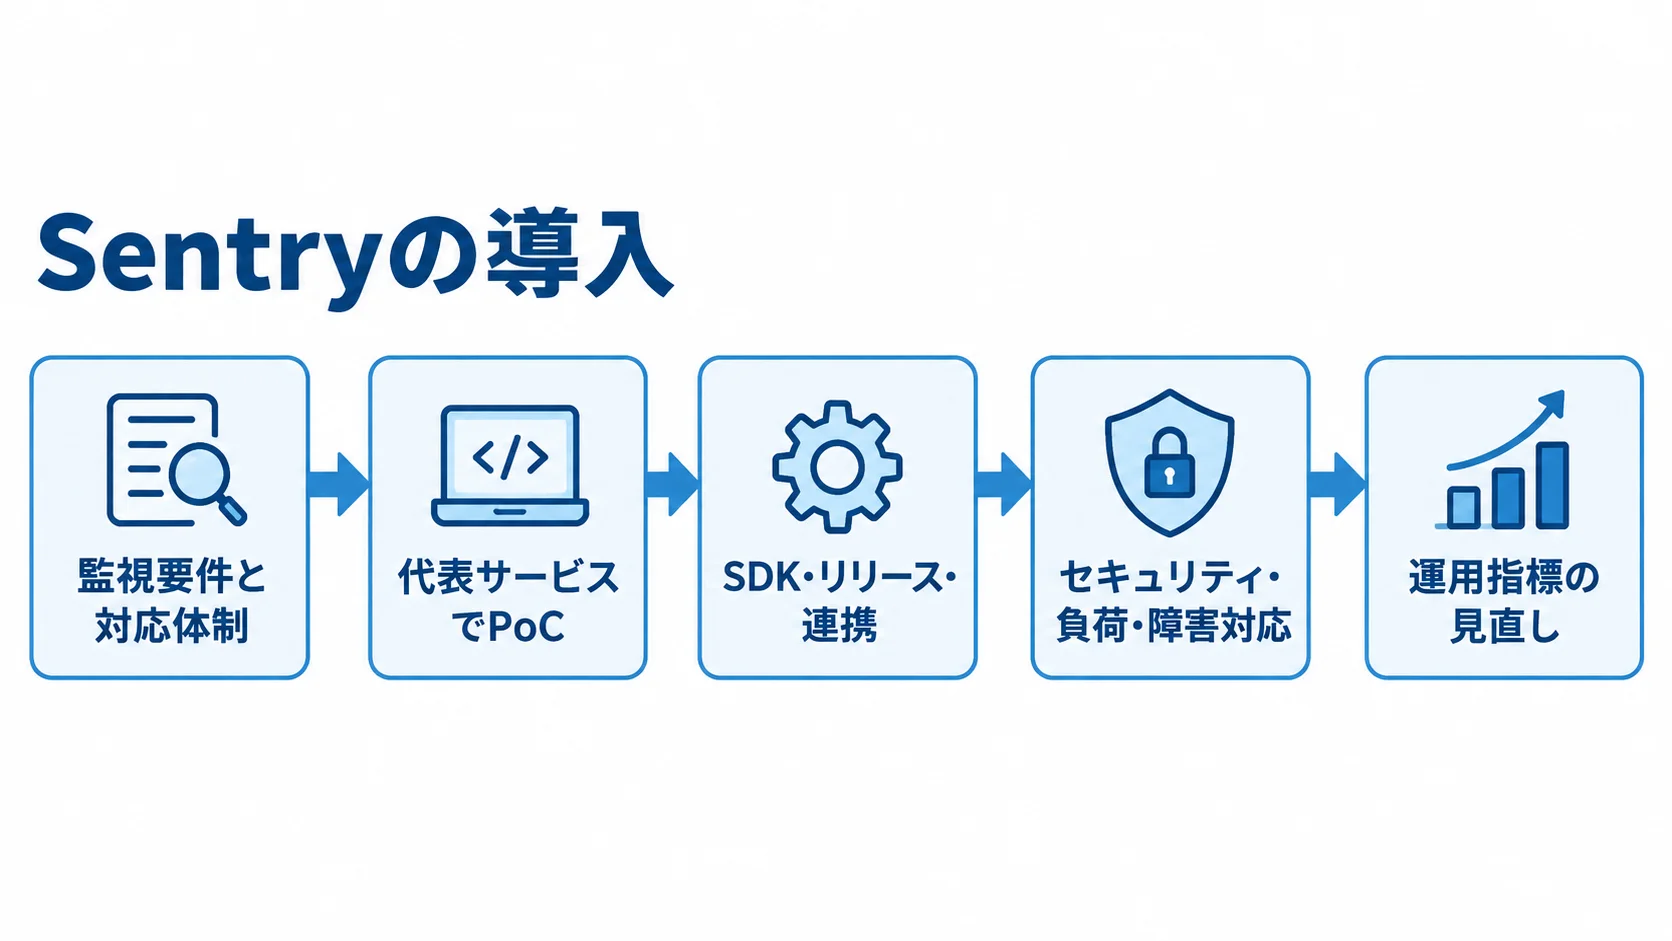
導入では、監視対象と対応責任、送信データと通知基準を決めます。リリース手順と効果測定まで含め、一つの運用設計として進めます。SDKの組み込みは、その設計に沿った作業です。
進め方としては、小さな代表サービスで検証してから、問題がなければフロントエンド、API、バッチ、モバイルへ広げるのが失敗しにくい方法です。
1. 監視要件と対応体制の定義
まず、重要なユーザージャーニーと許容停止時間を洗い出します。ログイン、検索、申請の各処理と、受注、決済、在庫更新の各処理について、失敗時の顧客・業務への影響を決めます。担当チーム、夜間対応の有無、目標復旧時間もあわせて決めておきます。
要件を決めずにおくと、すべてのエラーを同じ重大度で扱ってしまい、通知疲れを招きます。そこで、Issueの所有者と、一次切り分け・修正・リリース承認の担当も明確にします。
SLOを設定するなら、可用性だけでなく、利用者が体感する品質も含めます。品質の指標としては、エラー率、レイテンシー、クラッシュフリー率、重大Issueの未対応時間があります。
2. 代表サービスでのPoC
利用者への影響が分かりやすく、技術的にも代表性があるサービスを一つ選びます。
- 環境:SDKの組み込みと、development・staging・productionの分離
- 動作確認:エラー、リリース、ソースマップ、通知の確認
- 情報保護:この段階で、テスト用の個人情報、認証情報、決済情報が送信されないこと
イベントが届くことだけでは、合格とは言えません。通知を受けてからIssueの優先度を決め、原因を特定し、修正リリースまで演習します。再発時の扱いも含めます。
確認する指標は、導入前後の調査時間、誤通知の量、費用の見込みです。
3. SDK・リリース・連携の実装
本番展開では、処理の重要度に応じて対象を追加します。
- 対象:フロントエンド、API、非同期ジョブ、モバイル、バッチ
- SDK設定:ユーザー情報、URL・ヘッダーのフィルタ、サンプリング、例外除外
- 運用設定:タグとIssueの所有ルールを、コードや設定ファイルに記録
CI/CDには、リリース番号やコミット情報、ソースマップを組み込みます。デプロイ後は、Release Healthで状態を確認する流れにします。
通知先は、重大度と環境に応じて、サービスや担当チームごとに分けます。あわせて、チケットの重複起票を防ぐ条件も設定します。
4. セキュリティ・負荷・障害対応のテスト
テストは、収集の範囲から障害対応の手順まで、順に確かめます。
- 収集と負荷:例外、機密情報、イベント急増時の予算、通知抑制
- アクセスと保存:個人情報のマスキング、権限のない人が詳細を見られない設定、保存期間、削除手順、監査記録
障害訓練では、担当者が影響を判断し、原因を絞り込んで、ロールバックや修正リリースを実行できるかを試します。夜間の確認担当、修正権限、連絡先がそろっていなければ、導入の効果は得られません。
5. 運用指標の見直しと改善
リリース後は、週次または月次で、Issueや運用状況を振り返ります。
- 定期確認:Issueの件数と重複の状況、未対応時間、再発率、通知無視率、イベント量、料金
- 優先度:高頻度でも影響の小さいエラーと、低頻度でも業務を止めるエラーを分けたルールの更新
- KPI:重大な顧客影響を早く見つけて修正できているかの測定
- 変更時:新サービスの追加時に、タグ、所有者、通知、サンプリング、マスキングを見直すこと
運用手順や障害時の連絡網、ダッシュボードの見方を文書にまとめ、引き継ぎに使います。設定変更の承認方法も書き残しておけば、導入担当者だけが設定を理解している状態を避けられます。
Sentryの費用相場とコストの内訳
Sentryの費用は、利用料と導入・開発費、既存システムとの連携費、運用・保守費に分けて考えます。見積もりには、SDKの実装と個人情報対策の工数が入ります。通知設計と障害対応の工数も、あわせて含めます。
▶ 詳細はこちら:Sentryのシステム開発の見積相場や費用/コスト/値段について
プランとイベント量で変わる利用料
2026年8月確認のSentry公式料金ページに掲載されたプラン料金は次のとおりです(出典:Sentry公式Pricing、2026年8月確認)。
- Developer:無料
- Team:月額26米ドル
- Business:月額80米ドル
- Enterprise:個別見積
1ドルを150円として単純換算すると、Teamは約3,900円、Businessは約12,000円です。実際の請求額は、契約期間や為替、税に加えて、追加利用量によっても変わります。
有料プランには基本クォータがあり、TeamとBusinessの場合は、Error 50,000件、Logs 5GB、Tracing 500万span、Session Replay 50件などが含まれます。
エラーを無制限に送ると、追加料金だけでなく検索性も悪化します。そこで導入前に、1日あたりのエラーやログ、Trace、Replayの量を測り、サンプリングとフィルタを決めます。添付ファイルの量も、あわせて測っておきます。
導入・開発費の幅:20万円から3,000万円以上
Sentry単体の導入・開発費は、対象サービス数と運用設計の深さで変わります。範囲が広がるほど、初期費用も上がります。
- PoC:1サービスのSDK、環境分離、基本アラート、送信確認で20万〜80万円
- 小規模な本番:連携、PII除去、通知、手順を含め80万〜300万円程度
- 複数サービス:分散トレース、ログ、権限、SLO等を含め300万〜1,000万円程度
- エンタープライズ:複数組織・リージョン等を含め1,000万〜3,000万円以上
小規模な本番導入では、フロントエンド・API・バッチが見積もりの対象に入ります。
エンタープライズ運用では、SSOやSCIM、監査を求める場合があります。データ移行や24時間運用も、対象に入ることがあります。教育やSLA設計が加わる場合もあります。ここに挙げた額は、Sentry公式の開発統計ではなく、業務システムの工数から推定した相場です。
対応時間と改善範囲で決まる保守・運用費
導入後の費用は、対応時間と改善範囲で変わります。作業には、アラート調整やダッシュボード更新、月次レポート、リリース確認があります。設定変更や一次切り分けも含まれます。
- 平日日中の改善支援:月額5万〜30万円程度
- 24時間対応等を含む支援:月額30万〜150万円以上の場合があります。
後者には、一次対応、SRE伴走、定例改善、障害報告を含むことがあります。
これは類似する監視・運用支援からの推定額です。契約時間と対応範囲を分け、利用料と設定、改修、連携を別行で見積もります。
マスキングやテスト、文書、教育、保守も、別々に示すと比べやすくなります。
従量課金では、イベントの上限や予算アラートを設定し、サンプリング変更の承認者を決めておくと、予想外の請求を防げます。
費用を抑える監視範囲とデータ量の設計
費用を抑えるには、必要な情報は残しつつ、目的のないデータ送信を避けることが基本です。
- イベント:健康診断用など、価値の低いものを除外
- TraceとReplay:重要画面への絞り込み
- ログと環境:保持期間と検索用途の決定、ステージングの大量イベントを本番と同じ設定で送らないこと
サンプリングを強くしすぎると、再現しにくい障害の手掛かりを失います。
会員登録や決済、申請、受注などは、観測率を高く保ちます。一方で、静的ページや低影響の処理は段階的に抑え、重要度に応じて配分します。
開発会社・ベンダーの選び方
Sentryの契約や初期設定を支援する会社と、業務システムへ組み込んで障害対応まで設計する会社は、同じとは限りません。
選定では、ツールの知識に加えて、アプリケーション開発からクラウド、セキュリティ、リリース管理、SRE、保守運用まで、どこまで一体で任せられるかを確かめます。
導入件数より改善工程を見る実績の確認
提案会社には、利用経験を尋ねるとともに、次の観点で話を聞きます。
- 技術と範囲:言語、フレームワーク、構成、監視範囲
- 実装経験:ソースマップ、リリース、分散トレース、PII対策、通知抑制、Issue所有
- 改善内容:導入前後に何を改善したかの確認
公開事例は、会社名や数値よりも、自社との条件の近さを見ます。規模や利用者数、リリース頻度、障害対応時間、個人情報、夜間運用が近いかを確かめます。
非公開案件でも、匿名化した構成図や成果指標、作業範囲、顧客側に残る運用責任を説明できる会社なら、比べやすくなります。
観測範囲と責任分界による技術提案の評価
提案を見るときは、観測範囲と責任分界、データ管理の三つを確認します。
- SDKの対象:フロントエンド、API、バッチ、モバイル、DB、外部連携
- 監視と責任:Sentry、インフラ監視、ログ基盤の範囲を図示し、一次対応する会社・部署を明確化
- データ管理:送信先、閲覧者、削除時期を技術要件・契約条件の両面で確認
良い提案は、機能をすべて有効にする案よりも、重要な業務フローに必要な観測を絞り込みます。
SDKの設定例や通知ルールがあると、導入後の姿を具体的に比べられます。リリース運用、障害訓練、ダッシュボードの例も、あわせて示してもらうと、各社の差を見分けやすいです。
見積と引き渡し条件の確認
見積では、対象範囲、費用条件、納品物を明確にします。
- 見積条件:サービス数、言語、環境、月間イベント量、連携先、保持期間
- 要件:マスキング、SSO、運用時間帯、SLO、教育の有無
- 費用内訳:利用料と作業費、従量課金、急増対応、追加作業単価
- 成果物:コード、SDK設定、フィルタ、CI/CD、ダッシュボード、アラート、権限一覧
- 引き渡し資料:運用手順、障害対応フロー、テスト結果、設定変更方法
引き渡し時には、自社で変更できる範囲と、保守契約が必要な範囲を合意します。こうして合意しておくと、特定の担当者や会社への依存を抑えられます。
▶ 詳細はこちら:Sentryのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Sentryのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
▶ 詳細はこちら:Sentryのシステム開発の発注/外注/依頼/委託方法について
セキュリティと運用で見落としやすいポイント
Sentryへ送るイベントには、エラー内容だけでなく、URL、ユーザー情報、リクエストヘッダー、画面操作、入力値が含まれる可能性があります。
情報を集めすぎると、個人情報や機密情報の漏えいリスクが高まります。そのため、最小限のデータで原因を調べられる設計が必要です。
送信前に抑える個人情報と機密情報
送信する情報は最小限にし、個人情報や機密情報を除きます。
- 識別情報:ユーザーIDは必要に応じてハッシュ化するか、社内定義の識別子へ置き換えます。
- 送らない情報:氏名、メールアドレス、電話番号、住所、認証トークン、決済情報、URLクエリの秘密値
- マスキング:Authorization、Cookie、Replayの入力欄の制御
- エラー本文:業務データを含めないこと
設定を入れたら、開発環境で実際のテストイベントを送り、ダッシュボード、通知、Replay、ログに表示される値を点検します。
マスキングルールは、画面やAPI仕様が変わると漏れることがあります。そこで、リリーステストと定期監査に確認を組み込みます。
国外クラウドへのデータ移転の確認
国外クラウドを使う場合は、データ移転と契約上の対応を確かめます。
- 処理と委託:保存・処理地域、委託先、サポート担当者のアクセス
- 運用:保持期間、削除方法、セキュリティ認証、インシデント通知
- 制度情報:外国の名称、保護制度、第三者の保護措置
個人情報保護委員会のガイドラインでは、外国にある第三者へ個人データを提供する際に、上記のような情報提供が示されています(出典:個人情報保護委員会「外国にある第三者への提供編」、2025年改正後の公開資料)。
まずは、送信する情報を個人データではない形へ減らせるかを検討します。そのうえで、契約やプライバシーポリシー、社内規程、委託先管理、本人への説明を、法務・個人情報保護の担当と確認します。判断は、データの種類や利用目的、提供形態、契約関係によって変わります。
アラート疲れを防ぐための優先順位の定義
アラート疲れは、Sentry導入後に起きやすい問題です。開発中の例外、想定内の入力エラー、一時的な外部サービス障害、本番の顧客影響を同じ通知先へ流すと、担当者は通知を見なくなります。
通知の優先度は、環境や処理、利用者への影響に応じて分けます。
- 即時通知:本番で顧客影響が大きい問題や急増中のIssue
- 営業時間内確認:業務時間内に担当者が確認する問題
- 定期レビュー:低優先度の問題や通知ノイズ
Issueの所有者を自動で割り当て、同じ原因の重複通知を抑え、解決済みIssueが再発したときだけ再通知するなど、対応フローを決めておきます。
月次で、対応不要だった通知数、顧客から先に連絡された件数、重大Issueの見逃しを振り返ると、感覚に頼らずルールを見直せます。
障害対応の責任者と改善会議の決定
Issueの確認、修正、報告を誰が担うかは、Sentryを入れた後も自分たちで決める必要があります。そのうえで、役割分担と改善会議で扱う内容を決めます。
- 障害対応表:プロダクト、開発、インフラ、セキュリティ、サポートの役割と連絡順・判断基準
- 定例会:重大Issue、再発、未対応、通知ノイズ、観測できなかった障害を確認
Sentryの設定変更を、コードレビューや変更管理の対象にすると、異動やシステム拡張があっても監視品質を維持しやすくなります。
よくある質問(FAQ)
Sentryの導入前には、料金、対象範囲、個人情報、既存監視との関係を確かめておく必要があります。次の質問は、検討の段階でよく挙がるものです。
Sentryがあればインフラ監視は不要ですか?
不要にはなりません。Sentryは、アプリケーションのエラー、性能、リリース品質、ユーザー影響を把握する仕組みです。
CPU、メモリ、ネットワーク、ホスト、データベース基盤の監視とは役割が異なります。Trace IDやサービス名で両者をつなぐと、同じ障害を別の視点から調べられます。
無料プランだけでSentryを運用できますか?
小規模なPoCや一つのサービスのエラー監視なら、無料のDeveloperプランから試せる可能性があります。
有料プランが必要になるかは、利用者数やチーム連携、イベント量、保持期間で変わります。SSOや権限、ログやReplayの利用状況も関係します。
無料枠で始める場合も、イベント量を測り、将来の追加利用料と運用工数を含めて判断します。
Sentryへ個人情報を送っても問題ありませんか?
問題ないとは、一律には言えません。個人情報や認証情報を送らない設計にしたうえで、SDKのフィルタやサーバー側のマスキング、Replayの入力欄の制御を確認します。権限管理と保存期間も、あわせて確かめます。
国外クラウドへのデータ移転、委託先管理、社内規程、本人への説明や同意の要否は、法務・個人情報保護担当と確認してください。
Sentryの導入は自社だけでできますか?
一つのWebサービスへSDKを追加し、基本通知を設定するだけなら、自社で実施できる場合があります。
複数サービスの相関やリリース管理、PII対策まで含めると、アプリ開発と運用設計の経験が必要になります。既存監視との連携やSLO、夜間対応、監査要件も、そこに加わります。
自社の不足部分だけを外部へ依頼し、設定と運用手順を引き渡してもらう方法もあります。
まとめ
Sentryは、業務システムやアプリケーションのエラー、性能、リリース品質、ユーザー影響を開発チームが追跡する監視基盤です。
サーバーの死活監視で分からない画面操作や、API、データベース、外部連携の問題も、修正につながる情報としてまとめられます。
導入判断で押さえる3つの要点
Sentryは、Issue、Trace、Logs、Release Health、通知を、開発・運用の流れへ組み込んで価値を発揮します。
費用には、利用料のほかに、SDK実装、既存システム連携、個人情報対策、テスト、運用保守も含めます。
導入前に所有者、重大度、SLO、夜間対応、データ送信範囲を決めておき、導入後も改善の指標を持つ必要があります。
重要な1サービスでの現状測定
導入判断は、重要な1サービスの現状測定から始め、PoCで必要な構成を見極めます。
- 現状測定:エラー件数、検知・原因特定・修正時間、顧客への問い合わせ件数
- PoC:観測範囲、プラン、連携、運用体制の決定と、過剰機能や不明確な見積もりの回避
- 目標:利用者に影響する問題を早く見つけ、確実に直せる仕組みづくり
▼関連記事一覧
・Sentryのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Sentryのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Sentryのシステム開発の見積相場や費用/コスト/値段について
・Sentryのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。