
音声認識システムの開発期間は、既製APIを使うか独自に作るかで、即日から1年程度まで幅があります。開発は、要件定義・設計、開発、実環境テストの順に進みます。
音声の文字化に絞って、期間・工程・話者識別・遅延対策を説明します。対話や応答の生成は対象外です。
▼全体ガイドの記事
・音声認識システム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
音声認識システム開発の開発期間の全体像と、ボイスボットとの違い
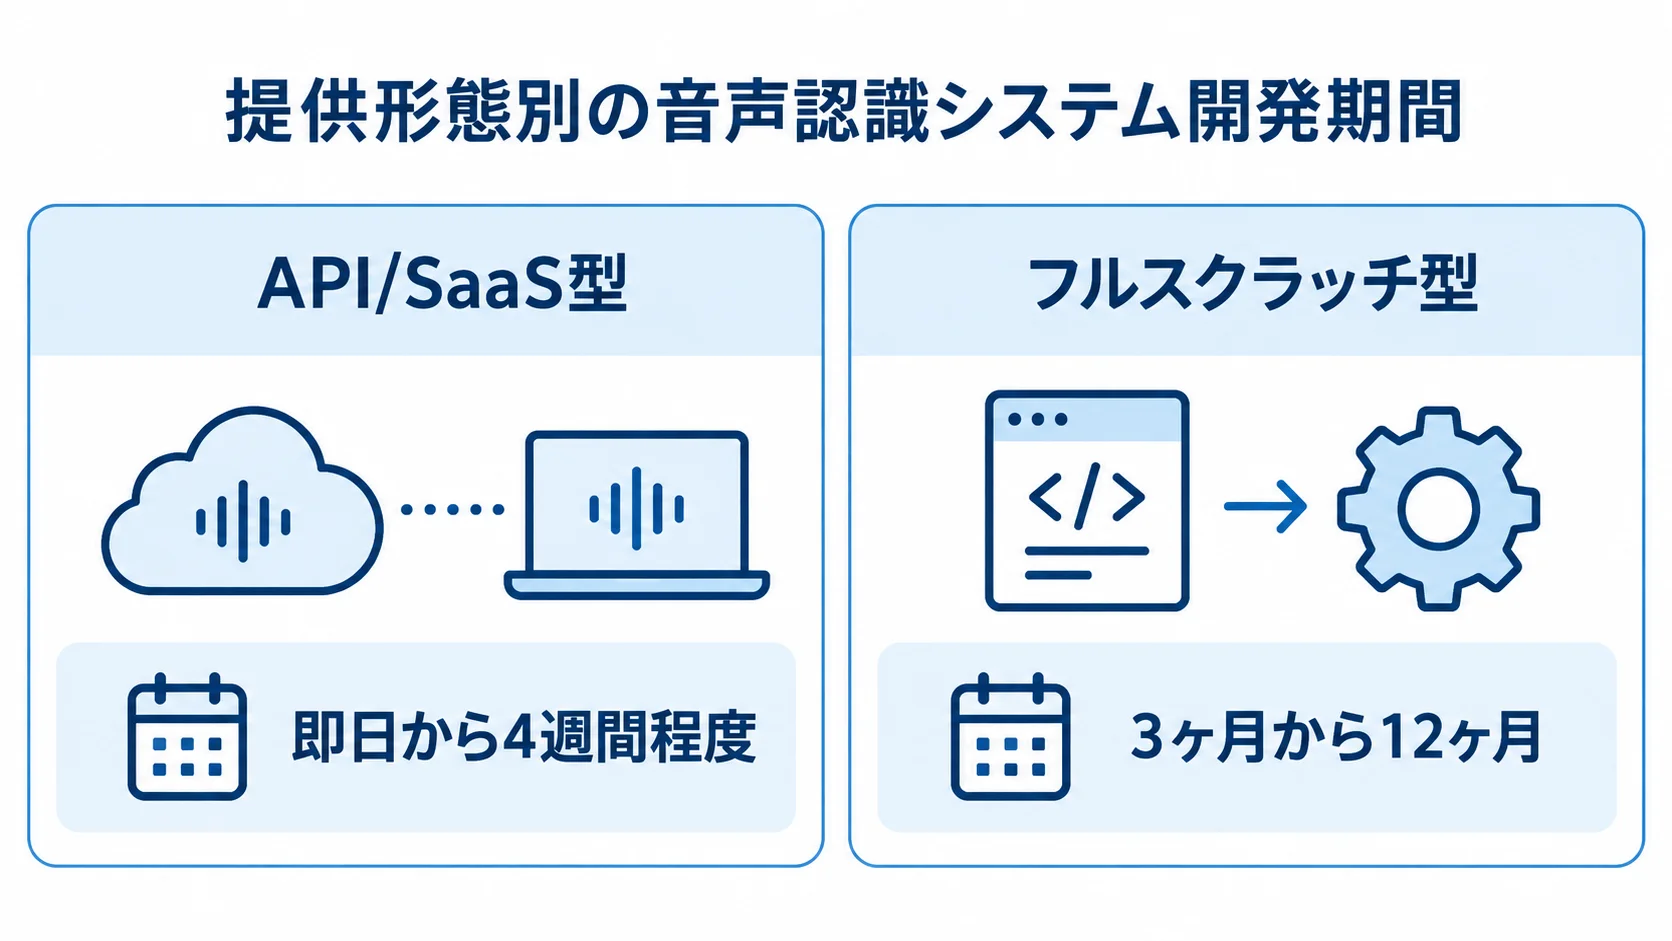
音声認識システムの期間は、既製のクラウドAPIを使うか、独自エンジンをフルスクラッチで作るかで変わります。求める精度や特殊な環境への適応範囲も影響するため、即日から1年程度まで幅があります。
既製APIの組み込みは即日から4週間程度です。一方、独自モデルの学習は3ヶ月から12ヶ月が目安です。
「音声を聞いて文字にする」入口レイヤーとしての位置づけ
開発期間を見積もる前に、音声認識システムとボイスボットが担う処理範囲の違いを押さえておきます。
- ASRは、Automatic Speech Recognition=自動音声認識の略です。
- 音声認識:マイクや電話口の音声波形をAIで解析し、文字列にする入口の基礎技術です。回答や対話の継続は担いません。
- ボイスボット:発話を文字化し、自然言語処理で意図を解釈します。回答を組み立て、音声合成で読み上げます。
対話シナリオや音声合成の調整は要りません。一方で、認識精度の作り込みが工数の中心になります。
話し方の違いや雑音を含む音声も、正確に文字にしなければなりません。そのため、認識精度を高める期間をどれだけ見込むかで、現実的なスケジュールが決まります。
提供形態別の期間目安(API/SaaS型・フルスクラッチ)
提供形態は、API/SaaS型とフルスクラッチ型に分かれ、開発期間の性格も異なります。導入を急ぐか、独自環境に合わせた精度調整を求めるかで選びます。
- API/SaaS型:既製クラウドAPIを使い、即日から4週間程度で導入できます。
- フルスクラッチ型:独自エンジンを構築し、開発に3ヶ月から12ヶ月を見込みます。
API/SaaS型では、Google Speech-to-TextやAmazon Transcribeを使います。Microsoft Azure Speechなども利用できます。これらのAPIはインターネット経由で呼び出し、初期費用は0円から数十万円程度、月額は数万円程度からです。
音声を送るとテキストが返る仕組みが完成しているため、自社システムからAPIを呼び出す実装さえ済めば利用できます。汎用的な議事録や一般的なコールセンター通話であれば、実用に届くことが多い方式です。
オンプレミス環境では、AmiVoiceなどの商用エンジンやKaldi、Whisperのローカル処理を基盤にできます。
医療・法律・特定業界のコールセンターなど、専門用語や激しい雑音、強い方言があり、汎用APIの精度が著しく落ちる現場で選ばれる方式です。
専門用語の多い現場で高精度に文字化するには、独自の音響モデル・言語モデルを一から学習します。その調整に時間がかかるため、既製APIより期間が長くなります。既製APIなら短期間・低コストで始めやすく、独自に作り込むほど期間は延びます。
まず、汎用的な文字起こしで足りるか、自社の音声環境に最適化した高精度なエンジンが必要かを決めます。求める精度と予算、期間のバランスから方式を選ぶと、現実的なスケジュールの出発点になります。
開発期間を左右する要因
同じフルスクラッチ型でも、状況によって期間は前後します。特に影響するのは、モデル調整の期間と、議事録・通話・音声コマンド・話者識別のどれを用途にするかです。
音響モデル・言語モデルのチューニング期間
フルスクラッチ型が3ヶ月から12ヶ月と幅広い主な理由は、音響モデルと言語モデルの調整にあります。この調整には一般に1ヶ月から3ヶ月程度をかけ、丁寧に行うことで認識精度を高めます。
- 音響モデル:声質や話す速さ、周囲の雑音など音の特徴を学習します。
- 言語モデル:単語の並び方を学習し、商品名や専門用語の認識に関わります。
工場の騒音下でコマンドを認識させる場合や、電話回線の音声を扱う場合は、その環境で録音した音声データを大量に集めて学習させます。
言語モデルでは、自社の商品名・部署名・専門用語・略語を正しく文字にできるかが課題です。
どちらのモデルも、データを一度投入すれば完成するものではありません。認識結果の誤りを確かめてデータを追加し、再学習を重ねて、精度を上げていきます。精度目標に届かないと納期が後ろ倒しになりやすいため、期間には余裕を持たせます。
想定用途(議事録作成・コールセンター通話テキスト化・音声コマンド認識・話者識別)による違い
用途ごとに必要な作り込みが異なるため、開発期間にも差が出ます。それぞれの音声環境や認識対象を踏まえて、優先順位を決めておきます。
- 議事録:静かな会議室の録音が中心で、汎用APIでも実用水準に届きやすい傾向です。
- 通話テキスト化:電話の音質や多様な話し方、早口への調整が必要です。
- 音声コマンド:「電源オン」「停止」など語彙は少数ですが、機器の動作音や環境音の中で確実に認識させる調整に時間がかかります。
- 話者識別:発言者を区別する機能が加わり、技術的難易度が上がります。
議事録用途は、API/SaaS型なら即日から数週間で立ち上げられる傾向があります。独自の専門用語辞書を整備する場合も、比較的短い期間で導入できることがあります。
一方、通話テキスト化では音響モデルの調整に一定の期間がかかり、議事録より工数が増えます。なお、話者識別の期間への影響は後の章で説明します。
工程別のスケジュールと期間配分
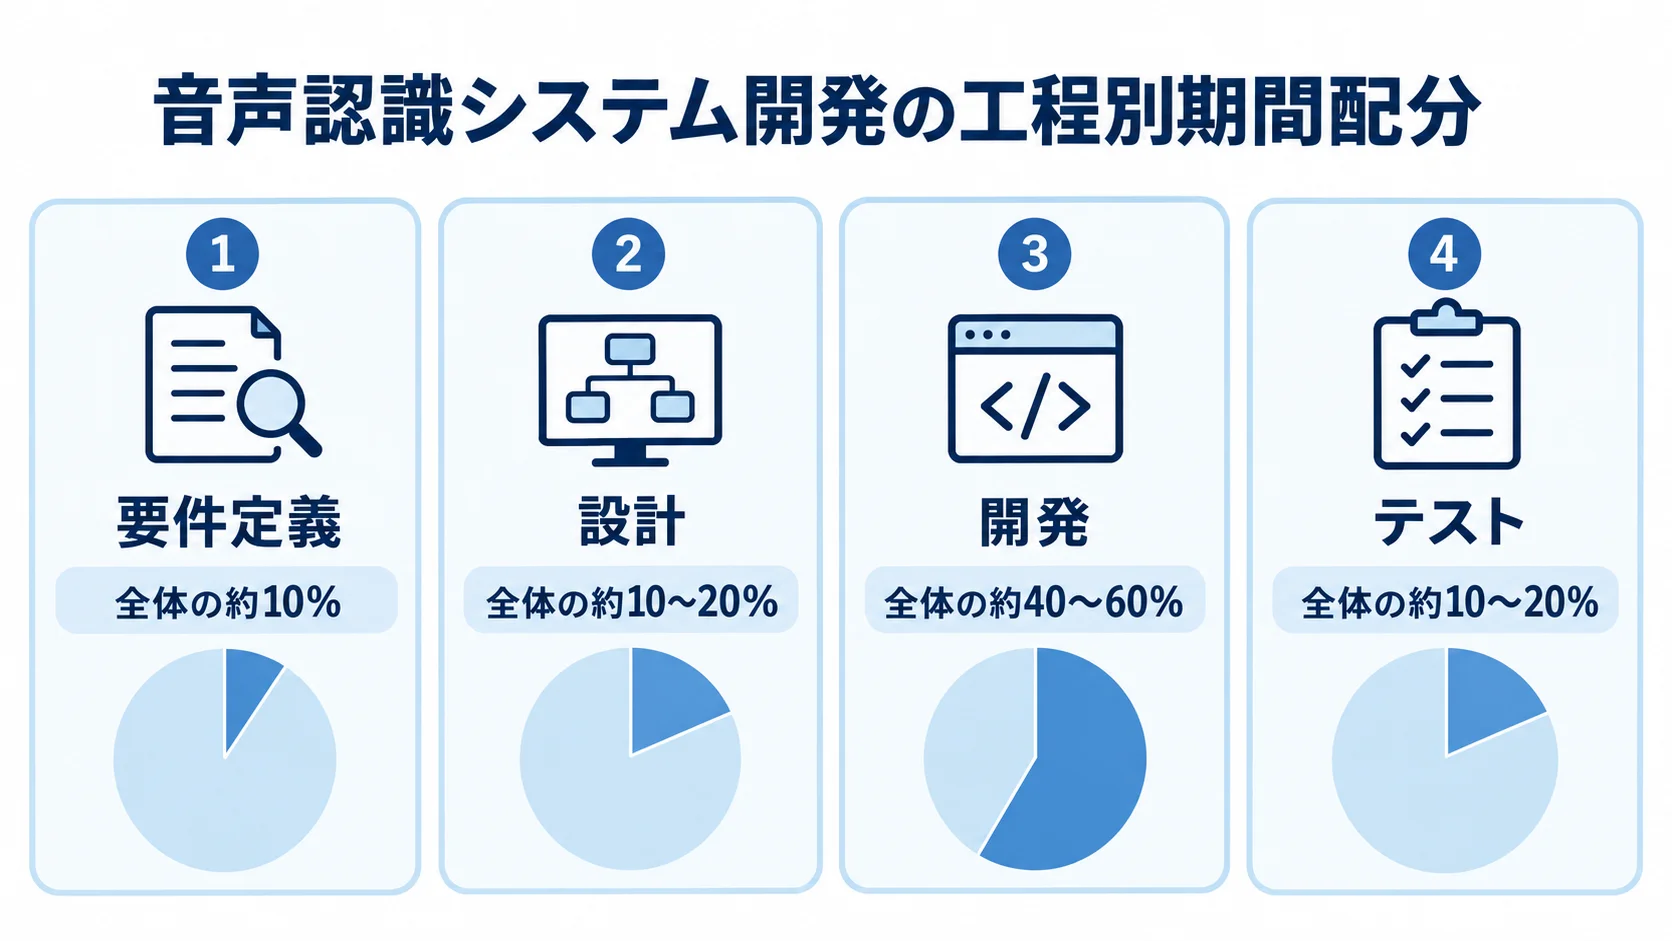
期間を見積もるには、要件定義から本番稼働までの配分を押さえておく必要があります。フルスクラッチ型の一般的な目安を見ると、開発の割合が大きく、前後の要件定義・設計やテストに割く時間が全体の組み方を左右します。工程ごとの割合は、下の4項目が目安です。
- 要件定義:全体の約10%。
- 設計:全体の約10〜20%。
- 開発:全体の約40〜60%。
- テスト:全体の約10〜20%。
要件定義・設計と、開発・テストでは、工程の内容も期間の考え方も異なります。
要件定義・設計フェーズ
要件定義は全体の約10%を配分する上流工程で、システムの成否を左右します。対象とする音声と必要な精度を具体化し、合格ラインを発注側と開発会社で合意します。
- 音声の条件:収録環境、話者の人数、扱う専門用語の範囲。
- 精度の基準:単語の誤り率を、どこまで下げれば実用と認めるかの水準。
静かな会議室と雑音の多い電話回線では、必要な音響モデルの調整が異なります。目標が曖昧なままだと、後のチューニングが際限なく膨らみます。
設計には全体の約10〜20%を配分し、エンジン構成、認識結果を他システムへ渡すAPI仕様、ログの保管方法を具体化します。
さらに、音響モデル・言語モデルの学習データと調整計画も、この段階で設計します。後工程で必要な音声が手元にない事態を避けるため、データ収集の道筋も早期に決めておきます。
開発・テストフェーズ(雑音環境での認識率検証を含む)
開発は全体の約40〜60%を占める、最も工数のかかる工程です。テストには約10〜20%を配分します。
- 開発:エンジン実装、モデル調整、認識ログ管理、他システムとのAPI連携。
- テスト:利用環境に近い音声で認識率を確かめます。
開発では、音声データを学習させ、認識結果の誤りを直すチューニングに多くの時間を使います。
開発中は精度が高く出ても、実際の現場には、空調音や周囲の話し声、電話回線のノイズが混じり、機器の動作音も加わります。そのため、こうした環境で認識率を検証し、単語の誤り率が要件定義で決めた基準を満たすかを測ります。
合格ラインは、一般に10〜15%以下などの水準です。基準に届かない場合はモデル調整に戻るため、開発とテストの往復期間が納期を左右します。
話者識別(ダイアライゼーション)機能を含む場合の期間への影響
話者識別(ダイアライゼーション)は、誰が話しているかを区別する機能です。これを加えると、音声を文字にするだけの場合より開発期間が上乗せされます。
会議での発言者や、通話中のオペレーターとお客様を区別する用途で使われます。実用面の価値は高い一方、技術的な難易度も上がります。期間を延ばす要因は、話者登録と発話の重なりの2つです。
話者登録・声紋データ収集にかかる工数
話者識別では、話者登録や声紋データの収集が必要になる場合があります。そのため、名前付きで個人を特定するのか、発言者の切り替わりだけを区別するのかを、先に決めておきます。
- 名前付きで識別:一人ずつ声を収録し、声紋データとして登録します。
- 切り替わりを識別:「話者A」「話者B」と区別できれば、事前登録は不要です。
会議で「田中部長の発言」として振り分ける場合は、対象者の声のサンプルを事前に登録します。登録する人数が増えるほど、収集と登録の時間も積み上がります。
声は体調や場面によって変わるため、複数の場面のサンプルを追加して調整することも必要です。登録の要件を早めに見極めれば、不要な工数を抑えられます。
複数話者の発話が重なる会議音声特有の技術課題
会議では複数人の発言が同時に起きることがあり、発話の重なりが話者識別の期間を押し上げます。
- 切り分けの誤り:別々の人の発言を一人にまとめてしまうこと。
- 発言者の誤判定:一人の連続した発言を、複数人に割り振る誤り。
人には聞き分けられる音声でも、システムにとっては、誰の声がどこからどこまでかを判定するのが難しい場合があります。
精度を高めるには、話者が入り交じる実際の会議音声で、検証と調整を繰り返します。一人ずつ順番に話す音声に比べると、検証の工数がかさみます。
このため、話者識別を含める場合は、通常の音声認識より検証とチューニングの期間を厚めに確保します。
納期遅延の典型要因と対策
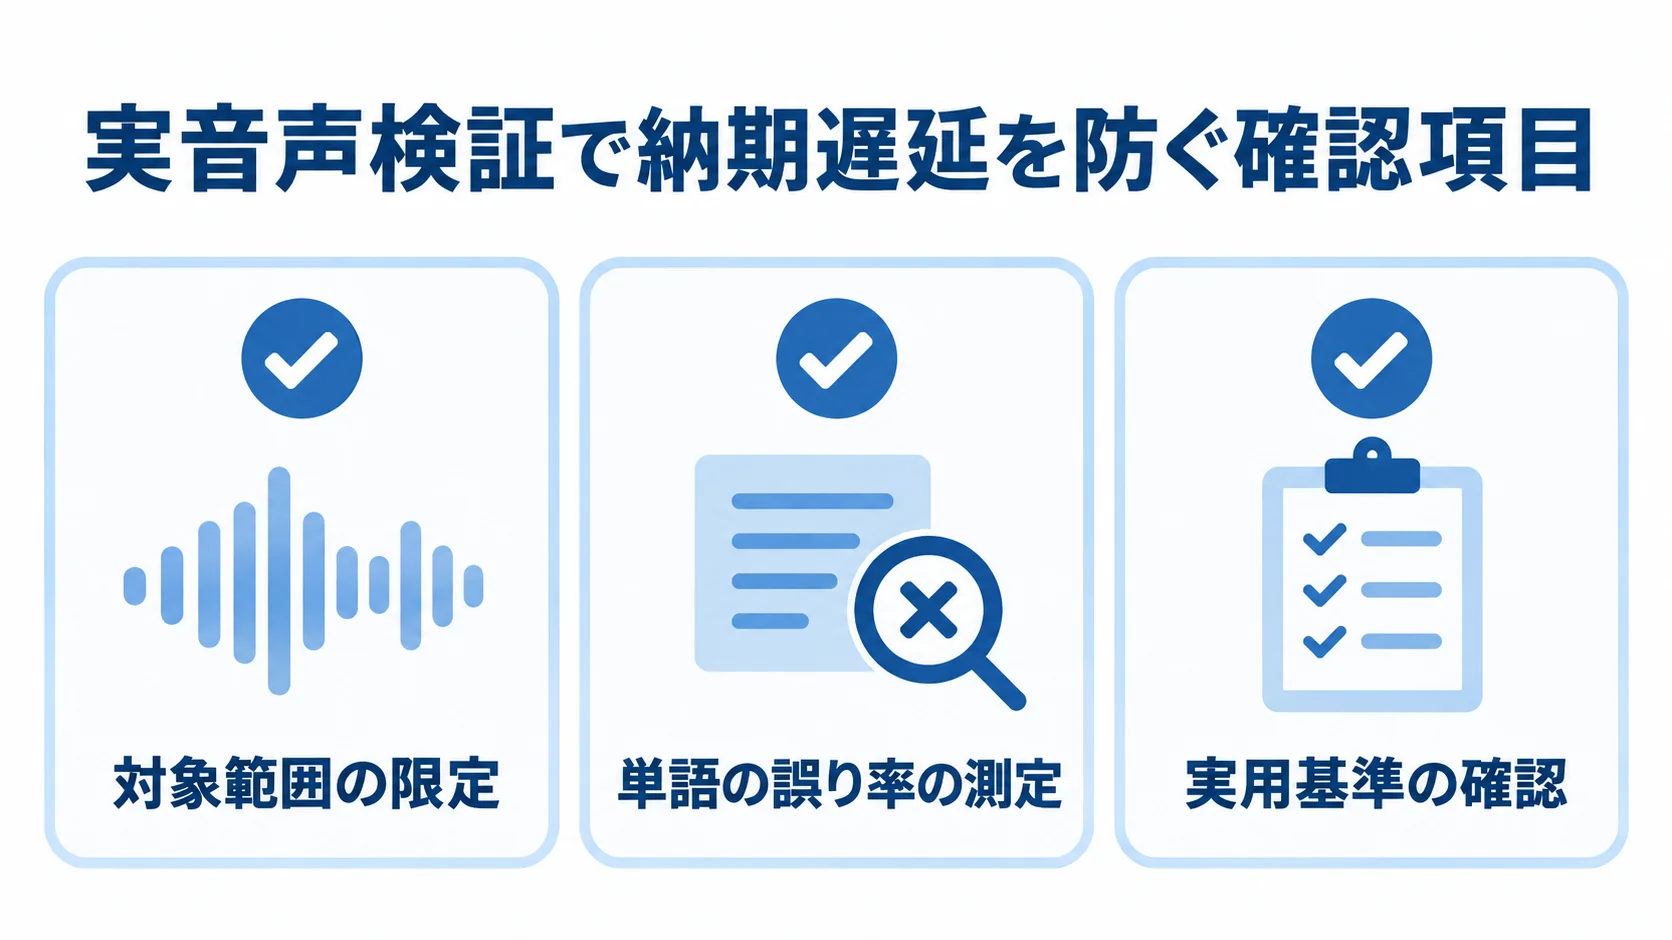
遅延には一般的な開発要因に加えて、音声を正確に文字にする難しさも関わります。特に、辞書整備の遅れと、実データ検証の不足による手戻りが起きやすい要因です。
どちらも本番稼働の直前に表面化しやすいため、要件定義や検証の段階で対策を進めます。
専門用語・固有名詞辞書整備の遅延
遅延要因としてよくあるのが、専門用語・固有名詞の辞書整備です。汎用エンジンは日常語を高精度で認識しても、未登録の語は誤認識する場合があります。
- 登録語の洗い出し:商品名、部署名、専門用語、略語、社名、人名の一覧。
- 表記の整理:読み方や表記の揺れを確認し、辞書に反映します。
- 優先順位づけ:初期リリースでは、利用頻度の高い語から整備します。
議事録の専門用語や、通話の商品名・手続き名が誤認識されると、実用に耐えません。登録語は現場に散らばっており、読み方や表記の揺れを含めて洗い出すと、想定以上に手間が膨らんで開発を遅らせます。
要件定義の早い段階で現場の担当者を巻き込み、用語集や過去の議事録、商品マスタを使えば、ゼロから作るより短い期間で辞書の土台を作れます。さらに、辞書は稼働後も追加していく運用が前提です。
実データ検証不足による手戻り
実際の現場音声での検証が不足すると、本番直前や稼働後に誤認識が増え、手戻りが生じます。そこで、実音声を使った早期の検証が納期対策になります。
- 対象を絞る:特定部署の議事録や一部のコールセンター回線で試す。
- 精度を測る:実際の音声で、単語の誤り率を把握します。
- 基準を確かめる:精度が実用基準に届くかを、早めに判断する。
人の会話には、言い回しの揺れや省略が含まれ、言い直しや言いよどみも混じります。現場の専門用語や雑音を正しく認識できるかは、音声を流して確かめる必要があります。
整った録音だけで検証すると、本番の生音声で認識率が想定を下回り、人手による修正が膨大になることがあります。また、文字起こしの手間が導入前より増える事態にもつながります。
そのため、現場のありのままの音声で検証することが、納期を守るうえで欠かせません。
まとめ
音声認識システムは、音声を文字に変換するASRで、理解や回答まで担うボイスボットとは役割が異なります。
期間の目安は、クラウドAPIを使うAPI/SaaS型が即日から4週間程度、オンプレミスに独自エンジンを構築するフルスクラッチ型が3ヶ月から12ヶ月です。さらに、モデル調整には1ヶ月から3ヶ月程度かかることがあります。工程配分の目安は、要件定義が約10%、設計が約10〜20%、開発が約40〜60%、テストが約10〜20%です。
議事録、通話、音声コマンド、話者識別では、必要な作り込みがそれぞれ異なります。話者識別では、話者登録や声紋データ収集に加え、発話が重なる会議音声への対応も期間に影響します。
まずは、用途と必要な精度、予算に合う方式を整理します。そのうえで、複数の開発会社に要件概要を示し、見積もりとスケジュールを比べます。
▼全体ガイドの記事
・音声認識システム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。