
TensorFlowのシステム開発を発注する場合は、業務課題とデータの確認、PoC、要件整理、本番開発、運用設計の順に進めると、業務導入につながります。
発注形態から委託先の選び方まで、順に見ていきます。全体像は、TensorFlowのシステム開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・TensorFlowのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
TensorFlowのシステムの範囲と仕組み
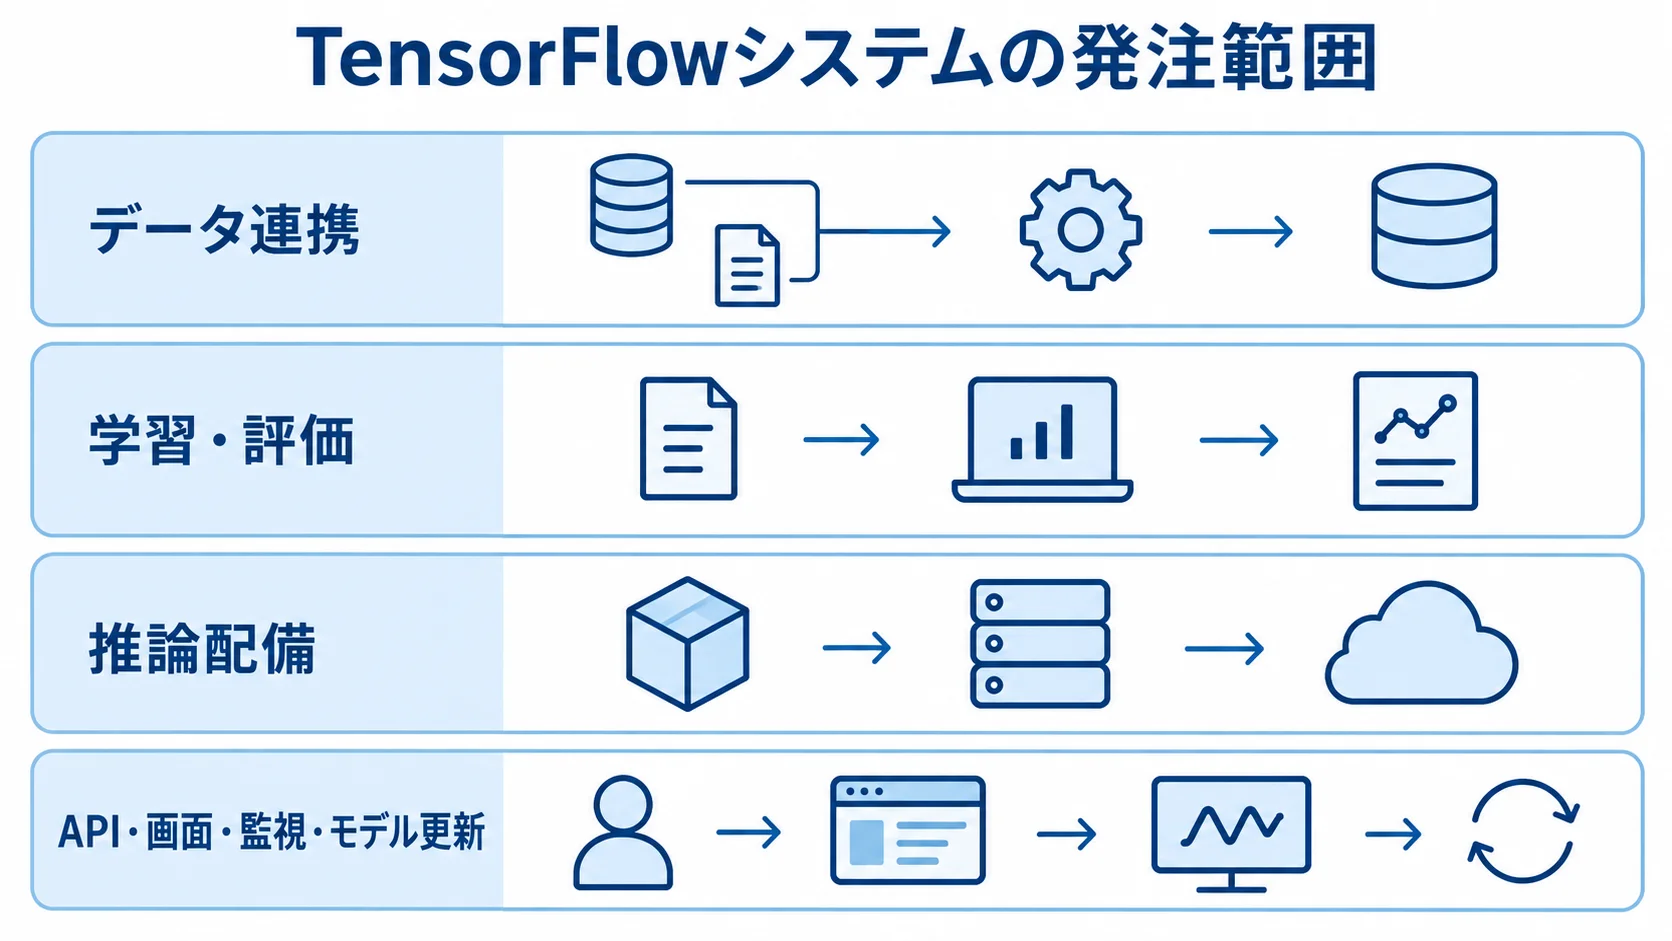
TensorFlowのシステムは、業務データを加工し、学習済みモデルで推論して、その結果を業務画面や既存システムへ返す仕組みです。さらに、発注の対象にはAIエンジンだけでなく、データ連携、API、認証、画面、監視、モデル更新も含まれます。
業務パッケージとは異なるAIモデルの開発基盤
TensorFlowは、画像、テキスト、音声、センサー値から分類、検出、予測、異常判定を行うモデルを開発・学習する、オープンソースの基盤です。
- 業務パッケージとの違い:販売管理やCRMのような画面や権限管理は、標準では搭載されていません。
- システムの範囲:データの収集と加工から、学習、評価、推論配備までの範囲です。
- 発注要件:データの更新頻度、推論時間、誤判定時の業務フローを、発注時に決めておきます。
「TensorFlowを導入する」とだけ伝えると納品の範囲が曖昧になりやすいため、データ連携、API、認証、画面、監視、モデル更新も発注対象に含め、範囲を一つずつ書き出しておきます。
実際の流れでは、基幹システムや検査装置から受け取ったデータをデータレイクやDWHに保存します。そのあと、欠損処理やラベル付けを経て学習に進みます。
学習後は、モデルを評価して承認します。配備先の例として、TensorFlow Servingなどの推論サーバー、クラウドのエンドポイント、TensorFlow Liteがあります。
発注に向く代表的な業務課題
AI化に向くかは、過去データの量と品質、正解ラベルの用意しやすさ、改善したいKPIで判断します。
- 画像検査:製造ラインで、良品と不良品を判定する用途です。
- 予測・検知:設備やIoTセンサーの異常、販売・需要、不正を対象とします。
- 分類・推薦:文書分類、レコメンド、音声処理に使います。
画像検査では、良品と不良品の画像をそろえ、現場の担当者が判定を訂正できる運用を設計します。需要予測では、販売実績に加えて、季節性、販促、欠品、店舗や商品の属性を扱います。
データが不足している場合や、導入後の判断フローが決まっていない場合は、本開発より先に、データアセスメントや小規模なPoCを発注する方が安全です。
TensorFlowのシステムの発注形態の選び方
発注形態は、課題の不確実性、社内技術者、データの機密性を基に選びます。また、納期や将来の内製化方針も、判断材料になります。
フルスクラッチの一括発注のほかに、PoC、部分委託、クラウド活用、内製支援を組み合わせる方法もあります。
PoCから段階的に委託する方法
AIの実現性や精度が見通せない場合は、2〜4か月程度のPoCを先に発注します。このとき、成果物には精度だけでなく、ほかの検証結果も含めます。
- 性能:ベースラインとの比較と、誤検知・見逃しの内訳を示してもらいます。
- 費用と速度:推論レイテンシと1件あたりの推論コストの確認。
- 実運用:データ不足の課題と、現場での確認手順。
本番へ移す条件は、事前に決めておきます。基準としては、再現率や適合率の目標、許容する誤検知数、担当者の確認時間があり、既存システムとの連携可否も判断材料になります。
PoC後に別の会社へ本番開発を移す可能性があるなら、契約で学習コード、評価データ、モデルファイルを受け取る条件を定めます。データ仕様書も、受け取り対象に含めます。
データから業務画面までの一括委託
社内に、データ基盤から業務アプリまでを横断できる人材が少なく、本番運用を短期間で立ち上げたい場合は、一括委託が候補になります。
- 委託範囲:データ連携、前処理、学習、評価、API、画面、認証、監視、運用手順を一括で含めます。
- 責任分担:業務承認者、データ所有者、インフラ管理者の担当を定め、障害時の一次対応者も決めます。
- 再委託:委託先が再委託する範囲の確認。
一括委託であっても、納品されたモデルを現場に組み込めない場合や、保守会社がモデルを更新できない場合があります。そのため、運用が分断されないような提案になっているかを確かめます。
クラウド活用とオンプレミスの使い分け
クラウドのマネージドMLサービスは、学習ジョブ、モデル配備、エンドポイント、パイプラインの初期構築を短縮しやすいのが特徴です。
たとえば、SageMaker AIは、独自のTensorFlowコードによる学習を支援します(出典:Amazon SageMaker AI公式ドキュメント、2026年確認)。
- クラウド:SageMaker AIはホスティングエンドポイントへ配備でき、TensorFlow向けコンテナも利用できます。
- オンプレミス・閉域クラウド:社外へ出せないデータ、既存GPU設備、遅延要件に応じて検討します。
- 比較条件:GPUの調達と保守、ピーク処理、バックアップ、脆弱性対応、終了時の移行。
クラウドかオンプレミスかは、価格に加えて、処理能力や運用を含めて判断します。
RFPと要件整理で決める事項
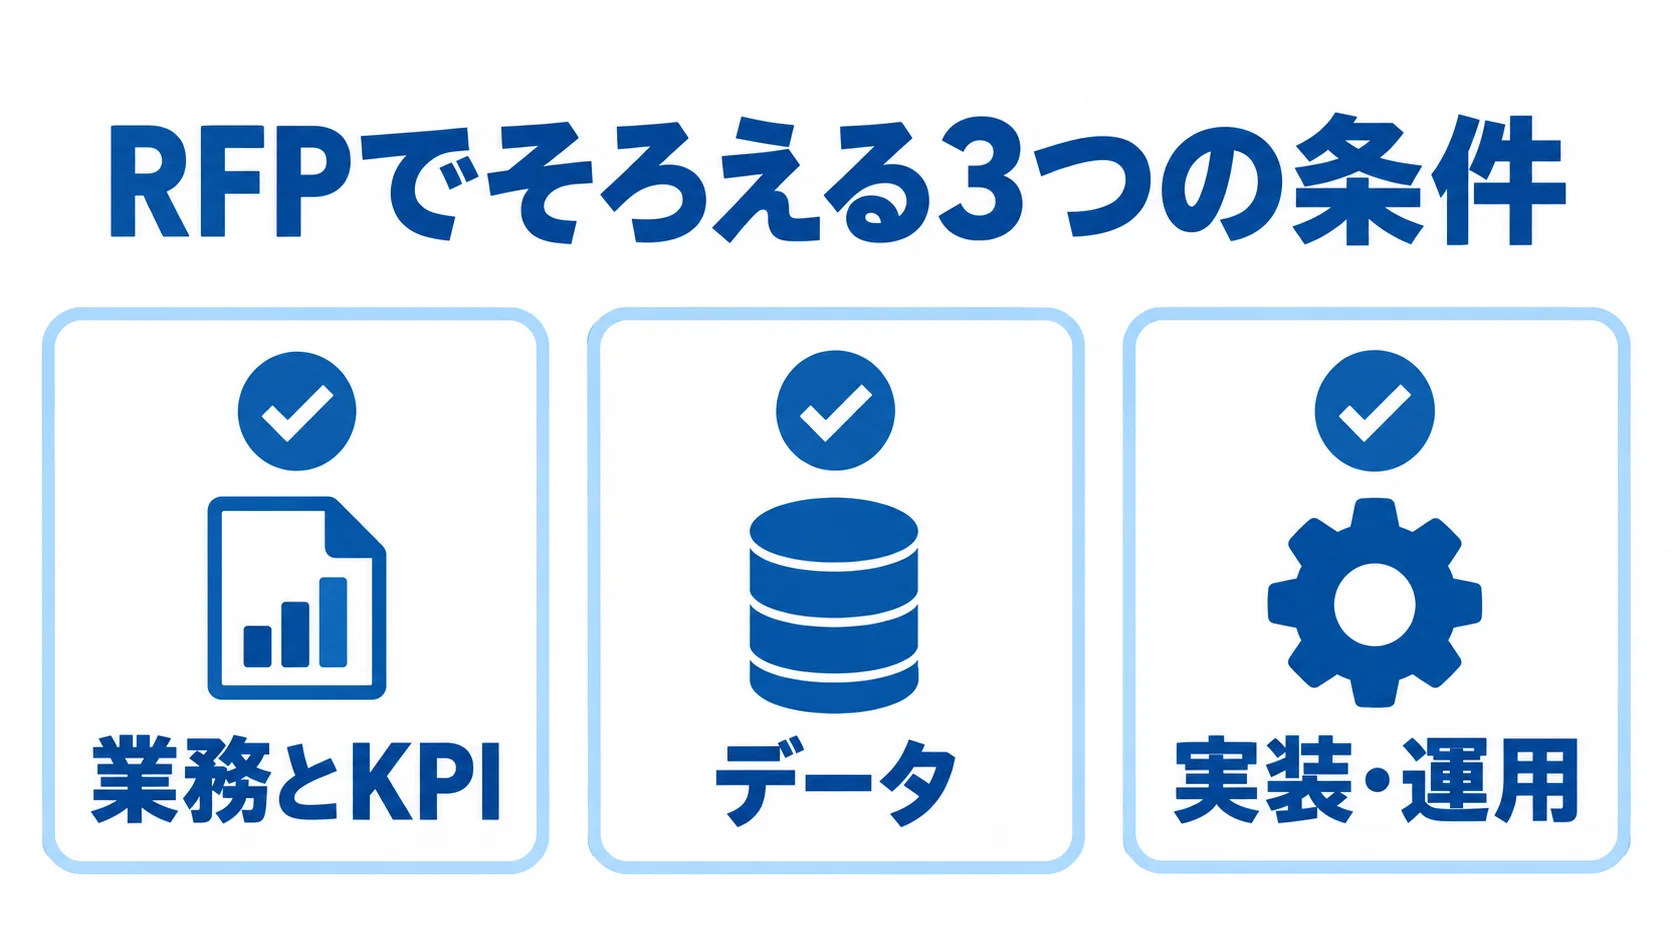
RFPは、候補会社が共通の前提で提案と見積を出せるようにするための文書です。技術名よりも先に、対象業務やデータなどの条件を具体的に書きます。
- 業務とKPI:対象業務、改善目標、利用者、受入基準を示します。
- データ:量、品質、権利、更新頻度、保存場所の記載。
- 実装・運用:連携先、制約、納期、予算、成果物の具体化。
業務課題とKPIの先行定義
予測・判定の対象より先に、「業務の何を改善するか」を書きます。KPIの例は、確認時間の短縮、見逃し率の抑制、欠品による販売機会損失の削減です。
- 業務KPI:改善対象と、誤検知時の再確認時間や推論時間の許容値を決めます。
- モデル受入:データセットごとの適合率、再現率、F1値などを確認します。
- システム受入:同時実行数、API応答時間、障害時の再送、操作ログ、権限管理。
学習用のデータと本番の条件が違う場合は、実運用に近い検証データを指定しておきます。
データの量・品質・権利の棚卸し
RFPには、データの種類、件数、期間を書きます。さらに、容量、更新頻度、保存場所も記載します。形式や欠損、重複、ラベルの有無も、あわせて書きます。
- 形式と品質:画像は解像度・撮影条件、テキストは言語・表記ゆれを確認します。
- センサーとラベル:サンプリング間隔・欠測時間を確認し、ラベル作成者と基準承認者を決めます。
- データ保護:学習利用、匿名化、保存期間、権限、再委託、国外移転を整理します。
- 権利と再利用:別案件への再利用、元データ削除、アノテーション・特徴量・評価結果の扱いを定めます。
ラベル付けの方法は、費用と納期を左右します。個人情報や機密情報、第三者の著作物が含まれる場合は、契約条件と削除方法も確認しておきます。また、データの所有権も、契約時に決めておきます。
成果物と運用範囲の一覧
成果物には、要件定義書、データ仕様書、前処理・学習コードを含めます。さらに、評価レポート、モデルファイル、API・画面仕様書も一覧に入れます。
- 構成・検証:インフラ構成図、監視設計、テスト結果を受け取ります。
- 運用・引継ぎ:運用手順書と引継ぎ資料を受け取り、精度劣化やドリフトの検知者を定めます。
- 再現性:TensorFlow、Python、CUDAの版、依存関係、コンテナ、モデル版管理を固定します。
- 障害・費用対応:再学習の承認と反映、ロールバック、手作業への切替、費用超過の通知を決めます。
TensorFlowのシステム開発を外注する進め方
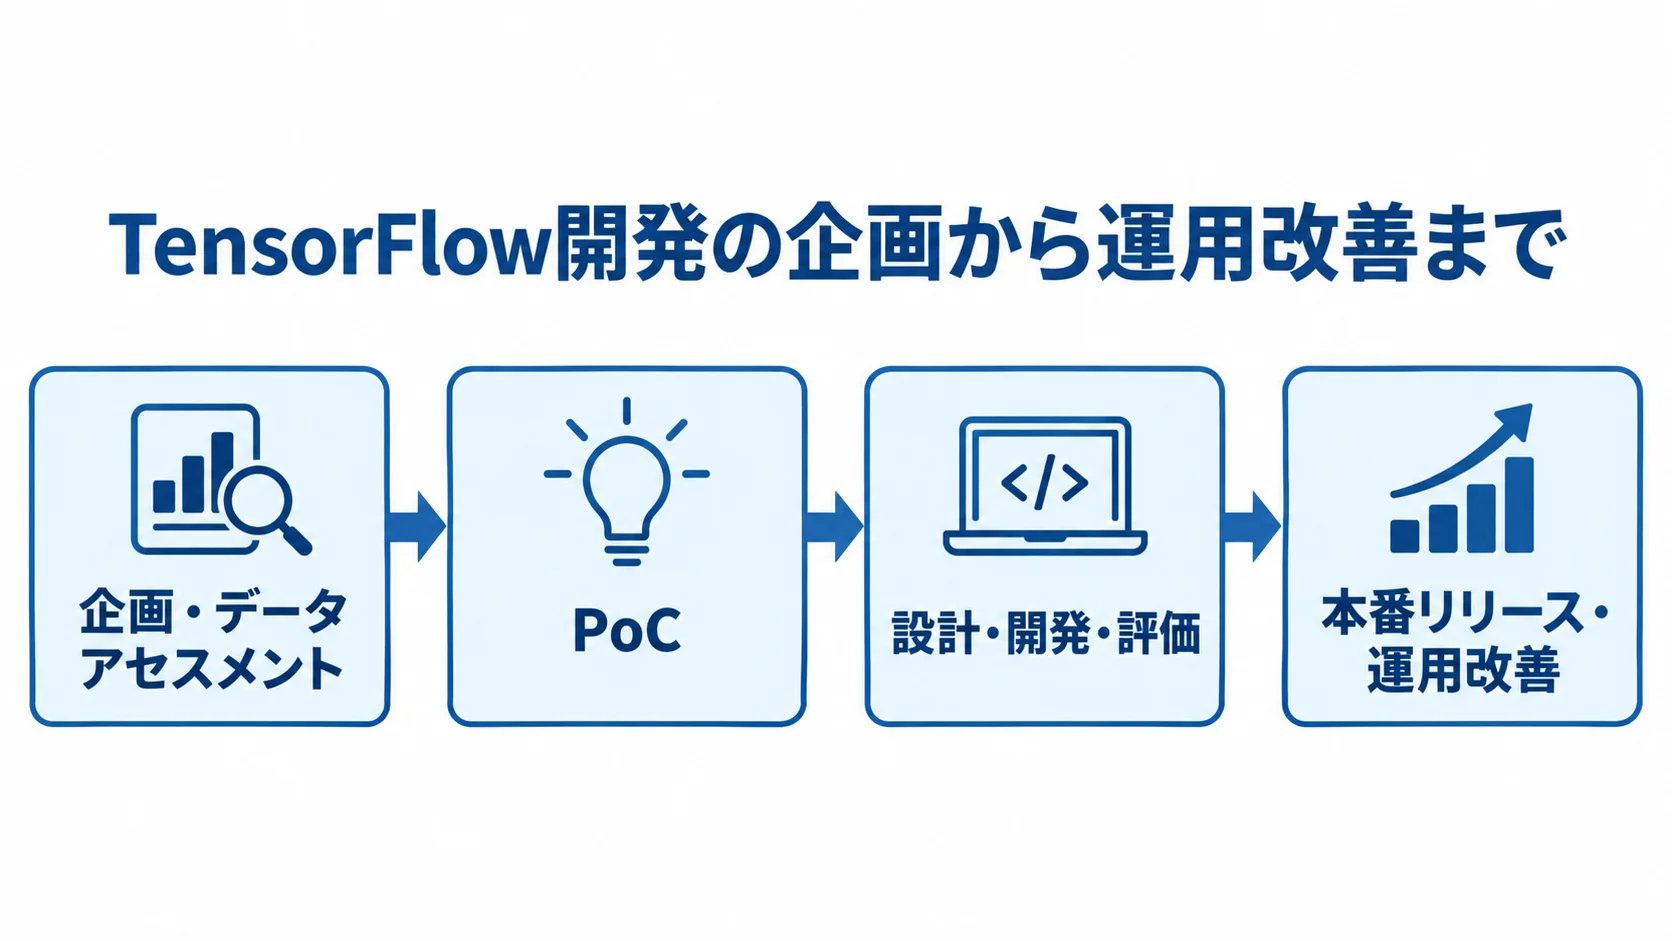
まず、企画、データアセスメント、PoCを順に進めます。続いて、設計・開発、評価、本番リリース、運用改善へ移ります。この順番にすると、技術検証と業務導入を切り分けやすくなります。
モデル学習が成功しても、業務画面やデータ連携が不十分であれば、本番では使えません。そのため、各工程の出口条件を明確にしておきます。
要件定義とデータアセスメント
業務担当者と開発会社は、対象業務を観察しながら、現行の判断基準や例外処理を整理します。あわせて、入力データと既存システムとの連携方法も押さえます。
- 学習に使えるデータを確かめ、不足やラベル基準の不一致は計画に反映します。
- 簡易モデルや既存モデルでPoCを行い、業務KPIへの効果を検証します。
- 誤検知しやすいケース、見逃せないケース、現場が訂正したケースに分けた評価。
- 最終報告にまとめる内容は、追加データ、推奨モデル方式、想定インフラ、費用、リスクです。
本番基盤と業務システムの実装
本番開発では、データ収集から結果の保存までを、再現可能なパイプラインとして組みます。工程は、前処理、学習、評価の順に進み、そのあとモデルの登録・承認、配備、推論へ続きます。
- 本番パイプライン:TFXは、データ検証や評価を組み合わせられる基盤です。
- 業務アプリ:推論APIの認証やタイムアウト、再送、入力検証を実装し、権限表示、結果訂正、監査ログも加えます。
- 受入体制:モデル、業務アプリ、インフラの担当者が、共通の基準を確認します。
TensorFlow公式のTFXは、研究段階のモデルを本番のMLパイプラインへ移すための基盤です(出典:TensorFlow公式「TFX | ML Production Pipelines」、2026年確認)。
たとえば、画像検査では画像と判定を紐付け、需要予測では予測値と実績を比較します。不正検知では、アラート後の調査記録まで設計します。
テスト・リリース・再学習と運用の接続
テストでは、通常データに加えて、欠損、異常値、想定外の形式を確認します。さらに、データ量の急増や旧モデルとの比較も確かめます。
- ピーク時の同時推論数や、API応答時間、GPU・CPU使用率、障害時の復旧時間を測ります。
- リリース後は、データ分布や予測の偏り、判明後の実績を監視します。加えて、推論時間、エラー率、クラウド費用も見ます。
- 再学習の頻度と承認者、テスト環境、本番反映、ロールバックを保守契約に含めます。
精度が上がっても、応答時間やコストが許容範囲を超えれば、要件は満たせません。モデルは環境やデータの変化によって性能が変わるため、一度納品すれば終わりというものではありません。
TensorFlowの外注で選ぶ契約形態
成果物と仕様を固定しやすい工程には請負、要件の変化が大きい研究や改善の工程には準委任が向いています。
要件整理やPoCは準委任、本番の特定機能は請負、リリース後は保守契約とする方法もあります。その際は、契約名だけでなく、納品、検収、責任、変更手続を確認します。
PoCと要件定義の準委任
PoCは、データ品質やモデル方式で結果が変わり、開始時に完成形を確定できない場合があります。そのため、専門家の稼働と検証を委託する準委任が使いやすいです。
- 成果物:実施項目、定例報告、評価レポート、コード、データ仕様、次工程の判断材料を契約に明記します。
- 見積:担当者の役割、工数、単価、期間、作業場所、追加作業の承認方法を確認します。
- 精度保証:データ条件と評価方法を合意したうえで、委託先だけに責任を負わせないようにします。
- 発注者側の前提:データ提供や現場ヒアリングが遅れた場合の納期変更を、あらかじめ定めます。
本番機能の請負と変更管理
仕様と受入基準を定義できる機能は、請負にしやすいです。API、画面、認証、バッチ、監視などが、その例です。
- 契約条件:完成物、検収基準、瑕疵対応、納期、追加費用を明確にします。
- 精度基準:測定に使うデータセットと、許容範囲を定めます。
- 変更管理:追加データ、ラベル付け、モデル再作成、クラウド構成変更を、無償と有償に分けます。
- 承認記録:影響範囲、納期、費用、テスト範囲を確認して、変更を承認します。
開発中は新しいデータや例外ケースが見つかるため、変更管理が欠かせません。仕様変更は、メールだけで済ませず、承認記録を残します。
知的財産とセキュリティの責任分界
学習・前処理コード、モデル、評価用データ、アノテーションの帰属と利用範囲を定めます。設定ファイル、Dockerfile、IaC、ログ、文書も、帰属と利用範囲を定める対象です。
- 利用条件:OSSのライセンス表示、学習済みモデル、外部データセット、第三者サービスの規約を確認します。
- 再現・移行:内製化や移行に備え、実行環境を再現できる成果物を受け取ります。
- モデル保護:モデルの持ち込み条件と取り扱い方法の確認。
- 運用責任:認証、ネットワーク分離、監査ログ、脆弱性対応、事故対応の担当者を決めます。
TensorFlow公式の指針では、マルチテナント分離、ネットワーク制御、レート制限、監視は利用者側の設計責任とされています(出典:TensorFlow公式GitHub「Using TensorFlow Securely」、2026年確認)。
同じ指針では、モデル、グラフ、チェックポイントがプログラムとして実行されることがあります。そのため、信頼できないものはサンドボックスなどで分離します(出典:TensorFlow公式GitHub「Using TensorFlow Securely」、2026年確認)。
TensorFlowのシステム開発費用・相場の目安
TensorFlowはオープンソースなので、ライセンス料が主な費用ではありません。費用の中心は、人件費、データ整備、ラベル付けです。GPU・TPU、推論基盤、既存システム連携、監視、保守も、費用の中心に含まれます。
ここで示す金額は、全国で統一された価格ではありません。一般的な業務システムの相場に、TensorFlow特有の工程を加味した、2026年時点の編集用の推定レンジです。
規模別の初期費用と期間の目安
費用と期間は規模によって異なります。次の推定は、人月単価おおむね80万〜120万円程度の一般相場と、工程別の工数、データ整備やML運用の追加作業から算出しています。
- PoC・小規模検証:300万〜800万円程度、期間は2〜4か月です。
- 小規模本番:1業務・1〜2モデルで800万〜2,000万円程度、期間は4〜8か月です。
- 中規模:2,000万〜5,000万円程度、期間は8〜15か月です。
- 大規模・全社展開:5,000万〜1億5,000万円以上、期間は12〜24か月以上です。
大量の画像・音声ラベル付けや、複数拠点の連携、厳格なSLA、オンプレミスGPUの調達がある案件では、上限を超える可能性があります。正確な金額は、RFPとデータサンプルを提示して、複数社から取得します。
データ・モデル・アプリ・運用別の見積内訳
見積は、工程ごとの比率に分けると比較しやすくなります。ここで示す比率は、案件の前提から作った推定で、全国統計ではありません。
- 要件定義・業務整理:10〜15%程度です。
- データ収集・整備・ラベル付け:15〜30%程度です。
- モデル設計・学習・評価:20〜30%程度です。
- アプリ・API・基盤実装:20〜30%程度です。
- テスト・セキュリティ・リリース:10〜20%程度です。
見積では、ラベル付けの件数と単価、学習の試行回数、GPU・TPUの利用時間を確認します。さらに、推論エンドポイントの常時稼働やストレージ、ログ保管を見ます。監視と再学習の費用も、あわせて押さえます。
Google Cloudの機械学習関連サービスは、計算資源、ストレージ、パイプライン実行などの利用量に応じて費用が変わります。無料クレジットやPoC割引は本番予算に含めず、通常料金で上限見積を作ります。
再学習とクラウド従量課金を含む運用費
運用費は、一般的な業務システムの初期開発費に対して年15〜25%程度を基準に試算します。そのうえで、再学習、データ品質監視、ドリフト検知、推論エンドポイント、脆弱性対応も加えます。
- 小規模本番:月30万〜150万円程度を仮置きする場合があります。
- 中規模:月100万〜500万円程度を仮置きする場合があります。
- 費用の性質:人月、工程比率、クラウド従量課金による推定で、専用の公開相場ではありません。
- 試算条件:通常月、繁忙期、障害時、再学習時の4パターンを見積もります。
学習時だけGPUを起動する設計や、推論負荷に合わせて台数を変える設計、保管期間後に古いモデルやログを削除する設計も比較します。
監視や再学習を除いて運用費を低く見せていないか、見積の前提を確認します。
TensorFlowの委託先選定と見積比較のポイント
委託先は、TensorFlowの経験に加えて、データ基盤、API・画面、認証に対応できるかで選びます。クラウド、MLOps、セキュリティ、運用移管への対応も、あわせて見ます。
モデル開発の実績があっても、本番運用の経験がなければ、障害対応や権限設計が別発注になる可能性があります。
類似案件の実績と構成・運用の確認
実績を確認する際は、業務課題、データ量、推論負荷、本番構成を質問します。そのうえで、自社に近い画像、需要予測、文書分類、IoT異常検知の事例があるかを確かめます。
- 構成・運用:匿名化した構成図、運用体制、障害対応、モデル更新方法を確認します。
- データ規模:Taranis事例は飛行1回で約10,000枚、1枚10〜20MB、総量約30TBです。
- 処理基盤:TensorFlow、GPU、Kubernetes、Cloud SQL、Pub/Subを組み合わせています。
- 拡張と確認軸:繁忙期はV100 GPUを1,000台から4,000台へ自動的に拡張します。あわせて、搬送、保存、配信、費用を確認します。
出典は、Google Cloud「Taranis Case Study」(2026年確認)です。事例を見るときは、モデル名だけでなく、処理規模、データ搬送、保存、配信、費用抑制も確かめます。
同じ条件と内訳での見積比較
相見積もりでは、同じRFPとデータサンプルを渡します。あわせて、想定ユーザー数、推論件数、納期も、各社に同じ条件で伝えます。
- 費用内訳:要件、データ整備、ラベル付け、モデル、API・画面、インフラ、セキュリティ、テスト、リリース、保守を比較します。
- 受入・保守:精度基準、性能SLA、再学習の回数と費用、保守受付時間を確認します。
- 権利・移行:モデル・コードの引渡し、データ再利用、クラウド名義、再委託先、終了時の移行支援を確認します。
安い見積では、除外項目を確認します。ただし、初期費用が低くても、モデル更新が都度見積もりなら、3年間の総保有コストが高くなる可能性があります。
提案説明での担当者と実装計画の確認
提案説明には、営業だけでなく、責任者や機械学習、データ基盤、アプリ、運用の各担当者にも参加してもらいます。
- 対応力:データ不足時の代替案、精度不足時の撤退条件、納期を守る優先順位を確認します。
- 初動計画:最初の4週間の作業、発注者の提供情報、判断会議、成果物レビューを確認します。
- AIガバナンス:透明性、説明責任、安全性、リスク管理を業務に反映する提案力を見ます。
参考資料は、経済産業省「AI事業者ガイドライン第1.2版」(2026年3月31日公表)です(出典:経済産業省「AI事業者ガイドライン検討会」、2026年)。
TensorFlowのシステム発注でよくある質問
TensorFlowの発注では、データ、業務KPI、運用、契約の確認が結果を左右します。よくある質問を取り上げます。
TensorFlowのシステム開発は数百万円でできますか?
データと1業務に限定したPoCであれば、300万〜800万円程度が推定レンジの一つです。ただし、本番画面、既存連携、監視、再学習、セキュリティまで含めると、800万〜2,000万円程度以上になる可能性があります。
ここで示す金額は、工程と人月から作った案件の推定で、公開されたTensorFlowの料金ではありません。
TensorFlowの開発はPoCから始めるべきですか?
学習データの品質や正解ラベル、業務KPI、導入後の運用が固まっていない場合は、PoCから始める方法があります。
PoCでは、精度だけでなく、誤検知時の業務フロー、推論時間、費用、追加データの必要性を確かめます。そのうえで、本番化の条件を合意します。データと要件が整っていれば、PoCと本番設計を一体化する方法もあります。
TensorFlowとPyTorchのどちらで開発すべきですか?
社内の技術や担当者の経験、利用したいモデルやライブラリを比べて決めます。推論遅延、データ保存場所、将来の内製化も、判断材料になります。
TensorFlow自体を目的とせず、既製のAI APIやクラウドのマネージドサービスで足りるかも確認します。
RFPではTensorFlowを必須にせず、業務KPIと運用条件を満たす方式を提案してもらうと、選択肢を残せます。
開発会社に保守と再学習も任せられますか?
委託はできますが、開発契約とは別に、保守の対象と費用を明確にします。
再学習、データドリフト確認、推論API監視、脆弱性対応を項目別に契約します。加えて、クラウド費用監視、障害復旧、モデルのロールバックも契約に含めます。
再学習が必要になる条件や、発注者が提供するデータと承認の扱いを決めておくと、運用開始後の責任分界が明確になります。
まとめ
TensorFlowの機能やモデル精度だけで発注先を決めず、データの量や品質、既存連携、業務KPIを要件にまとめます。推論性能、監視、再学習、セキュリティ、成果物の引渡しも、要件に含めます。
発注前のRFPと比較軸の統一
まず、AIで改善する業務とKPIを定め、データを棚卸しします。次に、PoC、部分委託、一括委託、クラウド活用、内製支援の中から、体制に合う方法を選びます。
見積は、初期費用だけでなく、ラベル付け、GPU・TPU、推論基盤、保守、再学習に分けて見ます。同じRFPを使って、複数社を比較します。
本番運用と将来の移行を見据えた委託先の選び方
委託先には、TensorFlowの経験だけでなく、データ基盤、業務アプリ、MLOpsの実績があるかを確認します。セキュリティ、保守、内製化支援の実績も、あわせて確かめます。
モデル、学習コード、評価データ、構成情報、運用手順を引き渡す条件と、精度劣化や障害時の責任を、契約に定めます。現場の判断を改善し続ける仕組みを発注することが、成功の鍵になります。
▼全体ガイドの記事
・TensorFlowのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。