
TensorFlowのシステムは、業務課題とデータの確認、PoC、技術構成の選定、本番運用の順に段階的に進めることで、業務判断の改善につながります。
全体像、自社への適性、開発工程、技術構成、費用と発注時の確認項目の順に説明します。各テーマの詳細は、関連記事もあわせてご覧ください。
▼関連記事一覧
・TensorFlowのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・TensorFlowのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・TensorFlowのシステム開発の見積相場や費用/コスト/値段について
・TensorFlowのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
TensorFlowのシステムの全体像
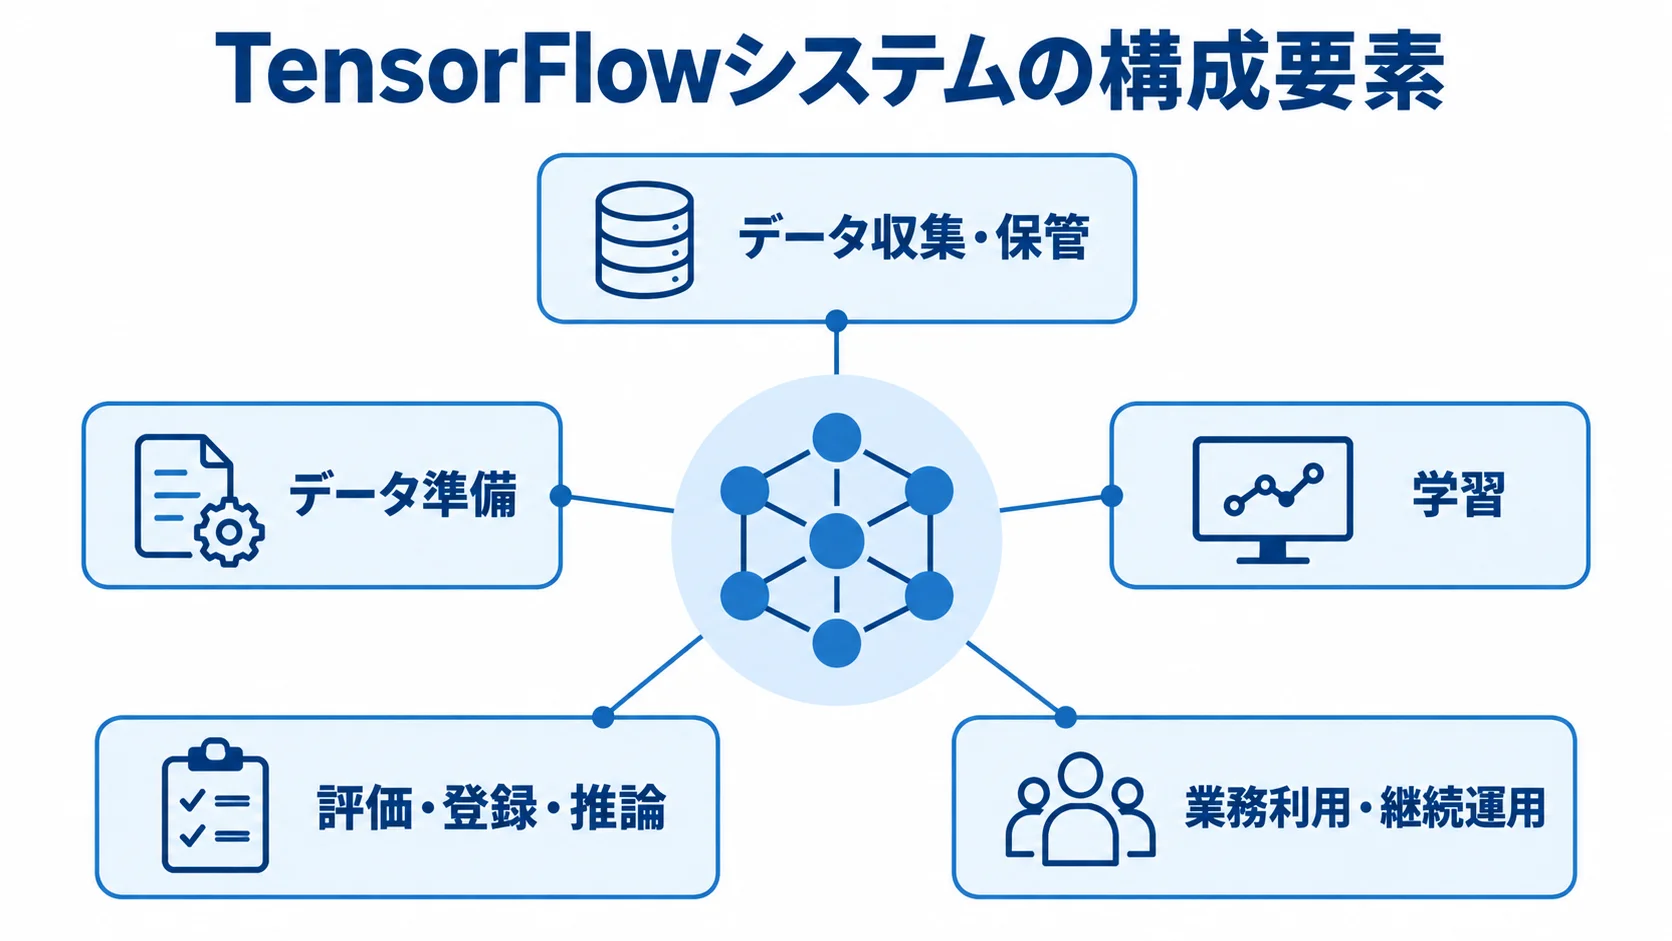
TensorFlowは、画像・数値・文章・音声などから機械学習モデルを作り、予測や分類を行うフレームワークです。TensorFlowだけで販売管理や生産管理は完成しないため、導入は既存の業務システムにAIの判断機能を組み込む開発として考えます。
TensorFlowの役割:AIモデルの作成と業務の判断への接続
まず、業務データを集めて欠損や重複を確かめ、必要に応じて正解ラベルを付けます。そのデータでTensorFlowやKerasのモデルを学習し、評価を通過したモデルを推論サービスへ配備します。
予測結果は、画面やバッチ処理を通じて在庫数や点検対象の更新に使います。さらに、このシステムはAI精度と業務の安全性を両立させます。
導入の可否は、正解率に加えて業務への影響を見て決めます。異常検知では、見逃しを減らすほど誤検知が増える場合があります。そのため、担当者の確認時間や、誤った自動処理を取り消す手順も設計します。
代表的な構成の5つの層
本番システムでは、データから運用までの役割を層ごとに整理します。次の5つのまとまりで見ると、担当範囲と不足を確認できます。
- データ収集・保管:基幹システムや現場からのデータ連携と、データレイクなどへの保存
- データ準備:学習に使える形へ、ラベル付けや欠損の処理を行う
- 学習:TensorFlowでモデルを作成する
- 評価・登録・推論:承認を受けたモデルを登録し、APIやバッチで動かす
- 業務利用・継続運用:画面や通知で業務に届けたうえで、監視・ログ・再学習(MLOps)を続ける
小規模なPoCでは一部の層を簡略化できます。ただし本番では、各層の運用担当を決めておく必要があります。最初に層を分けておくと、モデル開発と業務アプリ開発の抜け漏れに気づきやすくなります。
TFXには、データ検証や変換、学習、評価、モデル検証、配備などをパイプライン化する部品があります。公式資料では、学習から配備までの自動化やデータ異常の監視が説明されています(出典:TensorFlow TFX公式ドキュメント、2026年8月確認)。
画像・予測・異常検知など幅広い業務への活用
画像、販売、設備のデータを使う業務では、確認作業や予測、点検の判断を支援できます。
- 画像検査:傷や形状の違いで分類し、人が確認する対象を絞り込む
- 需要予測:販売履歴、季節、曜日、販促情報から需要を予測する
- 設備監視:温度・振動・電流の変化から、異常の兆候を検知する
- その他の候補:文書分類、問い合わせ内容の振り分け、不正利用の兆候の検出、音声の文字起こし補助、レコメンド
ただし、判断ルールが明確でデータが少ない業務では、通常の条件分岐や検索機能のほうが安価で説明しやすい場合があります。すべての業務をAI化する必要はありません。
TensorFlowのシステムが自社に向いているかの判断方法
TensorFlowを使うかは、技術の人気ではなく、業務課題とデータの条件から判断します。改善するKPIを一つか二つに絞り、現在の方法と比べるベースラインを作ります。
導入の判断では、データの量と品質に加えて、現場で予測結果を使う場面と、継続して運用できる体制も確認します。
学習データと正解ラベルの準備状況
画像分類では、画像の種類や枚数に加えて、明るさ、角度、撮影機器、季節差、異常の出現頻度を確認します。需要予測では、欠品期間、価格変更、キャンペーン、休日の情報も必要です。
ラベルが担当者の経験に頼っている場合は、判定基準を文章にまとめ、複数人の一致率を確かめます。データが少ないときは、転移学習や既存モデルの再利用で始められる可能性があります。
ただし、少量データで高精度が出ても、現場条件では性能が落ちることがあります。このため、学習用と評価用は単純なランダム分割にせず、拠点・期間・設備単位で分け、将来のデータに近い形で評価します。
AI導入後のKPIと許容できる誤差
受入条件には、「精度を高くする」より具体的な目標を置きます。たとえば検査業務なら、見逃し率を何%以下にするか、担当者が処理できる誤検知を一日何件までにするかを決めます。
需要予測では、平均絶対誤差に加えて、欠品率、廃棄率、在庫金額、発注作業時間をKPIに含めます。推論の応答時間と稼働率も定めます。
ネットワークが不安定な場所では、端末側で推論する方式や、通信できない場合の手動処理を用意します。また、画面表示に数秒かかる場合も、現場で使われない可能性があります。そのため、許容レイテンシを決めます。
TensorFlowを選ばないほうがよいケース
独自モデルを作る前に、適用条件と代替手段を次のとおり確かめます。
- データ・業務が未整備:学習データや正解がない場合や、AIを使う業務フローがない場合は、業務整理とデータ収集を先に行う
- 既製機能で足りる:AI APIやSaaSで目的を満たせるなら、独自モデルより短期間・低コストで済みやすい
- 運用体制が未定:更新担当や障害窓口が決まらないままだと、本番化後に止まるおそれがあります
判断では、PoCの予算に加えて、再学習、監視、脆弱性対応、モデル差し替えを含む3年程度の運用負担を見積もります。導入しない選択肢とも、運用負担を比べて判断します。
TensorFlowのシステム開発の3段階の進め方
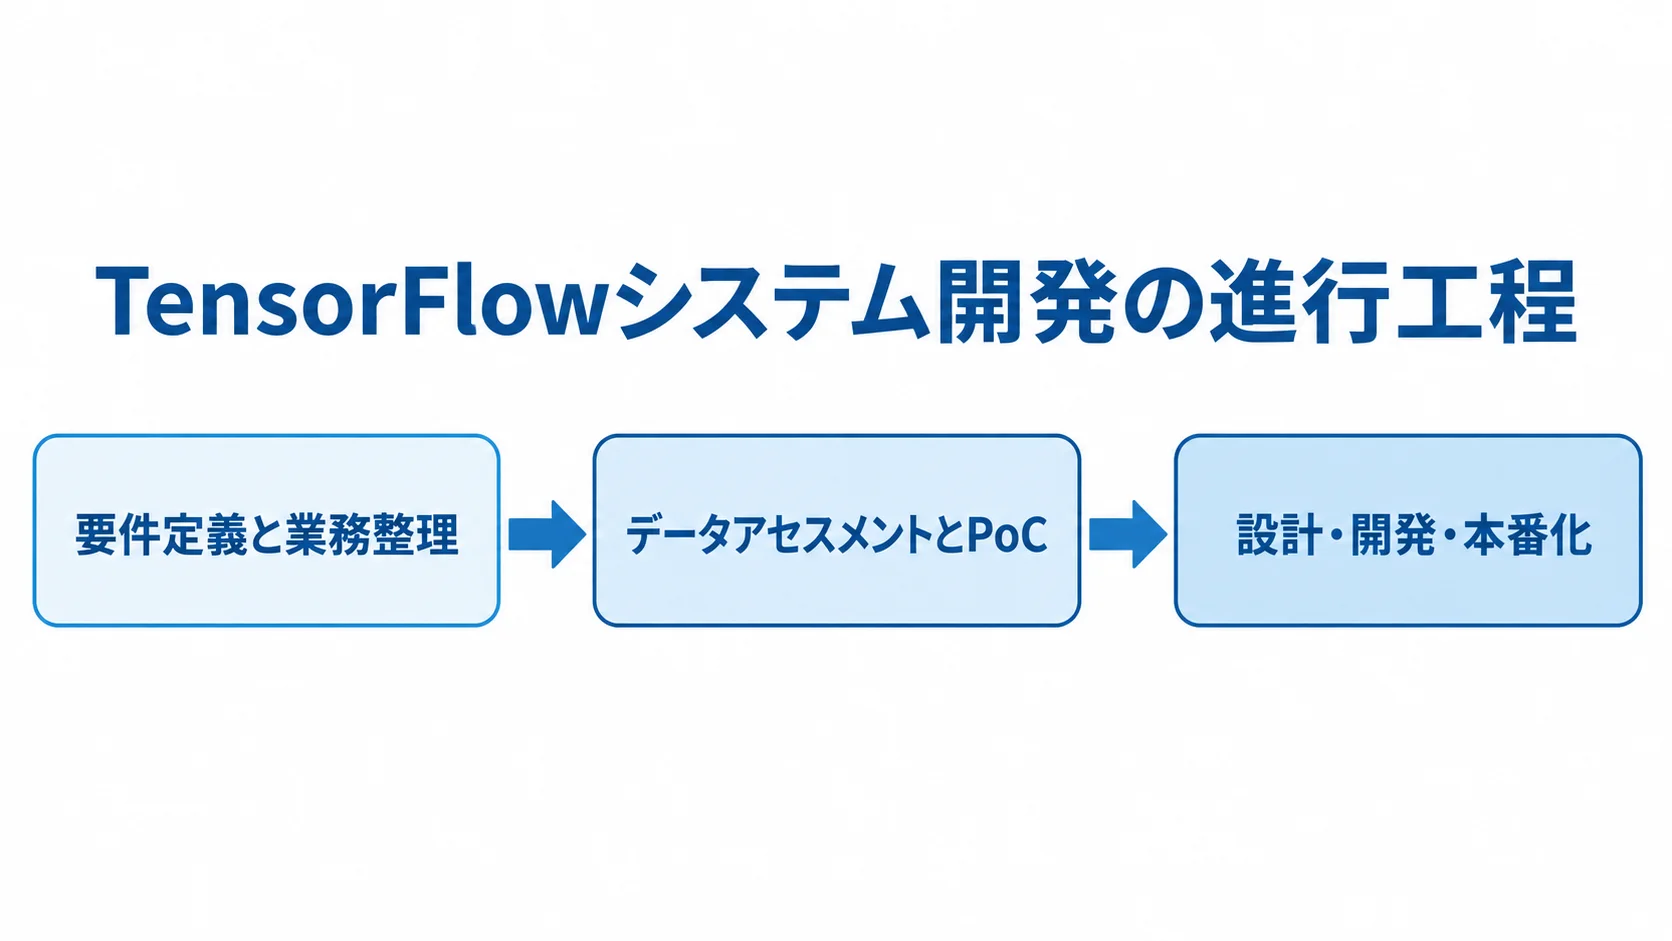
モデル学習から始めると、TensorFlowのシステム開発は失敗しやすくなります。まず業務課題とデータを確認し、PoCで仮説を検証してから、画面や運用を含めて本番化します。
各段階で成果物と中止条件を決めると、精度が伸びない場合の損失を抑えられます。主な工程は次の順です。
- 要件定義と業務整理
- データアセスメントとPoC
- 設計・開発・本番化
▶ 詳細はこちら:TensorFlowのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
1. 要件定義と業務整理
要件定義では、まず誰が、いつ、どの判断にシステムを使うのかを明確にします。そのうえで、システムに入るデータから結果の行き先までを整理します。
- 入力と出力:判断に使うデータと、返す結果
- 判断後の行動:判断結果を受けて、誰が何をするか
- 連携先:データを受け取り、結果を渡す既存システム
- 権限と監査ログ:誰が何を操作できるか、どこまで記録するか
- 利用条件:利用拠点、想定件数、応答時間
AIの提案を人が承認するか、条件を満たせば自動で実行するかで、画面の作りと、どこまでを誰が受け持つかが変わります。また、成果物には、業務フローとデータ項目表、KPIと非機能要件、概算日程、PoCの評価方法が含まれます。
目標は、たとえば「検査担当者の確認時間を30%削減する」「見逃し率を現行以下にする」のように、業務側が確認できる表現にします。
2. データアセスメントとPoC
データアセスメントでは、実データの量と欠損、偏りを調べます。あわせて、次の点も確認します。
- ラベルの品質:正解データとして使えるか
- 個人情報:含まれる範囲と扱い方
- 保存場所:データがどこに置かれているか
- 更新頻度:データがどのくらいの頻度で変わるか
見るべきは、データが目的の判断に使える状態かどうかです。画像では、異常画像が十分にあるかを見ます。需要予測では、欠品による見かけ上の低需要を区別できるかを確かめます。
PoCでは、精度に加えて、ベースラインとの差を測ります。誤検知と見逃し、推論時間も測ります。さらに、1件あたりの計算費、現場担当者の確認時間、データ更新時の再現性も見ます。
期間は2〜4か月程度が目安ですが、データ整備量や検証拠点数によって変わります。
3. 設計・開発・本番化
PoCの後は、システムの実装、段階的なリリース、モデル更新の管理の順で本番化します。
- PoCの結果を踏まえて、本番システムを実装します。
- リリース時は、いきなり自動処理にせず、予測値や候補を担当者が確認します。問題がなければ、拠点や処理量を段階的に増やします。
- モデルを更新するときに備えて、カナリアリリースやロールバックを使える状態にしておきます。
実装する要素には、データ連携、学習パイプライン、モデル登録、推論APIがあります。加えて、業務画面、認証、権限、ログ、監視も必要です。
さらに、モデルの版と入力スキーマ、評価結果を追跡します。承認者と配備日時も残します。
TensorFlowのシステムで選べる技術構成の比較
構成は、初期費用だけでなく推論遅延とデータの所在で選びます。加えて、運用人材、モデル交換、障害時の復旧の3点も見ます。また、モデルを実行場所(サーバー、クラウド、モバイル、エッジ端末)によって、設計が変わります。
サーバー推論でのTensorFlow ServingとAPIの組み合わせ
社内システムやWebサービスから共通モデルを呼ぶ場合は、SavedModelを推論サーバーへ配備します。その前段には、認証・認可や入力チェックを置きます。レート制限とログも併せて設けます。
TensorFlow ServingはSavedModelをRESTまたはgRPCで提供でき、モデルのバージョン管理や配備に使えます(出典:TensorFlow TFX公式ユーザーガイド、2026年8月確認)。
リアルタイム処理では、同時実行数とピーク時の応答時間を測ります。加えて、タイムアウトと再試行、モデルのウォームアップも確認します。一方で、夜間の大量処理では、バッチ推論により常時起動する計算資源を減らせる場合があります。
モバイル・IoT・エッジでのTensorFlow Lite系の検討
端末側で推論する場合は、実行環境とランタイム、性能と運用を合わせて確認します。
- 対象端末:カメラ、検査端末、スマートフォン、工場設備など
- モデル最適化:量子化や枝刈りによって、通信量・遅延・消費電力を抑えられる可能性があります
- 運用と検証:端末差や更新配布、紛失時のデータ保護、オフライン同期、版管理を確かめる
公式案内では、モバイル・組み込み向けにLiteRTという名称が表示される場合もあります。そのため、採用時にはサポート状況を確認します。特に、精度に加えて代表端末の処理時間と電池消費も実測して判断します。
マネージドML・コンテナ・オンプレミスの使い分け
運用場所は、管理を任せる範囲と、データや設備の制約で比べます。
- マネージドML:学習ジョブ、モデル登録、推論、パイプライン、監視を短期間で組み合わせやすい
- コンテナ:TensorFlow Servingを動かし、移植性を確保する
- オンプレミス:データを社外へ出しにくい場合や、低遅延の接続が必要な場合に向く
マネージドMLでは、料金と、TensorFlowの対応版を確認します。さらに、保管場所と終了時の移行方法も確かめます。コンテナでは、クラスタとGPUのほか、ログと脆弱性パッチを、自社または委託先が管理します。
オンプレミスでは、GPUの調達と故障時の交換が必要です。容量計画、電力、冷却、保守も欠かせません。学習はクラウド、推論は社内やエッジに分ける構成もあり、機密度と負荷の変動で選びます。
TensorFlowのシステムの費用相場と内訳
TensorFlow本体はオープンソースなので、見積もりの中心はライセンス料ではありません。費用は、データ整備、モデル開発、既存連携が中心です。推論基盤、計算資源(GPU・TPUなど)、監視と保守も主な内訳になります。
以下の金額は、TensorFlow専用の公定価格ではありません。一般的な業務システムの相場に、機械学習の工程を加味した2026年時点の推定です。
▶ 詳細はこちら:TensorFlowのシステム開発の見積相場や費用/コスト/値段について
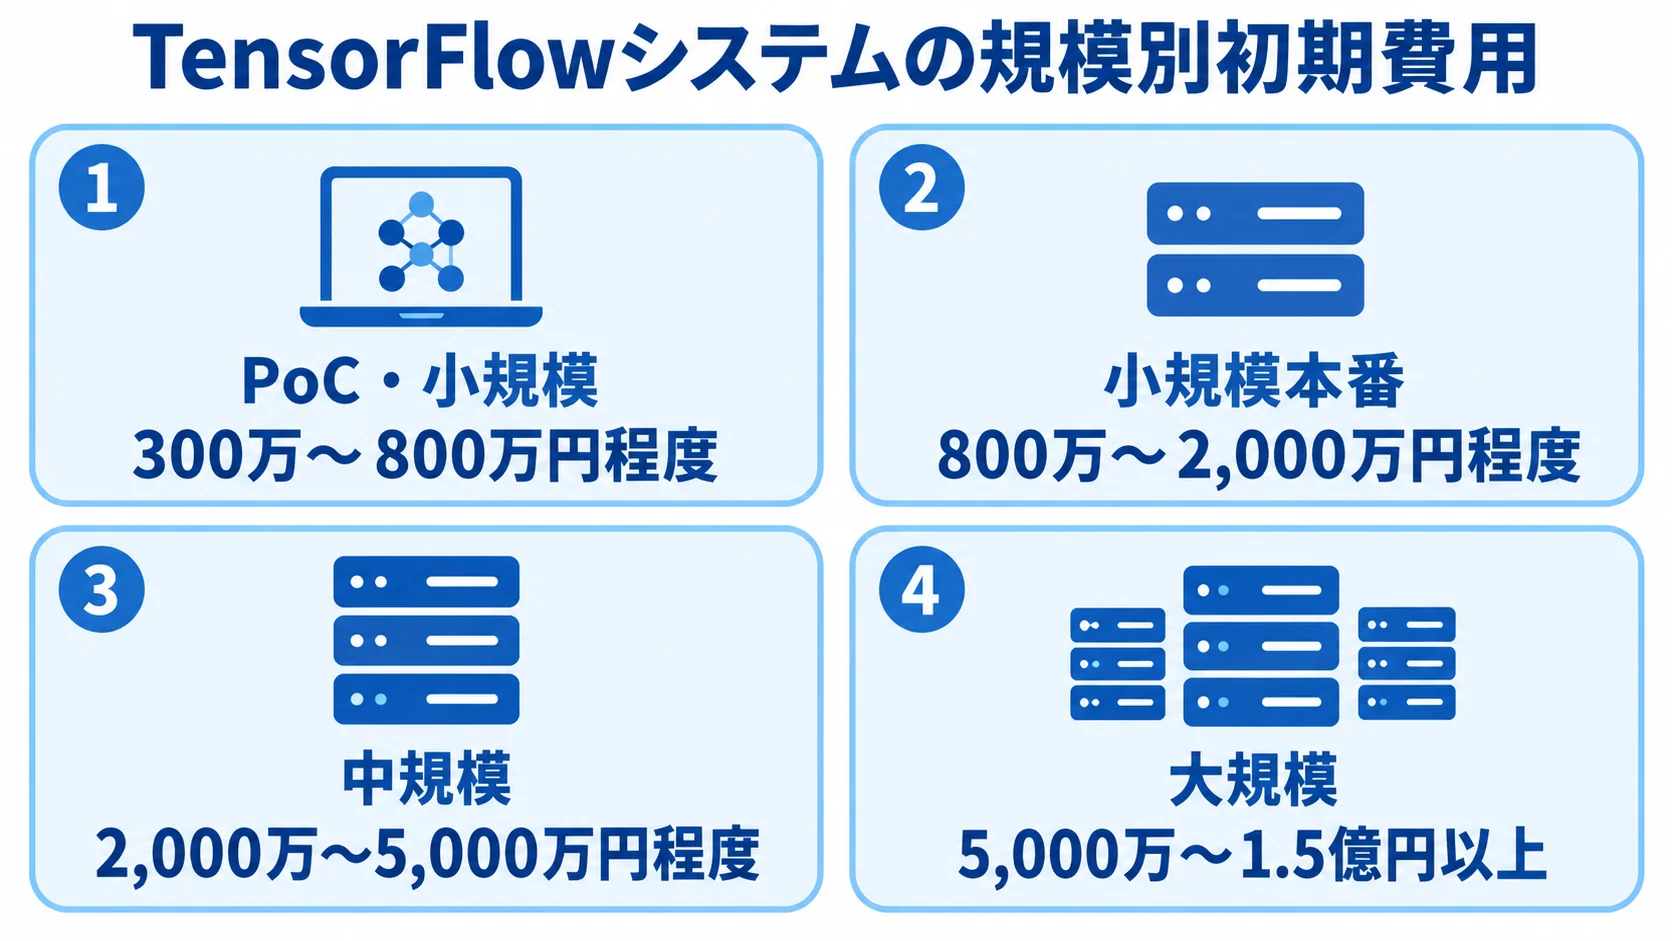
規模別の初期費用:300万円から1億円超まで
TensorFlow開発の予算は、案件の規模によって幅があります。各規模の費用目安を見ておきましょう。
- PoC・小規模:300万〜800万円程度
- 小規模本番:800万〜2,000万円程度
- 中規模:2,000万〜5,000万円程度
- 大規模:5,000万〜1.5億円以上
PoC・小規模は1業務・1モデル・限定データの評価や簡易APIが対象です。小規模本番は、データ連携、Web画面、認証、最小限の監視を含みます。
中規模は、複数拠点・複数モデル、基幹連携、再学習パイプラインを含みます。一方で、大規模は全社展開や高負荷の推論が対象で、厳格なSLA、複数部門のデータ基盤、内製移管も含みます。
期間の想定は、PoCが2〜4か月、小規模本番が4〜8か月、中規模が8〜15か月、大規模が12〜24か月以上です。金額と期間は、データ準備や連携先数、要求精度によって変わります。さらに、拠点数やセキュリティ要件も左右します。
人月単価を80万〜120万円程度と仮置きすると、データサイエンティストや機械学習エンジニアの人数と期間が、総額に影響します。この単価は市場統計ではなく、類似するAI・業務システムからの推定です(出典:一般的な業務システムの費用・人月単価の調査整理、2026年8月時点の編集用推定)。
費用の内訳:データ・モデル・アプリ・テスト
費用の目安は工程ごとに異なります。見積もりでは、次の割合を比較の材料にできます。
- 要件定義・業務整理:10〜15%
- データ収集・整備・ラベル付け:15〜30%
- モデル設計・学習・評価:20〜30%
- アプリ・API・基盤実装:20〜30%
- テスト・セキュリティ・リリース:10〜20%
画像や音声のアノテーション量が多い案件では、データ整備だけで数百万円以上になる場合があります。割合は、案件のデータや要件によって変わります。
見積書では、モデル開発費と、連携やデータ変換、ラベル作成、評価データの費用を分けます。GPU、モデル登録、APIの費用も、項目ごとに示します。画面、権限、監視、運用手順の費用も、同じ考え方で分けて示します。
含まれない工程が明確だと、追加費用が発生する条件を比較しやすくなります。
ランニングコスト:計算資源とモデル運用
運用費の目安と変動要因を把握し、負荷に合わせた構成を選びます。
- 費用項目:推論、保存、監視、転送、再学習、アノテーション、脆弱性・問い合わせ対応
- 小規模本番:月額30万〜150万円程度
- 中規模:月額100万〜500万円程度
- 変動要因:同時実行数、モデル数、データ量、再学習頻度、SLA
主要クラウドでは、カスタム学習はマシン種別・リージョン・アクセラレータの利用時間、パイプラインは実行回数や工程ごとのリソースに応じた従量課金です(出典:主要クラウドの機械学習料金案内、2026年8月確認)。
学習時だけGPUを起動する、夜間にバッチ推論する、低負荷時に台数を減らすといった設計は、負荷に応じた費用削減につながります。
TensorFlowのシステムを見積もる際の確認項目
相見積もりでは、「AI機能一式」ではなく、データ、モデル、アプリ、インフラ、運用に分けたRFPを渡します。同じ前提で提案を受けると、金額に含まれる範囲を比べられます。
精度だけでなく業務KPIと受入条件の記載
受入条件では、評価データの範囲と指標、目標値を定め、許容する誤検知と見逃しも記載します。推論時間や同時実行数、稼働率、障害時の代替手順も、あわせて書きます。
分類モデルは、正解率に加えて、クラスごとの再現率や適合率も確認します。現場で重要な少数クラスが、平均値に埋もれないようにします。
データが変わると性能は落ちるため、納品時の精度だけで契約を終えず、納品後の運用まで見据えて結ぶ必要があります。月次評価やドリフト検知、再学習の条件を運用要件に含めます。また、再評価と承認、旧モデルへの切り戻しも、運用要件に加えます。
データの権利・機密性・セキュリティの確認
RFPでは、データの扱いと保護設計、モデルの管理責任を明確にします。
- データの権利:利用目的、保存期間、委託先、再利用の範囲、削除方法
- 保護設計:通信経路、暗号化、ログ、テナント分離、管理者権限を定める
- モデル管理:取得、保管、配備を担える人と、その責任者
TensorFlowの公式ガイドは、モデルや計算グラフが実行プログラムに相当すると説明しています。そのため、信頼できないモデルを読み込む場合は、サンドボックスなどで隔離します。
マルチテナント環境では、ネットワーク分離やアクセス制御、レート制限、リソース監視も、利用者側で設計します(出典:TensorFlow公式セキュリティガイド、2026年8月確認)。
モデル以外の成果物と契約範囲
納品物には、コードとデータスキーマ、評価データ、モデルを含めます。さらに、コンテナ定義、インフラ・CI/CD設定、API仕様も対象です。テスト結果や運用手順も納品物に入ります。
モデルだけでは、再学習や別環境への移行ができない場合があります。そこで、学習データと派生データの所有権やモデルの利用範囲を、契約で確認します。第三者ライセンス、再委託、保守期間、脆弱性修正も含めて定めます。
精度劣化、クラウド障害、契約終了時のデータ削除と移行も対象です。成功条件と追加費用の条件を書面にすると、後になっての認識違いを減らせます。
TensorFlowのシステム開発会社・ベンダーの選び方
会社は、TensorFlowの知名度ではなく、データ基盤から業務定着まで担えるかで選びます。既存システムとの連携、認証、監視、障害対応、現場教育のどれかが欠けると、本番利用へ進みにくくなります。
データ・ML・業務アプリを横断する体制の確認
提案体制では、業務要件、データ、機械学習の担当を確認します。残りの領域では、本番まで誰が受け持つかを見ます。
- アプリ・API:業務画面と既存システムをつなぐ部分の担当
- インフラ・セキュリティ:基盤や権限、データ保護の担当
- 運用:本番後の監視や更新を続ける担当
全員を専任にする必要はありませんが、各領域の責任者と意思決定窓口を明確にします。
面談では、精度が上がらない場合の代替案、データ不足への対応、再学習の基準、障害時の切り戻しを質問します。
TensorFlow、TFX、推論サーバー、コンテナ、データ基盤、既存業務システムのうち、どこまで責任を持って実装するかも確認します。
実績の確認:業界名より構成と運用範囲
業界名だけでなく、データの性質や処理規模が自社に近いかを軸に、実績を確認します。
- 構成と運用:データ量、モデル、推論件数、既存連携、拠点、稼働期間、精度劣化への対応
- データの類似性:画像・時系列・文章・センサーなどの性質
公開事例には、数千万枚・約30TBの画像を扱い、1回の撮影で約10,000枚、1枚10〜20MBを処理するものがあります。その事例では、負荷に応じてGPU資源を増減させています(出典:TensorFlowを使った公開クラウド事例、2026年8月確認)。
この種の事例では、モデルだけでなく、アップロード、保存、処理キュー、データベース、スケール設計も成否を左右します。
費用の出し方と引き継ぎ可能性の比較
見積もりと引き継ぎ条件をそろえると、初期費用だけでなく将来の選択肢も比較できます。
- 費用内訳:作業単位、人月、クラウド従量費、アノテーション、保守、再学習を分ける
- 引き継ぎ:モデル、学習コード、評価データ、インフラ定義、運用手順を確認する
データ整備や監視が別料金なら、本番までの総額が高くなる可能性があります。API境界、データ・モデル形式、移行手順も契約に含めると、内製化や別会社への移行の選択肢が広がります。
▶ 詳細はこちら:TensorFlowのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:TensorFlowのシステム開発の発注/外注/依頼/委託方法について
2026年のTensorFlowシステム開発で重視すべき最新動向
2026年時点では、モデル作成だけでなく、データとモデルを管理して業務へ安全に届けるMLOpsが重視されています。公式案内では、TFXの本番パイプライン、TensorFlow Servingの推論、端末向けランタイムへの配備が整理されています。
再現可能な学習とモデル更新の仕組み
継続的に更新するには、学習の再現、モデルの監視、現場からの改善の経路を管理します。
- 再現と配備:学習条件を記録し、検証・承認・段階配備・ロールバックを自動化する
- 監視:入力の分布や欠損、予測の偏り、実績の精度、推論時間、コストを記録する
- 改善:現場で行われた訂正を、再学習データへ戻す
学習データと特徴量変換、コード、依存ライブラリを残します。ハイパーパラメータや評価結果も含めて残すと、同じ条件で学習を再現できます。
安全性と説明責任の業務設計
2026年3月31日公表のAI事業者ガイドライン第1.2版は、安全性、透明性、説明責任などを含むリスク管理を示しています(出典:経済産業省「AI事業者ガイドライン 第1.2版」、2026年3月31日)。
どのデータとモデルが、どの条件で、誰の承認を経て判断したかを追えるようにします。そのために、入力項目や出力の意味、信頼度を記録します。さらに、判断できない場合の表示や、担当者が覆した履歴も残します。
医療・金融・人事など影響が大きい業務では、AIだけで処理を完結させず、人の確認を挟みます。異議申立て、監査、停止手順も用意します。
TensorFlowのシステムについてよくある質問
導入前には、技術の選び方や費用、PoC、本番運用について疑問が出やすくなります。
TensorFlowのシステム開発費用はいくらですか?
目安は、PoC・小規模が300万〜800万円、小規模本番が800万〜2,000万円です。中規模は2,000万〜5,000万円、大規模は5,000万〜1.5億円以上が目安です。
主な費用は、ライセンス料ではなく、データ整備、モデル開発、業務連携、計算資源、監視・保守です。
TensorFlowのシステム開発でPoCは必要ですか?
データ品質や業務効果が不確かな場合は、PoCを行う価値があります。2〜4か月程度で、精度や誤検知、推論時間を確かめます。計算費、現場の確認負担、再学習の実現性も見ます。
TensorFlowと他の機械学習基盤はどう選びますか?
基準は、社内技術やデータの所在、推論遅延です。対応端末、内製方針、運用人材も判断材料になります。
TensorFlowは学習からサーバー・端末配備までを構成しやすい一方、既製APIや別基盤で足りるなら独自モデルは不要です。
学習データやモデルのセキュリティで注意することは何ですか?
データの利用目的、アクセス権、暗号化、保存場所を確認します。ログや削除方法、モデルやチェックポイントの取得経路も確かめます。信頼できないモデルは、サンドボックスやネットワーク分離で扱います。
レート制限や監査ログ、脆弱性パッチについて、どこまでを誰が担うかを、契約と設計書に記載します。
TensorFlowのシステム開発の成功に向けたまとめ
TensorFlowのシステムは、業務課題とKPIを定めて完成に向かいます。データを整えてモデルを評価し、推論APIや画面に組み込んで、監視と再学習まで運用します。
費用はライセンス料よりも、データや人材、計算資源、連携、保守によって決まります。
導入前に押さえるべき3つの要点
導入時に重視したい判断材料を、次の3点にまとめます。
- 業務KPI:誤検知時の対応や推論時間、現場の利用方法も定める
- PoCと運用費:PoCの段階からデータ整備、既存連携、セキュリティ、ランニングコストを確かめる
- 引き継ぎ:モデルとコード、再学習、監視、ロールバック、終了時の移行を契約に含める
最初の相談やRFPで揃えるべき情報
相談の前に、対象業務と作業時間、データの件数と形式、正解ラベルの有無、既存システムを整理しておきます。あわせて、提案の前提になる条件もまとめます。
- 利用拠点と想定ユーザー:どこで、誰が使うか
- 目標KPI:業務側で確認できる目標値
- 予算と納期:想定する金額と時期
- クラウド・オンプレミスの制約:データを置ける場所や環境の条件
情報がすべて揃っていなくても、不明な項目をそのまま示せば、必要な調査やPoCの提案を受けられます。
▼関連記事一覧
・TensorFlowのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・TensorFlowのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・TensorFlowのシステム開発の見積相場や費用/コスト/値段について
・TensorFlowのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。