
TensorFlowのシステム開発は、業務KPIとデータの確認から始めて、方式選定、設計、テスト、段階稼働を経て、業務に定着させる流れで進みます。
全体の構成から見積もりの確認点まで、順に見ていきます。全体像はTensorFlowのシステム開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・TensorFlowのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
TensorFlowのシステム開発の全体像
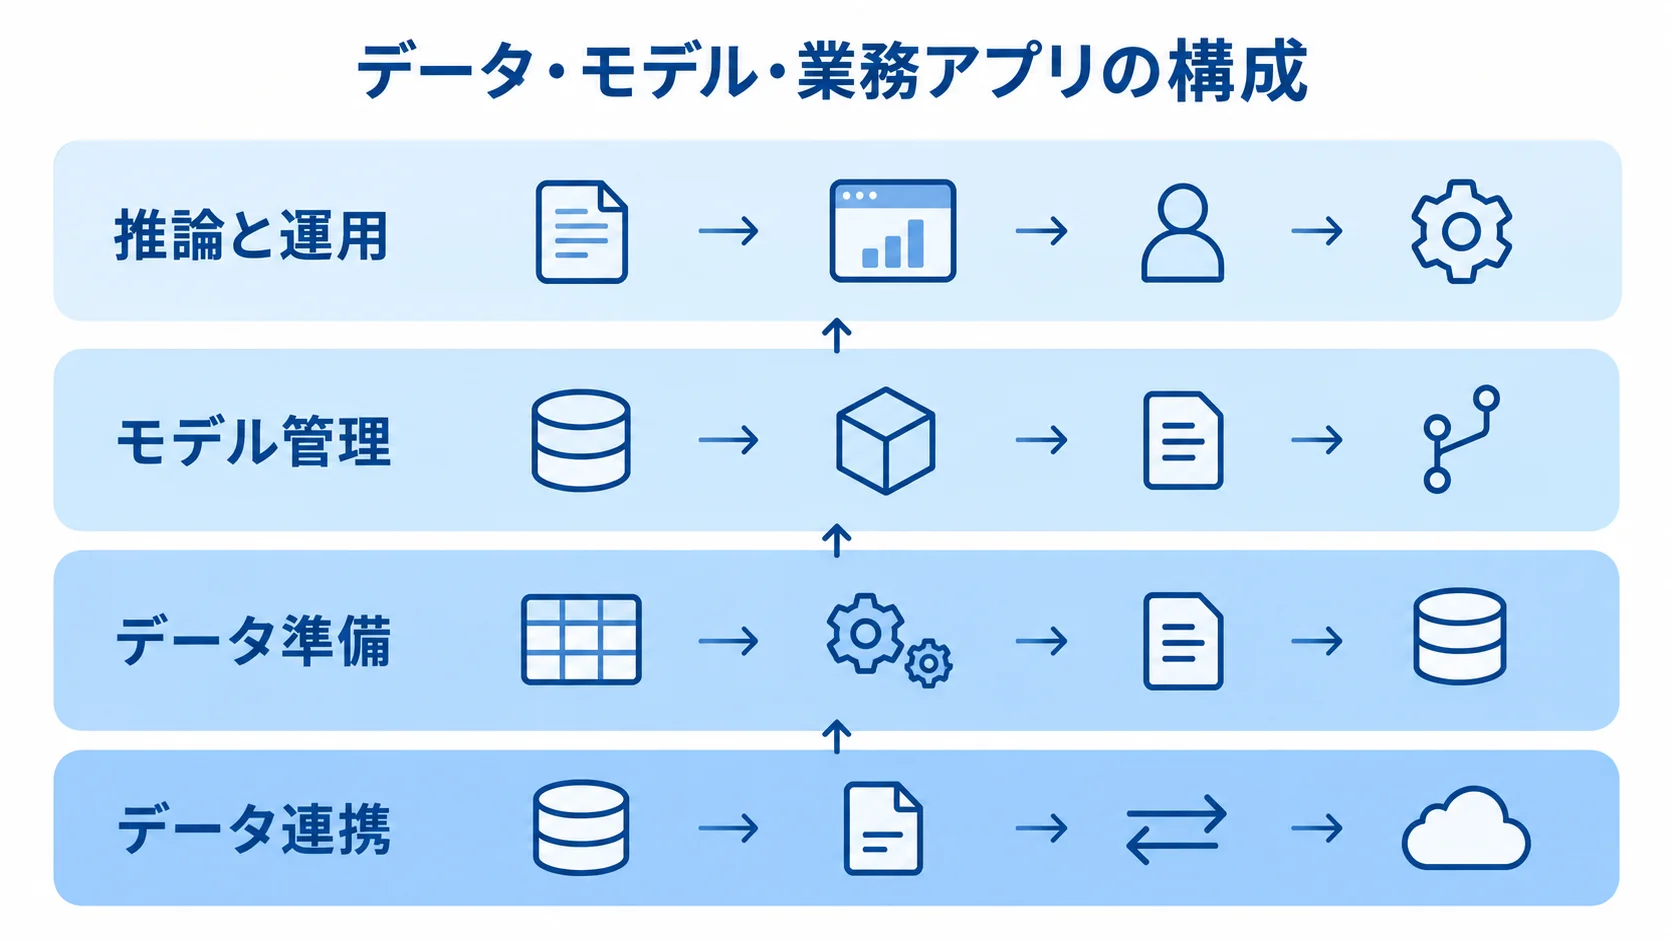
TensorFlowのシステムは、データ取得から推論結果の業務利用、モデル更新までをつないだ仕組みです。機械学習モデルは、その一部にあたります。
モデルの精度に加えて、データが継続して入るか、回答を何秒で返すかも設計の対象です。誤判定が起きたときに誰が確認するかも、あらかじめ決めておきます。
TensorFlowのシステムの定義
TensorFlowのシステムは、TensorFlowやKerasで作成した機械学習モデルを、業務アプリや既存の基幹システムに組み込んだ仕組みです。
- 利用例:工場のカメラ画像による不良候補の検査支援、販売履歴による需要予測の発注支援、センサーデータによる設備異常の監視。
- 結果の特性:一般的なシステムは固定ルールを適用するのに対し、機械学習の結果はデータの品質や分布で変わります。
- 業務要件:正解ラベル、誤検知・見逃しの許容範囲、モデルの有効期限、再学習の承認者。
データ・モデル・業務アプリの一体設計
データ取得から運用までの流れに沿うと、構成要素は4つに分けて考えられます。
- データ連携:基幹システムや装置から、連携層を通してデータを取り込みます。
- データ準備:データレイクやDBに保存し、欠損・重複を処理してラベルを付けます。
- モデル管理:TensorFlowの学習環境と、評価・承認・登録の管理。
- 推論と運用:APIや画面、監視、再学習をつなぐ部分。
画像や音声を扱うなら、データの保存容量と転送時間も初期設計の対象になります。
本番でデータ検証、変換、学習、評価、配備を繰り返す場合は、TensorFlow Extended(TFX)をパイプラインの選択肢にできます。TensorFlow公式も、TFXを本番向けMLパイプラインのエンドツーエンド基盤として説明しています。
公式の説明では、データ検証やモデル評価のほか、TensorFlow Servingや端末推論向けのTensorFlow Liteも案内しています(出典:TensorFlow公式「TFX | ML Production Pipelines」、2026年確認)。
ただし、すべての案件でTFXが必要なわけではありません。モデル数と再学習頻度に応じて、段階的に導入します。
TensorFlowのシステム開発の進め方・6フェーズ
開発を6つのフェーズに分けると、各段階で判断しやすくなります。決めるべきことが曖昧なままモデル開発に進むと、業務で使えなかったり、連携を後から追加して予算が膨らんだりする場合があります。
- 要件整理
- 方式・技術選定
- 設計・開発
- テスト
- 稼働
- 定着
フェーズ1:要件整理と業務KPI・AIの役割の定義
最初に決めるのは、どの業務をどの数値まで改善するかです。TensorFlowを採用するかは、その後で判断します。
- 改善目標:検査時間を何分短縮するか、見逃しを何%以下にするか、需要予測誤差をどこまで許容するかを、現状値と目標値で記録します。
- 評価指標:適合率、再現率、誤検知率、処理時間、1件あたりの推論コストを、業務影響と合わせて定義します。
- データの実現性:過去データの年数、画像・センサー・テキストの件数、ラベル担当者、個人情報・機密情報の有無。
- データ管理:データごとの更新頻度や保存場所、所有者、ラベル定義などを一覧にします。欠損率、重複、季節変動、学習同意、削除方法も含めます。
- 成果物:業務フロー、KPI・データ一覧、AIと人の役割、MUST・WANT機能表、非機能要件、概算日程。
AIの出力で自動発注や合否判定まで行うか、担当者への候補表示にとどめるかも、要件に書いておきます。特に、誤判定が大きな損失や安全上の問題につながる業務では、人の確認を残して段階的に導入します。
フェーズ2:TensorFlow・クラウド・既製AIの選定
TensorFlowを採用すること自体は目的にせず、必要な結果を得られる方式を選びます。方式の判断は、次の2つの場合に分けて考えます。
- 既製AI API:必要な結果を得られ、初期構築を抑えられる場合。
- カスタムモデル:独自データでの改善、低遅延、オンプレミス処理、将来の内製化に向けた学習コードの保有を望む場合。
独自モデルを開発する場合は、TensorFlowやKerasを検討対象にします。
比較表には、データ持ち出しの可否、TensorFlow・Pythonの対応版、学習用GPUの確保方法を入れます。そのうえで、リアルタイム・バッチ推論、API認証、モデル登録とロールバックの対応状況も比べます。さらに、監視、再学習、データエクスポート、解約時の移行条件も見ておきます。
AWSのAmazon SageMaker AIは、TensorFlowモデルの学習を扱います。出典はAWS「TensorFlow – Amazon SageMaker AI」で、2026年に確認しています。
Azure Machine LearningはTensorFlowを含むOSSモデルの学習・デプロイ・MLOpsを案内します。出典はMicrosoft Learn「What is Azure Machine Learning?」で、2026年に確認しています。
クラウドは、計算資源の性能に加えて、既存の認証、ネットワーク、ログ、バックアップ、データ所在地との整合性で選びます。一方で、コンテナとTensorFlow Servingは移植性を高める反面、GPU、Kubernetes、監視の運用負荷も増えます。
インフラ担当者が少ない場合は、マネージドエンドポイントを使い、モデルや学習コードの引き渡し条件を契約で確保します。
フェーズ3:データパイプライン・モデル・業務画面の設計と開発
設計では、まずデータの流れを書き出し、各工程の仕様を定めます。
- データ設計:入力データのスキーマや前処理、学習・評価データの分割、モデル版、推論結果の保存期間、業務への反映方法を決めます。
- 変換処理:学習時と推論時で処理を共通化し、使ったコードを追跡できるようにします。
- モデル評価:画像の良品・不良品と撮影条件、需要予測の欠品・特売、異常検知の正常範囲と事後ラベル。
- 業務画面:予測値、信頼度、判断理由に使える特徴、確認ボタン、訂正欄を用意します。訂正データは、再学習へ戻します。
- 本番基盤:ストレージ、学習ジョブ、モデルレジストリ、推論API、業務アプリ、監視ログを分けて構成します。
TFXを採用する場合は、まずデータ統計、スキーマ検証、異常検出の工程を置きます。そのあとに学習、評価、配備の工程が続き、それぞれの承認条件もパイプラインにまとめます。
TFXは、データ準備から成果物の追跡までを管理します(出典:TensorFlow公式「Understanding TFX Pipelines」、2026年確認)。また、AirflowやKubeflow Pipelinesなどの実行基盤にも対応します。
フェーズ4:精度・性能・セキュリティ・業務シナリオのテスト
テストは種類ごとに分け、技術面と業務面の両方から確かめます。
- 品質と精度:単体テスト、データ品質テスト、モデル評価。
- システム性能:API連携テスト、負荷テスト、推論時間、同時実行数。
- 安全性と業務:権限テスト、障害・復旧テスト、業務受入テストを分けて実施します。
まず、モデルの精度は、学習に使っていない評価データで確かめます。部門・店舗・季節による偏りや、誤検知と見逃しの件数も確認します。
また、受入基準は、「正解率が高い」のような曖昧な書き方を避け、見逃し率を何%以下にするかで定めます。推論を何秒以内に返すか、誤検知を何分以内に確認するかも決めます。
テストデータには、業務で変わりやすい条件も含めます。たとえば、画像検査では照明やカメラの変更、需要予測では繁忙期や特売、文書分類では新しい帳票様式を扱います。
画面を見て現場担当者が判断できるかは、技術者だけでなく業務責任者も確かめます。
セキュリティでは、学習データの権限や個人情報のマスキングを確かめるほか、モデルの持ち込み経路、API認証、ネットワーク分離も見ます。
レート制限、監査ログ、バックアップ、脆弱性対応については、どこまでを誰が受け持つかも決めます。外部モデルやチェックポイントは安全性を検証し、開発用データを本番へコピーしない運用にします。
経済産業省のAI事業者ガイドライン第1.2版は、2026年3月31日に公表されています。その透明性、リスク管理、説明責任を、社内ルールと受入項目に反映します(出典:経済産業省「AI事業者ガイドライン(第1.2版)」、2026年確認)。
フェーズ5:限定公開から本稼働への段階的な移行
稼働前には、モデル、推論API、業務画面、データ連携、監視を本番相当の環境に配置します。
- 限定公開:1店舗、1工場、1業務などに絞り、担当者が予測結果を確認しながら、シャドーモードやカナリアリリースで始めます。
- 切り戻し準備:旧モデルへ戻せるよう、モデル版、設定、コンテナ、データスキーマを一緒に管理します。
- 稼働判定:データの定刻到着、推論エラー時の再送、基準内のAPI応答時間の確認。
- 障害対応:監視アラートが担当者へ届くことと、旧モデルへの切り戻しを実測します。手作業の手順、窓口、意思決定者、利用者への告知文も用意します。
- 代替フロー:自動発注や合否判定では、モデル停止時も業務が完全に止まらない流れを設けます。
フェーズ6:監視・再学習・教育による現場への定着
稼働後は、システムだけでなくデータとモデルも監視の対象になります。
- 監視項目:入力の欠損・分布変化、予測の偏り、正解判明後の精度低下、推論遅延、GPU・エンドポイント使用量。
- 履歴の保存:データ変化、業務ルールの変更、モデルの問題を切り分けられるよう、学習データ、評価結果、モデル、リリース履歴を残します。
- 再学習:自動化が適切とは限らないため、新ラベルの品質と評価指標を確かめ、業務責任者の承認後に本番へ出します。
- 定期レビュー:月次または四半期にKPI、誤判定、問い合わせ、処理コスト、更新回数を確認し、追加開発の優先順位を決めます。
- 現場教育:役割別に、予測の見方、訂正方法、異常時の連絡先を短時間で伝えます。
TensorFlowのシステム開発の費用相場と内訳
TensorFlow自体はオープンソースのため、見積もりでは、ライセンス料以外の費用も含めて考えます。主な費用は、データ収集・整備・アノテーション、人材、モデル開発、システム連携です。さらに、推論基盤、監視、再学習、保守も含まれます。
ここに示す金額は、TensorFlow専用の全国統一価格ではありません。一般的な業務システム開発の相場に、機械学習特有の工程を組み合わせた、2026年時点の予算検討用レンジです。
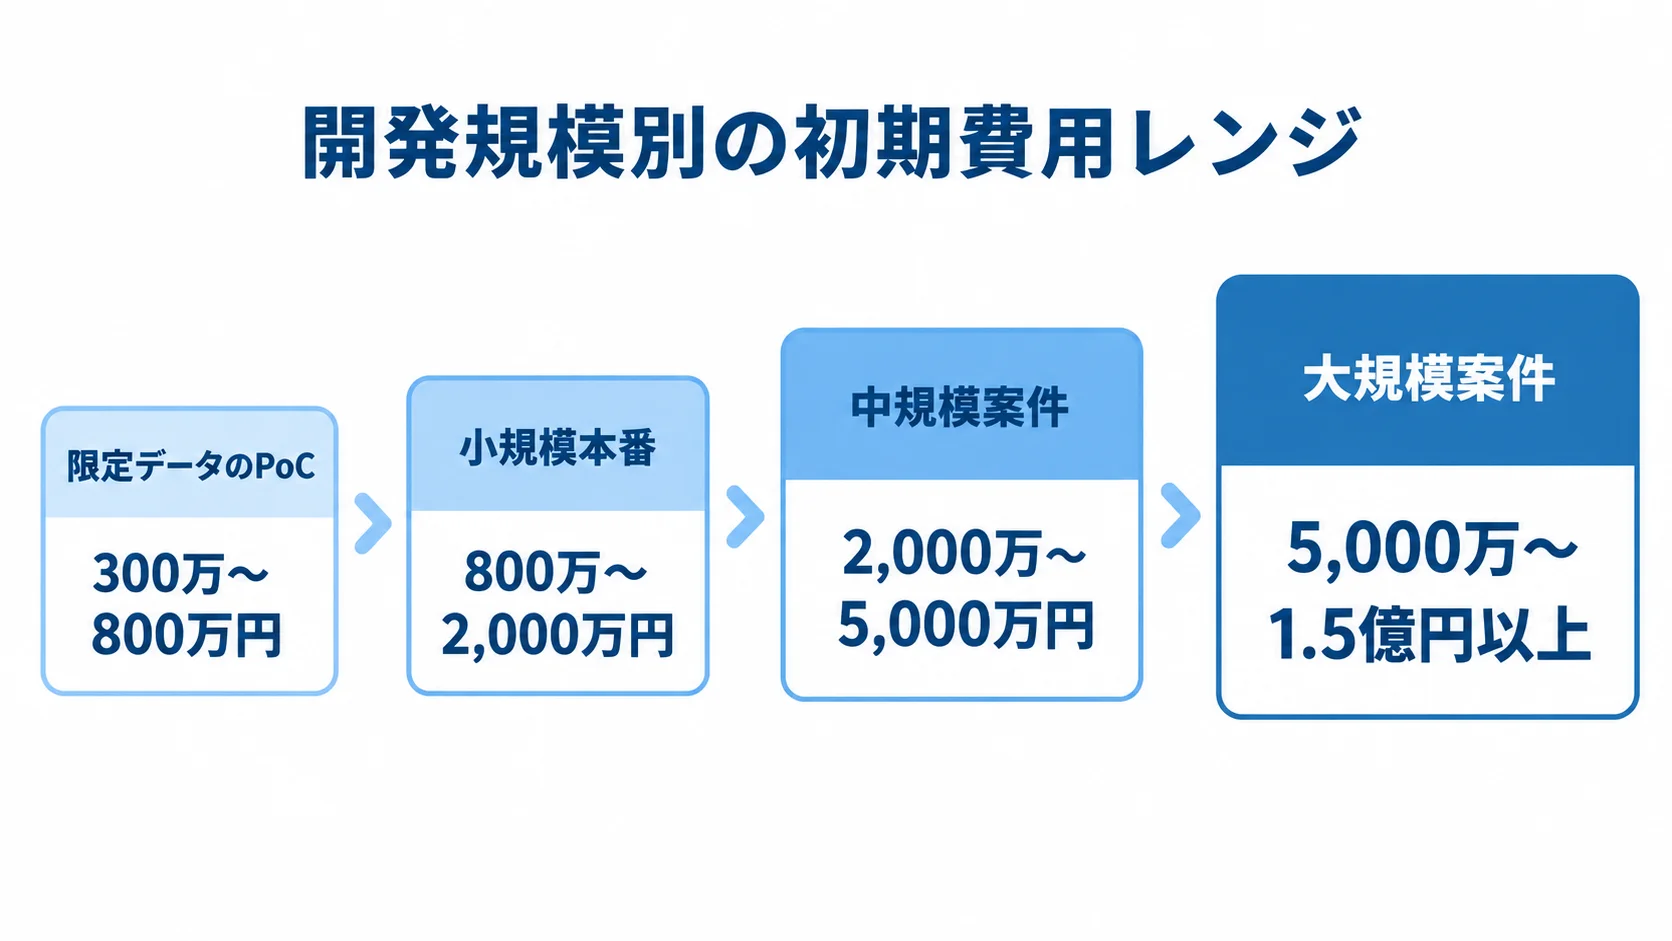
PoCから大規模本番までの段階別の初期費用
初期費用は規模や含む機能で異なるため、段階ごとの予算検討用レンジを確認します。
- 限定データのPoC:300万〜800万円程度。
- 小規模本番:800万〜2,000万円程度。
- 中規模案件:2,000万〜5,000万円程度。
- 大規模案件:全社展開、高負荷推論、厳格なSLA、データ基盤、内製移管を含む場合は、5,000万〜1.5億円以上となる可能性があります。
このレンジは、1業務・1モデル・限定データで、オフライン評価や簡易APIまでを行うPoCを想定したものです。簡易画面や既存データ接続も含める場合は、下限をそのまま当てはめない方が安全です。PoCでは精度だけでなく、本番化に必要なデータ量、推論コスト、業務変更の大きさも確認します。
小規模本番は、1〜2モデル、データ連携、Web画面またはAPI、認証、最小限の監視を含む想定です。一方で、複数拠点・複数モデル、基幹システム連携、権限・監査ログ、再学習パイプラインを含む場合は、中規模案件の想定です。
これらは公開統計の平均値ではなく、社内リサーチノートの一般的な業務システム規模別相場を、TensorFlow案件へ適用した推定です。開発会社の人月単価を80万〜120万円程度と仮置きし、データ整備、モデル開発、アプリ・基盤実装を加味した編集用レンジです。実見積もりでは、データ件数、連携数、SLA、運用時間を分けて再計算します。
データ整備・GPU・推論・保守を含むランニング費用
初期費用の内訳は、工程ごとの割合とデータ量を分けて見ていきます。
- 要件整理・業務設計:10〜15%程度。
- データ収集・整備・ラベル付け:15〜30%程度。
- モデル設計・学習・評価:20〜30%程度。
- アプリ・基盤・テスト等:各工程の範囲で確認。
アプリ・API・基盤実装は20〜30%程度、テスト・セキュリティ・リリースは10〜20%程度です。
画像や音声のアノテーション量が多いと、データ整備だけで数百万円以上になる場合もあります。そのため、件数と単価は別行にして見積もります。
クラウド費は、学習用GPUやTPUを常時確保するか、学習時だけ起動するかで変わります。たとえば、Google Cloudでは、カスタム学習の費用はマシン種別、リージョン、アクセラレータの時間課金が基本です。ノートブックは計算・ストレージ、パイプラインは実行と使用リソースで費用が決まります(出典:Google Cloud「Vertex AI Platform pricing」、2026年確認)。
無料クレジットが使える場合も、本番の計算資源費とは分けて見積もります。
運用費は初期開発費の年15〜25%を起点に、再学習、データ品質監視、ドリフト検知、推論エンドポイント、バックアップ、脆弱性対応を加えて考えます。小規模本番は月額30万〜150万円程度、中規模は月額100万〜500万円程度を仮置きできます。これは公開料金表ではなく、利用量と保守範囲からの推定です。
24時間監視や高可用性を求める場合は、対応時間とSLAを別に見積もります。
TensorFlowのシステム開発で見積もりを取る際のポイント
AI案件は、精度やデータの状態が確定しにくいぶん、通常の画面開発より不確実性が高くなります。
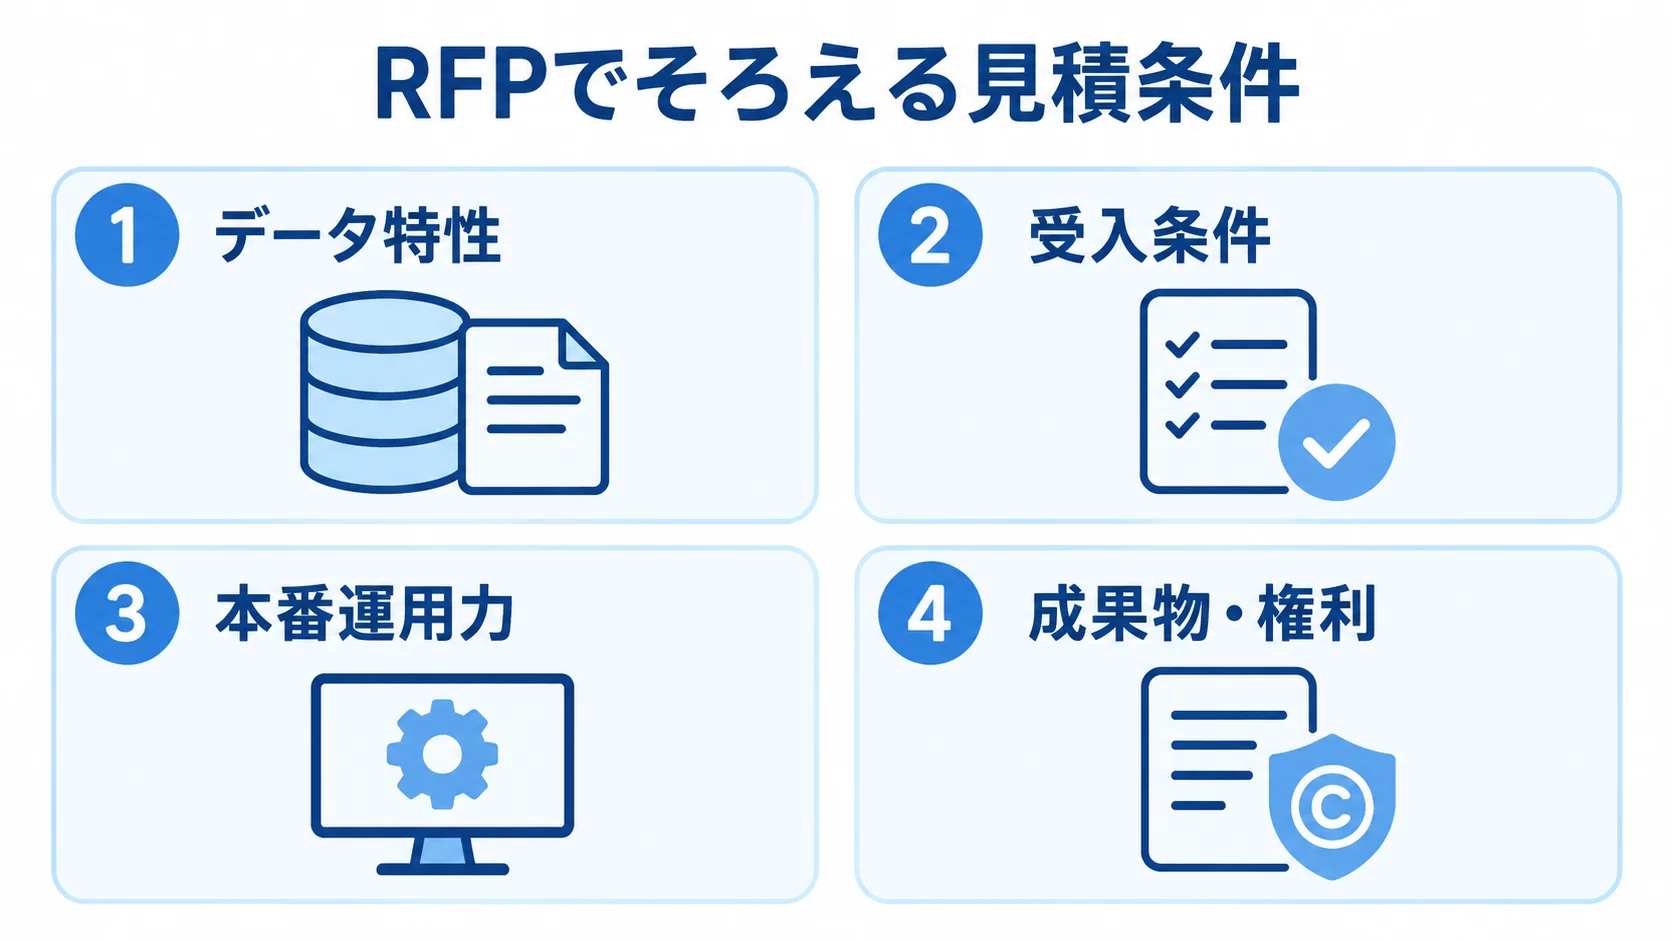
複数社に見積もりを依頼する場合は、同じRFPで、データ量、モデル数、推論件数、既存システム、利用拠点を伝えます。目標KPI、公開時期、予算上限も示します。そうすると、作業範囲と除外範囲を同じ粒度で比べられます。
要件定義書に書くデータ・精度・業務運用の範囲
RFPには、対象業務、利用者、現行フロー、改善KPI、入力データの種類と件数を記します。加えて、ラベルの有無、更新頻度、学習利用の制約、推論方式、許容レイテンシも含めます。
- 利用条件:利用時間帯、既存API・ファイル連携、画像の解像度・撮影条件を記載します。
- データ特性:時系列の粒度・欠測、テキストの文書形式・機密区分を示し、各社の見積前提をそろえます。
- 受入条件:誤検知・見逃しの上限、条件別評価、API応答時間、同時実行数、欠損時の挙動、停止時の代替手順を決めます。
- 精度の数値化:「高精度」を、評価データの再現率何%以上、店舗別の差何ポイント以内、95パーセンタイルの応答時間何秒以内と表します。
開発会社の選定(モデルと本番運用の実績)
候補会社の体制を見るときは、モデル開発者のほかに、データエンジニア、クラウド・インフラ担当、アプリ開発者、セキュリティ担当、業務コンサルタントがいるかを確認します。
- 本番運用力:PoCだけでなく、認証、障害対応、監視、移行、現場教育の体制を確かめます。
- 類似実績:画像、需要予測、異常検知など、自社に近いデータ形式や業務の実績を、提案書・デモで確認します。
- 見積項目:要件整理、アノテーション、評価、API・画面を同じ粒度でそろえます。GPU・ストレージ、監視、再学習、保守、教育も含めます。
Google CloudのTaranis事例は、1回のドローン飛行で約10,000枚、画像1枚10〜20MB、総スループット約30TBを扱います。TensorFlow、GPU、Kubernetes、Cloud SQL、Pub/Subを組み合わせています(出典:Google Cloud「Taranis Case Study」、2026年確認)。
大規模事例は、そのまま自社に当てはめず、データ量とピーク変動を自社の見積条件に置き換えて考えます。
成果物・権利・再学習・切り戻しの契約条件
契約では、ソースコード、学習コード、データスキーマ、評価データ、モデルファイル、Dockerfileの納品範囲を確かめます。
- 納品物:インフラ・監視設定、運用手順、設計書も契約対象にします。
- 権利と移行:学習データの所有権・再利用範囲、生成モデルの利用権、第三者ライブラリのライセンス、再委託先、終了時のデータ・モデル返却を定めます。
- 保守の担当:精度劣化の検知、再学習回数、ラベル付け、脆弱性パッチ、TensorFlow更新の担当を決めます。
- 障害対応:一次対応時間、復旧目標、旧モデルへの切り戻し、クラウド費上限アラート、法令・社内ルール変更への対応を確認します。
- 精度保証:保証範囲と、データ条件が変わった場合の再評価条件を分けて合意します。
モデルだけが納品されると、別会社へ移行できず、将来の保守費用が上がりやすくなります。
TensorFlowのシステム開発でよくある質問(FAQ)
TensorFlow開発では、始め方、費用、TensorFlowを使う必要性についての質問が多く寄せられます。発注前に判断しやすいよう、それぞれ答えを先に示します。
TensorFlowのシステム開発は何から始めればよいですか?
最初に確かめるのは、改善したい業務KPIと利用できるデータです。TensorFlowの機能は、その後に調べる流れになります。
対象業務と現状値・目標値を整理し、データ件数とラベルの有無を確かめます。誤判定の影響や既存システムとの接続方法も、あらかじめまとめておきます。
2〜4か月程度のPoCで精度、推論時間、業務フローを検証する進め方が現実的です。
TensorFlowのシステム開発費用はどれくらいですか?
費用の目安と、見積もりに含まれる工程を順に見ていきます。
- 予算検討用の推定レンジ:限定データのPoCは300万〜800万円、小規模本番は800万〜2,000万円、中規模は2,000万〜5,000万円です。
- 大規模・全社展開:5,000万〜1.5億円以上が予算検討用の推定レンジです。
- 費用の条件:範囲によって異なり、TensorFlowのライセンス料ではありません。
- 比較する工程:データ整備、モデル開発、システム連携で変動します。GPU・推論基盤、監視、再学習、保守でも変わるため、含まれる工程を比べます。
TensorFlowと既製AI APIはどちらを選ぶべきですか?
独自データで継続改善したい、推論遅延やデータ所在地を細かく制御したい、学習コードを自社資産にしたい場合はTensorFlowが候補です。一方で、汎用画像認識や文字起こしなどで既製APIがKPIを満たす場合は、開発・運用負担を抑えられる既製サービスから始める方が適しています。
PoCだけで終わらせないために何を確認しますか?
PoCを始める前に、本番化の判断基準、必要なデータ連携、運用担当者、予算上限、モデルやコードの納品範囲を決めておきます。
PoCの終了時には、精度だけでなく、実データでの業務時間、誤検知時の対応、推論コスト、監視方法、再学習手順も確かめます。
特に、本番化しない場合のデータ返却と成果物の扱いは、あらかじめ合意しておきます。
まとめ:TensorFlowのシステム開発における業務定着までの設計
TensorFlowのシステム開発では、モデル作成で終わらせず、業務に定着するまでを一続きで考えます。要件整理でKPIとデータの実現性を確かめ、方式を選び、設計・開発へ進みます。
テストでは精度・性能・安全性・業務シナリオを確かめます。稼働後も監視と再学習を続け、現場へ定着させます。
6フェーズごとの成果物と判断基準
要件整理ではKPIとデータ、選定では方式と、どこまでを誰が受け持つかを確かめます。設計・開発ではデータの流れとモデルを見ます。
テストは精度と業務シナリオ、稼働は監視と切り戻し、定着は再学習と教育を確認します。また、終了条件を記録しておくと、担当者が変わっても判断の根拠を引き継げます。
発注前に整えるKPI・データ・運用
発注前に、改善したいKPI、利用できるデータ、稼働後の担当者をそろえておくと、TensorFlowが必要かを判断しやすくなります。
どれかが不足している場合は、モデル開発を急がず、データ整備や業務フローの見直しを先に行います。そうすると、過剰投資を防げます。
- 小規模までの費用:PoCは300万〜800万円、小規模本番は800万〜2,000万円です。
- 中・大規模の費用:中規模は2,000万〜5,000万円、大規模は5,000万〜1.5億円以上です。
- 見積条件:データ整備、アノテーション、GPU・推論量、連携数を分けて比べます。監視、再学習、保守も、別の項目として並べます。
- 契約条件:精度基準、モデル・学習コードの権利、評価データ、再学習条件を契約に明記します。
- 運用契約:セキュリティ責任、監視、障害対応、切り戻し、終了時の移行も契約に含めます。
費用は範囲によって異なるため、ここに示す数字は予算検討用の推定レンジとして扱います。作業と除外条件も、見積書で比べます。
まずは小さく検証し、現場の判断を支える形から始めます。KPIとデータがそろった範囲で自動化を広げていくことが、長く使うための現実的な進め方です。
▼全体ガイドの記事
・TensorFlowのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。