
XGBoostシステムの開発費は、データ整備、業務連携、運用範囲によって、50万円から5,000万円以上まで変わります。
検証だけで済ませるか、本番の業務システムとして作るかで、費用は大きく違ってきます。まずは作る範囲を決めることが、見積もりの出発点になります。
▼全体ガイドの記事
・XGBoostのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
XGBoostシステムの概要
XGBoostのシステムとは、予測モデルを業務データと業務フローに組み込み、継続的に予測結果を使えるようにした仕組みです。XGBoost自体は、オープンソースの機械学習ライブラリです。
インストールやモデル学習だけでは、本番のシステムは完成しません。そのため、費用はモデル開発だけでなく、データから意思決定までの仕組み全体で見積もる必要があります。
予測エンジンと業務システムの違い
業務で使うには、基幹システムやCRMなどからデータを集める必要があります。販売管理やIoT機器のデータも、取り込む対象に含まれます。集めたデータは学習用の特徴量に変換し、予測の対象を表す正解ラベルも定義します。
- モデルの準備:学習と検証、モデルファイルの版管理です。
- 業務への提供:APIやバッチで推論し、結果を画面や通知へ返します。
- 統制と運用:アクセス権限と監査ログの整備です。
精度の高いモデルであっても、現場が結果を見られない状態や、入力データが更新されない状態では、投資効果が出にくくなります。
用途ごとに必要な構成
XGBoostは、解約予測、需要・売上予測、不正検知などに向いています。ほかにも、与信・延滞予測、設備故障の予知、品質異常の検出が用途になります。問い合わせの優先順位付けも、そのひとつです。
日次や週次で使うなら、DWHからのバッチ推論で始められます。受付時に即時判定する場合はAPIが、複数部門で使う場合はモデル登録や権限管理が必要になります。
画像や音声、長文を扱う場合は、別のモデルで特徴量を抽出し、そのあとでXGBoostへ渡す構成も検討します。見積もりは、この用途の定義から始まります。
XGBoostのシステム開発費用の相場
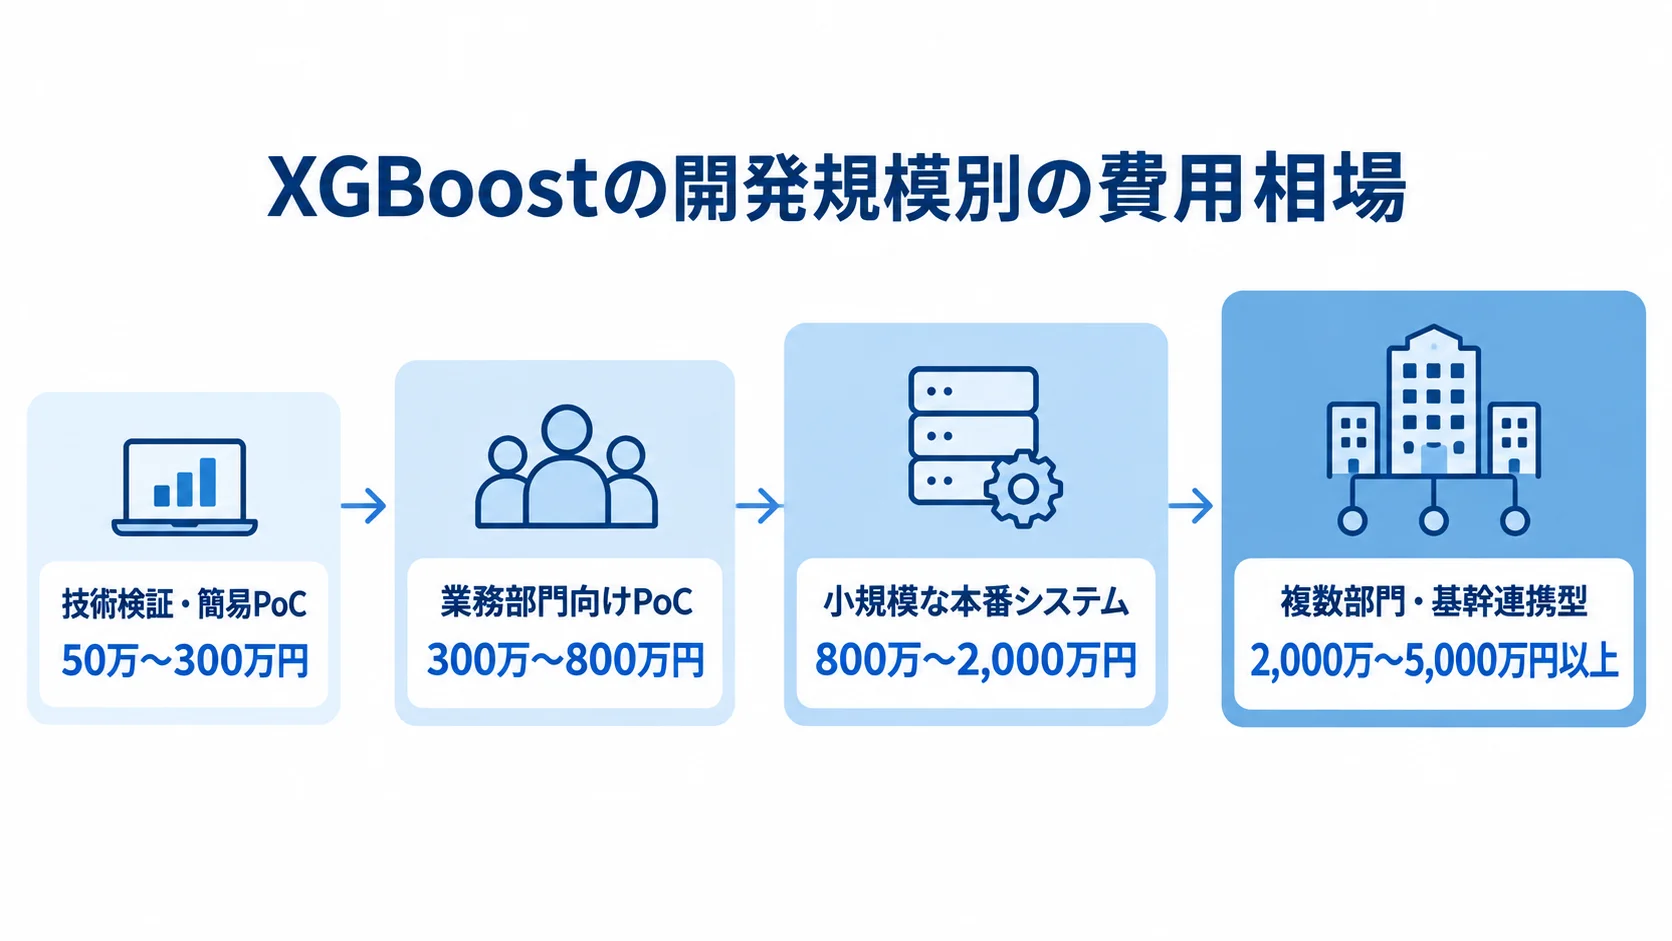
開発費は、検証だけで終えるか、本番の業務システムまで作るかで大きく変わります。ここで示す価格帯は、XGBoost専用の公的統計ではありません。
この価格帯は、NotebookLMリサーチノートにある業務システムの人月単価と規模別の相場、そしてAI基盤の公開価格例から推定したものです。
実際の金額は、データの量と品質、連携先、利用者数で上下します。可用性や個人情報の扱いでも変わります。そのため、この価格帯は初期見積もりを比べる目安として使ってください。
技術検証・簡易PoCの費用(50万〜300万円)
データが整っている場合に、XGBoostで予測できるかを試すなら、50万〜300万円程度が目安です。対象データの読み込みから、簡単な結果レポートまでを想定しています。
- データ確認:欠損値や外れ値を調べ、特徴量を試作します。
- モデル比較:ロジスティック回帰などとの比較と、評価指標の確認です。
- 成果物:評価結果をまとめた簡単なレポートです。
期間は1〜2か月程度です。画面や本番APIは原則として別費用で、監視、認証、再学習の自動化についても、別に費用を見込む必要があります。
データの持ち出し制限があったり、ラベル作成が必要だったりする場合は、この価格帯を超える可能性があります。そのため、PoCの成果物は事前に明確にしておいてください。
業務部門向けPoCの費用(300万〜800万円)
業務部門が実データで予測結果を確かめ、導入効果や運用方法まで評価するPoCなら、300万〜800万円程度が目安です。この金額には、データ連携や予測対象・ラベルの設計も含まれます。
時系列検証とXGBoostのハイパーパラメータ探索を行い、評価レポートも作成します。結果は簡易ダッシュボードかバッチ出力で示します。期間は2〜4か月程度です。
現場ヒアリングや業務ルールの整理が増えるほど、モデル比較以外の業務設計費用が加わります。
小規模な本番システムの費用(800万〜2,000万円)
予測結果を本番業務で継続して使う小規模システムは、800万〜2,000万円程度が目安です。データ連携やETL、特徴量生成を組み込み、モデルの登録と版管理も行います。
- 推論と連携:APIか定期バッチを、業務画面につなぐ作業です。
- 運用準備:権限、ログ、テスト、リリース手順の整備です。
- 継続利用:再学習の手順をあらかじめ用意します。
期間は3〜6か月程度です。機密データを扱う場合や手動承認を伴う場合は、セキュリティと運用設計も必要になります。そのため、モデル開発だけの見積もりとは比べられません。
複数部門・基幹連携型の費用(2,000万〜5,000万円以上)
複数のデータソースを統合し、基幹システムや複数の部門へ予測を返す場合は、2,000万〜5,000万円以上になることがあります。冗長化や監査証跡の整備も、費用に影響します。
期間は6〜12か月以上を見込みます。要件定義、段階移行、データ品質改善は、最初の計画に入れておきます。モデル評価の承認やMLOpsも必要になり、さらに運用SLAと教育まで計画に含めます。
複数モデルの同時運用や、高可用性のリアルタイム処理では、5,000万円を超える可能性もあります。この金額は、ライセンス料ではなく、連携・品質・運用にかかる企業システムの費用です。
XGBoostのシステム費用の内訳
「AI開発一式」とだけ書かれた見積では、工程ごとの費用が見えません。モデル開発のほかに、データと業務連携の担当工数が発生します。品質やセキュリティの工数も、見積もりに含まれます。
見積書では、費目を分けて記載してもらうと、会社ごとの価格差を比べやすくなります。
データ棚卸し・ラベル設計・特徴量作成の費用
データの状態を確認し、ラベルを設計する段階では、次の作業が発生します。
- データ確認:データソースと項目の意味、欠損・重複・異常値、個人情報の有無を調べます。
- ラベルと特徴量:正解の値を決め、学習用の項目を定義します。
- 解約予測:「契約終了日の何日前に兆候を判定するか」を先に決めます。未決定のままだと、学習データと本番データの条件がずれます。
- 作業見積もり:過去記録にラベルを付ける場合の、データサイエンティストと業務担当者の協力時間です。
この工程を省くと、後からデータを作り直すことになりやすく、開発全体の手戻りにつながります。
モデル開発・評価・説明可能性の費用
モデル開発では、ベースラインとの比較や時系列評価、ハイパーパラメータ探索を行います。学習と検証のデータ分割や、不均衡データへの対応、閾値の決定も必要です。再現できる実験環境も整えます。
分類では、適合率と再現率を中心に、F1スコアやROC-AUCなどを確認します。業務上の損失が異なる場合は、誤検知と見逃しのそれぞれを金額で評価することも必要です。
特徴量重要度やSHAPで根拠を説明する場合は、画面表示、レポート、監査用の保存にかかる工数が加わります。納品条件は、精度だけでなく業務のアクションとあわせて決めます。
API・バッチ・業務画面連携の費用
業務で使うには、入力データを受けてモデルを呼び出すAPIか、定期的に処理するバッチが必要です。APIでは、認証や同時実行数、タイムアウトの設計が要ります。さらに、エラー時の再試行、ログ、レスポンス時間も設計対象です。
バッチでは、実行スケジュールや未処理データの再処理を設計します。結果の差し替えや担当者への通知も必要です。
結果を一覧や顧客詳細画面に反映する場合は、既存システムの改修費がかかります。アラートや承認フローに反映する場合も、改修費が加わります。
MLOps・セキュリティ・テスト・教育の費用
本番運用では、次の四つをそれぞれ整えます。
- モデル管理:データセットや特徴量コード、XGBoostの版、設定を記録します。評価値や承認者、リリース日時も残し、以前のモデルへ戻せる状態にします。
- 監視と再学習:精度やデータドリフト、欠測率、推論失敗、レイテンシを見守り、再学習の条件と承認者を決めます。
- セキュリティ:個人情報や機密情報を扱う場合は、暗号化、ネットワーク境界、権限分離を押さえます。アクセスログや脆弱性検査、委託先管理も、確認の対象になります。
- 利用者支援:教育、運用マニュアル、障害時の連絡体制を整えます。
これらを含めて比べると、会社ごとの差が、モデル開発費とは別の部分にも生まれます。
XGBoostの見積費用が変わる要因
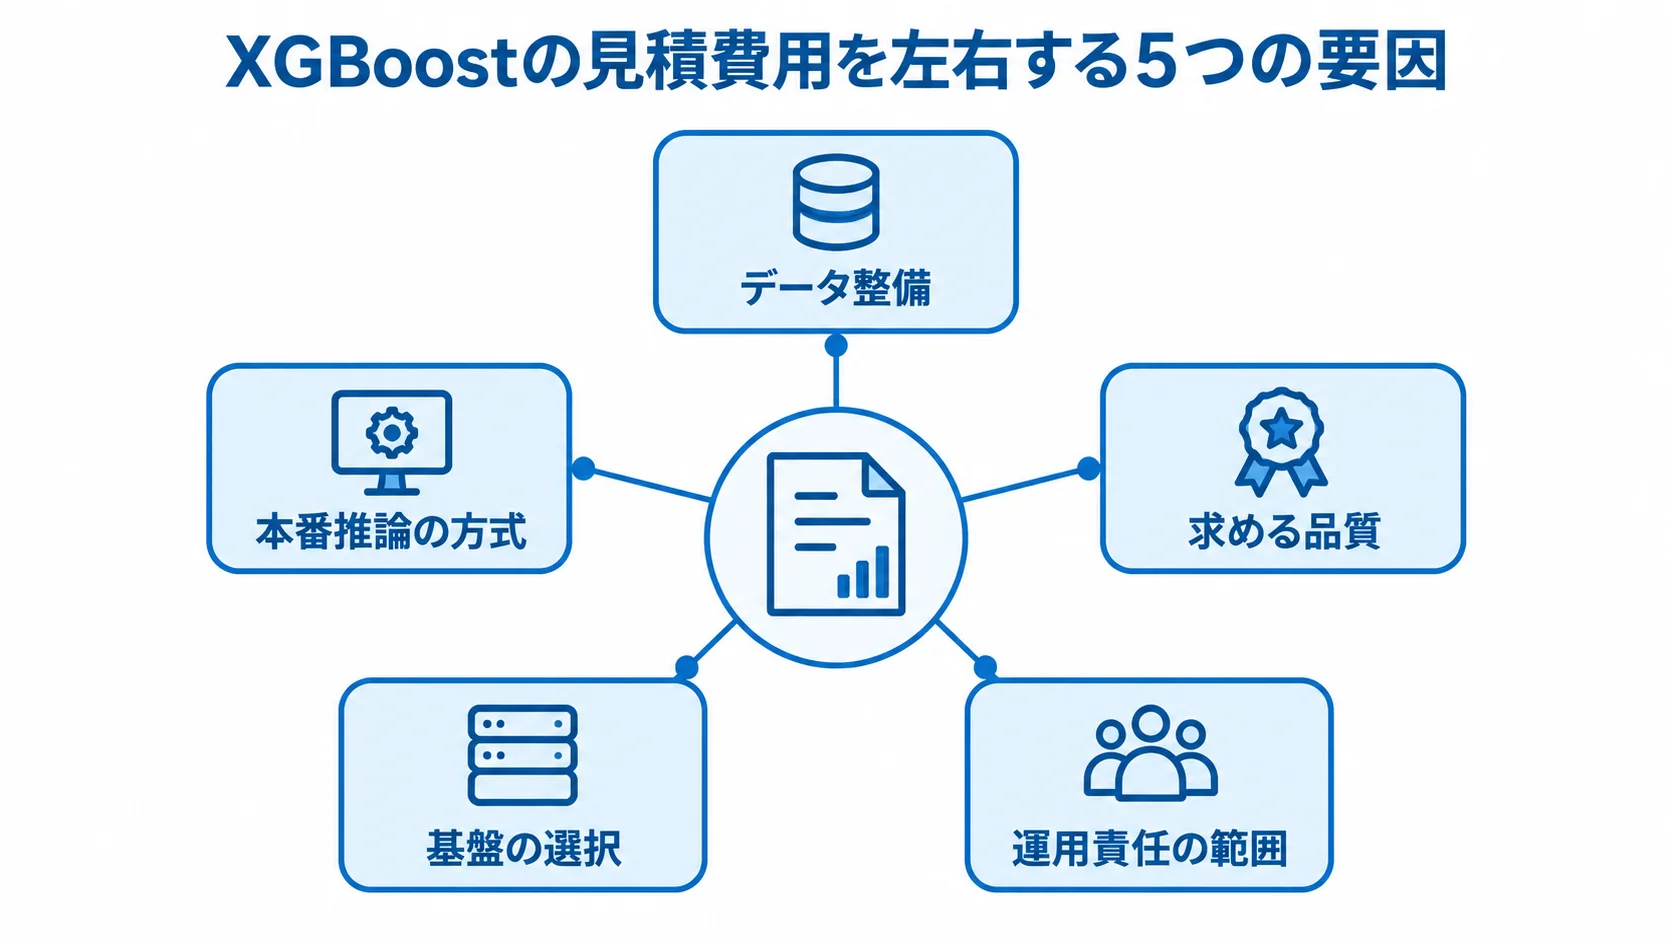
同じXGBoostを使っていても、見積金額が同じになるとは限りません。差が出やすいのは、データ整備と本番推論の方式です。さらに、求める品質、基盤の選択、運用責任の範囲も、差を生みます。
見積の違いは、含まれる作業の違いとして説明できます。
データ量・データ品質・正解ラベルの有無
履歴データが一つの表に整理され、予測対象と結果のラベルも定義済みなら、PoCを短く進められます。一方で、複数のシステムから履歴を集める場合は、作業が増えます。
人手でラベルを付けたり、欠損や重複を直したり、学習時と本番時で項目の定義をそろえたりするにも、費用がかかります。件数だけでなく、その情報が正しい時点のものか、時系列リークを防げるかも見ておく必要があります。
データ品質の調査を別項目として分けておくと、追加費用が発生する条件を明確にできます。
バッチ推論とリアルタイムAPIの違い
日次の需要予測や、翌日の解約候補の抽出なら、決まった時間のバッチ推論で始められる可能性があります。画面表示時の判定や受付中の不正リスク判定には、リアルタイムAPIが必要です。
APIでは、同時アクセスや応答時間、障害時の代替処理の設計が加わります。負荷試験と可用性の確認も必要です。そこで、予測頻度と許容待ち時間を先に決めておくと、過剰なサーバー構成や工数を防げます。
クラウド・オンプレミス・ハイブリッドの違い
クラウドは、初期のサーバー調達を抑えやすく、学習のときだけ計算資源を使う構成も取りやすいです。ただし、データ転送やストレージ、常時稼働のエンドポイント、監視などの従量費も発生します。
- AWS:選んだインスタンスの時間に応じて課金されます。
- 対象処理:学習、リアルタイム推論、バッチ変換などが該当します。
- サーバーレス推論:メモリや処理時間に応じた課金です。
- Vertex AIの学習:機械タイプ、リージョン、アクセラレータによって料金が変わります。
- Vertex AIの予測:サービス形態やノード時間を基準に料金が決まります。
いずれも、利用量に応じた従量課金を前提として試算されるサービスです。出典は、AWSが「SageMaker AI pricing」(Amazon Web Services、2026年確認)です。Vertex AIは「Vertex AI pricing」(Google Cloud、2026年確認)です。
可用性・監査・説明責任のレベル
求められる品質と統制は、予測結果を使う場面の影響度によって変わります。
- 参考情報として利用:社内で判断材料として使うケースです。
- 影響の大きい判断に利用:与信、審査、不正検知、設備停止などを扱います。
- 必要な統制:手動上書き、異議申立て、ロールバック、監査証跡、権限分離、再学習の承認を設計します。
業務システム全般のリサーチでは、要件定義を削りすぎると、データ品質の問題や追加の連携が本番前に発覚します。さらに、追加工数や費用が1.3〜1.5倍へ膨らむリスクも指摘されています。
(出典: NotebookLMリサーチ「業務システム全般_15」、2026年)
安く見える見積ほど、障害時や精度低下時にどこまで対応するのか、範囲を確かめてください。
費用を抑えたXGBoost開発の進め方
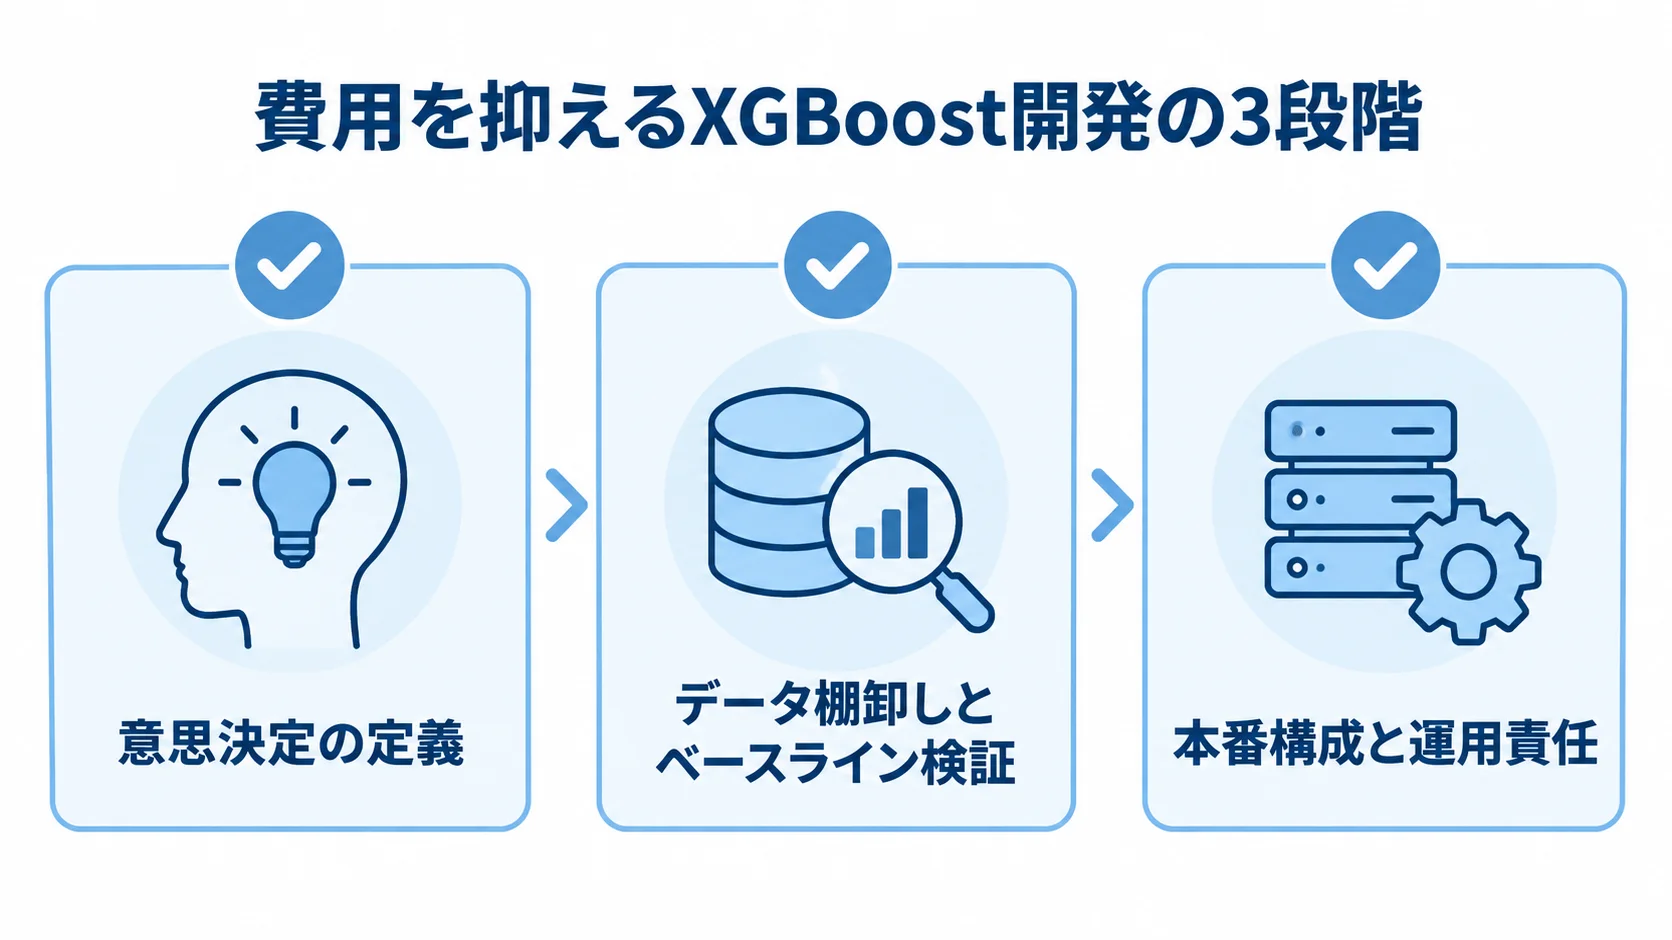
最初から本番用の大規模な基盤を発注するより、業務上の価値とデータの実現性を小さく検証する方が現実的です。
確認できた要件から段階的に本番へ移す方が、不要な投資を抑えやすくなります。また、PoCの段階から再利用できる成果物を意識しておかないと、同じ作業をやり直すことになります。
各段階の終了条件を決めて進めます。
予測ではなく意思決定の定義
投資判断につなげるには、「精度の高いモデルを作る」より先に、業務で何を変えるかを決める必要があります。たとえば、解約しそうな顧客へ何日前に連絡するか、需要予測を使って在庫や人員をどう変えるかです。
不正候補を誰が何分以内に確認するかも、決めておく必要があります。誤検知と見逃しのコストや許容待ち時間、予測結果を自動処理に使うか人が確認するかは、判断の材料になります。
ここまで決まると、評価指標と画面やAPIの範囲が明確になります。監視の範囲も、そこから決まります。
データ棚卸しとベースライン検証
データソースや更新頻度、過去期間を一覧にします。欠損や重複の状況、ラベルの作成方法、個人情報の有無も、同じ一覧に書き出します。
比較の基準(ベースライン)には、単純なモデルや現在の業務ルールを使います。XGBoostだけを有利に見せないよう、時系列で未来情報が混ざらないように検証します。
そのうえで、業務上の損失と予測指標を並べて見比べます。データ不足が分かった場合は、モデル開発を膨らませるより、記録方法の改善を先に契約する方が合理的です。
段階的な本番構成と運用責任
PoCで効果が見えたら、次に本番の構成を決めます。バッチかAPIか、クラウドかオンプレミスかを選び、モデルの登録先も決めます。データとモデルの承認者も、このとき決めておきます。
小規模なら、単一CPU環境や既存のDWHを使い、利用量が増えてからマネージドな学習・推論基盤へ移す方法もあります。
データを外部へ出せない場合や、既存の認証・監査基盤と統合する場合、長期の保守を自社で担う場合には、初期からオンプレミスやハイブリッドを設計します。構成は、現在の担当者が扱える範囲に合わせて決めます。
XGBoostのシステム開発費を抑える工夫
コストを最適化するには、単価の安い会社を選ぶことだけでなく、不要な機能を後回しにして、将来の作り直しを防ぐ設計にすることが大切です。
XGBoostは表形式データの予測によく使われ、学習の計算だけであれば、GPUが必ず要るとは限りません。
計算資源は、利用規模と時間制約をもとに選びます。
目的を絞った再利用しやすいPoC
最初は、価値を測りやすい一つの業務、一つのデータソース、一つの利用者群に絞ります。全社のデータを一度に統合するのは、後回しにしても構いません。
PoCで残した成果物は、本番の工程でも再利用できます。
- モデル資産:特徴量の定義と学習コードを保存します。
- 評価資産:評価データと評価方法の記録です。
- 実行資産:モデルの保存形式と実行手順を残します。
画面を作る前に、CSVや簡易ダッシュボードで予測結果を確かめる方法もあります。効果が見えない場合の中止条件を決めておくと、追加投資を抑えられます。
GPUとマネージドサービスの使いどころ
表形式データの小規模な学習は、CPUで処理できる場合があります。
- 高速化の検討条件:データ量や学習回数、許容時間を測り、CPUの待ち時間が業務要件を超える場合にGPUや分散学習を検討します。
- AWSの料金:利用時間に応じた従量課金です(出典: Amazon Web Services「SageMaker AI pricing」、2026年確認)。
- 継続利用:Savings Plansなどの選択肢もあります。
- 月額の算定:割引契約の前に、学習と推論の稼働時間、ストレージ、データ転送、監視まで含めて試算します。
既存のデータ基盤・認証・監視の再利用
DWHやデータレイク、ETLなどの既存基盤があれば、XGBoost専用の仕組みを重ねない方法を検討します。認証、ログ、CI/CD、監視基盤も、既存のものを使えないか確かめます。そのため、権限設計や障害通知の重複を減らせます。
Databricksの公式ドキュメントは2026年3月に更新されています。Runtime MLには、PythonとScalaのXGBoostライブラリが含まれます。
同ドキュメントでは、単一ノードと分散学習を選べると説明されています。既存の基盤に載せられれば、環境構築費を抑えられる可能性があります。
開発費と運用費を分けた比較
初期費用だけでなく、運用費も含めて比べます。
- 運用費の要因:月次の再学習やクラウドの常時稼働、監視で、総額が上がる場合があります。問い合わせやモデル評価、セキュリティ対応も、要因になります。
- 年間の目安:初期開発費の15〜25%程度です(出典:NotebookLMリサーチ「業務システム全般_15」、2026年)。
- 調整条件:再学習の回数や監視の範囲に応じて、費用を調整します。
- 比較項目:初期開発、月額基盤費、月次保守、再学習、追加モデル、障害対応に分け、1年目と2年目以降の総額を比べます。
XGBoostの見積もりを取る際の確認ポイント
見積もり依頼では、まず予測対象と利用者を整理します。そのうえで、データや判定頻度、業務での使い方も伝えます。
発注先がモデル開発だけを想定するのか、業務システムまで対応するのかをそろえてから、複数社を比べます。
発注前に整理する情報
予測したい事象や現在の判断方法、期待する業務効果、データソース、過去データの期間をまとめます。1日あたりの件数や更新頻度、ラベルの有無、個人情報や機密情報を含むかも整理します。
利用者数や許容待ち時間、バッチかAPIかを記載します。利用クラウドや連携先、手動確認の有無、必要な説明、希望時期も書いておくと、前提がそろいます。PoCか本番までか、保守を委託するか自社で担うかも明記してください。
見積の項目と前提条件のそろえ方
各社の見積は、要件定義、データ整備、ラベル作成、特徴量設計、モデル開発、評価に分けてもらいます。API・バッチや画面、インフラ、権限は、別々の項目として書いてもらいます。セキュリティテストや監視、教育、保守も、項目を分けて示すよう求めます。
人月や期間、担当職種、成果物は、各社で同じ粒度がそろっているか確かめます。検収条件や対象外作業、追加作業の単価も確認しておきます。「データは支給済み」「APIは別途」「監視はクラウド標準のみ」などの前提があると、総額を誤りやすくなります。
価格だけでなく、同じ範囲の成果物を比べることも大切です。
開発会社へ確認する質問
「XGBoostを使ったことがありますか」と聞くだけでなく、本番で誰が結果を確認し、精度の低下をどう検知したかを尋ねてください。学習データとモデルの版管理方法についても、確かめておきます。
再学習の条件と承認者、API障害時に業務を止めない方法も聞いておく必要があります。XGBoost専用の実績が公開されていなくても、データ基盤やMLOps、既存業務システムとの連携の実績が、要件に合う場合があります。
精度の数値だけを示して、運用や保守、責任分界を説明できない場合は、注意が必要です。
よくある質問
費用の目安は、前提条件によって変わります。ここに示す数字は固定価格ではないため、データや運用範囲と合わせて確認してください。
XGBoostのライセンス費用はかかりますか?
XGBoostはオープンソースの機械学習ライブラリで、商用ライセンスの購入が必ず発生するわけではありません。ただし、データ整備やモデル開発、クラウド・サーバーには費用がかかります。API、画面、監視、保守も、費用の対象になります。
OSSの利用条件や依存ライブラリ、脆弱性対応、サポート窓口の責任分界は、導入前に開発会社と確認しておく必要があります。
XGBoostの開発にGPUは必要ですか?
小規模な表形式データや、学習の頻度が低い用途では、CPUで足りる場合があります。一方で、大規模データや多数の並列探索、厳しい学習時間の制約がある場合は、GPUや分散学習を検討します。
GPUは処理時間を短くできる可能性がありますが、データ転送やメモリの制約、アイドル時間も比べる必要があります。先にCPUで基準時間を測り、削減費用と導入費を比較します。
PoCと本番開発の費用はどう違いますか?
PoCと本番開発では、確認・実装する範囲が変わります。
- PoC:手元のデータで予測可能性と業務効果を確かめ、目的に応じて50万〜800万円程度になります。
- 本番開発の範囲:定期データ連携や、APIまたはバッチ、画面、権限、ログが必要です。監視や障害対応、再学習、教育も含まれます。
- 本番費用:800万〜2,000万円以上まで広がります。
- 再利用する成果物:コード、データ定義、評価方法、モデル保存、未解決課題を納品物に含めます。
運用保守費は初期費用の何割ですか?
一般的な業務システムでは、目安として初期開発費の年間15〜25%程度を起点に考えられます。
XGBoostでは、再学習の回数や監視の範囲、クラウドの常時稼働、問い合わせ対応、精度評価、データ変更への対応によって変わります。
月次の再学習と四半期ごとの評価では、工数が異なります。保守契約には、監視の対象、再学習の判断値、精度劣化や障害時の担当者を明記するとよいでしょう。
まとめ
XGBoostの開発費は、技術検証・簡易PoCで50万〜300万円、業務部門向けPoCで300万〜800万円です。
小規模な本番で800万〜2,000万円、複数部門・基幹連携型で2,000万〜5,000万円以上が、推定の幅です。
XGBoostの費用は、ライセンス料ではなく、システム全体で捉えます。データ整備やモデル評価、APIやバッチ、業務画面の費用が含まれます。さらに、インフラや監視、保守も同じ範囲で見ます。
価格帯と変動要因のセット確認
XGBoost専用の公表統計はないため、業務システムやAI基盤の価格例を参考に、相場を推定しています。
- 推定の根拠:業務システムの人月単価・工程とAI基盤の公開価格例です。
- 価格例の見方:XGBoost専用の価格ではなく、基盤とアプリを分けて見積もるときの参考です。
エフサステクノロジーズの公式資料には、GPUドライバーや学習フレームワークの導入が30万円〜の例として載っています。さらに、GPUリソース管理環境の設計・構築は300万円〜です。
AIアプリ開発支援は300万円〜、運用Q&A対応は年間150万円〜です。いずれも個別見積の例です(出典:エフサステクノロジーズ「AI開発環境・GPUリソース管理」、2024年公開)。
小さな検証と分解した見積
まずは、予測対象と業務効果を絞り、データの状態を確かめます。そのうえで、CPUや既存基盤で実現できる範囲を測ります。
- 開発範囲:PoC、本番化、運用保守を分けて見積もります。
- 責任分界:データ品質や推論方式、セキュリティ、監視、再学習について、担当を決めます。
- 効果検証:自社データで性能と費用を測り、その結果を判断基準にします。
Databricksが紹介するShutterflyの事例では、XGBoostの学習と推論を分散処理しました。その結果、少なくとも20倍短縮したとされています(出典:Databricks Community、2025年)。
題名は「Scaling Machine Learning with Ray and Databricks: A Shutterfly Use Case」です。
これは特定環境のベンダー事例なので、自社の案件にそのまま当てはめることはできません。XGBoostを使うこと自体を目的にせず、予測結果を誰がどの業務で使うかを決めます。
許容する誤判定と稼働後の改善方法を決めておくと、費用と開発範囲を見積もりやすくなります。データやモデル、業務連携、運用を一体で比べたうえで、自社に合う開発会社へ相談してください。
▼全体ガイドの記事
・XGBoostのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。