
XGBoostのシステム開発では、予測の対象と、予測結果を業務へ返すタイミングを決めることが出発点になります。そのうえで業務データに合わせて設計すると、予測を業務の判断に生かせます。
▼関連記事一覧
・XGBoostのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・XGBoostのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・XGBoostのシステム開発の見積相場や費用/コスト/値段について
・XGBoostのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
XGBoostのシステムの概要
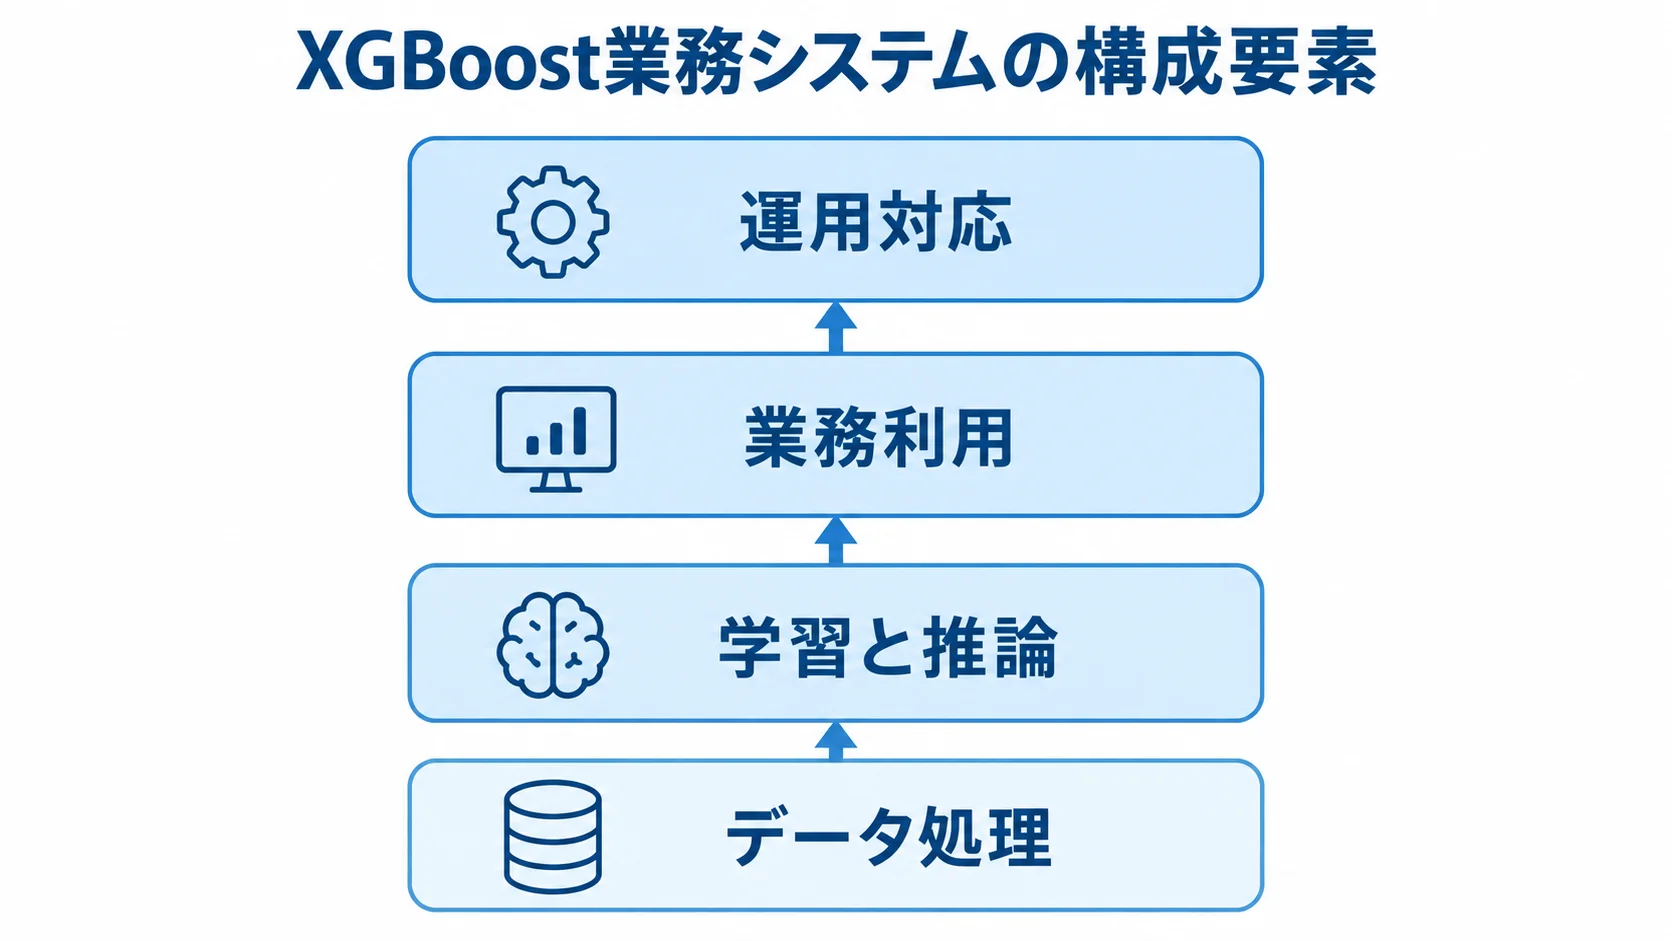
XGBoostのシステムは、データを集めて学習する部分と、学習済みモデルを業務で使う部分で構成します。ただし、精度だけを見て作ると、データが届かない、予測結果を誰も見ない、精度の低下に気づかないといった問題が起こります。
XGBoostの予測エンジンとしての役割
XGBoostは、複数の決定木を順に組み合わせ、前の予測の誤差を次の木で補正していく勾配ブースティングのライブラリです。
- 予測内容:分類では解約確率や不正の可能性、回帰では需要量や売上が対象になる
- 順位付け:ランキングで検索結果や推薦候補の並び順を予測する
- 使うデータ:顧客属性、購買履歴、設備センサー値などの表形式データ
業務目的と正解ラベルは、人が先に定めておく必要があります。
解約予測であれば、対象期間、休眠との区別、予測後の営業対応を決めておきます。特に、モデルの選択より、予測対象と業務アクションの設計が成果を左右します。
業務システム化に必要な構成要素
業務で使うには、収集から業務画面への連携までをつなぎ、データ品質とモデルを運用する仕組みが必要です。
- データ処理:収集、欠損・重複の整理、特徴量作成
- 学習と推論:学習ジョブ、モデル登録・版管理、推論APIまたはバッチ
- 業務利用:業務画面との連携、データ品質・精度・ドリフトの監視
- 運用対応:処理失敗や応答時間の監視、再学習、ロールバック
業務システムに必要な要素は、「入力」「学習」「モデル管理」「推論」「業務活用」「監視」の六つに分けると整理できます。
PoCでは、入力データと学習・評価を小さく試します。一方で、本番化では認証や権限、ログを加え、障害対応やデータ保存期間も決めていきます。
XGBoostでできることとシステムの種類
XGBoostのシステムは、予測対象と結果を返すタイミングで分類できます。
業務データの定期処理は作りやすい一方で、受付や設備監視など数秒以内の判定では、API設計と障害対策を先に固める必要があります。
需要予測・解約予測・不正検知への活用
需要予測、解約予測、不正検知は、いずれも業務データを使って判断の材料を作る用途です。
- 需要予測:販売実績、曜日、季節、価格、販促、在庫から需要量を見積もる
- 解約予測:利用頻度、問い合わせ、契約期間、支払い状況から優先フォロー対象を抽出する
- 不正検知:金額、時間、頻度、端末、過去の行動との差から確認取引を絞る
このほか、設備故障の予知、製造品質の異常検知、人材や案件の成約確率、問い合わせの優先順位付けにも利用できます。
予測は、人の判断を補助するものです。そのため、誤判定の損失が大きい場合は、自動での拒否や処分より、人が確認する候補の提示から始めると安全です。
バッチ型とリアルタイム型の使い分け
方式は、予測結果を返す時点に合わせて選びます。定期的な需要計画であればバッチ型、入力直後の判定であればリアルタイム型が候補になります。
- バッチ型:日次や時間単位で足りる業務向けです。データ基盤から対象を抽出して定刻に推論し、需要計画や翌日の営業リストに使います。
- リアルタイム型:申込受付、決済、不正アクセスを、APIで入力直後に判定する
バッチ型は、APIを常時稼働させずに済むため、初期構成と運用費を抑えやすい方式です。
リアルタイム型では、入力の検証、タイムアウト、再試行を設計します。
加えて、異常時の代替処理も用意し、APIの応答が遅くても業務を止めないようにします。予測できない場合は、人の確認へ回すルールも決めておきます。
画像・音声・長文を扱うときの別構成
入力データの種類によっては、前処理を加えたり、XGBoost以外の方法を検討したりする必要があります。
- 画像・音声・長文:表形式データに強いXGBoostも、生データを扱う用途では第一候補になるとは限らない
- 二段構成:画像の特徴量、音声の周波数情報、文章のベクトルを表形式にして使う方法が適する場合がある
- 機械学習の要否:単純な集計や明確なルールで足りれば、機械学習を使わない方が保守しやすいこともある
- 採用判断:データ量、正解ラベル、予測後の施策、説明責任、誤判定コストを比べる
XGBoostのシステム開発の進め方
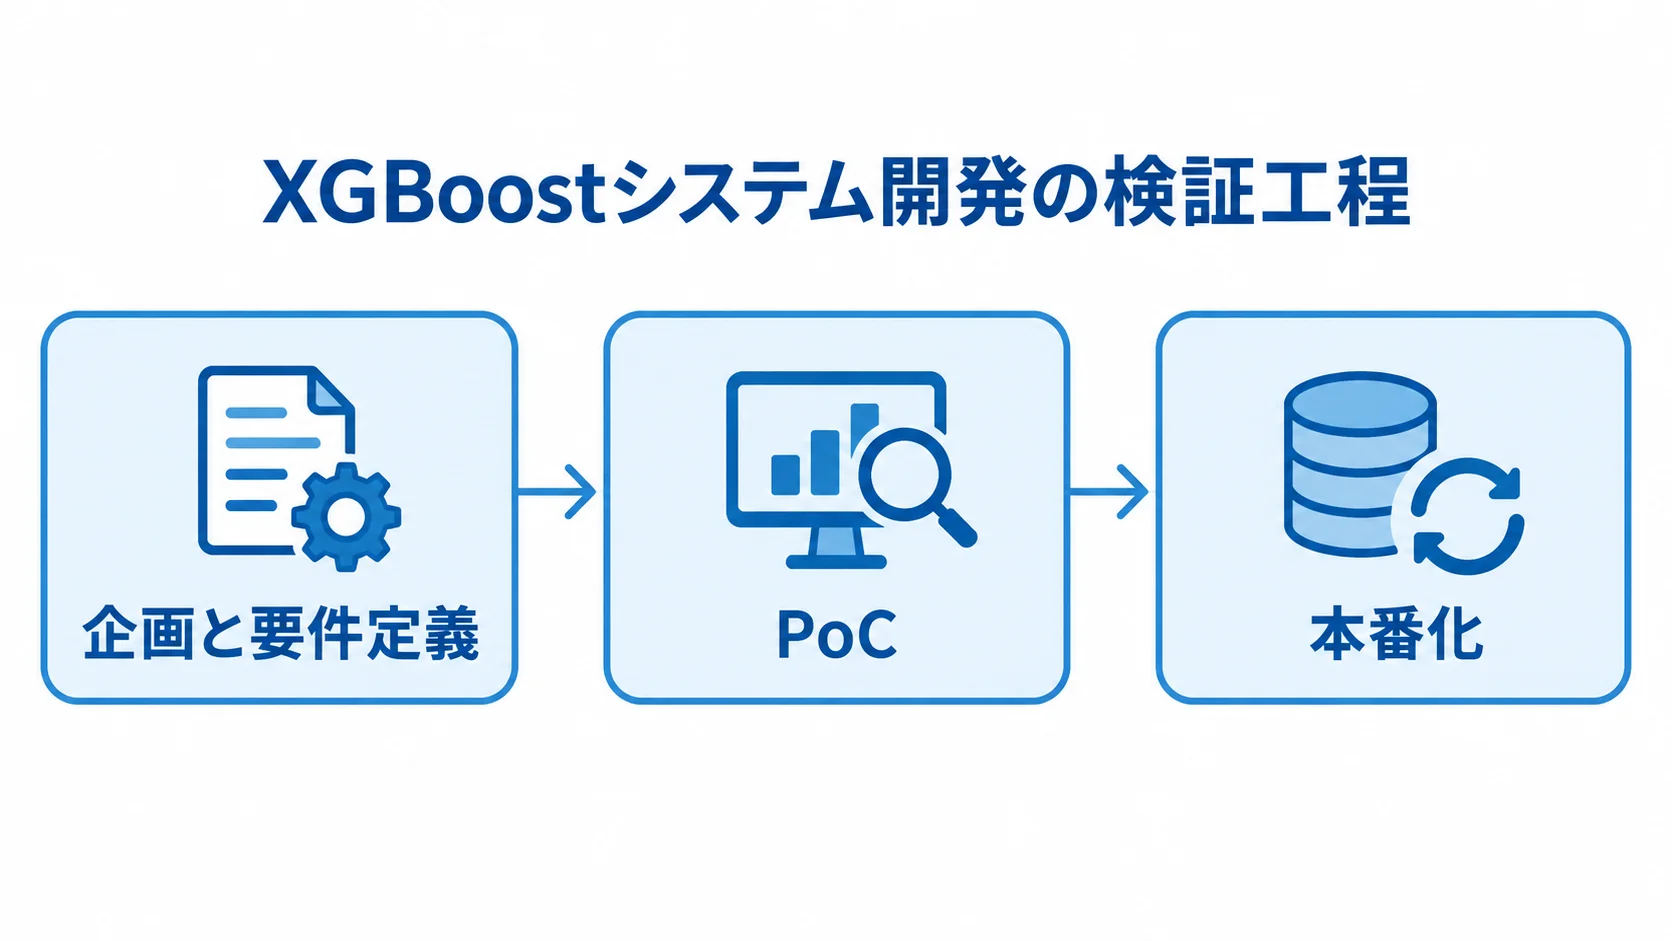
開発は、精度の高いモデルを一度作るだけでは終わりません。開発では、目的、データ、モデル、業務連携、運用の順に検証を重ね、本番で予測を使える状態へ仕上げていきます。また、工程ごとに成果物と中止条件を決めておくと、PoCの長期化を防げます。
▶ 詳細はこちら:XGBoostのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
企画と要件定義での予測の使い道
最初に、誰がいつ、どの判断のために予測を見るのかを明確にします。
- 業務KPI:「精度を上げる」だけでなく、接触率、欠品削減、審査時間短縮などに置き換える
- 判断条件:見逃しと過検知のどちらを優先するか、許容レイテンシ、説明項目、手動で上書きできる範囲を決める
- データの洗い出し:データソース、更新頻度、保管場所、個人情報、過去データの期間、ラベル作成者を一覧にする
正解ラベルがない場合は、業務担当者と定義を決め、一定数のサンプルを人手で確認します。また、学習時だけの情報を使ってしまう時系列リークにも注意します。
PoCでのベースラインと業務価値の検証
PoCでは、本番画面は作らずに、代表データで特徴量、学習、評価を試します。
- 比較:単純なモデルを基準にして、XGBoostによって業務上の改善があるかを確かめる
- 評価指標:分類は適合率・再現率・F1・AUC、回帰はMAE・RMSEなどを候補にし、業務損失と結びつける
- データ分割:ランダム分割だと将来の性能を高く見積もることがあるため、時間順に発生する業務では時系列分割を使う
- 不均衡データ:少数クラスの再現率と混同行列を見る
- 終了条件:精度だけでなく、現場が予測を見て行動できるか、必要なデータを継続取得できるかで判断する
本番化での連携・監視・再学習の実装
本番では、学習と推論で同じ特徴量の定義を使えるようにし、運用記録と監視の仕組みを用意します。
- 共通処理と記録:特徴量処理を共通化し、データセット、前処理コード、XGBoostの版を残す。加えて、パラメータ、評価値、承認者、リリース日時も控えておく。
- 切り戻し:記録を残しておき、問題が起きたときに過去のモデルへ戻せるようにする
- 監視:欠損率、値の分布、ドリフト、予測分布を確認する。実績との差、API応答時間、ジョブ失敗も見ておく。
- 再学習の承認:学習の処理は自動化できますが、業務への反映の承認まで自動化するかは、リスクに応じて決めます。
正解値の確定が遅い業務では、まずデータ品質とドリフトを確認し、精度は正解値が確定してから確かめます。
XGBoostのシステム開発費用相場
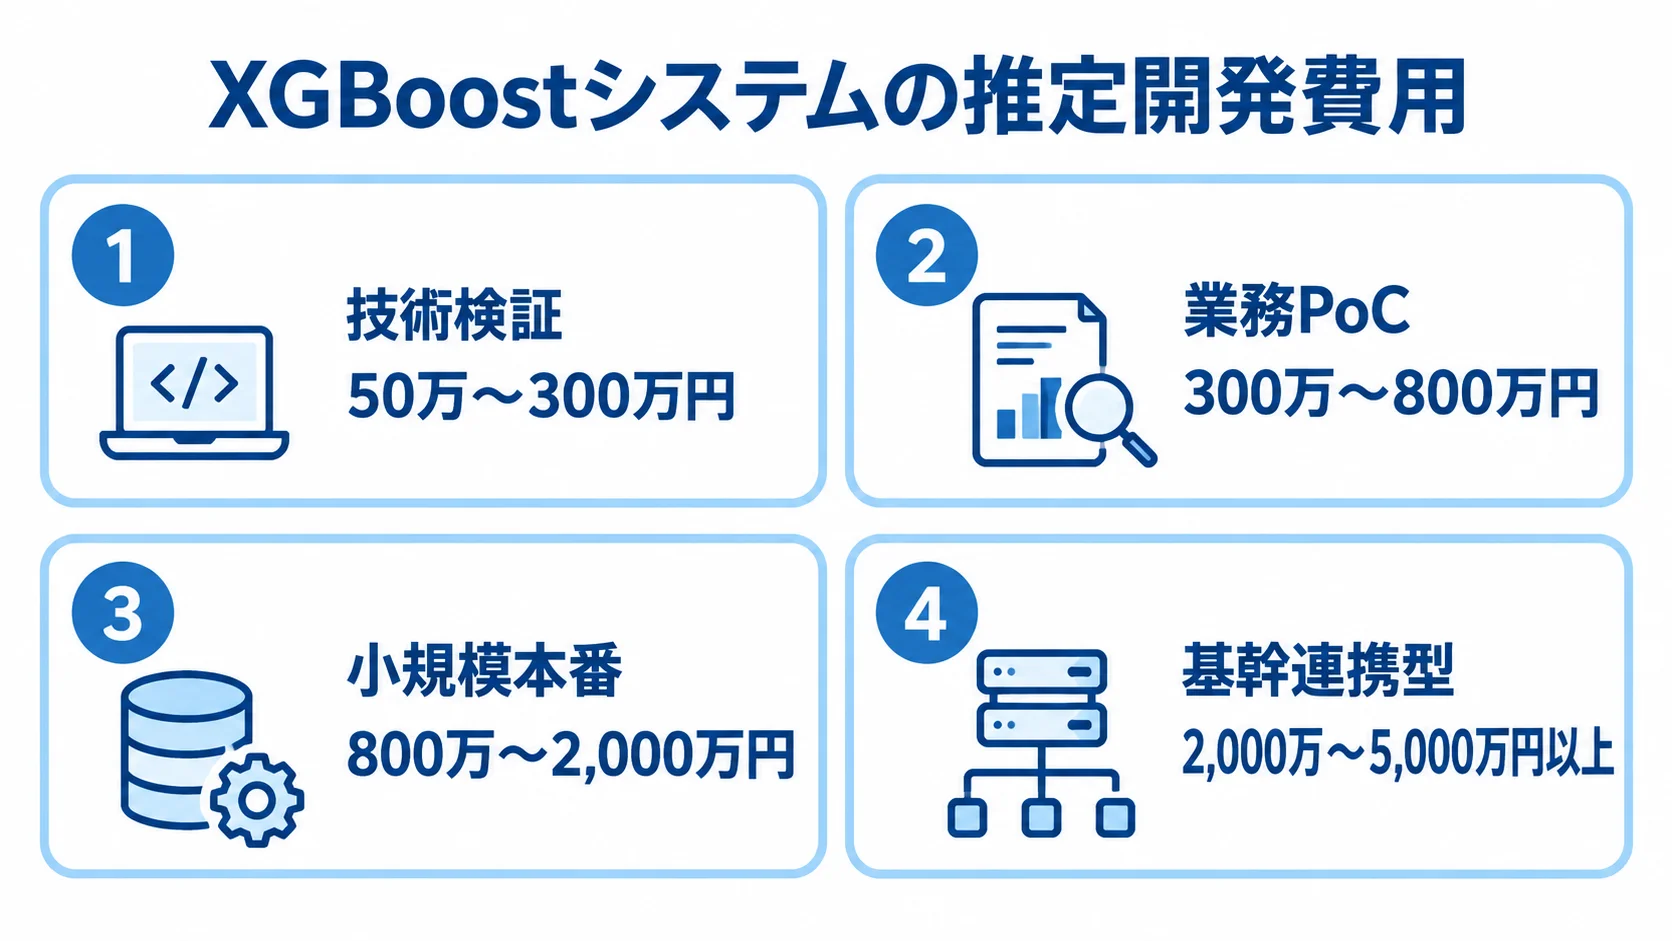
XGBoostはオープンソースのため、中心となる費用はライセンス費以外にあります。その中身は、データ整備やラベル設計、特徴量の作成と評価です。このほか、連携とインフラ、監視・保守の費用がかかります。
ここで示す金額は、業務システムの人月単価と工程をもとにした推定で、確定価格ではありません。
▶ 詳細はこちら:XGBoostのシステム開発の見積相場や費用/コスト/値段について
▶ 詳細はこちら:XGBoostのシステム開発の発注/外注/依頼/委託方法について
技術検証と業務PoCの費用目安(50万〜800万円)
技術検証と業務PoCでは、含まれる作業と成果物が異なります。
- 技術検証の費用・期間:整ったデータで特徴量を試作しモデル比較する場合、50万〜300万円程度、1〜2か月ほど
- 技術検証の範囲:簡易評価レポートまでで、画面や本番監視は含まれない。データ整形やラベル作成を頼むと、費用が範囲を超えやすい
- 業務PoCの範囲:複数データの抽出、ラベル設計、学習・評価、簡易ダッシュボードやバッチ出力を含む
- 業務PoCの費用・成果:300万〜800万円程度、2〜4か月ほどです。報告書には、精度と業務効果、追加データ、運用負荷を残します。
小規模本番の費用目安(800万〜2,000万円)
本番化では、連携や運用機能の範囲によって、費用と期間が変わります。
- 小規模本番の機能:ETL、特徴量処理、モデル版管理、APIまたはバッチ推論を実装する。加えて、権限、ログ、画面連携、再学習手順も含める。
- 小規模本番の費用・期間:初期費用は800万〜2,000万円程度、期間は3〜6か月ほどです。既存の認証や監査ログとつなぐ場合は、調査とテストが加わります。
- 基幹連携型:複数部門のデータや基幹のリアルタイム連携、冗長化、監査証跡、運用SLAが要るなら、2,000万〜5,000万円以上になる可能性があります。
- 費用が増える要因:モデルの複雑さより、連携や可用性、セキュリティ、移行、運用設計の範囲が広がることです。
運用費と再学習・監視の設計
運用費は、保守に加えて、学習と推論の環境、データ量の設計によって変わります。保守費は、XGBoostの再学習の頻度とデータ量で増減するため、固定の率に頼らず、それらを見て見積もります。GPUは必須ではなく、学習頻度、データ量、分散学習の必要性から費用対効果を確かめます。
- 運用費の対象:計算資源、データとログの保存、監視、問い合わせと障害対応を含みます。再学習や評価、セキュリティ更新も含まれます。
- 保守費の目安:一般的な業務システムでは、初期開発費の年間15〜25%を起点にすることがあります。
- CPU・GPUの選択:中規模の表形式データなら、CPUで十分な場合があります。
公式文書でも、CPU・GPU・分散学習・推論を分けて選ぶことが前提になっています(出典:クラウド機械学習サービス公式ドキュメント、2026年確認)。
クラウド・オンプレミス・スクラッチの選び方
実行基盤は、データの所在やセキュリティ、処理量を基に決めます。加えて、人材や既存の認証・監査の仕組みも踏まえます。
最初から大規模な基盤を用意せず、PoCは小さく始めます。本番の要件が固まってから可用性や分離を加えると、過剰投資を抑えやすい進め方になります。
マネージド型の特徴と注意点
マネージド型は、インフラの構築や更新を減らし、PoCから本番への移行を後押しします。
- 利用できる機能:学習ジョブ、モデル登録、オンラインとバッチの推論、実験管理を組み合わせられる
- 利用料:データ転送、常時稼働のエンドポイント、ログ、モデルレジストリに注意する
- 対応環境:2026年時点の公式文書ではXGBoost 3.0系など複数版があり、CPU・GPU・分散学習に対応する例がある
- バージョン管理:latestに頼らず、XGBoost、Python、CUDA、推論形式を明示する
版によって、対応するインスタンスやデバッガー、入力形式は異なります。
たとえば、XGBoost 3.0.0は2025年2月27日に公開され、外部メモリの扱いなどが更新されました(出典:XGBoost公式リリースノート、2025年)。
オンプレミス・ハイブリッドの管理範囲
データの制約や既存の環境によっては、オンプレミスや閉域のハイブリッド構成も検討します。
- 適する条件:個人情報、機密情報、製造データを外部へ持ち出せない場合
- 管理範囲:既存の認証、ネットワーク、バックアップ、監査ログは使えることがあります。一方、GPU、ドライバー、学習環境、脆弱性対応は自社か委託先が管理します。
- 構成と契約:データとモデルの保管先、推論結果の経路を図にする。障害時の切り替えや削除証跡、再委託、契約終了時の返却・消去も要件に含める。
セキュリティとガバナンスの設計
セキュリティとガバナンスは、設計の段階から運用や契約まで通して確認します。
- 基本対策:入力データを必要最小限にし、暗号化や権限、秘密情報の扱いを決める。環境分離、監査ログ、脆弱性対応も設計時に確認する。
- 影響の大きい判断:人事、与信、取引制限に使う場合は根拠表示、手動確認、異議申立て、判断履歴の保存を用意する
- ガイドライン:AI事業者ガイドライン第1.2版を参照し、対応を検討する
同ガイドラインは、リスクに応じたガバナンス、透明性、セキュリティを整理しています。ただし、XGBoostに一律の手続きを課すものではありません。
目的や責任者、データ管理、事故対応、委託先との分担を、契約や規程に落とし込むときに参照できます(出典:経済産業省「AI事業者ガイドライン第1.2版」、2026年)。
開発会社・ベンダーの選び方
開発会社を比べるときは、XGBoostを使ったという言葉だけで判断しません。モデルの技術力に加えて、データ基盤やAPI・バッチ、業務画面まで一貫して設計できるかを見ます。
加えて、セキュリティやMLOps、保守まで含めて設計できるかも確かめます。公開実績がXGBoost専用でない場合でも、実装の範囲と、再学習や精度監視の担当を尋ねます。
実績の確認範囲(本番運用まで)
実績を見るときは、モデルの構築だけでなく、運用期間中の対応まで確かめます。
- 導入実績:入力データと予測対象、推論頻度、利用者数を尋ねる。精度指標や稼働期間、障害対応も聞いておく。
- 確認資料:顧客名や数値が非公開でも、匿名化した構成図や工程表、テスト項目、運用体制を見る
- 運用責任:ドリフト検知、再学習の頻度と評価、承認者、切り戻し、問い合わせ窓口を契約前に決める。運用期間中の責任の分け方が明確な提案を選びます。
見積の内訳と担当チーム
見積もりは作業を一式にまとめず、範囲と工数、前提を分けてもらいます。さらに、除外作業や追加単価、検収条件も、項目ごとに示してもらいます。
- データ・モデル:データの確認、ラベル作成、特徴量、学習と評価
- システム:API、画面、インフラ、セキュリティテスト
- 運用:監視、教育、保守
チームには、業務担当や管理者に加えて、データサイエンティストやデータエンジニアが関わります。また、アプリケーションやインフラ・セキュリティの担当も加わります。
少人数の体制でも、ラベル定義、本番リリース、障害時の判断を誰が承認するかを決めておきます。業務システムの責任を、データサイエンティストだけに負わせないようにします。
発注前にRFPへ書く項目
発注の前に、提案、契約、運用の前提を、RFPと契約条件にまとめておきます。
- 予測要件:予測の対象と時点、使うデータとラベル、件数を記載する。さらに、更新頻度、誤判定の許容、説明要件、利用者と権限も書く。
- システム要件:既存連携、クラウド可否、保存場所、納期、保守範囲を示す。データ未整理なら、データ評価を最初の成果物とし、扱いも決める。
- 成果物の権利:ソースコード、学習済みモデル、特徴量処理、IaC、文書について、権利と引き渡しの範囲を確認する
- 契約・終了条件:再委託やOSSライセンス、個人情報の扱い、事故通知を明確にする。サービス終了時のデータ消去とモデル廃止の方法も決める。
- 要件不足の影響:定義を削りすぎると、追加連携やデータ品質の問題が本番前に見つかり、見積もりが膨らむ可能性があります。
▶ 詳細はこちら:XGBoostのシステム開発でおすすめの開発会社/ベンダー6選と選び方
よくある質問(FAQ)
XGBoostの導入で多い疑問を、発注と運用の観点から回答します。自社のデータや業務のリスクに応じて、必要な調査を加えてください。
XGBoostのシステムはデータが少なくても作れますか?
作れる可能性はありますが、件数だけでなく、正解ラベルの品質と予測事象の発生数を見ることになります。
データが少ない場合は、単純なモデルと比較し、時系列分割や交差検証、信頼区間の確認を行います。
本番での自動化より、まずは参考表示から始めると安全です。また、データを追加したときの改善可能性も、PoCの成果物に含めます。
XGBoostのシステム開発にGPUは必要ですか?
表形式データが小規模で学習の頻度も低ければ、CPUだけで足りる場合があります。GPUは必須ではありません。
GPUは学習時間を短縮できる一方で、利用単価や環境管理の手間が増えます。選ぶ際は、学習時間、実行回数、納期、推論量を測って比べます。
先にCPUでベースラインを作り、GPU導入の効果を比べる方法が現実的です。
モデルの精度が下がったらどうすればよいですか?
精度が下がったら、まず入力の欠損や項目定義の変更、分布の変化を確認します。連携の失敗やラベル確定の遅れも見ます。
ドリフトが原因の場合でも、再学習で解決するとは限りません。特徴量や業務ルール、閾値を見直すことや、切り戻しも検討します。
監視条件と対応者を事前に決めておくと、異常を見過ごさずに済みます。
PoCから本番化できない主な理由は何ですか?
PoCのデータを本番で取得できない、ラベル定義が合意されない、利用担当や画面が決まらないことが主な理由です。
監視や再学習の責任者がいない場合もあります。開始時点で、本番の入力経路と利用者を確かめ、業務KPIとセキュリティ条件も決めておきます。
何を納品すれば移行できるかを定めておくと、検証を本番につなげやすくなります。
まとめ
XGBoostのシステムは、モデルだけでなく業務基盤全体を指します。データ収集と特徴量の作成から版管理を経て推論に至り、業務画面、監視、再学習までを範囲に含みます。
需要予測や解約予測、不正検知、故障予知などに使えます。一方で、画像や長文では、別のモデルや二段構成が適する場合もあります。
目的とKPI、データの洗い出し、PoC、本番設計、段階リリースの順で進めます。費用は、技術検証が50万〜300万円、業務PoCが300万〜800万円です。
さらに、小規模本番は800万〜2,000万円、基幹連携型は2,000万〜5,000万円以上が推定レンジです。見積もりでは、データ整備、連携、監視、保守を分けて考えます。
精度だけでなく、誤判定のコストや説明責任、再学習、責任の分け方も確認してください。
▼関連記事一覧
・XGBoostのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・XGBoostのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・XGBoostのシステム開発の見積相場や費用/コスト/値段について
・XGBoostのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。