
XGBoostのシステムは、業務目的とデータを決めたうえで、モデル開発、推論との連携、監視と再学習の順に整理して発注すると、予測結果を現場で使い続けられます。発注側は、予測の結果を誰が使うのかまで含めて、各段階の範囲を決めておく必要があります。
▼全体ガイドの記事
・XGBoostのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
XGBoostのシステムを発注する前に知るべき全体像
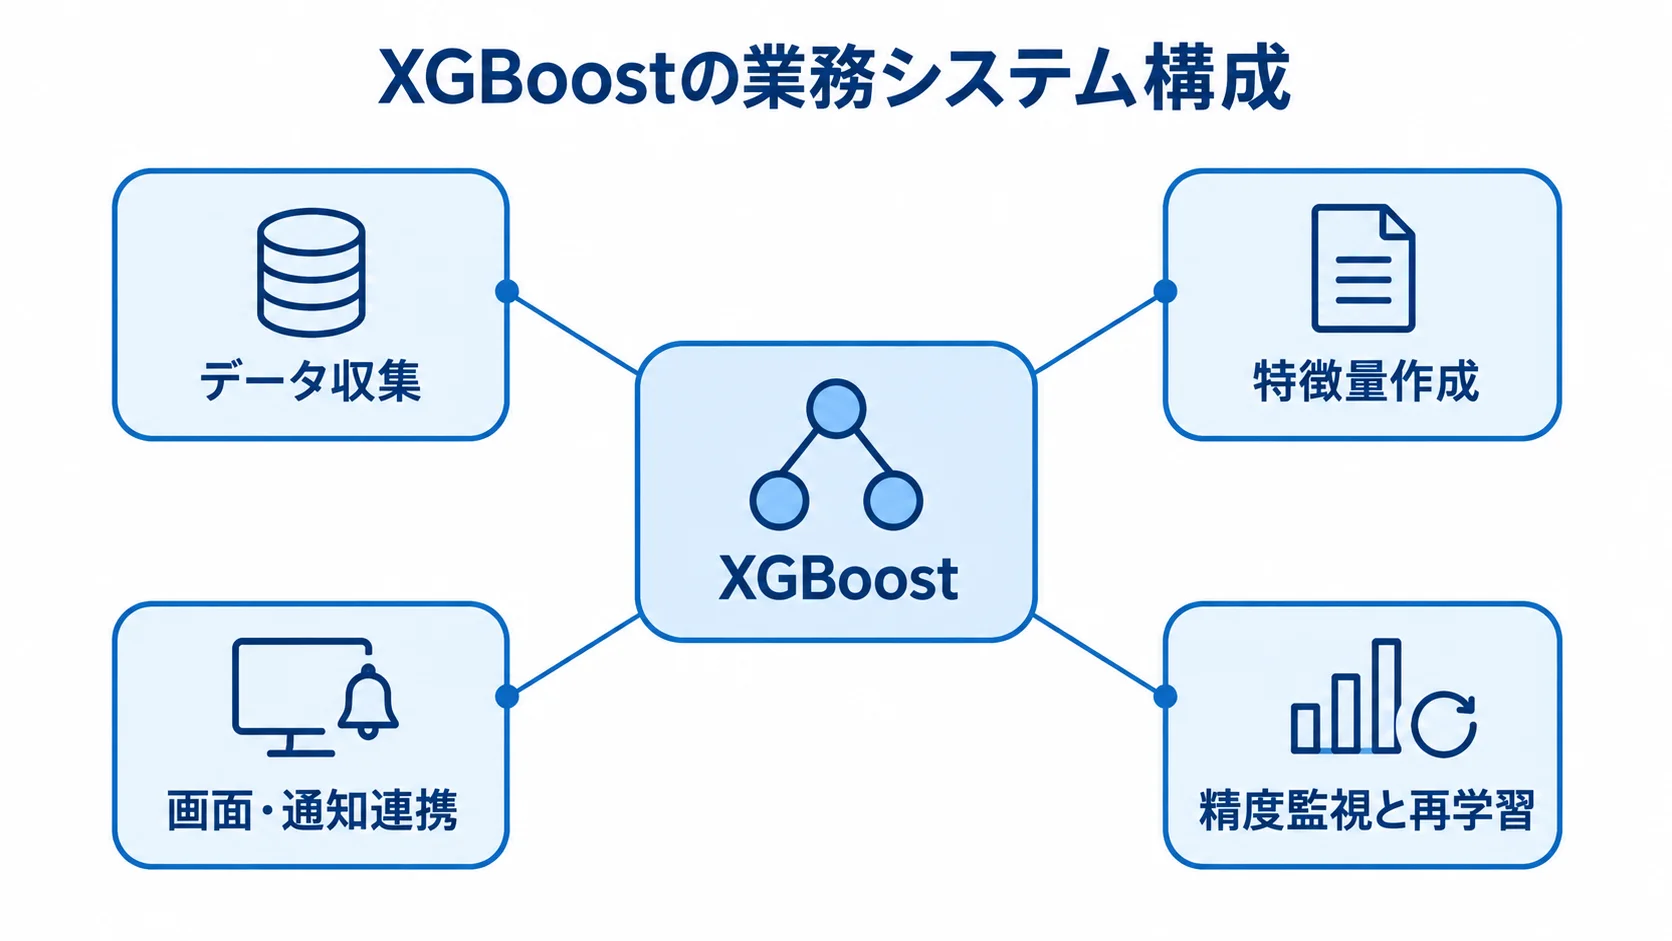
発注の依頼文が「XGBoostを使った予測モデルを作ってほしい」の一文だと、本番開発まで含む範囲を判断しにくくなります。XGBoostは予測を行うエンジンで、業務システムとして動かすには、データ収集や特徴量の作成、モデルの登録が必要です。さらに、推論や画面、通知との連携も求められます。
精度監視と再学習の手順も、あわせて設計しておく必要があります。そのため、発注する側は、アルゴリズムの採用とシステム開発を分けずに考えます。
XGBoostの導入だけでは残る業務システムの範囲
学習データからモデルファイルを作る工程と、予測を現場で使う工程は別物です。たとえば解約予測では、顧客情報を毎日取得し、予測対象日より後の情報を除いて特徴量を作ります。
確率を顧客一覧に表示するとき、根拠も併せて示せるようにします。さらに、手動上書き、保存、再実行の方法と、失敗時の通知を決めておきます。これらが欠けると、モデルが動いていても業務が止まる場合があります。
納品範囲には、学習コードとデータ項目一覧、特徴量定義を含めます。モデルの版と評価結果、APIまたはバッチも納品に入ります。ログ、監視、運用手順も欠かせず、学習データと設定を記録しておけば、担当者が異動した後も再現できます。
表形式データの予測と業務アクションの結び付け
XGBoostは、表形式データによる分類・回帰・ランキングに向いています。入力には、顧客属性や購買履歴、設備センサーが当たり、取引履歴も使えます。たとえば解約や需要の予測に使え、故障兆候や問い合わせの優先度も対象になります。
予測結果は、営業連絡や在庫補充、点検につなげます。審査や通知へ渡す場合もあります。一方で、画像や音声を入力する場合は、別のモデルで特徴量を抽出して渡す構成も検討します。
発注前に、予測の後で誰が何をするかを決めておきます。画面がない場合や通知が多すぎる場合は、現場に定着しにくくなります。誤判定を直せない場合や、根拠を説明できない場合も同じです。
- 評価条件:見逃しと過検知、それぞれの損失の大きさ
- 運用条件:許容レイテンシと判断期限、人的レビューの有無
XGBoostのシステムの発注形態の選び方
発注形態は、開発費だけでなく、業務の整理と意思決定を誰が担えるかで選びます。データサイエンティストだけに依頼するか、基盤やAPIまで作れる会社へ一括で頼むかによって、負担と、どこまでを誰が受け持つかが変わります。
PoCと本番開発を分けて発注する方法もあります。判断の材料は、自社の技術責任者の有無と、既存の基盤です。
一社へ一括発注する場合の窓口と責任
企画から保守までの工程を一社にまとめる方法は、技術責任者が少ない自社に向いています。データ、機械学習、アプリの担当者とPMが同じ計画で動くため、責任が抜けにくくなります。
一方で、一社への依存が強いと、提案や見積の妥当性を判断しにくくなります。契約では、担当範囲と責任分界をはっきりさせます。
- 契約条件:再委託やクラウドの扱い、ソースコード、モデルや学習データの権利、保守終了時の引き継ぎ
- 作業範囲:「AI開発一式」に、データ整備や監視、画面が含まれるかを分けて確認する
複数社へ分割発注する場合の専門性と全体管理
データ基盤は既存のベンダー、モデルは機械学習の会社、画面と認証は開発会社に分ける方法があります。この方法では、DWHや基幹システムの既存担当を生かせ、専門性の高い会社を選びやすくなります。
ただし、全体の設計と総合テストは自社が管理する必要があります。特徴量作成側とAPI側で、項目名や欠損値の扱い、入力順がずれると、本番で誤予測につながります。
全体責任者を置き、共通文書には、データ項目とモデルの入出力を書きます。さらに、エラー時の再送と障害時の連絡順も記載します。
不確実な場合の調査とPoCの先行発注
正解ラベルがない、データ期間が短い、重視する指標が未定な場合は、本番開発の前に小さな調査を依頼できます。調査では、データの洗い出しやラベルの定義、特徴量の試作を行います。単純モデルとの比較、精度評価、業務ヒアリングも含みます。
PoC後に本番へ進まない場合でも、成果物を受け取れる契約にしておきます。成果物には、品質課題、評価データの期間と指標、再現用コードが含まれます。モデルや未解決事項があれば、次の会社へ引き継げます。
成功条件を精度だけにせず、業務改善の効果と本番化の条件も合意します。
RFPと要件を整理してXGBoostの発注範囲を明確にする方法
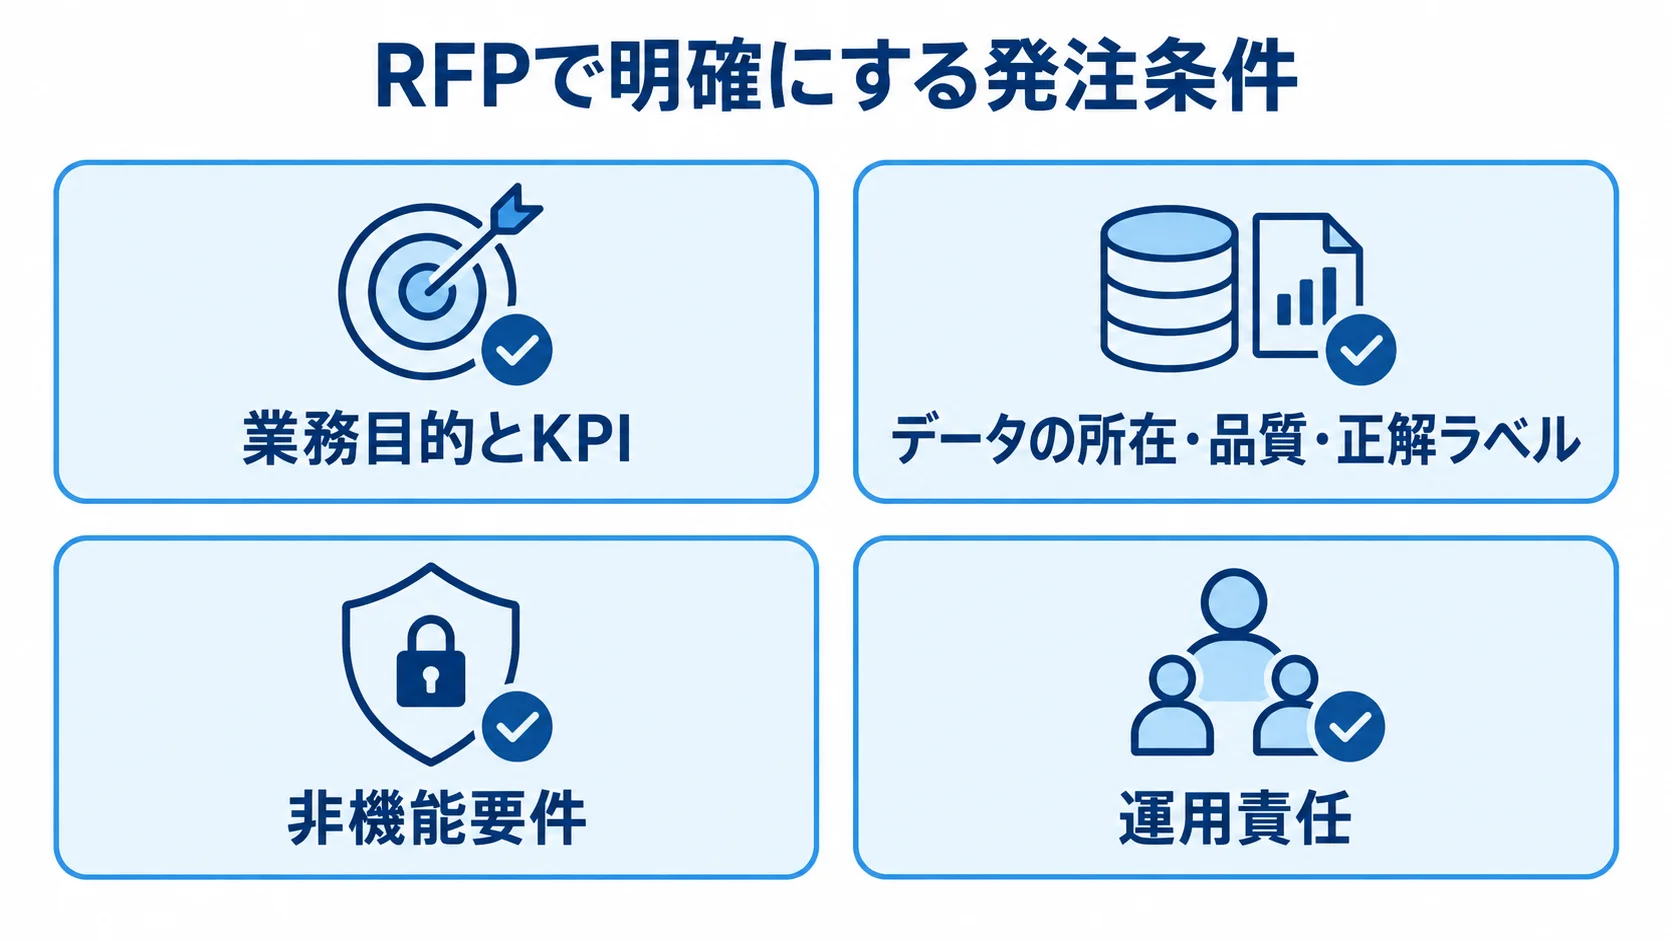
RFPは、開発会社へ前提を伝える資料です。業務目的、データ、対象ユーザーを書きます。制約や納品物、見積条件も添えます。
ただし、画面の細部が未定でも、「予測して何を変えるか」と発注範囲は具体的に書きます。曖昧なRFPでは、各社の見積前提が異なり、価格だけを比べられません。
予測モデルより前に定める業務目的とKPI
予測対象と時点、その結果を受けて行う業務を書きます。たとえば、30日以内に解約する顧客を毎朝抽出し、担当者が優先順位を付けて連絡する業務です。
翌週の店舗別需要を予測し、発注量の判断材料にする例もあります。精度以外の指標も設定します。たとえば、月間削減時間や欠品率、解約率、検知後の対応率を挙げられます。
誤判定の損失が大きい不正検知や審査では、正解率以外の指標も必要になります。見逃しを減らすか、確認件数を絞るかによって、必要な評価指標が変わります。
- 指標の決定:開発会社任せにせず、業務部門とリスク部門を交えて決める
- 指標候補:適合率、再現率、F1スコア、AUC、確率のしきい値から選ぶ
データの所在、品質、正解ラベルの洗い出し
データごとに、保管場所と項目、更新頻度を一覧にします。保有年数や欠損・重複、個人情報・機密情報の有無も書き添えます。
解約予測では、契約開始日、利用回数、問い合わせが候補になります。請求や解約日も候補です。
解約後にしか分からない情報を特徴量に入れると、実運用では使えないデータリークが起きます。正解ラベルがない場合も、早めに伝えます。
ラベルの作成ルールと対象期間を決めておきます。データの抽出と匿名化、持ち出しの扱いも、RFPに書きます。テスト環境での保管方法も含めます。
- ラベルの確定者:故障、解約、不正、成約をそれぞれ誰が確定するか
- データ不足:精度を断定せず、追加収集やルールベースとの併用を提案してもらう
RFPに入れる非機能要件と運用責任
バッチかAPIか、推論の頻度、同時利用者を書きます。応答時間、稼働時間、バックアップも書き添えます。
障害通知とログ保存期間を含めます。権限と監査証跡も必要です。
日次予測に常時稼働のAPIを作ると、初期費用とクラウド費用が増えます。一方で、即時の判定が必要なのに日次バッチを選ぶと、業務要件を満たせません。
稼働後は、精度を確認する人、再学習の条件、新モデルの承認者を定めます。データドリフトや欠損率、推論失敗を監視し、レイテンシや評価値も見ます。しきい値を超えたときの連絡先と対応期限も決めておきます。
- AIガバナンス:経済産業省などの「AI事業者ガイドライン第1.2版」(2026年3月31日公表)が示す、リスクベースの考え方
- 運用への反映:説明、記録、セキュリティ、インシデント対応を、契約と運用の両方に落とし込む
クラウド・オンプレミスの選択と2026年の技術動向
2026年時点では、Python環境に組み込む形のほか、機械学習基盤の学習、登録、推論の機能を組み合わせる形があります。監視機能も含めて、構成を決めます。
XGBoostとPython、CUDAの互換性を固定します。コンテナとSparkの版も固定します。
開発と本番の差を防ぐため、最新機能よりも、運用期間中に保守できる構成を優先します。
AWSとGoogle Cloudの本番化の部品
AWSのAmazon SageMaker AIでは、XGBoostを組み込みアルゴリズムまたはフレームワークとして使えます。CPUやGPU、分散学習、推論は、用途に応じて選びます。
公式資料では、2026年8月の確認時点で1.2系から3.0-5までの対応コンテナが示されています。ただし、XGBoost 3.0-5はP3 GPUインスタンスに対応しないといった条件もあります。
タグは「latest」で固定せず、具体的な版を指定します。インスタンスタイプやリージョン、データ形式も、見積書と構成図に明記します。
- Vertex AI:カスタム学習でXGBoostを動かし、Model Registryへ登録して予測に展開する形
- データ連携:BigQueryやCloud Storageを使う場合は、連携設計を一つにまとめやすい
選んだ基盤では、学習から予測までに必要な構成と管理条件をはっきりさせます。
- 構成:学習ジョブやモデル登録、エンドポイント、サービスアカウントの設計
- 管理条件:ネットワークの境界と費用の上限まで、構成に組み込んでもらう
Databricksの大量データと実験管理
Databricks Runtime for Machine Learningには、XGBoostやMLflowなどが含まれます。単一ノードと分散学習のどちらも選べます。
xgboost.sparkによる分散学習には、データ分割数やワーカー数などの制約があります。
大量の表形式データでは有力な選択肢です。ただし、分散処理で必ず安くなるとは限りません。学習やクラスターの起動時間、転送量、推論頻度を比べます。
2026年のXGBoost公式リリースノートには、3.2.0や3.3.0などが掲載されています。カテゴリカル特徴量やSHAP、量子化が改善されています。分散GPU学習なども改善されています(出典: XGBoost公式リリースノート、2026年6月)。
- 更新の影響:再現性と、依存ライブラリとの互換性に関わる
- 更新手順:脆弱性や機能更新を判断する人、再学習、回帰テストを契約に含める
オンプレミスやハイブリッドの場合のデータ所在と統制
データの持ち出し制限に合わせて、基盤の構成と予測結果の返し方を選びます。
- 構成の選択:個人情報や機密取引、工場データを持ち出せない場合は、オンプレミスやハイブリッドを候補にする
- 予測結果の連携:自社内で学習して、予測結果のみを業務システムへ返す設計も可能
オンプレミスでは、運用を担う側と必要な費用もあわせて確認します。
- 運用分担:GPUの調達や更新、バックアップ、障害対応を、自社か委託先のどちらが担うか
- 費用比較:オンプレミスがクラウドより安いとは限らない
エフサステクノロジーズのAI基盤導入支援資料では、GPUドライバーと学習フレームワークのインストールが30万円からです。GPUリソース管理環境の設計・構築とAIアプリ開発支援は、それぞれ300万円からです。運用Q&Aは年間150万円からです(出典: エフサステクノロジーズ公開資料、2024年)。
ただし、XGBoost専用の価格ではありません。基盤、アプリ、運用費を分けて示した公開事例です。
XGBoostのシステム開発で選ぶ契約形態と責任範囲
データや評価結果を見ながら仕様が変わるため、工程ごとに契約を分ける方法が現実的です。調査と要件整理は準委任、本番機能は請負、監視と再学習は保守契約とします。そのうえで、成果物と責任を対応させます。
請負契約の成果物と検収条件
仕様が固まったAPI、画面、データ連携、バッチ処理は、請負契約で成果物と検収条件を決めやすい領域です。請負の範囲には、画面や機能、入出力、エラー処理を書きます。テストと納期、検収期間も記載し、修正対象も明記します。
「予測機能一式」とまとめず、受け取るデータ、確率の形式、結果の保存先を明確にします。
データや業務条件で精度は変わるため、「本番で必ず精度90%」などの保証は慎重に扱います。提供データの品質と評価期間・指標を決めます。再現条件と改善範囲も定めます。
- 精度未達時:原因分析だけにするか、再開発まで含めるか
- 検収条件:モデルの稼働と、業務効果を別々に扱う
準委任契約の調査・改善・運用の継続案件
準委任は、一定期間の作業や専門家支援を依頼する契約です。データの洗い出しやラベル設計、仮説検証に向いています。モデル比較や精度改善、再学習条件の調整にも使えます。
作業時間と体制、定例会議を決めます。報告書とレビューの方法も定めます。特定の精度や機能の完成を、成果として保証しないよう注意します。
発注側もレビューに加わり、知識が開発会社だけに偏らないようにします。
- 受け取る成果:品質・評価レポート、実験履歴、課題一覧、議事録を、定期的に受け取る
- 契約終了時:ソースコード、モデル、設定、手順の引き渡し条件
モデル・学習データ・再委託の権利と責任
学習データや前処理コード、特徴量の権利と利用範囲を確認します。学習コードとモデル、評価結果も対象です。ログや画面、インフラ設定にも、権利と利用範囲を定めます。
XGBoostはオープンソースでも、開発会社のコードや顧客データ、第三者ライブラリの扱いは別です。
モデルを別クラウドや別会社へ移せるか、契約終了後も使えるかを明記します。再委託時は、会社名とデータ範囲、国外移転の有無を確認します。アクセス権と事故報告の経路も見ます。
- 会社間の分担:モデル会社とシステム会社が分かれる場合の、匿名化の可否と入力項目の管理者
- 障害・誤判定:一次対応と原因調査、顧客説明の担当を、責任分界に含める
XGBoostのシステム開発を外注する費用相場
XGBoost単体の国内開発費について、公的な相場表はありません。
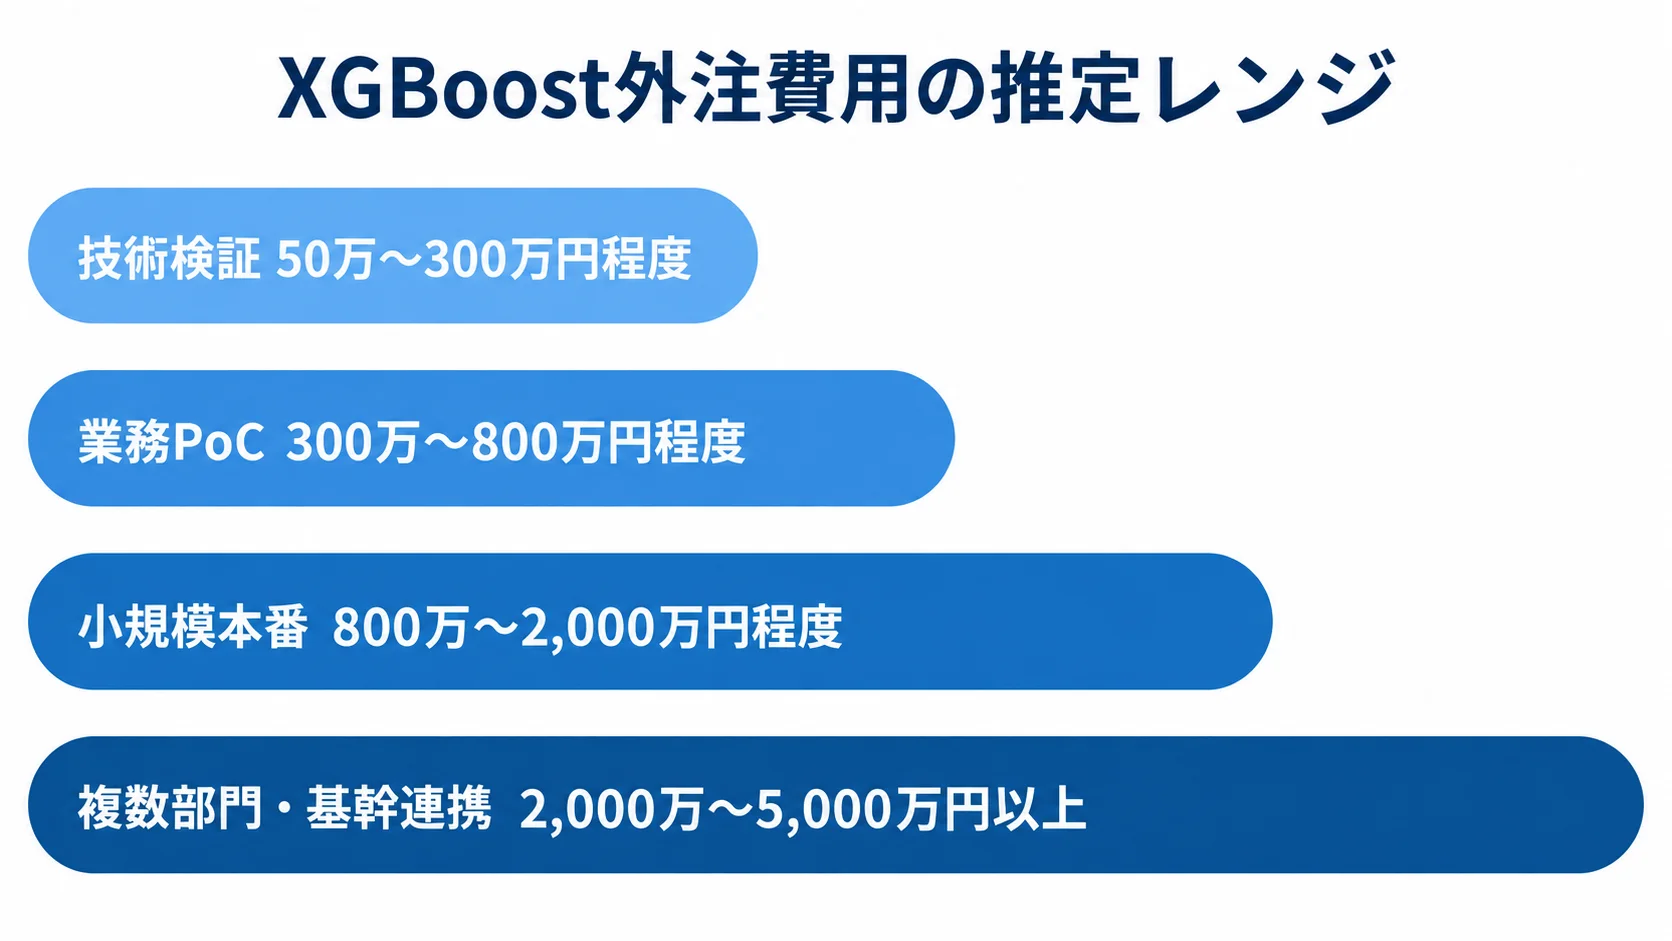
以下の数字は、人月単価と工程、基盤の公開価格から算出しています。業務システムへの組み込み範囲も前提にした推定です(出典: NotebookLM「業務システム全般_15」調査、2026年)。
データの量やラベル作成、連携数で変わります。セキュリティや同時利用者、保守条件によっても変わります。見積もりの確定額ではなく、RFP作成時の予算幅として使います。
技術検証と業務PoCの費用目安(50万〜800万円程度)
整ったデータで複数モデルを比べ、評価レポートに絞る技術検証は、50万〜300万円程度が目安です。期間は1〜2か月程度です。
データ読込と特徴量試作、XGBoostと単純モデルの比較、評価と報告を含みます。画面やAPIは含まれず、本番監視やデータ連携も対象外です。そのため、費用と成果物が明確になります。
業務PoCは、300万〜800万円程度が目安で、期間は2〜4か月程度を見込みます。データ抽出とラベル設計、欠損・不均衡への対応を含みます。さらに、業務評価と簡易ダッシュボードも入ります。
- 発注者作業:データクレンジングやラベル作成が、無償の作業として除外されていないか
- 追加の影響:除外作業を後から加えると、予算と期間が変わる
小規模本番の費用目安(800万〜2,000万円程度)
小規模本番は、800万〜2,000万円程度が推定レンジです。ETLや連携、モデル版管理、APIまたはバッチに加え、画面や権限、ログ、テスト、リリースまで含みます。期間は3〜6か月程度です。
- 開発体制:データや機械学習、API、PM、テストの担当が関わるため、モデル開発だけの場合より高額になる
- 費用範囲:XGBoostのライセンス料ではなく、業務システムの設計、実装、テスト、運用準備にかかる
複数データソースや基幹連携、リアルタイム推論を含む案件は、2,000万〜5,000万円以上になる可能性があります。冗長化、監査証跡、MLOps、段階移行も含まれ、期間は6〜12か月以上です。
機械学習の費用と、業務アプリ・インフラの費用は、分けて提示してもらいます。
初期費用と分けた運用費(再学習・監視を含む)
ランニングコストには、学習・推論・保存の費用があります。監視や問い合わせ、障害対応も含まれます。評価や再学習、セキュリティ更新、バックアップも対象です。
一般的な業務システムでは、初期開発費の年間15〜25%を保守費の起点にする方法があります。XGBoostは再学習の頻度とデータ量で増減するため、固定率に頼らず見積もります。
SageMaker AI公式資料では、GPUは単価が高くても、学習時間の短縮で費用対効果が上がる場合があると説明されています(出典: Amazon SageMaker AI公式ドキュメント、2026年8月確認)。
- 日次推論:月1回の学習なら、CPUバッチが適する場合がある
- 常時判定:推論エンドポイント、オートスケール、負荷試験まで比べる
XGBoostの委託先を選ぶときの確認ポイント
委託先は、XGBoostの経験だけでなく、データを業務につなぎ、本番で精度と安全性を維持できるかで評価します。公開事例が学習コードだけか、API・画面まで含むか、監視や再学習まで含むかを確認します。
提案時には、公開できる範囲で構成や役割を聞きます。運用体制と成果も確かめます。
実績で確認する本番運用の範囲
業務の内容やデータ量、バッチかAPIかを質問します。環境や稼働後の監視内容も聞きます。
顧客名を出せなくても、予測対象や更新頻度、ユーザー数を匿名化して説明できると、会社同士を比べやすくなります。モデル更新頻度や復旧方法も、同じように説明できるかを見ます。
データ抽出や特徴量の再現、モデル登録の経験を確認します。評価履歴と承認、ロールバックの経験も見ます。特に、単純モデルとの比較や誤判定の分析、現場の対応率まで示せると、定着を見通しやすくなります。
提案チームの業務・データ・アプリ担当
機械学習エンジニアの体制では、画面や権限、既存連携、障害対応を設計しきれない場合があります。PMや業務コンサル、データと機械学習の担当について、役割と稼働時期を確認します。アプリやインフラ、テストについては、担う範囲を確かめます。
契約後に担当者が交代する場合の引き継ぎも、あらかじめ決めておきます。発注側では、データ抽出の承認やラベル確認、業務レビューを誰が担うかを明確にします。テストデータの準備やセキュリティ審査、受入テスト、教育も、担当を決めておきます。
社内作業が多い場合は、データ準備の支援やPMOを追加で発注できます。社内の負担も含めて、総額を比べます。
見積書の前提と除外項目の比較
まず、各社の見積が同じ前提に立っているかを確認します。そのうえで、データの整備やラベル、特徴量、学習・評価を分けて見ます。
API、画面、認証、クラウドは、分けて示してもらいます。セキュリティや監視、マニュアル、教育、保守も、項目ごとに見ます。
未記載の項目は、除外か別途見積かを質問し、回答を比較表や議事録に残します。データの件数と期間、連携先、学習回数を前提として揃えます。推論頻度、ユーザー・環境数、納期、テスト範囲も前提に含めます。
CSVを一度受け取る見積と、基幹から毎日取得してエラー時に再送する見積は、別物です。そのため、安い見積が仕様の削減によるものか、効率化によるものかを確認します。
- 追加費用:品質悪化や連携先の増加、API変更、改善の試行回数の増加、セキュリティ対応にかかる費用
- 変更管理:承認者と納期への影響、上限額を決めて、認識の違いを抑える
XGBoostのシステムを発注してから稼働・保守するまでの進め方
発注後は、工程ごとに判断の材料を残し、次の工程へ進む条件を決めながら進めます。
- 要件定義での、予測対象と業務シナリオの決定
- データの準備と、品質・ラベルの確認
- PoCによる、モデルと評価指標の検証
- 本番システムの設計と開発
- 精度と業務シナリオのテスト
- 人的確認を挟んだ段階的なリリース
- 稼働後の監視と運用改善
連携要件も、最初から本番の業務シナリオを意識して考えます。
要件定義とデータ準備での業務の正本
要件定義では、顧客や設備、注文などの正本を決めます。予測対象日の基準や欠損値、更新の締め時刻も決めておきます。DWHと業務画面で意味がずれないよう、項目の定義を共有します。
学習と本番で特徴量の計算が変わらないよう、同じコードや処理仕様を使います。データ準備では、匿名化とアクセス権、抽出期間を確認します。欠損率や外れ値、重複、ラベル分布も見ます。
また、時系列データでは、未来のデータが過去の学習行に混ざらないよう分割します。
- 検証方法:不均衡分類での評価データとしきい値を、業務部門と決める
- 改善分担:品質改善が開発会社と自社のどちらの範囲かを、発注書に残す
テストでの予測精度と業務シナリオの確認
学習データの数値だけでなく、未知の期間や本番に近いデータで評価します。誤判定は、誤検知と見逃しに分けて分析します。欠損や特徴量の異常、しきい値の問題も、原因として分けて見ます。
更新前より悪化した業務区分がないか比較します。業務シナリオでは、取得失敗やタイムアウト、再送を確認します。モデルの読込失敗や手動上書き、障害復旧も確かめます。
担当者が結果を見て判断し、記録や必要な訂正ができることも検証します。そのため、公開直後は自動処理へ直結させず、提案の表示と人的確認から始めます。
稼働後の精度低下とデータ変化の監視
正解ラベルが確定したら精度を再計算し、データ分布や欠損率、推論失敗を監視します。処理時間や予測確率の偏りも見ます。顧客行動や売れ方の変化で、精度が下がる場合があります。
精度基準と再学習の条件、承認者、旧モデルへ戻す条件は、運用手順に書いておきます。
保守契約では、月次レポートだけにするか、監視アラートの一次対応まで含めるかを分けて決めます。原因調査や再学習、モデル更新に加えて、クラウド費用の見直しや脆弱性対応まで含むかも確かめます。
- 運用移管:ダッシュボードやアラート、障害・再学習・モデル廃止の手順の引き継ぎ
- 継続体制:予測を使い続けるための体制まで、発注の範囲に入れる
よくある質問
発注時は、アルゴリズムだけでなく、データ準備と業務連携の条件を合わせて確認します。契約や保守の条件も、同時に確かめます。
データが少なくてもXGBoostのシステムを外注できますか?
外注は可能ですが、まずデータ調査とPoCから始める方法が適しています。確認するのは、正解ラベルの数、対象期間、許容できる誤判定です。ルールベースや単純モデルとも比べます。
不足がある場合は、追加収集とラベル作成の計画も含めて提案してもらいます。
XGBoostのシステム開発にGPUは必要ですか?
必ずしも必要ではありません。表形式データで学習回数が少ない場合は、CPUのバッチ処理で足りることがあります。
データ量や探索回数、学習時間を測ります。推論の同時実行数やGPU料金、開発と運用の複雑さも含めて判断します。また、AWSの公式資料も、CPUやGPU、分散学習を用途に応じて選ぶ前提です。
XGBoostのシステムを外注するときの費用はどれくらいですか?
推定レンジは、技術検証が50万〜300万円程度、業務PoCが300万〜800万円程度、小規模本番が800万〜2,000万円程度です。
複数部門や基幹連携を含む案件は、2,000万〜5,000万円以上が目安です。XGBoost固有の公定相場はなく、データ整備や連携の範囲、画面や監視、保守の範囲で変わります。
モデルやシステム、クラウド、運用費は、分けて確認します。
外注先が作ったXGBoostのモデルは自社で使い続けられますか?
契約で利用範囲と引き渡し条件を定めれば、使い続けられる形にできます。受け取る範囲として、学習データや特徴量、学習コードを確認します。
モデルや依存ライブラリ、コンテナ、インフラ設定も確認します。評価履歴と運用手順も、受領の範囲に含めます。契約終了後の再学習や別環境への移行、別会社への保守引き継ぎも想定し、納品形式と権利を決めます。
まとめ
XGBoostの発注では、モデル作成だけで終わらせず、データ準備と特徴量から、推論、画面、監視、再学習、障害対応まで、発注に含める範囲を整理します。
予測によって誰の業務を変えるかを決めます。そのうえで、RFPに目的やKPI、データを書きます。非機能要件や納品物、保守条件も書きます。
PoC・本番・運用ごとの費用の考え方
推定レンジは、技術検証が50万〜300万円程度、業務PoCが300万〜800万円程度、小規模本番が800万〜2,000万円程度です。複数部門や基幹連携を含む場合は、2,000万〜5,000万円以上です。
データ品質や連携数、APIの即時性によって変わります。個人情報の扱いや、クラウド・オンプレミスの選択も関わります。保守と再学習の条件も含め、作業、前提、除外、追加条件は分けて比べます。
委託先の評価(精度・運用・引き継ぎ)
委託先のXGBoost経験や、基盤・業務システムの実装力を確認します。評価と説明、監視・再学習、セキュリティ、引き継ぎ体制も見ます。
小さなPoCで不確実性を減らし、成果物と責任範囲を確認してから、本番へ進めます。追加費用と運用停止のリスクを抑えるには、自社の業務とデータを理解し、現場で予測を使える状態まで伴走できる会社を選びます。
▼全体ガイドの記事
・XGBoostのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。