
Zipkinのシステム開発は、課題とKPIを決めることから始め、PoC、計装、検証、段階稼働、運用定着の順に進めます。この順で進めると、障害の切り分け時間の短縮につながります。
全体像は、Zipkinのシステム開発の完全ガイドでも確認できます。
▼全体ガイドの記事
・Zipkinのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Zipkinのシステムの全体像
Zipkinは、分散システムのリクエストを追跡するオープンソースの分散トレーシングシステムです。販売管理やERPのように業務データを処理する仕組みとは違い、遅延やエラーが起きたサービスを可視化します。
Zipkinによる処理経路と遅延箇所の可視化
注文画面では、APIゲートウェイ、認証、注文の各サービスが連携する場合があります。在庫、決済、通知が加わることもあります。遅延が起きたとき、ログだけでは各サービスの処理時間を追いにくいことがあります。
- 処理経路:trace全体と各spanを記録し、共通のtrace IDから処理の流れを一本のタイムラインで示します。
- 遅延箇所:DB待ち時間、外部API応答、リトライの発生箇所を同じ画面で把握できます。
ログ・メトリクス・APMの役割の違い
障害を調べるときは、記録の種類によって得られる情報が違うため、用途を分けて考えます。
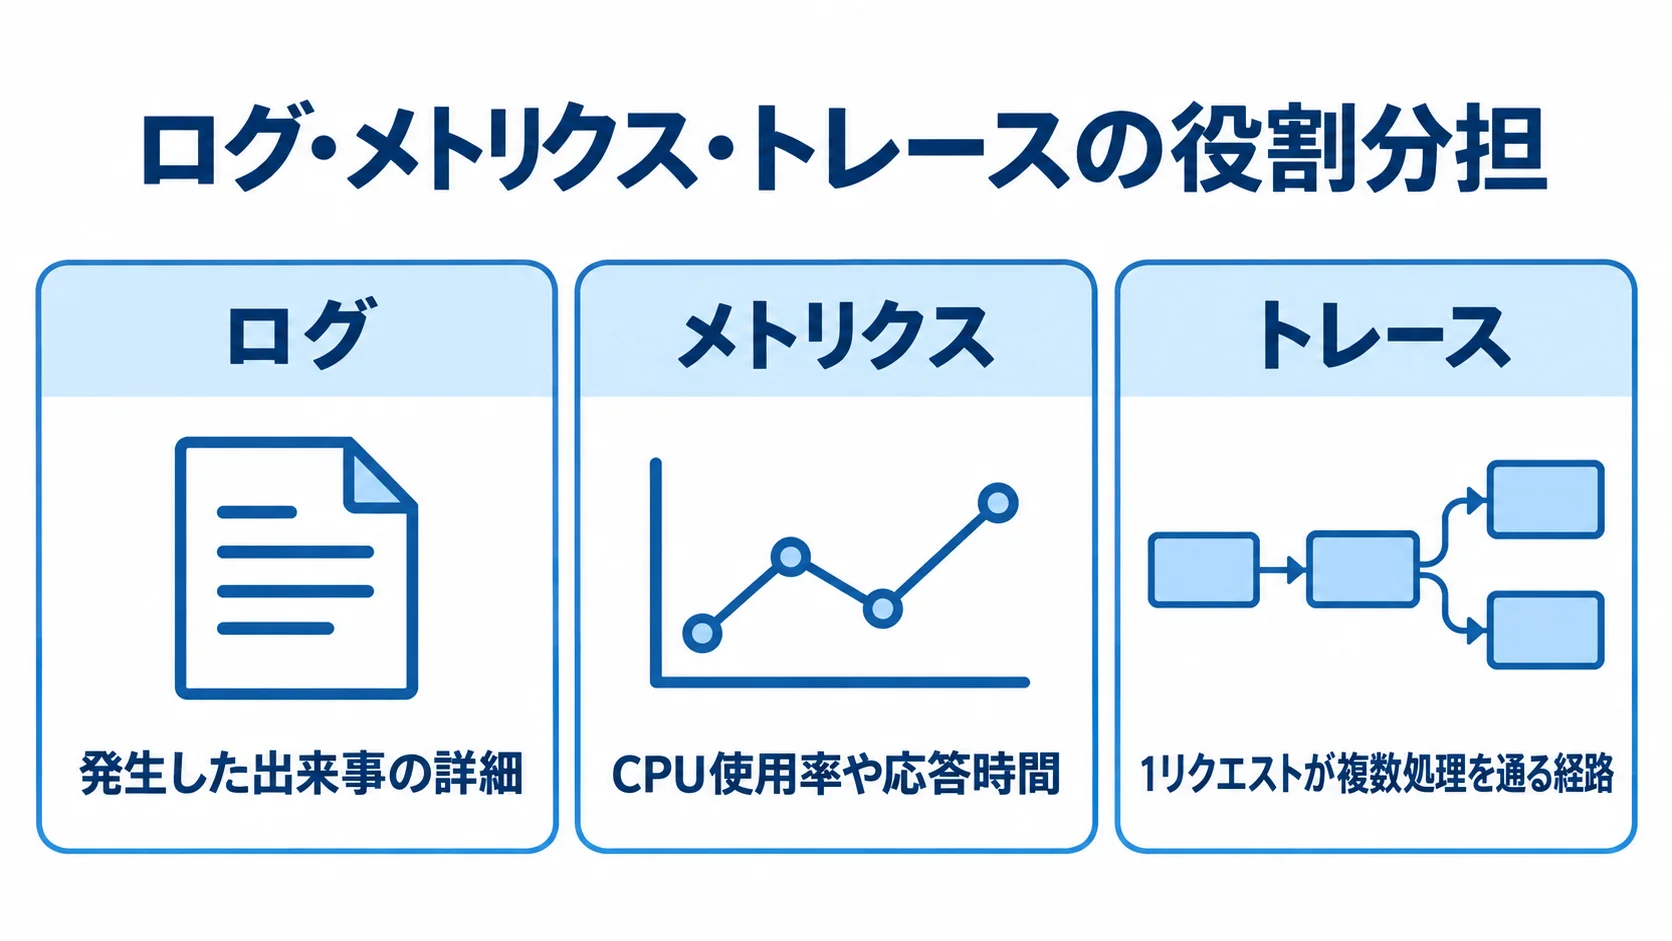
- ログ:発生した出来事の詳細を残す記録です。
- メトリクス:CPU使用率や応答時間など、時系列の数値で表します。
- トレース:1リクエストが複数の処理を通る経路を示します。ただし、Zipkinだけで監視は完結しません。
そこで、メトリクスで異常を検知し、トレースで遅い経路を絞り、ログでエラー内容を確認する分担が現実的です。導入前には、何を検知し、何を追跡し、どのログと結び付けるかを決めておきます。
本番の基本構成と各部の役割
Zipkinでは、計装したアプリがcollectorへデータを送り、そのデータを検索・表示したうえで、storageへ保存します。
- 計装:tracerまたはinstrumentationを、アプリに組み込みます。
- 送信:Reporterがspanをcollectorへ送ります。
- 受信:Zipkin collectorがデータを受け取る部分です。
- 検索・表示:検索用APIとWeb UIで保存データを参照し、traceを確認できます。
- 保存:storageにデータを保管します。
計装したアプリは、HTTPやKafkaなどでcollectorへ送ります。さらに、保存・索引化したデータは、query serviceとWeb UIが参照します(出典:OpenZipkin公式アーキテクチャ、2026年確認)。
検証環境では、Dockerで9411番ポートのZipkinを起動し、2〜5サービスをつなぐ方法で足りる場合があります。一方、本番では、保存先(Cassandra、Elasticsearch、MySQLなど)を設計し、backupや保持期間、負荷分散も決めます。
Web UIには組み込み認証がないため、network制御や認証proxyも要件に含めます。
Zipkinのシステム開発の進め方と6フェーズ
ツールを先に決めると、計装漏れや過大なデータ量が起きやすくなります。そこで、まず課題と対象範囲を定め、PoCで確かめてから本番設計へ広げます。流れは、運用担当への引き渡しまで含めて考えます。
フェーズ1:要件整理(目的とKPIの設定)
まず、解決したい業務課題を文章にします。「Zipkinを入れること」そのものは、目的にはなりません。
- 応答時間:注文APIの95パーセンタイル応答時間を確認する指標
- 原因特定:障害の平均切り分け時間を短くする目標
- 追跡範囲:重要業務フローのtrace検索率を決める項目
現状の障害対応で、検知から原因特定まで何分かかるかを測っておくと、導入後の効果を比べられます。
対象業務と入口のAPIを決めたうえで、関係するサービスの言語やフレームワーク、メッセージング、外部SaaSの使用有無を洗い出します。あわせて、ログ基盤の状況と想定リクエスト数、必要な保持日数を確認します。
さらに、閲覧する担当者と時間帯も決めておきます。また、個人情報やアクセストークンをspanに入れないルールと、障害時の連絡先も定めます。
最初から全サービスを計装せず、利用者影響の大きい2〜5サービスから始めると、検証しやすくなります。
フェーズ2:選定(OSS・SaaS・Collectorの役割分担)
方式を選ぶときは、自社で運用するZipkin OSSと商用APMを、運用負担やデータ管理の条件で比べます。
- 自前Zipkin:保管場所や検索環境を管理しやすい
- SaaS:運用負担や検索機能を抑えやすい
- Collector併用:複数の送信先を選びやすい
自前運用はライセンス費用を抑えやすい一方で、保存や可用性、更新を自社で担う必要があります。さらに、UI認証と障害対応も自社の範囲に入ります。
SaaSでは、取り込み量、保持期間、ユーザー数、ホスト数などの料金条件と、データの所在を確認します。
新規案件では、OpenTelemetryで計装し、OpenTelemetry Collectorを受け口にする構成が有力です。Collectorは、receiverで受信し、processorでサンプリングや属性削除を行い、exporterでZipkinや商用バックエンドへ送れます。
公式資料では、Collectorはテレメトリの受信・処理・複数宛先への送信を担う中立的な実装と説明されています(出典:OpenTelemetry Collector公式ドキュメント、2026年確認)。
そこで、将来バックエンドを変える可能性があるなら、アプリと保存先を直接結び付けない設計が判断材料になります。
フェーズ3:設計・開発(計装とデータ設計)
計装やデータの扱いを決めるときは、通信経路や採用ライブラリ、属性、保護・保存を設計します。
- 通信経路:HTTP、Kafka、バッチ等を洗い出し、trace contextが途切れる箇所を探します。
- 計装候補:対応ライブラリを選び、自動計装の範囲を検証します。
- 属性・採取:service.nameなどのログ形式を標準化し、通常時のhead samplingや障害向けtail samplingを検討します。
- 保護・保存:機密情報を属性に入れず、TLS、RBAC、保存期間、バックアップ暗号化を設計します。
環境名やversion、trace IDを含め、ログ形式も標準化します。HTTP methodやstatus、errorも、同じ形式の項目として扱います。
JavaやSpringではBrave、Micrometer Tracing、OpenTelemetry SDKなどが候補です。Node.js、Python、Goでも対応ライブラリを選べます。
URLのquery、顧客名、メールアドレス、認証headerは、そのまま属性へ入れない設計にします。
フェーズ4:テスト(正常系と異常系の再現)
合格の基準は、原因を判断できるspanが残っているかです。画面にtraceが出ているだけでは、この基準を満たしません。
- 正常な注文処理を再現する
- 遅いDB、外部APIのタイムアウト、HTTPエラーを再現する
- リトライ、サーキットブレーカー、非同期処理の遅延を再現する
- traceとログを相互に検索できるか確認する
負荷試験では、ピーク時のspan数とcollectorのCPU・メモリ、storageへの書き込みを測ります。あわせて、検索応答時間とアプリ負荷も確認します。さらに、採取率を100パーセント未満にしても、重要なエラーが残るかを試します。
バックアップからの復元や、trace閲覧権限、タグやログへの機密情報の混入も確認します。これらの試験を終えてから、本番投入を判断します。
フェーズ5:稼働(段階リリースと監視)
本番導入では、対象を段階的に広げながら、監視項目と閲覧範囲を決めます。
- 開発環境、ステージング、本番の一部サービスの順にリリースし、全体計装によるデータ急増や属性のばらつきを抑えます。
- 本番では、利用者影響が大きく、入口から下流まで追跡しやすい業務フローを選びます。
- 採取率、保持日数、検索権限、障害時の連絡先を、手順書に記します。
- collectorの送受信失敗、storage使用量、trace検索時間、span欠落率を監視します。
- アプリ遅延と月間データ量を追います。Zipkin UIは、社内網や認証proxyなどで公開範囲を制御します。
サンプリングを変えたときの費用と診断能力の変化も記録します。さらに、公開範囲の制御にはVPNやゼロトラストも使えます。
フェーズ6:定着(障害対応手順への組み込み)
traceを障害対応で使えるようにするには、調査手順と運用担当への引き継ぎを整えておきます。
- 障害対応:サービス名と時間帯でtraceを探し、遅いspanやエラー、ログ、deployを調べる手順を作ります。
- 訓練:月1回程度、trace IDを使った調査を試し、担当者による使い方の差を縮めます。
- 引き継ぎ:構成図、計装対象、属性規則、sampling、保持期間、復元、更新、問い合わせ先を納品します。
- 移行:新規開発はOTLPまたはCollectorを軸にし、既存構成は影響を見て段階移行します。
導入後は、この2つが運用の中で回っているかを確認します。
OpenTelemetryは2025年12月にZipkin exporter仕様を非推奨にしました。ただし、既存の安定版は、少なくとも2026年12月までセキュリティ修正などの対象です。
この方針は、OpenTelemetry「Deprecating Zipkin Exporter」で確認できます(2025年12月公開・2026年確認)。
Zipkinのシステム開発にかかる費用相場とコストの内訳
Zipkin単体の国内受託開発価格を示す公的統計は確認できません。そのため、ここに示す金額は、業務システム全般の相場と対象範囲をもとにした編集用の推定レンジです。
Zipkinの範囲は業務システム全体より狭いものの、金額は対象の条件によって変わります。金額を動かす要因は、サービス数、言語、Kubernetes、既存ログ基盤です。さらに、保存量やSLA、夜間対応によっても変わります。
固定価格とは断定せず、見積もりの初期目安として扱います。
初期費用の目安:PoCで50万〜200万円、本番で300万円以上
規模別に、費用と期間の目安、各段階に含む作業をまとめます。
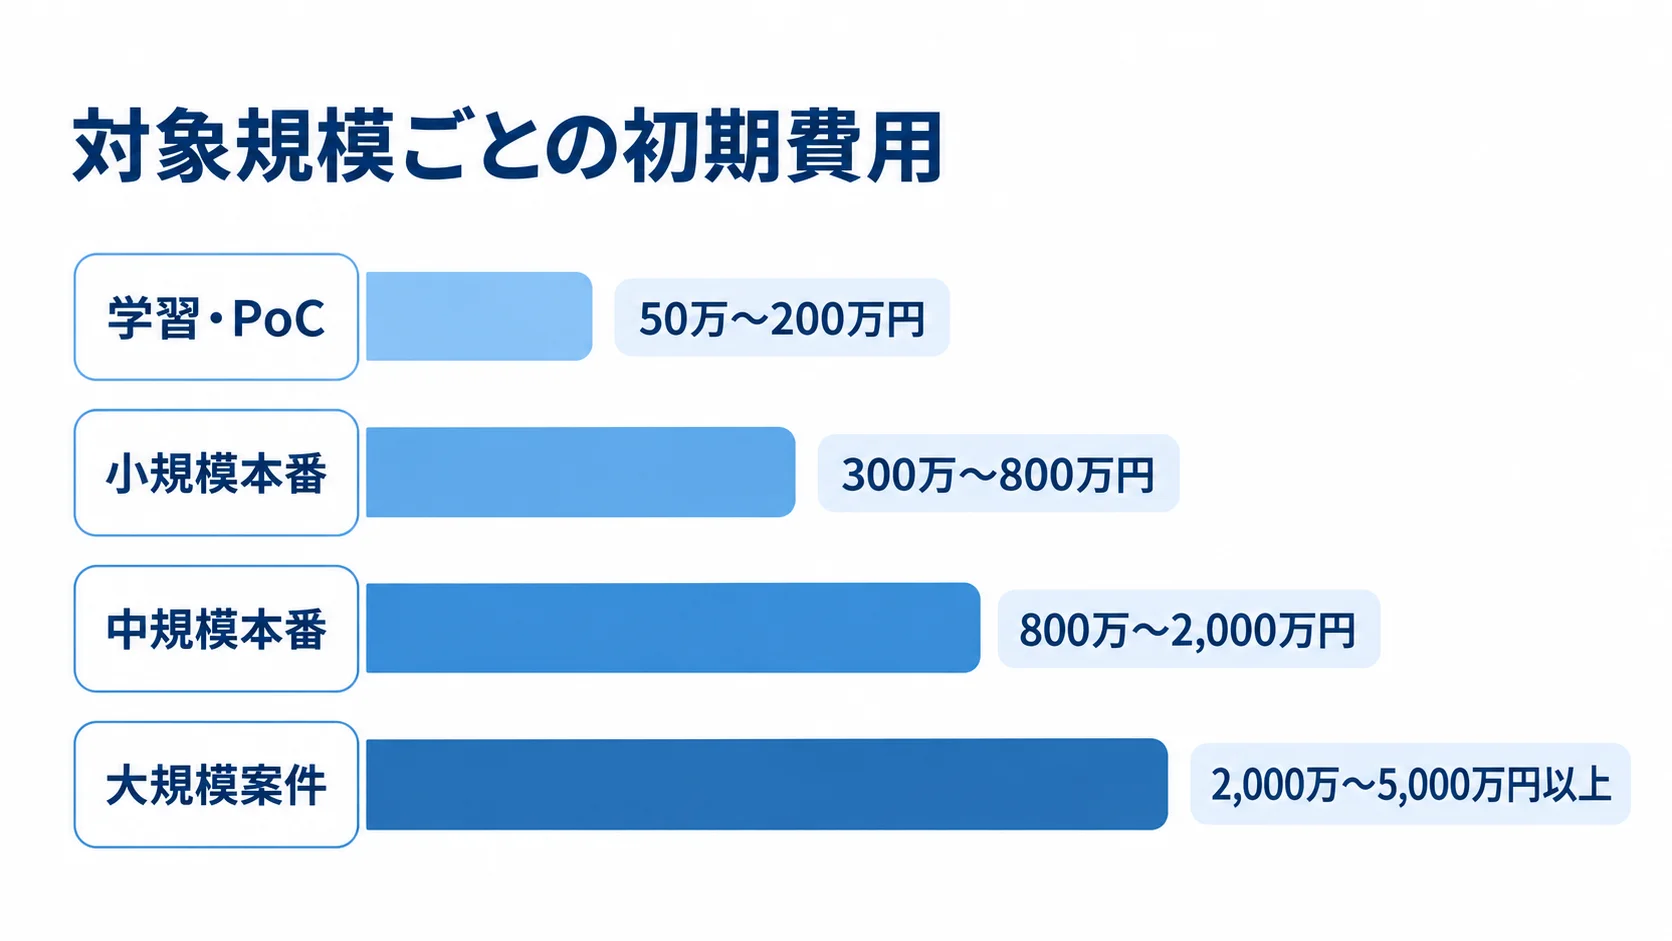
- 学習・PoC:50万〜200万円、2〜6週間。Docker起動、2〜5サービス計装、正常・異常系確認、報告書を含みます。
- 小規模本番:5〜20サービス、300万〜800万円、1〜3か月。認証、TLS、永続storage、backup、dashboard、手順書を含みます。
- 中規模本番:20〜100サービスを対象に、800万〜2,000万円、3〜6か月程度です。
- 大規模案件:複数clusterやregion等では2,000万〜5,000万円以上、6〜12か月以上の可能性があります。
中規模は、OTel CollectorやKubernetes、sampling、負荷試験を含む場合の目安です。既存計装からの移行も、この範囲に含まれる場合があります。
大規模案件では、高可用性や長期保持、SIEM連携、24時間運用も条件になります。そこで、サービス数と運用要件を分けて確認します。
工数の増えやすい箇所:計装より周辺設計と検証
費用の中心は、ライセンスではなく人件費です。そのため、人月単価と必要な役割、成果物を分けて見積もります。
- 費用項目:要件整理、計装、Collector、storage、security、負荷試験、運用教育が中心です。
- 技術者単価:業務システム一般の参考値は1人月50万〜150万円程度です。
- 体制:PoCは1〜2人、小規模本番は2〜4人、中規模以上はPM、SRE、アプリ・インフラ担当の混成です。
- 見積もり内訳:要件定義、計装、Collector、storage、UI・認証、試験、文書、教育ごとに分けます。
単価は業務システム一般の相場整理を参考にしています(出典:NotebookLM「業務システム全般_16」、2026年確認)。
サービスごとに異なるフレームワーク、非同期処理、外部API、ログ形式を合わせる作業も発生します。
コード変更だけで見積もると、テストや運用設計の費用が後から増えます。
月額費用の変動要因(ストレージ・監視・保守・データ量)
OSSを使う場合でも、クラウドやサーバー、storageの費用は発生します。加えて、backupや監視、更新、保守担当者の費用もかかります。
New Relicは月100GBまで無料で、超過分はOriginal Dataが1GBあたり0.40ドルです(出典:New Relic公式料金ページ、2026年確認)。
- 月額推定:自己運用は小規模20万〜60万円、中規模60万〜200万円です。
- 保守費:初期開発費の年15〜25パーセントが参考です。storage費はトレース量で変わります。
- Datadog:APMホスト、取り込みGB、Indexed Spansの保持日数ごとに料金を公開しています。
- 採取率:100パーセントから10パーセントへ下げるとデータ量は単純には減りますが、重要エラーは別途検証します。
Grafana Cloudの新規顧客向けApplication Observabilityは、米ドル建ての料金モデルです。2026年2月13日以降は、ホスト時間に加えてtrace等が1GBあたり0.50ドルです(出典:Grafana Cloud公式料金ページ、2026年確認)。
料金は契約条件や為替でも変わるため、日本円の月額は断定できません。そこで、自前運用とSaaSを比べるときは、同じ条件をそろえて試算します。そろえる項目は、1日あたりのspan数、平均spanサイズ、採取率です。さらに、保持日数、検索対象期間、利用者数も含めます。
導入方式と将来性を判断するチェックポイント
Zipkinと商用APMのどちらにするかは、料金だけでは決まりません。障害検索や体制、保存先を比べたうえで、既存連携や今後の追加も見ます。短期のPoCにはZipkin OSSを、長期にはOpenTelemetryとOTLPを軸にします。
自前運用とSaaSの選び方
方式は、社内で基盤を運用できるか、どこまでデータを制御したいかを基準に比べます。
- 自前運用:クラウドなどを管理でき、保存先やネットワークを制御したい企業に合います。
- SaaS:短期間で相関を始めたい企業や、24時間運用を担いにくい企業が選びやすい方式です。
SaaSを選ぶ場合は、テナントのリージョン、保持期間、アクセス監査を確認します。さらに、契約終了時のデータ返却と、従量課金の上限も確かめます。
新規設計のOTLPと既存環境の段階移行
OpenTelemetryのZipkin exporter仕様は2025年12月に非推奨となりました。ただし、既存のexporterを直ちに廃止する必要はありません。一方、新規のSDKでは、Zipkin exporterの実装は必須ではなくなっています。
- アプリからOTLPをZipkinのOTLP ingestionへ送る方法と、Collector経由の公式案を比べます。
- exporter、ライブラリ、trace context、属性名、保存先を洗い出します。
- 一部サービスをCollectorへ向けてZipkin出力を確認し、OTLP対応先やSaaSを比べます。
- 切り戻し先、二重送信期間、データ上限、障害時の支援を決めてから全体へ広げます。
保守のことを考えると、古い設定だけを標準にしないほうが安全です。影響範囲を確かめながら移行します。
Zipkinのシステム開発で見積もりを取る際のポイント
見積もりの精度は、現状をどれだけ具体的に伝えるかで上がります。そのため、まずサービス構成と通信経路を整理します。目標KPI、データ量、セキュリティ条件、運用体制をまとめ、価格だけでなく納品物と支援範囲も比べます。
要件書に記すサービス数とデータ量
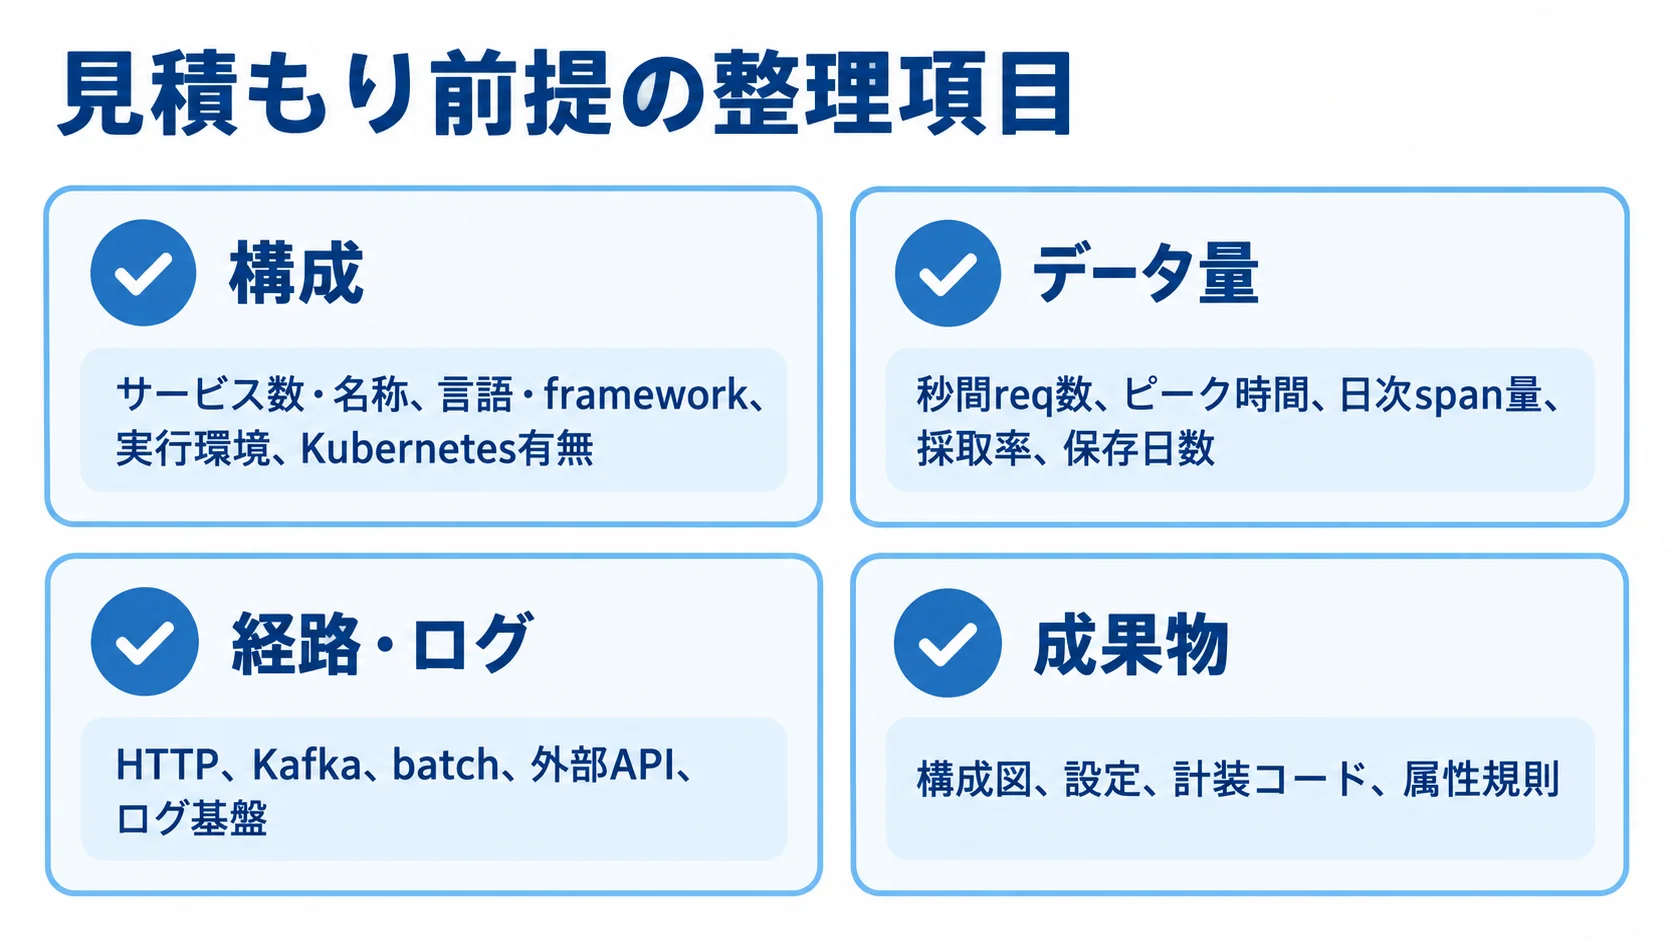
見積もりの前提をそろえるため、構成、データ量、通信経路、納品物を要件書にまとめます。
- 構成:サービス数と名称、言語とframework、実行環境、Kubernetesの有無を書きます。
- データ量:秒間req数、ピーク時間、日次span量、採取率、保存日数を示します。
- 未計測項目:計測できていない値は「未計測」と書き、PoCの計測工程を見積もりに含めます。
- 経路・ログ:HTTP、Kafka、batch、外部API、ログ基盤、trace ID出力可否を整理します。
- 成果物:構成図、設定、計装コード、属性規則などを、種類ごとに分けて挙げます。
dashboardやalertに加えて、負荷試験報告やsecurity確認表も記載します。手順書と教育も、記載の対象にします。さらに、本番画面や一次切り分け、backup復元の範囲も確認します。
複数社の比較と体制・実績の確認
同じ条件を各社に伝え、提案内容と回答の具体性を比べます。
- 共通条件:対象数、保持日数、24時間対応、OpenTelemetryとZipkinの役割、SaaS可否をそろえます。
- 技術と体制:計装、Collector、Java・Spring・Kubernetes、ログ相関、security、引き継ぎ、SLAを比べます。
- 実績:Zipkinに限らず、分散traceや可観測性基盤の本番運用経験を尋ねます。
- 確認事項:採取率、機密情報の削除、storage障害時の影響、OTLP移行箇所を質問します。
- 回答:データ量や運用手順に触れない提案では、追加費用や属人化の可能性があります。
見積もりに含める機密情報・性能・運用のリスク
情報漏えいや性能低下、運用引き継ぎの負担も、見積もりの時点で確認します。
- 機密情報:tag、baggage、URL、headerに個人情報、token、session ID、接続文字列、内部host名が混ざると漏えいにつながります。
- 記録ルール:token、password、暗号鍵、決済情報等は未処理で記録せず、mask等を検討します。
- 性能:全量採取の負荷、collectorのqueue詰まり、storage容量の枯渇、検索遅延を想定します。
- 運用:証明書更新、backup復元、更新、障害時のescalation、退職や異動時の権限変更を決めます。
記録の扱いについては、OWASP Logging Cheat Sheetが、mask、削除、hash化、暗号化の検討を示しています(出典:OWASP Logging Cheat Sheet、2026年確認)。
見積もりには、属性の許可リストの作成と、masking試験も含めます。
設計・試験・運用支援の範囲を書面に残すと、発注後の認識違いを防げます。
Zipkinのシステム開発でよくある質問(FAQ)
PoCの範囲と費用、OpenTelemetryへの対応を確認すると、自社に必要な進め方を判断しやすくなります。
モノリスのシステムにもZipkinは必要ですか?
外部API、複数DB、キュー、バッチをまたぐ処理のあるモノリスでは、Zipkinが遅延の追跡に役立ちます。一方で、単一サービス内であれば、既存のAPMや詳細ログで足りる場合もあります。まずは重要業務フローを1つ選び、Zipkinが必要かをPoCで確かめます。
Zipkinは無料なので開発費も無料ですか?
OSSのライセンス費用は基本的に無料でも、計装やCollector、storageの費用が発生します。さらに、クラウドや監視、バックアップなどの運用費、試験や教育、保守にかかる費用もかかります。
PoCは50万〜200万円、小規模本番は300万〜800万円程度の推定レンジです。サービス数や運用条件を踏まえた目安なので、自社のspan量と保持日数を測り、初期費用と月額を分けて見積もります。
新規開発でZipkin exporterを使い続けても問題ありませんか?
利用を続けるかどうかは、既存環境か新規設計かで分けて考えます。
- 既存環境:安定版を短期利用できます。security修正などは、少なくとも2026年12月まで継続する方針です。
- 新規設計:OTLPまたはCollectorを軸にし、将来の移行計画を決めます。
アプリとバックエンドの間にCollectorを置く構成と、ZipkinのOTLP ingestionへ送る構成を比べます。
まとめ:運用定着までを見据えたZipkinのシステム開発
成功の要点:6フェーズの一続きの設計
まず、要件整理では目的とKPIを決め、選定ではOSS・SaaS・Collectorの役割を分けます。次に、設計・開発では、計装とtrace context、属性を固め、保持期間やセキュリティも決めます。最後に、正常系・異常系の試験から段階リリース、監視、障害訓練、手順書による定着まで、一続きで進めます。
最初に整理する課題・対象サービス・データ量
導入相談の前に整理する条件を、費用、見積もり、移行方針に分けてまとめます。
- 費用前提:計装工数、storage、データ量、cloud、監視、backup、保守で変わります。
- 見積もり条件:PoC値を本番費用とは扱わず、サービス数、span数、採取率、保持日数、SLAをそろえます。
- 移行計画:新規はOTLP等、既存Zipkinは切り戻せる段階移行で選択肢を残します。
▼全体ガイドの記事
・Zipkinのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。