
Zipkinは、分散処理の遅延や障害の特定に役立つ、リクエストの追跡システムです。
システム開発を進めるには、基本概念と構成、導入と運用を押さえることが出発点になります。費用や開発会社の選び方も、あわせて確認しておくと判断しやすくなります。
▼関連記事一覧
・Zipkinのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Zipkinのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Zipkinのシステム開発の見積相場や費用/コスト/値段について
・Zipkinのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Zipkinのシステムの概要
Zipkinは、分散したサービスをまたぐリクエストの経路と処理時間を記録し、1つの画面で追跡するシステムです。販売管理やERPのように業務データを登録・更新する業務システムとは役割が異なり、業務システムが正常に動いているかを調べるための運用基盤です。
分散トレーシングで分かる内容
分散トレーシングでは、同じリクエストに含まれる各処理の開始・終了時刻やサービス名、HTTPメソッドを確認できます。ステータスやエラー、タグも、処理ごとに把握できます。
たとえば、利用者が注文画面を開くと、APIゲートウェイから認証、商品、在庫へと処理が進み、決済と通知へも続きます。全体が3秒なら、在庫が2秒を占める場合もあります。外部決済への接続でタイムアウトした箇所も特定できます。
Zipkinが向いているシステムの特徴
Zipkinは、複数のAPIやコンテナ、非同期メッセージ、外部サービスを組み合わせるシステムに向いています。
- 処理を追えない:サービス単位のログでは、1件の処理の流れがつかめない
- 障害を再現しにくい:発生した箇所を絞り込みにくい
- 調査に時間がかかる:性能問題を切り分けるには経験が要る
一方で、単一アプリケーションで処理が完結し、既存のログとメトリクスだけで原因を把握できる場合は、導入の優先度を下げても問題ありません。
Zipkinのシステムを理解する基本概念と種類
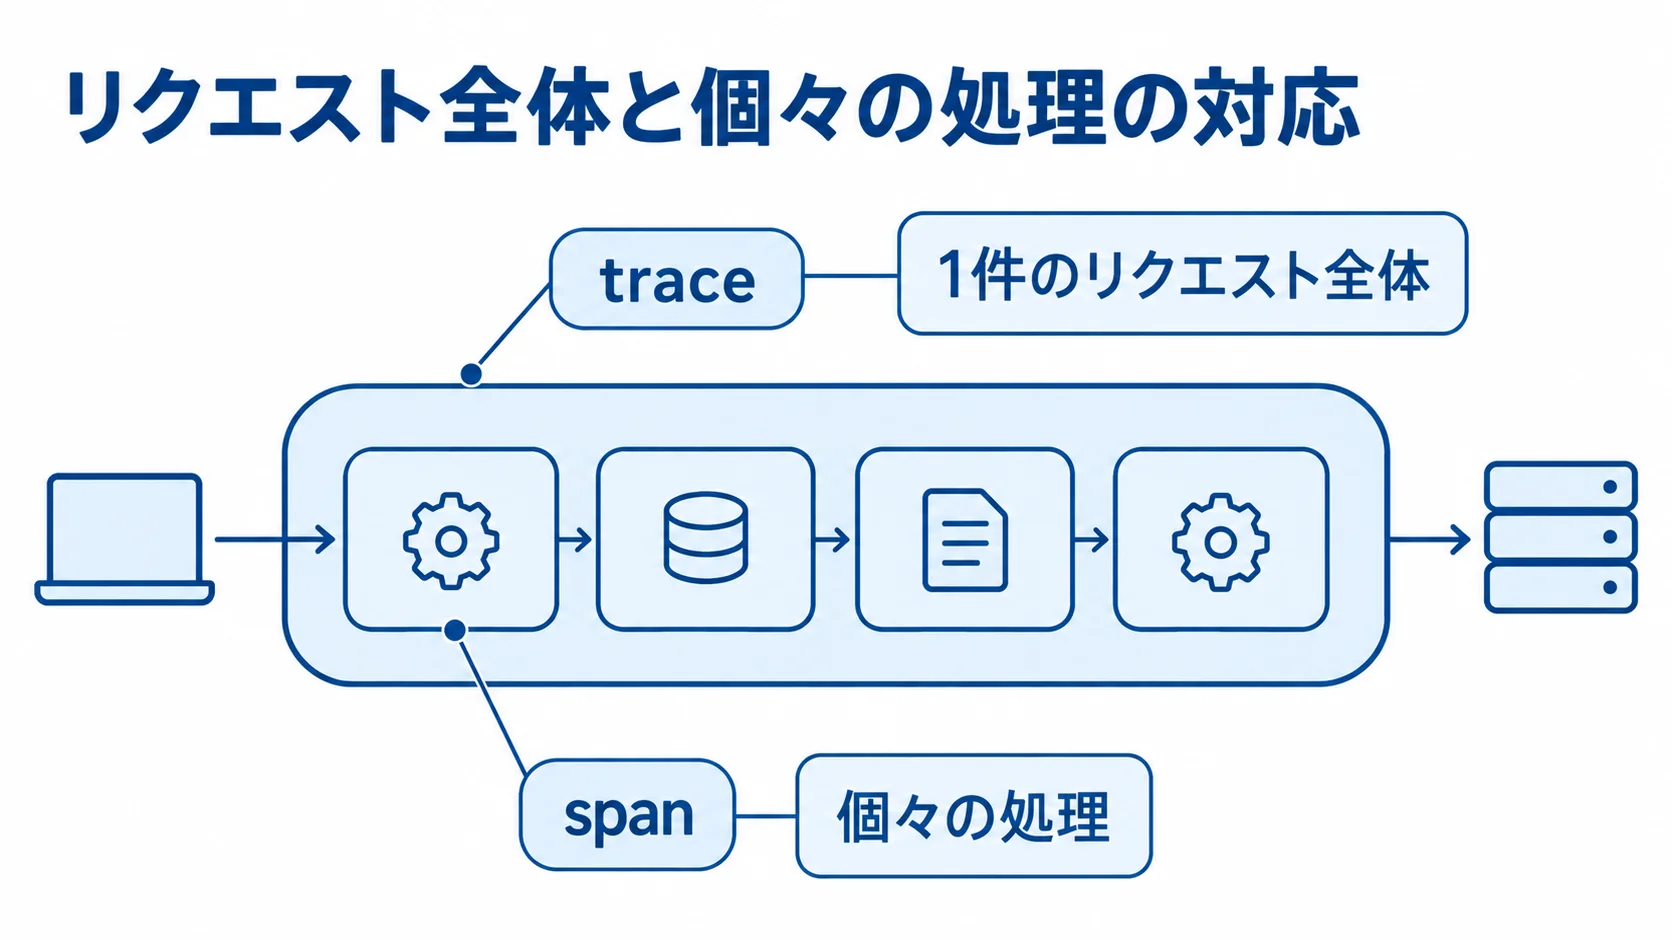
Zipkinを導入する際は、製品名だけでなく、trace、span、ID、計装という4つの用語の意味を押さえておく必要があります。さらに、ログやメトリクスとの役割分担を知っておくと、Zipkinの位置づけや必要な構成を判断しやすくなります。
trace・span・trace ID・span IDの違い
traceは利用者の1回の操作や1件のリクエスト全体をまとめる単位です。spanは、その中の個々の処理を表す単位で、認証、DB検索、外部API呼び出しなどが該当します。
trace IDは全体を、span IDは各処理を識別するものです。親子関係のあるspanを時系列に並べると、ウォーターフォール形式で処理の順序と待ち時間を読み取れます。
ログ・メトリクス・トレースの役割分担
ログは詳細なイベントを、メトリクスはCPU使用率やエラー率、応答時間などの時系列数値を扱います。トレースは、1件の処理が通ったサービスと経路を示します。
たとえば、メトリクスで注文APIの95パーセンタイルが悪化した時間を見つけ、traceで遅いリクエストを特定したうえで、ログで例外の内容を確認します。
Zipkinは、監視・通知・監査までを単独で担う仕組みとは限りません。そのため、既存のログ基盤やメトリクス監視との相関を設計します。
自前運用・Collector併用・SaaS利用の違い
導入方式は大きく3つに分かれ、自社運用、OpenTelemetry Collectorなどの中継基盤との併用、トレース機能を持つ商用サービスの利用があります。自社で管理する範囲と初期構築の負担は、方式ごとに異なります。
- 自前運用:保管場所やカスタマイズを自社で管理しやすい
- Collector併用:計装と保存先を分けられ、将来の変更に備えやすい
- SaaS利用:初期構築の負担が小さい
自前運用では、可用性やバックアップを自社で担うことになります。更新やアクセス制御も、運用側が受け持つ範囲です。
SaaS利用の月額は、データ量やホスト数で変わります。保持期間や契約条件によっても変わります。
Zipkinのシステム構成とデータの流れ
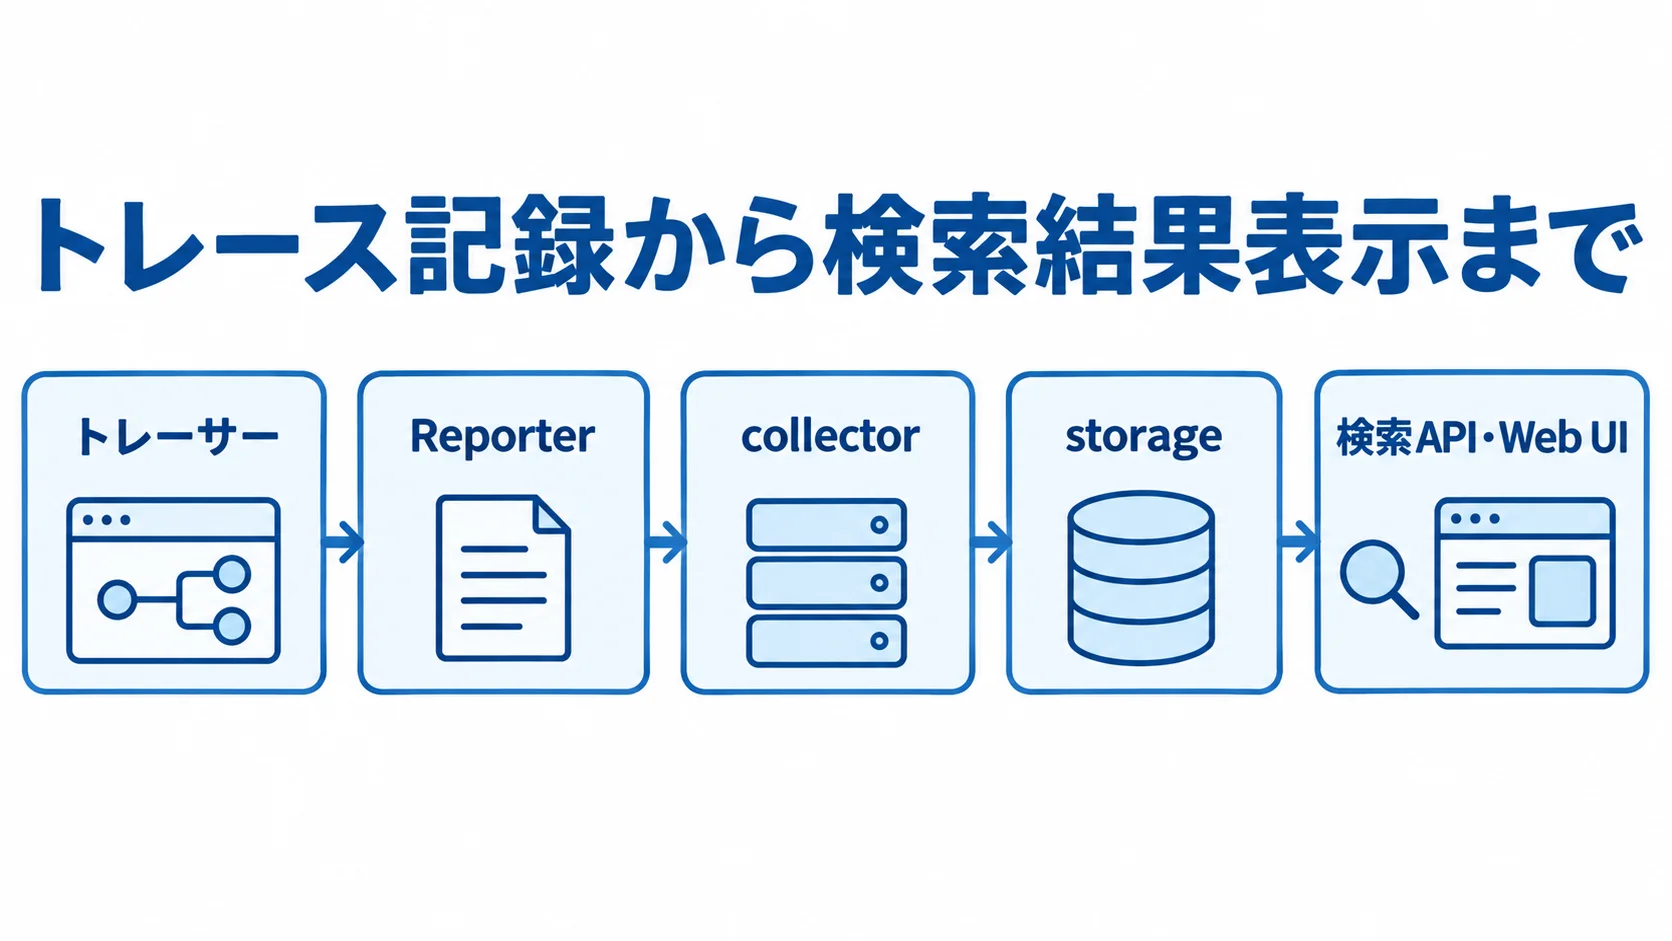
本番運用では、計装から閲覧までを一連の流れとして設計する必要があります。コンテナを1つ起動することは、その流れの一部にすぎません。
公式の構成では、トレーサーがアプリ内でspanを記録し、Reporterがそれをcollectorへ送信します。その後、検索APIが保存先を読み、Web UIが結果を表示します(出典:OpenZipkin公式アーキテクチャ、2026年確認)。
▶ 詳細はこちら:Zipkinのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
アプリケーションの計装とコンテキスト伝搬
計装とは、トレースを記録する仕組みを、Webサーバーやメッセージング処理などに組み込むことです。HTTPクライアントやDBドライバも対象になります。
入口で作ったtrace IDを下流へ伝搬させないと、サービスごとに別のtraceが作られ、全体を追えなくなります。そのため、HTTPではリクエストヘッダー、非同期処理ではメッセージのメタデータを使い、同期と非同期の両方でコンテキストを引き継ぎます。
collector・storage・検索API・UIの役割
受信から検索結果の表示までは、collector、storage、検索API、UIの4つの要素が分担します。
- collector:spanを受信して形式を検証し、必要に応じてバッチ化やサンプリングをしたうえで保存先へ渡す
- storage:トレースを一定期間保持する役目
- 検索API:サービス名、時間、アノテーションなどを条件にデータを取得できる仕組み
- UI:親子関係と処理時間を、読める形で示す画面
公式の拡張には、HTTP、Kafka、RabbitMQなどの受信経路があります。保存先としては、インメモリやMySQL、Cassandra、Elasticsearchなどが示されています(出典:OpenZipkin公式サーバー拡張情報、2026年確認)。
本番環境で追加すべき設計
PoCではインメモリ保存でも画面を確認できますが、本番では保存期間や容量上限を決める必要があります。障害時の再送とバックアップ、復元の方法、collectorの冗長化も、あわせて決めておきます。
ZipkinのWeb UIには、標準の認証機能が備わっていません。そのため、社内ネットワークに閉じる、認証プロキシを置く、アクセス元を制限するといった防御が必要になります。
通信はTLSで保護し、保存先の読み取り権限は運用担当者に限ります。さらに、誰がどのtraceを閲覧したかを監査できる状態にしておきます。
Zipkinのシステム開発・導入の進め方
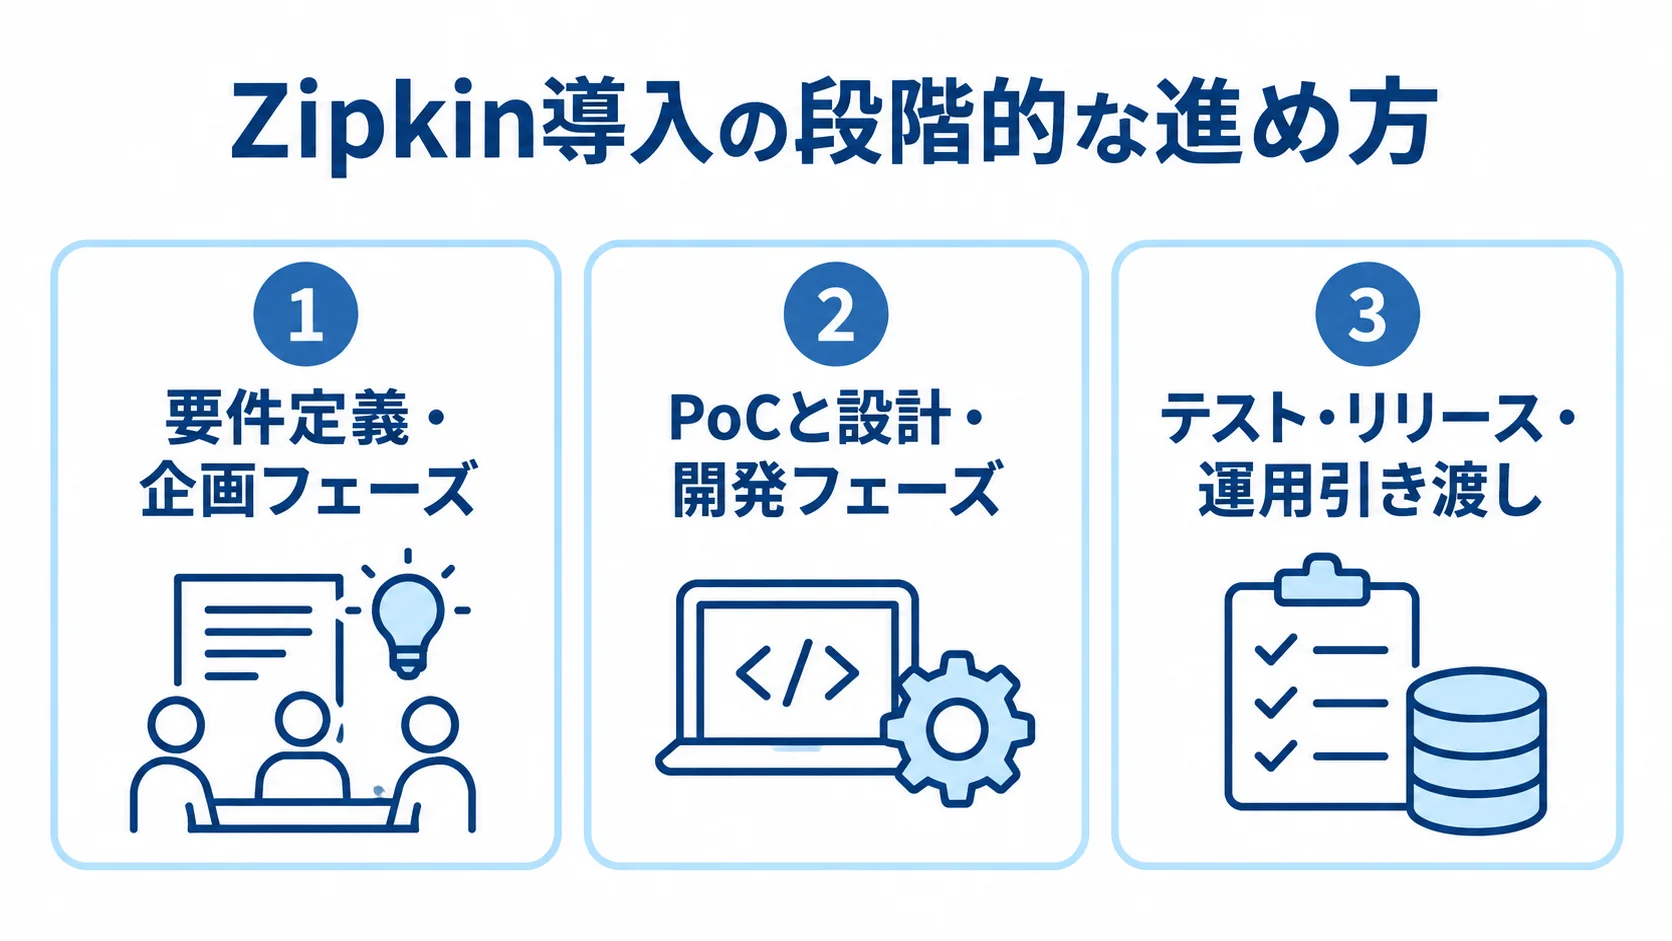
導入では、改善する業務フローを決め、少数のサービスで効果を検証してから、本番へ段階的に広げます。全サービスを最初から計装すると、データ量が多くなりすぎて、不具合の切り分けが難しくなります。
要件定義・企画フェーズ
改善したい内容は、後から数値で追えるKPIとして定めます。KPIの候補には、応答時間や障害対応など4つの指標があります。
- 応答時間:注文APIの95パーセンタイル
- 障害対応:平均切り分け時間
- trace確認率:重要業務フローのうち確認できる割合
- 検知時間:リトライやタイムアウトの把握にかかる時間
対象サービス数、1日のリクエスト数、ピーク時の同時実行数を洗い出します。外部APIやメッセージングの利用、個人情報の有無、保持期間も、一覧にして整理します。どこまでを誰が受け持つかも決めておきます。
PoCと設計・開発フェーズ
対象は2〜5サービス程度に絞り、入口から下流までtrace IDがつながるかを確かめます。そのうえで、代表的な障害をUIで追跡できるかも確認します。
- 正常系:基本の処理経路
- 遅延・失敗:DBの応答の遅れ、外部APIのタイムアウト、HTTPエラー
- 再試行・非同期:リトライやメッセージ遅延
JavaやSpring系では、Brave、Micrometer Tracing、OpenTelemetry SDKなどが候補になります。一方、Node.js、Python、Goなどは自動計装の対象が異なるため、言語とフレームワークごとに検証します。
テスト・リリース・運用引き渡し
本番前には負荷試験を行い、spanの増加量と、アプリケーションへのオーバーヘッドを測ります。また、collectorが停止しても業務処理が止まらないか、容量上限に達したときにどう縮退するか、ネットワーク切断後に再送できるかも確かめます。
運用手順書には、画面の見方やtrace IDによるログ検索、採取率の変更を書きます。加えて、データ削除や障害時の連絡先もまとめます。これにより、担当者は開発者個人の判断に頼らず調査できる状態で引き渡せます。
OpenTelemetryとZipkinの使い分け
Zipkinは、主にtraceを保存・検索・表示するバックエンドとUIです。OpenTelemetryは、計装やデータ収集、標準化を担います。
両者は併用できます。たとえば、OpenTelemetryで計装し、Collectorを経由してZipkinへ送る構成があります。新規に設計する場合は、保存先を固定しすぎないよう、OpenTelemetryとOTLPを入口にする構成が現実的です。
Collectorを中継するメリット
OpenTelemetry Collectorは、テレメトリを受信・処理し、複数の宛先へ出力する実行ファイルです。
パイプラインは、receiver、processor、exporterで構成されます(出典:OpenTelemetry Collector公式アーキテクチャ、最終更新2026年3月)。
processorで属性の削除やサンプリングを行えば、複数のexporterへ分岐することもできます。中継層があると、アプリを毎回改修せずに、送信先やデータ削減ルールを切り替えやすくなります。
2026年時点の新規導入・移行方針
OpenTelemetryは2025年12月にZipkin exporterの仕様を非推奨化しました。一方で、既存の安定版exporterは少なくとも2026年12月まで、セキュリティ修正と重大なバグ修正を続ける方針です(出典:OpenTelemetry公式ブログ、2025年12月・2026年2月更新)。移行は、新規の設計と既存環境の切り替えで進め方が分かれます。
- 新規案件:古いZipkin exporterだけを標準とせず、OTLPで送って、ZipkinのOTLP取り込みかCollector経由で出力する方法
- 既存環境:急いで一斉移行せず、exporter、SDKの版、データ形式、保持期間、送信失敗時の挙動を洗い出す
- 段階切替:Collectorを並行稼働させたうえで、少数サービスからOTLPへ切り替える進め方
- 移行判断:trace ID、属性、件数、検索結果、障害時の復旧を比べ、問題がなければ段階的に切り替える
Zipkinのシステム開発にかかる費用相場
Zipkin単体の国内受託開発価格を示す公的統計は確認できませんでした。そのため、次の金額は、業務システム全般の相場と必要な作業から算出した編集用の推定です。
金額は、対象サービス数や利用言語、Kubernetesの有無によって変わります。既存のログ基盤や保持期間、可用性といった条件も関わります。
夜間対応の要否も、金額に影響します。前提条件と納品物の範囲をそろえて比較します。
▶ 詳細はこちら:Zipkinのシステム開発の見積相場や費用/コスト/値段について
導入パターン別の初期費用と期間
初期費用と期間は、対象規模と作業範囲で大きく変わります。導入の段階ごとに、プロジェクト全体で見た推定レンジを比べると、規模による違いが見えます。
- 学習・PoC:50万〜200万円、2〜6週間
- 小規模本番:300万〜800万円、1〜3か月
- 中規模本番:800万〜2,000万円、3〜6か月
- 大規模・高可用性:2,000万〜5,000万円以上、6〜12か月以上の場合あり
学習・PoCは、Docker起動、2〜5サービスの基本計装、代表シナリオ確認までです。小規模本番は5〜20サービスを対象とし、TLSや永続ストレージ、権限に加え、ダッシュボードと運用手順書も含みます。
中規模本番は20〜100サービスを対象に、Collectorやコンテナ基盤、サンプリングを扱い、負荷試験や既存監視との相関まで行います。
大規模案件は、複数クラスタやリージョン、長期保持を求める場合です。SIEM連携や24時間運用を求める場合も、大規模案件に当たります。
金額には、計装や基盤に加えて、テストと運用設計を含みます。Zipkin本体の価格は、この金額の内訳に入っていません。
ランニングコストの内訳
OSSのライセンスが無料でも、クラウドやサーバー、ストレージには費用がかかります。バックアップや監視の仕組みも必要になります。さらに、保守や更新、障害対応も継続して発生する費用です。
- 小規模の自己運用:月20万〜60万円
- 中規模の自己運用:月60万〜200万円程度
- 保守費の考え方:初期開発費の年15〜25%を目安とする場合もある
上記の金額は編集用の推定で、保守担当者の稼働を含めるかどうかで見え方が変わります。トレース量が増えた場合は、別途見直します。
公開料金の例では、2026年2月以降の新規利用で、ホスト時間は1時間あたり0.025米ドルです。trace・log・profileの取り込みは、1GBあたり0.50米ドルです(出典:Application Observability公開料金表、2026年)。
別のサービスでは、100GBまで無料で、超過分を1GB単位で課金する方式があります。ホスト単位やユーザー単位で課金する方式もあります。
比較する際は、1日あたりのspan数をGBへ換算します。採取率や保持日数も含めて月額を試算し、バックアップや検索期間も同じ条件で見ておきます。
Zipkinの開発会社・ベンダーの選び方
ベンダーは、計装から運用引き渡しまで設計できるかで選びます。Dockerを起動できるかは、その前提として確かめます。
Zipkin専用の公開実績に絞ると、候補が少なくなります。そのため、分散トレーシングやOpenTelemetry、APMの経験を確認します。さらに、クラウドネイティブ基盤やログ相関の経験もあわせて見て、自社要件への適用方法を質問します。
計装・Collector・既存監視の技術力の確認
技術提案では、自社の言語や基盤に対応できるかを確かめます。あわせて、コンテキスト伝搬の方法、spanの作成範囲、Collectorの設計を誰が担うかも見ておきます。
- 言語・通信:Java、Spring、Node.js、Python、Go、HTTP、メッセージング
- 収集・保護:receiver、processor、exporter、サンプリング、属性マスキング
- 監視との連携:複数宛先、trace ID検索、メトリクスからの導線、通知
既存のログ検索やメトリクス連携、通知条件までをデモで示せる相手であれば、導入後の運用を具体的に想像できます。
セキュリティ・運用・引き継ぎの範囲の確認
本番運用の提案では、次の点を具体的に確かめます。
- セキュリティ:TLS、認証プロキシ、RBAC、ネットワーク分離、アクセス監査
- 運用条件:保持日数、削除手順、復元、collector障害時の縮退
- 監視導入の内訳:計装対象、採取率、1日span数、保持日数、容量上限、アラート、夜間対応、SLA、運用教育
納品物は、設定ファイルのほかにも、構成図やデータ分類表、テスト結果があります。障害対応・変更手順や操作説明も含め、提案の範囲を比べます。
見積もり依頼で伝える情報
見積もりの前提がそろっていないと、各社の提案を同じ条件で比べられません。依頼の時点で伝えておけば、金額の差の理由を確かめられます。
- 規模・負荷:サービス数、言語と実行基盤、リクエスト数、span数、ピーク負荷、保持日数
- 環境・監視:開発・検証・本番の環境数、既存ログとメトリクスの有無
- 運用・安全性:個人情報の扱い、必要な可用性、24時間対応の要否
- 依頼範囲:PoCか本番運用までか、既存Zipkinの移行か新規構築か
同じ要件の提案であれば、初期費用、運用費、将来の移行費を比べられます。
▶ 詳細はこちら:Zipkinのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Zipkinのシステム開発の発注/外注/依頼/委託方法について
セキュリティと運用で失敗しないための注意点
トレースは障害調査に役立つ一方で、URLやヘッダー、タグに機密情報が混ざる可能性があります。baggageやログとの相関情報についても、注意が必要です。
詳細な記録は、便利さにつながるとは限りません。そのため、収集する属性を定め、不要な情報は記録しない設計にします。
記録してはいけない情報とマスキング
OWASP Logging Cheat Sheetも、除外やマスクなどの対象として示しています(出典:OWASP Logging Cheat Sheet、2026年確認)。そのため、span属性やログには、次の情報を直接含めないようにします。
- 認証・接続情報:アクセストークン、パスワード、暗号鍵、DB接続文字列
- 機微な業務情報:決済情報、要配慮個人情報、セッション識別子
必要な場合は、一方向の識別子や業務上の意味を持たない分類値に置き換えます。元のデータを復元できない形にしておきます。
サンプリングと保持期間の設計
全リクエストを保存すると、データ量や検索負荷、ストレージ費用が増えます。そこで、採取方法と環境ごとの率を設計します。
- head sampling:通常系を一定割合で採取
- tail sampling:結果を見て高遅延やエラーを残す
- 環境別設定:開発・検証・本番で採取率を変える
本番では、正常系を低い割合で、エラーやタイムアウトを高い割合で残す方法もあります。ただし、採取率を下げる前に、KPIを測れる件数を確保できるかを確かめます。
よくある失敗と改善策
導入で起きやすい失敗には、計装の範囲、trace IDの伝搬、属性の付け方、UIの閲覧権限に関わるものがあります。対策は、導入の前に決めておきます。
- データ過多:全サービスを一度に計装すると想定を超えるため、代表フローでのPoC
- IDの途切れ:入口と下流でtrace IDが切れないよう、伝搬の検証
- タグの不統一:サービスごとの差を防ぐため、属性の命名規約を決めておく
- UIの公開:誰でも閲覧できる状態を避け、負荷試験とアクセス制御を行う
collectorや保存先が停止しても業務を止めないよう、送信を非同期にします。あわせて、タイムアウトとバッファの上限も設けます。
よくある質問(FAQ)
Zipkinのシステム導入で寄せられやすい質問に、判断基準を簡潔に答えます。サービス数やデータ量、運用体制に照らして、確認してください。
Zipkinは無料で使えますか?
ZipkinのOSS本体は、ライセンス費用を抑えて利用できます。ただし、導入費用と運用費用がゼロになるとは限りません。
サーバーやストレージ、バックアップが必要になります。計装や保守に加え、監視とセキュリティ対応も必要です。初期費用と月額費用を分けて見積もります。
モノリスのシステムにもZipkinは必要ですか?
単一アプリケーションで処理が完結し、ログとメトリクスで原因を追えるなら、優先度は高くありません。
外部APIやDBをまたぐ場合や、キューやバッチ、別プロセスを経由する場合は、重要なフローから導入できます。将来の分割に向けて処理の境界を知りたい場合も、重要なフローから導入できます。
新規開発ではZipkin exporterを使い続けてもよいですか?
新規開発では、OpenTelemetryとOTLPを入口にする設計を優先します。必要に応じて、ZipkinのOTLP取り込みやCollectorを経由させます。
既存の安定版Zipkin exporterは、2026年12月まで修正する方針です。ただし、提供状況はSDKや言語によって異なるため、採用するライブラリのサポート期間を確認します。
開発会社へ相談するときに何を準備すればよいですか?
相談の前には、構成図や対象サービス、言語を準備します。あわせて、環境数や1日のリクエスト数、ピーク負荷を整理します。障害事例と保持期間も、伝えられるようにしておきます。
既存のログ・監視基盤やセキュリティ上の制約も、共有しておくと役立ちます。そのうえで、PoCか本番運用までか、自社運用か、夜間対応が必要かを明記すると、比較しやすくなります。
まとめ
Zipkinは、分散システムのリクエストをtraceとして追い、遅延やエラーが起きたサービスを可視化します。さらに、trace・spanとIDの仕組みを理解し、ログやメトリクスと組み合わせると、障害対応と性能改善の精度を高められます。
導入は、目的とKPIの定義から始まり、2〜5サービスのPoC、計装と伝搬の検証へと進みます。その後、本番構成を組み、負荷や障害、セキュリティの試験を経て、運用引き渡しに至ります。
推定費用は、PoCが50万〜200万円、小規模本番が300万〜800万円、中規模本番が800万〜2,000万円です。金額は、span数や保持期間によって調整し、可用性や運用体制も踏まえて決めます。
2026年時点で新規に設計するなら、OpenTelemetryとOTLPを中心にし、Zipkinなどのバックエンドへ柔軟に出力できる構成が、将来性の面で有力です。
開発会社やベンダーは、起動実績に加えて、計装やCollector、データ量の扱いを確かめます。さらに、マスキングや認証、バックアップを確かめ、障害訓練や運用引き継ぎまで含めて比べます。
▼関連記事一覧
・Zipkinのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Zipkinのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Zipkinのシステム開発の見積相場や費用/コスト/値段について
・Zipkinのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。