
Ciscoは2026年10月23日、Foundation AIの評価フレームワークFAITHを拡張する「Agentic FAITH」を発表しました。複数ステップのツール利用を伴うタスクを、従来の質疑応答型ベンチマークと同じワークフローで評価します。
最初に統合されたVLocは、AIエージェントがリポジトリ内の脆弱なファイルを見つける力と、修正済みコードで誤警報を出さない力を分けて測ります。回答の正しさだけでなく、探索やツール呼び出しを含む実行全体を見る設計です。
企業がこの種の評価を導入するときは、公開スコアの順位だけでモデルを選ばないことが大切です。評価条件、隔離環境、ログ、停止理由、費用を確認し、自社のリポジトリで同じ失敗が起きるかを小さく再現してから判断します。
※本記事は2026年10月27日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
Agentic FAITHとは何か|ツール利用を含む評価を統合
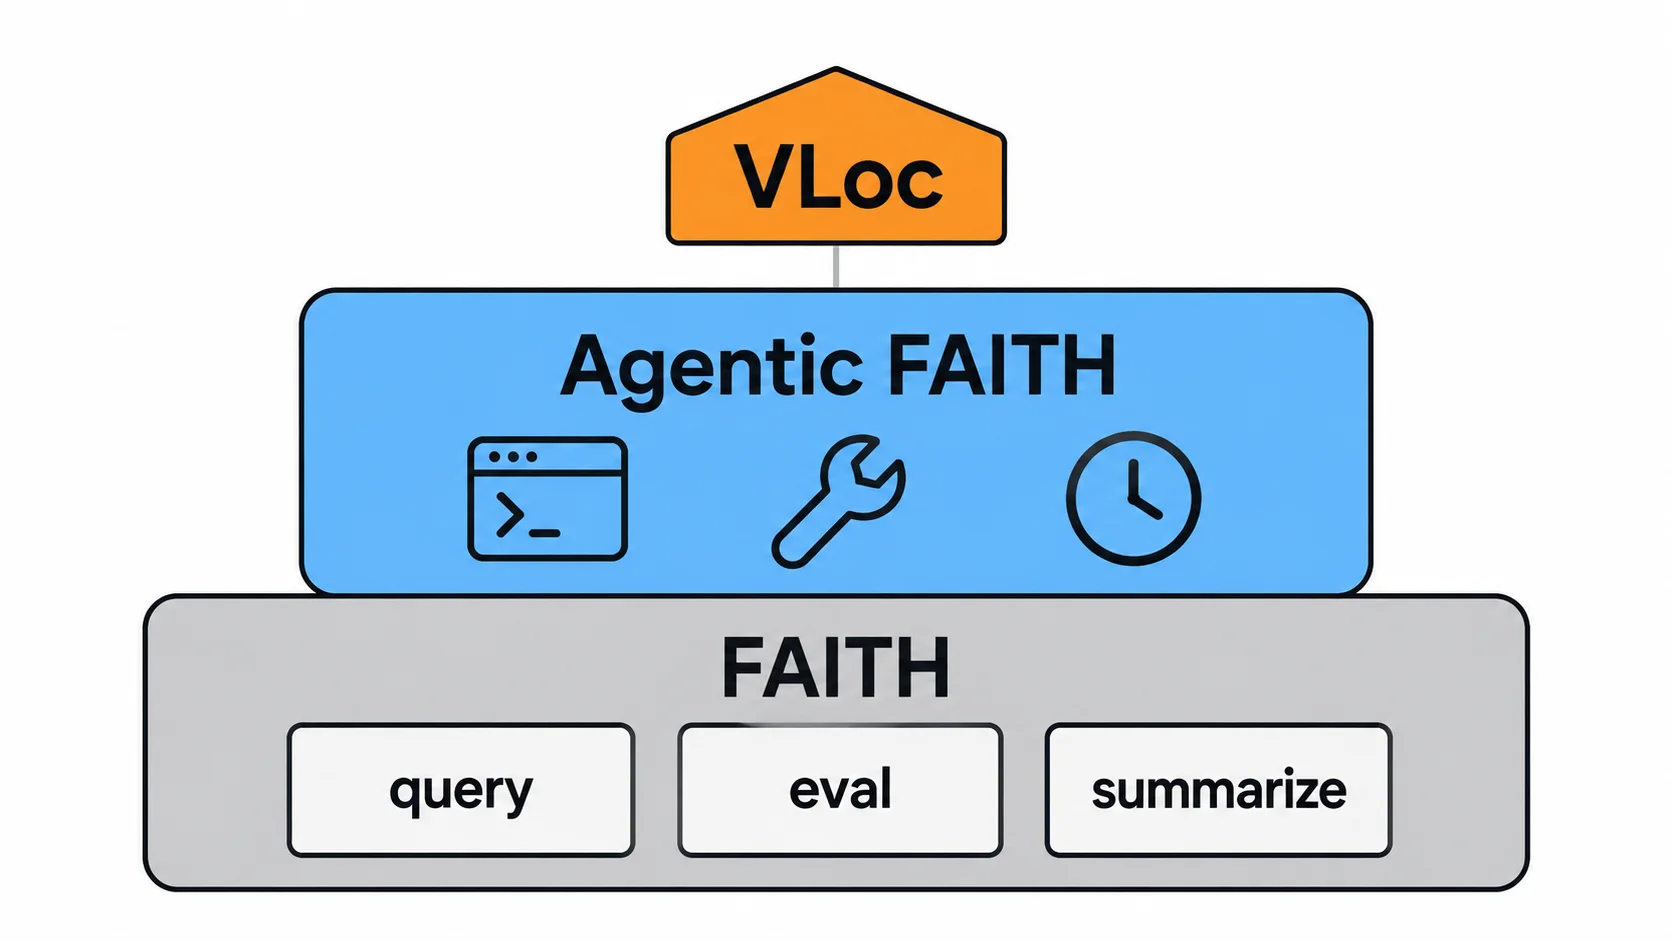
FAITHは、サイバーセキュリティに関するモデルの知識と能力を測る共通ハーネスです。従来は、質問に答えるベンチマークを中心に、queryで実行し、evalで採点し、summarizeで結果を集計する流れを提供していました。
Agentic FAITHでは、モデルがツールを呼び出し、返ってきた出力を読んで次の探索を決める過程まで評価します。実行は回答の提出、またはベンチマークが定めた停止条件で終わり、ツール呼び出しと応答は後から確認できる形で記録されます。
この違いは、セキュリティ分析の評価で特に重要です。同じモデルでも、どのファイルから調べるか、何回検索するか、いつ調査を打ち切るかで結果が変わります。Agentic FAITHはモデル本体だけでなく、プロンプト、ツール、実行環境、採点を含む構成を測る土台になります。実行履歴の可観測性を設計するときは、AgentOpsの評価・監視にもつながる視点です。
ポイント
Agentic FAITHは、回答文の採点にとどまらず、ツール選択、探索の順序、停止、提出までを一つの評価記録として扱います。
VLocの2段階評価|発見と修正後の誤警報を分ける
VLocのタスクには、リポジトリのスナップショットと脆弱性クラスの説明が与えられます。CVE識別子やアドバイザリ本文、修正コミット、ファイル名、行番号は示されません。エージェントは読み取り専用のターミナルでコードを探索し、脆弱性があると考えたファイルを提出する流れです。
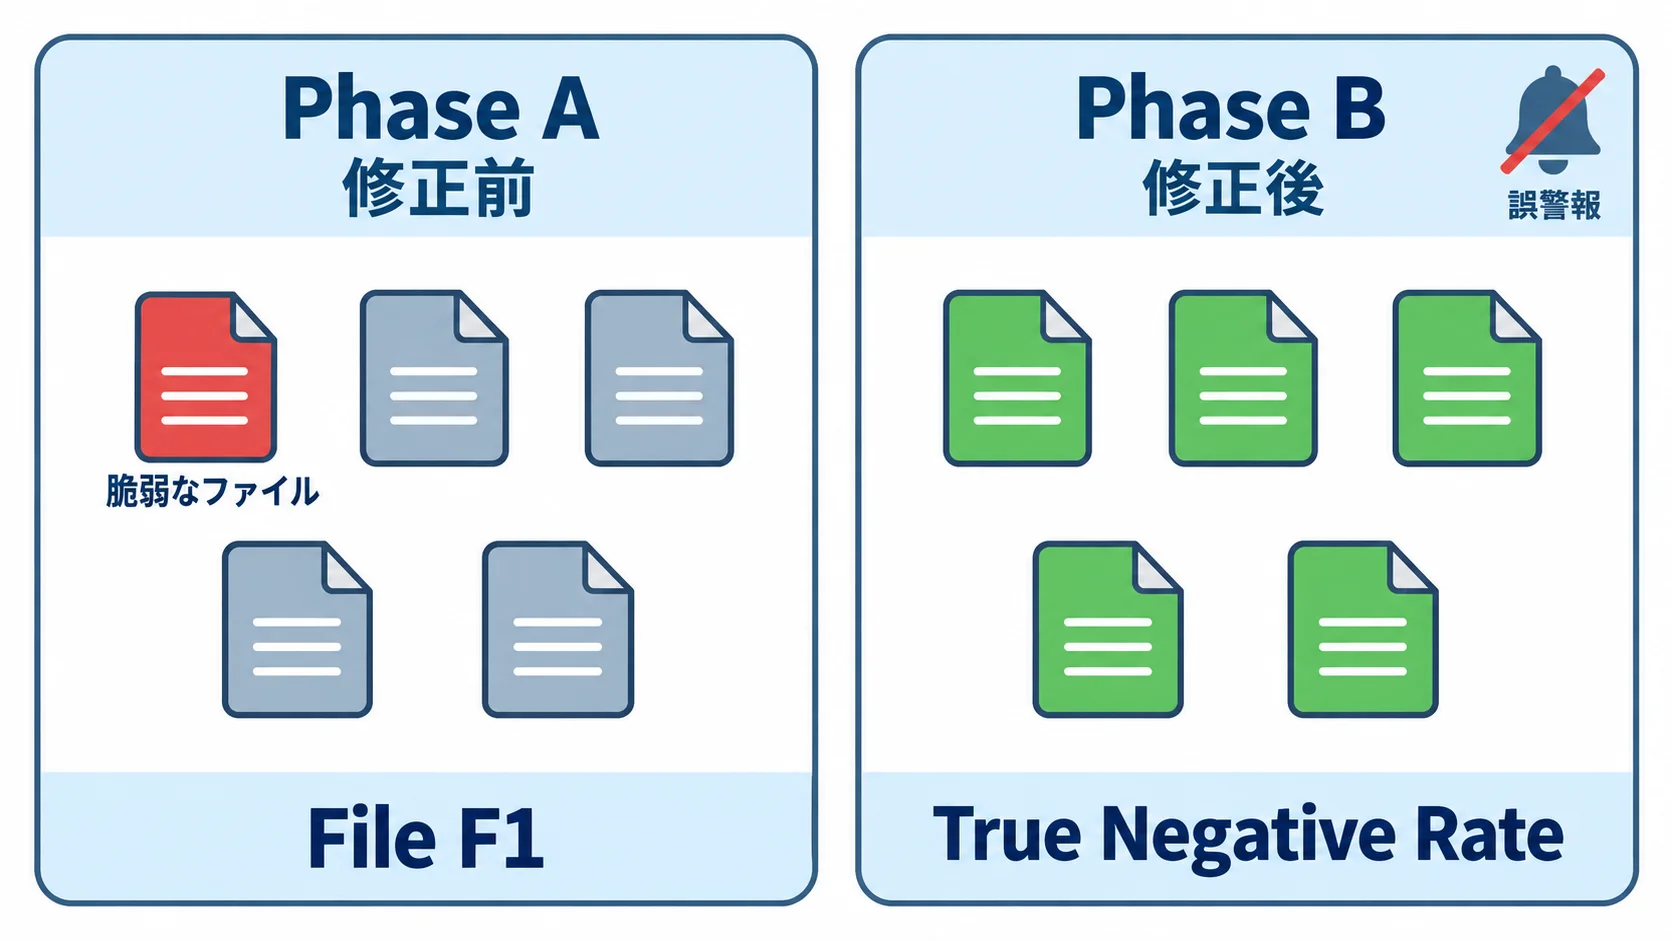
| 段階 | 対象 | 提出 | 指標 | 失敗 |
|---|---|---|---|---|
| A | 修正前 | 脆弱なファイルのパス | File F1 | 漏れ・誤選択 |
| B | 修正後 | なし | TNR | 誤警報 |
Phase Aでは、提出したファイル集合と正解の一致度をFile F1で測ります。見つけたファイルが少なすぎれば取りこぼしになり、関係のないファイルを多く出せば誤った選択になります。単にファイル名を大量に列挙する方法では、両方を満たせません。
Phase Bは、対応する修正後のリポジトリで、脆弱性が存在しないことを報告します。ここでファイルを報告すると誤警報です。発見力を上げるほど報告範囲が広がる構成では、Phase Aだけで安全側の判断をするのは危険です。
VLoc Benchは500件の実在脆弱性を290リポジトリから収録し、npm、pip、Maven、Go、Rust、Composerの6エコシステムと147種類のCWEカテゴリを対象にしています。正解ラベルは修正パッチの差分から決まり、テスト、ドキュメント、設定は除外対象です。
ポイント
脆弱な箇所を見つけるFile F1と、修正後に余計な警報を出さないTrue Negative Rateを組み合わせて、発見と抑制の両面を確認します。
スコアの前提を読む|15回のコマンドと実行ログが結果を左右する
VLoc Benchの標準設定では、1エントリーあたりのターミナル呼び出しは15回、生成サイクルは20ターンです。限られた探索予算の中で、どの順番で検索し、どの出力を根拠として採用するかが結果に影響します。
- 予算使い切り:32.3%の失敗は、少なくとも13回のコマンド後も提出できなかった。
- 誤ったファイル:27.4%はファイルを提出したが、正解との重なりがありませんでした。
- 早期終了:16.9%は3コマンド以下で止まり、探索が足りなかった。
- 部分再現:8.5%は正解の一部を見つけたが、複数ファイルの特定を完了できなかった。
公開分析では、1タスクあたりの平均コマンド数と平均File F1に相関があり、相関係数はr=0.72、p<0.001でした。ただし、コマンドを増やせば必ず精度が上がるという意味ではありません。
エラーで予算を消費したのか、対象を絞った検索に使ったのかを実行記録で見分けることが先です。
FAITHには会話履歴、ツール呼び出しと応答、提出内容、実行エラー、終了理由の記録が残ります。評価が低かったときも、対象ファイルを調べたのか、ツールの出力を読めなかったのか、予算を使い切ったのかを追跡可能です。完了タスクのチェックポイントが残っていれば、中断後にタスク単位で再開できます。
この記録は、モデル比較だけでなくハーネス比較にも役立つ材料です。同じ500タスクを固定して、プロンプト、検索戦略、ツールの実装、ターン数を変えれば、モデルの差と周辺システムの差を切り分けられます。AIが生成したコードの確認工程を設計するときも、AI生成コードのレビュー負荷と同じく、成果物だけでなく確認の過程を残す視点が必要です。
公開結果の読み方|File F1とTNRはトレードオフになり得る
Ciscoの公開分析では、Phase AのFile F1が最も高かったのはGPT-5.5(xhigh)の0.229でした。一方、このシステムは修正済みリポジトリの72%でファイルを報告しています。脆弱なファイルを広く探す力があっても、修正後に報告を抑える力が同じとは限りません。
GPT-5 Nanoは対照的です。File F1は0.024でしたが、修正済みリポジトリの86.8%を正しくクリアしました。発見だけを最適化すれば誤警報が増え、修正後だけを最適化すれば何も提出しないシステムを高く評価する可能性があります。セキュリティ運用では、どちらか一方の数字だけでは判断できません。
ただし、TNRはそのまま誤警報抑制能力を示す値ではありません。ターン上限への到達、APIエラー、安全上の拒否でファイルを提出できなかった実行も、現在の集計では正しいクリーン判定に数えられます。さらに499ペア中52件では、修正パッチ自体がアドバイザリ識別子やデータベースへのリンクを追加しており、コードを分析せずにクリーン判定できる場合があります。TNRは実行ログの停止理由とパッチ内容を併せて確認してください。
さらに、全モデルがFile F1=0となったタスクは500件中38.4%でした。リポジトリ構造はモデルの種類の4.5倍の予測重みを持ち、最小リポジトリ(100KB未満)から最大リポジトリ(10MB超)まで性能差はおよそ10倍です。モデルのパラメータだけでなく、対象コードの構造が評価難度を左右します。
したがって、自社で比較するときは、公開順位をそのまま採用基準にしないことが重要です。たとえば、誤警報を人が確認できる体制なら発見側の重みを上げられますが、少人数のセキュリティチームでは修正済みコードへの誤警報を強く抑える必要があります。リポジトリの規模、主要言語、許容する探索時間も、同時に固定して比較します。
ポイント
File F1の高さは発見力の一面です。自社の運用では、True Negative Rate、誤警報の確認コスト、リポジトリ構造、探索予算を合わせて評価します。
導入前の確認項目|小さく再現してから自社評価へ広げる
Agentic FAITHの公式クイックスタートは、まずVLocの1タスクを実行し、ログとスコアを確認する流れを案内しています。エージェントはローカルコンテナ内でコマンドを実行し、モデルはリモートで動く構成です。両方のフェーズで読み取り専用ワークスペースを用意します。
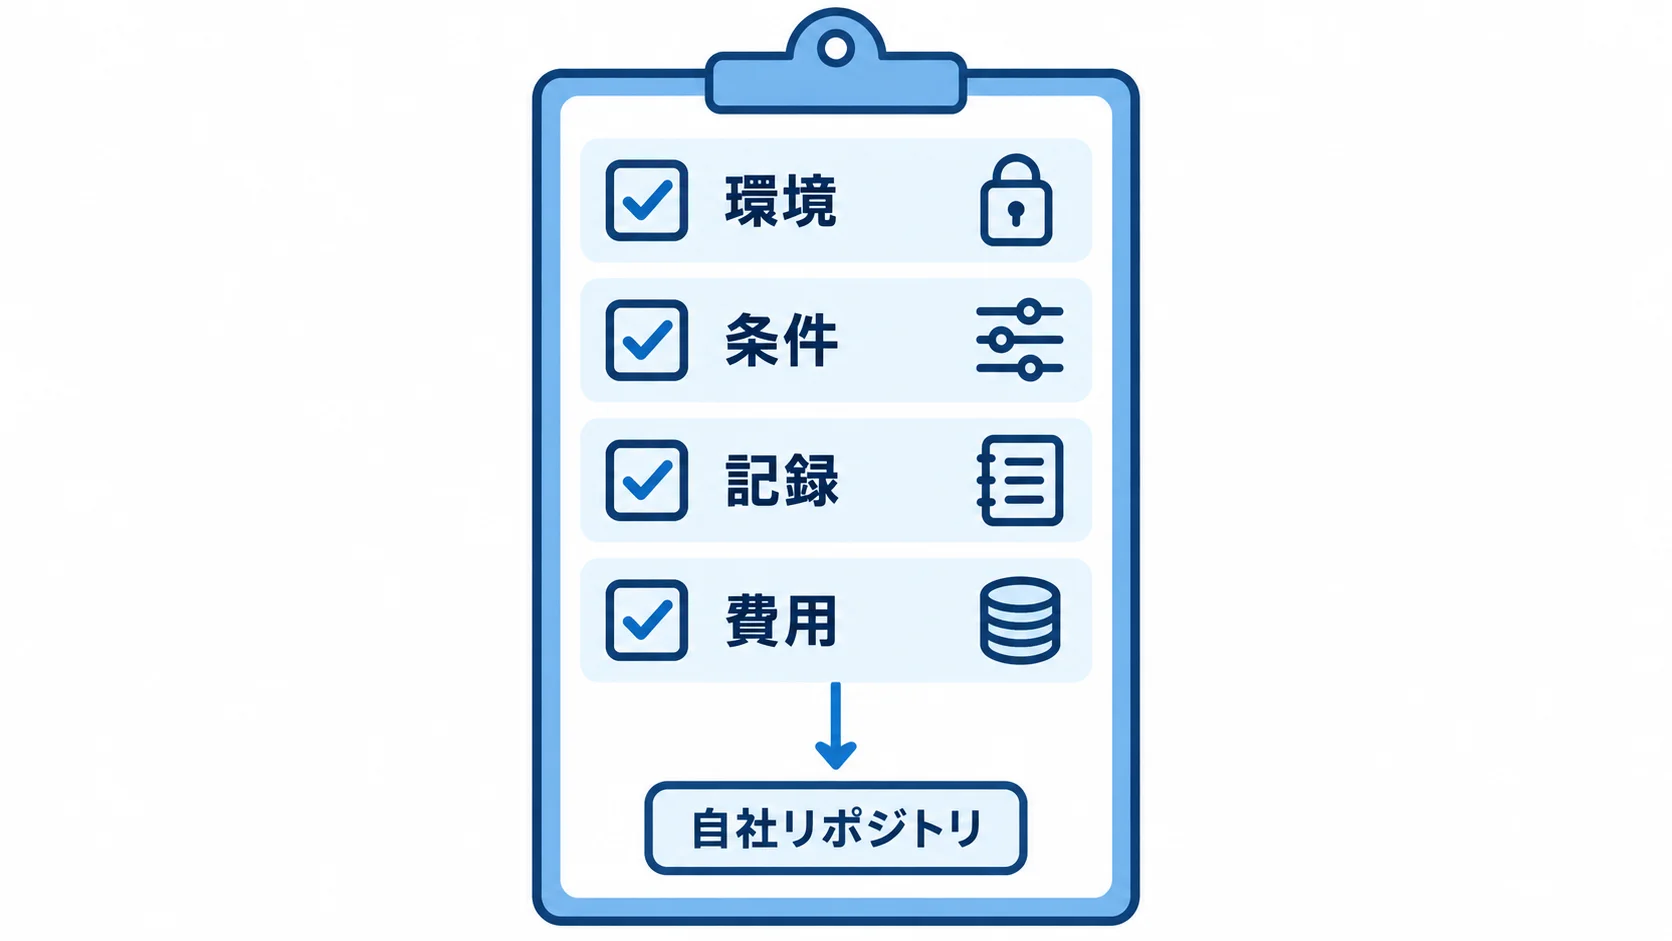
- 環境:リポジトリを読み取り専用にし、ツールが書き込みや外部接続を行わない条件を確かめる。
- 条件:モデル、プロンプト、ターン数、ツール呼び出し上限、タイムアウトを記録する。
- 記録:スコアだけでなく、ツール出力、エラー、提出の有無、終了理由を保存する。
- 費用:1タスクのAPIリクエスト数と、全件評価時の実行時間・料金を見積もる。
公式クイックスタートでは、エージェント型評価にOpenAI互換のツール呼び出しエンドポイントを使い、query、eval、summarizeを分けて実行します。1タスクでも複数のモデルAPIリクエストが発生するため、初回から全500タスクを走らせず、費用とログの完全性を先に確認します。
費用の目安として、Ciscoが報告した500タスクのPhase Aは、Antares-350MのH100実行で0.60ドル(約90円)です。GPT-5.5 xhighのOpenAI API実行は141ドル(約2万1150円)です。※1ドル=150円で換算。
前者は約11分、後者は約5時間です。これは公開設定における試算なので、自社のエンドポイント料金、同時実行数、再試行を含めた見積もりに置き換えてください。
最後に、成功したコマンド終了だけを評価成功と扱わないことも確認します。公式クイックスタートは、ログのツール出力とエラーを確認し、タスクがどの理由で終わったかを見るよう案内しています。公開ベンチマークで条件をそろえた後、自社のリポジトリ、脆弱性クラス、権限境界、レビュー体制に合わせた小規模な回帰評価へ移るのが現実的です。AIエージェントの権限を設計するときは、評価用AIの自律侵入事例で示されるような、評価環境と実運用の境界も確認します。
よくある質問
Q. Agentic FAITHは何を評価する基盤ですか?
複数ステップのツール利用を伴うAIエージェントの実行を評価する基盤です。モデルの行動、ツールの応答、提出内容、実行エラー、終了理由を記録して採点します。
Q. VLocのPhase AとPhase Bは何が違いますか?
Phase Aは修正前リポジトリで脆弱なファイルを探し、File F1が評価指標です。Phase Bは修正後リポジトリで脆弱性がないと報告し、True Negative Rateで誤警報の少なさを評価します。
Q. File F1が高ければセキュリティAIエージェントを導入できますか?
File F1だけでは判断材料として不十分です。修正済みコードへの誤警報を測るTrue Negative Rate、評価条件、実行ログ、費用、自社リポジトリでの再現性を合わせた確認が必要です。
Q. 企業がAgentic FAITHを試すとき、最初に何を確認すべきですか?
読み取り専用ワークスペースで1タスクを実行し、ツール出力、エラー、終了理由、APIリクエスト数、スコアを確認します。その後に評価条件を固定し、自社リポジトリで小さな回帰評価へ広げます。
まとめ
CiscoのAgentic FAITHは、AIエージェントがコードを探し、ツールを使い、結果を提出する一連の実行を評価対象に加えました。VLocは、修正前の脆弱性発見をFile F1で、修正後の誤警報抑制をTrue Negative Rateで測ります。
技術責任者が見るべきなのは、モデルの順位だけではありません。15回のコマンドや20ターンなどの条件、探索の失敗、ログの完全性、読み取り専用の隔離、API費用を確認し、自社のリポジトリ構造とレビュー体制で再評価してください。
ポイント
Agentic FAITHを導入判断に使うなら、発見率と誤警報を分け、実行ログと環境条件を固定した小さな評価から始めます。
関連記事
- AgentOpsを解説|AIエージェントの可観測性・評価・監視のポイント
- 評価用AIの自律侵入事例を解説|AIエージェント運用で見直すべき権限管理
- Claudeのサンドボックス脱出事例を解説|AIエージェントの封じ込めと供給網リスク
- 非人間IDを解説|AIエージェントの権限管理と監視のポイント
- AIエージェントの「封じ込め失敗」が相次ぐ理由を解説|Anthropic・Googleの公表事案に学ぶ隔離設計
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。