
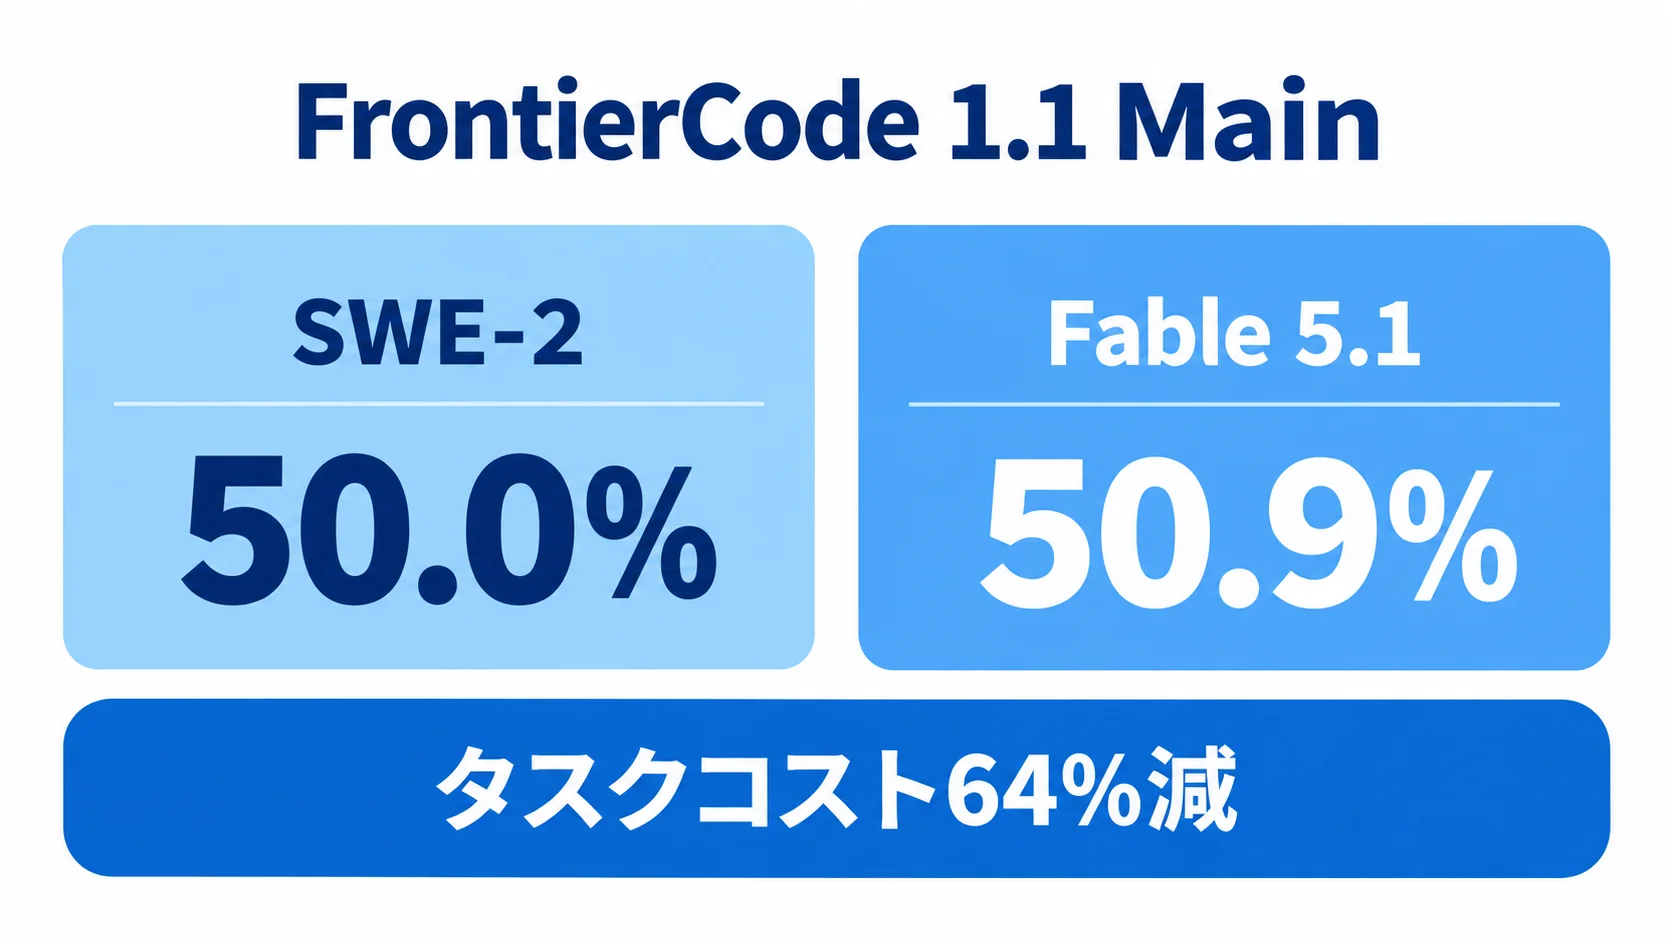
Cognitionは2026年9月10日、コーディングモデル「SWE-2」を発表しました。SWE-2はFrontierCode 1.1 Mainで50.0%を記録し、Fable 5.1の50.9%に1ポイント以内で、Cognitionの比較ではタスクコストが64%低いモデルです。
この「64%安い」は、すべてのAPI利用や開発業務の料金が64%下がるという意味ではありません。FrontierCode 1.1 Mainで測ったタスク単価の比較であり、トークン単価や自社の月額費用にそのまま置き換えられない点に注意が必要です。
SWE-2はDevin DesktopとDevin CLIから提供され、Devin WebとFusionにも展開されています。ベンチマークごとの差、medium・high・maxの努力レベル、frontierモデルと組み合わせるFusionを見ながら、社内の代表タスクで品質と総コストを測ることが導入判断の出発点になります。
※本記事は2026年10月14日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
SWE-2とは|9月10日にCognitionが発表したコーディングモデル
SWE-2は、CognitionがDevin向けに開発したコーディングモデルです。Cognitionは2026年9月10日の発表で、FrontierCode 1.1 Mainのスコアを50.0%と公表しました。Fable 5.1の50.9%に近い数値ですが、評価条件と実行環境を含む結果として読む必要があります。
提供先は単独のAPIではありません。発表時点でDevin DesktopとDevin CLIから利用でき、Devin WebとFusionにも展開すると説明されています。つまり、SWE-2はモデル単体の性能だけでなく、コードを読み、編集し、ビルドやテストを実行する開発エージェントの中で使う前提の製品です。
ポイント
SWE-2はDevinの開発エージェントで使うコーディングモデルです。「64%安い」はFrontierCode 1.1 Mainにおけるタスクコスト比較で、トークン単価の値ではありません。
ベンチマーク比較|Fable 5.1に近いがタスク別の差は大きい
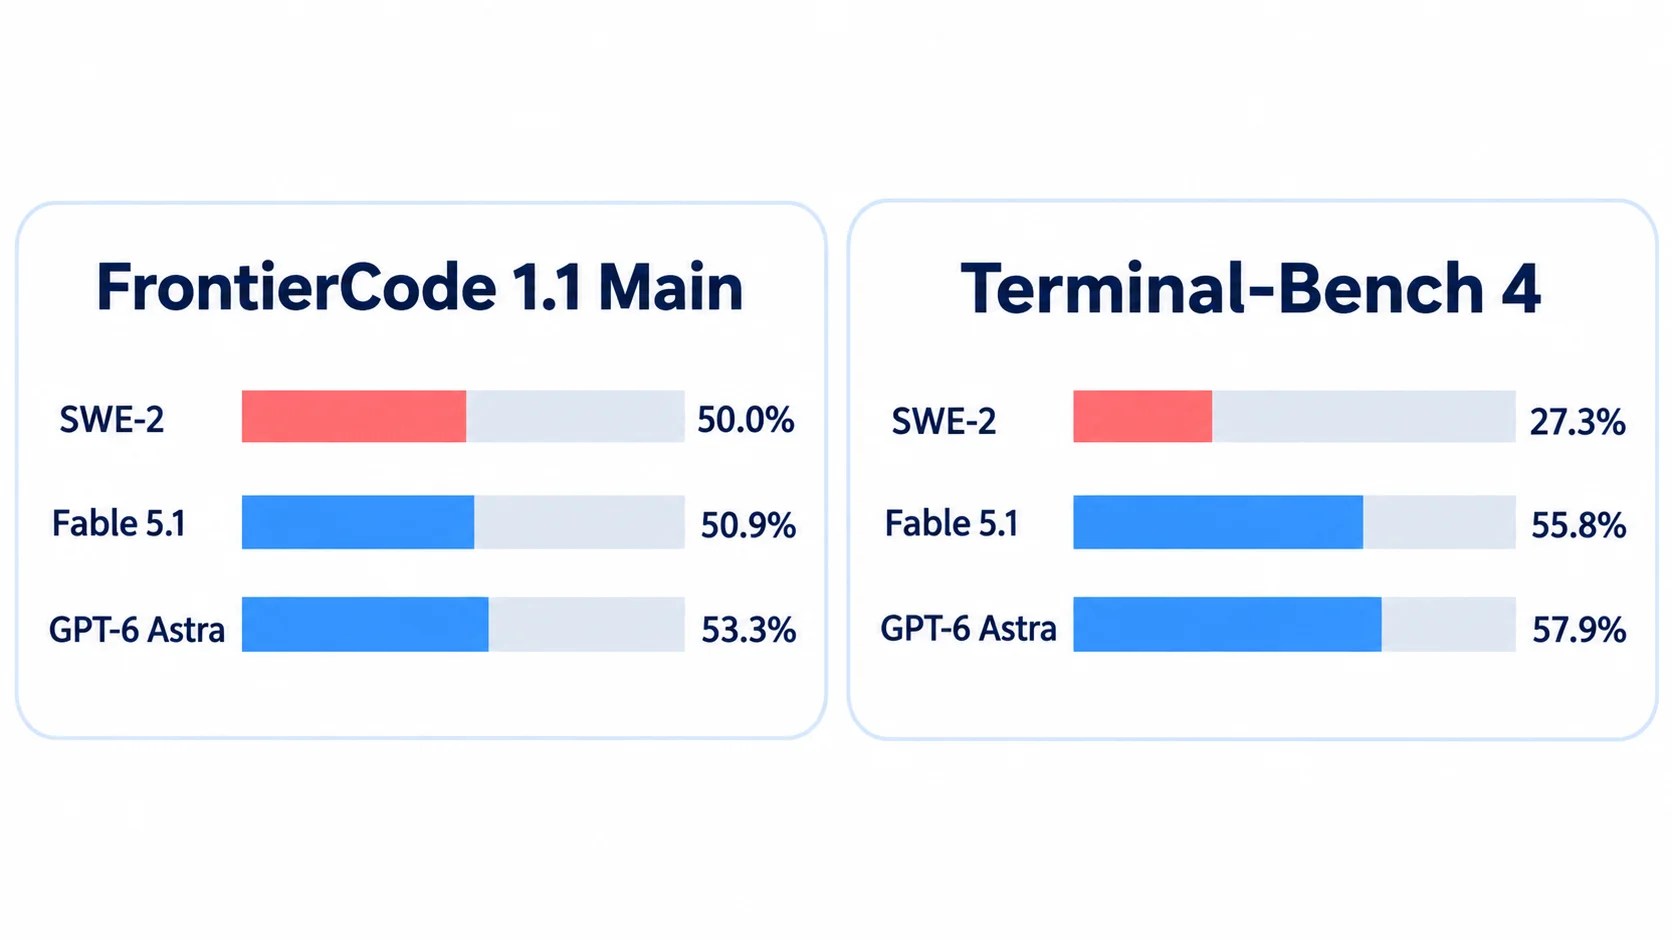
SWE-2の評価は、ベンチマークを変えると見え方が変わります。FrontierCode 1.1 MainではFable 5.1に近い結果です。Terminal-Bench 4では27.3%で、Fable 5.1の55.8%やGPT-6 Astraの57.9%を大きく下回りました。
| モデル | FrontierCode 1.1 Main | DeepSWE 1.1 | Terminal-Bench 2.1 | Terminal-Bench 4 |
|---|---|---|---|---|
| SWE-2 | 50.0% | 73.0% | 92.8% | 27.3% |
| Kimi K3 | 44.2% | 68.5% | 88.3% | 21.5% |
| Grok 4.6 | 48.0% | 67.5% | 88.4% | 20.3% |
| Fable 5.1 | 50.9% | 67.4% | 91.4% | 55.8% |
| GPT-5.6 Sol | 47.5% | 72.7% | 88.8% | 37.3% |
| GPT-6 Astra | 53.3% | 74.1% | 89.9% | 57.9% |
| SWE-1.7 | 42.0% | 37.7% | 81.5% | 7.6% |
DeepSWE 1.1ではSWE-2が73.0%、Terminal-Bench 2.1では92.8%でした。反対に、長い端末作業を含むTerminal-Bench 4ではFable 5.1との差が28.5ポイントあります。1つの表の一列だけを見て、SWE-2がすべての開発作業で最上位だと判断することはできません。
FrontierCode 1.1は、オープンソースコードベースの実際のPRをもとにしたタスクで、ドキュメント参照など正当なインターネット利用を認めています。1,000件超の評価基準を監査し、75件を修正したうえで、Mainは100タスク、Extendedは150タスクの評価対象です。モデルごとのハーネスと努力レベルも異なるため、AI生成コード時代のコードレビューまで含めて検証します。
ポイント
FrontierCode 1.1 Mainの近さはニュースの入口です。短い修正、テスト、長時間の端末操作など、自社の仕事に近い評価セットでモデルを比べます。
コスト性能の仕組み|努力レベル全体をRLで同時に学習
SWE-2のコスト性能は、単純な値引きではありません。Cognitionは推論努力の全レベルを1回の強化学習(RL)実行で学習し、成功率とロールアウトのコストを同時に扱う設計を説明しています。報酬関数はR = S - λ_e Cで、Sは成功、Cは米ドルの推論コストとロールアウト時間を組み合わせたコストです。
λ_eは努力レベルごとに、ベースモデルのパレート曲線の傾きに合わせて調整します。これにより、最も賢い一つの設定だけを伸ばすのではなく、コストと成功率の組み合わせを複数の努力レベルで改善する狙いです。
学習基盤では、SWE-1.7以降にRL環境を3倍へ増やし、指示追従のオーバーレイを加え、過去のSWE-2チェックポイントで検証器を強化しました。NVFP4/FP8カーネルや量子化認識学習も使い、同程度のスループットでメモリ使用量と学習・推論の差を抑えたとしています。
こうした訓練設計は、SWE-2がなぜ少ないターン数で作業を進められるのかを説明する材料になります。ただし、モデル内部の工夫が自社の費用を保証するわけではありません。成功率、修正回数、レビュー工数を一つのタスク単価として記録してください。
ポイント
SWE-2は成功率とロールアウトコストを同時に学習する設計です。導入時は、モデルの説明ではなく自社タスクの成功率・ターン数・レビュー工数で費用を測ります。
medium・high・maxの選び方|短い修正と複雑な変更を分ける
SWE-2はmedium、high、maxの努力レベルを使い分けます。CognitionのFrontierCode 1.1 Mainでは、SWE-2 mediumがSWE-1.7より高いスコアを取りながら、平均ターン数は58%少なく、平均コストは81%低くなりました。
| 設定 | 平均ステップ数 | 使い分けの目安 |
|---|---|---|
| SWE-1.7 | 127 | 比較対象 |
| SWE-2 medium | 53 | 単純・中程度のタスク |
| SWE-2 high | 80 | 複雑なタスク |
| SWE-2 max | 98 | より多くの計画・探索・検証が必要なタスク |
※1ドル=150円で換算。円換算は目安で、実際の請求額は契約条件で変わります。
100タスクを各モデル3回実行した平均ステップ数は、SWE-1.7が127、SWE-2 mediumが53、highが80、maxが98でした。最初の実質的な編集に到達する中央値も、SWE-1.7の48ステップに対してSWE-2 mediumは18ステップです。
mediumは早く着手しやすく、短い修正や中程度の変更の初期候補になります。highとmaxは複雑な変更で計画・探索・検証を増やす設定です。単純な作業までmaxに固定すると、品質向上よりも待ち時間とコストが先に増えるため、タスク種別で初期設定を分けます。
モデル選定では、スコアだけでなく、完了までのターン、テストの通過率、レビューで戻った回数の記録が必要です。複数モデルの開発体験を比較する際は、Codex vs Claudeの1週間比較のように、同じ作業を同じ条件で測る考え方が参考になります。
ポイント
mediumを短い修正の初期設定にし、high・maxは複雑な変更へ回します。成功率だけでなく、完了時間とレビュー工数を含めて努力レベルを決めてください。
Fusionと導入判断|SWE-2単体か2モデル構成かを測る
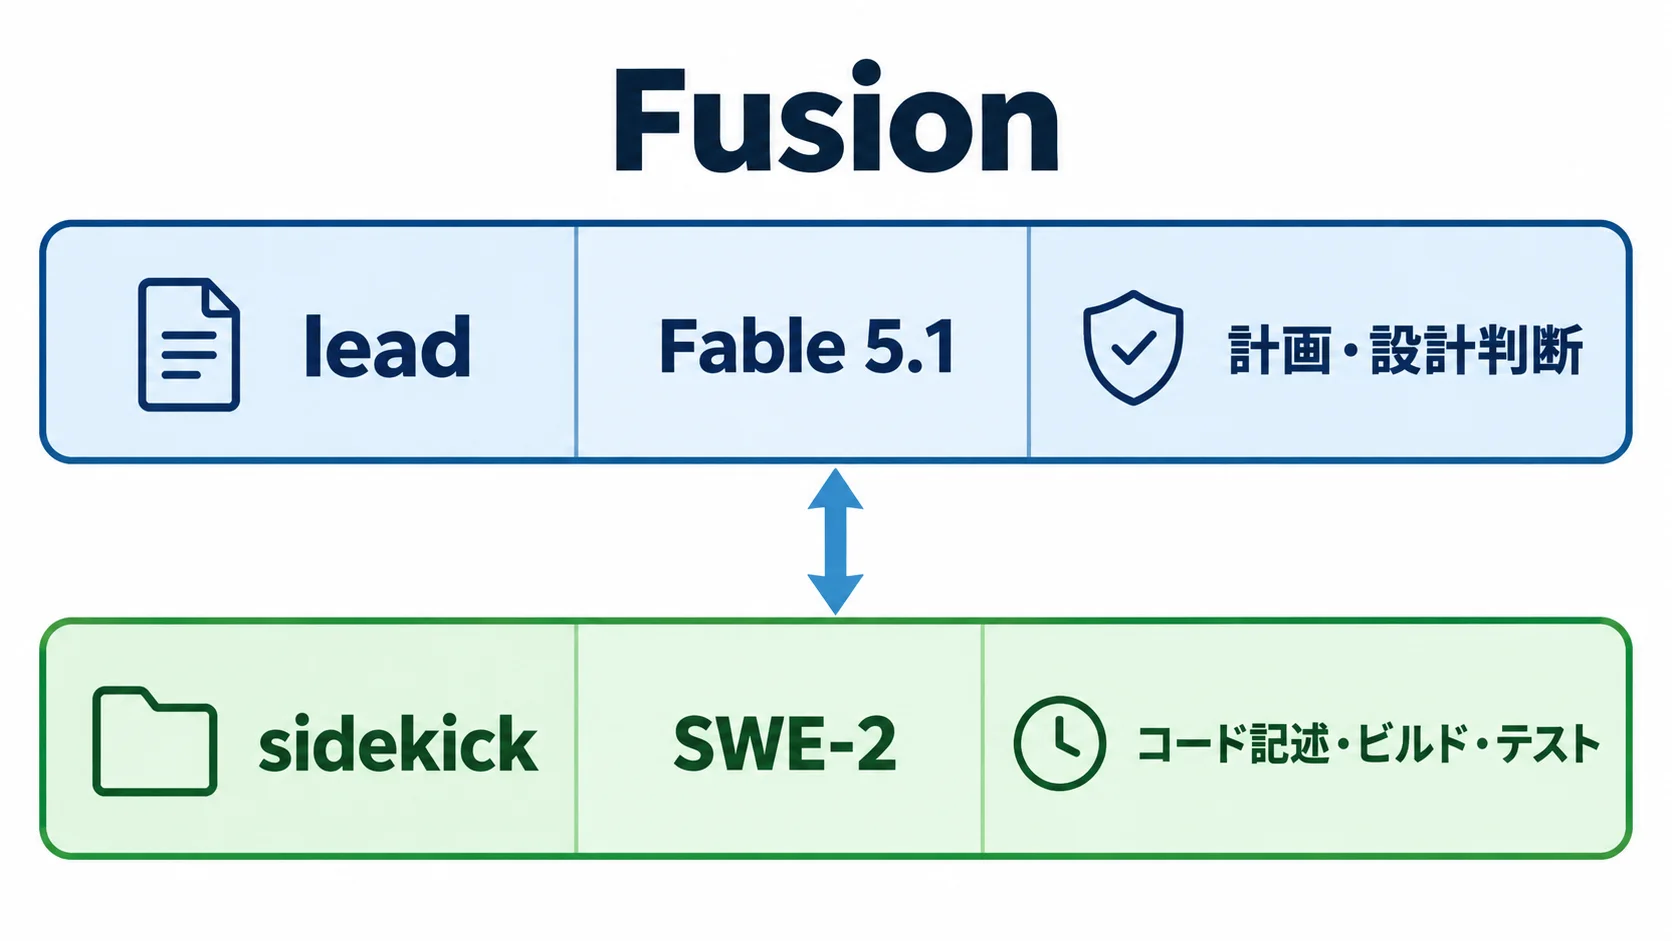
Fusionは、frontierモデルをlead、コスト効率を重視するモデルをsidekickにする2モデル構成です。leadが計画・設計判断・調査・重要な正しさを担い、sidekickがコード記述・ビルド・テスト・変更確認を実行します。CognitionはFable 5.1をlead、SWE-2をsidekickにする組み合わせを推奨しています。
| ベンチマーク | Fable 5.1 | Fusion(Fable 5.1 + SWE-2) | コスト差 |
|---|---|---|---|
| DeepSWE 1.1 | 64.3点・$14.63(約2,195円) | 63.1点・$7.88(約1,182円) | 46%減 |
| Terminal-Bench 4 | 57.6点・$17.46(約2,619円) | 56.1点・$13.37(約2,006円) | 23%減 |
| SWE-Atlas QnA | 64.8点・$7.57(約1,136円) | 65.9点・$5.00(約750円) | 34%減 |
| Vals Code Migration | 54.6点・$70.97(約10,646円) | 57.3点・$42.00(約6,300円) | 41%減 |
| FrontierCode 1.1 Extended | 63.6点・$2.68(約402円) | 63.5点・$1.67(約251円) | 38%減 |
表のFusion比較はSWE-2単体の性能ではありません。Fable 5.1とSWE-2を組み合わせたセッション全体の結果です。料金もペア内の各モデルをそれぞれの単価で請求し、企業向けCognition Platformでは両モデルのトークン使用量に応じてACUで計測されます。AgentOpsの可観測性・評価・監視と同じように、モデル別の利用量を追える状態が必要です。
Fusionは有料プランのDevin CLI 3000.10.20以降、Devin Desktop 3.10.0以降で利用できます。無料・トライアル tierやlegacy/credit-based planには含まれません。導入前に契約プラン、アプリのバージョン、リポジトリへの権限、データの扱いを確認してください。
導入検証は、SWE-2単体とFusionを同じ代表タスクで走らせるところから始めます。成功率、完了時間、モデル別のコスト、レビューでの修正回数を揃え、開発チームが許容できる品質ラインを下回らない構成だけを段階的に広げます。
ポイント
Fusionの比較値はFable 5.1とSWE-2の合計結果です。単体モデルの評価と混同せず、2モデルの総コスト・レビュー品質・利用条件を同じセッション単位で比べます。
よくある質問
Q. CognitionのSWE-2はいつ発表されましたか?
2026年9月10日に発表され、Devin DesktopとDevin CLIから提供開始されたとCognitionが説明しています。
Q. SWE-2の「Fable 5.1より64%安い」は何を意味しますか?
FrontierCode 1.1 MainにおけるCognitionのタスクコスト比較です。すべての業務のトークン単価が64%安いという意味ではありません。
Q. SWE-2はFable 5.1と同じ性能ですか?
FrontierCode 1.1 Mainでは50.0%対50.9%ですが、Terminal-Bench 4では27.3%対55.8%です。タスクによって差があるため、同じ性能とは判断できません。
Q. FusionではSWE-2だけを使いますか?
Fusionはfrontierのleadとコスト効率を重視するsidekickを組み合わせる仕組みです。Fable 5.1 + SWE-2では両モデルが別々に課金されます。
まとめ
CognitionのSWE-2は、FrontierCode 1.1 Mainで50.0%を記録し、Fable 5.1に近いスコアをタスクコスト64%減で実現したと発表されたコーディングモデルです。一方、Terminal-Bench 4では27.3%にとどまり、ベンチマークによって得意な仕事が分かれます。
導入時はmedium・high・maxをタスクの難度で使い分け、SWE-2単体とFusionのセッションを同じ条件で測ります。成功率、ターン数、レビュー工数、2モデルの合計コストを社内タスクで記録し、品質ラインを保てる範囲から対象を広げてください。
ポイント
SWE-2の導入判断は、64%という見出しではなく、自社タスクで品質・時間・レビュー工数を含むタスク単価を測って決めます。
関連記事
- Gemini Enterprise Agent Platformを解説|企業向けエージェント基盤の機能と運用ポイント
- Agent Plugins 1.0を解説|主要ベンダー横断のAIエージェント拡張規格と選定ポイント
- 非人間IDを解説|AIエージェントの権限管理と監視のポイント
- Claudeのサンドボックス脱出事例を解説|AIエージェントの封じ込めと供給網リスク
- AIエージェント導入を解説|過度な期待を避けるROI評価のポイント
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。