
MiniMaxは2026年10月19日、エージェントタスクやコーディング、Computer Use向けの「MiniMax M3.1 Flash」を正式提供しました。
オンライン推論は前世代比で約3倍速く、エージェントタスクの利用コストは70%低いと同社は説明しています。入力は100万トークンあたり0.15ドルで、長いコードベースや複数ステップの処理を低い単価で回したい企業が検討しやすいモデルです。
API、M Plan、MiniMax Codeに加え、公式モデルカードには重みのダウンロード手順も掲載されています。利用形態を選ぶ際は、ベンチマークの数値だけでなく、自社の入力長、出力量、推論設定、運用体制を同じ条件で比べる必要があります。
※本記事は2026年10月28日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
MiniMax M3.1 Flashとは|エージェント・コーディング向けに正式提供
MiniMax M3.1 Flashは、質問に答えるだけのモデルではありません。MiniMaxは、SaaSをまたぐ業務、複数ファイルの処理、コードの修正とテスト、コンピューター操作、サイバーセキュリティを対象領域として示しています。
エージェントは、依頼を受けて計画を立て、ツールを呼び出し、結果を見て次の処理へ移る仕組みです。1回の回答品質より、途中で文脈を保ちながら何手も実行できるかが成否を左右します。M3.1 Flashの「Flash」は、この長い処理を速度と費用の両面から軽くする方向性を示しています。
企業での位置付けを考えると、単体のチャット導入より、既存のエージェント基盤に組み込む候補として見るのが自然です。たとえば、Gemini Enterprise Agent Platformのような基盤と比べる際も、モデルの知能だけでなく、ツール接続、監査、権限管理まで同じ表に並べて評価します。
ポイント
M3.1 Flashは、短い対話の置き換えより、ツール呼び出しを含む長い業務フローで速度と単価を測るモデルです。
1Mトークンと常時推論|長い処理を支えるAPI仕様
公式APIドキュメントでは、コンテキストウィンドウは最大1,000,000トークンです。大規模なコードベース、長い資料、複数回のツール実行結果を一つのセッションに保持しやすくなります。入力を詰め込めばよいという意味ではなく、何を毎回渡し、何をキャッシュするかが設計上の論点です。
入力はテキストだけでなく、画像と動画にも対応します。出力はテキストです。画面の状態や資料を読み取り、テキストで次の操作や判断を返す使い方に向きます。画像・動画の生成モデルと混同しないことが、システム構成を決める前提になります。
effortで推論の深さを調整する
M3.1 Flashの推論は常時有効で、無効化できません。APIのeffortはlow、medium、high、xhigh、maxを受け付け、指定しない場合の既定値はmaxです。深い推論ほど出力トークンとレイテンシーが増えるため、すべての処理を最大設定にする必要はありません。
OpenAI互換APIではreasoning_effort、Anthropic互換APIではoutput_config.effortを使います。推論内容はそれぞれreasoning_contentとthinkingに分かれて返るため、既存クライアントが最終回答だけを表示する実装になっているかを確かめます。
ポイント
1Mトークンを使えることより、入力の再利用とeffortの段階設定を組み合わせ、費用と応答時間を管理できることが実務上の利点です。
200TPS超と70%コスト減|料金を円換算で見る
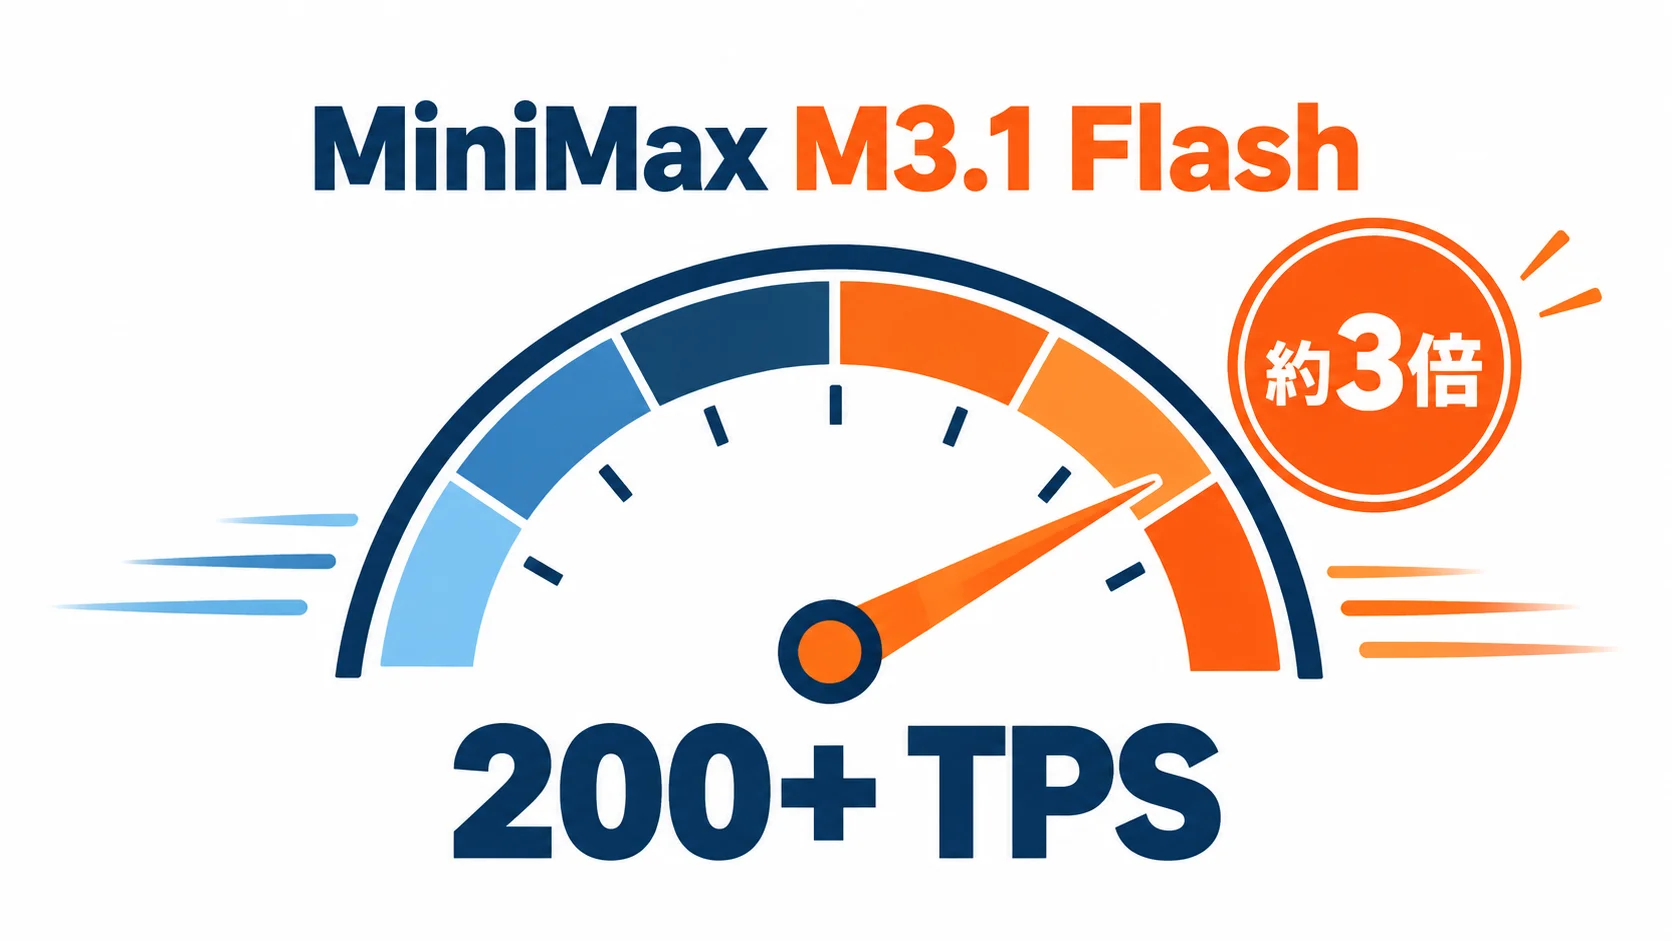
MiniMaxの発表では、日常利用時の出力速度は200+ TPS、中央値(P50)は170+ TPSです。オンライン推論は前世代比で約3倍速いとされています。TPSは環境やリクエストの条件で変わるため、自社のプロンプト、出力長、同時実行数を固定して測定するのが前提です。
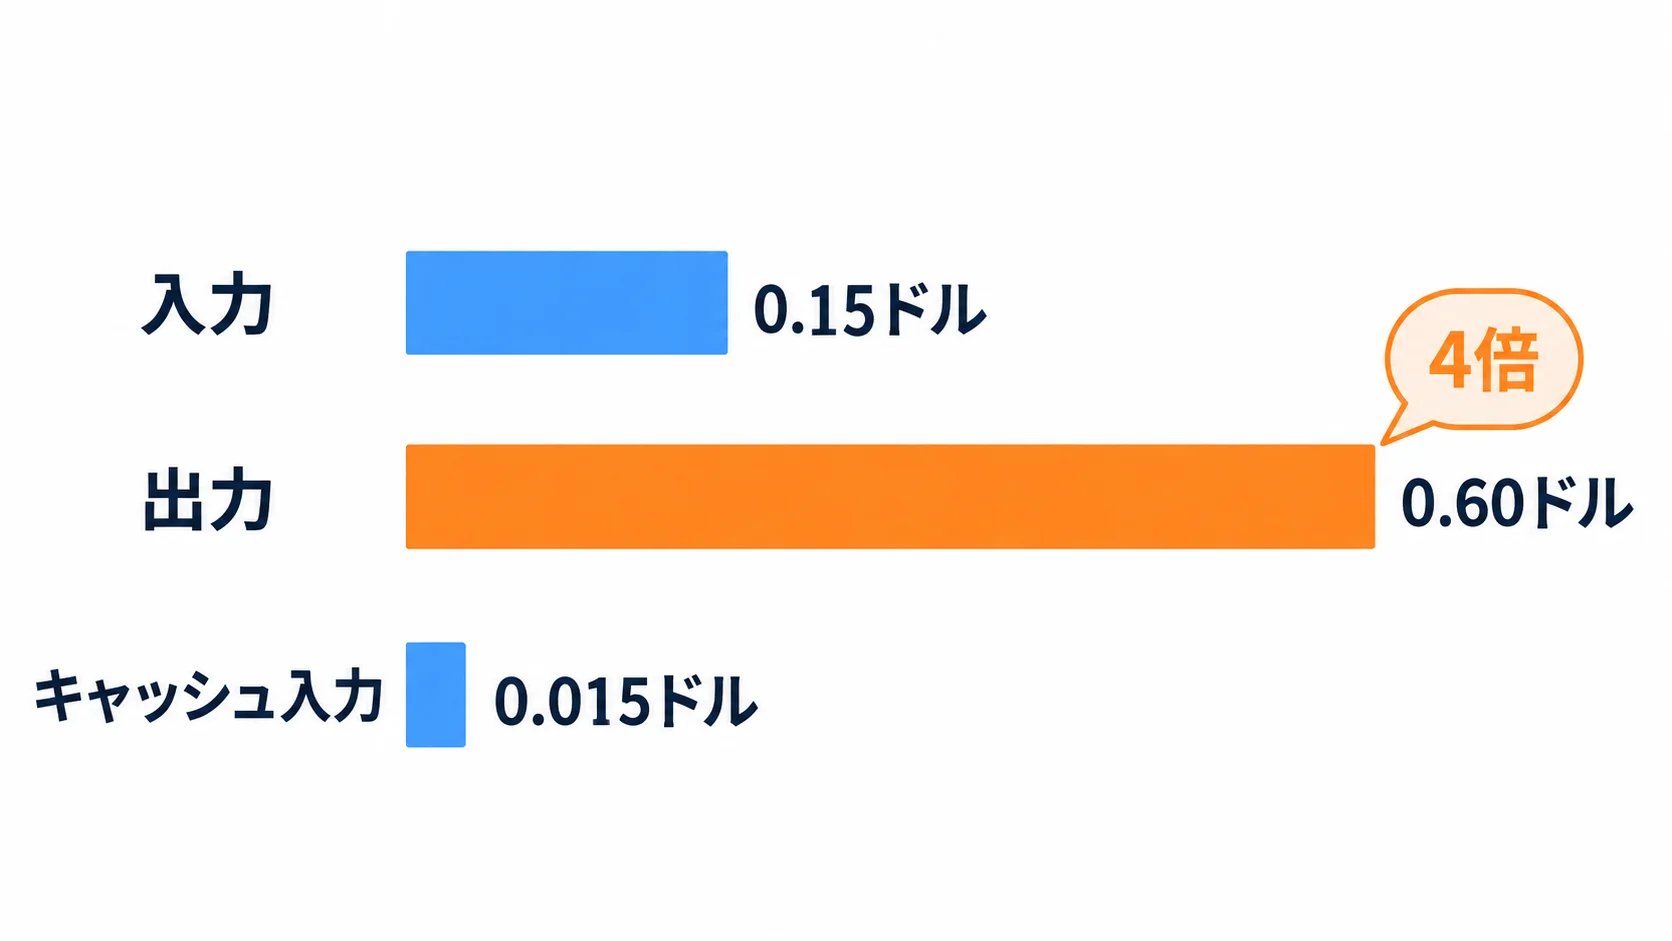
料金は入力・出力・キャッシュ入力で分かれます。※1ドル=150円で換算した金額です。1回の処理で入力100万トークン、出力10万トークンを使うなら、入力0.15ドル(約23円)と出力0.06ドル(9円)の合計で約32円です。実際には推論内容のトークンやツール呼び出しの回数も費用に影響するため、単純な文字数だけで月額を決めません。
| 項目 | 価格(100万トークン) | 円換算 |
|---|---|---|
| 入力 | 0.15ドル | 約23円 |
| 出力 | 0.60ドル | 90円 |
| キャッシュ入力 | 0.015ドル | 約2.3円 |
出力単価は入力の4倍です。エージェントが長い推論や説明を毎回出す設計では、入力の安さだけでなく出力の上限とeffortを管理します。反復するシステム指示やコードの一部はキャッシュ対象として整理し、実測した入力・出力・キャッシュの内訳を月次で確認して予算と実績の差を追う運用が必要です。
ベンチマークとマルチモーダル|適用領域を切り分ける
公式モデルカードは、エージェント、コーディング、コンピューター操作、セキュリティに関する複数の評価を掲載しています。BankerToolBenchは76.2、DeepSWE v1.1は73.7%、OSWorld 2.0は61.7、Agents’ Last Examは29.6、CyberGymは82.2です。
これらはタスクごとの評価値であり、導入後の業務成果を直接示すものではありません。コード修正ならテスト通過率と人手のレビュー時間、Computer Useなら操作完了率と誤操作率、文書業務なら出典確認にかかる時間を測ります。モデルの得意領域と自社の成功条件を一対一で対応させることが大切です。
ツールを複数つなぐ場合は、モデルの能力だけでなく、呼び出し先の権限や失敗時の停止条件も評価します。AWS「Kiro Crew」のようなマルチエージェント設計を参考にする場合も、担当を増やす前に、1つのエージェントがどこまで安全に完了できるかを測定する設計です。
画像・動画入力は、画面比較、図表の読み取り、映像のショット分析などに使えます。M3.1 Flash自身の出力はテキストなので、生成物を返す処理では別のツールやモデルを組み合わせる構成です。
ポイント
ベンチマークの順位を導入判断に直結させず、自社の完了率、レビュー時間、誤操作率を評価指標として先に定義します。
API・重み公開と導入判断|小さく検証してから広げる
クラウド側の利用経路としてMiniMax API、M Plan、MiniMax Codeがあり、これに公式重みを使う自社運用が加わります。公式モデルカードには重みのダウンロード方法と、SGLang、vLLM、TokenSpeedを使ったローカル展開の案内があります。モデルカード上の構成は総パラメータ約428B、トークンごとの活性化パラメータ23Bです。
APIは検証を始めやすい一方、入力データの扱い、利用量、障害時の切り替えをサービス条件と合わせて確認する必要があります。重みを自社環境で動かす場合は、GPUメモリ、推論基盤、モデル更新、監視、脆弱性対応まで自社で担う体制が必須です。総パラメータの大きさだけで可否を決めず、実際の構成で必要な資源を見積もります。
導入前にそろえる4つの測定値
- 品質:正解率、テスト通過率、出典の確認率をタスクごとに記録する。
- 速度:初回応答と完了までの時間を、同時実行数をそろえて測る。
- 費用:入力・出力・キャッシュ入力と
effort別の単価を集計する。 - 安全性:ツール権限、停止条件、ログ、失敗時の人手承認を確認する。
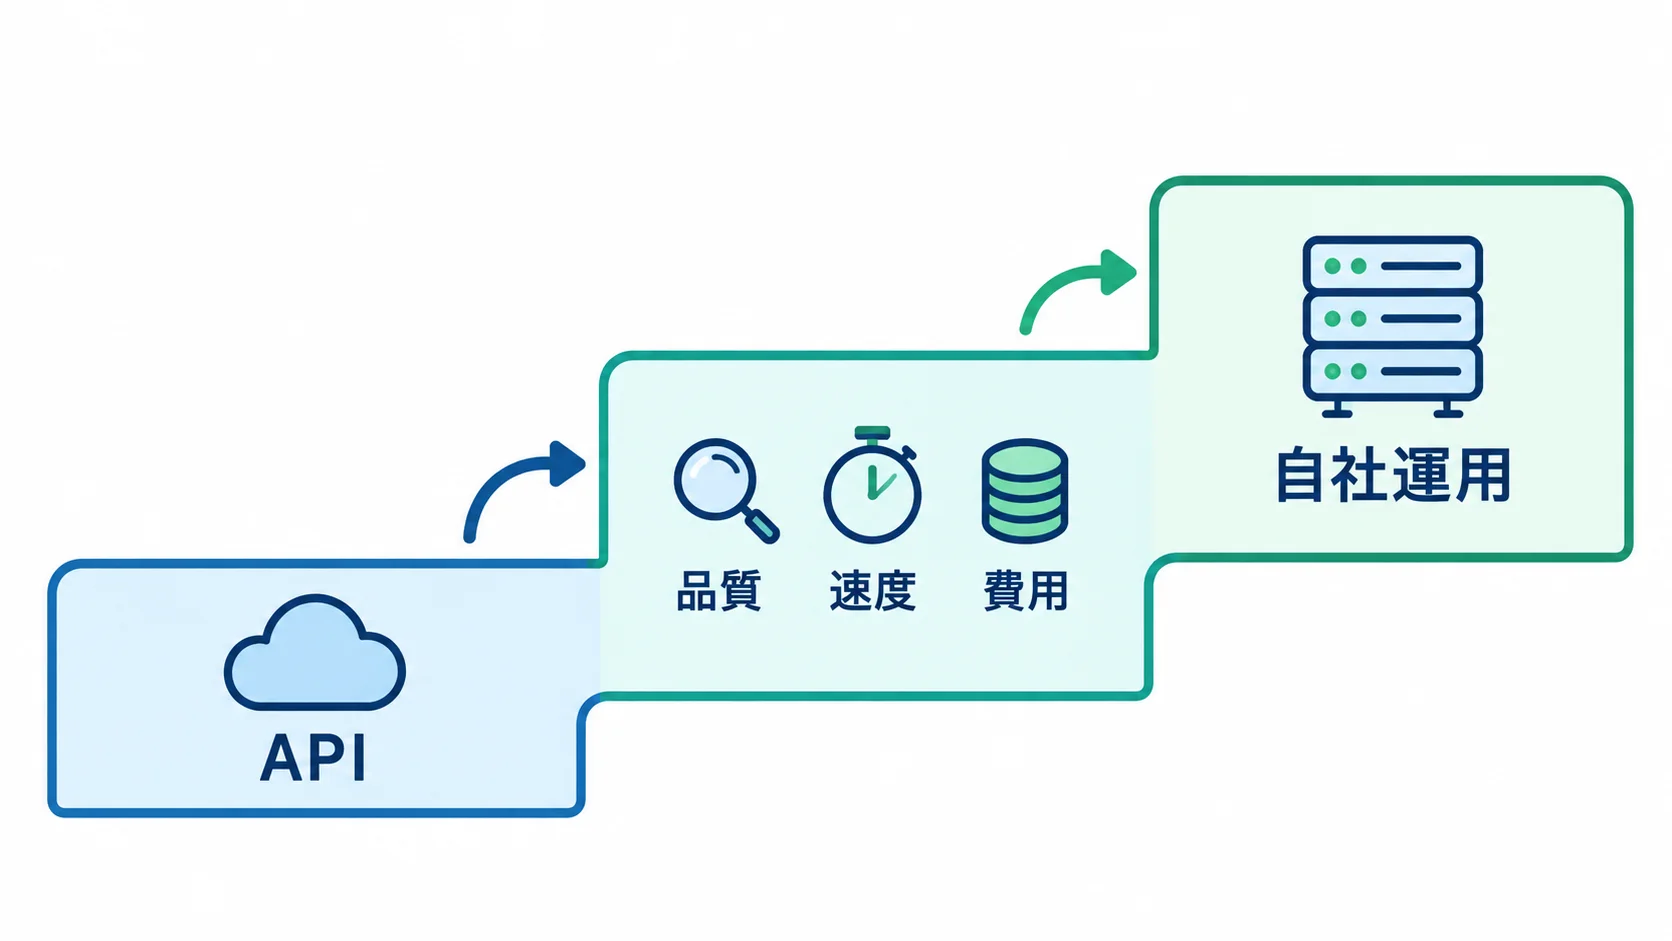
APIで代表的な数十タスクを実行し、既存モデルと同じ入力・同じ評価者で比較する設計です。その後にデータの持ち出し制約や長期費用を確認し、必要な場合だけ自社運用へ進めます。ツール接続の標準化はMCP仕様改定、エージェントのIDと権限は非人間IDの論点と合わせた設計が必要です。
ポイント
最初はAPIで自社タスクの品質・速度・費用を測り、データ要件と運用体制が合う場合にだけ公式重みの自社運用を比較します。
よくある質問
Q. MiniMax M3.1 Flashの料金はいくらですか?
入力は100万トークンあたり0.15ドル、出力は0.60ドル、キャッシュ入力は0.015ドルです。
Q. MiniMax M3.1 Flashはどのような入力に対応していますか?
テキスト、画像、動画の入力に対応し、出力はテキストです。
Q. 推論を無効にして高速化できますか?
推論は無効化できません。負荷やレイテンシーを下げるときは、effortを低い段階に設定します。
Q. MiniMax M3.1 Flashの重みは公開されていますか?
公式モデルカードに重みのダウンロード手順があり、SGLang、vLLM、TokenSpeedでの展開が案内されています。
まとめ
MiniMax M3.1 Flashは、エージェント、コーディング、Computer Useを対象に、最大1,000,000トークンの文脈、画像・動画入力、常時推論を備えたモデルです。入力0.15ドル、出力0.60ドルという価格と、200+ TPSという公表値が、長い処理を大量に回す選択肢を広げる材料です。
導入時は、公表ベンチマークをそのまま成果とみなさず、自社タスクで品質・速度・費用・安全性を測ります。APIで小さく試し、データ要件や運用体制が合う場合に、公式重みを使う自社運用まで比べると判断しやすい設計です。
ポイント
まず代表タスクの実測値を作り、M3.1 Flashの低い単価が自社の総コスト削減につながるかを確認してから、対象業務を広げます。
関連記事
- DeepSeek V4を解説|Pro・Flashの仕様とAPI料金、企業導入のポイント
- Claude Opus 5を解説|性能・料金とモデル選定のポイント
- Claude Coworkを解説|デスクトップでファイル・ツールを横断する業務支援AI
- Gemini Enterprise Agent Platformを解説|企業向けエージェント基盤の機能と運用ポイント
- AWS「Kiro Crew」を解説|マルチエージェントOSSの設計と活用ポイント
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。