
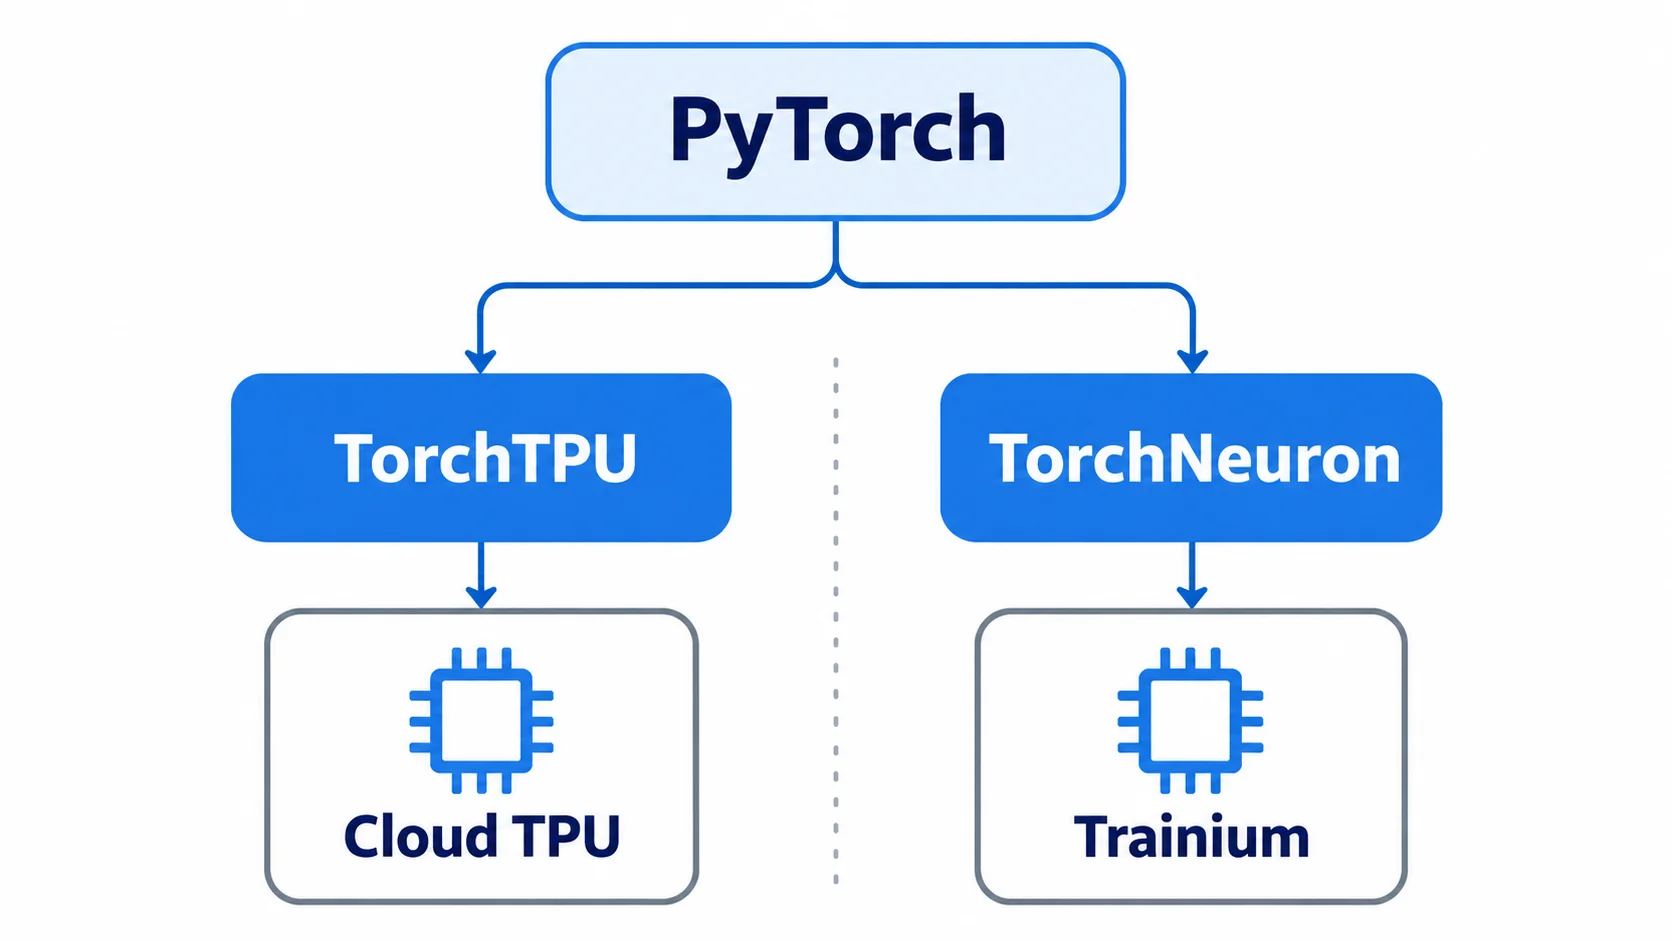
AWSは2026年10月20日、AWS Trainium向けのTorchNeuronのパブリックベータを発表しました。GoogleもTorchTPUを公開し、PyTorchからCloud TPUやTrainiumを使うためのネイティブなバックエンドがそろいました。
企業の開発チームにとっての意味は、チップを変えるたびにモデル実装全体を書き換える負担を減らせることです。モデルと入力をデバイスへ移す書き方を保ちやすくなり、Cloud TPUとTrainiumを同じPyTorchの検証手順に乗せられます。
ただし、デバイス指定の変更だけで本番移行が完了するわけではありません。対応していない演算、コンパイル時のグラフ分割、精度、入力形状、分散実行、導入環境を確認して初めて、チップ選定の比較材料になります。
※本記事は2026年10月21日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
ネイティブ化|TorchTPUとTorchNeuronがPyTorchの入口をそろえる
TorchTPUはGoogleのTensor Processing Units向けPyTorchバックエンドです。PyTorchのATenカーネル、XLA計算のコンパイルキャッシュ、データ並列・テンソル並列、torch.compile()によるグラフ実行を備えています。Google Cloudの公式ドキュメントでは、Cloud TPU上でeagerモードの対話的なデバッグや、torch.distributedによるスライス間のスケールに対応すると説明されています。
一方、TorchNeuronはAWS Trainium向けのネイティブPyTorchバックエンドです。PyTorchのPrivateUse1拡張機構でTrainiumをneuronデバイスとして登録し、Trn2とTrn3インスタンスで利用します。AWSの公式ドキュメントは、eager実行、torch.compile、標準の分散API、NKI(Neuron Kernel Interface)によるカスタムカーネルをサポートするとしています。
共通するのは、PyTorchのモデル定義やテンソル操作を出発点にできることです。違いは、TorchTPUがCloud TPUのバックエンド、TorchNeuronがTrainiumのバックエンドである点と、デバイス名やコンパイラの対応範囲です。両者を「同じ製品の別名」と捉えると、移行試験の設計を誤ります。
移行の実像|変更はデバイス指定から始まり、検証で終わる
TorchNeuronの最小構成は、モデルと入力を.to("neuron")へ移す形です。AWSは標準のPyTorch APIで動かせることを示しており、torch.acceleratorを使うコードは変更なしで動かせると説明しています。TorchTPUもPyTorchのデバイスバックエンドとしてモデルをTPU上で実行します。
この変更は、移植作業を小さく始めるための入口です。実際には、モデルと入力だけでなく、オプティマイザー、混合精度、データローダー、分散初期化、チェックポイントの入出力まで試します。CPUの結果とアクセラレータの結果を並べ、差分を記録する流れです。
TorchNeuronのeager実行では、未対応の操作がCPUで実行される場合があります。記録されたフォールバック操作はtorch_neuronx.get_fallback_ops()で確認する仕様です。モデルが動いても、処理の一部がCPUへ戻れば転送時間やスループットは変わります。成功したかどうかに加え、演算ごとの実行先が測定対象です。
アクセラレータ選定の背景を考えるときは、AI推論向けクラウド支出の変化も参考になります。学習と推論では形状、バッチ、レイテンシーの条件が変わるため、学習で動いた結果を推論の採算へそのまま当てはめないことが大切です。
ポイント
.to()の変更は移行の開始点です。演算の対応状況、CPUフォールバック、数値の一致、入力形状ごとの性能を確認して、初めて実運用の候補になります。
実行方式|eagerとtorch.compileを使い分ける
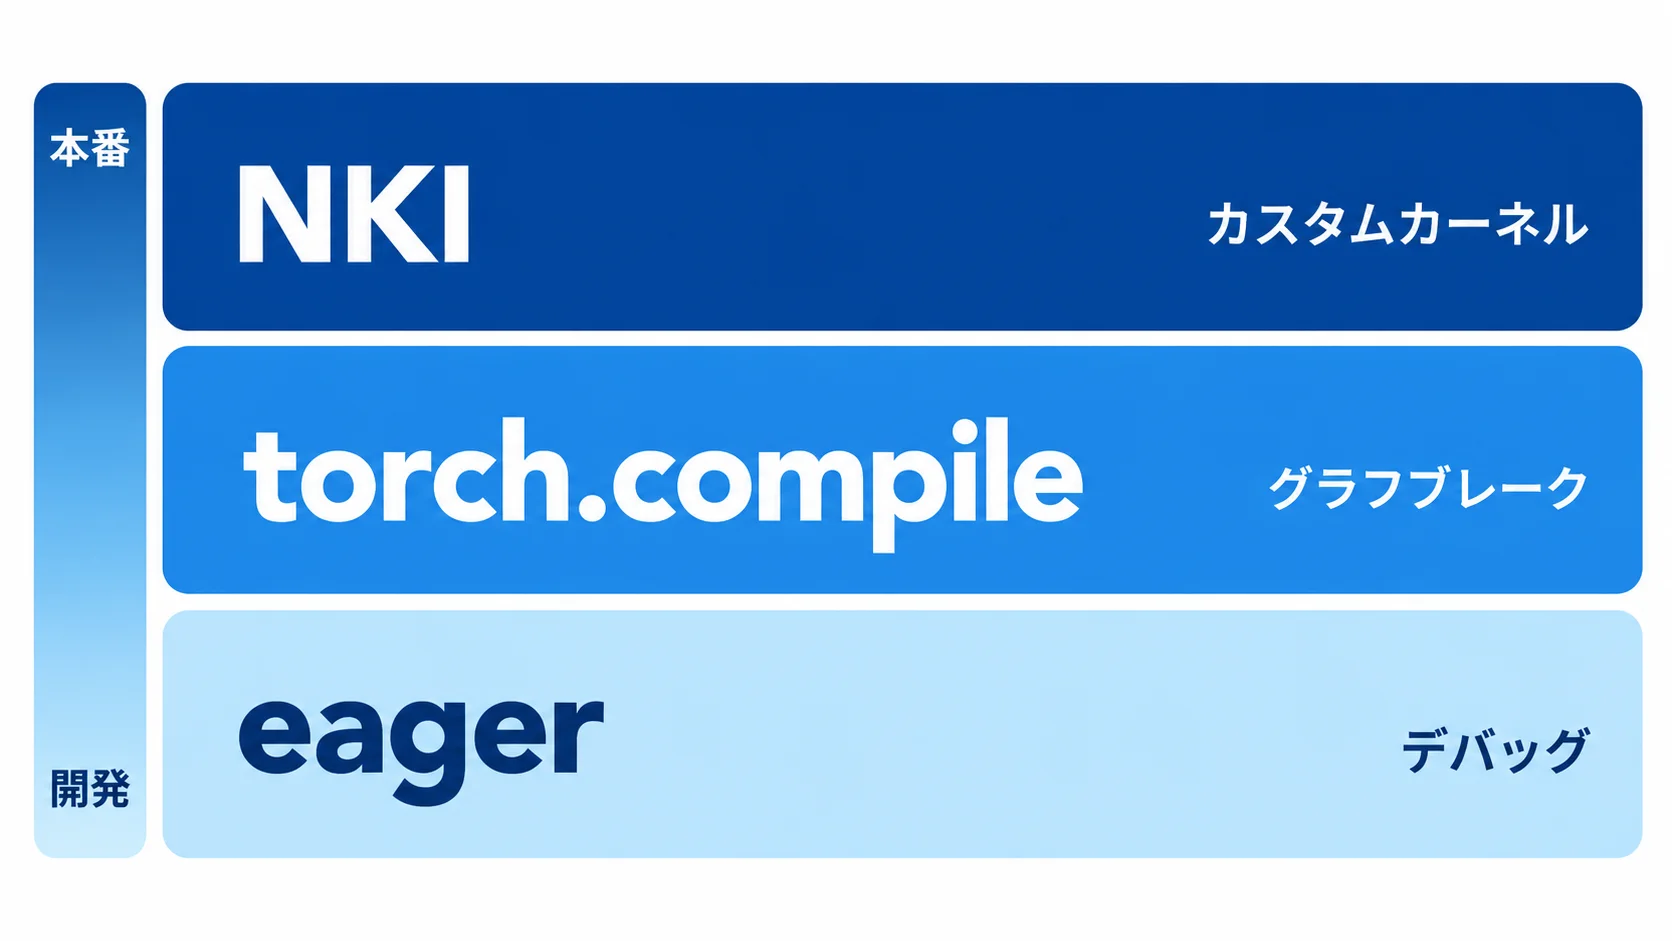
eager実行は、Pythonが呼び出した操作をその場で実行する方式です。TorchNeuronでは、制御フロー、print、ブレークポイントを使えるため、移行初期のデバッグに向きます。TorchTPUもeagerモードで対話的にモデルを確認できます。まず動作を確かめ、次に性能を引き上げるという順序を作りやすい方式です。
本番でグラフ実行を試すときは、TorchNeuronではtorch.compile(model, backend="neuron")を使います。TorchTPUではtorch.compileのTPUバックエンドを使う構成です。TorchNeuronではTorchDynamoがFXグラフを取得し、NeuronバックエンドがStableHLOを経てNEFFを生成します。初回呼び出しにはコンパイル時間が含まれる点に注意が必要です。後続の実行ではキャッシュを再利用できる設計です。
コンパイルできない処理を見つけたら、グラフブレークの位置と回数を確認します。TorchNeuronの公式資料では、捕捉できない構造はグラフブレークになり、Neuronバックエンドがlowerできない操作はコンパイルに失敗すると説明されています。動作確認だけでなく、1リクエスト内のグラフ分割回数も測定対象です。
さらに速度を詰める場合、TorchNeuronにはNKIがあります。標準PyTorchの操作列で足りない箇所にカスタムカーネルを入れる仕組みですが、これは「デバイスを移す」作業とは別の最適化工程です。チームが保守できる範囲を決め、まず標準APIで再現性を確保してから追加します。
ポイント
開発時はeagerで演算と数値を確かめ、本番候補ではtorch.compileの初回コンパイル、グラフブレーク、キャッシュヒットを測ります。カスタムカーネルは最後の選択肢です。
選定表|Cloud TPUとTrainiumを仕様・運用条件で比べる
2つのバックエンドを比較するとき、モデルのコード差だけを見ると判断を誤ります。実際に固定する環境と、公式が案内する実行条件を並べると、検証用の構成を先に決められます。
| 項目 | TorchTPU | TorchNeuron |
|---|---|---|
| 対象ハードウェア | Cloud TPU | Trainium2(Trn2)・Trainium3(Trn3)。 |
| 実行方式 | eager・torch.compile | eager・torch.compile。 |
| 分散処理 | データ並列・テンソル並列・torch.distributed | 標準のPyTorch分散API。 |
| 公開状況 | Apache 2.0、公開リポジトリ、torch_tpu==0.2.0 | Apache 2.0、Neuron 2.33.0のパブリックベータ。 |
| 環境の目安 | Python 3.11以上、TPU VM、v6e GCE環境 | PyTorch 2.13/2.14、Python 3.12〜3.14、Linux x86_64。 |
TorchTPUは、Google CloudのTPU VMで既存のPyTorchモデルを検証し、スライスへ広げる流れを取りやすい構成です。TorchNeuronは、Neuron 2.33.0と対応するPyTorch・Python・OSの組み合わせを固定することが先になります。AWSのリリースノートではスタンドアロンwheelがUbuntu 26.04向けとされ、Ubuntu 22.04・24.04は別の導入条件の対象です。
専用チップの比較では、ハードウェアの理論値に加えて、ソフトウェアとデータセンターの前提も費用に影響します。Azure Maia 300のような専用AIチップを考えるときも、モデルを動かすAPI層、コンパイラ、運用環境を一体で評価する視点が欠かせません。
ラックや電力まで含めた基盤の条件は、Vera Rubinのラック設計を扱った記事にも整理されています。TorchTPUとTorchNeuronの比較でも、1枚のチップの性能だけでなく、必要なインスタンス数、通信、冷却、監視を含む運用単位で見積もります。
導入手順|本番前に同じモデルで差分を測る
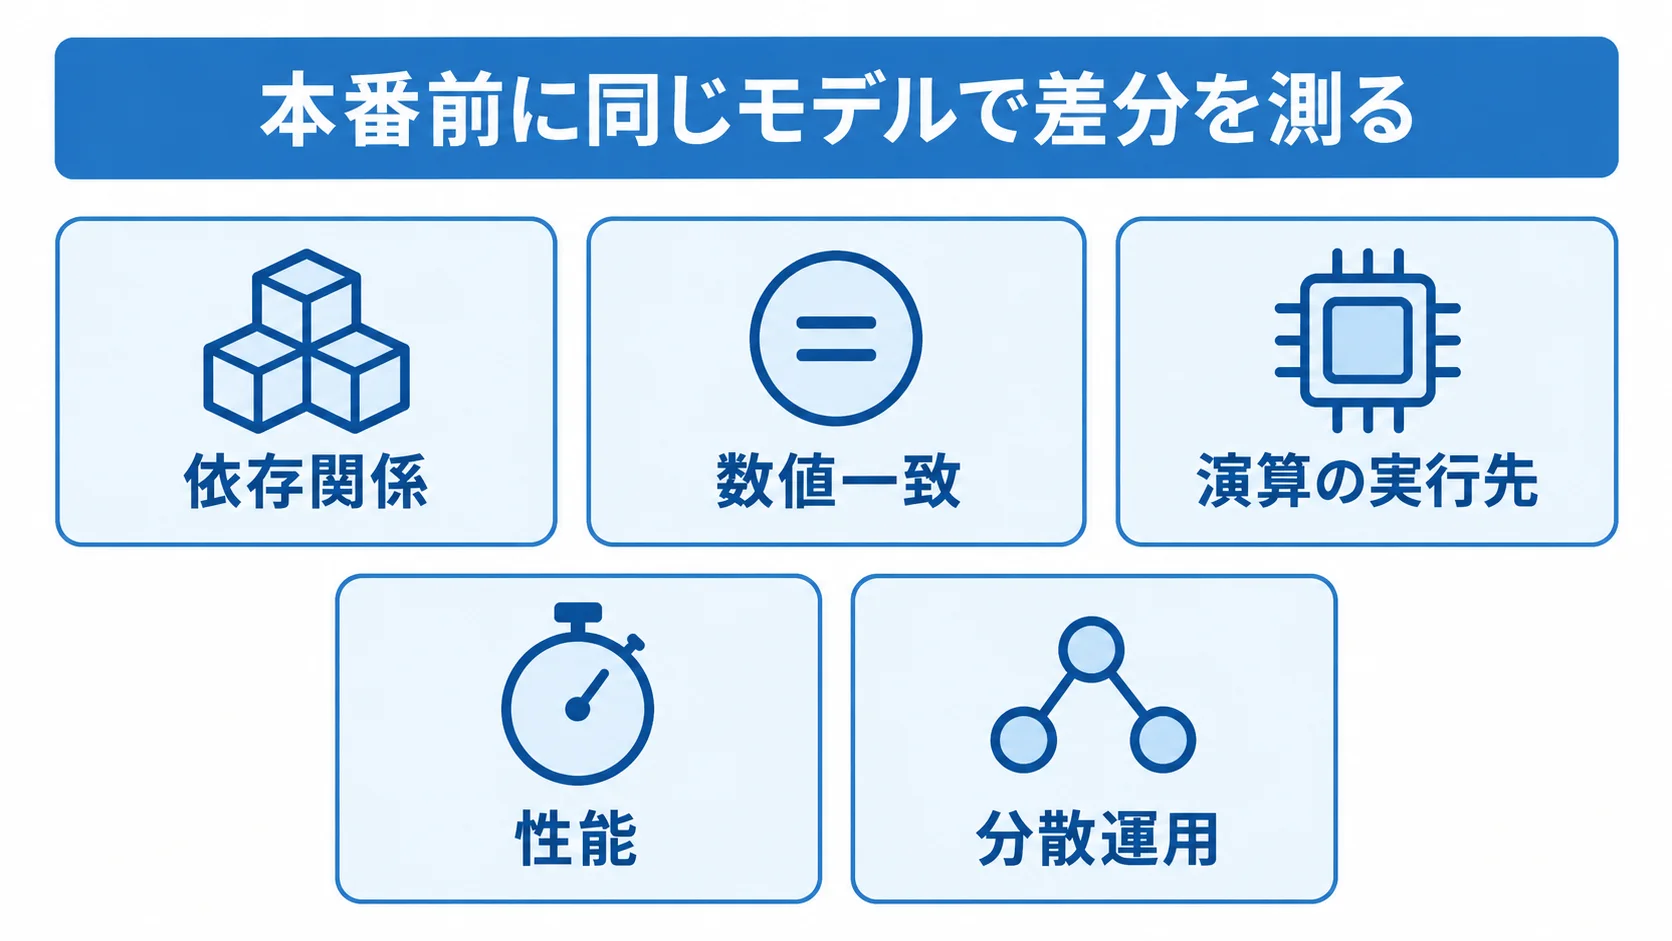
実装チームが最初に作るべきものは、チップごとの別実装ではなく、同じモデルを同じ入力で測る検証表です。TorchTPUとTorchNeuronで、次の順に差分を残します。
- 依存関係:PyTorch、Python、OS、アクセラレータ用パッケージを固定し、再現できる起動手順を残す作業です。
- 数値一致:CPUを基準に、代表的な入力形状で推論結果と学習時の勾配を比較します。
- 演算の実行先:未対応API、CPUフォールバック、グラフブレークの有無が焦点です。
- 性能:初回コンパイルを含む時間、定常時のスループット、メモリ、入力形状ごとの再コンパイルが測定項目です。
- 分散運用:通信、チェックポイント、障害時の再実行、監視ログを本番に近い構成で試します。
パブリックベータのTorchNeuronを試す場合は、まず小さなモデルをeagerで動かし、次に代表モデルのtorch.compileへ進みます。TorchTPUでも同じ順番で、単一ホストから分散構成へ段階的に広げる計画です。検証期間中に速度だけを追うと、フォールバックやグラフ分割が本番のレイテンシーに現れたとき原因を追えません。
採用を決める基準は、単一のベンチマーク順位ではありません。既存モデルの変更量、必要な専門知識、環境の固定しやすさを同じ表で比較します。分散時の再現性と監視しやすさも確認し、アクセラレータを替えても運用手順を維持できるか判断します。
よくある質問
Q. TorchTPUとTorchNeuronは同じ製品ですか?
同じ製品ではありません。TorchTPUはCloud TPU向け、TorchNeuronはTrainium向けのPyTorchバックエンドです。
Q. PyTorchコードは本当に.to()の1行だけで移せますか?
.to()の変更は入口になりますが、対応API、数値一致、フォールバック、入力形状、分散実行の検証が必要です。
Q. torch.compileは必ず使う必要がありますか?
必須ではありません。eagerで動作と数値を確認したうえで、性能が必要なモデルにtorch.compileを適用します。
Q. 本番導入前に何を確認すべきですか?
依存関係、CPUとの数値差、未対応演算とフォールバック、初回コンパイル、定常性能、分散時の通信と障害対応が確認項目です。
まとめ
TorchTPUとTorchNeuronは、PyTorchのモデルをCloud TPUやTrainiumへ移す入口をそろえます。TorchNeuronはTrn2・Trn3向けのパブリックベータ、TorchTPUは公開リポジトリとパッケージで提供され、eagerとtorch.compileの両方を使えます。
チップを選ぶときは、デバイス指定の変更量だけで決めません。対応演算、フォールバック、グラフブレーク、数値、入力形状、分散構成、Python・OS・PyTorchの固定条件を同じ検証表で比較します。運用チームが保守できる構成から段階的に広げることが判断の軸です。
ポイント
最初の一歩は同じPyTorchモデルをeagerで動かすことです。その後、torch.compile、代表形状の性能、分散実行を順に検証すれば、チップの違いをソフトウェアと運用の条件として比較できます。
関連記事
- AI推論向けクラウド支出96%増予測を解説|学習から推論への投資シフト
- Microsoft「Azure Maia 300」を解説|自社AIチップでGPU依存はどこまで減るか
- NVIDIAがVera Rubinのラック設計をOCPに公開を解説|250kW・液冷時代のAIデータセンター
- Mistral Large 4を解説|1兆パラメータのオープンウェイトモデルと自社運用の選択肢
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。