
データレイクは、データを集めておく器です。ETLは、そのデータを分析に使える状態に整える仕組みです。目的と利用者を先に決め、構築からツール選定、費用、運用、外注まで段階的に設計すると、分析やAIの土台として機能します。
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
全体像:データレイクとETLの役割分担
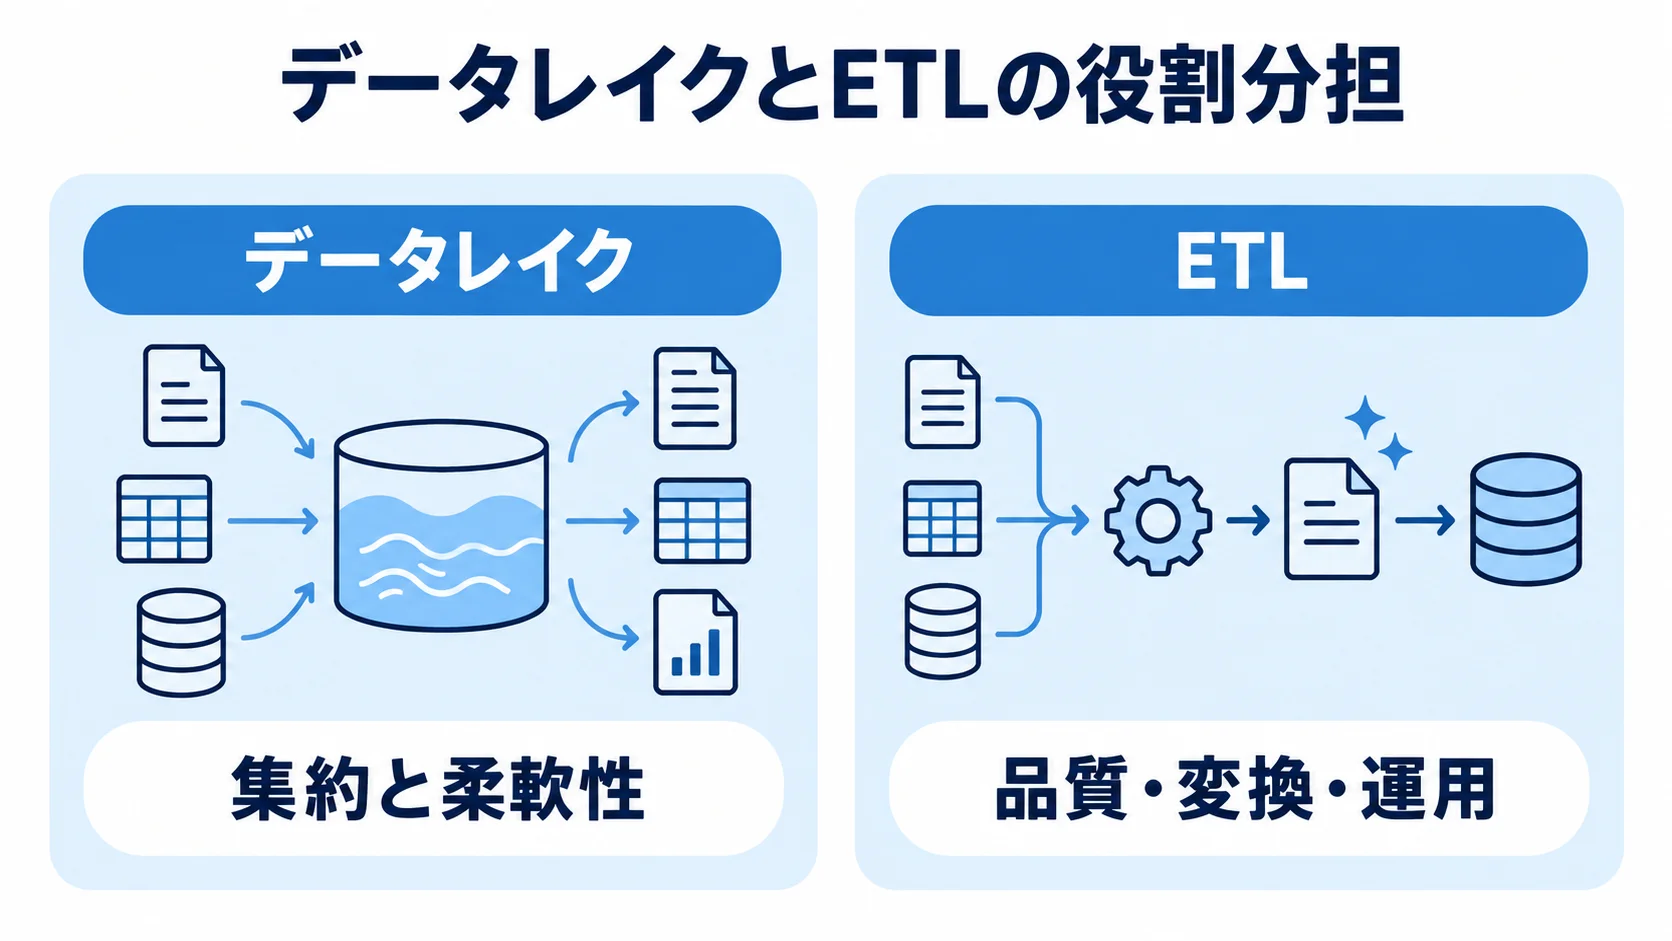
まず、どこに、どんな形で、誰が使うためにデータを集めるのかを決めておきます。ここが曖昧なままだと、取り込みが増えるほどコストが膨らみ、運用も崩れやすくなります。
データレイクが得意なこと(集約と柔軟性)
データレイクは、構造化・半構造化・非構造化のデータをまとめて受け止められる器です。そのため、最初から完璧なモデリングを求めず、「集めて検証できる状態」を早く作れるのが強みです。
ETLの役割(品質・変換・運用)
ETLは、データを取り込んでから使える形にするまでを受け持ちます。その中身は、4つの領域に分かれます。
- 取得:連携方式、増分の取り込み、遅延、失敗時の再実行。
- 変換:型、マッピング、名寄せ、正規化。
- 品質:重複の排除、欠損、異常値、監査ログ。
- 運用:スケジュール、監視、アラート、権限。
データレイクに価値が出るのは、検索・分析・可視化に使える状態に整える工程まで、セットで設計したときです。そのうえで、ジョブの本数よりも運用の安定性を確認します。
構築手順:データレイクを失敗しにくい進め方
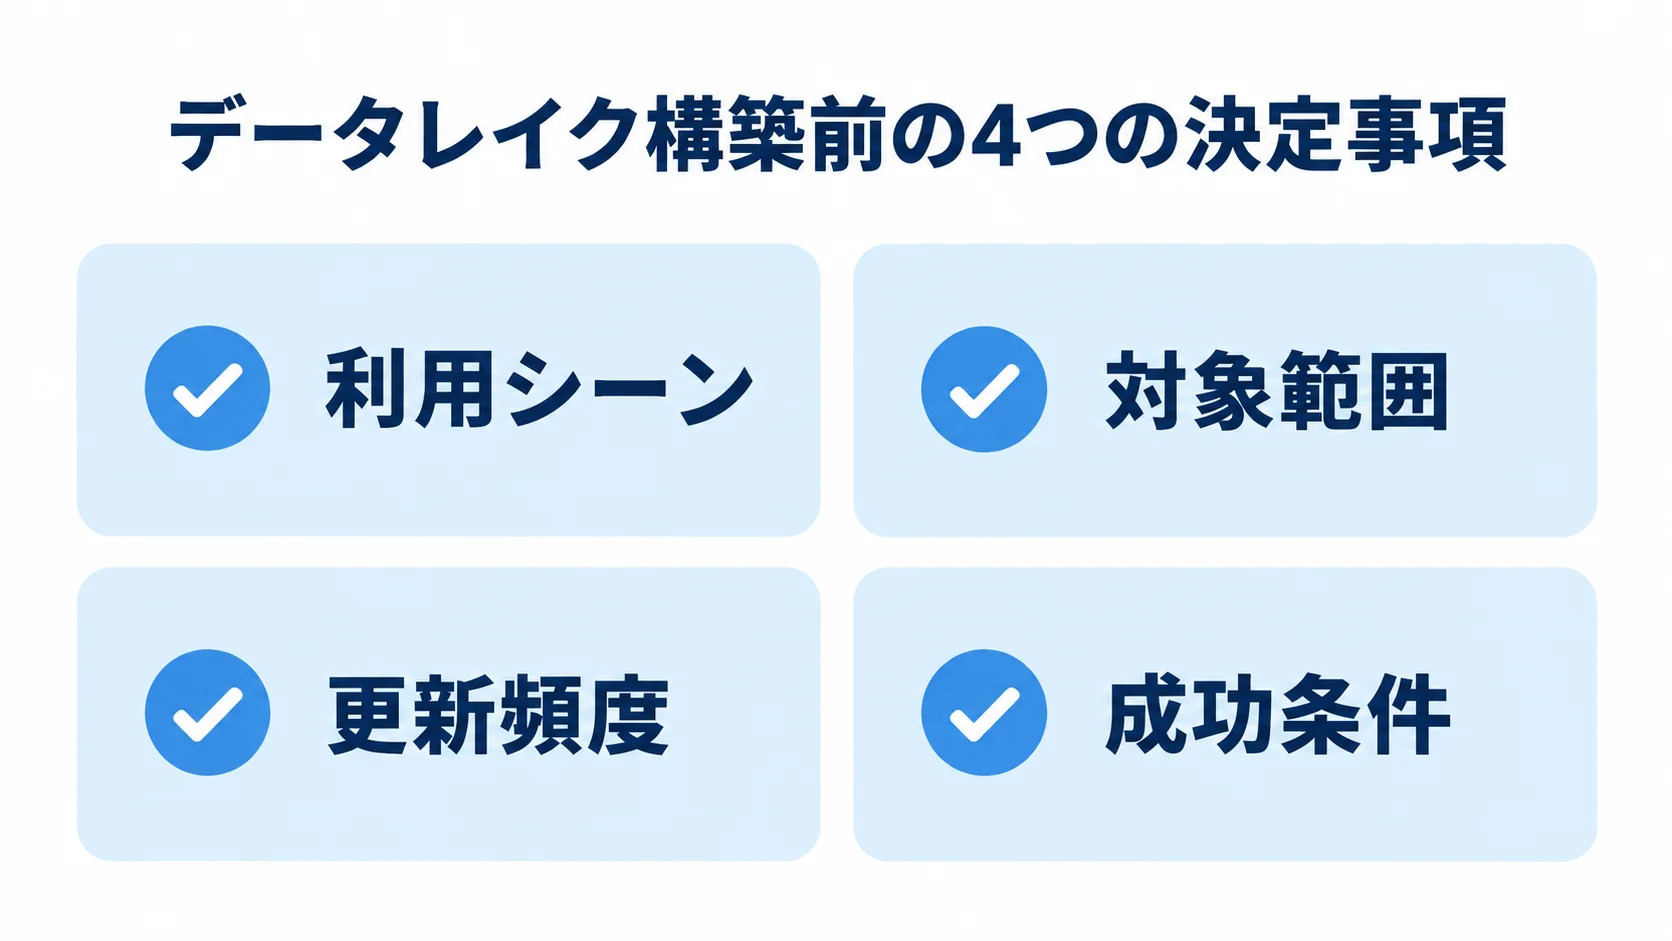
データレイクの構築は、意思決定に使える状態を段階的に増やしていく取り組みです。基盤を作ること自体は、その手段のひとつです。最初から全社を一度に対象にすると、要件が膨らみ、データが集まる前に関係者が疲れてしまいがちです。
最初に決めること(目的と利用者の固定)
構築の前に、データレイクで何を実現したいのか、誰がどの場面で使うのかを固めておく必要があります。固める点は4つです。
- 利用シーン:誰が、何を判断するために使うか。例として、在庫の過多や欠品を減らす、販促ROIを見える形にする。
- 対象範囲:最初に扱う業務領域とデータ。受注・出荷・在庫の3系統から始めるなど、範囲を絞る。
- 更新頻度:リアルタイムが必要か、日次・週次でよいか。
- 成功条件:指標の見える化、運用の安定稼働、月次締めの短縮など。
やることと同じくらい、やらないことも決めておきます。特に、対象範囲を先に絞っておくと、構築の途中で目的が広がるのを防ぎやすくなります。
よくあるつまずき(データが増えたときの崩れ方)
データを集めるほど、次のような点でつまずきやすくなります。
- データ定義がバラバラ:同じ「売上」でも集計の粒度が違う。
- 例外を吸収できない:返品、欠品、移動在庫、締め処理が想定されていない。
- 品質監視がない:欠損や重複に気付けず、指標が壊れてしまう。
- 権限が後回し:個人情報や機密データの扱いで止まる。
こうしたつまずきを防ぐには、ログ、監査、権限、データ辞書の最低ラインを最初から作っておくことです。そうすると、後半の手戻りを減らせます。
ツール選定:ETLを比較して選ぶときの判断軸
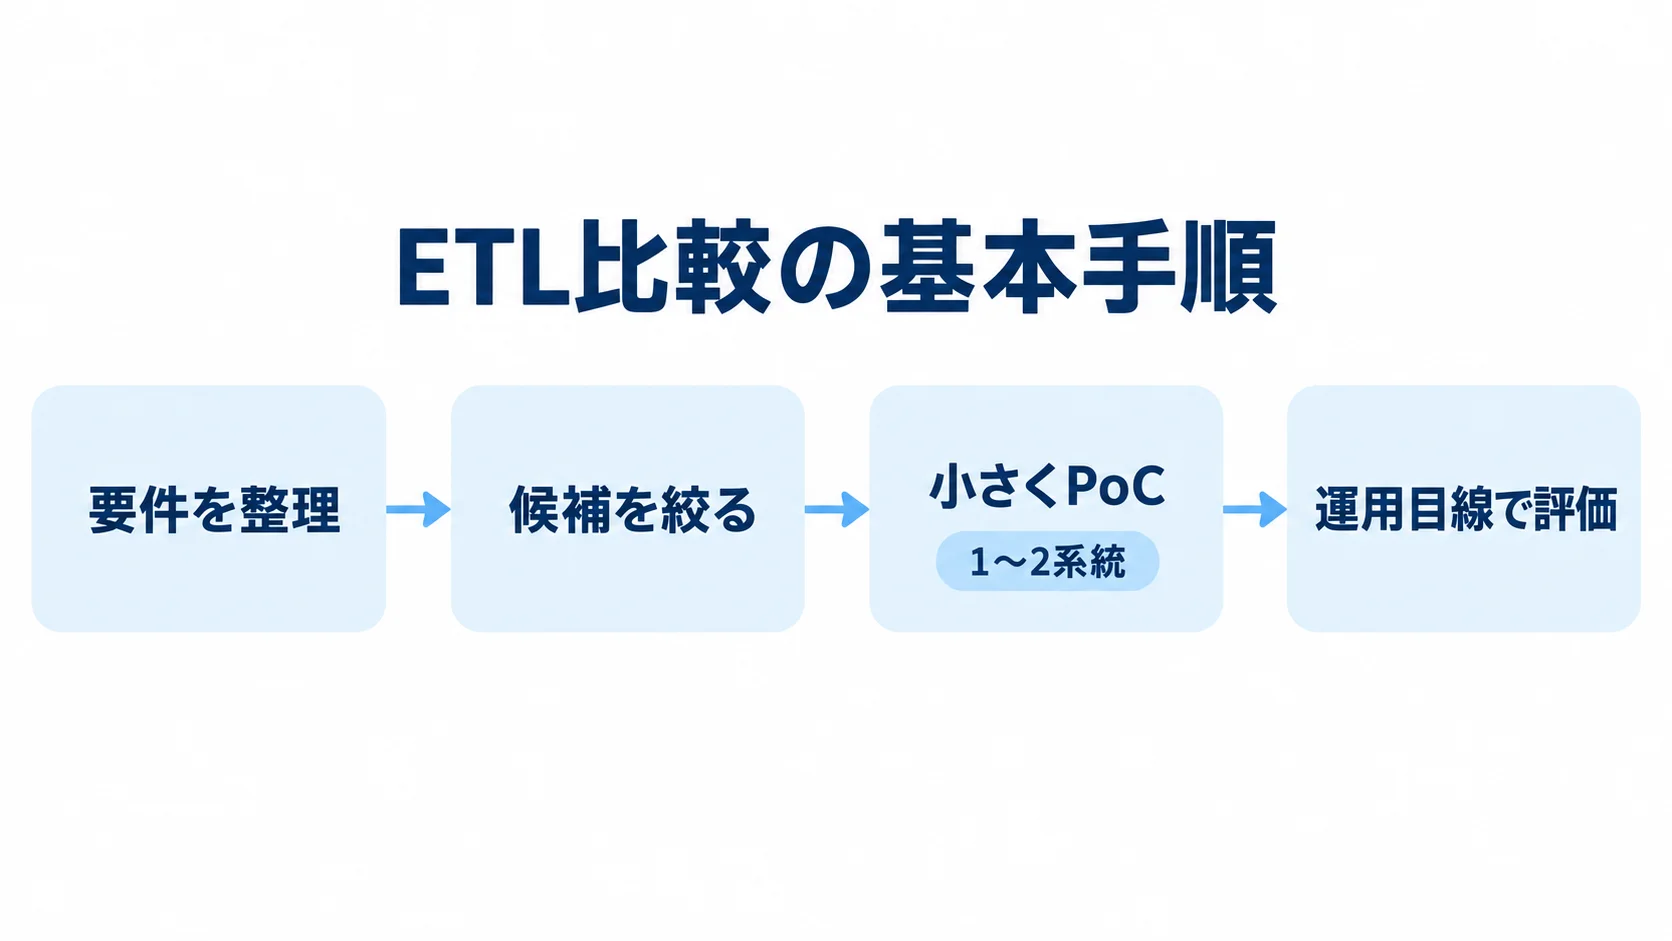
ETLを選ぶときに大事なのは、機能の多さよりも、運用で壊れにくいかどうかです。連携先が増えるほど、失敗時の再実行、監視、権限、変更管理の確認が欠かせなくなります。
比較の基本手順(要件→候補→PoC)
ETLを比べるときは、次の順に進めます。
- 要件を整理:連携先、更新頻度、データ量、権限、監査、SLAを押さえる。
- 候補を絞る:オンプレかクラウドか、GUIかコードか、コストモデルで比べる。
- 小さくPoC:実データで1〜2系統の取り込みと変換を試す。
- 運用目線で評価:監視、再実行、ジョブ管理、変更のしやすさ。
評価ポイント(運用・変更・責任分界)
ETLを評価するときは、障害時や変更時にどう動くかを見ておく必要があります。確認する観点は5つで、障害対応から責任の境目までを含みます。
- 失敗時の挙動:再実行、リトライ、冪等性、部分成功の扱い。
- 監視:遅延検知、データ品質アラート、通知先の柔軟性。
- 変更管理:スキーマ変更への強さと影響範囲の追跡。
- 権限:データ、ジョブ、接続情報のアクセス制御。
- 責任分界:ツールに任せる範囲と、SQLやコードで実装する範囲。
将来の追加や変更が多いほど、作りやすさより直しやすさを優先して考えます。接続できるかどうかだけで決めると、運用コストで行き詰まりやすくなります。
費用と見積:予算の目安とブレを減らす考え方
費用がブレる原因は、ツール代そのものよりも、取り込むデータの幅と運用の難しさにあります。特に、見積の段階で前提が揃っていないと、後から追加が発生しかねません。
コスト要因(データ量より「複雑さ」)
費用を左右するのは、データ量の多さより複雑さです。その要因は4つに分かれます。
- 連携先の数:API・DB・ファイル、認証方式、相手先の制約。
- 変換の難易度:名寄せ、マスタ整備、業務ルールの再現。
- データ品質:欠損や重複、入力のばらつき、例外処理の多さ。
- 運用要件:監視、アラート、SLA、権限、監査。
見積で揃えるべき前提(後出しの防止)
見積の前に前提を揃えておくと、後出しを防ぎやすくなります。揃えておく項目は5つです。
- 対象データ:テーブル・項目数、サンプル、更新頻度、粒度。
- 要件:見える化したい指標、締め処理、例外、権限。
- 品質:許容欠損、許容遅延、監査ログ要件。
- 運用:監視、当番、通知、復旧手順。
- スコープ境界:構築と運用支援の範囲。
最初は小さく作り、価値が出た領域から増やしていくと、費用対効果を読みやすくなります。また、前提を揃えるだけでも、費用のブレとトラブルを減らせます。
外注とパートナー選び:依頼で失敗しないチェックポイント
外注の成功確率を上げる鍵は、発注先を比べられる状態を作り、運用まで含めて期待値を揃えることです。また、データ基盤は運用して初めて価値が出るものです。
依頼前に用意するもの(RFPの最小セット)
依頼の前に、開発会社へ伝える内容を最低限そろえておきます。目的から優先度までの5点で、依頼の範囲をあいまいにしないための材料になります。
- 目的:意思決定、工数、締め、在庫など、何を改善したいか。
- 対象システム:ERP、会計、受発注、WMS、CRM、ECなど。
- 対象データ:テーブル数、件数、更新頻度、例外の概略。
- 運用の希望:監視や障害時対応、内製の範囲、体制。
- スコープと優先度:最初にやることと後でやること。
選定で見るべき観点(実績より運用力)
開発会社を選ぶときは、実績の数より、稼働後の運用を続けられる備えがあるかを見ます。見る点は5つです。
- データ品質:監視、検知、修正フローを設計しているか。
- 障害時の切り分け:原因特定、再実行、暫定対応の手順が決まっているか。
- 変更に強い設計:スキーマ変更や追加連携の見積ルールを持つか。
- コミュニケーション:仕様合意、レビュー頻度、議事録の整備。
- 引き継ぎ:運用手順書、権限設計、教育を含むか。
まとめ:運用を前提にしたデータの資産化
データレイクとETLは、分析やAIの前段にある土台です。目的、対象、運用を揃えて段階的に価値を増やしていくことで、データを継続して使える資産に変えられます。
- 誰が何を判断するかを定め、やらないことも明確にする。
- 構築は段階的に進め、監視・権限・品質を後回しにしない。
- ETLは機能より、再実行・監視・変更管理で比較する。
- 費用はデータ量より、例外・品質・運用の複雑さで確認する。
- 外注は前提を揃え、回し続ける力で選ぶ。
関連記事
- データレイク構築の進め方と事例|構築手順とプロセスを詳しく解説
- データレイク構築の費用・コストは?予算の目安と見積もり方法
- データレイク構築の外注・発注先選び|委託・依頼時の注意点を解説
- データレイク構築に強い開発会社・ベンダー・SIer5選|選び方のコツ
ETLの比較、費用、外注、開発会社については、関連記事で詳しく扱っています。
- ETL ツール比較の進め方と事例|選定手順とプロセスを徹底解説
- ETL ツール導入の費用・コストは?予算の目安と見積もりのポイント
- ETL ツール導入の外注・発注先選び|委託・依頼時の注意点
- ETL構築に強い開発会社・ベンダー・SIer5選|選定のポイント
- ETL構築に強い開発会社・ベンダー・SIer5選|選定のポイント
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。