
ITシステムのバグ修正は、再現確認から原因の特定、修正、回帰テスト、リリース、再発防止までを一つの流れとして進めます。
修正範囲を絞り影響範囲を確かめることが、デグレ(修正で既存機能が壊れること)の防止につながります。特に本番システムでは、一つの修正が事業に直結します。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
ITシステムバグ修正の全体像と進め方の基本
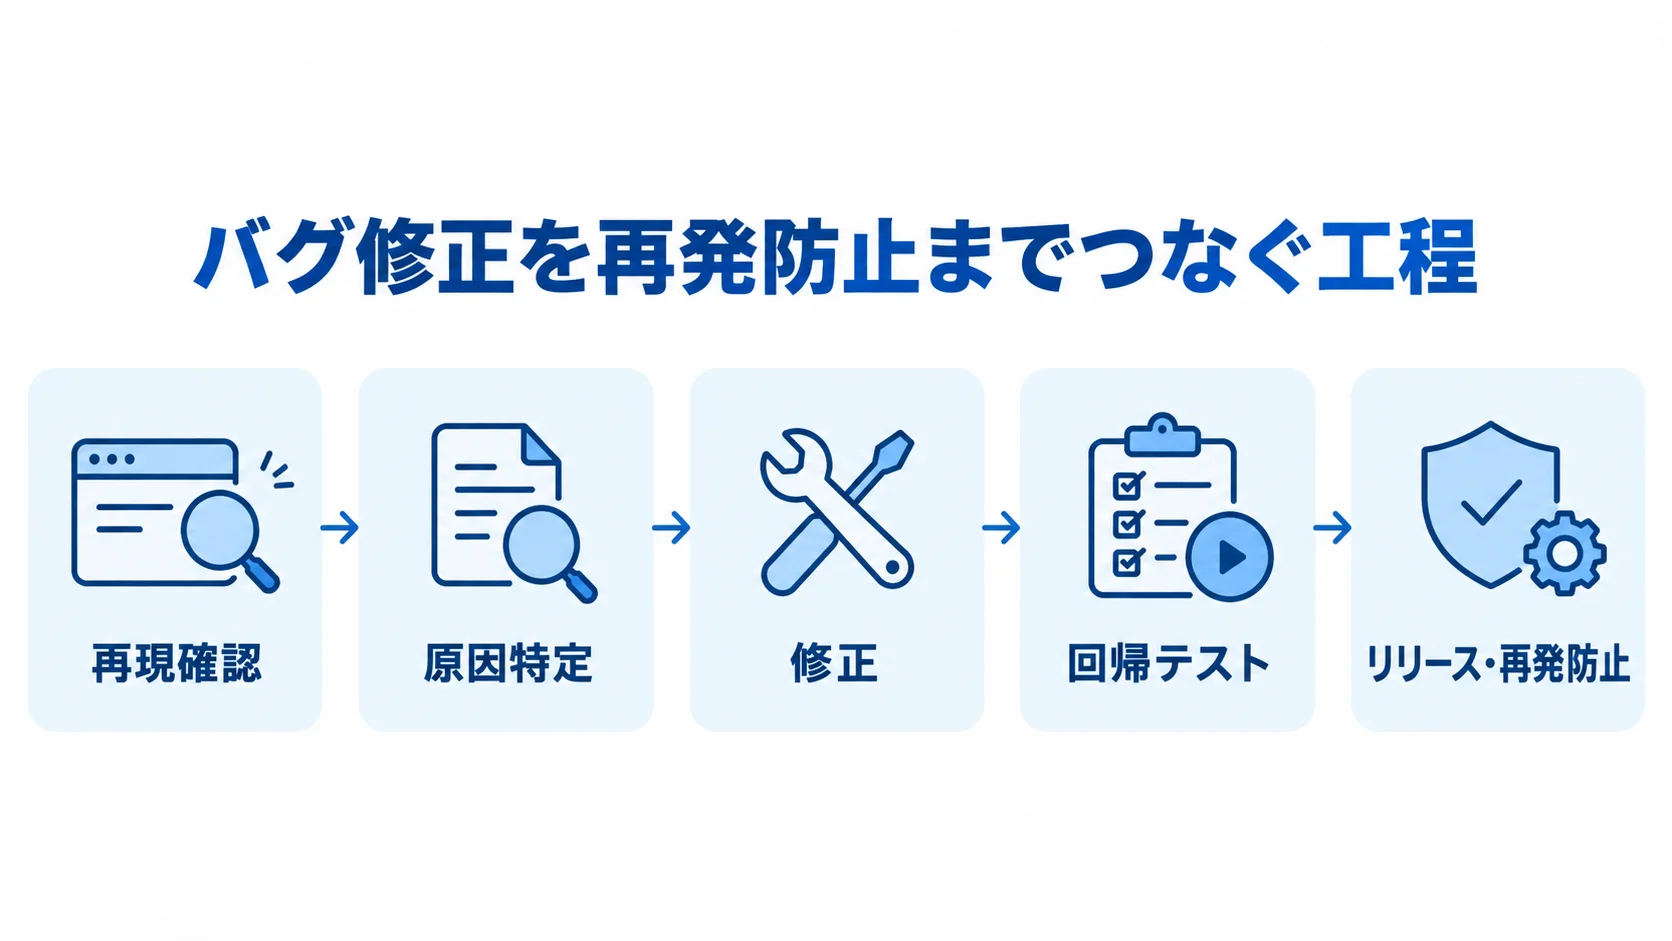
バグ修正は、コードを直す作業を含む一連のプロセスとして捉える必要があります。まず再現を確認し、原因を特定して修正します。
そのうえで、修正によって他の機能が壊れていないかを確かめる回帰テストを行い、安全にリリースして、再発防止まで進めます。この全体像を押さえずに目の前のコードだけを直すと、デグレや再発を招くおそれがあります。
バグ修正の全工程と「デグレ防止」の位置づけ
ITシステムのバグ修正は、おおまかに次の流れで進みます。
まず①バグを再現して事象を切り分け、②ログ解析とコードレビューで原因を特定します。次に③修正方針を決め、④コードを修正します。
その後、⑤修正箇所と影響範囲の回帰テストを行い、⑥リリースし、⑦事後の再発防止策を検討します。
- デグレード:修正によって今まで正常だった機能が壊れる現象で、バグ修正に特有の最大のリスクです。
- 発見の難しさ:修正したエンジニア本人が気づきにくいため、厄介です。
直したバグの周辺を念入りに確認していても、一見無関係に見える機能への影響に気づかないまま、リリースしてしまうケースは少なくありません。
バグ修正の進め方は「デグレを防ぎながらどう直すか」を主軸に組み立てる必要があり、その中心にあるのが回帰テストです。
暫定対応(ホットフィックス)と恒久対応の切り分け
本番障害が絡むバグでは、まず「とにかく止血する」暫定対応(ホットフィックス)と、根本から直す恒久対応を分けて考えます。
- 最優先の対応:ユーザーに実害が出ているときは、応急処置で被害の拡大を止めることです。
- 暫定対応後の失敗:事態が落ち着いたあと、恒久対応がそのまま放置されることが、現場ではよく起こります。
ホットフィックスだけでは根本原因が残るため、恒久対応まで終えなければ同じバグが再発します。
新機能開発の優先度に押し出され、根本修正のタスクがバックログの底に沈んでしまうことが背景にあります。これを防ぐには、暫定対応を行った時点で恒久対応のチケットを必ず起票し、期限と担当者を決めておくことが欠かせません。暫定と恒久を分けて管理することが、バグの再発を防ぐ第一歩になります。
バグの再現確認と原因特定の進め方
バグ修正の品質は、修正に着手する前の「再現確認」と「原因特定」でほぼ決まります。再現手順が曖昧なまま修正に取りかかると、本当の原因とは別の場所を触ってしまい、デグレを生むリスクが高まります。
まずは確実に再現させ、原因を正確に突き止めておけば、結果として最短距離で修正できます。
再現手順の固定と「失敗するテスト」の先行作成
バグ修正の第一歩は、誰が行っても同じ結果になる再現手順を確立することです。「どの環境で」「どのデータで」「どの操作をすると」「何が起きるか」を具体的に書き出し、安定して再現できる状態をつくります。
- 再現条件の特定:入力データの境界値、特定の権限、タイミング依存などから、原因の当たりをつけられます。
- 先に書くテスト:修正コードを書く前に、そのバグを再現する失敗テストを書いておく方法で、効果的です。
バグがある状態ではテストが失敗(レッド)し、修正が正しく行われるとテストが成功(グリーン)に変わります。
このテストはそのまま回帰テストの資産となり、将来同じバグが再発したときの検知役になります。再現を口頭やメモで済ませず、テストコードとして固定しておくことが、品質の底上げにつながります。
根本原因の特定と対症療法の回避
再現できたら、次は原因の特定に進みます。ここで避けたいのが、表面的な症状にだけ対処する「対症療法」です。
- 見かけ上の対処:エラーが出る箇所に例外処理を足してエラーを消しても、奥のデータ不整合や設計の問題を放置すれば、別の形でバグが再発します。
- 原因の掘り下げ:ログ解析やコードの追跡を通じて、「なぜそのバグが起きるのか」を一段深く追うことが大切です。
原因の調査では、変更履歴(コミットログ)をさかのぼり、「いつから、どの変更で問題が混入したか」を特定する手法が有効です。特定のリリース以降にバグが起きているなら、そのリリースの差分に手がかりがあります。
なお、根本原因の調査やなぜなぜ分析の詳しい手法は、ITシステムバグ修正の完全ガイドでも体系的に整理しています。原因を正しく押さえることが、的確で副作用の少ない修正への近道です。
修正作業と回帰テストでデグレを防ぐ方法
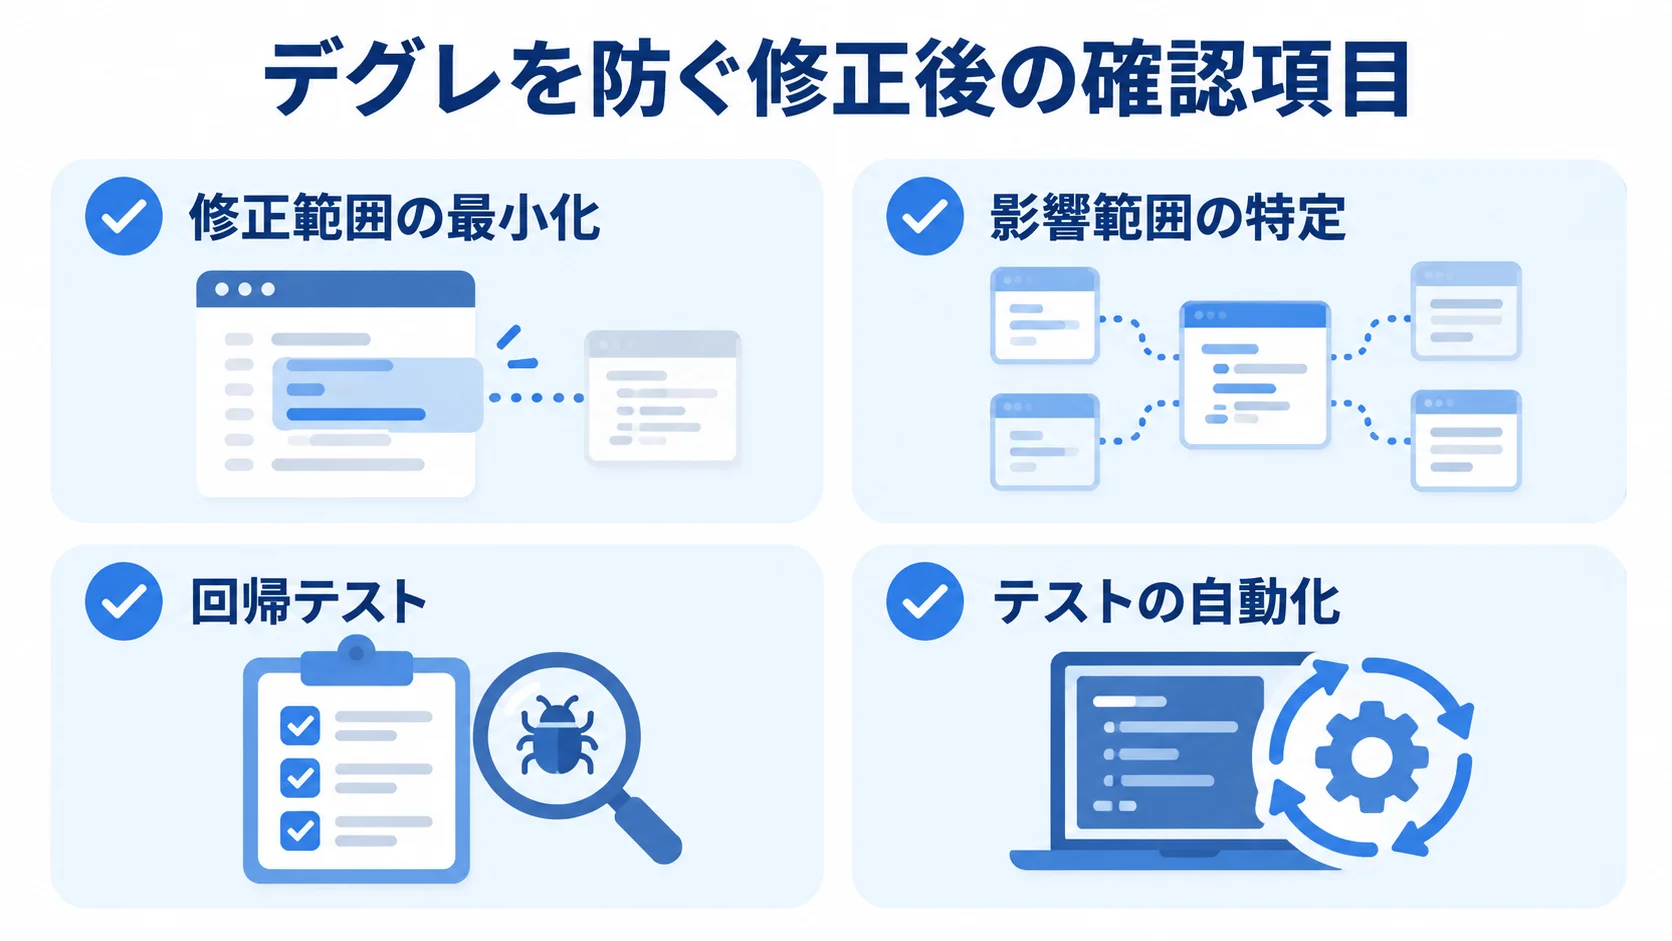
原因が特定できたら、いよいよ修正に入ります。ここで大切なのは、修正の範囲をできるだけ小さく保ち、影響範囲を見極めたうえで回帰テストを行うことです。
デグレの多くは「ついでに直す」「広く書き換える」といった修正範囲の肥大化から生まれます。このため、修正は最小限に、確認は最大限にという姿勢が、安全なバグ修正の鉄則です。
修正範囲の最小化と影響範囲の見極め
バグ修正では、「直す範囲を一つのバグに絞る」ことが基本です。
- ついでの改善:修正のついでにリファクタリングや別の改善まで詰め込むと、変更点が増え、どの変更がデグレを引き起こしたのか追いにくくなります。
- 変更の分離:リファクタリングが必要なら、バグ修正とは別のコミットや別のプルリクエストに分けるのが望ましい進め方です。
修正後は、その変更がどの機能に影響しうるかを洗い出します。修正した関数を呼び出している箇所、共有しているデータ構造、同じ画面やAPIを使う機能などが、影響範囲の候補になります。
この影響範囲の特定が甘いと、テストすべき箇所を見落とし、思わぬデグレを本番に持ち込むことになります。そこで、コードの依存関係を把握し、影響が及ぶ範囲を一覧にしてからテストに進みます。
回帰テストの設計とテスト自動化によるデグレ検知
回帰テストとは、修正によって既存の機能が壊れていないかを確認するテストです。
- 動作確認の範囲:修正した箇所の確認に加えて、洗い出した影響範囲の主要な機能を一通り動かし、従来どおり正しく動くかを検証します。
- 完了の条件:修正したバグが直っていることと、他の機能が壊れていないことの両方を確認してはじめて、修正が終わったと言えます。
毎回すべての機能を手作業で確かめるのは現実的ではないため、テストの自動化が大きな助けになります。
再現テストとして書いた失敗するテストや、主要機能の自動テストをCI(継続的インテグレーション)に組み込みます。これにより、修正のたびに回帰テストが自動で走り、デグレを早期に検知できます。
人手による確認は重要な部分に集中させ、繰り返しの検証は自動化に任せます。この役割分担があれば、限られた人員でも品質を保てます。
テストの外部委託やQAサービスの活用も選択肢になります。自社にテスト人員が足りない場合は、回帰テストの設計や実施を専門会社に任せることで、デグレ検知の精度を高められます。
テスト委託の費用感や進め方については、ITシステムバグ修正の費用相場もあわせて参考にしてください。
バグ修正の優先順位付けとタスク管理
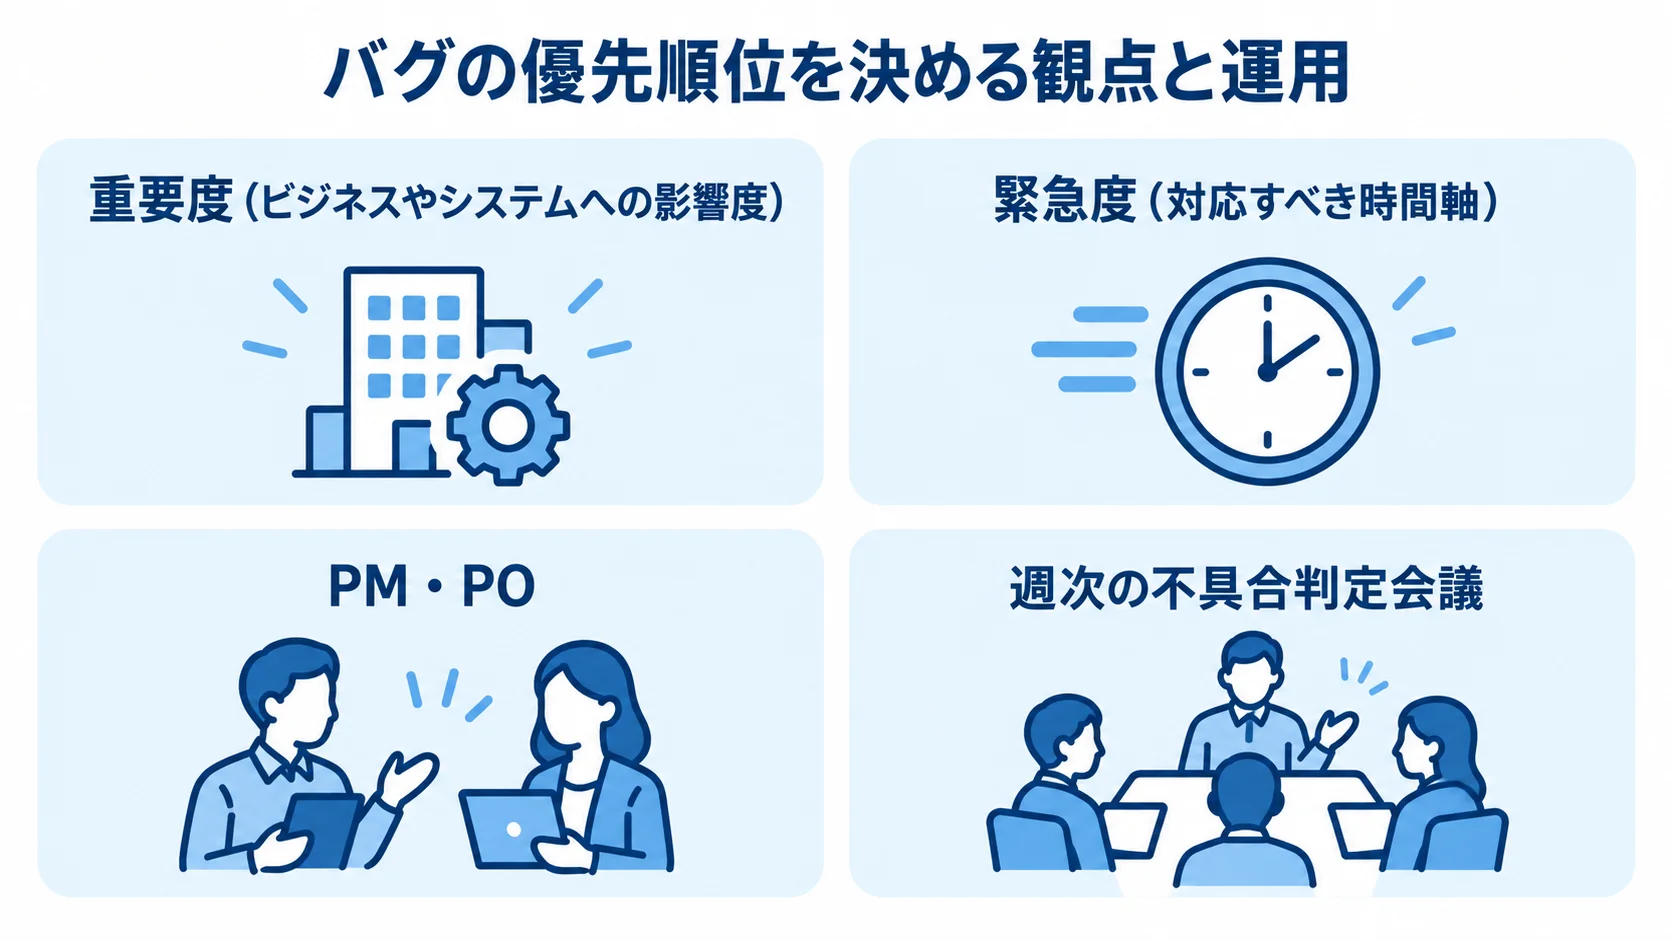
バグが見つかっても、限られた開発リソースで一度にすべて直すのは難しいものです。そのため、どのバグから手をつけるかを戦略的に決めることが、現場では欠かせません。
優先順位の付け方を誤ると、影響の小さいバグに時間を取られ、本当に直すべき重大なバグが後回しになってしまいます。
重要度×緊急度マトリクスと検出者バイアスの排除
バグの優先度は、「重要度(ビジネスやシステムへの影響度)」と「緊急度(対応すべき時間軸)」の2つの観点を並べたマトリクスで判断するのが基本です。
- 最優先のバグ:多数のユーザーの決済が止まるバグは、重要度も緊急度も最高で、即時対応が求められます。
- 後回しにできるバグ:特定条件下でしか起きず実害も小さい表示崩れなら、優先度を下げて計画的に対応すれば足ります。
ここで注意したいのが「検出者バイアス」です。バグを発見したテスト担当者やエンジニア本人が単独で優先度を決めると、自分が見つけたバグを過大評価しがちです。さらに、「とりあえず見てもらうため」に優先度を高く設定してしまうこともあります。
優先度は、残課題やスケジュール、ビジネス上の文脈を俯瞰できるPM・POが判断すべきものです。だからこそ、発見者の主観に引きずられず、全体最適の視点で優先度を決める仕組みが必要になります。
週次の不具合判定会議とあえて直さないバグの判断
優先度を属人的に決めない仕組みとして有効なのが、週1回程度の「不具合判定会議」です。
- 朝会での即決:朝のスタンドアップで、その場の勢いで優先度を決めると、解析が不十分なまま対応に着手し、結局は時間を失いがちです。
- 週次の合意:週次でバグの一覧やバグ曲線(発見数の推移)を共有し、チーム全体でスケジュールと優先度を合意する運用にすれば、判断の精度が上がります。
すべてのバグを直すのが正解とは限りません。そこで、「あえて直さないバグを決める」というビジネス視点も必要になります。
たとえば、修正コストが極端に高く、実害の小さいバグもあります。また、ソーシャルゲームなどで「ユーザーが得をするバグ」は、修正するとかえって運営・ユーザー双方の不利益になることもあります。つまり、何を直し、何を直さないかを選ぶことも、立派なバグ修正のマネジメントです。
リリースと再発防止までの仕上げ
回帰テストを通過した修正は、いよいよ本番環境へリリースします。しかし、リリースして終わりではありません。
デグレが万が一起きたときに素早く戻せる体制を整え、そのバグがなぜ生まれたかを振り返ったうえで、同種のバグを未然に防ぐ仕組みをつくるところまでが、バグ修正の本当のゴールです。
安全なリリースとロールバックへの備え
本番リリースは、影響の小さい時間帯を選び、リリース直後のモニタリング体制を整えたうえで実施するのが安全です。
- リリース直後の監視:エラーログやアクセス数、主要機能の動作を見て、異常があればすぐに検知できるようにしておきます。
- ロールバックの備え:万一デグレが見つかったときに備えて、一つ前の状態へ素早く戻せるよう、あらかじめ用意しておくことが欠かせません。
大規模なシステムでは、いきなり全ユーザーに反映しない方法もあります。一部のユーザーから段階的に展開する「カナリアリリース」が有効です。
カナリアリリースでは、一部のユーザーに限って反映するため、問題が起きても影響範囲を限定でき、被害を抑えながら本番での挙動を確認できます。修正コードを安全に届けるという発想を持つことが、デグレを本番で大きな事故にしないための備えになります。
テスト資産として残す再発防止策
同じバグを二度と起こさないために、再発防止の仕組みを残しておきます。最も効果的なのは、修正時に書いた再現テストを永続的なテストスイートに組み込み、今後のリリースで自動的に検証され続ける状態にすることです。
- 仕組みで防ぐ:「気をつける」「注意する」のような属人的な対策より、テストコードでデグレを検知できる仕組みにすることが、本質的な再発防止になります。
- 振り返りの対象:そのバグがなぜ混入し、なぜリリース前に検知できなかったのかを振り返ることも大切です。
特定の人を責めるより、バグを見逃したプロセスや仕組みの欠陥に目を向ける姿勢が、チーム全体の品質を底上げします。
外部のテスト会社やQAパートナーに依頼する場合の選び方は、ITシステムバグ修正のおすすめ会社で詳しく解説しています。
発注の進め方や外注時の注意点は、ITシステムバグ修正の発注・外注ガイドもあわせてご覧ください。
まとめ
ITシステムのバグ修正は、「再現確認→原因特定→修正→回帰テスト→リリース→再発防止」という一連の工程として進めることが、デグレを防ぎ品質を担保する近道です。
修正の前に失敗するテストを書いて再現を固定し、修正範囲を最小化して影響範囲を見極めます。そのうえで、回帰テストとテスト自動化によってデグレを検知します。
この流れを徹底することで、「直したつもりが別の機能を壊す」という最大のリスクを大きく減らせます。これが、安定したシステム運用につながります。
あわせて、重要度×緊急度のマトリクスと判定会議で優先度を全体最適の視点から決めます。あえて直さないバグも含めて戦略的に管理し、リリース後はロールバックに備えたうえで、再発防止のテストを資産として残すところまで仕上げます。
限られた人員でも、進め方の型と仕組みを押さえれば、バグ修正の品質は着実に高められます。本記事を出発点に、自社のバグ修正プロセスを一段引き上げていただければ幸いです。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。