
ITシステムのログ監視は、「収集」「集約・保存」「解析・アラート」の3段階で、目的を起点に設計します。
ログには障害の予兆や原因のヒントが詰まっており、集めて整理し、通知につなげて初めて活かせます。各段階の作業と、つまずきやすい点を見ていきます。
ログ監視の設計では、目的に合わせて各段階の役割を定めます。
- ログ収集:必要なログを継続的に集める
- ログ集約:複数のログを一箇所に集めて検索する
- 解析・アラート:異常を検知して通知につなげる
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
ITシステムログ監視の全体像
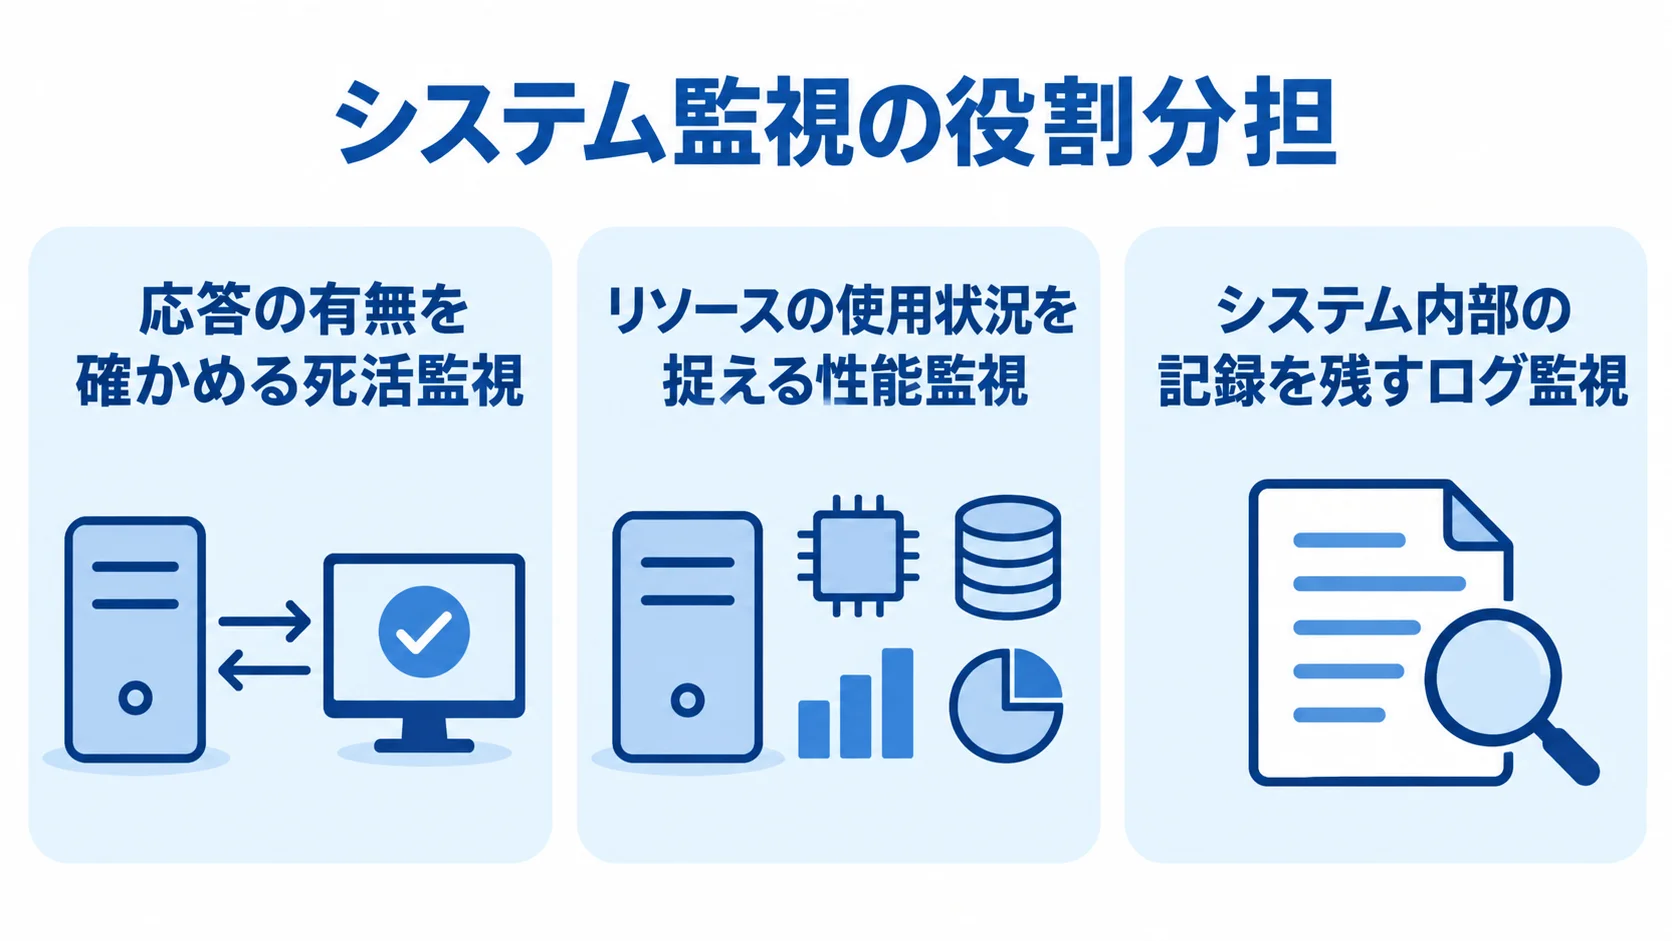
ログ監視とは、サーバーやアプリケーション、ネットワーク機器などが出力するログ(動作記録)を継続的に収集し、エラーや異常な挙動を検知する仕組みです。
システム監視は一般的に、死活監視・性能監視・ログ監視の3種類に分けられます。ログ監視は「何が起きたか」をテキストの記録として残す手段で、障害の原因究明において決定的な役割を担います。
まず、ほかの監視との違いと組み合わせ方から見ていきます。
死活監視・性能監視との違いとログ監視の役割
死活監視は、PingやSSH、ポート監視などを用いて対象の稼働を確かめる監視です。
3種類は、見ている対象が違います。
- 死活監視:応答の有無という外形の状態
- 性能監視:CPUやメモリなどリソースの使用状況
- ログ監視:システム内部で起きたことの記録
性能監視では、CPU使用率やメモリ、ディスク使用量といったリソースの状況を把握し、負荷の高まりや枯渇の予兆を捉えます。
たとえば、死活監視で「Webサーバーが応答しない」と分かっても、原因までは特定できません。メモリ不足、アプリケーションの例外、外部APIのタイムアウトなど、切り分けには追加の情報が必要です。
そこで、ログ監視がエラーメッセージやスタックトレース、リクエストの記録から原因を絞り込みます。死活監視と性能監視が「異常の発生」を捉え、ログ監視が「異常の正体」を突き止めます。
この役割分担が、システム監視の基本構造です。つまり、ログ監視は単独で完結せず、3種類の監視を組み合わせて初めて真価を発揮します。
死活監視や性能監視がアラートを発した瞬間に、関連するログへすぐ辿り着けるよう設計しておくことが、障害対応時間を大きく左右します。
監視対象となる主なログの種類
監視対象のログは、出力元と記録の内容によって次の3種類に分けられます。
- システムログ:OSが出力するsyslogやイベントログ
- アプリケーションログ:業務処理やエラーの記録
- そのほかのログ:Webサーバーのアクセスログ、データベースのスロークエリログ、セキュリティログ(認証の成否やアクセス制御の記録)
これらはフォーマットも出力場所もばらばらなため、個別に追いかけるのは現実的ではありません。そこで、ログ監視では複数のログを一箇所に集約し、横断的に検索・分析できる状態を作ることが重要になります。
たとえば、アクセスログとアプリケーションログを突き合わせれば、「どのリクエストがどのエラーを引き起こしたか」が見えます。また、セキュリティログとアクセスログを組み合わせれば、不正アクセスの兆候も浮かび上がります。
ログ監視の質は、何をどこまで集約し、どう関連づけられるかで大きく変わります。
ITシステムログ監視の進め方と手順
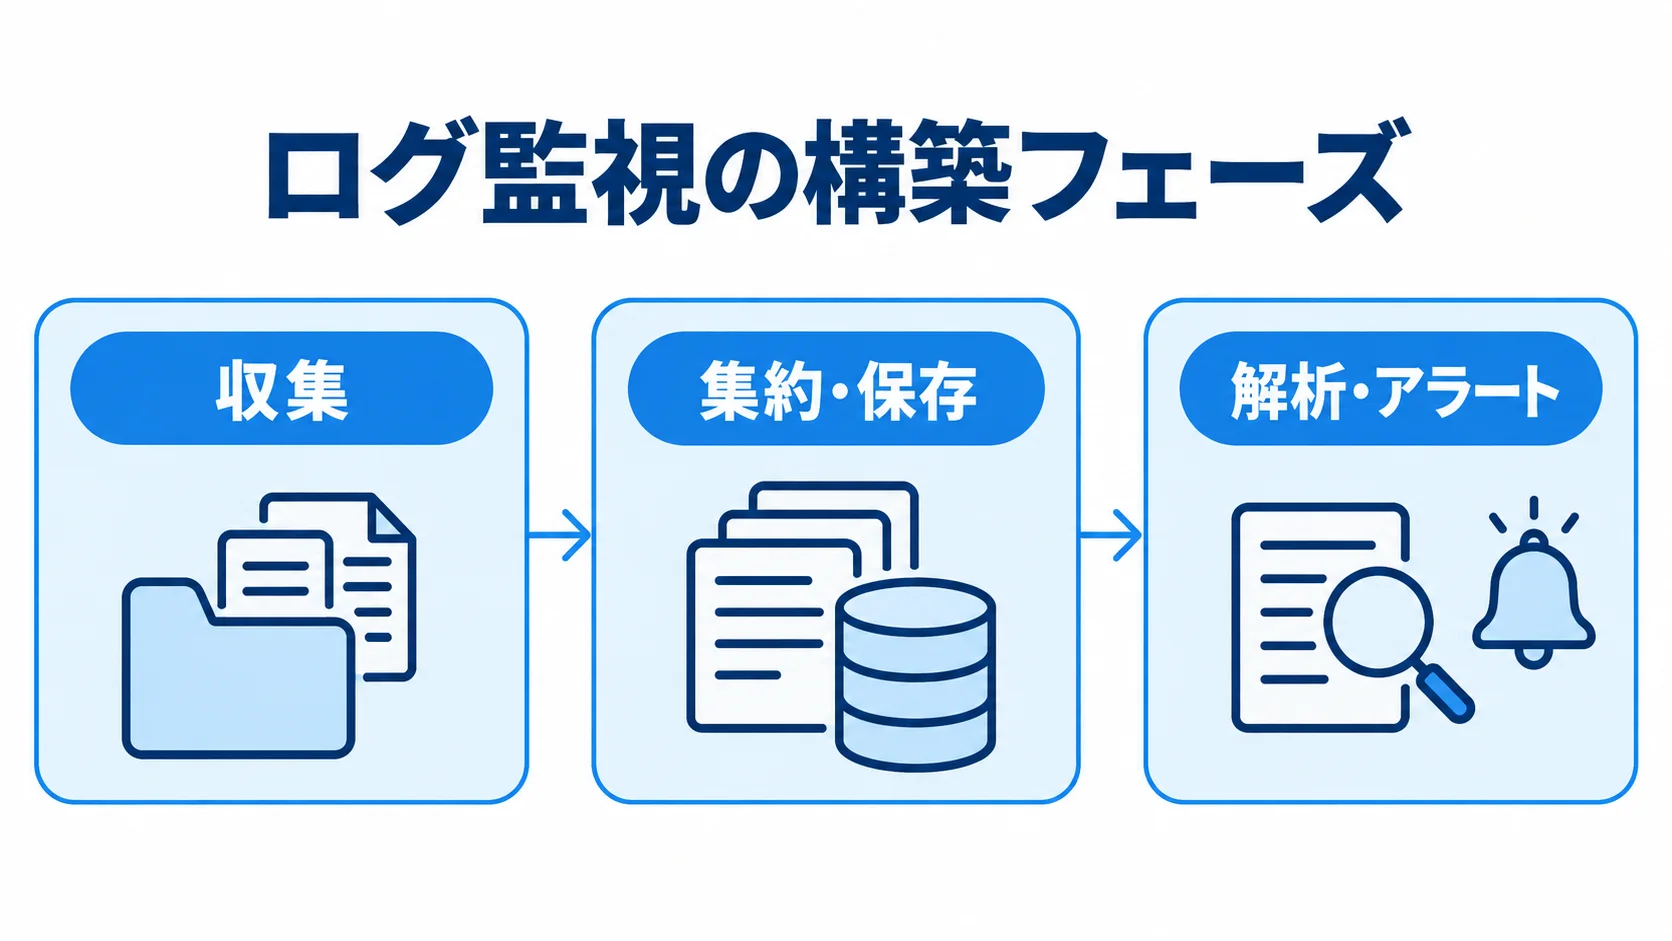
ログ監視の構築は、「収集」「集約・保存」「解析・アラート」の3フェーズに分けて進めます。
まず、何のために何を監視するのかという目的を決め、その目的を起点に設計します。目的が曖昧なままツールを入れると、後から「アラート疲れ」や運用の破綻を招くおそれがあります。
各フェーズで行う作業と、つまずきやすい勘所を解説します。
ステップ1: 監視目的の定義とログ収集の設計
最初に決めるのは「何を検知したいのか」で、ツールの選定はその後になります。検知したい対象は、主に3つに分かれます。
- 致命的エラー:サービス停止につながるエラーを早期に捕まえる
- 不正アクセス:その兆候を掴む
- 性能劣化:原因をログから追う
目的によって、収集すべきログも設定すべき閾値も変わります。また、目的が曖昧なまま全ログを集め始めると、ノイズに埋もれて肝心の異常を見落としがちです。
目的が定まったら、対象となるサーバー・アプリケーション・ミドルウェアを洗い出し、それぞれが出力するログの場所とフォーマットを一覧にします。
各ホストには、ログ収集用のエージェント(FluentdやFluent Bit、各監視ツール提供のエージェントなど)を導入します。
収集の段階で不要なログを除外し、必要なログにタグやメタデータを付与しておくと、後の解析が格段に楽になります。
最初の設計が雑だと、後からの作り直しに大きなコストがかかります。そのため、ここは丁寧に進めるべきフェーズです。
ステップ2: ログの集約・保存基盤の構築
収集したログは、一箇所に集約して横断検索できる基盤へ送ります。集約基盤の選択肢には、主に3種類があります。
- クラウド型のログ管理サービス:Datadog LogsやAmazon CloudWatch Logsなど
- 検索基盤:Elasticsearch/OpenSearchなど
- 統合監視ツールのログ機能:Zabbixなど
集約基盤を持つことで、複数サーバーのログをまたいで「同じ時間帯に何が起きていたか」を時系列で追えるようになります。
保存基盤の設計で見落とされがちなのが、保存期間(リテンション)の設定です。ログは放置すると際限なく増え続け、ストレージコストを圧迫します。
クラウド型サービスの多くは、取り込んだデータ量に応じた従量課金です。そのため、取り込み量が積み上がると、月額コストが想定を大きく超えることもあります。
直近の障害解析に必要な期間は、すぐ検索できる状態で保持します。一方で、コンプライアンス上の長期保存が必要なログは、安価なストレージへアーカイブする階層管理が現実的です。
保存基盤を整える段階で、ログのパース(構造化)も行っておきます。非構造のテキストのまま保存すると検索性が落ちるため、日時・ログレベル・メッセージ・送信元といった項目に分解して保存します。そうすると、後の絞り込みや集計が速くなります。
ステップ3: 解析ルールとアラート条件の設定
集約したログから異常を見つけ出し、担当者へ通知する仕組みがログ監視の核心です。アラート条件は、通知の判断に使う観点ごとに設定します。
- キーワード:FATAL、ERROR、OutOfMemoryなどを含むログが出現したら通知
- 発生回数:一定時間内に同種のエラーが規定回数を超えたとき
- 通知経路:メールやSlack、PagerDutyなど
アラートの通知を、夜間や休日でも見逃さずに受け取れる体制を作ります。
なかでもアラート設計は、ログ監視で最も失敗が起きやすいフェーズです。実際に、「特定のキーワードを含むログだけをSlackに通知する」という複雑な条件分岐を組んだ事例があります。ところが、設定ミスで重要なエラーログが通知対象から漏れ、障害の発見が3時間も遅れました。
事例から得られる教訓は明確で、ツール選び以上に「アラート設計のシンプルさ」が重要だということです。
凝った条件分岐は一見賢く見えますが、設定の意図を後から誰も理解できなくなり、メンテナンス不能なブラックボックスと化します。
運用を始めた後は、検知漏れと過検知の両方を定期的に振り返り、閾値や条件を調整し続けます。最初から完璧なアラートは作れないという前提に立ち、実際のログの傾向を見ながらノイズを減らします。この継続的なチューニングが、ログ監視の成否を分けます。
ログの相関分析とオブザーバビリティへの発展
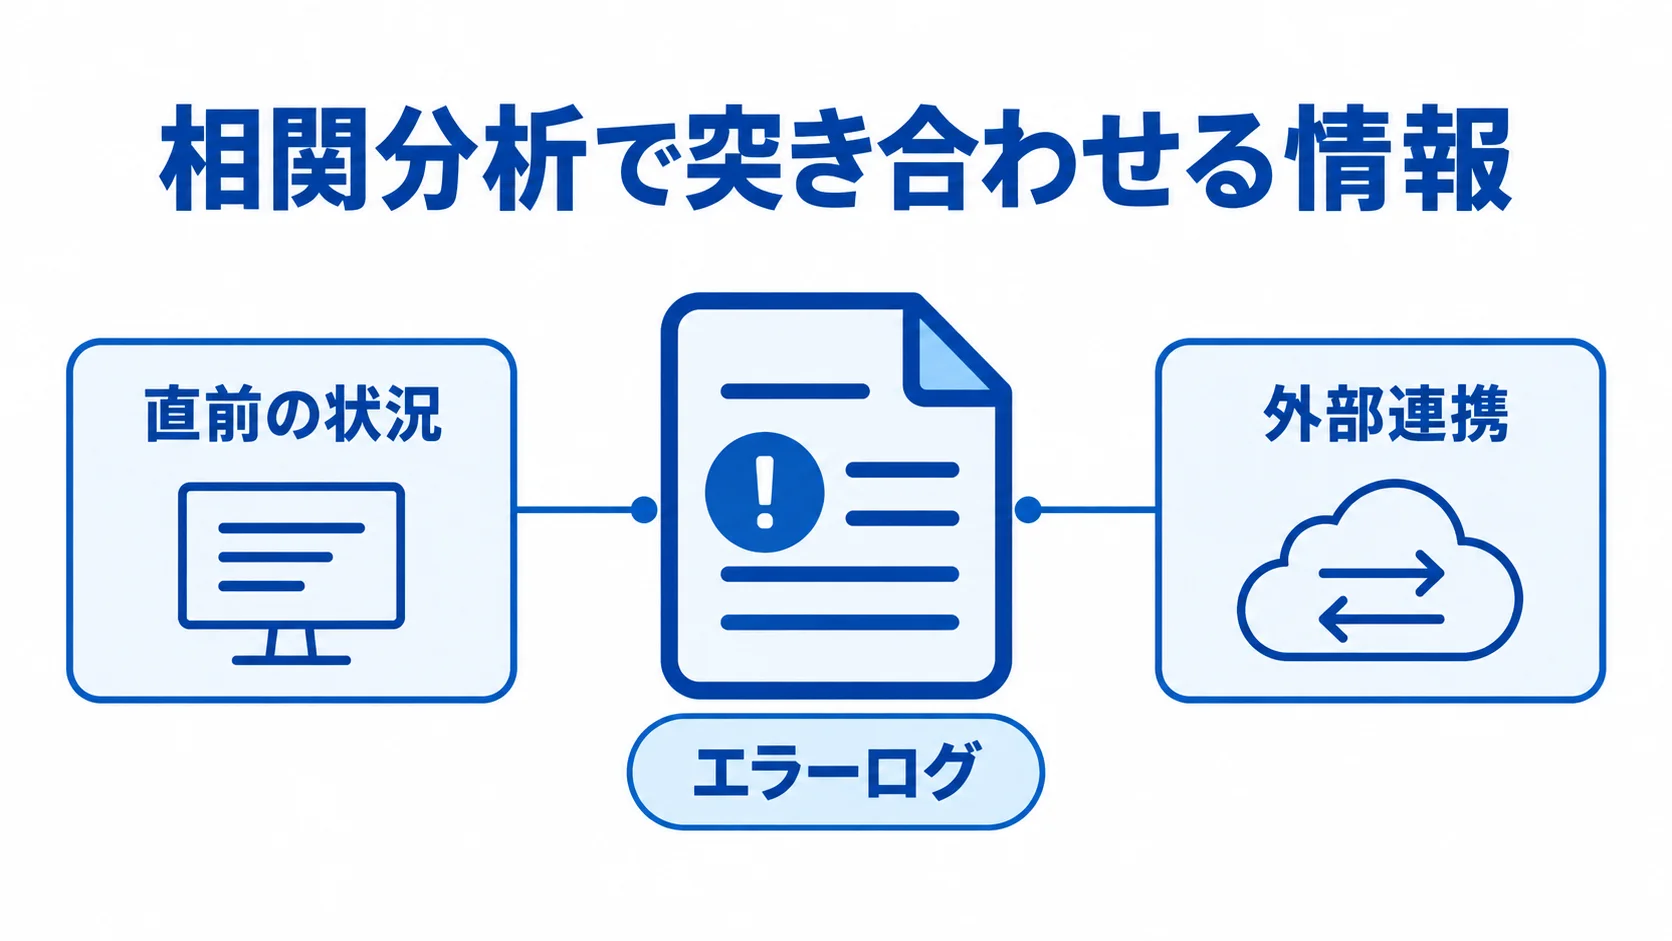
ログを集めて単純なキーワード検知ができるようになったら、次の段階は「相関分析」です。
単一のログを見るだけでは分からない障害の連鎖があります。複数のログやメトリクス、トレースと突き合わせて読み解くと、「なぜ問題が起きたのか」まで追えます。
相関分析による読み解き方は、近年注目される「オブザーバビリティ(可観測性)」の考え方です。
ログ・メトリクス・トレースを束ねる相関分析
監視(モニタリング)が「どこに異常があるか」を示すのに対し、オブザーバビリティは「なぜその異常が発生したか」を明らかにするアプローチです。両者の違いは、ログ監視をどこまで発展させるかを考えるうえで重要です。
相関分析で突き合わせる情報は、主に3種類あります。
- エラーログ:エラーが出ているという事実
- 直前の状況:レスポンスタイムの悪化や、特定のサーバーへの負荷集中
- 外部連携:外部サービスの呼び出し遅延
ログ・メトリクス・トレースを束ねて、原因を確認します。
実際に、ある中規模SaaS企業では、APM・ログ・メトリクス・トレースを統合的に可視化しました。その結果、障害の原因特定にかかる時間が従来の3分の1にまで短縮されました。
直感的なGUIで関連情報を一画面で追えるようになり、経験の浅いメンバーでも原因に辿り着けるようになりました。そのため、運用全体の負荷も下がりました。
ログ単体の監視から相関分析へ進むことは、障害対応のスピードと属人性の解消に直結します。
AIOpsによる異常検知の実態と限界
近年は、AIや機械学習でログやメトリクスから異常を自動検知する「AIOps」も実用段階に入りつつあります。
AIOpsは、3つの観点から見ると実態がつかめます。
- 検知の仕組み:平常時の挙動との違いで異常を見つける
- 学習データの量:正常時のデータがどれだけ要るか
- 新種の障害や文脈のある判断:AIだけでは任せきれない領域
平常時のログパターンを学習させ、そこから逸脱した挙動を「いつもと違う」として検知します。人間が閾値を一つひとつ設定する手間を減らし、これまで気づけなかった異常を浮かび上がらせます。
一方で、AIOpsを過信するのは禁物です。異常検知の精度を上げるには、ある程度まとまった量の正常時データを学習させる必要があります。導入直後やトラフィックの少ないシステムでは、十分に機能しないこともあります。
過去に例のない新種の障害や、ビジネス上の文脈に依存する判断(このエラーは想定内か致命的か)は、AIが自動で正しく切り分けられるとは限りません。
AIOpsは、人間が見るべき点を絞り込むための補助として位置づけるのが現実的です。人間の判断を置き換えるものではありません。
最終的な対応方針は、システムとビジネスを理解した人間が決めるという前提を崩さないことが大切です。
ログ監視の費用相場とコストの内訳
ログ監視のコストは、採用するツールの課金体系と、運用を自社で行うか外部に委託するかによって大きく変わります。
とくにログ監視は、データ取り込み量が課金に直結しやすく、設計を誤ると想定外の費用が発生しがちです。ここでは、ツール費用と運用費用の両面から費用構造を見ていきます。
ツール費用の相場と課金体系
予算を月額5万円未満に抑えたい場合は、初期コストがかからないOSSのZabbixが選択肢になります。
ツール費用は、予算規模、課金の単位、第三者評価の3点で比べられます。
- 予算規模ごとの候補:月額の予算に応じて、候補のツールを比べる
- 課金の単位:取り込んだデータ量か、ホスト数か
- 第三者評価の数値:ITreviewの満足度と料金
月額5万〜20万円程度の規模では、取り込んだデータ量あたりおよそ$0.76/GBといった従量課金のCloudWatchが現実的です。
月額20万円以上の本格運用では、ホスト単位の課金(月額$15程度〜/ホスト)で高度な統合機能を持つDatadogが候補に挙がります。
ITreviewの2026年5月時点のデータでは、Mackerelの機能満足度は4.4です。Mackerelのスタンダードプランは月額2,180円/台です。一方で、Datadog(月額1,650円〜)とZabbix(0円〜)は、ともに満足度4.1という評価です。
ログ監視で注意したいのは、ホスト数だけでなく取り込むログ量によって費用が膨らむ点です。冗長なデバッグログを取り込み続けると、課金が跳ね上がります。そのため、収集の段階でフィルタリングして不要なログを減らすことが、費用を抑える鍵になります。
運用費用とランニングコスト
ツール費用以上に見落とされがちなのが、運用にかかる人件費です。ログ監視は導入後も、継続的な作業が発生します。
運用の継続作業には、次のようなものがあります。
- アラート対応:通知が来たときに対処する
- 閾値チューニング:実際のログの傾向に合わせて検知の基準を調整する
- 基盤メンテナンス:ログを集めて保存する仕組みを保守する
24時間365日体制を自社の人員だけで賄おうとすると、エンジニアの夜間・休日対応の負荷が重くのしかかります。
この負荷を外部に委託する場合は、監視代行(MSP)の相場を見ておきます。一次対応を含む24時間365日監視パッケージは、1台あたり月額10,000〜30,000円が目安です。
個別サービスの監視を追加するオプションは、月額200円/1サービスです。さらに、Apacheなどの自動復旧監視は、月額3,000円といった単位で積み上がります。
自社運用の人件費と外部委託費を比べて判断します。自社のコア業務に人員を集中させたいなら委託が向いています。一方で、ノウハウを内製で蓄積したいなら、自社運用を選ぶ判断軸でコストを評価するとよいでしょう。
ログ監視を依頼・見積もりする際のポイント
ログ監視を外部に依頼する、あるいは複数社から見積もりを取る際には、価格だけで判断すると後悔につながります。
監視範囲、サポート体制、契約形態を見極めれば、ブラックボックス化や偽装請負といったリスクを避けられます。発注前に押さえたい点を、順に見ていきます。
監視範囲とSLAの明確化
見積もりを比較する前提として、「どこまでを監視し、異常時に何をしてくれるのか」をSLA(サービス品質保証)として明文化することが欠かせません。
対応範囲は、どこまでを委託するかで段階が分かれます。
- 検知のみ:異常を見つけて知らせるところまで
- 一次対応まで:異常時の初動対応まで含める
- 自動復旧やOSアップデートの代行:復旧や更新の作業まで任せる
対応範囲が曖昧なまま安いプランを選ぶと、いざ障害が起きたときに「それは契約外です」と言われ、結局自社で対応する羽目になります。
外部に委託しても、発注側が手放してはいけないスキルがあります。SLAを適切に定める力と、自社システムのアーキテクチャ全体を把握する力は、委託先任せにしてはいけません。
これらを手放すと、「MSPに丸投げした結果、自社システムを理解できる社員がゼロになった」という構造的な失敗に陥ります。監視の作業は委託しても、何をどう監視すべきかの判断は自社に残します。この線引きが、健全なアウトソーシングの条件です。
契約形態と偽装請負のリスク
監視業務を委託する際は、契約形態の違いを理解しておく必要があります。業務委託契約(請負・準委任)と労働者派遣契約では、指揮命令の所在が根本的に異なるためです。
請負・準委任の契約で指揮命令の線引きを守るには、次の3つの点を押さえておきます。
- 指揮命令の所在:請負・準委任では受託側にある
- 作業者への直接の指示:発注側が細かな指示を出すと「偽装請負」と判断されるおそれがある
- 担当者への直接の返信の求め方:担当者に直接返信を求めると、指揮命令とみなされるおそれがある
とくに注意したいのが、現代的なグレーゾーンです。たとえば、発注者の事業所で請負労働者が一人で業務を行う場合があります。その作業者が管理責任者を兼任すると、発注者の注文が直接の指揮命令とみなされ、偽装請負と判断される恐れがあります。
管理責任者宛のメールを作業担当者にCC送付すること自体は、違法ではありません。ただし、実質的な作業手順の指示が含まれていると、指揮命令とみなされる恐れがあります。
アジャイル開発やSlackで常時つながる現代の運用現場では、コミュニケーションの境界線が曖昧になりがちです。そのため、契約形態に応じた適切な距離感を保つことが重要です。
ベンダーロックインと失敗事例への対策
SaaS型のログ監視ツールは導入が容易な反面、独自の設定やダッシュボードを作り込むほど、他ツールへの移行コスト(スイッチングコスト)が高まります。
ロックインへの備えは、次のような観点で考えます。
- 乗り換えの想定:将来ほかのツールへ替えることを前提に考える
- 収集規格の標準化:収集の段階で規格をそろえる
- 運用フローの設計:アラートの確認と対応の手順を決めておく
ログの収集規格としてOpenTelemetryのような標準仕様を採用しておくと、ベンダーロックインを回避しやすくなります。
収集の入口を標準化しておけば、出口となる解析ツールを後から差し替える自由度が保てます。
もう一つ注意したいのが、ツールを入れただけで満足してしまう失敗です。「高価なSaaSを導入したものの、結局誰もダッシュボードを見ず、宝の持ち腐れになった」という組織レベルの失敗は珍しくありません。
これを防ぐには、誰がいつアラートを確認し、どう対応するかという運用フローを、契約と同時に設計します。加えて、監視結果を定期的にレビューする文化を組織に根づかせることが必要です。
見積もりを取る段階から、ツール費用だけでなく、運用が回る体制をどう作るかまで発注先と握っておくと、投資を無駄にしません。
まとめ
ITシステムログ監視は、死活監視・性能監視と組み合わせることで「なぜ障害が起きたのか」を解き明かす要となる監視です。
進め方は、監視目的の定義からログ収集の設計、集約・保存基盤の構築、解析・アラート条件の設定へと進みます。
なかでもアラート設計は凝りすぎず、シンプルに保つことが検知漏れを防ぐ最大の鍵となります。
ログを相関分析へと発展させ、メトリクスやトレースと束ねてオブザーバビリティを高めれば、障害の原因特定時間を大幅に短縮できます。
費用面では、ツールの取り込み量課金と運用人件費の両方を見据えます。外部委託する際は、SLAを明確にし、偽装請負に配慮し、ベンダーロックインを避けることが重要です。
押さえた流れを起点に、自社に合ったログ監視体制を設計し、安定したシステム運用につなげてください。
ログ監視の構築や運用設計でお困りの際は、コンサルティングから実装・定着支援まで一気通貫で対応できるパートナーに相談することで、失敗のリスクを大きく減らせます。
あわせて、ログ監視の関連テーマについては以下の記事もご覧ください。
ITシステムログ監視でおすすめの開発会社・ベンダー6選と選び方では、具体的なツール・委託先を比較しています。
ITシステムログ監視の見積相場や費用についてでは、コストの内訳を詳しく解説しています。
外部委託を検討中の方は、ITシステムログ監視の発注・外注・委託方法についてをご覧ください。
全体像を体系的に把握したい方は、ITシステムログ監視の完全ガイドをご参照ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。