
ITシステム保守監視の進め方は、現状の棚卸しから監視設計、運用体制の整備へと進み、改善を続ける流れです。
- 監視:CPUやメモリなどの状態を継続して見張る作業
- 保守:異常への対応、パッチ適用、バックアップを担う作業
- 体制:有人監視と自動監視の組み合わせ
24時間365日の監視は少人数のIT部門に大きな負担で、夜間対応の疲弊や重大障害の見落としを招きがちです。何から手をつければよいか分からず、属人化したままの企業も少なくありません。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム保守監視の全体像と役割
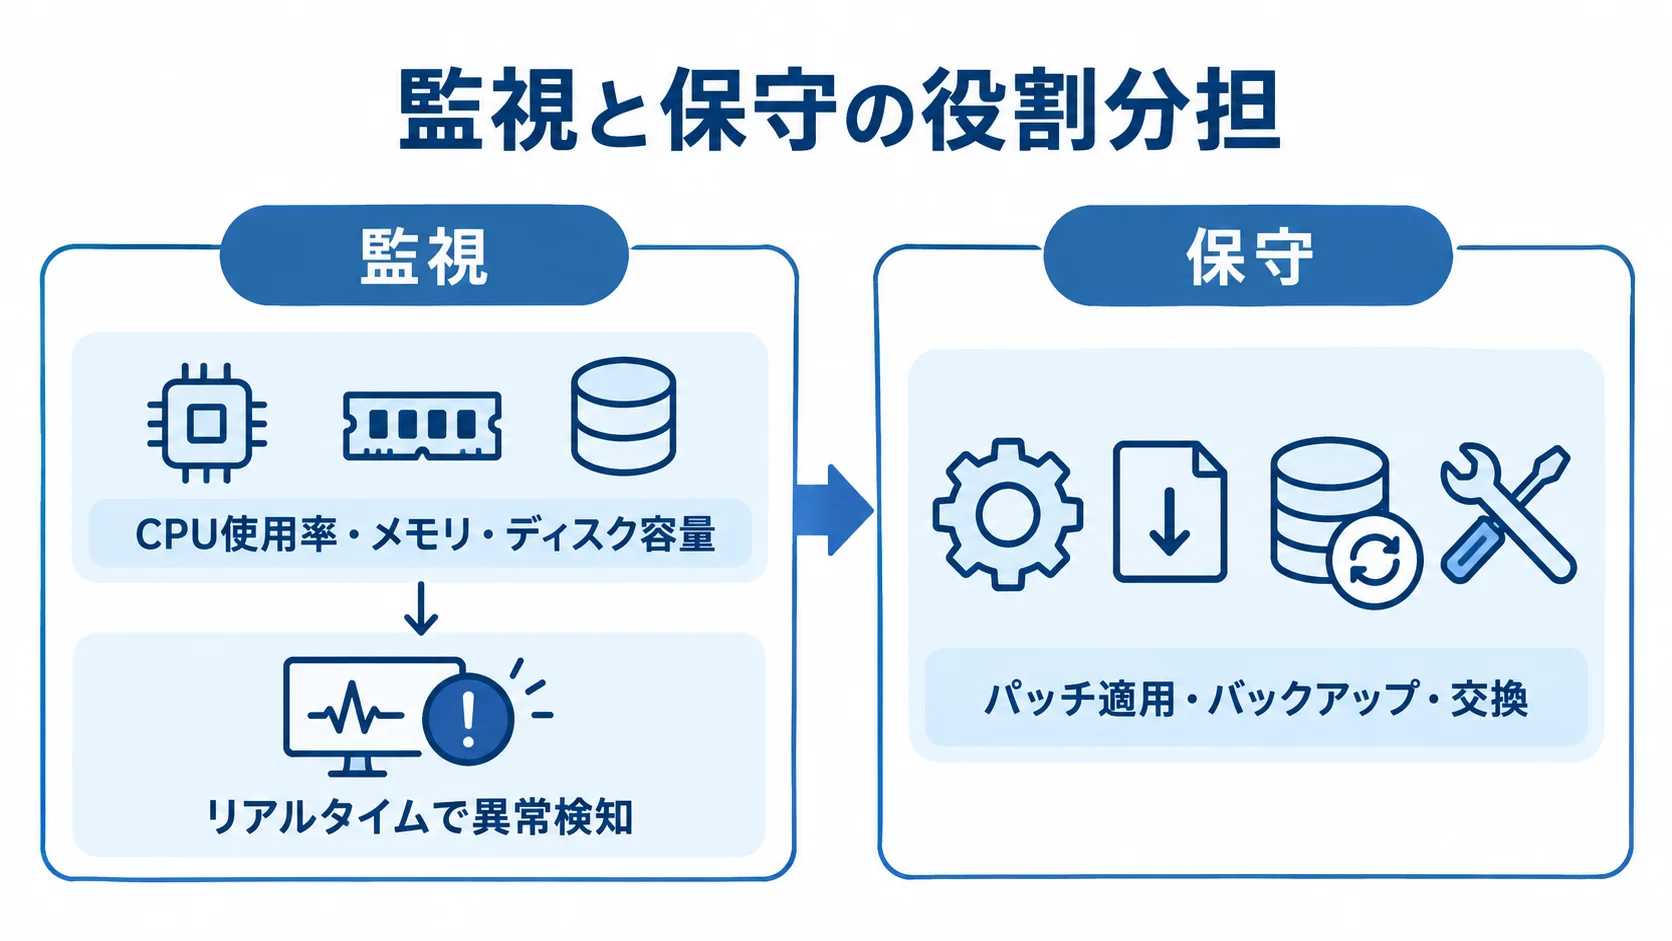
ITシステム保守監視とは、サーバーやネットワーク、アプリケーションが正常に稼働しているかを継続的に見張り、異常の予兆や障害を検知して対応する一連の活動を指します。
進め方を考える前に、「保守」と「監視」がそれぞれ何を担い、どのような体制で成り立っているのかを押さえておきます。後工程の設計を誤らないための土台になるからです。
「保守」と「監視」が担う範囲の違い
保守監視という言葉はひとまとめに語られがちですが、両者の役割ははっきり異なります。「監視」は、CPU使用率やメモリ、ディスク容量などが正常範囲を超えていないかをリアルタイムで見張り、異常に「気づく」役割です。
一方、「保守」は、検知された異常に対応し、定期的なパッチ適用やバックアップ、ハードウェアの交換で「手を打つ」役割を担います。この区別があいまいなまま体制を組むと、「アラートは鳴っているのに誰も対応しない」「対応はしているが、何を監視すべきかが決まっていない」といった事態が起こります。
進め方を設計するときは、監視で「何を見るか」と、保守で「どう対応するか」をセットで決めておくことが欠かせません。とりわけ近年は、監視で得たログやメトリクスを保守の改善に活かす循環をどう作るかが、運用品質を左右する重要なポイントになっています。
有人監視と自動監視の組み合わせ
24時間365日の監視を実現する方法は、大きく「有人監視」と「自動監視」の2つに分かれます。有人監視は、専任のオペレーターが監視センターでモニターを見続け、異常を検知したら手動で一次切り分けやエスカレーションを行う方式です。確実性は高い反面、人件費がかさみ、夜間や休日のシフト勤務による担当者の負担が課題になります。
自動監視は、監視ツールがあらかじめ設定したしきい値に基づいて異常を検知し、通知やチケット起票、場合によっては一次対応までを自動で行う方式です。実際の運用では、アイレットの「cloudpack」が、アラート全体の約80%を社内システムで自動処理し、人間が対応するのは残りの20%にとどめています。
また、中小企業でも、ネットワーク監視ツールの導入と異常検知の自動化により、トラブル対応工数を最大で約8割削減した例が報告されています。現実的な進め方としては、定型的で頻度の高い事象は自動監視に任せ、判断を要する複雑な事象に有人監視のリソースを集中させる「ハイブリッド型」が主流です。
ITシステム保守監視の進め方5ステップ
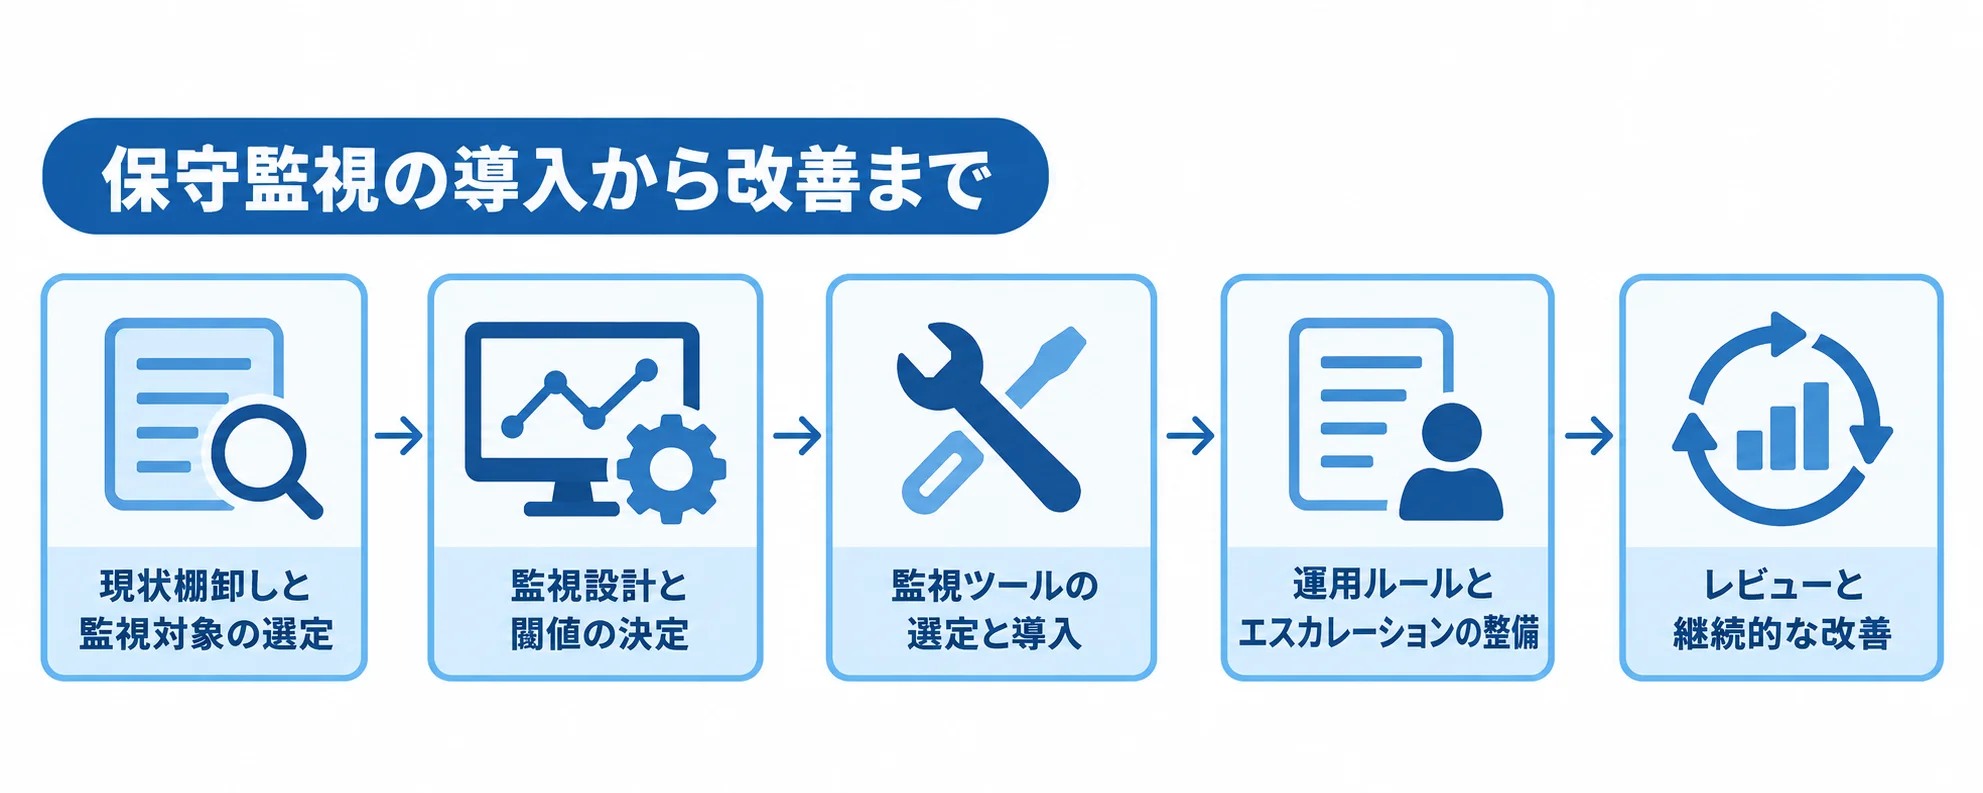
保守監視の体制は、思いつきでツールを導入するのではなく、現状の把握から始めて段階的に積み上げることが成功の鍵です。そうすれば、無理なく体制が整っていきます。
全体は5つのステップです。まず現状を棚卸しし、次に監視設計とツール選定を進め、その後に運用ルールを整えて、継続的に改善していきます。
ステップ1:現状棚卸しと監視対象の選定
最初に、自社が保有するITシステムの全体像を一覧にします。どのサーバーがどの業務を支えているのか、ネットワーク構成はどうなっているのか、クラウドとオンプレミスがどう混在しているのかを洗い出します。
この棚卸しが甘いと、後の監視設計で「重要なシステムが監視対象から漏れていた」という致命的な抜け漏れが生じます。続いて、洗い出した資産に監視の優先順位を付けます。ここでは、すべてを同じレベルで監視しないことが大切です。
売上に直結する基幹システムやサービス提供の根幹を担うサーバーは厳重に監視し、停止しても業務への影響が小さいシステムは監視レベルを下げます。また、監視対象を広げすぎると、後述する「アラート疲労」を招き、かえって重大障害を見落とす原因になります。そのため、ビジネス影響度を基準に取捨選択することが肝心です。
ステップ2:監視設計と閾値の決定
監視対象が定まったら、次は「何を、どの基準で異常と判断するか」を設計します。見る項目は次のとおりで、項目ごとにしきい値を決めていきます。
- CPU使用率、メモリ使用率、ディスク空き容量の状態
- ネットワークの疎通
- アプリケーションの応答時間
- プロセスの死活
この閾値の設計が、保守監視の品質を大きく左右する最重要工程です。
現場でよくある失敗は、監視ツールの初期設定にある「CPU使用率80%で通知」を、そのまま使ってしまうことです。その結果、一瞬のスパイクでCPUが80%を超えただけで通知が飛び、問題のない事象でもアラートが鳴り続けます。
これを避ける実践的なコツは、次の2つです。
- 継続時間を条件に加える:「一瞬のスパイクは無視し、80%超が5分間継続したら通知する」というルールにするだけで、無意味なアラートを大幅に減らせます。
- 閾値を運用で調整する:運用しながら現実のシステムの挙動に合わせて調整していく前提で設計します。
ステップ3:監視ツールの選定と導入
監視設計が固まったら、それを実現する監視ツールを選定します。
ツール選びでありがちな失敗は、「多機能な統合ツールを選んでおけば安心」と考えて、自社の規模に合わないオーバースペックなツールを導入してしまうことです。高機能なツールは運用に専門知識を要し、使いこなせないまま費用だけがかさむケースも珍しくありません。
監視ツールは「スーパーカーと乗用車」に例えると分かりやすくなります。
- Datadogのような高機能ツール:スーパーカーのように高速で高セキュリティですが、扱うには知識が必要で、価格も高めです。
- Site24x7のようなツール:乗用車のように設定が簡単で安価ですが、セキュリティ面はやや控えめです。
近年はSaaS型で小さく始め、必要に応じて広げていくのが主流です。サーバー台数が少なく影響も限られる段階では、OSSのZabbixなどで十分なこともありますが、台数や運用工数が増えると、有料SaaSへ移行する損益分岐点が訪れます。そのため、自社のフェーズを見極めてツールを選ぶことが、コストと品質のバランスを取るうえで欠かせません。
ステップ4:運用ルールとエスカレーションの整備
ツールを導入しても、アラートが鳴ったときに「誰が、いつ、何をするか」が決まっていなければ、監視は機能しません。そこで、検知から対応までの運用ルールを整備します。中心となるのが、サポート体制の階層化です。
階層化では、一般に次の3段階で役割を分けます。
- L1(一次対応):アラート検知とプレイブックに沿ったトリアージ
- L2(二次対応):詳細なログ分析や一時復旧
- L3(三次対応):根本原因の解決やアーキテクチャ変更
この階層化には「80/20ルール」が役立ち、L1が問題全体の約80%を処理します。残りのうち約80%をL2が引き取り、20%以下の難度の高い問題をL3が担う分担です。
あわせて、各役割の責任範囲を明確にするRACIマトリクスを整備しておくと、障害時に「誰が判断するのか」で混乱せずに済みます。RACIでは、実行責任と説明責任、相談先と報告先を役割ごとに書き分けます。特に、複数のベンダーやクラウドが絡む環境では、受け持ちの範囲を文書で明らかにしておくことが、後のトラブル防止に直結します。
ステップ5:レビューと継続的な改善
保守監視は、導入した後も運用しながら磨き続けるものです。
月次や四半期ごとに、閾値や運用ルールを見直します。その判断材料として、次の4つの指標を見ます。
- 検知したアラートの件数
- 誤検知の割合
- 平均修復時間(MTTR)
- 稼働率
継続的な改善は、大きな効果を生みます。あるサービスでは、再発防止フローを徹底し、二次運用チームによる恒久的な改善活動(半期で30件以上)を積み重ねました。その結果、目標としていた正常対応率99.9%を上回る99.99%を達成し、アラート対応時間を累計10,000時間以上削減しています。
SLA(サービス品質保証)として「インシデント応答30分以内」「稼働率99.9%以上」などの客観的なKPIを設定しておくと、改善の効果を数値で確かめられます。PDCAを回し続ける体制こそが、保守監視を「鳴り止まないアラートに振り回される状態」から「安定して回る仕組み」へと変えていきます。
内製か委託(MSP)かの判断ポイント
保守監視の進め方を考えるうえで避けて通れないのが、「自社で監視するのか、それともMSP(マネージドサービスプロバイダー)に委託するのか」という判断です。経済産業省は2030年にIT人材が最大で約79万人不足すると試算しており、既存システムの運用保守に人員を割き続けることには限界があります。
委託の利点と注意点を押さえたうえで、委託後の移管をどう設計するかも欠かせません。
委託のメリットとブラックボックス化のリスク
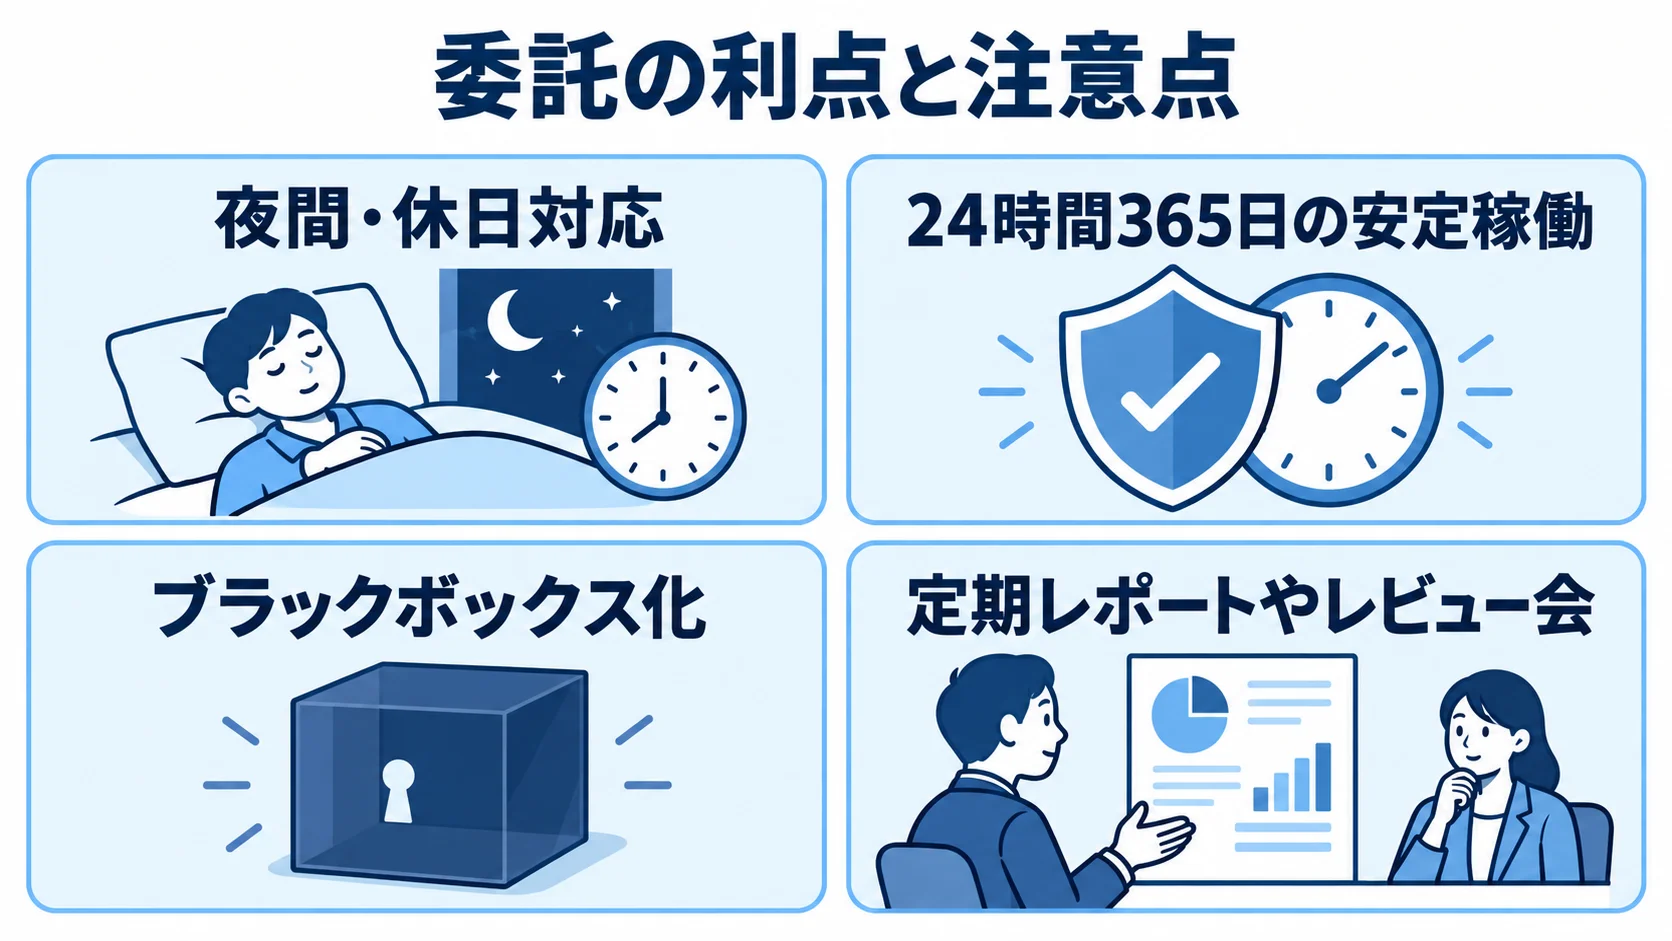
保守監視をMSPに委託する最大の利点は、夜間・休日対応による担当者の疲弊を防ぎ、24時間365日の安定稼働を専門事業者に任せられることです。社内のITリソースを、運用維持という「守りのIT」から、DX推進や新規企画といった「攻めのIT」へ振り向けられるようになります。
実際にトヨタ自動車は、アジャイル開発のPoC増加で膨らんだAWS環境の運用監視を外部委託することで、開発メンバーが本来の業務に集中できる体制を整えました。一方で注意したいのが、外部への丸投げによる運用の「ブラックボックス化」です。委託先に任せきりにすると、自社にノウハウが蓄積されず、特定ベンダーへの依存(ベンダーロックイン)が進みます。
情報漏洩リスクへの配慮も欠かせません。こうしたリスクを抑えるには、委託前に運用ドキュメントを整備し、委託後も定期レポートやレビュー会で運用状況を把握し続けることが重要です。委託は、責任を手放すことではなく、自社が判断を持ったまま手間を減らす手段として捉えることが、後悔しない判断につながります。
移管時の並走期間(ハイパーケア)の設計
委託を決めたら、現行の運用を委託先へ引き継ぐ移管プロセスを丁寧に設計します。移管でよくある失敗は、契約開始と同時に運用を全面的に委託先へ切り替えてしまい、引き継ぎ漏れによる障害対応の混乱を招くことです。これを防ぐために設けるのが、自社と委託先が並んで運用を行う「並走期間(ハイパーケア)」です。
一般には3〜6ヶ月の並走期間を設け、その間に委託先がシステムの癖や過去のトラブル履歴を把握し、運用ドキュメントを実態に合わせて更新していきます。並走期間を十分に取ることで、移管後に「想定外の事象に委託先が対応できない」という事態を避けられます。
また、将来的に運用を自社へ引き戻す内製化(リパトリエーション)の可能性を見据えるなら、委託の段階から「いつでもナレッジを逆移管できる状態」を維持しておくことが望ましいです。具体的には、運用手順書やインシデント対応記録を自社でも参照できる形で蓄積し、ベンダーだけが情報を握る状態を作らないことが、長期的な選択肢を保つうえで欠かせません。
保守監視でよくある失敗と回避策
保守監視の進め方を一通り押さえても、実際の運用には典型的な落とし穴がいくつも待ち受けています。あらかじめ失敗のパターンを知っておけば、同じ失敗を繰り返さずに済みます。
現場で頻発するのは、「アラート疲労」と「AI・自動化への過信」という2つの失敗です。
「アラート疲労」による重大障害の見落とし
監視対象を増やしすぎたり、しきい値を不適切に設定したりすると、重要度の低いアラートが大量に発生します。すると、担当者は次第にアラートに慣れてしまい、「どうせ大したことはない」と通知を軽視するようになります。この状態が「アラート疲労」であり、いわゆる「オオカミ少年化」です。
その結果、本当に重大な障害のアラートが、ノイズに埋もれて見落とされるという最悪の事態を招きます。回避策の核心は、アラートの「量」ではなく「質」を高めることです。前述した「5分間継続したら通知」のような継続時間の条件に加え、アラートに重要度レベル(緊急・警告・情報など)を定義し、影響範囲に応じて通知先や通知方法を変えます。
たとえば、緊急度の高いものはオンコール担当者へ即座に電話で、情報レベルのものはチケットに記録するだけ、といった具合に強弱を付けるのです。つまり、すべてのアラートを等しく扱わないことが、限られた人員で重大障害を確実に捕捉するための現実的な答えになります。
AI・自動化への過信と誤検知への備え
近年は、機械学習による異常検知や予測を行うAIOps、生成AIによる原因分析やヘルプデスク応答など、保守監視の自動化が急速に進んでいます。自動化率80%という実例が示すとおり、その効果は確かに大きいものです。しかし、AIや自動化を万能と過信するのは危険です。
生成AIには誤検知や過剰検知といったハルシネーションのリスクがあり、AIに運用ルールを正しく学習させるには、地道なデータ整備という泥臭い手間がかかります。特に注意すべきは、自動化システムが未知の障害を「正常」と誤認し、重大障害を見落とすケースです。このとき、責任がツールベンダーとMSP、自社のどこにあるかは、契約内容によって異なります。
そのため、自動化を導入するときは、AIの判断を鵜呑みにせず、人間が最終確認する場面を残しておくことが欠かせません。さらに、誤検知で障害が起きた場合の責任の所在を、契約段階で明確にしておきます。自動化は人間の負担を減らす強力な手段ですが、人間の判断が欠かせないという前提を忘れないことが、安全な運用につながります。
まとめ
ITシステム保守監視の進め方は、5つのステップで組み立てます。現状棚卸しと監視対象の選定から始め、閾値を含む監視設計、自社規模に合ったツール選定へ進みます。続いて、L1からL3までの階層化を含む運用ルールを整備し、レビューによる継続的な改善で締めくくります。
有人監視と自動監視を組み合わせ、「5分間継続したら通知」といった現場の閾値チューニングや「80/20ルール」による役割分担を取り入れることで、限られた人員でも安定した監視体制を実現できます。
内製か委託かを判断するときは、ブラックボックス化を避けながら、3〜6ヶ月の並走期間を設けて安全に移管することが大切です。また、アラート疲労による見落としやAI・自動化への過信といった失敗パターンをあらかじめ知っておくことで、よくある落とし穴を回避できます。
ここまでの進め方を土台に、自社の保守監視を一歩ずつ前進させていただければ幸いです。費用相場やおすすめのベンダー、発注方法など、さらに詳しい情報は、以下の関連記事もあわせてご覧ください。
関連記事:ITシステム保守監視でおすすめの開発会社・ベンダー6選と選び方
関連記事:ITシステム保守監視の見積相場や費用・コスト・値段について
関連記事:ITシステム保守監視の発注・外注・依頼・委託方法について
関連記事:ITシステム保守監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。