
ITシステム監視対応の進め方は、アラートを検知してから復旧までを一連の流れとして組み立て、その流れを回していくことです。
- 検知:アラートやログから異常を把握
- 切り分け:影響範囲と原因の確認
- 復旧:対応手順に沿った復旧と再発防止
成果を分けるのは、監視ツールよりも、誰が、どのレベルの事象を、どの順番で対応するかという対応プロセスです。階層設計からMTTR短縮、SLA運用までを順に説明します。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム監視対応の全体像
監視対応を進める前に、まず「監視」と「監視対応」を区別しておく必要があります。監視は、アラートを検知して状態を見える形にするところまでを指します。一方、監視対応は、そのアラートに対して人やシステムが実際に動き、復旧と再発防止までを担う領域です。
多くの現場で障害が長引く原因は、監視ツールの性能ではなく、検知後の対応プロセスが整理されていない点にあります。対応の良し悪しは、最終的にMTTR(平均修復時間)という客観的な数値に表れます。
アラートが上がってから誰がどう動くかが決まっていれば、夜間や休日でも復旧が早まり、担当者の負担も軽くなります。逆に、手順が属人化していると、対応できる人がいない時間帯に重大障害が起きた瞬間、被害が一気に拡大します。
監視対応がカバーする範囲と種類
監視対応の範囲は、対象によって死活監視・リソース監視・ログ監視・サービス監視などに分かれます。死活監視はサーバーやネットワーク機器が応答するかを確かめ、リソース監視はCPUやメモリ、ディスク使用率の異常を捉えます。
また、ログ監視はアプリケーションのエラーや認証失敗を検知します。サービス監視は、利用者の目線でWebサイトやAPIが正しく応答するかを外形から監視します。
これらを同じ重みで扱うと現場は大量のアラートに埋もれるため、「どの監視が、ビジネスにどれだけ影響するか」で優先度を分けることが大切です。たとえば決済処理のAPI停止は、リソース使用率の一時的な上昇よりはるかに重大で、対応プロセスもエスカレーション先も変えるべきです。監視対応の設計とは、この優先度の地図を最初に描く作業だと言えます。
内製と委託の選び分け
監視対応を自社で回すか、MSP(マネージドサービスプロバイダ)へ委託するかは、対応プロセス設計の出発点になります。経済産業省はIT人材が2030年に最大約79万人不足すると試算しており、既存システムの運用保守に人を割き続ける体制は限界に近づいています。
特に、24時間365日の有人監視を自社だけで維持するのは、中堅企業でも相当に重い負担です。一方で、すべてを外部へ丸投げすると、対応の中身がブラックボックス化し、社内にノウハウが残りません。
そこで現実的な落としどころとなるのが、一次対応(L1)や夜間帯を委託しつつ、判断を要するL2/L3の一部を自社に残すハイブリッドです。どこまでを委託し、どこからを自社が握るかを先に決めておくと、後述するL1/L2/L3の役割設計がぶれにくくなります。委託の進め方はITシステム監視対応の発注/外注/依頼/委託方法についてで詳しく解説しています。
L1/L2/L3の階層を設計する進め方
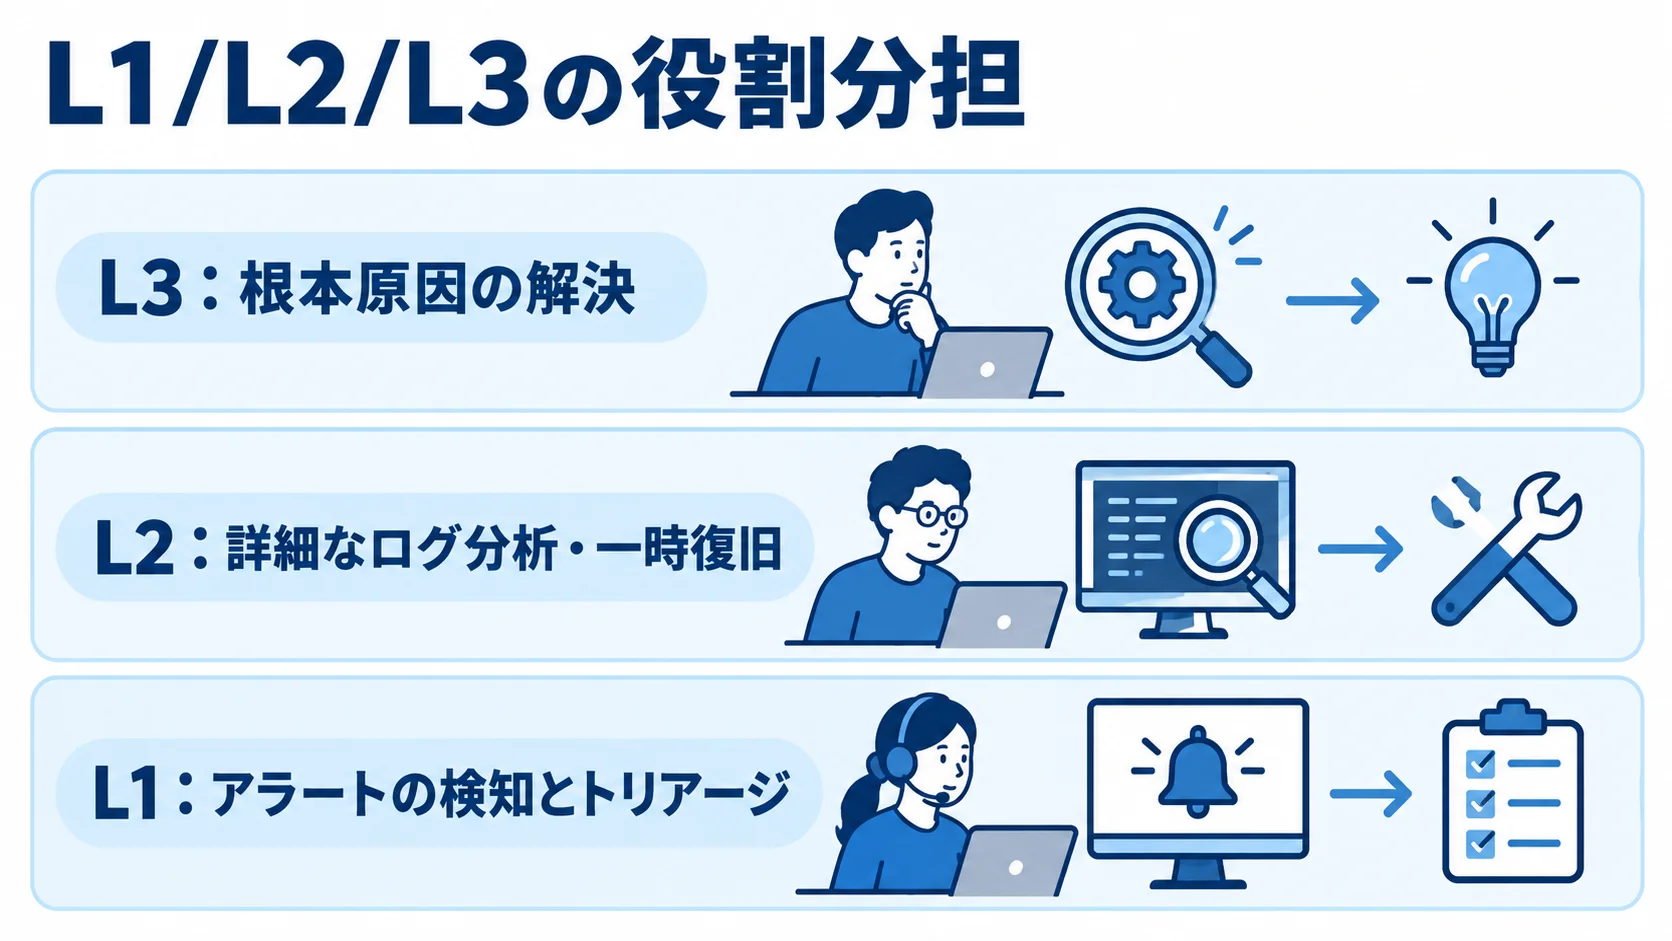
監視対応プロセスの中核は、サポート体制を階層化することです。一般にはL1(一次対応)、L2(二次対応)、L3(三次対応)の3層に分け、層ごとの守備範囲を決めておきます。
階層が曖昧だと、簡単な事象まで専門エンジニアが対応してコストが膨らみます。逆に、手に負えない障害を一次担当が抱え込み、復旧が遅れることもあります。
現場でよく使われる目安が「80/20ルール」です。発生する問題の約80%は特権アクセスを必要としない定型対応でL1が処理でき、残りのうち約80%をL2が処理し、最終的に20%以下の高度な事象だけがL3へ回るという考え方です。そのうえで、この比率を意識して人員と権限を配分すると、対応コストと品質のバランスが取りやすくなります。
各レベルの役割と作業範囲
L1はアラートの検知とトリアージ、プレイブックに基づく定型作業を担います。パスワードリセット、サービス再起動、既知障害の一次切り分けなどが典型です。
ここで大切なのは、L1が判断に迷わないよう、プレイブック(手順書)を整備しておくことです。手順書がなければ、L1は単なる取次窓口になり、すべてがL2へ流れて階層化の意味が失われます。
L2はL1で解決できなかった事象を引き取り、詳細なログ分析や一時復旧、監視ルールのチューニングを担って、原因を絞り込み暫定対応を打つ層です。L3は、アーキテクチャ変更やデバッグ、根本原因の解決といった上流を扱います。L3まで上がる事象は数こそ少ないものの、放置すれば再発し続けるため、恒久対策の踏み込み方がシステム全体の安定性を左右します。
RACIによる責任分界点の明文化
階層を分けても、実際の障害時には「これは誰が決めるのか」で手が止まることがあります。そこで有効なのが、RACIマトリクスです。RACIは、実行責任(Responsible)・説明責任(Accountable)・相談先(Consulted)・報告先(Informed)の4区分で、各タスクの意思決定権を一枚の表にまとめる方法です。
誰が手を動かし、誰が最終判断するかが明確になるため、緊急時の停滞を防げます。特にマルチベンダー環境では、このRACIが障害時の「責任の押し付け合い」を止める鍵になります。
クラウド基盤・SaaS・監視ツール・MSPが絡む障害では、「基盤の問題か、設定ミスか、アプリの不具合か」で各社が様子見をしてしまいがちです。あらかじめ、一次切り分けの実行責任者と最終説明責任者をRACIで決めておけば、原因が確定する前でも誰かが動き出せます。責任の線引きの仕方はITシステム監視対応でおすすめの開発会社/ベンダー6選と選び方でも体制比較の観点として触れています。
インシデント対応フローの組み立て方
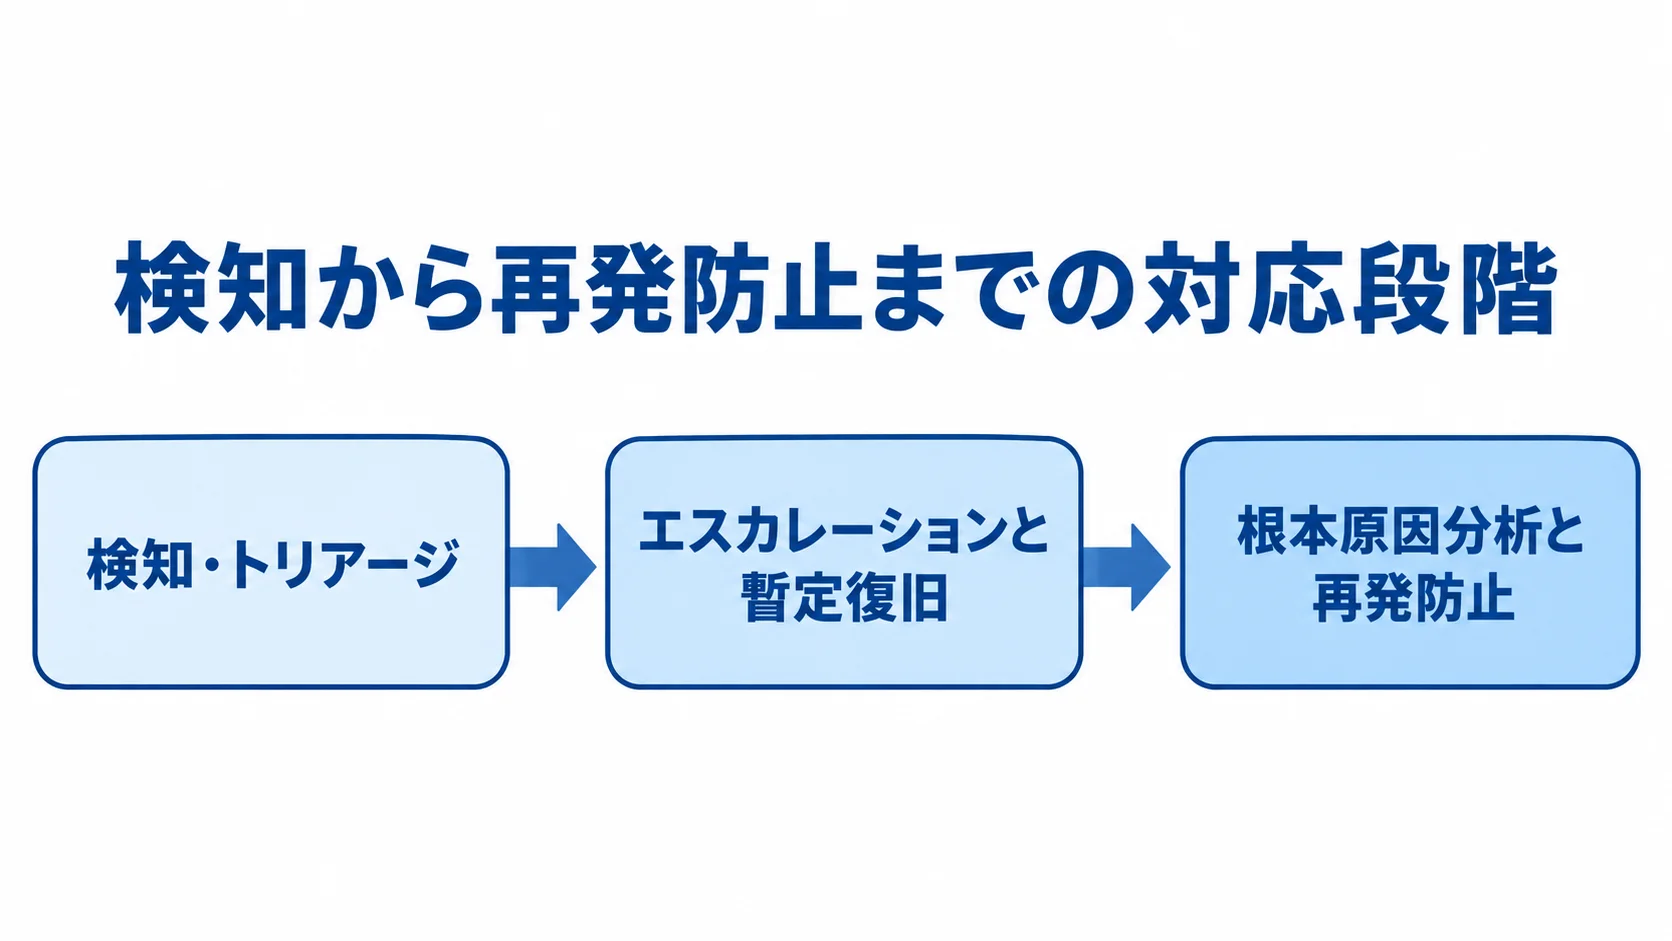
階層設計ができたら、次は実際の対応をどの順番で進めるかを決め、インシデント対応フローとして組み立てます。標準的な流れは6段階で、検知から始まり、トリアージ(重要度判定)、エスカレーションと進み、暫定復旧を経て、根本原因分析と再発防止で締めくくります。
この流れを文書にし、関係者全員が同じ手順を共有しておくと、夜間や休日でもぶれない対応につながります。フロー設計で大切なのは、各ステップに「次へ進む条件」と「時間の上限」を明記することです。
たとえば「L1で15分以内に切り分けできなければL2へエスカレーション」といった具体的なトリガーを定義しておけば、抱え込みによる復旧遅延を防げます。曖昧な「適宜エスカレーション」では、判断が遅れがちな深夜帯ほど機能しません。
重要度レベルとトリアージの基準づくり
トリアージとは、上がってきたアラートに優先順位をつける作業です。事業への影響度と緊急度の2軸で、たとえばSEV1(全面停止・即時対応)、SEV2(主要機能の障害)、SEV3(軽微な不具合)といった重要度レベルを定義します。
この基準を事前に決めておかないと、現場の感覚で対応順が変わり、本当に重大な障害が後回しになる事故が起こります。重要度の判定は、影響を受けるユーザー数やビジネス損失で機械的に決められるのが理想です。担当者の経験に頼らず、誰がトリアージしても同じ結論になる仕組みにすると、対応のばらつきを抑えられます。
トヨタ自動車では、アジャイル開発の増加で増えたクラウド環境の運用監視を外部へ委託し、開発メンバーが本来業務に集中できる体制を整えた導入事例があります。このように対応基準をそろえておけば、外部委託先とも同じ物差しで連携できます。
エスカレーションと連絡体制の整備
エスカレーションルールは、誰に、どの手段で、どのタイミングで連絡するかを定めたものです。電話、チャット、オンコールツールなど連絡経路を一本化し、担当者がつかまらない場合の代替連絡先まで決めておきます。
現場で意外に多い失敗が、連絡先が古いまま放置されていて、いざという時に誰にもつながらないことです。連絡体制では、技術的なエスカレーションだけでなく、経営層や顧客への報告ルートも忘れてはいけません。さらに、重大障害では、復旧作業と並行して「いつ、何を、誰が」対外的に説明するかが問われます。
バンダイナムコオンラインは、オンラインゲームのサーバー運用監視を委託し、24時間365日の有人監視と独自の自動監視を組み合わせてサービス停止を防いでいます。こうした安定運用の裏には、明確な連絡・報告体制の整備があります。
MTTRを短縮し再発を止める進め方
監視対応プロセスの成果は、最終的にMTTR(平均修復時間)の短縮として現れます。MTTRは障害発生から復旧までの平均時間で、これを縮めることは事業損失の最小化に直結します。そのうえで、検知から復旧までのどこに時間がかかっているかを段階ごとに計測し、ボトルネックを特定して潰していくのが、対応プロセスの継続改善です。
ただし、復旧を急ぐあまり暫定対応だけで終わらせると、同じ障害が何度も再発します。一時復旧と恒久対策を分けて管理し、根本原因分析(RCA)を必ずフローに組み込むことが、長期的にMTTRを下げる近道です。再発が減れば、対応件数そのものが減るため、現場の負担も雪だるま式に軽くなっていきます。
自動化による一次対応の負荷軽減
MTTR短縮で大きな効果を生むのが、一次対応の自動化です。検知から切り分け、チケット起票、エスカレーションまでをツールで自動化すれば、人が動き出すまでの時間を大幅に圧縮できます。
実際、アイレットのcloudpackではアラート全体の約80%を社内システムで自動処理し、人手の対応を残り20%に絞り込んでいます。また、DTSのReSMでも、アラートの80%をフィルタリングしている実績があります。
中小企業でも、ネットワーク監視ツールの導入と異常検知・原因切り分けの自動化によって、トラブル対応工数を最大約8割削減した事例があります。自動化は大企業だけのものではなく、頻発する定型対応から始めて、人は判断が要る事象に集中します。この役割分担は、限られた人員で安定運用を実現する現実的な進め方です。自動化や閾値設計の具体はITシステム監視対応の完全ガイドで全体像とあわせて確認できます。
アラート疲労を防ぐ閾値チューニング
MTTRを下げるうえで見落とされがちなのが、アラートそのものの質です。監視対象が多すぎたり、しきい値が不適切だったりすると、大量の通知に埋もれ、重大障害に気づけなくなる「アラート疲労」が起こります。オオカミ少年化したアラートは、それ自体が対応プロセスのボトルネックになります。
現場でよく使われるコツは、デフォルト設定をそのまま使わないことです。たとえば、CPU使用率80%で即通知という設定では、一瞬のスパイクでも鳴り続けます。一方で、「5分間継続したら通知する」と継続時間を条件に加えるだけで、無視してよいノイズが激減します。
再発防止のフローを徹底し、二次運用チームが恒久改善を積み重ねた現場では、目標99.9%を上回るアラート正常対応率99.99%を達成し、対応時間を累計1万時間以上削減した例もあります。閾値チューニングは、まさに対応プロセスの土台を整える作業です。
SLAとKPIによる監視対応の品質運用
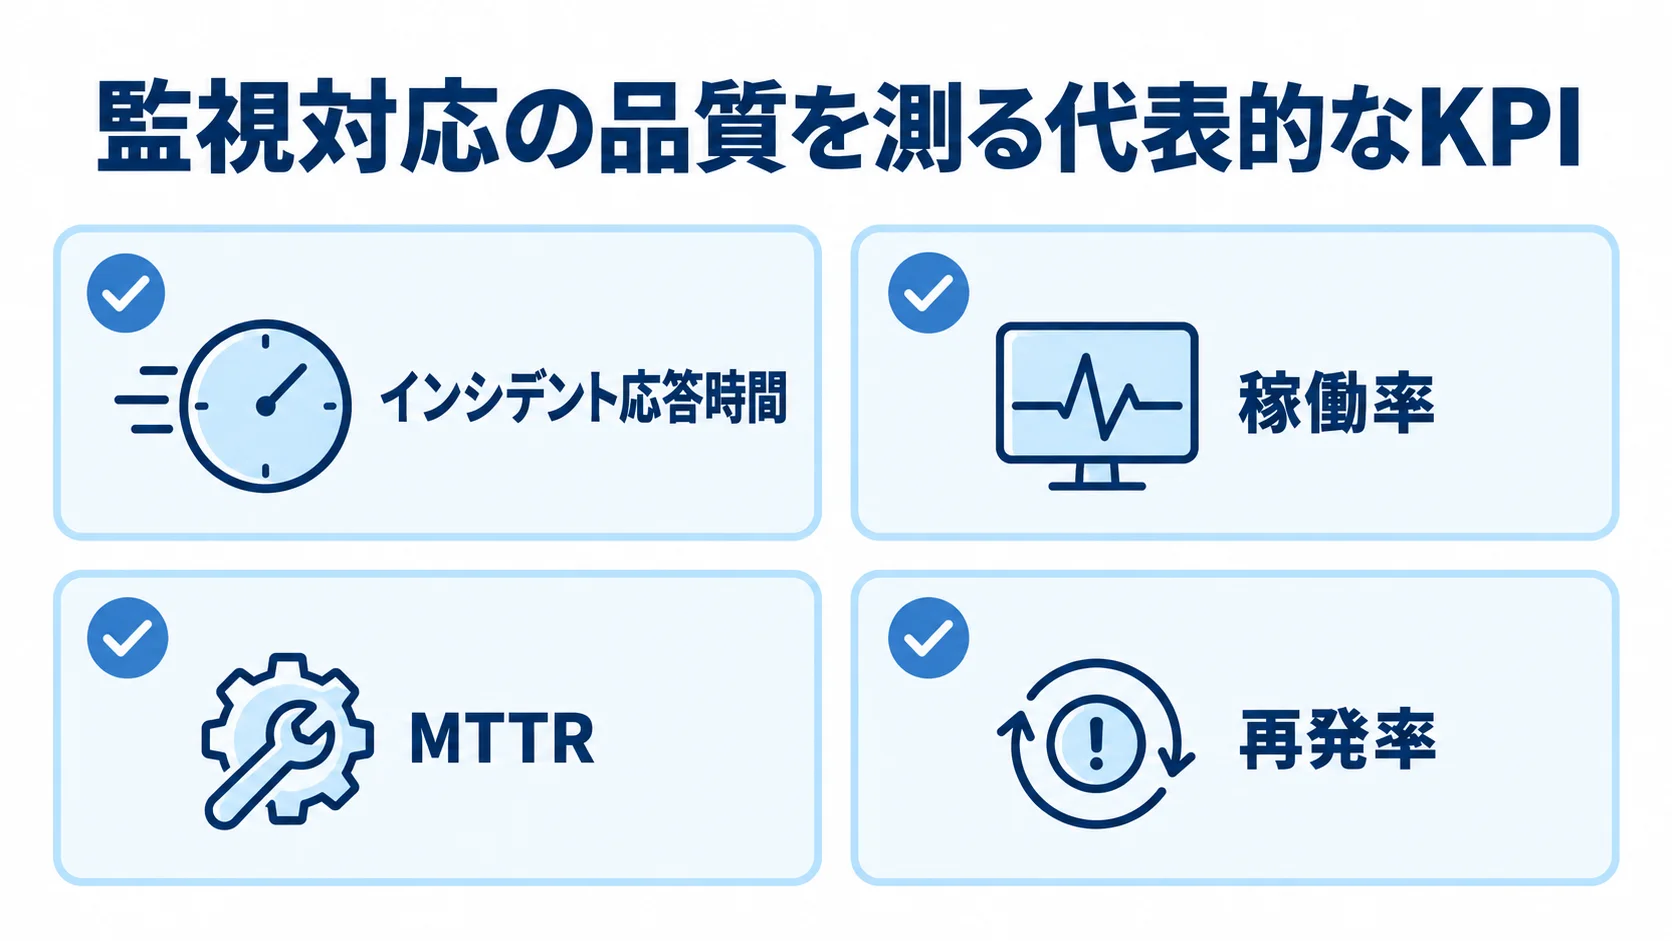
品質を安定させるには、対応プロセスを作ったあとも、SLA(サービスレベル合意)とKPIで対応の質を数値として運用し続ける必要があります。SLAはインシデント応答時間や稼働率といった約束事を、KPIはその達成度を測る指標を指します。
これらを設定すると、感覚ではなくデータに基づいて改善を回せるようになります。自社運用でもKPIを置く価値はありますが、特にMSPへ委託する場合は、SLAが契約の品質を担保する生命線になります。
応答時間や稼働率の基準が曖昧なまま契約すると、障害が起きても「契約上は問題ない」とされてしまいます。だからこそ、委託の前提となるSLA設計まで含めて、対応プロセスとして捉えることが重要です。
応答時間・稼働率など測るべき指標
監視対応で設定すべき代表的なKPIには、インシデント応答時間(例: 重大障害は30分以内に一次応答)と稼働率(例: 99.9%以上)、MTTR、再発率などがあります。これらを定点観測すると、対応プロセスのどこが弱いかが見えてきます。
たとえば、応答は速いが復旧が遅いならL2/L3の体制に課題があり、再発率が高いなら根本原因分析が不十分だと判断できます。指標は、現場が追える数に絞り、ビジネスインパクトと結びつくものを優先します。
稼働率99.9%と99.99%では、年間の許容停止時間が約8.8時間から約53分へと大きく変わります。どの水準を目指すかは、システムの重要度とコストのバランスで決めるべきです。ただし、目標を高くしすぎると、対応コストを跳ね上げるだけで終わります。
レビュー会によるPDCAの運用
KPIを設定したら、定期的なレポートとレビュー会でPDCAサイクルを回します。月次でインシデント傾向を振り返り、頻発する事象には恒久対策を打ち、しきい値やプレイブックを更新していきます。このレビューを続けることで、対応プロセスは生きた仕組みとして進化し続けます。
一方で、作りっぱなしのフローは、システムの変化に取り残されてすぐ形骸化します。また、レビュー会は、社内とMSPが同じデータを見て議論する場としても機能します。SLAの達成状況を共有し、未達があればその原因と改善策を一緒に検討します。
この透明性が、委託先のブラックボックス化とベンダーロックインのリスクを下げます。対応プロセスの設計から運用、改善まで一気通貫で支援できるパートナーなら、PDCAの定着まで伴走してもらえます。費用面の目安はITシステム監視対応の見積相場や費用/コスト/値段についてで確認してください。
まとめ
ITシステム監視対応の進め方は、ツール導入ではなく対応プロセスの設計から始まります。まず監視対応の全体像と内製・委託の方針を決め、次にL1/L2/L3の階層を組み、RACIでどこまでを誰が受け持つかを明確にします。
続いて、検知から再発防止までのインシデント対応フローを組み立て、自動化と閾値チューニングでMTTRを短縮します。最後に、SLAとKPIで品質を数値で管理し、レビュー会でPDCAを回し続けることが、安定運用への王道です。
これらの手順を一つずつ整えていけば、属人化や夜間対応の疲弊から抜け出し、限られた人員でも止まらない運用体制を築けます。自社だけで設計が難しい場合は、対応プロセスの整備から運用定着まで伴走できるパートナーへの相談も有効です。会社選び、費用相場、発注方法といった個別テーマは関連記事で詳しく解説しているため、自社の状況に合わせて読み進めてみてください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。