
委託先は、リソースだけでなくレスポンスとアプリ内部まで見て、障害前の改善につながるかで選びます。CPU・メモリ・ディスクの異常と、ユーザーが感じる遅延は別々に起きるためです。
リソース監視・APM・キャパシティプランニングに対応する6社を、しきい値設計やROI、ロックイン回避、自社運用と監視代行(MSP)の分担から比べます。
- リソースの余力:CPU・メモリ・ディスクに余裕があるかを確認する
- 原因の追跡力:APMやログで、レスポンス劣化の原因まで追えるかを見て選ぶ
- 中長期の見通し:増強と内製化まで見据えて、費用と役割を決める
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム性能監視のパートナー選びが重要な理由
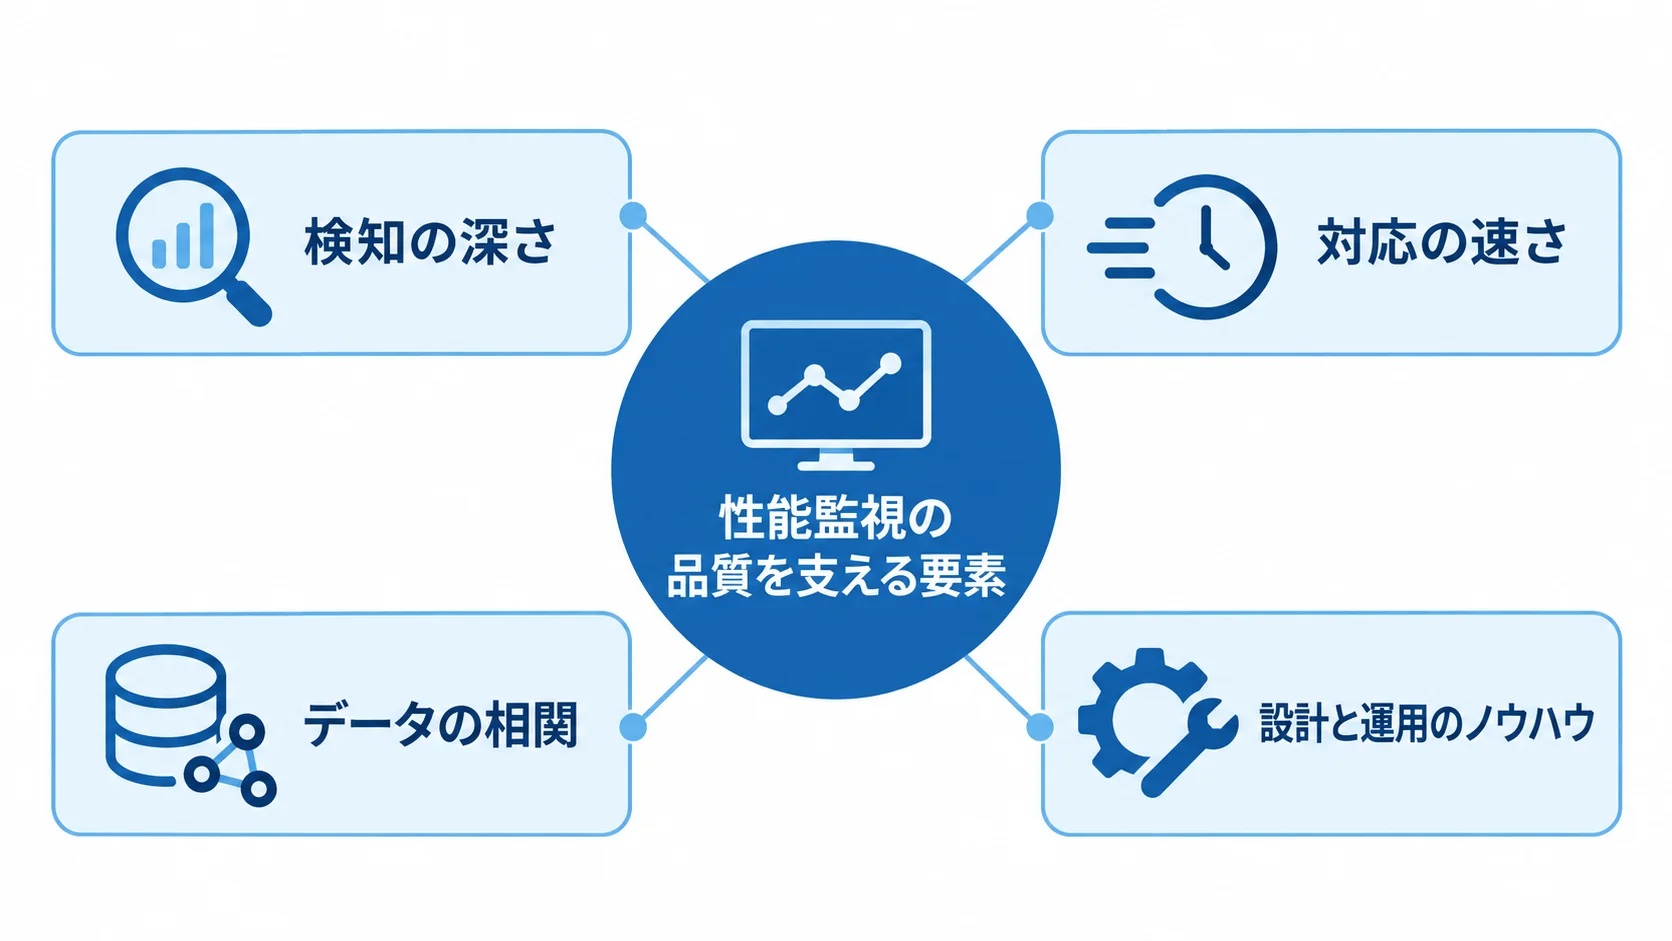
性能監視は、ツールを導入するだけでは成果につながりません。警告の基準と、アプリケーション層まで原因をたどる方法を、あらかじめ設計しておく必要があります。
さらに、得られたデータをキャパシティ増強の判断へつなぐことも求められます。監視の品質は、設計と運用のノウハウに左右されます。
とくに性能監視では、表面的なリソース監視だけで満足してしまい、「CPU使用率は正常なのにユーザー体感は遅い」という落とし穴に陥りがちです。そのため、APM(アプリケーションパフォーマンス監視)まで踏み込める体制を持つパートナーかどうかが、実務上の分かれ目になります。
適切なパートナー選定が成否を分ける理由
パートナーを見極めるには、検知から対応までの流れを分けて確かめます。
- 検知の深さと初動の速さ:両立できるかを確認する
- データの相関:APM・ログ・メトリクス・トレースの関係を整理する
性能監視の効果は、検知できる「深さ」と対応の「速さ」で決まります。ある中規模のSaaS企業では、APM・ログ・メトリクス・トレースを統合した結果、障害の原因特定にかかる時間が従来の3分の1に短縮されました。
この成果は、ツールを入れただけでは生まれず、どのデータをどう相関させて見るかを設計できるパートナーが伴走したからこそ得られたものです。反対に、高機能なSaaSを導入しても、ダッシュボードを誰も見ない失敗が起きることがあります。また、MSPに丸投げしたことで、自社システムを理解する社員がいなくなる例もあります。
パートナー選びは、ツール選定だけで終わらず、自社にノウハウを残しながら運用負荷を下げる体制づくりまで含めた判断です。
発注前に確認すべきポイント
発注前に対象範囲と運用分担を具体化しておくと、各社を比べやすくなります。
- 対象環境:APM・トレースの対応範囲まで確認する
- 運用条件:しきい値、SLA、移行時の標準規格対応を確認する
まず、対応できる監視対象の範囲を確かめます。オンプレ・クラウド・マルチクラウドのどこまでを対象にできるかを、発注前に決めておきます。
加えて、APMやトレース、しきい値設計、アラートチューニングの対応範囲も見ておきます。あわせて、SLA(サービス品質保証)をどこまで明文化できるかも確かめます。
レスポンス監視では、外形監視にとどまるのか、アプリ内部のボトルネックまで追えるのかで、提供価値が大きく変わります。
将来の内製化や他ツールへの移行を考えるなら、OpenTelemetryのような標準規格に対応しているかも確かめておきたい点です。
SaaS型ツールに深く作り込むほど、移行コスト(スイッチングコスト)は膨らみます。だからこそ、ロックインを避ける設計を提案できるかどうかも、長期的なコストを左右します。
株式会社ripla|コンサルから開発まで一気通貫で支援
riplaは、コンサルティングから開発まで一気通貫で支援できる企業です。IT事業会社として社内DXを推進してきた経験を活かし、ビジネスの成果につなげることと、システムを定着させる支援に強みを持っています。
営業・顧客・生産・販売管理など、幅広い基幹システムの構築・導入実績があります。さらに、企業の業務要件に合わせて柔軟に対応できる体制を整えています。
特徴と強み
riplaの強みは、監視を業務成果へつなぐ設計にあります。
- 監視要件の組み込み:システムの構築段階から、監視要件を取り込める
- 経営指標への接続:技術指標を事業成果とROIに結び付ける
riplaの最大の特徴は、性能監視を単なる「ツール導入」ではなく、「ビジネス成果につながる運用設計」として捉える点にあります。
事業への影響を早期に把握する指標も、あわせて設計できます。
また、自社でDXを推進してきた事業会社としての視点も持ち合わせています。そのため、レスポンス劣化がユーザー離脱や売上機会の損失にどう直結するかを整理できます。
技術指標を経営判断につなげるうえで、これは大きな強みです。ダウンタイムや遅延による機会損失の観点から、性能監視の投資対効果(ROI)を定量的に示す支援も得意としています。
得意領域・実績
構築後の安定稼働と改善まで含めて、支援範囲を確認できます。
- 安定稼働と継続改善:基幹・業務システムを、稼働後も改善し続ける
- ハイブリッド運用:一部を委託し、内製化への移行も含めて設計する
riplaは、基幹システムや業務システムを数多く構築・導入してきました。
性能監視でも、構築したシステムの特性を理解したうえで、ボトルネックになりやすい箇所を見極めた監視設計ができます。
一部を委託しつつ、重要な部分は自社で把握する「ハイブリッド運用」を相談できます。将来の内製化へ移る体制づくりにも対応します。
こうした運用では、SLA定義やアーキテクチャ全体を把握するスキルを社内に残せます。ITシステム性能監視の進め方も参考になります。
Datadog|APM統合で原因特定を高速化するSaaS監視
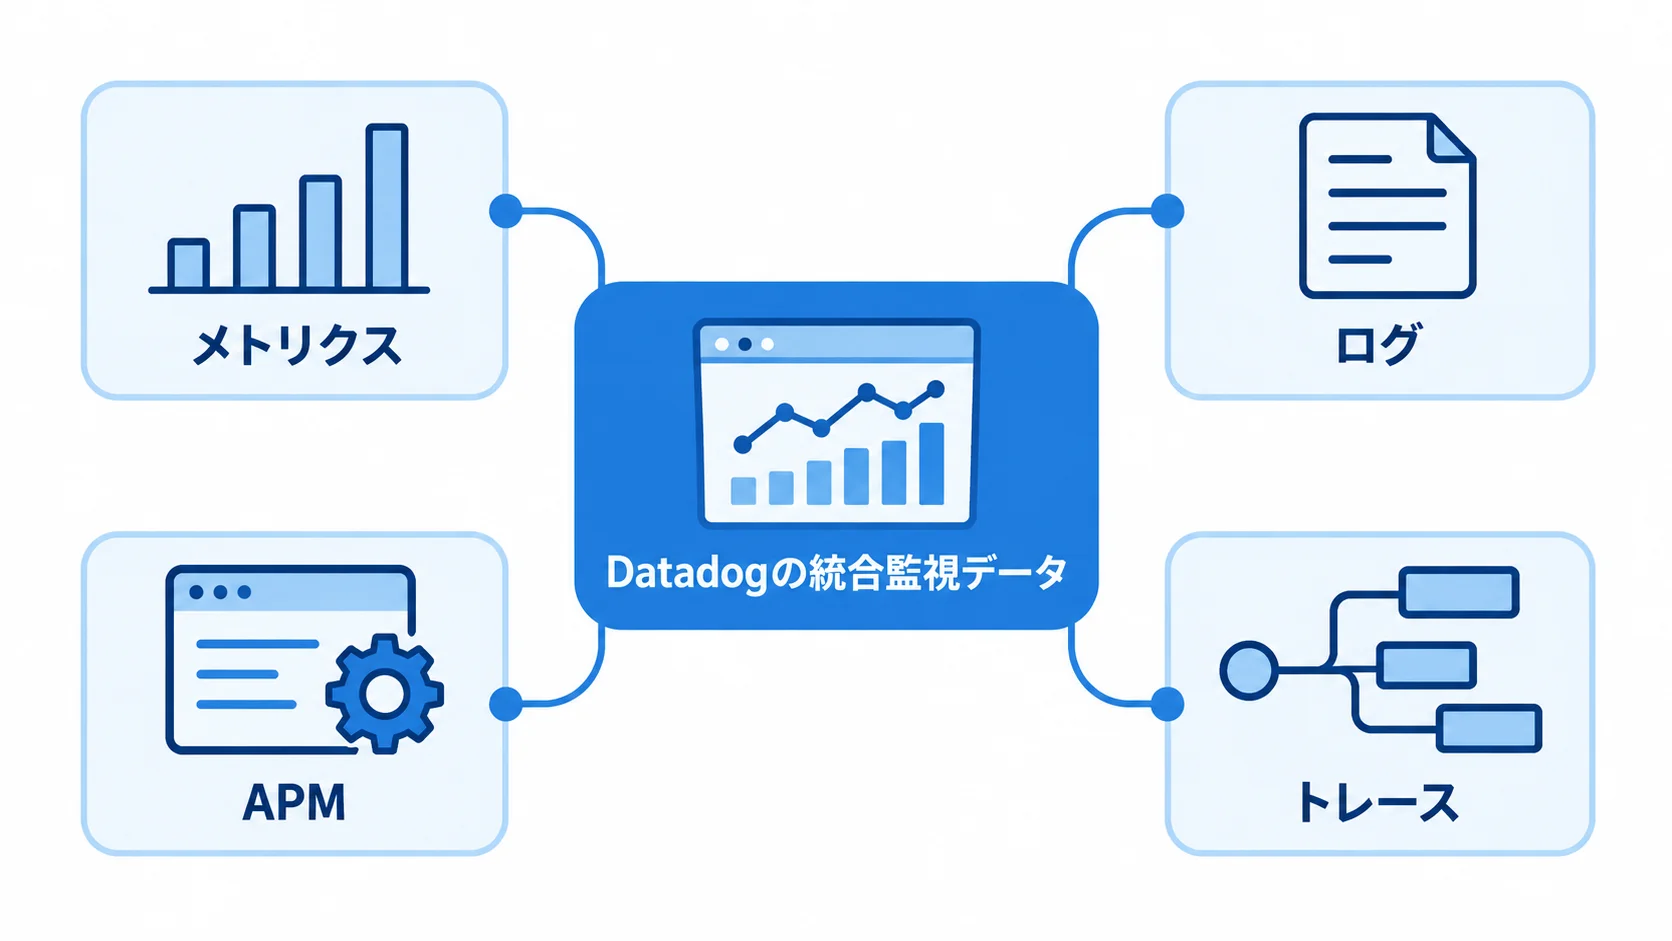
Datadogは、メトリクス・ログ・APM・トレースを一つのプラットフォームで統合して可視化できる、SaaS型の監視サービスです。
クラウドネイティブな環境やマイクロサービス構成と相性がよく、レスポンス劣化の原因を、アプリケーション内部の処理単位まで追える点が高く評価されています。ITreviewでも満足度は4.1で、安定した評価を得ています。
特徴と強み
Datadogは、複数の観測データを一つの画面で扱える点が特徴です。
- 複数クラウド:指標を横断して確認する
- 費用との両立:ログ取込量とトレース数を、費用と合わせて管理する
最大の強みは、直感的なGUIと豊富な連携機能です。AWS・Azure・GCPをはじめとする数百種類の連携に標準で対応し、各レイヤーのメトリクスを横断して並べ、相関を見られます。
Datadogは、初心者でも障害時にどこを見ればよいかが分かりやすく、運用負荷の軽減につながります。
料金はホスト課金が基本で、月額15ドル前後(およそ月額1,650円〜)から始められます。機能の豊富さを考えれば、妥当な水準です。
一方で、取り込むデータが増えると費用が膨らみやすくなります。そのため、何を有料で取り込むかの取捨選択が、運用コスト管理のカギになります。
得意領域・実績
適した規模と予算を先に確認すると、導入後の見通しを持てます。
- 適した環境:クラウド中心の中〜大規模環境
- 費用と性能のバランス:月額予算と性能の深掘りを、同時に検討する
特に、複数サービスが絡み合う構成で真価を発揮します。
前述の中規模SaaS企業の事例のように、APM・ログ・メトリクス・トレースを統合して可視化することで、障害の原因特定時間を3分の1に短縮した実績があります。
月額20万円以上の監視予算を確保できる企業に向いた選択肢です。
Mackerel|国産・導入のしやすさが魅力のSaaS監視
Mackerelは、はてなが開発・提供する国産のSaaS型サーバー監視サービスです。
エージェントを入れるだけで主要なリソースメトリクスの監視を始められる手軽さと、日本語サポートの安心感から、国内の企業で広く使われています。
ITreviewでは機能満足度4.4と、本記事で取り上げる中でも高い評価を得ています。
特徴と強み
Mackerelは、基本監視を早く始めて、設定を保守しやすいサービスです。
- 導入の手軽さ:エージェントで基本メトリクスを始めやすい
- 料金と設定:台数に応じた月額と、設定の分かりやすさを確認する
強みは、導入のしやすさと運用の分かりやすさです。
CPU・メモリ・ディスクといった基本的なリソース監視をすぐに始められ、ロール(役割)単位でサーバーをまとめて管理できるため、台数が増えても見通しが効きます。
スタンダードプランは月額2,180円/台です。台数に応じて費用が決まるため、コストの見通しが立てやすい料金体系です。
監視設定や閾値の調整がシンプルで、過検知を抑えやすい点も評価されています。性能監視で陥りがちな「アラート疲れ」を避けるうえで、シンプルな設計を保ちやすい点は実務上の安心材料です。
得意領域・実績
対象サービスの規模と担当者の運用体制を照らし合わせます。
- 適した規模:小規模〜中規模のWebサービスに向く
- 日本語での運用:日本語資料を使い、運用を定着させやすい
中小〜中規模のWebサービスやクラウドサーバーの性能監視に向いています。
海外製の高機能ツールほどの深掘りは要らないものの、リソースの推移を継続して把握し、キャパシティ増強の判断材料にしたいというニーズに、ちょうど合います。
日本語のドキュメントとサポートが充実しているため、社内に専任の監視担当を置きにくい組織でも運用しやすい点が支持されています。
Zabbix Japan|OSSベースで柔軟に作り込める監視基盤
Zabbixは、ライセンス費用ゼロで使えるオープンソースの統合監視ソフトウェアです。Zabbix Japanが、技術サポートやトレーニング、構築支援を提供しています。
リソース監視からネットワーク監視まで幅広くカバーでき、初期コストを抑えながら自社の要件に合わせて作り込める点が特徴です。ITreviewの満足度は4.1です。
特徴と強み
Zabbixは、細かな条件設定と構築の自由度を重視する場合に向きます。
- 条件の定義:ライセンス費用なしで、条件を細かく定義できる
- 外部支援の併用:公式支援やSIerを組み合わせ、運用品質を補う
強みは、ライセンス費用が不要なことと、カスタマイズの自由度の高さです。
トリガー(しきい値)やテンプレートを細かく定義でき、Load Averageやディスク使用量に応じた多段階のアラート設計を、自社の運用方針どおりに作り込めます。
オンプレミス環境を多く抱える企業や、データを外部SaaSに送りたくないセキュリティ要件にも適しています。
一方で、構築や運用には相応の技術力が求められます。そのため、Zabbix Japanのような公式サポートや、構築に長けたSIerの支援を組み合わせることで、OSSのコストメリットを活かしつつ運用の安定性を確保できます。
得意領域・実績
初期費用だけでなく、運用技術を確保できるかを見ます。
- 初期コストの抑制:月額5万円未満の監視予算に合わせやすい
- 自社運用の土台:オンプレ環境と将来の内製化を支える
社内に監視を運用できる技術者がいる、あるいは将来的に内製化を進めたい組織であれば、Zabbixを基盤に据えることでベンダーロックインを避ける道を残せます。
多数のサーバーを抱える大規模オンプレ環境での導入実績も豊富です。
Amazon CloudWatch|AWS環境に最適化された性能監視
Amazon CloudWatchは、AWSが提供する標準の監視サービスです。EC2やRDS、Lambdaのメトリクスを、追加導入なしで収集できます。
AWS上にシステムを構築している企業であれば、最も自然に性能監視を始められる選択肢のひとつです。従量課金制で、ログ取込はおよそ0.76ドル/GBが目安となります。
特徴と強み
CloudWatchは、AWSの標準機能を使って監視を組み立てます。
- AWSとの統合:各サービスと標準で連携できる
- アラームの活用:アラームから、自動対応まで接続しやすい
強みは、AWSサービスとの密な統合です。各リソースのメトリクスが自動で収集され、しきい値を超えるとアラームが発報されます。さらに、Auto Scalingやサーバーレスのアクションと連動させて、自動対応まで組めます。
AWSをすでに利用している企業にとっては、新たなツール契約を増やさずに性能監視を始められる手軽さが魅力です。
従量課金のため、小規模なうちは費用を抑えつつ、規模に応じて柔軟に広げられます。月額5万〜20万円の予算帯なら、AWS中心に運用している企業にちょうど収まりやすい料金感です。
得意領域・実績
利用範囲がAWSのみか、他環境を統合する必要があるかを確認します。
- AWS中心の環境:リソース推移を把握する
- マルチクラウド:追加の統合設計を確認する
AWSのみ、あるいはAWS中心のクラウド環境で性能監視を行いたい企業に最適です。一方で、マルチクラウドやオンプレを含む統合監視には、別ツールとの組み合わせが必要になる場合があります。さらに、キャパシティプランニングの基礎データとして活用したいケースでも力を発揮します。
ManageEngine OpManager|オンプレ・インフラ統合監視に強みを持つツール
OpManagerは、ゾーホー(ManageEngine)が提供する統合インフラ監視ツールです。
サーバーのリソース監視に加え、ネットワーク機器やストレージまでを一元的に監視できる点が特徴です。オンプレミスの設備を多く抱える企業に向いています。
視覚的なダッシュボードとパッケージ型の分かりやすい料金体系が支持されています。
特徴と強み
OpManagerは、機器をまたいだインフラ把握を重視する構成です。
- 機器をまたぐ把握:サーバーとネットワークを、一画面で俯瞰する
- 長期費用の比較:永続ライセンスを含めて比べる
インフラ全体の性能監視を1つのツールで完結できる点が大きな強みです。リソースの使用率やレスポンスをマップ上で俯瞰でき、どの機器がボトルネックになっているかを直感的に把握できます。長期運用でのコスト予測が立てやすい点も利点です。
SaaS型ほどクラウド連携は広くありませんが、オンプレやハイブリッド環境の物理・仮想インフラを丁寧に監視したいニーズに応えます。
導入支援やトレーニングのメニューもあり、運用立ち上げのサポートを受けやすい点も安心材料です。
得意領域・実績
保有設備の範囲とクラウド移行の段階を基準に検討します。
- 自社保有の設備:データセンターや社内インフラを、まとめて監視する
- 物理・仮想機器:ハイブリッド環境も含めて見渡す
物理機器の死活・性能・トラフィックを一画面で見渡せるため、インフラ規模が大きい組織ほどメリットを感じやすい製品です。クラウド移行の過渡期にあるハイブリッド環境でも活用できます。
ITシステム性能監視のパートナー選びのポイント
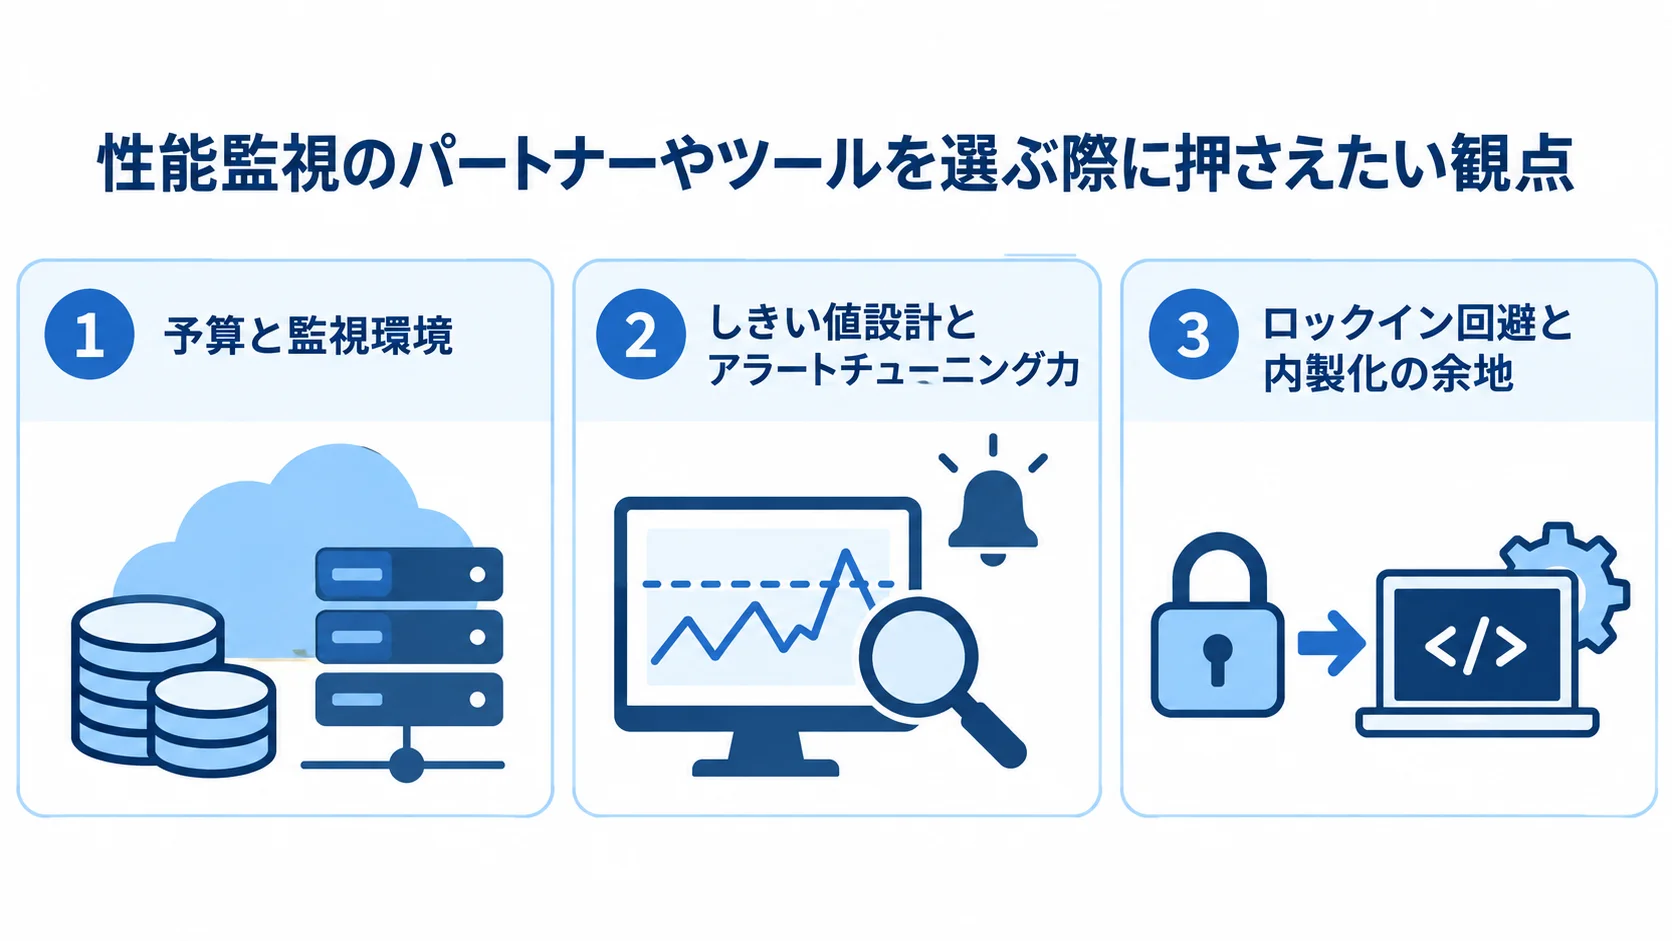
6社を紹介してきましたが、最終的にどこを選ぶかは、自社の監視環境・予算・技術レベルによって変わります。性能監視のパートナーやツールを選ぶ際に押さえたい観点は、3つあります。
予算と監視環境による絞り込み
費用は、ツールの料金と人の役割を分けて、環境条件と合わせて比べます。
- 予算帯とクラウド範囲:この2つで候補を分ける
- MSPと自社の分担:一次対応費用と自社の役割を分けて見積もる
まずは予算と監視環境を起点に候補を絞ります。目安として、月額5万円未満なら初期コストゼロのZabbixが候補です。月額5万〜20万円ならCloudWatchやMackerelを検討します。月額20万円以上でAPMまで深掘りしたい場合はDatadogが候補です。
環境で見ると、AWSのみならCloudWatch、オンプレ中心ならZabbixやOpManager、マルチクラウドならDatadogが候補になります。
ツールの導入と運用を自社で行うか、監視代行(MSP)に委託するかも検討します。24時間365日の一次対応は、1台あたり月額10,000〜30,000円が相場です。
Apache等の自動復旧監視は、月額3,000円程度がオプションの目安です。詳しくはITシステム性能監視の費用相場も確認します。
しきい値設計とアラートチューニング力の確認
通知条件は段階化し、対応すべき異常を見分けられるようにします。
- 通知の段階:警告・軽度・重度を、用途に合わせて定める
- 通知の絞り込み:通知数を抑えつつ、重要な異常を見落とさない
性能監視で差が出るのは、ツールそのものよりも「どの値で何を鳴らすか」というしきい値設計です。
たとえば、1CPUあたりのLoad Averageは、4以上を警告、8以上を軽度障害、12以上を重度障害とする例があります。ディスクやInodeは80%超、90%超、95%超で段階化します。
メールキューの場合は、500件超、1,000件超、2,000件超が区切りの例です。現場の特性に合わせて、多段階の条件を調整します。
段階化の目安を、自社の特性に合わせて調整できるパートナーかどうかを見極めます。
過剰な通知は「アラート疲れ」を招きます。条件分岐の設定ミスで重要なエラーが通知されず、発見が3時間遅れた事例もあります。
ツールの選定以上に、アラート設計をシンプルに保てるかが運用品質を左右します。ITシステム性能監視の進め方も参考にします。
ロックイン回避と内製化の余地の確認
移行可能性と社内に残す知識を、契約前から決めておきます。
- 標準規格への対応:OpenTelemetryなどで、移行可能性を残す
- 社内の知識:SLAと全体設計の知識を、社内にも保持する
SaaS型ツールに深く作り込むほど、後から別ツールへ移行する際のスイッチングコストが膨らみます。
特定ベンダーに縛られすぎない構成が有効です。将来の選択肢を残すには、メトリクスやトレースの収集方式を、ツールに依存しない共通の形にしておきます。
ツールを切り替えても、監視の仕組みごと作り直す必要が減ります。
監視代行に委託する場合も、丸投げで自社にノウハウが残らない「ブラックボックス化」は避けます。
一部を外注しつつ要所は自社で握る「ハイブリッド運用」にします。必要に応じて内製化へ移れる体制であれば、長期的なリスクを抑えられます。発注・外注方法も参考にします。
まとめ
ITシステム性能監視は、リソースの使用状況に加えて、レスポンスタイムも見ます。アプリ内部のボトルネックを捉えることで、ユーザー体験と事業成果を守ります。
株式会社riplaを筆頭に、6つの選択肢を紹介しました。あわせて、Datadog・Mackerel・Zabbix・CloudWatch・OpManagerの強みと適した環境も整理しました。
選定では、まず予算と監視環境で候補を絞ります。そのうえで、しきい値設計とアラートチューニングの実力を見極め、ロックインを避けて内製化の余地を残します。
自社にノウハウを残しながら運用負荷を下げられるパートナーが、長期的な成功につながります。費用は費用相場、全体像は完全ガイドも確認してください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。