
ITシステム性能監視は、監視対象の洗い出しから始め、ツールの導入、ダッシュボードの構築、しきい値とアラートの設計へと段階的に進めるのが基本です。
性能監視は、CPUやメモリ、ディスク、レスポンスタイムを継続的に見て、障害の予兆を捉える取り組みです。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
ITシステム性能監視の全体像と他の監視との違い
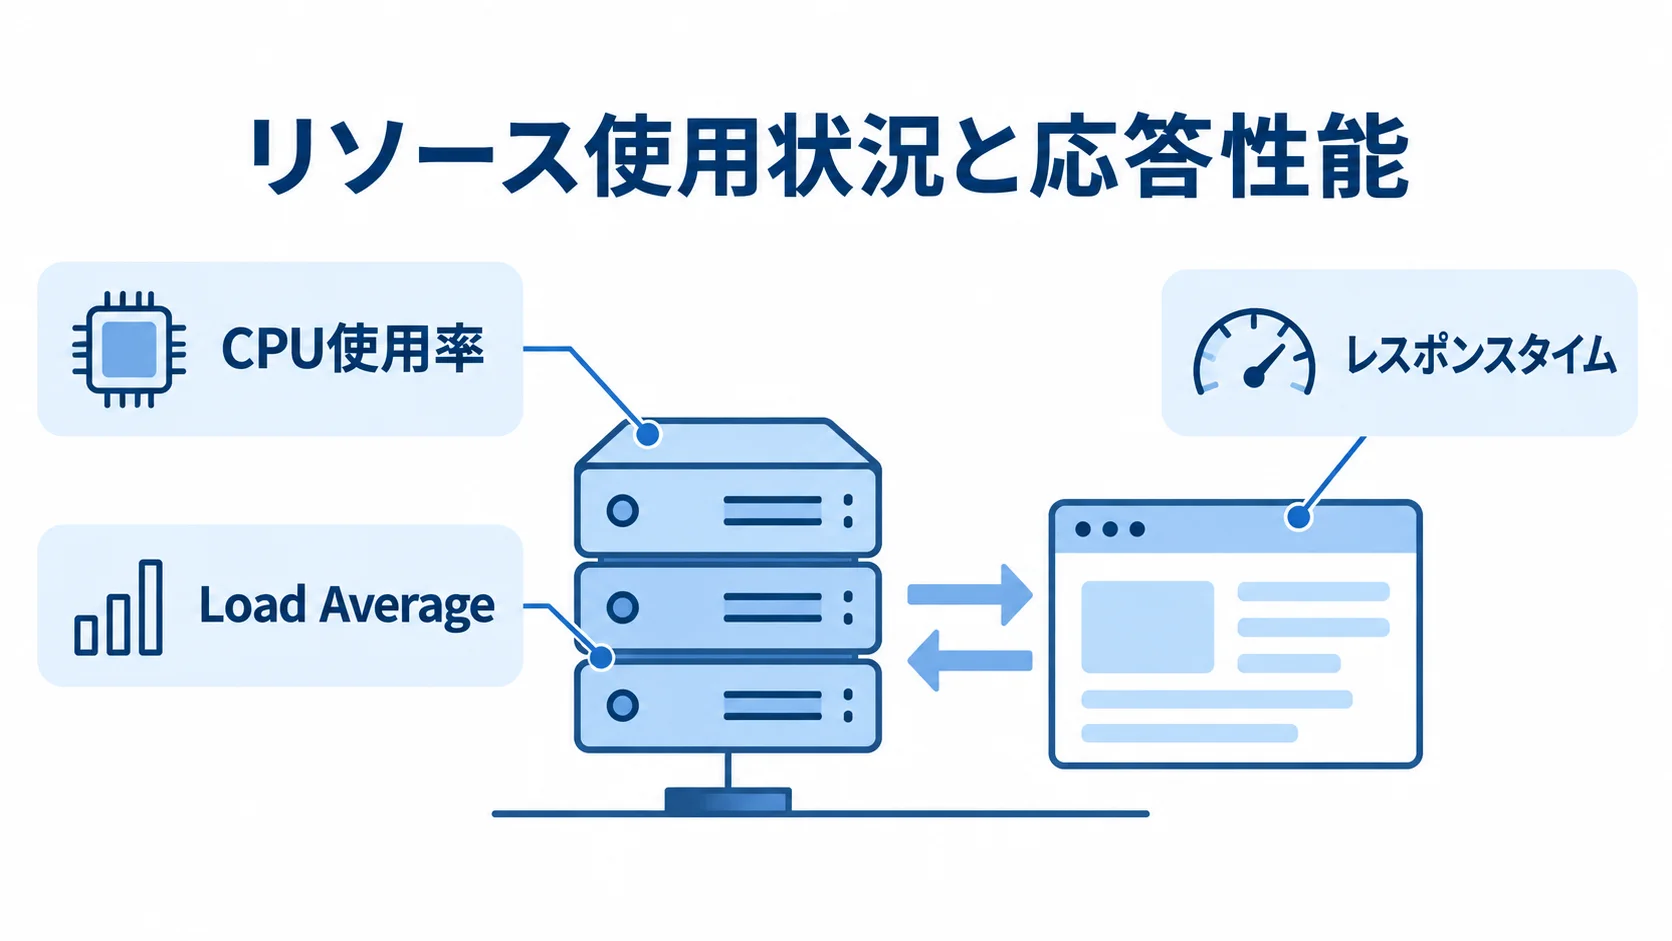
システム監視は一般に、死活監視・性能監視・ログ監視の3種類に分けられます。このうち性能監視は、システムが完全に停止する前の段階で、劣化の予兆を捉える役割を担います。
まず、死活監視やログ監視と並べると、性能監視が何を見る監視なのかがはっきりします。
性能監視が見るのはリソースとレスポンス
性能監視が主に見るのは、サーバーのリソース使用状況と、アプリケーションの応答性能です。
具体的には、CPU使用率、Load Average、メモリの空き容量、ディスク使用量とI/Oを計測します。
ネットワーク帯域やレスポンスタイム、スループットについても、継続して確認します。
たとえば、CPU使用率が一時的に90%に達してもすぐに下がるなら、問題ない場合があります。一方で、90%が10分以上続くなら、処理が詰まり始めている可能性が高くなります。
- 性能監視の本質:リソースを連続した時系列データとして観察する点にあります。
- 判断の軸:「どれだけの値が、どれだけの時間続いているか」を捉えると、停止に至る前に手を打てるようになります。
死活監視・ログ監視との役割分担
死活監視は、Pingやポート監視によって「サーバーやサービスが応答しているか」をシンプルに判定します。
止まった瞬間を即座に検知するのには優れていますが、止まる前の劣化の兆しは捉えられません。
性能監視は、止まる前のリソースの逼迫を数値で示すため、死活監視より早い段階で対応できます。
両者は競合せず、補完し合う関係です。
ログ監視は、記録に残ったエラーメッセージや特定のイベントを検出する監視です。性能監視がメトリクス(数値)を扱うのに対し、ログ監視はテキストとして残る出来事を扱います。
実際の運用では、性能監視でCPUの異常上昇を捉え、ログ監視でその時刻に出ていたエラーを突き合わせます。この連携によって、原因の特定が速まります。
- 3種類の役割:性能監視が「予兆を数値で捉える」中核を担い、死活監視とログ監視がその前後を支える構図です。
- 監視設計の土台:この役割分担を押さえることが、過不足のない監視設計の出発点になります。
ITシステム性能監視の進め方と工程
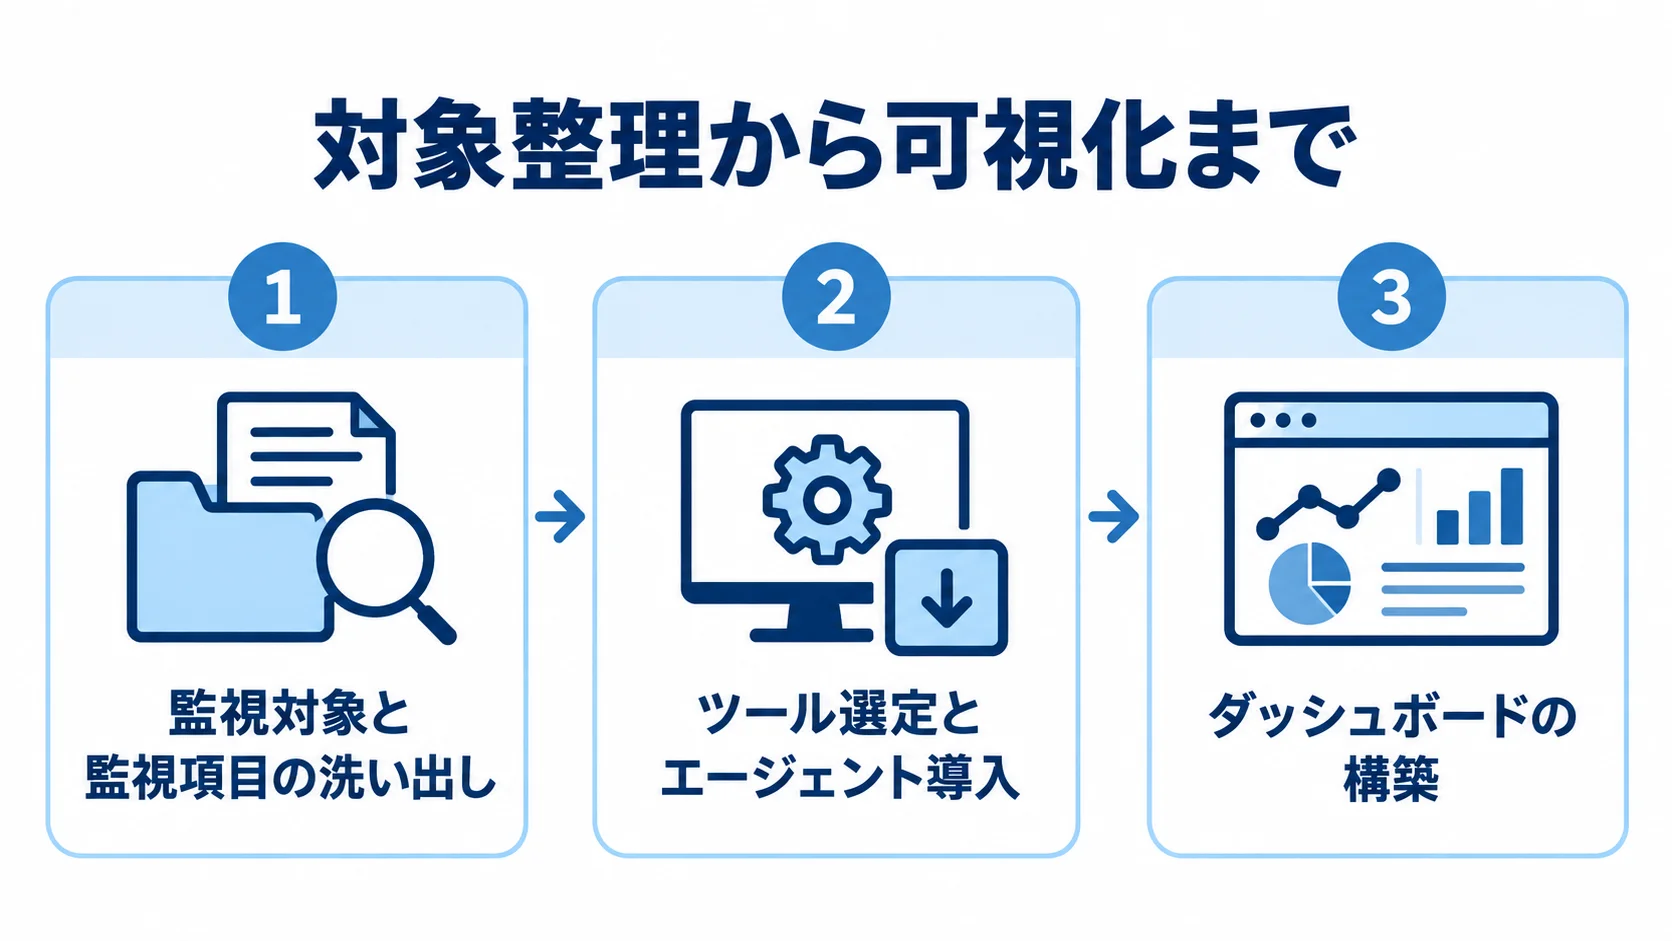
性能監視は、対象の整理から段階的に進めるのが定石です。工程は、監視対象と監視項目の洗い出し、ツールの選定とエージェント導入、ダッシュボードの構築の3つです。
各工程で何を決めるかを押さえておくと、後戻りの少ない監視基盤を作れます。
工程1: 監視対象と監視項目の洗い出し
最初の工程では、何を監視するかを決めます。まず、発注側が現場の担当者と一緒に、Webサーバー、アプリケーションサーバー、データベースサーバーを洗い出します。
あわせて、それらが載るインフラ(オンプレミスかクラウドか)を確認し、重要度を評価します。
監視の密度には優先順位をつけます。特に、停止するとビジネスに直結するサーバーほど、監視項目を厚くします。
監視項目は、リソース系とレスポンス系に分けると整理が進みます。リソース系は、CPU・メモリ・ディスク・ネットワークなどのサーバー資源です。
レスポンス系は、Webページの応答時間、APIの処理時間、データベースのクエリ応答時間を指します。
- 必要な項目の取りこぼし:最初から項目を絞りすぎると、障害時に必要なメトリクスが取れていなかった、という事態を招きます。
- この段階の方針:監視したい項目は広めに挙げ、後のしきい値設計で通知を出す対象を絞り込みます。
工程2: ツール選定とエージェント導入
監視項目が固まったら、それを計測するツールを選びます。
代表的なツールには、Zabbix、Datadog、Amazon CloudWatch、Mackerelなどがあります。
ツールを選ぶ軸は、予算、監視環境(オンプレかクラウドか)、運用チームの技術レベルの3つが中心です。
予算の目安としては、月額5万円未満ならZabbix(初期コストゼロ)が候補になります。また、月額5万〜20万円なら従量課金のCloudWatch、月額20万円以上で高度な表示機能を求めるなら、ホスト課金のDatadogを検討します。
ツールを決めたら、監視対象のサーバーにエージェントを導入します。多くの性能監視ツールはエージェント型で、サーバー上で動くプログラムが、リソース情報を定期的に集めて監視サーバーへ送ります。
エージェントの導入時は、収集間隔(1分ごとか5分ごとか)と、エージェント自身がリソースを過度に使っていないかを確認します。導入直後はしきい値を設定せず、正常時のリソースがどの程度で推移するかを1〜2週間かけて観測します。この観測があると、後のしきい値設計の精度が上がります。
具体的な選定で迷う場合は、ITシステム性能監視でおすすめの開発会社/ベンダー6選と選び方もあわせてご覧ください。
- 詳しい比較:ツールの詳細な比較や費用相場は、関連記事で深掘りしています。
- 候補の確認:開発会社やベンダーの候補を並べて見たいときにも役立ちます。
工程3: ダッシュボードの構築
収集したメトリクスは、ダッシュボードに並べて初めて運用で使えるようになります。
サーバーごとにCPU・メモリ・ディスクの推移をグラフで並べ、レスポンスタイムの変化も時系列で追えるようにします。
情報を詰め込みすぎると誰も見なくなり、監視が形だけになってしまいます。そのため、ダッシュボードは「毎日見られる粒度」に整えます。
高価なSaaS型の監視ツールを入れても、ダッシュボードが複雑だと日常的には見られません。さらに、アラートが鳴ってから初めて画面を開く、という組織レベルの失敗も起こります。
これを避けるには、まず1画面で全体の健全性を把握できるサマリーダッシュボードを作ります。
詳細は深掘り用に別途用意します。この二段構えが効果的です。
- 開く目的:ダッシュボードは、平常時から劣化の兆しに気づくために開くものです。
- チームでの共有:この前提をチームで共有しておくと、ダッシュボードが日々の運用に根づきやすくなります。
性能監視のしきい値設計とアラート運用
性能監視の成否を分けるのは、しきい値の設計です。しきい値が緩すぎると障害を見逃し、厳しすぎるとアラートが鳴りすぎて「アラート疲れ」を招きます。その結果、重要な通知が埋もれてしまいます。
しきい値は、警告・軽度障害・重度障害の3段階で運用します。
現場で即参照できるしきい値の目安
Load Average(1CPUあたり)は、4以上で警告、8以上で軽度障害、12以上で重度障害とするのが目安です。
また、ディスクおよびInodeの使用量は、80%超過で警告、90%超過で軽度障害、95%超過で重度障害とする基準があります。さらに、メールキューを監視する場合は、500件超で警告、1,000件超で軽度障害、2,000件超で重度障害とする運用例があります。
これらの数値は出発点で、システムの特性に合わせて調整が必要です。たとえば、バッチ処理が走る時間帯はCPUが上がるのが正常という場合があります。その時間だけしきい値を緩めるといったチューニングが、現実には欠かせません。
しきい値には、「何%が何分続いたら通知するか」という持続時間の条件を組み合わせます。瞬間値だけで判定するとノイズが増えるため、5分や10分の継続を条件に加えると、誤検知を大きく減らせます。
- 性質に合わせた設定:性質を踏まえてしきい値を作り分けると、実用的な監視に近づきます。
- 影響の大きい項目:ディスク使用量のように、超過すると確実に障害につながる項目は、早めに警告を出す設計にしておくと安全です。
アラート疲れを防ぐ通知設計
アラート設計は、ツール選び以上に重要だといわれています。実際、「特定キーワードを含むログだけをSlackへ通知する」という条件分岐で、設定ミスが起きた事例があります。
本来届くべき重要なエラーが届かず、障害の発見が3時間遅れました。この事例から、通知のロジックは複雑にしすぎないほうが安全だといえます。
過検知が続くと、通知に慣れた運用担当者が、本当に重要なアラートまで見過ごすようになります。これをアラート疲れと呼びます。
しきい値やアラートを詰める段階では、ITシステム性能監視の発注/外注/依頼/委託方法についても参照できます。発注と運用委託のどこまでを任せるかを判断する材料になります。
- 通知の使い分け:アラートの届け方を重要度に応じて変えることが、持続可能な監視運用の鍵になります。
- 重要度別の通知:重度障害だけを電話やオンコールで即時に通知し、警告はチャットのまとめ通知にとどめるといった階層化が、アラート疲れを防ぐうえで有効です。
キャパシティプランニングと予兆検知への発展
性能監視は、障害を検知するだけでなく、将来のリソース不足を予測する「キャパシティプランニング」へ発展させると真価を発揮します。
蓄積したメトリクスの推移を分析すれば、いつディスクが満杯になるか、いつCPUが恒常的に逼迫するかを見通せます。
リソース推移からみた増設タイミングの判断
キャパシティプランニングの基本は、リソース使用量の傾向を把握して、限界に達する前に増設や構成変更を行うことです。
たとえば、ディスク使用量が毎月5%ずつ増えているなら、現在80%でも4カ月後には100%に達すると予測できます。この予測があれば、深夜に慌てて対応する事態を避け、計画的にストレージを増設できます。
性能監視で蓄積した時系列データは、こうした先読みの根拠になります。
レスポンスタイムの監視も、キャパシティの判断材料になります。アクセス数の増加に伴ってAPIの応答時間がじわじわ延びているなら、サーバーの処理能力が頭打ちに近づいているサインです。
アプリケーション全体の性能を把握したい場合は、APM(アプリケーションパフォーマンスモニタリング)を統合する方法があります。ある中規模SaaS企業では、DatadogでAPM・ログ・メトリクス・トレースを統合しました。その結果、障害の原因特定にかかる時間が従来の3分の1に短縮されました。
- 操作のしやすさ:直感的なGUIによって、運用に不慣れなメンバーの負荷も下がったといいます。
- 監視の範囲:リソース単体の監視から一歩進み、アプリケーションの挙動まで含めて性能を捉えると、増設や改修の判断精度が高まります。
オブザーバビリティとAIOpsの実態と限界
監視の高度化としてよく語られるのが、「オブザーバビリティ(可観測性)」です。
従来の監視は「何が問題か(どこに異常があるか)」を示します。一方、オブザーバビリティは、メトリクス・ログ・トレースを統合して、「なぜそれが問題か(なぜ障害が発生したのか)」を明らかにします。
性能監視で異常な数値を捉えた後に、その原因を内部データから追える状態を作ると、復旧までの時間を大きく縮められます。
さらに進んだ取り組みとして、AIがログやメトリクスから異常を予測するAIOpsがあります。ただし、AIOpsにも限界があります。
精度の高い予測には、正常時と異常時の十分なデータを学習させる必要があります。しかし、運用を始めた直後は学習データが不足し、期待した精度が出ないことがあります。
過去に例のない種類の障害や、複数の要因が複雑に絡むケースには、対応しきれない場面もあります。
- 全体の整理:キャパシティプランニングやオブザーバビリティを体系的に押さえたい場合は、ITシステム性能監視の完全ガイドにまとめてあります。
- AIOpsの位置づけ:人間の判断を補う道具として導入し、最終的な対応は運用担当者が行う前提で進めるのが現実的です。
投資対効果の説明と継続的改善のサイクル
性能監視を導入し、続けていくには、経営層への投資対効果の説明と、運用を改善し続ける仕組みが欠かせません。
監視ツールやMSPの費用は「コスト」として見られがちです。一方で、ダウンタイムによる損失を防ぐ「投資」として説明できれば、決裁は通りやすくなります。
ダウンタイムの機会損失によるROIの算出
投資対効果を説明する基本の考え方は、ダウンタイム1時間あたりの損失額を見積もり、監視によって防げる停止時間を掛け合わせることです。
たとえば、ECサイトの1時間あたりの売上が50万円だとします。年間4時間分の停止を防げるなら、年間200万円の機会損失を回避できます。
これに対して、監視費用が年間100万円であれば、差し引きで十分な効果が見込めると説明できます。
ダウンタイムの損失には、売上のほかに、問い合わせ対応の人件費や復旧作業の工数も含まれます。
さらに、信頼低下によるブランド毀損まで含めると、損失額は売上の低下を上回ることがあります。これらを数字で示せば、監視投資の妥当性を説明できます。
費用の内訳は、ITシステム性能監視の見積相場や費用/コスト/値段についてで確認できます。
- 損失の見方:売上の減少だけで見ると、損失の全体を捉えにくくなります。
- 比べ方:監視費用と比べるときは、年間ベースで揃えて見るのが分かりやすいです。
ポストモーテムによる監視自体の改善
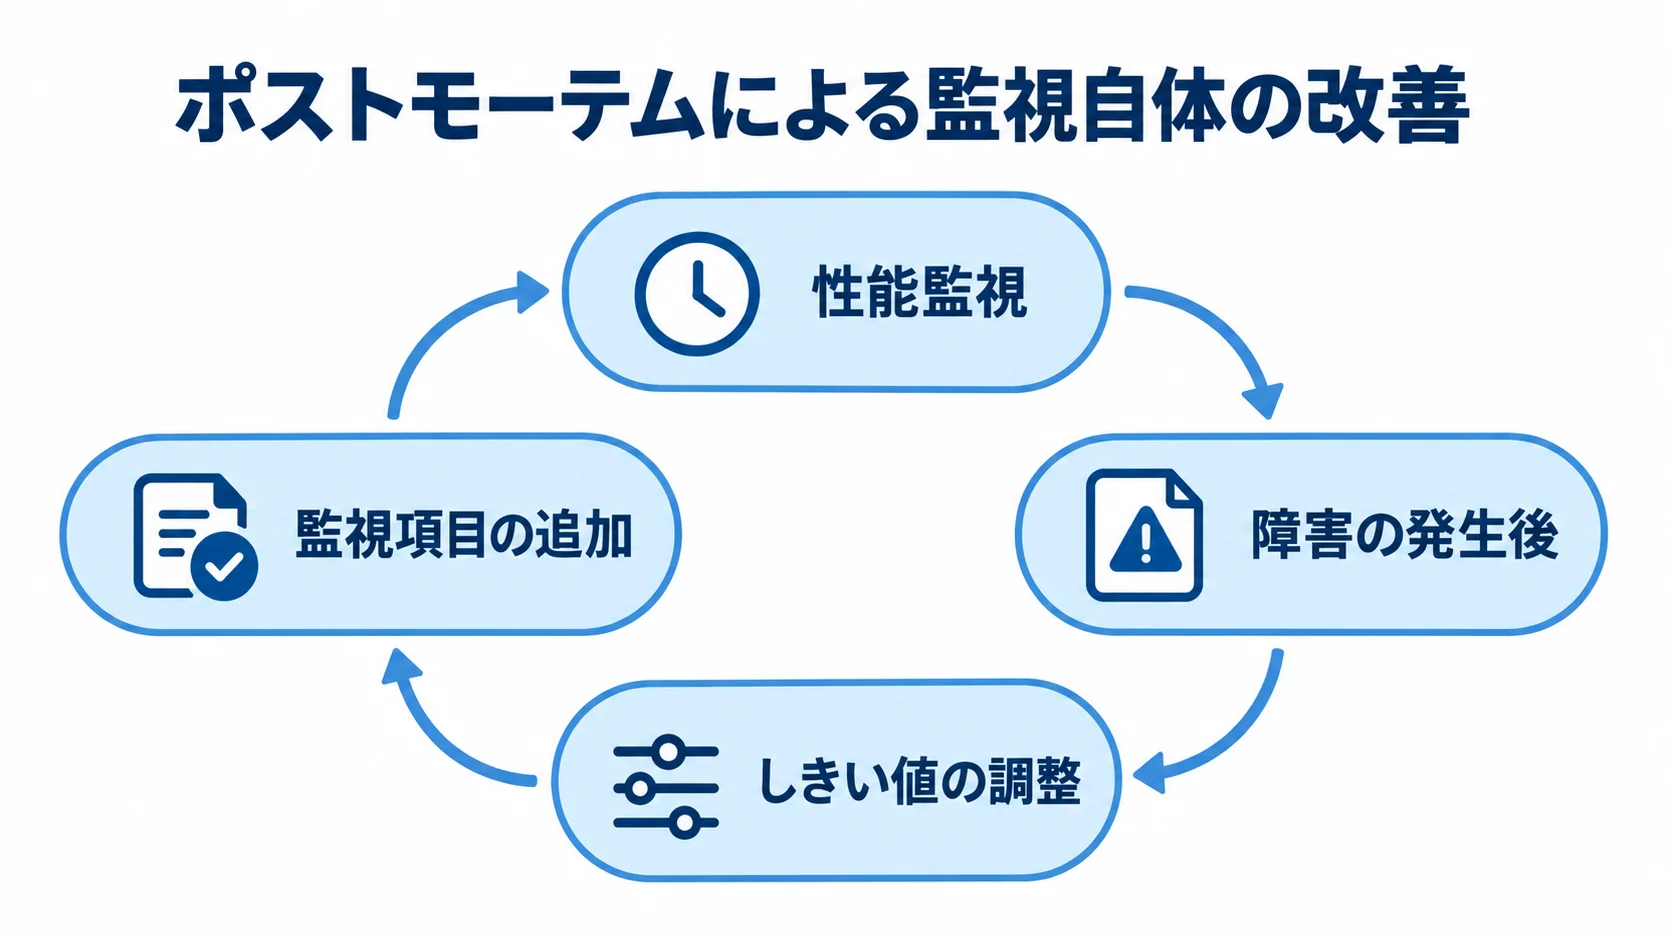
性能監視は、運用しながら継続的に改善していくものです。その中核となるのが、障害後の振り返りであるポストモーテムです。
障害の発生後は、原因だけでなく検知の過程も確認します。具体的には、「アラートは適切なタイミングで鳴ったか」「しきい値は妥当だったか」「もっと早く気づける兆候はなかったか」を検証します。
この振り返りで得た学びは、しきい値の調整や監視項目の追加という形で、監視システム自体に反映させます。
さらに、障害のたびに監視を磨けば、検知精度が高まり、同じ原因の再発を防げます。特に、ポストモーテムを定例化すると、運用改善に効果的です。
導入から改善までの全体像は、ITシステム性能監視の完全ガイドで確認できます。
- 監視の形骸化:振り返りを続けないと、監視は実態からずれていきます。
- しきい値の放置:システム構成が変わってもしきい値が古いまま放置されると、いざというとき役に立たなくなります。
まとめ
ITシステム性能監視は、CPU・メモリ・ディスク・レスポンスといったリソースの推移を継続的に追い、障害が表に出る前に予兆を捉える取り組みです。
進め方としては、監視対象と監視項目の洗い出しから始め、予算や環境に合ったツールを選んでエージェントを導入し、日常的に見られるダッシュボードを構築します。
そのうえで、Load Average 4/8/12とディスク80/90/95%を、警告・軽度・重度の3段階で設計します。持続時間の条件も組み合わせると、誤検知とアラート疲れを抑えられます。
さらに、蓄積したメトリクスをキャパシティプランニングに活用すると、限界前に計画的な増設ができます。APMやオブザーバビリティと組み合わせれば、原因特定も速くなります。
導入を続けるには、ダウンタイムの機会損失からROIを算出して経営層に説明し、障害後のポストモーテムで監視自体を改善し続けることが欠かせません。
各工程を自社に当てはめて進めれば、止まる前に手を打てる性能監視を組み立てられます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。