
ITシステムの原因調査は、ログ解析による事実収集、なぜなぜ分析、根本原因の特定と検証、恒久対策の立案と実行という4工程で進めます。
復旧だけで対応を終えると同じトラブルが繰り返されるおそれがあるため、原因を人ではなく仕組みに求め、事実に基づいて恒久対策につなげることが再発防止の土台です。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
ITシステム原因調査の全体像と位置づけ
ITシステム原因調査とは、発生した障害や不具合に対して「なぜそれが起きたのか」を事実に基づいて解明し、再発を防ぐための恒久対策につなげる活動です。障害対応の全体フローでは、検知・一次連絡・影響範囲調査・暫定復旧が「止血」のフェーズです。原因調査は、その後にサービスがいったん安定してから腰を据えて取り組む工程として位置づけられます。
原因調査を疎かにすると、暫定対応を繰り返すだけの「もぐら叩き」状態に陥ってしまいます。
インシデント管理と問題管理の違い
原因調査を正しく位置づけるには、「インシデント管理」と「問題管理」の違いを押さえる必要があります。
- インシデント管理:サービスが正常に稼働しない状態をできるだけ早く解消し、迅速な復旧を目的とします。
- 問題管理(障害管理):インシデントを引き起こした根本原因を特定し、再発しない仕組みを作ることにあります。
このため、原因調査は問題管理の中核を担います。この区別が曖昧なまま現場が動くと、「とにかく動けばよい」という空気が広がり、暫定対応がそのまま放置されがちです。
インシデントの状態(サービスが落ちている)と、障害の原因となった事象は切り分けて捉えます。後者には、特定のバッチが異常終了したことや、設定値が誤っていたことが当たります。後者を恒久的に潰すのが原因調査の役割だと、関係者全員が共通認識を持つことが出発点です。
原因調査を行うことで得られる効果
原因調査をきちんと回すと、まず同種トラブルの再発が減り、結果として平均復旧時間(MTTR)が短縮されていきます。
- 本番に近い環境での検証:意図的に擬似障害を起こし、回復力を確かめる取り組みです。
- レジリエンススコア:この取り組みで、組織のスコアが2.3から4.1へ引き上がっています。
この取り組みでは、計47件の実験で12件の致命的な故障モードを特定し、MTTRを65%削減した事例があります。こうした結果は、原因を事前と事後に深く掘ることが運用品質に直結することを示しています。
さらに、調査によって得られた知見はチームの学習資産になります。残したいのは、「障害が直った」という結果だけでなく、「なぜ起きたのか」「なぜ早期に検知できなかったのか」という構造的な学びです。こうした学びが積み重なると、組織全体のシステム理解と対応力が底上げされていきます。
原因調査の進め方を体系的に学びたい方は、ITシステム障害対応の進め方もあわせて確認すると、復旧から調査までの流れが立体的に把握できます。
進め方ステップ1:ログ解析による事実収集
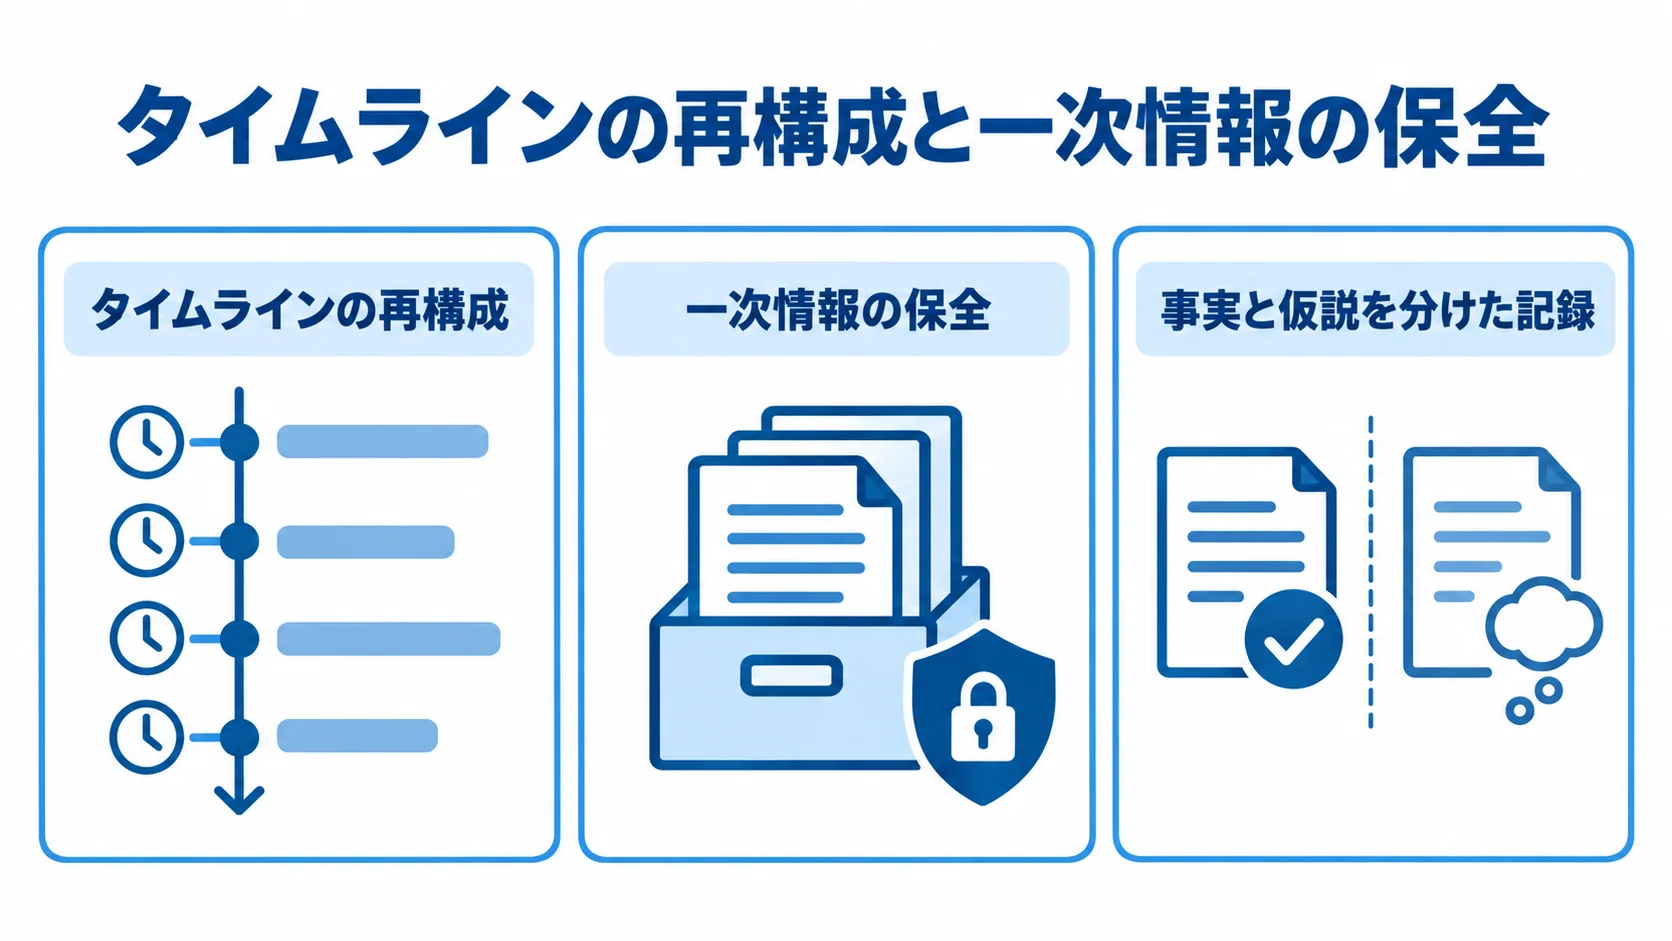
原因調査の第一歩は、推測ではなく事実を集めることです。憶測で「たぶんあれが原因だろう」と決めつけて進めると、的外れな対策に時間を浪費してしまいます。この工程では、ログ・メトリクス・構成情報といった客観的な証拠を時系列で並べ、何がいつ起きたのかを正確に再構成することが中心になります。
タイムラインの再構成と一次情報の保全
最初に行うのは、障害発生前後のタイムラインを分単位で再構成することです。
- 照合するデータ:アプリケーションログ、サーバーのリソース監視データ、デプロイや設定変更の履歴を突き合わせます。
- ネットワーク機器のログ:「異常値が最初に現れた時刻」と「直前にどんな変更が行われたか」を特定します。
多くの障害は、リリース・設定変更・トラフィック急増といった「直前の何か」と相関しているため、時系列の整理だけで有力な仮説が立つことも少なくありません。
一次情報の保全も、この段階で欠かせません。調査の過程でログがローテーションされて消えたり、復旧作業によって証拠となるデータが上書きされたりすると、後から原因にたどり着けなくなります。そこで、調査対象のログやスナップショットは早めに別領域へ退避し、改変されない形で確保しておく習慣をつけます。
事実と仮説を分けた記録
ログ解析を進めるうえで陥りやすいのが、事実と仮説の混同です。「データベースの接続数が上限に達していた」は観測された事実ですが、「だからアプリが応答しなくなった」は仮説にすぎません。
- 同列に扱う危険:事実と仮説を同じレベルで扱うと、検証されていない思い込みが「原因」として独り歩きしてしまいます。
- 調査メモの書き方:「観測された事実」と「そこから立てた仮説」を分けて書きます。
事実には必ずログの該当箇所やメトリクスのグラフといった裏付けを添え、仮説には「これを確かめるには何を見ればよいか」という検証手順をセットで書いておきます。
こうすることで、複数人で調査する際の認識のズレが減り、後工程のなぜなぜ分析にスムーズにつながります。
進め方ステップ2:なぜなぜ分析による深掘り
事実が揃ったら、次は表面的な事象の奥にある本質的な原因を掘り下げます。その手法が、トヨタ生産方式に源流を持つ「なぜなぜ分析」です。
一つの事象に対して「なぜ?」を繰り返し問いかけ、根本にある構造的な要因へとたどり着きますが、進め方を誤ると個人攻撃や形式的な作文に陥るため、正しい運用が欠かせません。
「なぜ」を「どのようにして」への変換
なぜなぜ分析が失敗する最大の要因は、「なぜ」が「なぜ(あなたが)ミスをしたのか」という個人への詰問に変質してしまうことです。
- 詰問の影響:個人への詰問が続くと、担当者は萎縮し、本当の情報を出さなくなります。
- 問いの言い換え:詰問に陥るのを防ぐ、実践的な技法です。
具体的には、「なぜテストを通したのか」「なぜ気づかなかったのか」という問いがそれにあたります。これでは真因にたどり着けません。
問いは「なぜミスが起きたのか」から、「どのようにしてこの状況が生まれたのか」に変えます。「どのような仕組みであればこのミスは防げたのか」と、主語を人から仕組み・プロセスへ移します。
たとえば「花瓶の水を換えようとして落として割った」という失敗があります。これを本人の不注意で片づけず、「水場までの移動経路に障害物があった」「花瓶の材質が割れやすかった」と、環境の問題として捉え直します。
問いの向け先を人ではなく構造に固定することが、有効な分析の鍵になります。
非難なき文化と心理的安全性の確保
なぜなぜ分析を機能させる土台が、「非難なき文化(ブレームレス・カルチャー)」です。これは、個人のミスを責めるのではなく、ミスを誘発してしまった仕組みやプロセスの欠陥に焦点を当てる考え方を指します。
- ファシリテーターの最大の役割:人は誰でもミスをする前提で、「誰が悪いか」ではなく「どうすれば次は防げるか」を全員で考える場をつくることです。
- 関連する観点:なぜなぜ分析の失敗回避や再発防止策の組み立て方を知りたい方は、ITシステム障害復旧の進め方で扱う事前準備の観点も参考になります。
具体的には、分析の冒頭で「この場は犯人探しではなく仕組みの改善のための場である」と明言します。担当者の固有名詞ではなく役割や工程で語り、発言を遮らず最後まで聞く運用ルールも徹底します。
心理的安全性が確保されてはじめて、現場は真因に直結する本音を口に出せます。たとえば「実はこういう作業を省略していた」「マニュアルが古くて使えなかった」といった話です。
進め方ステップ3:根本原因の特定と検証
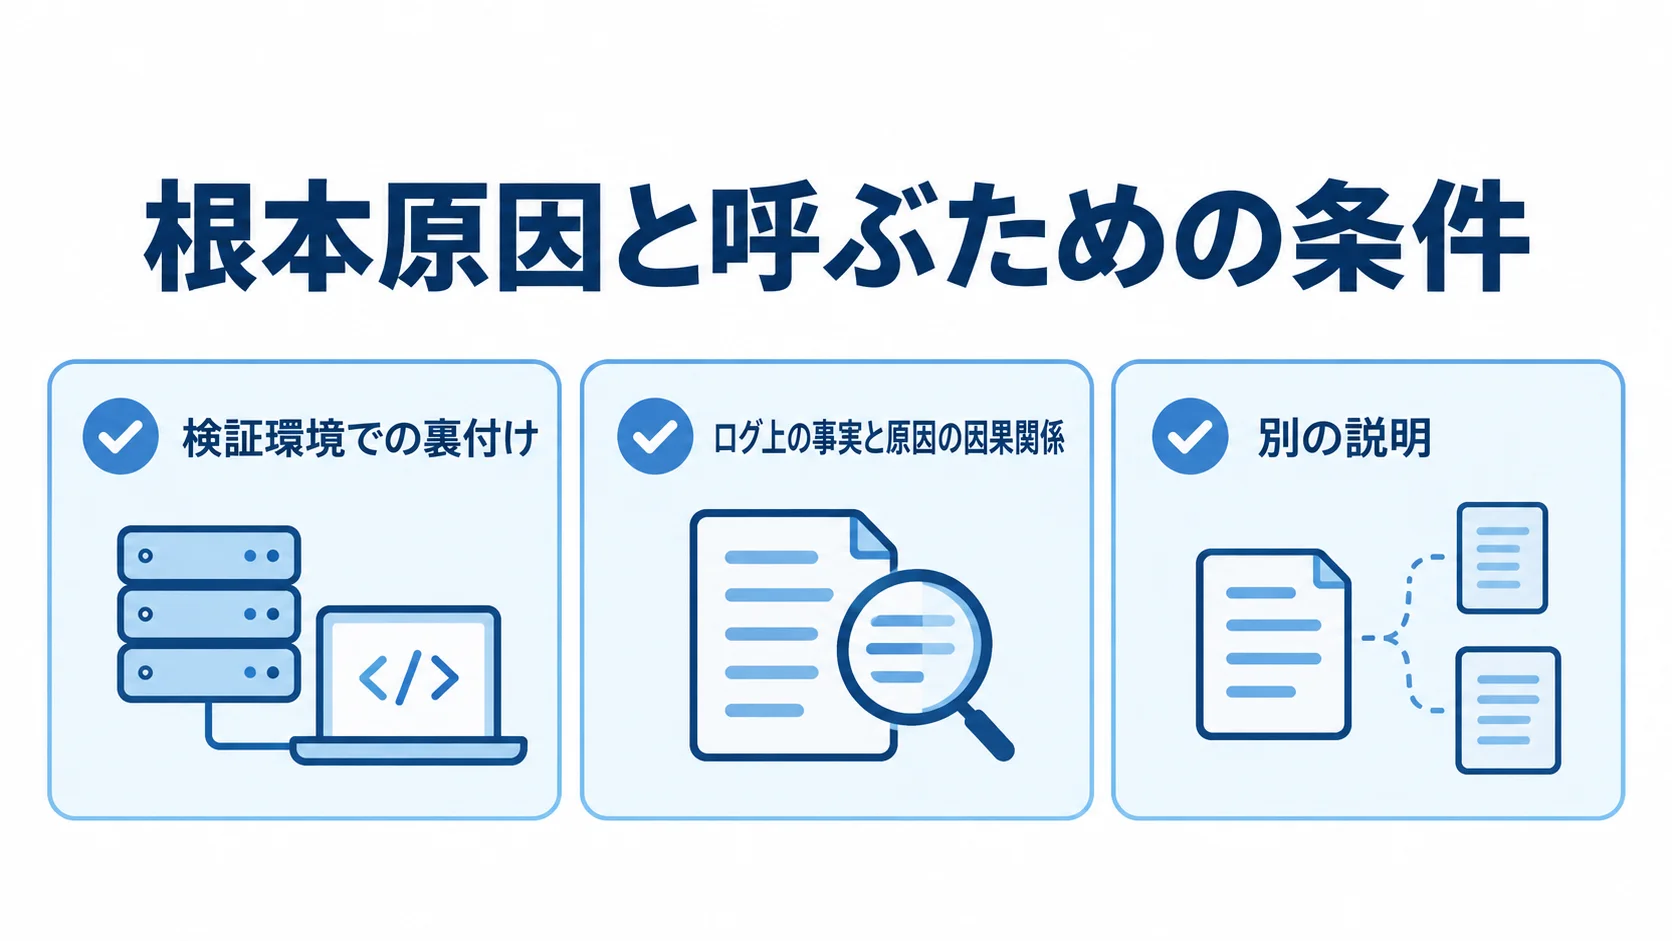
なぜなぜ分析で浮かび上がった候補のなかから、本当に根本原因と呼べるものを絞り込み、それが正しいことを検証するのがこの工程です。
ここを丁寧にやらないと、もっともらしいが実は的外れな「真因らしきもの」に対策を打ってしまい、再発を防げません。事実との整合性を冷静に確認する姿勢が求められます。
真因の条件と再現による裏付け
根本原因と呼ぶための条件は、「それを取り除けば、当該の障害は発生しなくなる」と論理的に説明できることです。逆に言えば、対策を打っても再発の余地が残るのなら、まだ掘り下げが足りていません。
- 要因の確認:掘り下げた要因について「これがなければ本当に起きなかったか」を一つひとつ問い直し、必要十分なところまで到達したかを確認します。
- 検証環境での裏付け:理想は、同じ条件を再現し、特定した原因で実際に障害が再現するかを確かめることです。
再現に成功すれば、その原因が真因である確度は格段に高まります。再現が難しい場合でも、ログ上の事実と原因の因果関係に矛盾がないか、別の説明が成り立たないかを多角的に点検し、説明の穴を埋めていきます。
外部ベンダー起因の障害と報告書の妥当性評価
原因がSaaSやクラウド、外部委託先といったベンダー側にある場合、調査の主導権を相手任せにしてはいけません。
- 報告書(RCA)の評価:ベンダーから届く原因調査報告書は鵜呑みにせず、内容の妥当性を自社で評価する姿勢が欠かせません。
- 確認の観点:事象のタイムラインが自社のログと整合しているか、再発防止策が原因に対して有効か、実施期限が明確かを見ます。
説明が抽象的だったり、原因と対策がかみ合っていなかったりする場合は、遠慮なく差し戻し、追加情報の開示を求めるべきです。
あわせて、SLA(サービス品質保証)に違反していないか、違反していればペナルティの適用や再発防止のコミットメントを交渉する余地があります。外部起因の障害では、待つだけで終わらず、自社のシステムを守る当事者としてベンダーに働きかける実務が成否を分けます。
進め方ステップ4:恒久対策の立案と確実な実行
真因が特定できたら、それを潰す恒久対策を立案します。ここで気をつけたいのは、「気をつける」「チェックリストに項目を足す」といった属人的な対策に逃げないことです。
人の注意力に依存した対策は、忙しくなれば必ず形骸化します。だからこそ、仕組みで再発を防ぐ発想に立って対策を設計することが求められます。
4つの分類による再発防止策の検討
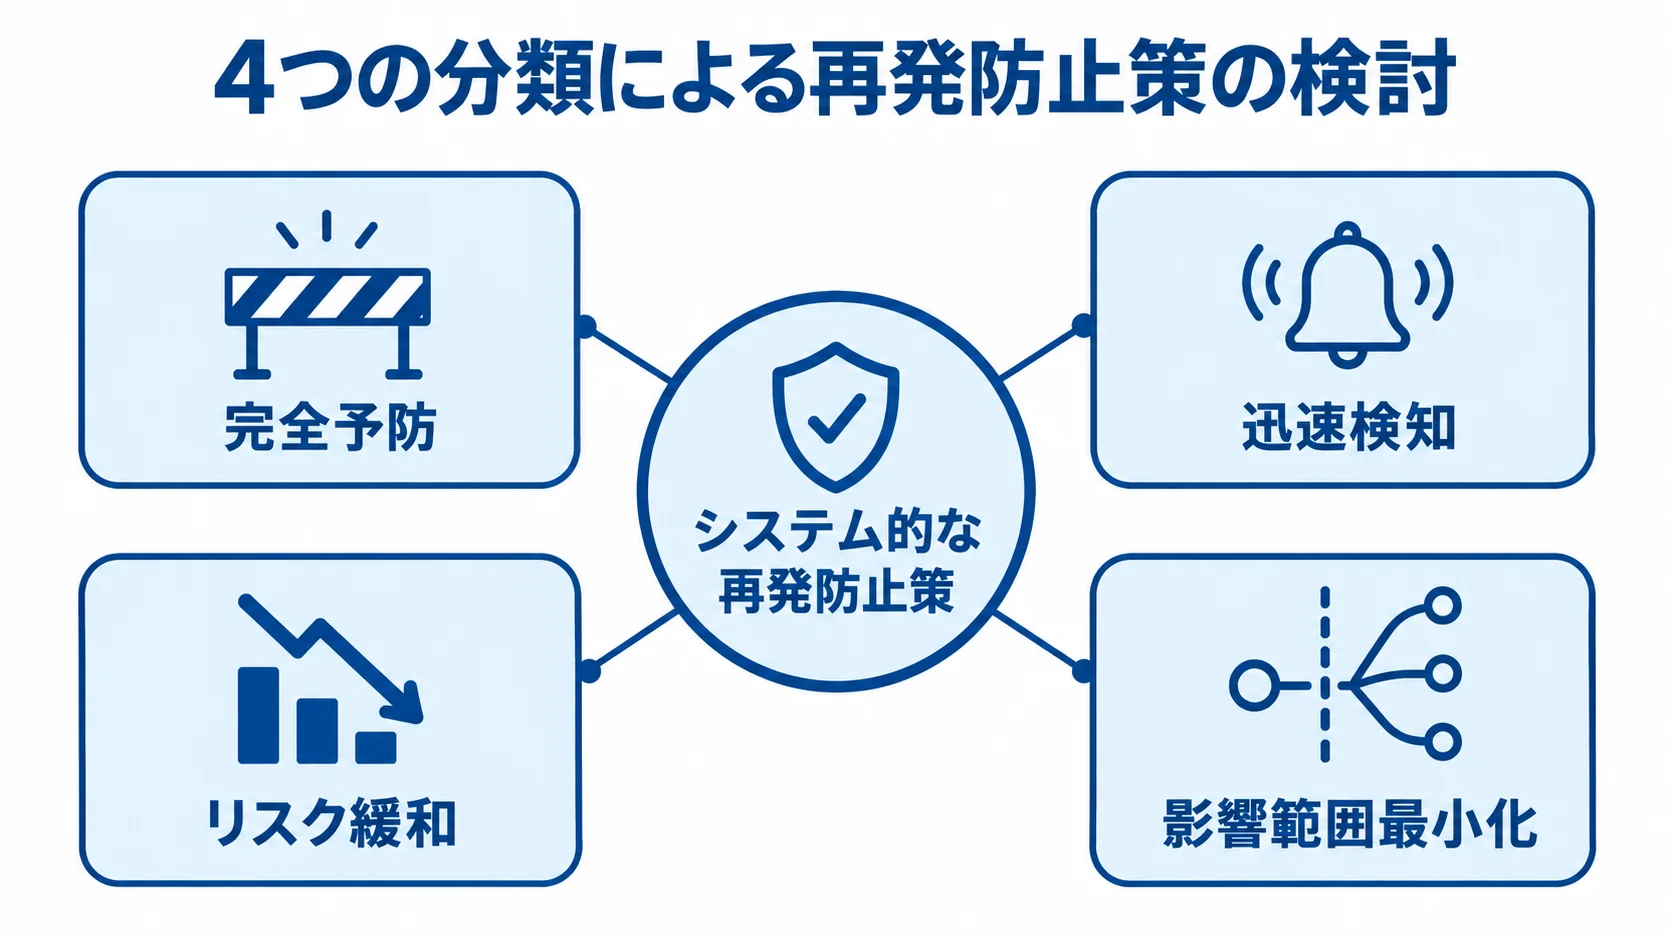
システム的な再発防止策は、次の分類で検討すると漏れがなくなります。
(1)完全予防は、そもそもその事象が発生しないようにすることです。設定の自動化や、不正な入力を受け付けない仕組みなどが該当します。(2)リスク緩和は、発生しても被害を小さくする方法で、多重化やリソースの余裕確保などが該当します。
残る2分類は、検知と影響範囲を扱います。
- (3)迅速検知:発生したらすぐ気づけるようにする(監視・アラートの追加・閾値見直し)
- (4)影響範囲最小化:影響を局所に閉じ込める(機能の切り離し、段階的なリリースなど)
理想は(1)の完全予防ですが、コストや技術的制約で難しい場合は、(2)から(4)を組み合わせて多層的に守ります。
特に「迅速検知」は見落とされがちです。ポストモーテム(事後検証)で「なぜ監視アラートより先にユーザーやカスタマーサポートが障害に気づいたのか」を厳しく問うと、検知の穴が浮き彫りになります。
たまたま早期に発見できた偶然の幸運(グッドラック)に頼っていた箇所を洗い出して、検知の仕組みで埋めていくことが、再発防止の質を高めます。
恒久対策が新規開発に押し出されないための工夫
原因調査でもっとも見落とされがちなのが、立案した恒久対策が「実行されない」問題です。
- 実行されない対策:ポストモーテムで再発防止策を書いても、新機能開発に埋もれて、技術的負債の解消が後回しにされ続ける現場は多くあります。
- 実行の制度化:対策を書いただけで終わらせないためには、実行を制度として守る工夫が必要です。
具体的には、恒久対策を通常の開発タスクと同じバックログに期限と担当者付きで登録し、定期的に進捗を確かめる仕組みを作ります。
ビジネス側から「新機能を優先してほしい」と圧力がかかったときは、対策を打たずに再発した場合の損失を定量的に示すのが有効です。停止時間、信用の低下、対応コストを、投資対効果として説明します。
再発のリスクを数字で語ることで、技術的負債の解消に必要なリソースを確保しやすくなります。
原因調査をドキュメント化するポストモーテムの作り方
原因調査の成果を組織の学習資産として残すための文書が、ポストモーテム(事後検証報告書)です。
単なる障害報告書は「何が起きて、どう直したか」を記録します。一方、ポストモーテムは「なぜ起きたのか」「何を学び、どう再発を防ぐのか」までを記述します。学びをチーム全体で共有する点が大きな違いです。
ポストモーテムに盛り込むべき必須項目
ポストモーテムには、次の項目を盛り込むと過不足のない内容になります。
- 概要:何が起き、どの程度の影響があったかの要約。タイムライン:検知から復旧までの時系列
- 根本原因:なぜなぜ分析で特定した真因。再発防止策:4分類で整理した対策と、担当者・期限
- 検知方法の評価:どうやって気づいたか、もっと早く気づけなかったか。運が良かった点(グッドラック):たまたま助かった偶然要素と、そこに潜むリスク
特に「検知方法の評価」と「運が良かった点」は、通常の障害報告書には含まれない、ポストモーテム独自の重要項目です。
偶然うまくいった部分を直視すると、次は運に頼らず検知と対処ができる体制へと改善していけます。これらの項目をテンプレートにしておけば、誰が書いても一定の品質で調査結果を残せるようになります。
実施タイミングと小規模チームでの回し方
ポストモーテムは、記憶が鮮明なうちに実施するのが鉄則です。目安としては、障害解決後72時間以内、すなわち2〜3営業日以内が理想とされます。
- 早めの開催:時間が経つほど当事者の記憶は薄れ、ログも追いにくくなるため、復旧の余韻が残るうちに調査会を設定するのが望ましいでしょう。
- 小規模チームの現実:人員が限られる中小・スタートアップでは、「そこまで手が回らない」という声も聞かれます。
そうした状況でも、簡易な形で振り返りを習慣化する価値は大きいです。1〜2名であっても、事実の時系列・真因・次にやることの3点だけは必ず文書に残す、というように最小限の型を決めておけば、過度な負担なく学習を積み上げられます。
原因調査を外部の専門家とともに進めたい場合の進め方は、ITシステム原因調査の発注・外注方法で詳しく解説しています。
まとめ
ITシステム原因調査の進め方は4つの工程で構成されます。「ログ解析による事実収集」「なぜなぜ分析による深掘り」「根本原因の特定と検証」「恒久対策の立案と確実な実行」です。
事実から出発し、問いの向け先を人ではなく仕組みに固定し、真因を検証で裏付けて、対策を仕組みとして実装する。この流れを丁寧に回すことが、再発を断ち切り平均復旧時間を縮める近道です。
あわせて、非難なき文化の醸成と、外部ベンダー報告書(RCA)の妥当性評価に取り組みます。恒久対策が新機能開発に押し出されないための交渉術と、ポストモーテムによる学習資産化も必要です。
これにより原因調査は、単なる後始末から組織を強くする継続的な改善活動へと変わります。
まずは身近な障害から、事実と仮説を分けて記録し、72時間以内に簡単な振り返りを残すところから始めてみてください。
原因調査の体制づくりや、自社に合った仕組み化に悩む場合は、コンサルティングから開発・運用まで一気通貫で支援できるパートナーに相談するのも有効な選択肢です。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。