
ITシステム障害復旧の進め方は、障害を検知して影響範囲を把握し、暫定復旧、データ復元、恒久対策の順に、システムを正常な状態へ戻していく流れです。
サービスが止まれば売上機会を失い、顧客が離れていくおそれもあります。データが失われれば、事業そのものが揺らぎかねません。その成否の大半は、平常時の設計と準備で決まります。障害が起きてから手順を考えていては、間に合いません。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム障害復旧の定義|障害対応との違いと全体像
ITシステム障害復旧とは、障害によって停止したり劣化したりしたシステムやサービスを、できるだけ早く確実に正常な状態へ戻す一連の活動のことです。
よく似た言葉に「障害対応」がありますが、両者は対象とする範囲が異なります。障害対応は、インシデントの検知から事後の再発防止までを含む広い概念であるのに対し、障害復旧は、その中で「機能を取り戻す」ことに重心を置いた領域です。
復旧を語るうえで欠かせないのが、災害復旧(ディザスタリカバリ)と事業継続(BCP)の視点です。さらに、単一サーバーの障害だけでなく、データセンター全体の喪失やサイバー攻撃による広範な被害まで想定して、どの水準まで戻すかをあらかじめ決めておく必要があります。
障害復旧は、「壊れたものを直す」だけでなく、「事業を止めない」ための設計と一体で考えるテーマです。
暫定復旧と恒久対策の切り分け
障害復旧では、「暫定復旧」と「恒久対策」を切り分けて考えることが、最初に押さえるべき点です。暫定復旧は、根本原因が完全には分からなくても、まずサービスを利用可能な状態へ戻すための応急処置を指します。予備サーバーへの切り替え、再起動、影響範囲を限定した機能停止などが該当します。
暫定復旧では、利用者への影響を最小化することが最優先で、原因の究明は後回しでも構いません。一方の恒久対策は、原因を特定したうえで、同じ障害が二度と起きないようにシステムやプロセスを修正する取り組みです。
両者を混同すると、原因が分かるまで復旧作業を始められず、その間もサービスは止まり続けて被害が拡大します。逆に、暫定復旧だけで満足して恒久対策を怠れば、同じ障害が何度も再発します。まず止血し、その後に根治するという二段構えが、障害復旧の基本姿勢です。
復旧目標を定めるRTOとRPO
障害復旧の設計でまず決めるべき指標が、RTO(目標復旧時間)とRPO(目標復旧時点)です。RTOは、障害発生からどれだけの時間で復旧させるかという時間の目標で、たとえば決済システムなら1時間以内、社内の参照系システムなら1営業日以内といった形で、業務への影響に応じて定めます。
RTOを短く設定するほど、冗長構成や自動切替の仕組みが必要になり、コストも上がります。また、RPOは、どの時点までのデータを復旧させるかというデータ損失の許容量です。たとえばRPOを15分とすれば、障害直前の最大15分間のデータは失われる可能性があることを意味します。
RPOを限りなくゼロに近づけるには、リアルタイム同期やレプリケーションが必要になります。RTOとRPOを業務ごとに定義すると、過剰投資を避けつつ、事業に必要な復旧水準を合理的に決められます。この2つの指標が、後述する復旧手順とバックアップ設計のすべての土台になります。
ITシステム障害復旧の進め方|検知から復旧完了までの流れ
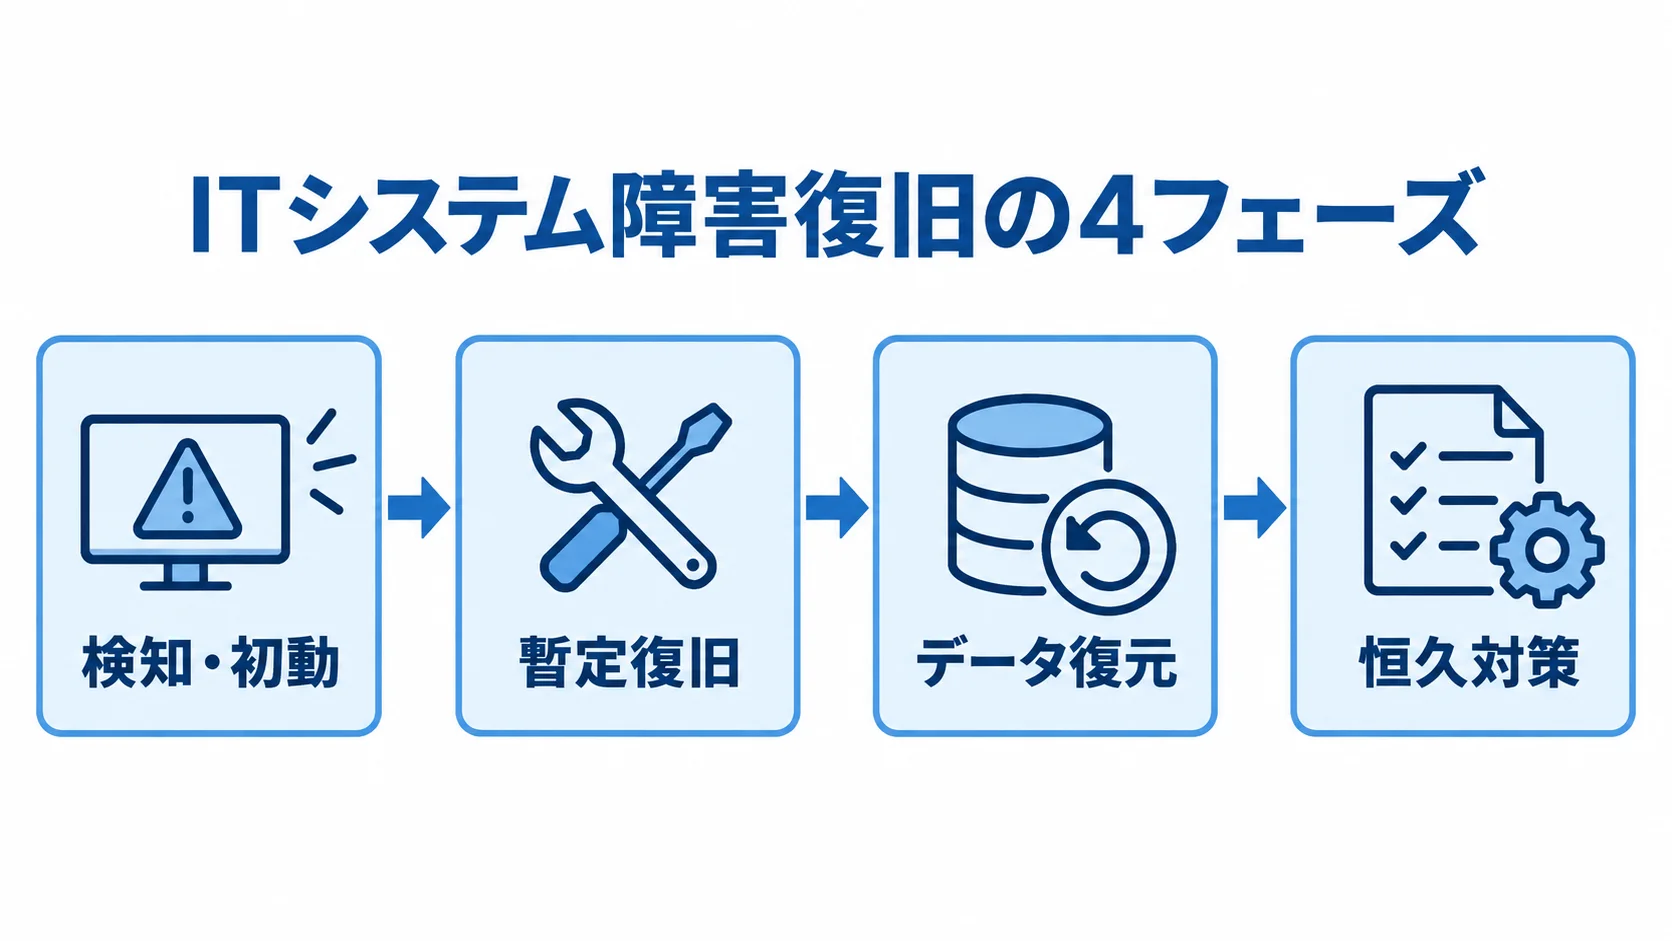
障害復旧は、次の4つのフェーズを段階的に進めていきます。各フェーズで「次に何をするか」を手順として書き出しておくと、対応する人が迷わずに進められます。
- 検知・初動:障害の検知と影響範囲の把握
- 暫定復旧:サービスを利用可能な状態へ戻すこと
- データ復元:バックアップからの復元と、整合性の検証
- 恒久対策:根本原因の特定と、再発防止策の計画
現場の判断に頼る部分を減らし、誰が対応しても一定の水準で復旧できる状態を平常時に作っておくことが、復旧時間の短縮に直結します。
検知・初動と影響範囲の把握
復旧の起点は、障害を早期に検知することです。死活監視やリソース監視、ログ監視のアラートによって、利用者からの問い合わせより先に異常を捉えられる体制が理想です。検知したら、まず影響範囲を素早く特定します。どのサービスが、どの程度、どの利用者に影響しているのかを把握しなければ、復旧の優先順位は決められません。
初動では、復旧目標値に沿った時間管理が重要です。たとえば、被害が極めて大きいCriticalな障害では、検知から15分以内に関係者へ第一報を入れ、1時間以内の復旧を目標とする、といった基準をあらかじめ設けておきます。
原因が未確定でも、「現在調査・復旧対応中」として状況を共有し、復旧見込み時刻を仮置きで伝えておけば、関係者の不安と問い合わせの集中を抑えられます。初動の数分が、その後の復旧全体のスピードを左右します。
予備系への切り替えと暫定復旧
影響範囲が把握できたら、サービスを利用可能な状態へ戻す暫定復旧に移ります。冗長構成を組んでいる場合は、待機系サーバーへの切り替え(フェイルオーバー)が最も確実な手段です。たとえば、ロードバランサーの切り替えやデータベースのレプリカ昇格によって、利用者の体感への影響を最小限に抑えながらサービスを続けられます。
予備系がない場合は、障害が起きた機能だけを切り離して縮退運転に移す、再起動で一時的に回復させる、といった応急処置を取ります。このとき、暫定復旧の操作手順そのものが新たな障害を生まないよう、切り替え手順を平常時に文書化して、実際に動作確認しておくことが欠かせません。
「予備系があるはずなのに切り替えられなかった」という事態は、訓練不足からよく起こります。暫定復旧の確実性は、日頃の準備の質によって決まります。
データ復元と恒久対策への移行
暫定復旧でサービスを戻した後、データの欠損や破損があれば復元作業に入ります。バックアップからリストアする際は、いつの時点のバックアップを使うかを、RPOに照らして判断します。
復元後は、データの整合性を必ず検証し、業務に使える状態を確認してから本番へ反映します。この検証を飛ばして復元すると、破損したデータを上書きする二次被害につながりかねません。
サービスとデータが安定したら、根本原因まで掘り下げて、再発を防ぐ修正を計画する恒久対策へ移ります。恒久対策は、完了して初めて復旧が真に終わったといえます。暫定復旧だけで放置すると同じ障害が繰り返されるため、対策の実施状況を追跡する仕組みも合わせて整えておきます。
バックアップ・予備サーバーからの復旧手順
障害復旧の実効性は、バックアップと予備サーバーの設計の質で決まります。どれほど詳しい復旧手順書があっても、肝心のバックアップが取れていなければ、データは戻りません。
戻せるバックアップの設計と検証
バックアップ設計の指針として広く知られるのが「3-2-1ルール」です。データのコピーを3つ持ち、2種類の異なる媒体に保存して、そのうち1つは遠隔地に置く、という考え方です。これにより、機器故障から拠点全体の被災まで幅広いリスクに対応できます。
また、近年はランサムウェア対策として、改ざんできないイミュータブルバックアップやオフライン保管を組み合わせる構成も重視されています。見落とされがちなのは、バックアップから実際に復元できるかの検証です。
バックアップは取っていても、いざリストアしようとすると、ファイルが壊れていた、手順が分からず時間がかかった、というケースは少なくありません。そのため、定期的にテスト環境へ実際に復元するリストア訓練を行い、RTO内に戻せることを確かめておくべきです。大切なのは、「取れているバックアップ」よりも「戻せるバックアップ」を担保することです。
災害復旧サイトと冗長構成の活用
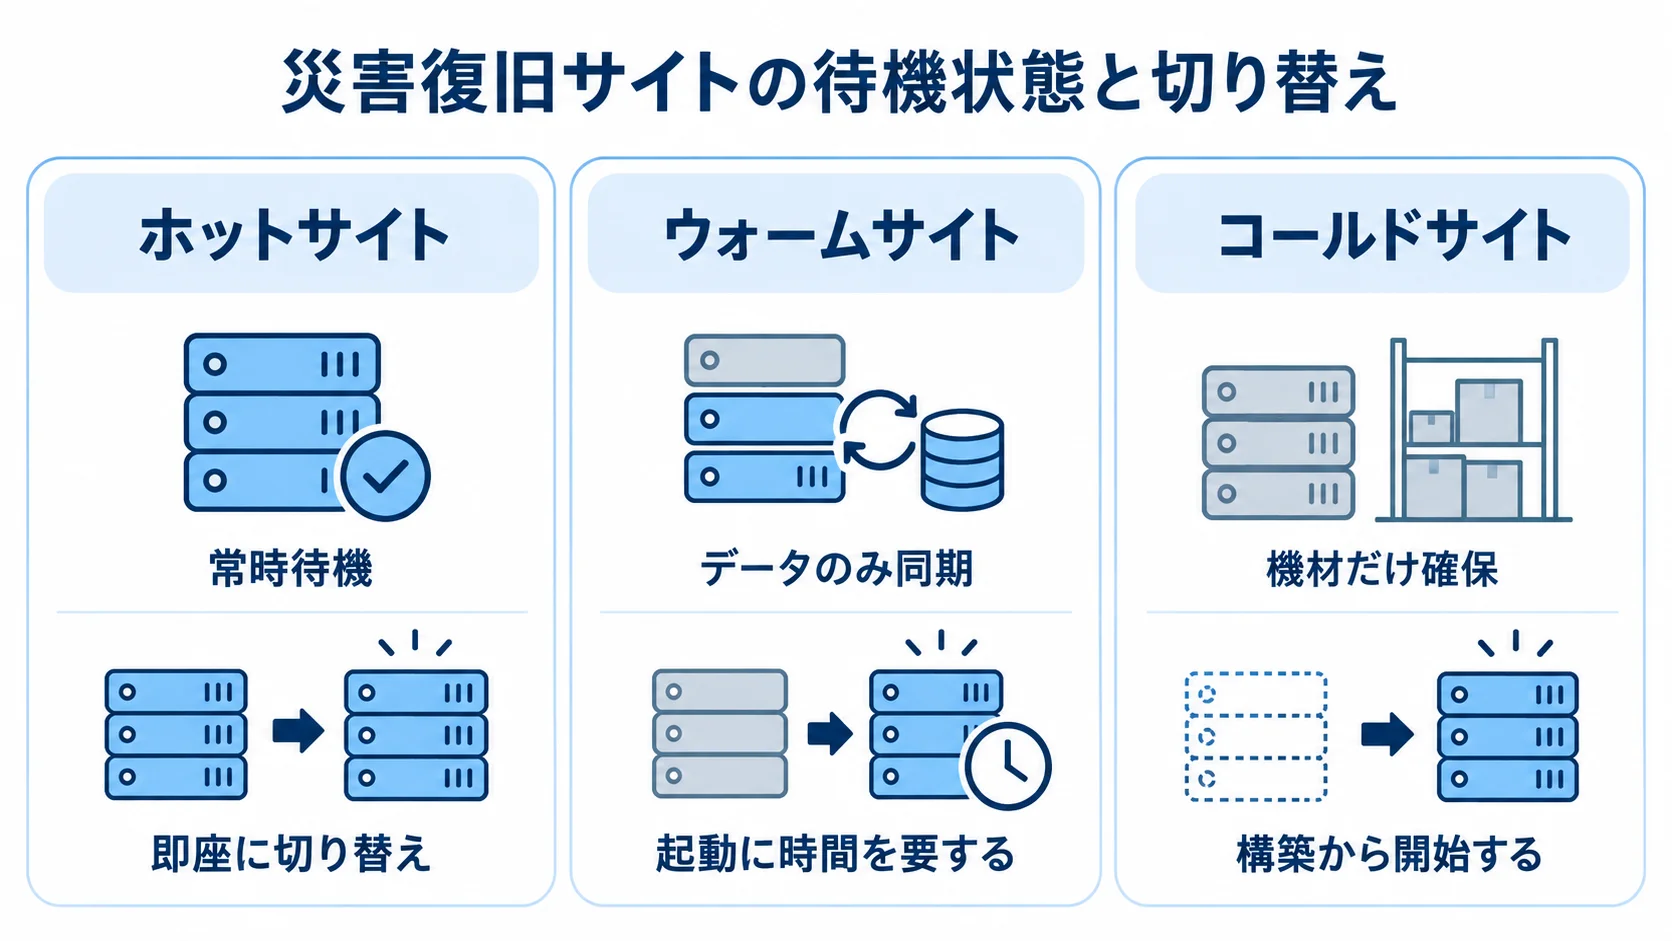
データセンターの被災やクラウドリージョン全体の障害といった広域災害に備えるには、災害復旧サイト(DRサイト)の構築が有効です。DRサイトには、ホット、ウォーム、コールドの3種類があり、RTOとコストのバランスで選びます。
ホットサイトは常時待機して即座に切り替えられ、ウォームサイトはデータのみ同期して起動に時間を要します。コールドサイトは機材だけ確保して、構築から始めます。RTOを短くするほど、常時稼働の冗長構成が必要となり、コストも上昇します。
クラウド環境では、複数のアベイラビリティゾーンやリージョンにまたがる構成によって、比較的低コストで地理的冗長性を確保できます。ただし、切り替え手順を含む復旧シナリオを事前に文書化し、定期的に切り替え訓練を行うことが欠かせません。DRサイトや冗長構成も、平常時に切り替えを試したことがなければ、実際の障害時に機能しない可能性が高くなります。
復旧力を高める事前準備と回復力の検証
障害復旧の質は、障害が起きてから何をするかよりも、平常時にどれだけ準備したかで決まります。
監視体制の整備、構成情報の一覧化、意図的に障害を起こして回復力を試す訓練まで体系的に行えば、いざというときの復旧時間を大きく短縮できます。
監視体制と構成情報の可視化
復旧を素早く始めるには、障害をいち早く検知する24時間365日の監視体制が前提となります。サーバーの死活やリソース、アプリケーションのログ、外形監視を組み合わせれば、利用者が気づくより先に異常を捉えられます。検知が遅れれば、その分だけ復旧の開始も遅れ、被害が広がります。
同時に、構成情報を一覧にしておくことも大切です。ネットワーク構成図やサーバー一覧、システム間の依存関係、IT資産台帳が整理されていれば、障害発生時にどこを切り替え、どこを復旧すべきかを迅速に判断できます。
担当者の頭の中にしか構成がない属人化した状態では、その人が不在の夜間や休日に障害が起きたとき、復旧そのものが立ち行かなくなります。構成情報を文書にまとめておくことは、復旧力の土台になります。
ゲームデーとカオスエンジニアリング
復旧手順が実際に機能するかを検証する実践的な訓練が「ゲームデー」です。本番に近い環境で意図的に擬似障害を発生させ、検知から復旧までを実地でロールプレイします。手順書の不備や権限の不足、連絡経路の漏れといった、机上では見えない問題が訓練で表面化します。
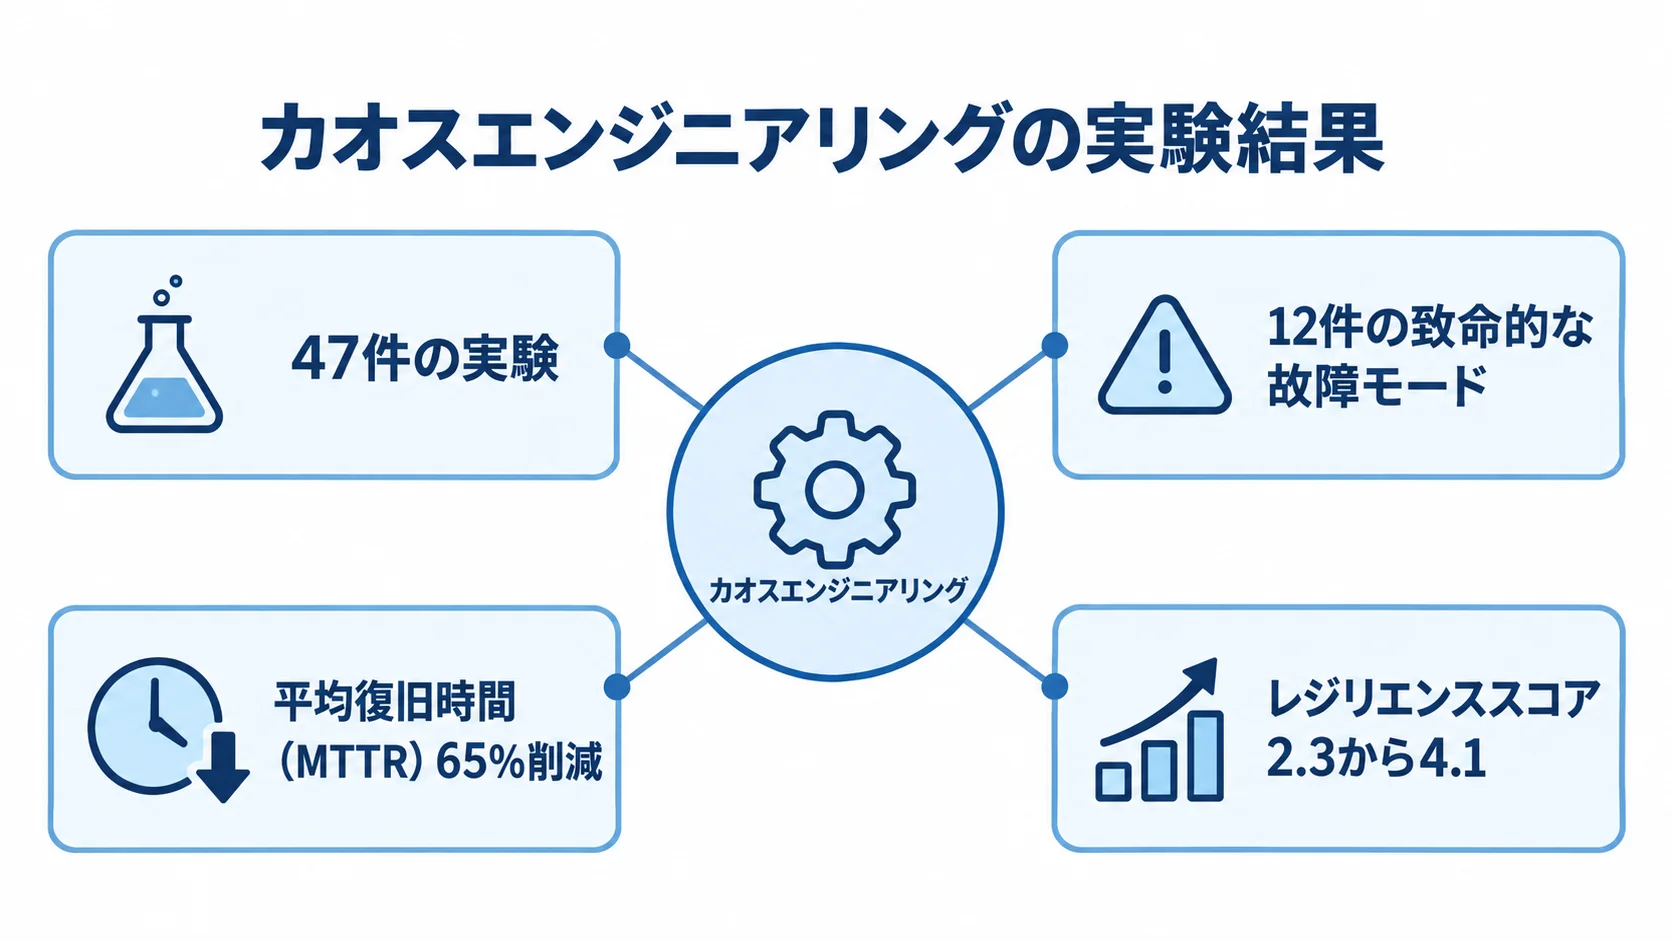
さらに踏み込んだ手法が、カオスエンジニアリングです。専用ツールで本番環境にあえて障害を注入し、システムの回復力(レジリエンス)を科学的に検証します。ある事例では、計47件の実験で12件の致命的な故障モードを特定し、平均復旧時間(MTTR)を65%削減、レジリエンススコアを2.3から4.1へ向上させました。
訓練や検証を通じて、平常時に弱点を先回りして潰すアプローチが、現代の障害復旧では主流になりつつあります。
深刻な被害への備えとベンダーへの復旧依頼
通常の障害復旧で対応しきれない深刻な被害として、ランサムウェアをはじめとするサイバー攻撃があります。
自社のリソースだけで広域災害や高度な攻撃に備えるのは現実的に難しいため、外部ベンダーへ復旧を依頼する選択肢も考えておく必要があります。
ランサムウェアからの復旧への備え
ランサムウェアは、データを暗号化して使えなくし、復旧と引き換えに身代金を要求するサイバー攻撃です。警察庁が2023年3月に公表した広報資料では、被害を受けた企業140社のうち95%が業務に何らかの影響を受けたと回答しています。攻撃では通常のバックアップまで暗号化されることもあり、一般的な障害復旧の手順では戻せない事態が起こり得ます。
備えとして有効なのは、ネットワークから隔離したオフラインバックアップや、書き換えできないイミュータブルストレージの活用です。攻撃を受けても汚染されていないバックアップが残っていれば、そこからの復元で事業を再開できます。
加えて、復旧手順に「感染端末の隔離」と「侵入経路の遮断」を組み込み、復旧と同時に被害の拡大を止める設計にしておくことが、サイバー攻撃時の復旧の鍵を握ります。身代金を支払っても、データが確実に戻る保証はありません。だからこそ、自力で復旧できる備えが欠かせません。
ベンダー依頼時のSLAと報告書の評価
復旧を外部ベンダーへ委託する場合は、契約時にSLA(サービス品質保証)で復旧目標を明確に取り決めます。RTOやRPO、一次対応までの時間、対応時間帯(24時間365日か平日日中のみか)を具体的に定め、未達時のペナルティも合意しておきます。曖昧なまま委託すると、いざ障害時に「契約範囲外」とされ、想定した復旧が受けられない事態に陥ります。
また、ベンダーが提出する障害報告書(RCA)も、そのまま受け入れず妥当性を評価する姿勢が欠かせません。根本原因の分析が表面的だったり、再発防止策が「今後注意する」といった精神論にとどまったりする場合は、具体化を求めて差し戻すべきです。発注側が情報開示を求め、対策の実効性を見極めれば、復旧品質を自ら管理できます。
委託先の選定や依頼の進め方については、ITシステム障害復旧の発注/外注/依頼/委託方法についてで詳しく解説しています。具体的なサービス比較はITシステム障害復旧でおすすめの開発会社/ベンダー6選と選び方を、費用感はITシステム障害復旧の見積相場や費用/コスト/値段についてをあわせてご覧ください。
まとめ|平常時に備える確実な復旧力
ITシステム障害復旧の進め方は、検知・初動から、予備系への切り替えによる暫定復旧、バックアップからのデータ復元、根本原因に対する恒久対策へと、段階的に進みます。
その成否を分けるのは、RTOとRPOという復旧目標を業務ごとに定義し、それに見合ったバックアップ設計と冗長構成を平常時に整えているかどうかです。障害が起きてから準備していては、間に合いません。
「取れているバックアップ」よりも「戻せるバックアップ」を、リストア訓練やゲームデーで確かめておく必要があります。ランサムウェアのような深刻な被害には、オフラインバックアップで備えます。外部ベンダーに委託する場合は、SLAと報告書の妥当性を自ら見極めます。
これらを積み重ねることで、いざというときに確実に戻せる復旧力が身につきます。本記事を起点に、自社の復旧体制を一度洗い出し、弱点を平常時のうちに潰していくことをおすすめします。障害復旧を含む運用全体の体系的な理解には、ITシステム障害復旧の完全ガイドもぜひ参考にしてください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。