
ITシステム障害対応は、障害を検知してから事後対応・再発防止までを6つのステップで順に進めます。
- 検知:障害の兆候の把握と事象の確認
- 連絡:一次報告とエスカレーション
- 復旧:作業の実施と再発防止の進行
障害をゼロにすることより、起きた瞬間にどれだけ早く検知し、的確に初動を取り、復旧までの時間(MTTR:平均復旧時間)を短くできるかが大切です。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム障害対応の全体像と前提となる考え方
障害対応の進め方を具体的に見ていく前に、混同されやすい用語の整理と、対応全体を貫く基本的な考え方を押さえておきます。ここが曖昧なままだと、対応フローだけをまねても現場では機能しません。
とくに「インシデント」と「障害」、「インシデント管理」と「問題管理」の違いは、対応の優先順位づけに直結する重要な前提です。
インシデントと障害、インシデント管理と問題管理の違い
「インシデント」とは、サービスが正常に稼働していない状態そのものを指します。「ユーザーがログインできない」「決済が完了しない」といった、利用者から見て困っている状態がインシデントです。一方で「障害」とは、そのインシデントを引き起こしている原因となる事象を指し、データベースサーバーの応答停止やメモリ枯渇などが該当します。
この区別が大切なのは、対応の目的が二つに分かれるからです。インシデントへの対応は「とにかく早くサービスを正常な状態に戻す」ことが目的で、これを「インシデント管理」と呼びます。これに対して、根本原因を突き止めて同じ事象を二度と起こさないようにする活動が「問題管理(障害管理)」です。
緊急時にまずやるべきはインシデント管理であり、原因が完全にわからなくても暫定的にサービスを復旧させることが最優先になります。原因究明と再発防止は、サービスが落ち着いた後の問題管理として腰を据えて取り組むべきものです。
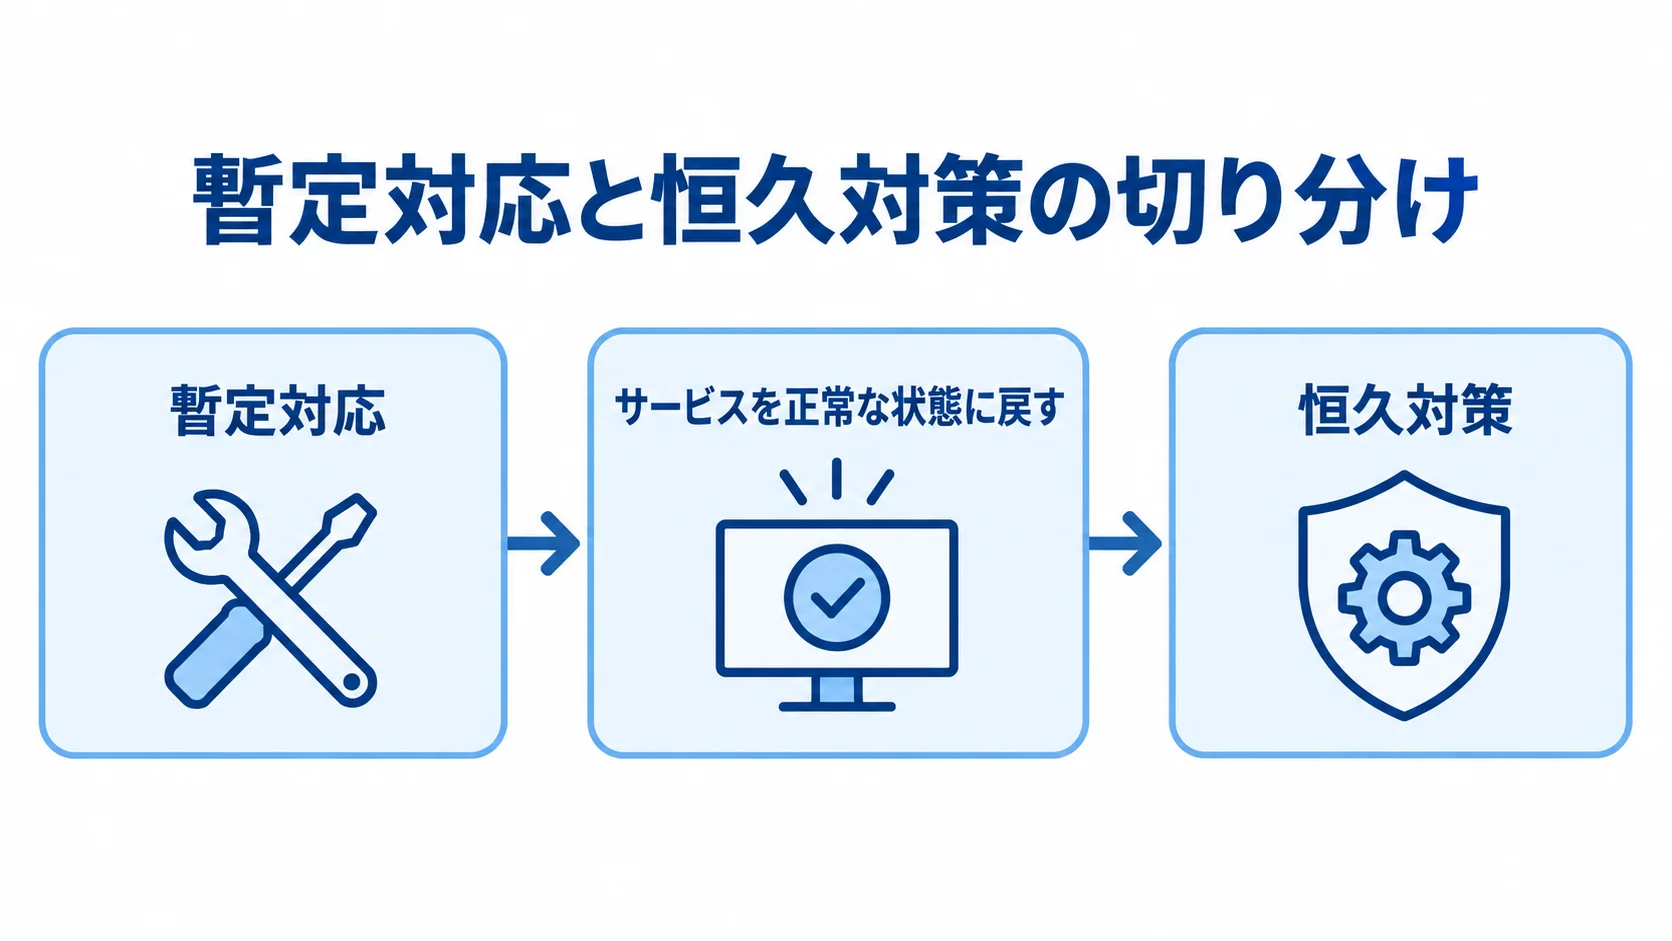
暫定対応と恒久対策を切り分ける発想
障害対応で混乱しやすいのが、復旧作業の最中に「原因を完全に直そう」としてしまうことです。原因の根本修正にこだわると復旧が遅れ、その間ユーザーや事業への損害が拡大し続けます。
そのため、まずはサーバー再起動やフェイルオーバー、機能の一時停止といった暫定対応でサービスを回復させ、利用者への影響を止めることを優先します。根本原因を取り除く恒久対策は、サービスが安定してから別タスクとして計画的に実施します。
この切り分けを欠くと、緊急対応と恒久対策が混在して指揮系統が乱れ、結果的にどちらも中途半端になります。「今は止血、治療は後で」という発想が、障害対応全体を貫く基本姿勢です。
ITシステム障害対応の進め方|6ステップの全フロー
ITシステム障害対応は、大きく6つのステップで進みます。その6つは、「検知・事象確認」「一次連絡・エスカレーション」「影響範囲調査」「原因調査」「復旧作業」「事後対応・再発防止」です。
ステップごとにやることを明確にし、属人化を避けて誰でも同じ手順で動けるようにすることが、MTTR短縮に直結します。
ステップ1〜2|検知・事象確認と一次連絡・エスカレーション
最初のステップは、障害の検知です。理想は監視システムのアラートによる自動検知ですが、現実にはユーザーからの問い合わせやカスタマーサポート経由で発覚することも少なくありません。検知後はまず、「本当に障害が起きているのか」「どの機能が影響を受けているのか」を冷静に確認します。
アラートが誤検知である可能性もあるため、再現性や監視ダッシュボードの数値を確認したうえで、正式な障害として扱うかを判断します。障害と確定したら、即座に一次連絡とエスカレーションを行います。その際に効いてくるのが、具体的なSLA目標値です。
影響が極大なCritical(決済停止・全面サービス断など)であれば、検知から15分以内に関係者へ第一報を入れ、1時間以内の目標復旧を掲げます。影響が大きいHighの障害では、30分以内にエスカレーションを完了させる基準を設けておくと、誰がいつ動くべきかが明確になります。第一報は「原因がわからない」状態でも構わず、むしろ「現在調査中」と速報を出すこと自体が、無用な混乱を防ぐ初動として欠かせません。
ステップ3〜4|影響範囲調査と原因調査
一次連絡と並行して、影響範囲の調査を進めます。「どのユーザーが」「どの機能で」「どの程度の頻度で」影響を受けているのかを定量的に把握することが目的です。影響範囲が明確になると、復旧の優先順位や、顧客・経営層への報告内容の精度が上がります。
全体像を見誤ると、本来止めるべきでない機能まで止めてしまったり、逆に被害を過小評価したりします。そのため、ログやメトリクスを根拠に客観的に判断します。
原因調査では、ログ解析を中心に「どこで何が起きているのか」を切り分けていきます。ただし、緊急対応の段階では原因の完全特定にこだわりすぎず、暫定対応で復旧の見込みが立てば、根本原因の究明は後回しにして構いません。直近のリリース内容、インフラの変更履歴、外部サービスの障害情報といった「変化点」から当たりをつけると、原因の絞り込みが速くなります。
ステップ5〜6|復旧作業と事後対応・再発防止
復旧作業では、暫定対応によってサービスを正常な状態へ戻します。サーバーの再起動、問題のあるリリースのロールバック、フェイルオーバーによる予備系への切り替えなど、状況に応じた手段を選びます。また、復旧作業は必ず指揮役の承認のもとで実施し、作業内容と実施時刻を記録しておくと、後の検証に役立ちます。
復旧後は監視を強化し、再発や二次障害が起きていないかをしばらく見届けます。そのうえで、事後対応・再発防止は、障害対応を「学習資産」に変える最も重要なステップです。障害報告書を作成して関係者へ正式に報告するとともに、根本原因の分析と恒久対策の立案を行います。
ここを「とりあえず報告書を出して終わり」にすると、同じ障害が必ず再発します。後述するポストモーテム(事後検証)の考え方を取り入れ、仕組みの欠陥として原因を捉え直すことが、再発防止の鍵となります。
役割分担の進め方|ICSと少人数の縮退運転
障害対応がうまくいくかどうかは、技術力以上に「役割分担」で決まります。誰が指揮を執り、誰が手を動かし、誰が外部と連絡を取るのかが曖昧だと、複数人が同じ作業を重複したり、逆に誰も連絡を入れずに情報が滞ったりします。
大企業で採用されるインシデントコマンドシステム(ICS)では、役割を明確に定義します。一方で、人員が揃わない中小・スタートアップでも、人数に応じて役割を統合する縮退運転で回せます。
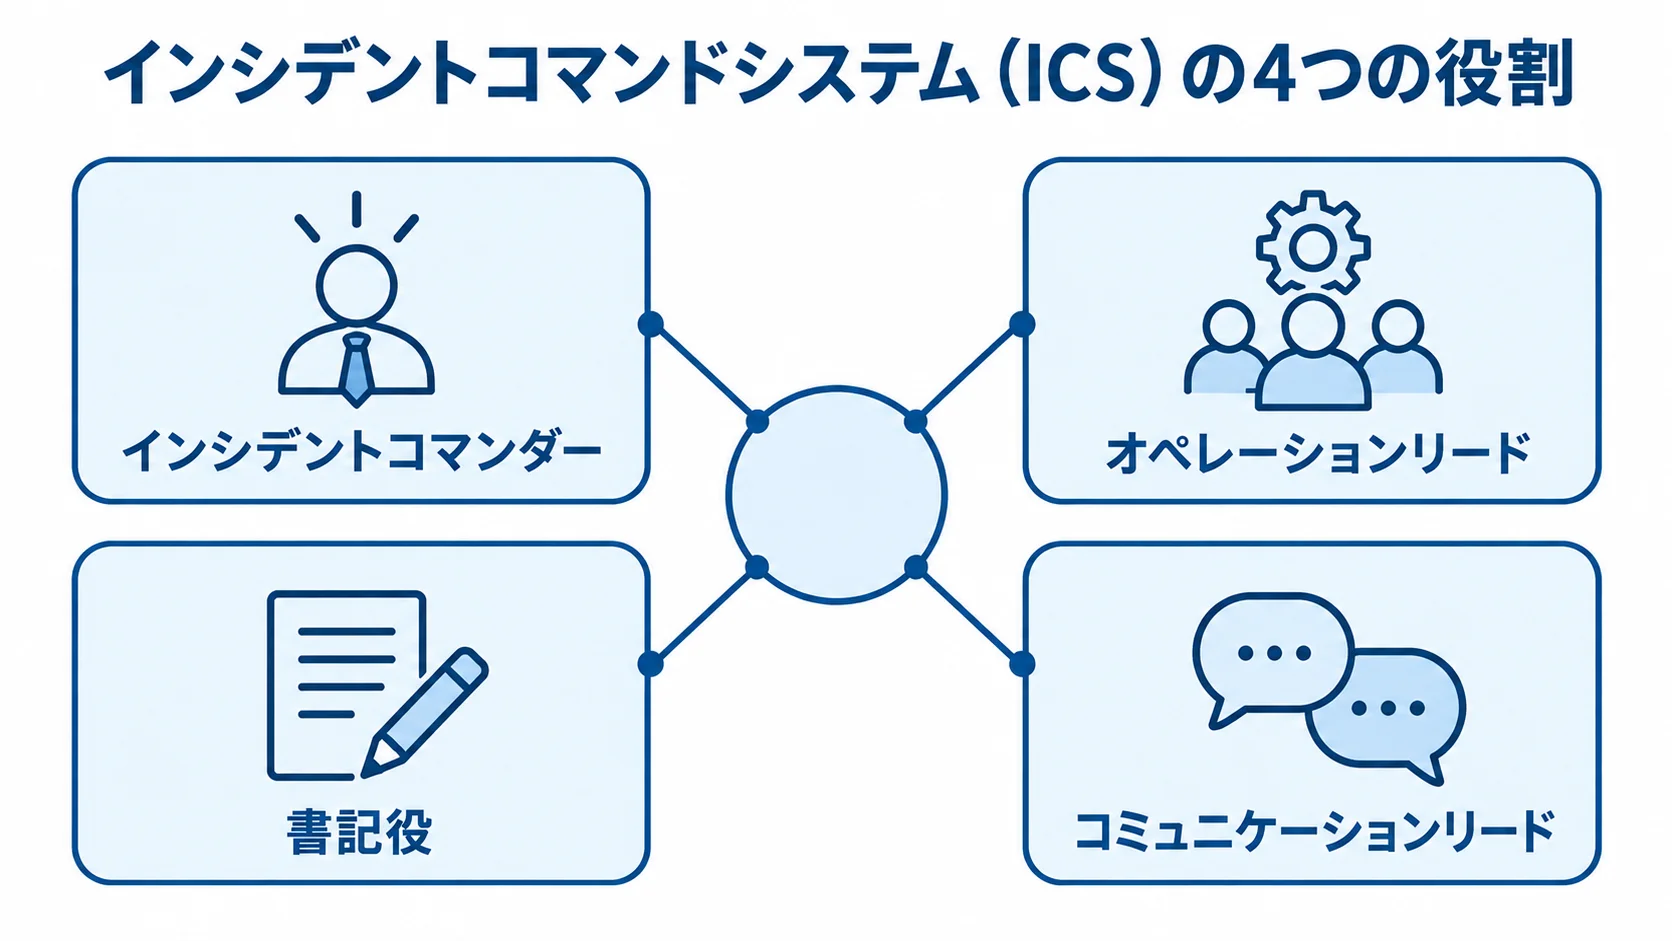
インシデントコマンドシステム(ICS)の4つの役割
ICSでは障害対応を主に4つの役割に分けます。1つ目はインシデントコマンダー(指揮官)で、状況を俯瞰して意思決定を下す司令塔です。2つ目はオペレーションリードで、実際に復旧作業の手を動かす実施担当です。
3つ目はコミュニケーションリードで、経営層や顧客、社内関係者への報告・調整を一手に引き受けます。4つ目は書記役で、対応のタイムラインや判断の根拠を記録し続けます。この分担で最も価値があるのは、コミュニケーションリードを独立させる点です。
作業者が外部からの問い合わせ対応に追われると、肝心の復旧作業が止まってしまいます。そこで、連絡窓口を一本化すると、エンジニアが復旧に集中できる環境が生まれます。たとえば、LINEなど大規模サービスを運用する企業でも、こうした明確な役割分担が大規模障害時の混乱を抑えるのに効いています。
1〜2名でも回す縮退運転のライン兼務ロジック
ICSは理想的な体制ですが、夜間や休日に4人も集まらないのが多くの中小企業の現実です。そこで有効なのが、人数に応じて役割を統合する「縮退運転」の考え方です。重要なのは、人が足りないなりに「どの役割を優先して残すか」を事前に決めておくことです。
1名しかいない場合は、その1名が全役割を兼務しつつ、何よりもまず応援を呼ぶことを最優先にします。2名いる場合は「対応ライン(指揮兼実務担当)」と「コミュニケーションライン(連絡兼書記)」の2つに完全分割するのが鉄則です。これは、作業者が外部連絡にリソースを奪われて復旧が止まる事態を防ぐためです。
3名揃えば、ようやくインシデントコマンダーを意思決定に専念させ、別メンバーへ作業を依頼する本来の体制へ移行できます。人数の増加に応じて段階的に役割を分ける設計にしておくと、少人数の現場でも統制を保ったまま障害に立ち向かえます。
再発防止の進め方|ポストモーテムとなぜなぜ分析
障害対応の進め方を本当に価値あるものにするのは、最後の再発防止のプロセスです。復旧して終わりにせず、なぜその障害が起きたのかを掘り下げ、二度と起こさない仕組みへと落とし込みます。
ここで欠かせないのが、ポストモーテム(事後検証)という枠組みと、なぜなぜ分析という根本原因の追究手法です。
ポストモーテムと非難なき文化(花瓶の例え)
ポストモーテムとは、タイムラインを含めて障害の経緯を整理し、根本原因と再発防止策をまとめた事後検証ドキュメントです。一般的な「障害報告書」が報告のための形式的な書類になりがちなのに対し、ポストモーテムは組織の学習資産化を目的とする点が大きく異なります。
理想的な実施タイミングは、記憶が新しいうちの解決後72時間以内(2〜3営業日以内)で、時間が経つほど当事者の記憶が薄れ、検証の精度が落ちてしまいます。
ポストモーテムを機能させる前提が「非難なき文化(Blameless Culture)」です。これを理解するのに分かりやすいのが「花瓶の例え」で、花瓶の水を換えようとして落として割ってしまったときは、次のように捉えます。
- 個人の不注意:責める対象とはしない
- 環境・仕組み:水場まで花瓶を運ばなければならない動線や割れやすい材質など、原因として捉え直す
障害も同じで、個人のミスを責める犯人探しをすると、現場はミスを隠すようになり、かえって再発リスクが高まります。そのため、「ミスを誘発したシステムやプロセスの欠陥は何か」に焦点を当てることで、初めて本質的な改善が進みます。
なぜなぜ分析を個人攻撃にしない問いの立て方
根本原因を掘り下げる代表的な手法が「なぜなぜ分析」です。表面的な事象に対して「なぜ」を繰り返し問うことで、奥に潜む本質的な課題を浮き彫りにします。ただし、この手法には落とし穴があります。
「なぜ(あなたは)テストを怠ったのか」のように問うと、たちまち個人攻撃に転じてしまいます。これを防ぐ実践的なコツは、問いを「なぜ」から「どのようにして」へ言い換えることです。たとえば「なぜミスをしたのか」を「どのような状況・仕組みがそのミスを起こりやすくしたのか」と問えば、視点は自然と人から仕組みへ移ります。
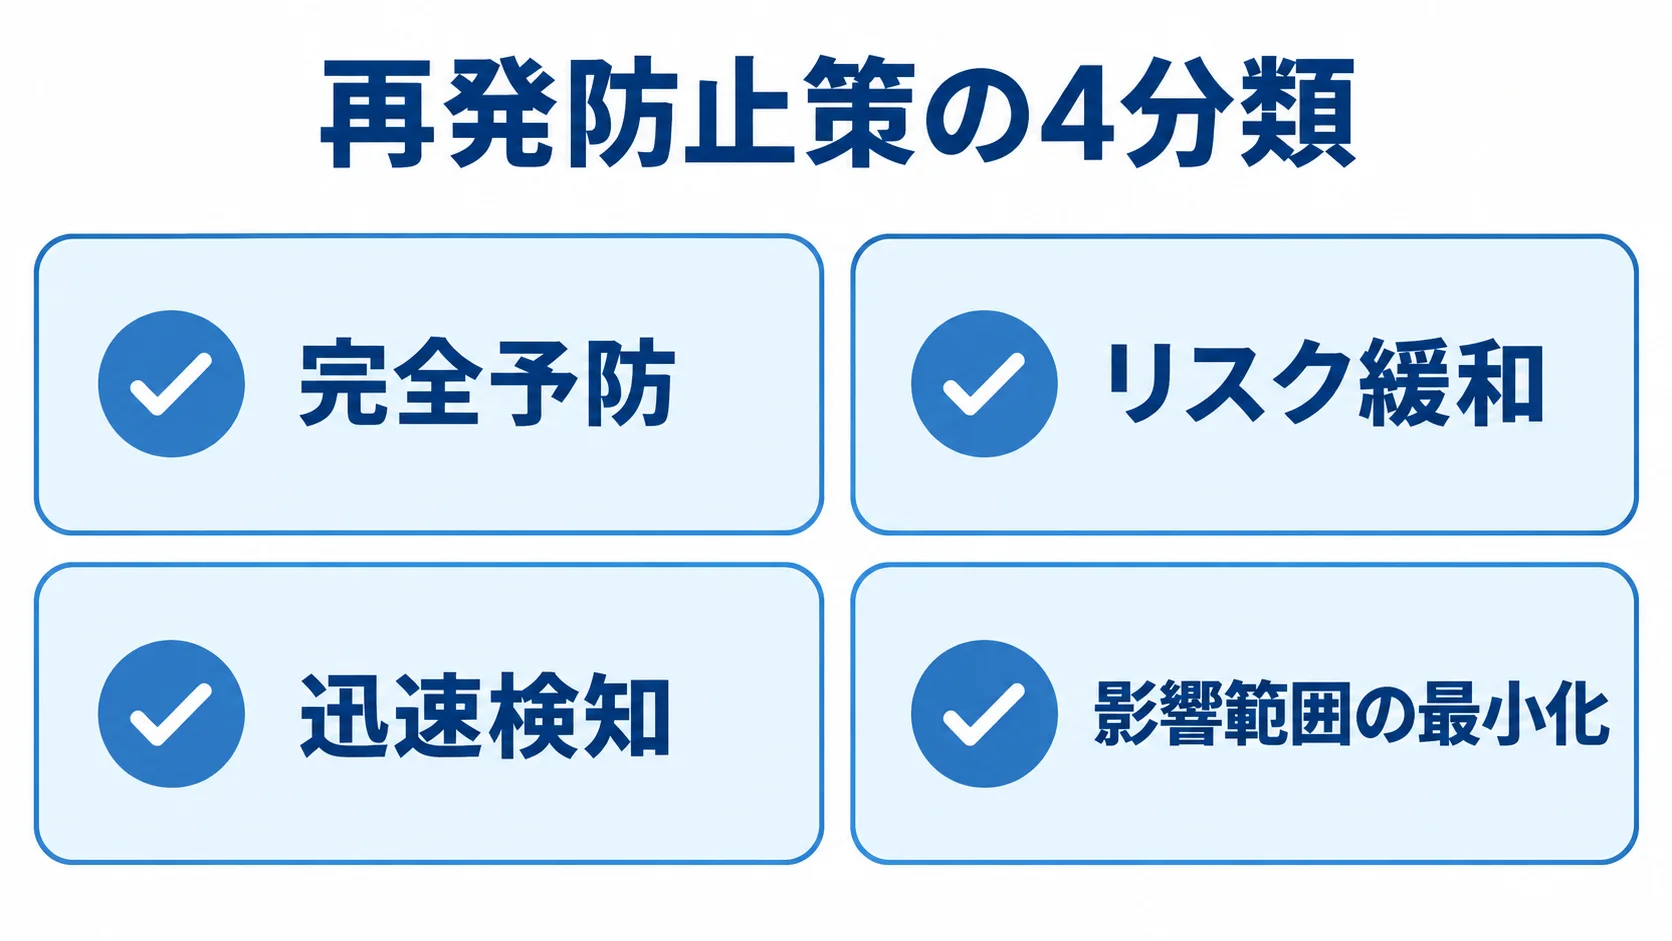
さらに、再発防止策は「気をつける」「チェックリストを追加する」といった属人的な対策に逃げず、4分類で検討すると実効性が高まります。4分類とは、(1)完全予防と(2)リスク緩和、(3)迅速検知と(4)影響範囲の最小化です。あわせて「たまたま早期発見できた」といった運の良かった点や、「なぜ監視アラートより先にユーザーが気づいたのか」という検知方法の弱点を洗い出すと、潜在リスクを先回りして潰せます。
そのまま使える障害報告書とSLAのテンプレート
ここまでの進め方を現場で回すには、毎回考え直すより、定型のテンプレートを用意しておくのが効果的です。障害報告書(ポストモーテム)の必須項目と、障害の重大度に応じたSLA目標値の設定例は、自社用に調整すれば、対応のブレを抑えて初動を標準化するのに役立ちます。
障害報告書・ポストモーテムの必須項目
障害報告書には、最低限、次の5項目を盛り込みます。
- 何が起きたかの一文サマリー(概要)と、発生・検知・復旧の各時刻を記したタイムライン
- 影響範囲(影響を受けたユーザー数・機能・期間)
- 根本原因(なぜなぜ分析の結果)
- 暫定対応と恒久対策の内容、および4分類での再発防止策
- 運が良かった点と検知方法の評価
これらを埋めると、報告書は記録にとどまらず、次の障害を防ぐためのチェックリストとして機能します。
とくに根本原因と再発防止策は、前述の非難なき文化となぜなぜ分析の成果が反映される中核部分です。「担当者が確認不足だった」で終わらせず、「確認漏れが起きやすいレビュー体制だった」と仕組みの言葉で書けているかが、報告書の質を分けます。
重大度別のSLA目標値とエスカレーション基準
障害の重大度を分類し、それぞれに対応時間の目標値を定めておくと、現場が迷わず動けます。一例として、影響が極大なCritical(決済停止・全面サービス断など)は、検知から15分以内に第一報を入れ、1時間以内の目標復旧を設定します。
影響が大きいHighは30分以内にエスカレーションを完了させ、Medium・Lowはより緩やかな基準とします。こうした目標値を明文化しておくと、深夜にひとりで障害に直面したエンジニアが、「今すぐ全員を叩き起こすべき事態なのか、それとも翌朝の報告で足りるのか」を即座に判断できます。
一方で、判断基準が個人の感覚に委ねられていると、報告が遅れたり、逆に過剰反応で疲弊したりします。重大度とSLAの対応表を一枚作っておくと、障害対応の初動が安定します。
障害対応を支える事前準備と進め方の注意点
どれだけ進め方を整えても、事前準備が不足していると初動が遅れます。障害対応は、起きてから考えるものではなく、起きる前に備えるものです。
監視体制・ゲームデーによる回復力の検証
事前準備の基本は、24時間365日の監視体制です。死活監視・リソース監視・ログ監視を組み合わせ、異常をユーザーより先に検知できる状態を作ります。
あわせて、次の準備がいざというときの初動速度を左右します。
- ネットワーク図などでシステム構成を一覧にする
- 対応マニュアルを整備する
- 予備サーバーや定期バックアップを用意する
さらに一歩進んだ準備として、本番に近い環境で意図的に擬似障害を発生させる「ゲームデー」というロールプレイ訓練があります。専用ツールで障害を注入し、システムの回復力(レジリエンス)を科学的に検証するカオスエンジニアリングという手法も広がっています。
ある導入事例では、計47件の障害注入実験から12件の致命的な故障モードを特定し、結果としてMTTR(平均復旧時間)を65%削減、レジリエンススコアを2.3から4.1へ向上させたという成果も報告されています。障害が起きてから慌てるのではなく、平時にあえて壊して鍛えるという発想が、対応力の底上げにつながります。
恒久対策とオンコール負担をめぐる注意点
進め方を実践するうえで見落とされがちなのが、ポストモーテムで立てた恒久対策が、日々の新機能開発に押し出されて実行されない問題です。ビジネス側の「新機能を優先したい」という圧力は強く、再発防止策はしばしば技術的負債として後回しにされます。
これを防ぐには、恒久対策を通常の開発タスクと同じバックログに載せ、期限と担当者を決め、進捗が分かるようにすることが有効です。たとえば、「いつか直す」を「いつまでに誰が直す」に変えるだけで、再発防止の実行率は大きく変わります。
もう一つの注意点は、障害対応者のメンタルヘルスとオンコール負担で、深夜や休日の呼び出しが一部の人に偏ると、燃え尽きや離職を招きます。役割をバランスよく配置し、深夜・休日のオンコール負担を定量的に把握したうえで、交代枠やインセンティブを見直すことが、持続可能な障害対応体制には欠かせません。障害対応は技術の問題であると同時に、人と組織の問題でもあるという視点を持つことが大切です。
まとめ|進め方の標準化によるMTTR短縮
ITシステム障害対応の進め方は、「検知・事象確認 → 一次連絡・エスカレーション → 影響範囲調査 → 原因調査 → 復旧作業 → 事後対応・再発防止」という6ステップに整理できます。緊急時はまず暫定対応でサービスを止血し、根本原因の究明と恒久対策は問題管理として後から計画的に進める、という切り分けが全体を貫く基本姿勢です。
役割分担はICSを基本としつつ、人員が揃わない現場では縮退運転のライン兼務ロジックで統制を保ちます。また、障害対応を本当に強くするのは再発防止の質です。
再発防止では、非難なき文化のもとでなぜなぜ分析を行い、「なぜ」を「どのようにして」へ言い換えて個人攻撃を避けながら、仕組みの欠陥として原因を捉え直します。そのうえで、72時間以内にポストモーテムを実施し、4分類で再発防止策を立て、恒久対策が新機能開発に埋もれないよう進捗を管理します。
これらを障害報告書とSLAのテンプレートで標準化すれば、属人化を解消しながらMTTRを着実に短縮できます。自社のリソースで監視や24時間対応を回すのが難しい場合は、運用代行やインシデント管理サービスの活用も選択肢に入れながら、まずは本記事の進め方を自社の障害対応フローへ落とし込むところから始めてみてください。
関連記事として、ITシステム障害対応でおすすめの開発会社・ベンダー6選と選び方と、ITシステム障害対応の完全ガイドがあります。費用や発注方法を確認したいときは、ITシステム障害対応の見積相場や費用・コスト・値段についてと、ITシステム障害対応の発注・外注・依頼・委託方法についてもあわせてご覧ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。