
XGBoostのシステム開発は、要件整理、基盤選定、設計開発、テスト、稼働、定着の順に進めると、本番運用につながります。各段階から次へ進む条件を決めておくことが、その要になります。
全体像はXGBoostのシステム開発の完全ガイドでも扱っています。
▼全体ガイドの記事
・XGBoostのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
XGBoostのシステム開発の全体像
XGBoostは決定木を順に追加して、予測誤差を小さくする機械学習ライブラリで、分類、回帰、ランキングに対応します。顧客の解約確率、需要量、設備故障の可能性、問い合わせの優先順位など、表形式の業務データが用途の候補になります。
XGBoost自体と、業務で使えるシステムの違いを、まず押さえておきます。
表形式データ向けの予測エンジン
XGBoostを業務で使うには、予測エンジンの仕組みだけでなく、特徴量の選び方、予測後の設計、適用の判断も決めておく必要があります。
- 予測エンジン:入力特徴量から予測値や確率を返す部分です。
- 特徴量と予測例:購入履歴、問い合わせ回数、契約期間、設備温度、曜日、在庫数から、30日以内の解約確率や翌週の需要量を求めます。
- 予測後の設計:何をいつ予測し、誰がどう行動するかを決める作業です。
- 適用判断:入力データの特性と業務上の損失を、採用の基準として見ることです。
画像・音声・長文には、別モデルで特徴を抽出する二段構成が適する場合があります。一方で、単純な条件分岐や集計で同じ判断ができるなら、機械学習を使わない方が説明しやすく、保守の負担も抑えられます。
業務システムを構成するデータ・推論・画面・運用
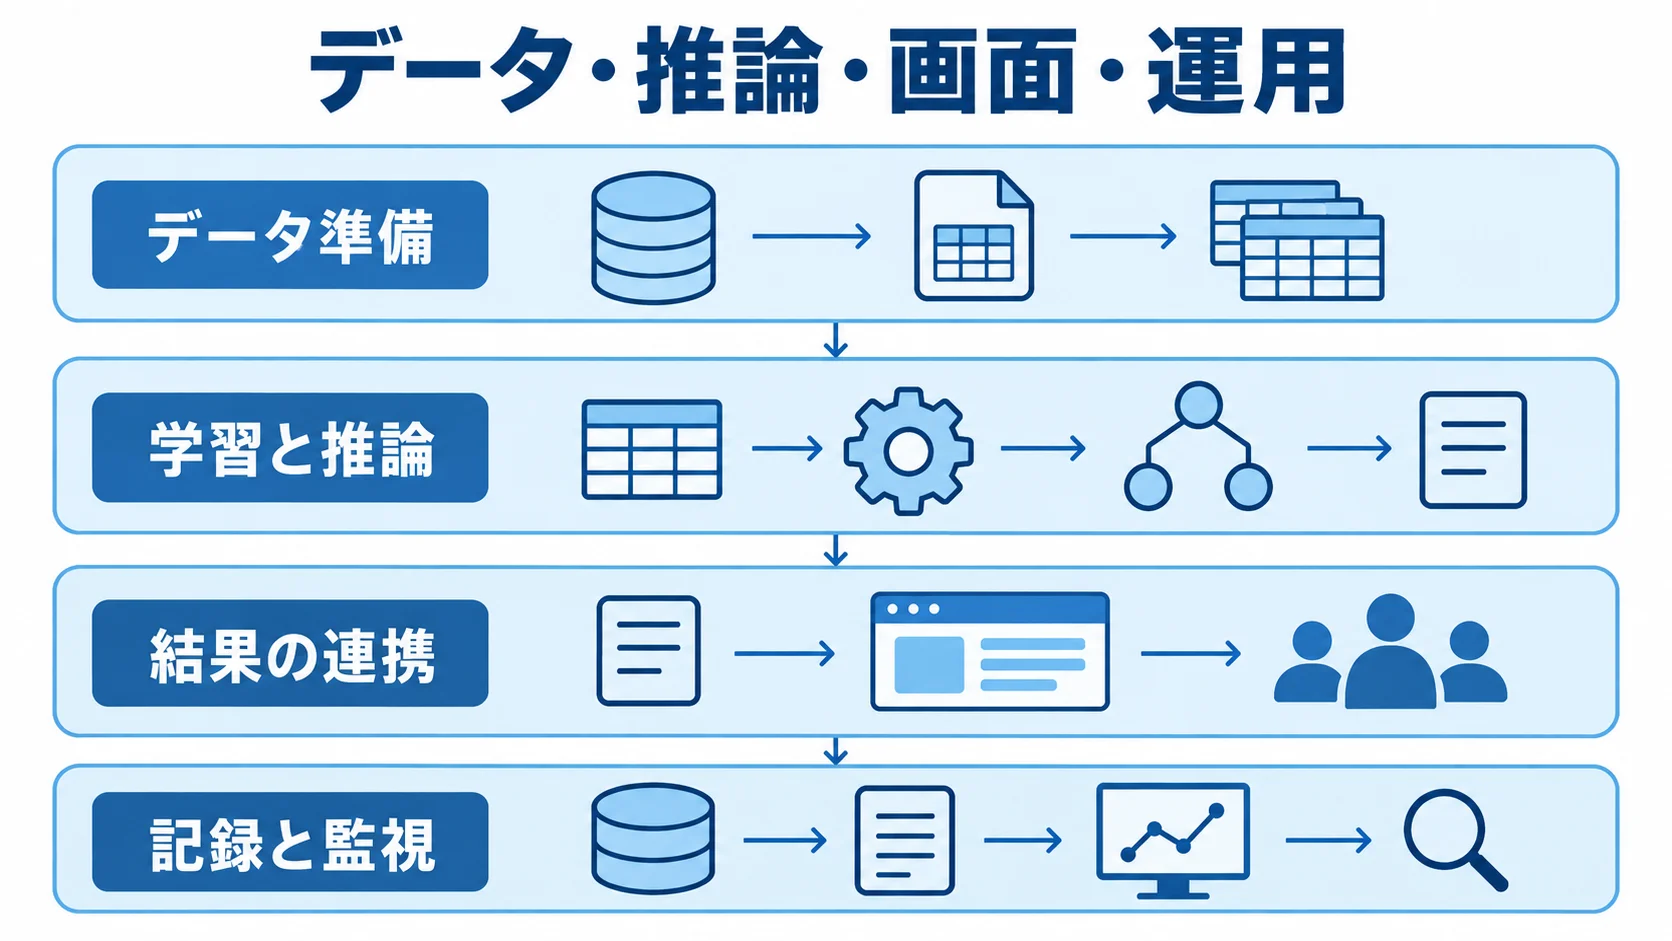
業務システムとしてXGBoostを動かすには、データの準備から結果の連携、監視までを一続きの構成として見ておく必要があります。
- データ準備:基幹システム、CRM、IoT機器、ファイルからデータを集め、欠損や重複を整えて特徴量を作ります。
- 学習と推論:学習データでモデルを作成・評価・登録したうえで、日次・時間単位のバッチか、受付時のAPIで推論します。
- 結果の連携:予測結果を業務画面、BI、メール、チャット、承認ワークフローなどに届けます。
- 記録と監視:開発・稼働時の記録と、稼働後の状態の監視。
- 運用設計:モデル作成だけで完了とせず、業務を継続して改善するための運用を、初期設計に含めます。
データセット、特徴量コード、XGBoostのバージョンを記録し、学習を後から再現できるようにします。加えて、ハイパーパラメータ、評価値、承認者、リリース日時も残します。
稼働後は、精度と入力欠損、分布の変化、推論エラー、応答時間を監視し続ける必要があります。予測を見た担当者の行動も、監視の対象に含まれます。
XGBoostのシステム開発の進め方
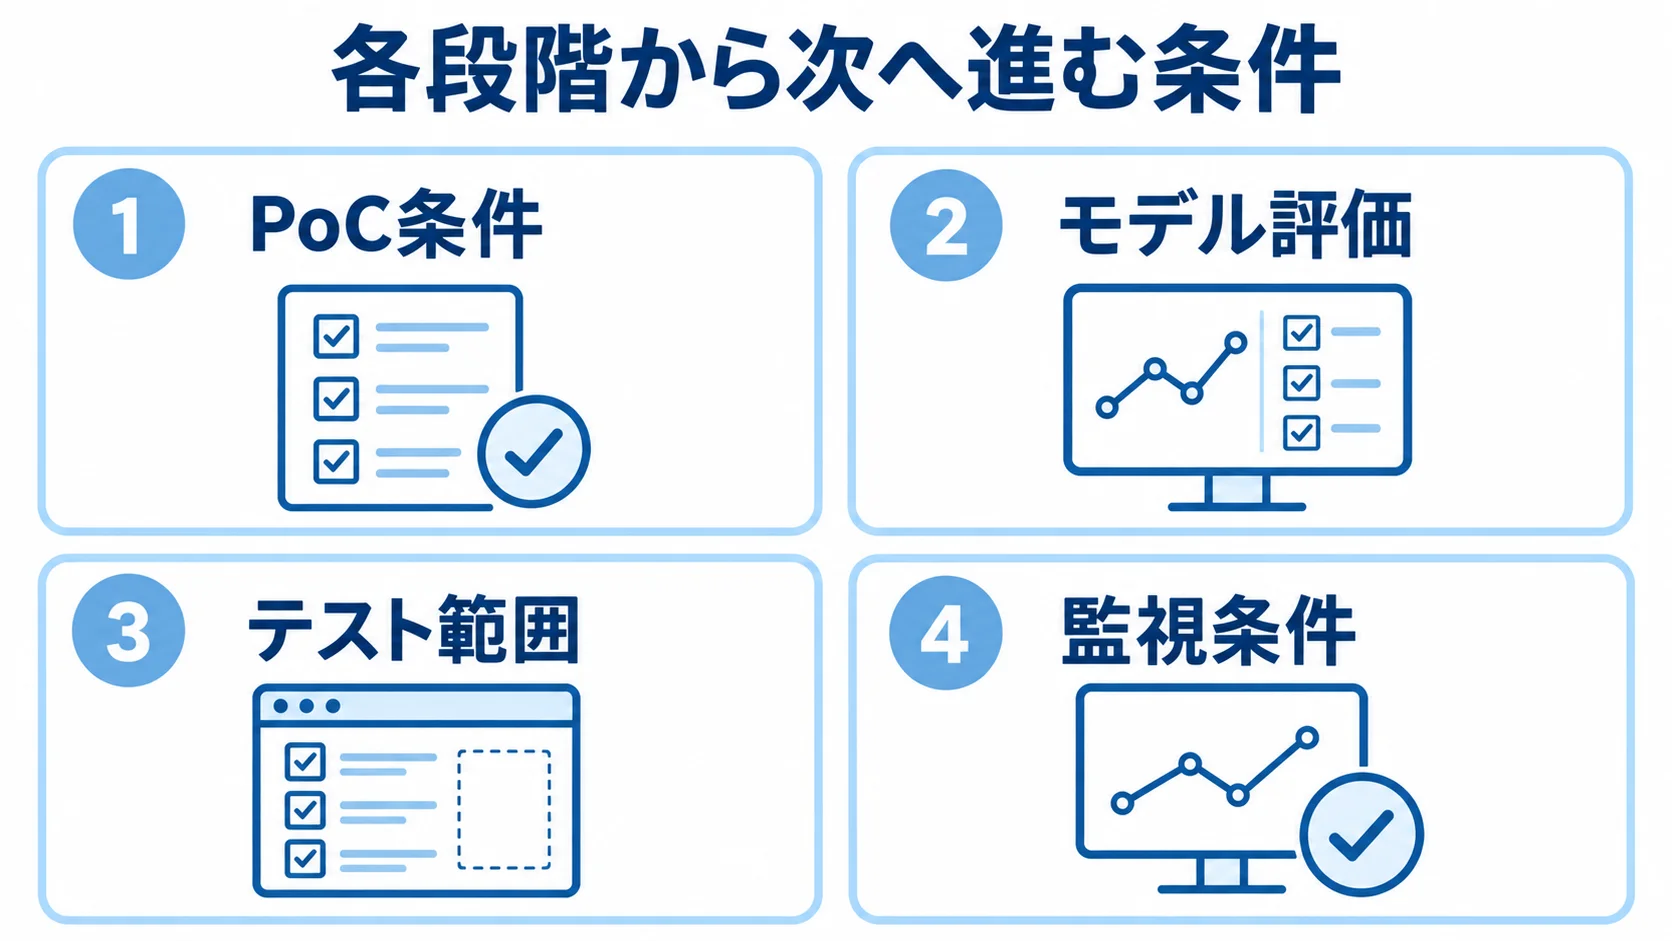
モデル作成だけを切り出して進めると、本番化の段階でつまずきます。そこで、六つの段階に分け、各段階から次へ進む条件を決めておきます。
評価指標は精度だけにせず、現場の行動と費用対効果まで含めて、関係者と合意しておきます。
フェーズ1:要件整理による予測対象と業務アクションの定義
要件整理では、改善したい判断を起点に、データの条件からPoCの合格基準まで決めていきます。
- 予測後の行動:改善したい判断を定めたうえで、解約予測の連絡時期や需要予測の発注量を決めます。
- 不正検知:保留案件を確認する担当者の決定。
- データ棚卸し:データソース、項目、更新頻度、保存期間、欠損、重複、個人情報の確認。
- PoC条件:目的、対象ユーザー、予測時点、業務KPI、データ、セキュリティ、合格基準を一覧にまとめる。
予測の後に行動がつかないテーマは、精度が高くても投資効果を出しにくくなります。また、データ棚卸しでは、正解ラベルを誰が作ったかを確認し、時系列リーク(未来の情報が混ざること)がないかも調べます。
フェーズ2:選定でのクラウド・オンプレミス・スクラッチの比較
学習、モデル登録、推論、監視を、どの基盤で運用するかを比べます。要件に応じて、次の構成から選びます。
- 社内環境:小規模な検証であれば、PythonとCPUを使い、データを外部へ出さずに試せます。
- マネージドサービス:運用の人員を抑えたい場合の候補は、SageMaker AIやVertex AIです。
- オンプレミス・ハイブリッド:認証、監査、ネットワーク境界を細かく合わせたい場合に検討します。
AWS公式資料では、SageMaker AIのXGBoostに複数の対応版があり、3.0-5を含むCPU・GPU・分散学習・推論の選択肢があります。出典はAmazon Web Servicesの公式資料「XGBoost algorithm with Amazon SageMaker AI」です(2026年確認)。
版によって対応インスタンスや入力形式が異なるため、タグをlatestにせず、XGBoost、Python、CUDA、入力形式を固定できるかを確認します。
データの保管場所、モデルの持ち出し可否、API認証、料金の課金単位を見ます。そのうえで、障害時の責任分界と将来の移行性も確認します。
フェーズ3:設計開発でのデータ処理と推論方式の実装
設計開発では、データ処理と推論方式を軸に、画面やモデル評価も含めて形にしていきます。
- 特徴量:学習用と本番用で定義やデータ処理を共通化し、スキーマの変更を検知できるようにします。
- 推論方式:日次・毎時の予測はバッチで、受付時など数秒以内の判断が要る場合は、REST APIやメッセージ連携を検討します。
- APIと画面:異常時の処理を決めたうえで、予測値や判定情報を画面で確認できるようにします。
- モデル評価:XGBoostを単純なベースラインと比べ、業務の損失に結び付く指標を選ぶ作業です。
- 再現性:データ、コード、パラメータ、評価結果を記録し、学習を再現できる状態にしておきます。
たとえば、「直近30日間の購入回数」の処理が学習時と本番時で異なると、稼働後に精度が下がる場合があります。そのため、データ変換、欠損値、カテゴリ値、時刻のタイムゾーンを共通化しておきます。また、日次・毎時の予測であれば、DWHやデータレイクからのバッチ処理が向いています。
APIの設計では、タイムアウト、リトライ、重複リクエスト、入力値の検証、予測できない場合の代替ルールを決めておきます。
画面に、予測値、判定日時、モデル版、主な寄与特徴、手動上書きの記録を表示すると、現場は判断の理由を確かめられます。
分類では適合率、再現率、F1、AUC、混同行列が、回帰ではMAEやRMSEが候補になります。
見逃しの損失が過検知の三倍なら、閾値も変わります。
フェーズ4:テストでの精度・連携・障害の検証
テストでは、モデルの評価だけでなく、本番連携、性能、安全性まで確かめておく必要があります。
- テスト範囲:単体からデータ処理、モデル評価、API・画面の結合、性能、セキュリティ、受入まで。
- 評価条件:時系列分割と不均衡データへの配慮、正解率以外の指標の確認。
- 性能・連携:本番相当のデータ量で処理時間や応答時間、同時実行数、障害時の挙動を確かめます。
- 画面・運用:予測表示、担当者の操作、通知が正しく、重複しないこと。
- 情報保護:個人情報や機密情報を扱う場合は、ログのマスキング、暗号化、権限、秘密情報の管理、脆弱性検査、委託先の再委託範囲を受入条件に含めます。
時系列データは、未来の情報を混ぜないように分割し、学習期間と検証期間を明示します。
不均衡データでは、少数クラスをすべて見逃しても正解率が高く見えるため、再現率や業務上の見逃し件数も確認します。
性能確認では、バッチ処理時間、APIの平均・P95応答時間、同時実行数を測ります。また、タイムアウトや学習失敗時の通知も検証します。
フェーズ5:稼働での段階リリースとロールバック条件の設定
稼働では、公開を止める条件と、問題が起きたときに戻す手順を事前に決めておくことが欠かせません。
- 最初から予測で自動処理はせず、参考表示や提案として現場に示したうえで、人の確認を経て業務に反映する。
- 過検知や見逃しの影響が大きい場合は、一定期間シャドー運用とし、既存の判断とモデル予測を比べる。
- 精度、エラー率、処理遅延のどの水準で公開を中止するかを、リリース前に決めておく。
- 切り替え日時、対象データ、担当者、監視項目、問い合わせ窓口を、稼働手順書に記載する。
- 旧モデルへ戻す方法と、旧業務へ戻す判断者を、稼働手順書に記しておく。
- 承認版だけを本番へ出し、モデルファイル、特徴量コード、依存パッケージ、設定値を保管すると、障害原因を追えます。
モデルを更新するときは、旧版と新版を同じ評価データで比べます。
フェーズ6:定着での監視・再学習・教育の運用組み込み
稼働後は、監視と再学習、現場の教育、責任の分担を運用の中に組み込んでおく必要があります。
- 監視条件:精度が落ちる前に、監視項目と再学習の条件を決めておく。
- 再学習の契機:定期実行のほか、ドリフトや業務ルールの変更を起点にします。
- 本番反映:再学習したモデルは、評価と承認の後にリリースし、稼働後も監視を続けます。
- 現場教育:予測の見方、手動上書き、誤判定の報告、個人情報、障害時の代替業務を扱う。
- 責任と継続判断:担当を定めたうえで、運用状況を見直し、モデルを続けるかルールへ戻すかを判断します。
正解ラベルが後から得られる場合は、精度も確認します。
すぐには分からない業務では、代理指標や人によるサンプル確認を組み合わせます。
監視対象は、入力欠損率、未登録カテゴリ、特徴量の分布、データドリフトです。さらに、推論エラー、API応答時間、バッチ遅延も見ます。
Google CloudのVertex AI資料では、モデル登録やオンライン・バッチ推論が整理されているほか、トレーニング提供時の偏りや推論ドリフトの監視も扱われています(出典: Google Cloud「Introduction to Vertex AI」、2026年確認)。
責任分界は、データ所有部門、モデル評価のデータサイエンティスト、基盤監視のインフラ担当、画面保守の開発会社に分けます。
再学習の判断者がいないと、モデルは短期間で古くなります。
月次レビューでは、予測利用率、施策実行率、誤判定損失、処理時間、運用費を材料にします。
▶ 詳細はこちら:XGBoostのシステムの進め方
XGBoostのシステム開発にかかる費用相場
XGBoostはオープンソースですが、ライブラリ購入費だけで開発費は決まりません。
費用の中心は、データ整備やラベル設計です。
費用に含まれるのは、特徴量作成、モデル評価、APIまたはバッチ、業務画面です。
インフラ、セキュリティ、監視、保守も対象になります。
次に示す金額は、XGBoostの公表標準価格ではありません。リサーチノートの人月単価・工程と、公開AI基盤の価格例から整理した推定です。
検証から本番までの段階ごとの費用レンジ
費用と期間の目安は、開発の範囲が広がるにつれて大きくなります。
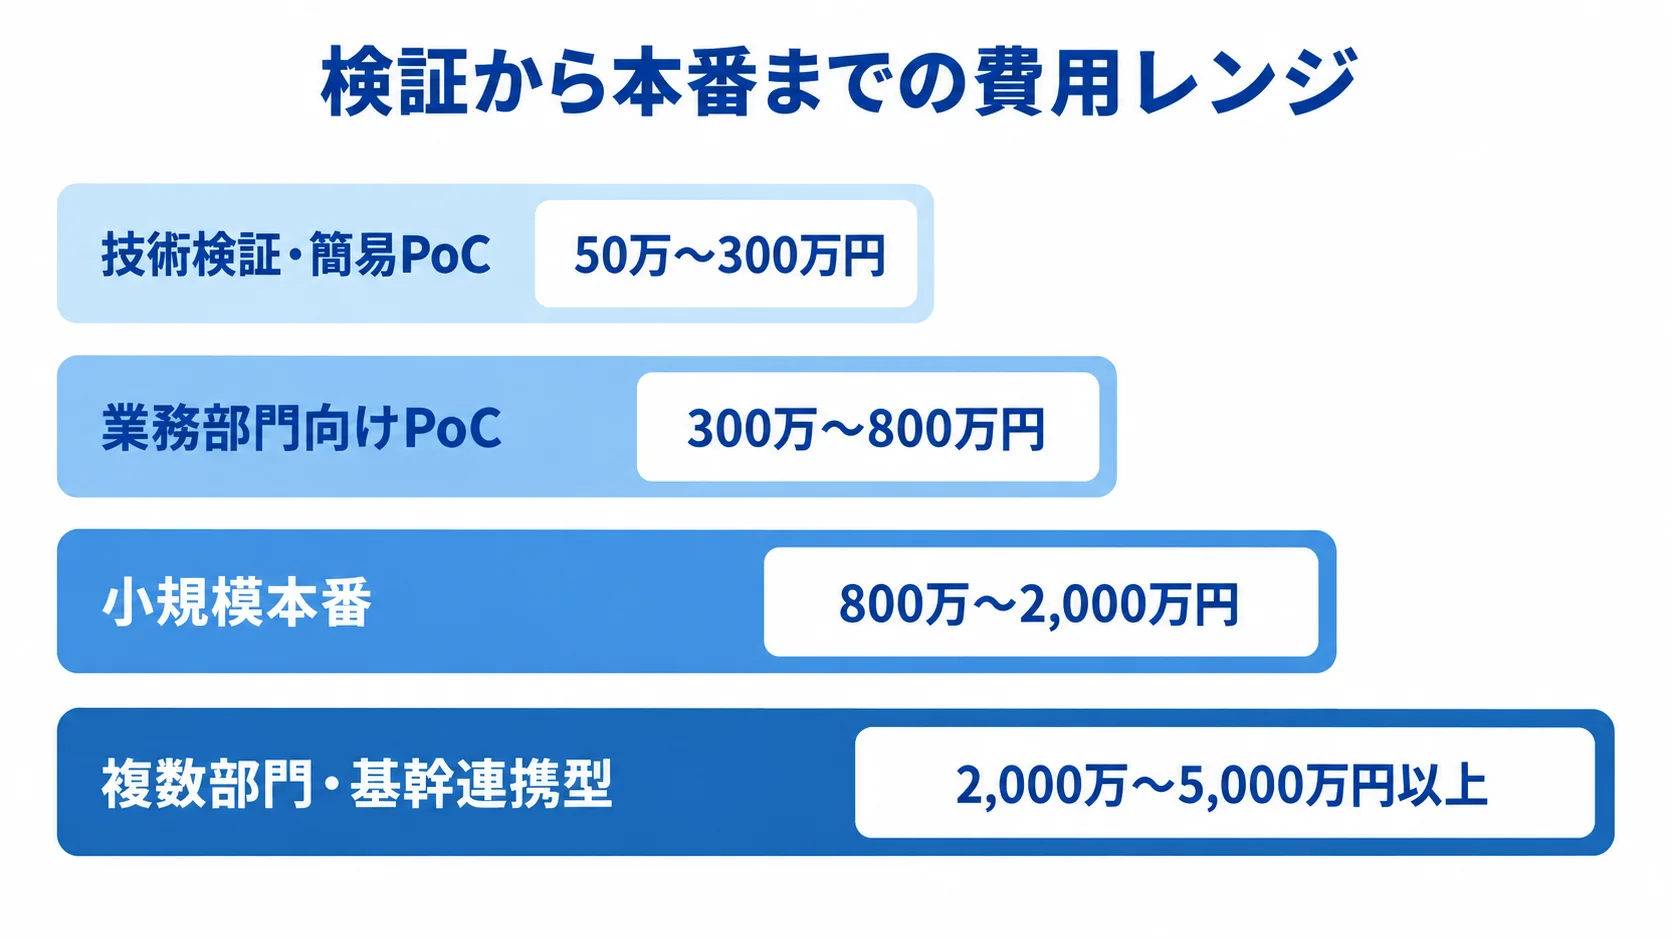
- 技術検証・簡易PoCは50万〜300万円程度で、期間は1〜2か月程度が目安です。
- 業務部門向けPoCは、複数データソース、ラベル設計、学習・評価、簡易ダッシュボードまたはバッチ出力を含み、300万〜800万円程度、2〜4か月程度が目安です。
- 小規模本番は、ETL、モデル版管理、APIまたはバッチ推論、権限、ログ、業務画面、再学習手順を含み、800万〜2,000万円、3〜6か月程度です。
- 複数部門・基幹連携型は、2,000万〜5,000万円以上、6〜12か月以上の場合があります。
- 金額は、データソース数、過去データの整備、ユーザー数、推論頻度、可用性、セキュリティ要件で変わります。見積もりは、対象範囲をそろえて比べます。
簡易PoCでは、手元のデータで特徴量を試作し、複数のモデルを比べて精度を確認します。ただし、画面、認証、本番監視、正式なデータ連携は、原則として含まれません。
この段階で、XGBoostを使う意味を判断します。欠損やラベル不足があれば、モデル開発より先にデータ整備を行います。
複数部門・基幹連携型には、冗長化、監査証跡、リアルタイム連携、MLOps、段階移行、運用SLAが含まれます。
見積もりの内訳(データ・モデル・アプリ・基盤)
費用の内訳は、次の作業ごとに分けて提示してもらいます。「AI開発一式」や「XGBoost組み込み一式」のように一式でまとめられると、完成範囲を判断しにくくなります。
- 企画・データ:要件定義、企画、データ棚卸し、クレンジング、ラベル作成
- モデル:特徴量設計、学習・評価、モデル登録
- アプリ・基盤:API・バッチ、業務画面、認証・権限、テスト、クラウド・オンプレミス
- 運用:監視、教育、保守
- 人月単価の参考:フリーランス50万〜80万円、中小開発会社80万〜120万円、大手SIer150万〜200万円程度です。
実際の単価は、役割、地域、契約形態、専門性、品質条件によって変わります。さらに、人数、期間、成果物も確認します。
公開資料には、GPUドライバーや学習フレームワークの導入が30万円〜の例があります。また、GPU管理環境の設計・構築が300万円〜、AIアプリ開発支援が300万円〜の例もあります。
運用Q&Aは年間150万円〜の例です(出典: エフサステクノロジーズ「AI開発環境・GPUリソース管理」、2026年確認)。これらはXGBoost専用の価格ではないため、比較の材料として扱います。
再学習と監視の頻度によるランニングコスト
稼働後の費用は、次の運用項目や構成によって変わります。
- 運用作業:推論用計算資源、学習ジョブ、データ・ログ保存、監視、バックアップ、問い合わせ、障害対応、再学習、モデル評価、セキュリティ更新が発生します。
- 保守費の目安:一般的な業務システムでは、初期開発費の年間15〜25%を起点に見積もる方法があります。
- 変動要因:XGBoostでは、再学習回数、クラウドの常時稼働、監視時間帯、正解ラベルの確認作業によって保守費が変わります。
- CPU・GPUの選択:GPUの追加費用と、学習時間の短縮効果を比べます。
中規模の表形式データでは、CPUで十分な場合も多く、初めからGPUを前提にする必要はありません。
GPUは学習時間を短縮できる反面、利用料、ドライバー、コンテナ、監視、運用知識が増えます。そのため、学習時間の短縮が業務価値や費用削減につながるかを測定します。
XGBoost 3.0.0は2025年2月27日に公開され、外部メモリやカテゴリデータなどが更新されました(出典: XGBoost公式リリースノート、2025年)。
保守計画では、採用版を固定し、アップデートの検証費用も含めます。
XGBoostのシステム開発で見積もりを取る際のポイント
見積もりは合計金額だけでなく、前提条件、成果物、除外事項、責任分界、追加費用の条件まで確認します。
データ品質やラベル定義は後から変わりやすく、要件を削りすぎると本番前に連携の追加が起きます。
不確定項目を明示し、検証と本番開発を分けた提案同士を比べると、予算超過の原因を把握しやすくなります。
発注前に整理する予測対象・データ・利用者
見積もりの前提をそろえるには、予測の内容、データ、依頼条件を発注前に整理しておくことが大切です。
- 予測範囲:対象、期間、頻度、件数、正解ラベルを、それぞれ決めます。
- データ条件:データソース、更新頻度、欠損率、共有できる情報の確認。
- 利用条件:ユーザー数、既存連携、需要予測の粒度、解約予測の対象外と観測期間を定める。
- 依頼書:依頼書に書く内容は、業務課題、現行フロー、予測後の行動、KPI、稼働時期、セキュリティ条件です。
- 受入・運用条件:精度目標は「90%以上」の一言で済ませず、誤判定コスト、許容する見逃し、処理時間と合わせて示す。
需要予測の粒度は、商品・拠点・日次などの単位から選びます。
全データを渡せない場合も、項目一覧、件数、期間、サンプルの匿名化方針を共有すると、見積もりの前提がそろいます。
依頼書には、クラウド利用の可否、ソースコードやIaCの納品要否、運用担当者、保守時間帯も明記します。
精度目標などの条件をそろえておくと、提案会社の評価を同じ条件で比べられます。
モデル以外の本番運用力による開発会社の比較
候補会社については、XGBoostを使った経験に加えて、本番運用までの担当範囲を確認します。
- 本番運用の経験:データ基盤、API・バッチ、業務画面、認証、監査ログ、MLOps、保守の担当範囲。
- 関連実績:専用の実績がなくても、表形式予測、版管理、再学習、ドリフト監視、既存連携の経験を要件に生かせるかを質問する。
- 納品物:担当者の経歴に加えて、設計書、評価レポート、テスト計画、運用手順書を納品できるかを確認する。
- 比較条件:要件整理、PoC合格条件、データ保管場所、対応クラウド、オンプレミス、モデル持ち出し、障害時SLA、再学習責任者、課金単位を比べます。
- 業務シナリオ:同じサンプルで、誰がどの画面で予測を見て何をするかを確かめる。精度だけで競わせると、使われない高価なPoCを選ぶ危険があります。
契約・セキュリティ・追加費用のリスクの明記
契約・セキュリティと追加費用は、次の項目を明記してもらい、確認します。
- データ・委託:学習データの所有権、個人情報の委託範囲、再委託、クラウドのリージョン、ログ保存期間。
- 権利・安全管理:モデルと特徴量コードの権利、OSSライセンス、脆弱性対応、事故時の連絡、契約終了時の返却・削除。
- 指針の参照:ガイドラインは、リスク管理の参照枠として使えます(出典: 経済産業省・総務省「AI事業者ガイドライン第1.2版」、2026年3月31日)。
- 追加費用:費用が追加される条件を、事前に定めておきます。
AI事業者ガイドライン第1.2版は、XGBoostの利用に一律の手続きを課す法律ではありません。目的、責任者、透明性、セキュリティ、委託先管理を整理するときに、その内容を照らし合わせて使います。
追加費用の条件には、データソース追加、ラベル作成のやり直し、連携API変更、画面追加を含めます。さらに、リアルタイム化、GPU化、24時間監視、精度再検証、セキュリティ基準の追加も、条件に加えます。
特に、要件定義を削りすぎると、業務システム全般で追加の工数や費用が当初見積もりの1.3〜1.5倍に膨らむリスクがあります。
未確定事項は、予備工数として切り分けるか、PoCで確定させます。あわせて、変更管理の承認者と単価も契約書に記載します。
よくある質問(FAQ)
開発の進め方と発注に関する疑問に答えます。データ、業務リスク、既存基盤、利用者体制に応じて、受入条件を検討します。
XGBoostのシステムはデータが少なくても作れますか?
作れる場合もありますが、件数だけでなく、予測対象の偏り、ラベルの正確さ、期間、データの変化を確認します。
少量のデータでは、単純なベースラインと比べ、時系列分割や交差検証で評価します。そうすることで、過学習や偶然の精度向上を避けます。
不足がある場合は、ラベル設計と収集計画をPoCの成果物にします。
XGBoostのシステム開発にGPUは必要ですか?
必須ではありません。中程度の表形式データで、学習の頻度や探索の回数が多くなければ、CPUで費用と構成を抑えられる場合があります。
大規模データや反復学習では、GPUが時間を短縮することがあります。ただし、料金に加えて、ドライバー、コンテナ、監視、人材費も比べる必要があります。
CPUと比べて、処理時間と総費用を見たうえで決めます。
PoCから本番システムへ移行するときの注意点は何ですか?
まず、PoCの評価データと本番の入力データで、特徴量やラベルの定義が一致するかを確認します。
そのうえで、API・バッチの処理時間、権限、ログ、監視を、本番向けに追加で設計します。さらに、再学習、手動上書き、ロールバック、運用担当者も設計に含めます。
本番化の判断では、精度に加えて、現場の業務が変わったか、安全に戻せるか、継続費用を負担できるかを合格条件に置きます。
XGBoostの予測理由を業務担当者へ説明できますか?
業務担当者に予測理由を説明するには、理由の表示の仕方と、利用後の対応を決めておく必要があります。
- 寄与の表示:特徴量重要度やSHAPで予測に寄与した特徴を示し、因果ではなくモデル上の寄与と伝えます。
- 入力データ:入力に誤りがあると、予測結果も変わってしまいます。
- 重要な判断:人の確認、手動上書き、異議申立て、判断履歴の保存を設けておく。
- 活用先:説明可能性を、監査と業務改善の両方に使う。
まとめ
XGBoostのシステムは、モデルだけでなく業務基盤です。データ収集から特徴量作成、学習・評価、版管理、推論までを含みます。さらに、画面、監視、再学習、現場定着まで含めて考える必要があります。
進め方は、要件整理、選定、設計開発、テスト、稼働、定着の六段階に分け、各段階の合格条件を決めて進めます。
成果を左右する精度以外の設計
費用の幅を把握し、見積もりの範囲と基盤構成を合わせて判断します。
- 推定レンジ:技術検証・簡易PoCは50万〜300万円、業務部門向けPoCは300万〜800万円です。
- 本番の推定レンジ:小規模本番は800万〜2,000万円、複数部門・基幹連携型は2,000万〜5,000万円以上です。
- 見積もり条件:XGBoost固有の確定相場ではありません。データ整備、連携、画面、監視、保守を分けて前提をそろえます。
- 基盤選択:GPUやクラウドは、目的と処理量に応じて選び、必要以上に初期構成を大きくしないことが大切です。
発注準備で1枚にまとめる予測対象・データ・業務アクション
発注の準備では、予測の目的と運用条件を一枚にまとめ、関係者で共有します。
- 発注前に、予測対象、データ、正解ラベル、予測後の行動、許容する誤判定、推論頻度を整理します。
- セキュリティ条件と運用担当者もまとめ、PoCで確かめる範囲と本番範囲を分けて示します。
- 比較しやすい提案を受けたうえで、ドリフト、再学習、モデル承認、ロールバックも設計し、現場で使い続けられるシステムに育てていきます。
▼全体ガイドの記事
・XGBoostのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。