
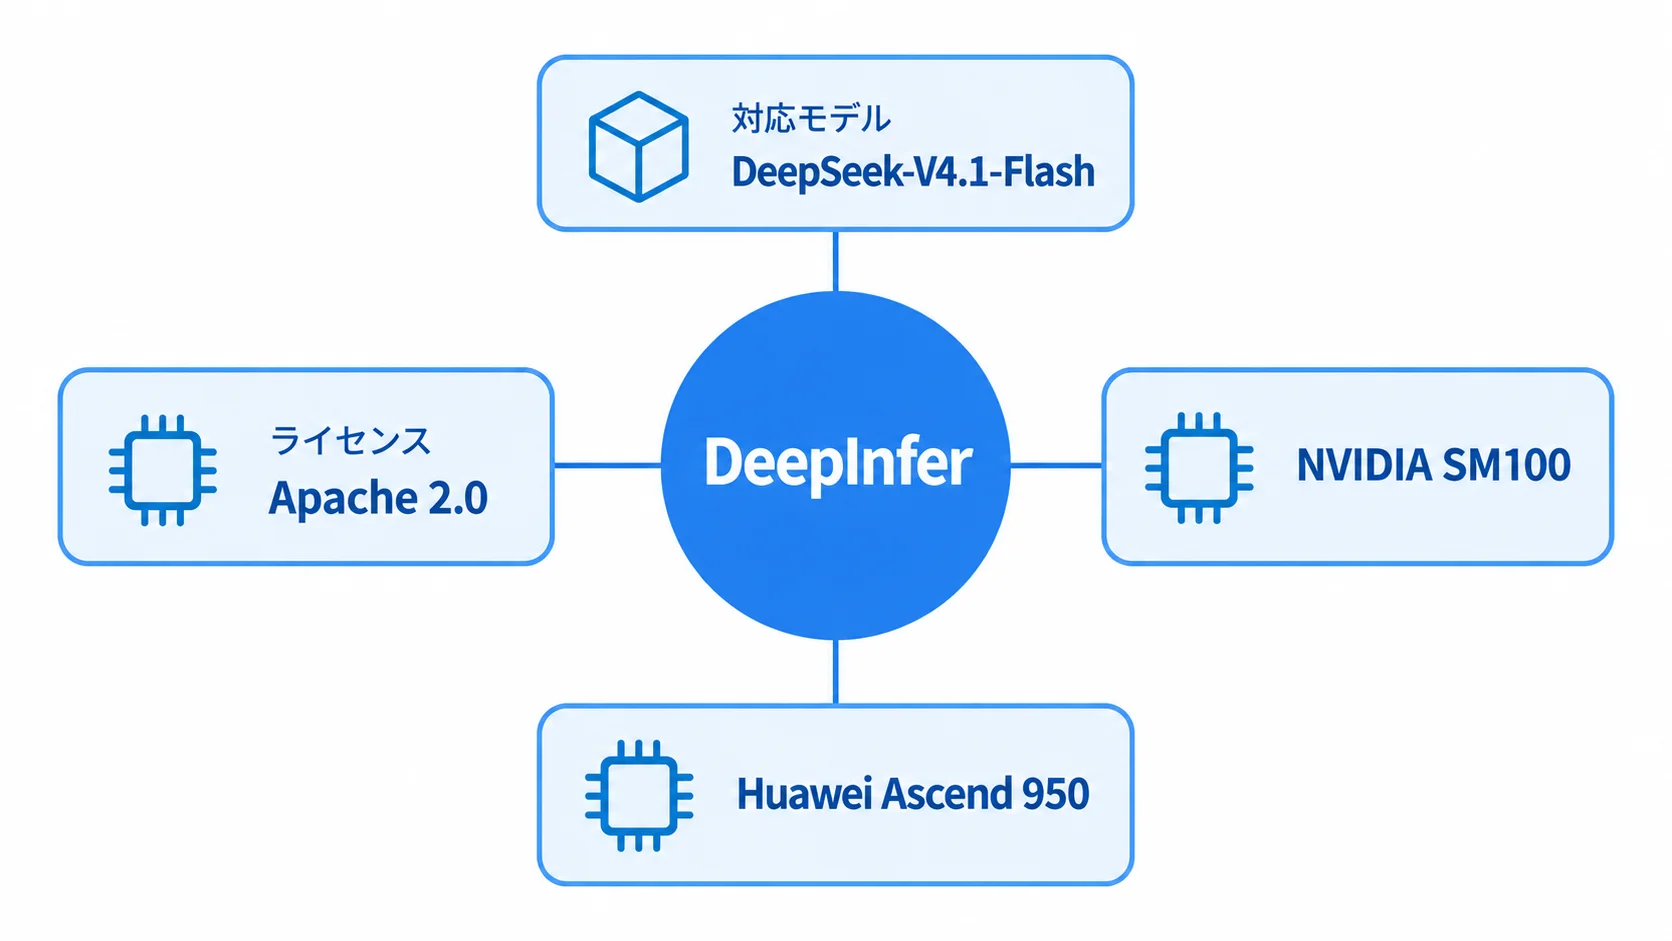
DeepSeekは2026年10月20日、大規模本番サービスを支える推論フレームワーク「DeepInfer」をオープンソース化しました。対応モデルはDeepSeek-V4.1-Flashの1モデルです。
DeepInferはNVIDIA SM100 GPUとHuawei Ascend 950 NPUの両方に対応し、投機的デコード、再計算の抑制、非同期スケジューリング、構造化出力などを備えます。
モデルを呼び出すAPIだけでなく、推論処理そのものを自社で組み立てたい企業にとって選択肢になります。
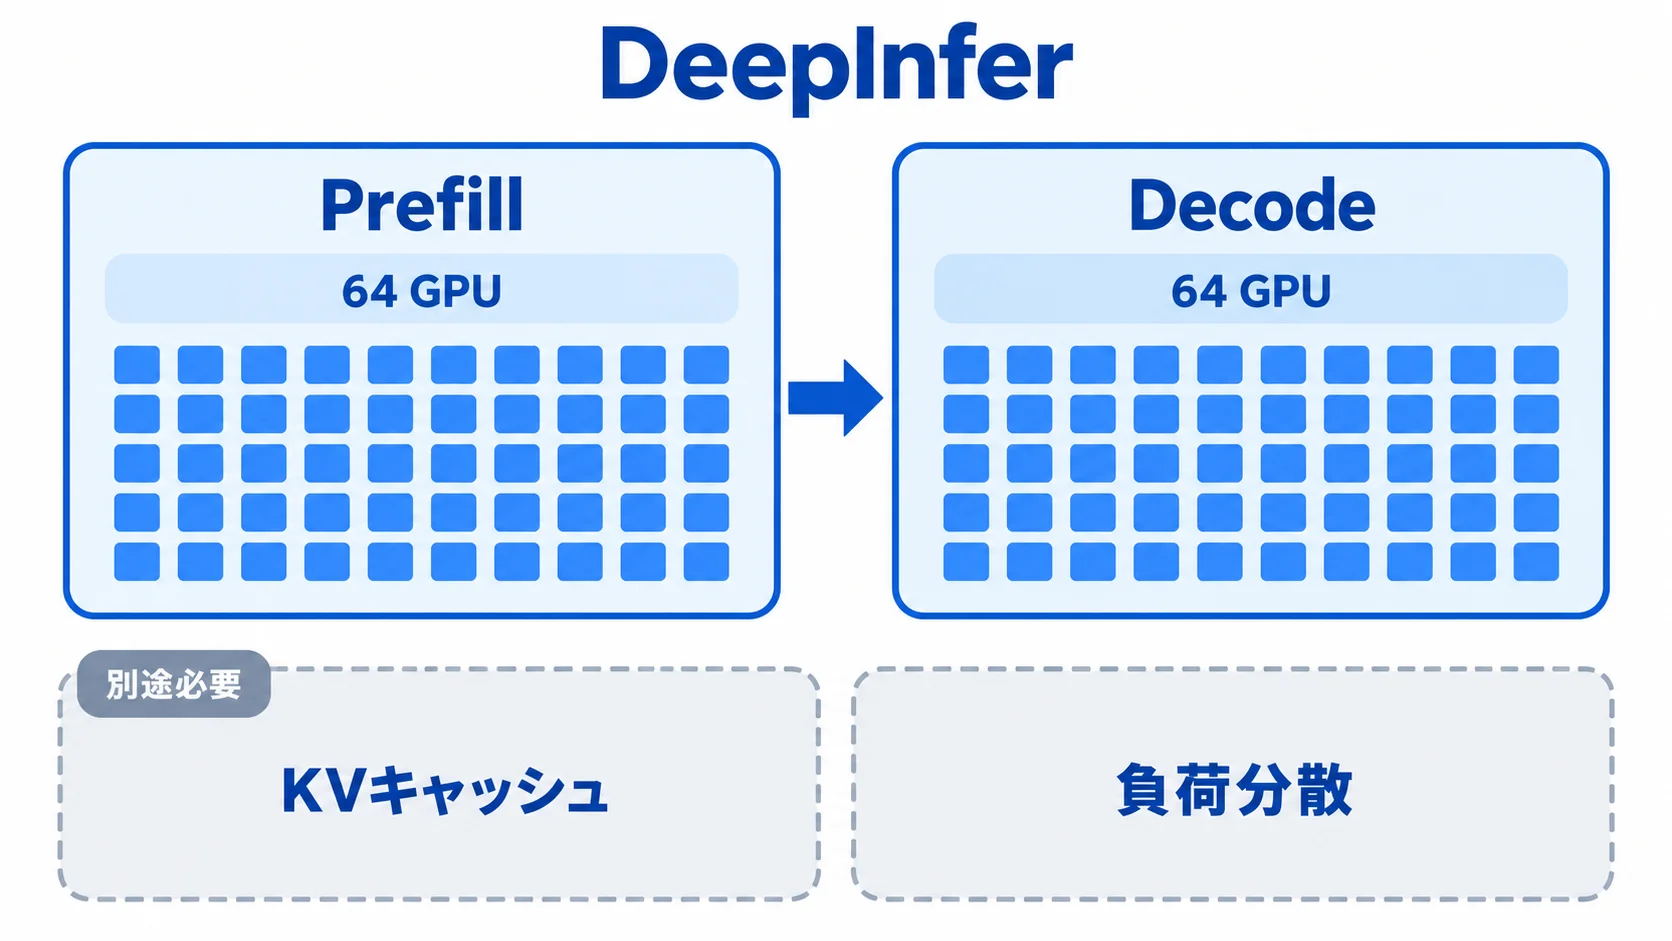
ただし、OSS化されたコードだけで大規模なオンライン推論サービスが完成するわけではありません。KVキャッシュシステム、PrefillとDecodeの分離、負荷分散は別途必要で、公式Q&Aが示す効率的な最小構成もPrefill 64 GPUとDecode 64 GPUです。
※本記事は2026年10月21日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
DeepInferとは|V4.1-Flash向けの推論基盤をApache 2.0で公開
DeepInferは、DeepSeekが大規模サービスで使う推論フレームワークにあたります。READMEは、スケールしたサービングに必要なコア機能を備えたオフライン推論向けのOSSです。対応モデルを広く受け入れる汎用サーバーではなく、DeepSeek-V4.1-Flashに合わせた実装と説明されています。
デフォルトのチェックポイントはdeepseek-ai/DeepSeek-V4.1-Flash-1017です。初回実行時にHugging Faceのキャッシュへダウンロードするほか、ローカルのモデルディレクトリを指定してネットワークなしで動かせます。重みを自社環境へ置く場合は、推論エンジンとモデル重みを別々のソフトウェアとして管理します。
DeepInferのライセンスはApache License 2.0です。一方、DeepSeek-V4.1-Flash-1017のモデルリポジトリはMIT Licenseと表示されています。エンジンの改変・再配布条件と、モデル重みの利用条件を同じものとして扱わないことが、商用利用の最初の確認項目です。
モデルの仕様やAPI料金を含む選択肢全体を見直すときは、DeepSeek V4の仕様とAPI料金も比較材料になります。APIを使うのか、自社のGPUで推論するのかで、費用の見方と運用責任は変わります。
ポイント
DeepInferはV4.1-Flashに特化した推論エンジンです。Apache 2.0のエンジンとMITのモデル重みを分けて、利用条件を確認します。
機能|DSparkと非同期処理で推論の待ち時間を削る
DeepInferの特徴は、推論計算やCPU待機を減らす機能を、個別のカーネルだけでなく実行エンジンまで含めてまとめている点です。
最適化カーネル、MoEのExpert ParallelismとEPLB、SWA bounded replay、非同期スケジューリングが組み合わさります。
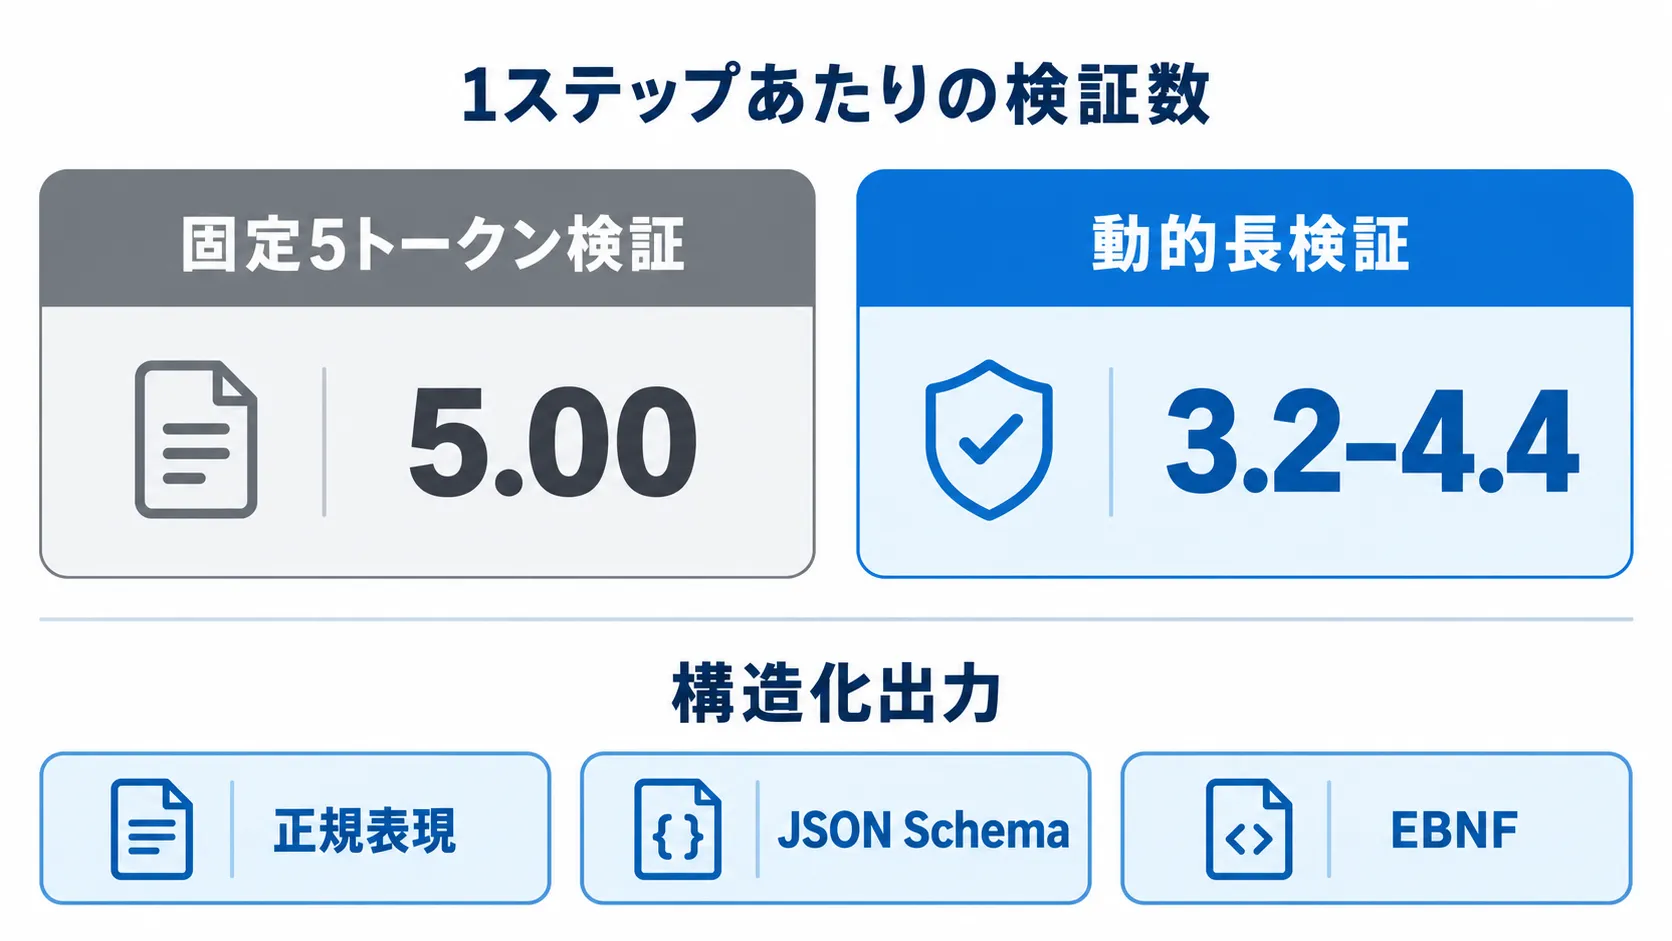
DSparkはドラフトトークンを先に作り、Confidence Headが見積もる受理確率を使って検証する仕組みです。公式Q&AのEP64/DP64ベンチマークでは、固定5トークン検証に対し、動的長検証の1ステップあたりの検証数は5.00から3.2–4.4へ減りました。rankあたり約60同時系列の本番動作点ではスループットが+4–7%です。
この数値は、単一リクエストの速度ではなく、同時実行数とハードウェア構成を含む測定です。PoCでは平均値だけを追わず、低負荷・高負荷それぞれで、TTFT、1秒あたりの出力トークン数、ドラフトの受理率を記録します。
構造化出力は正規表現、JSON Schema、EBNFを指定できます。生成後の文字列を別の検証処理で直す設計に比べ、業務APIの返却形式を推論時に制約できるため、JSON連携の失敗率や再試行回数を測定しやすい構成です。
ポイント
DSparkの効果は同時実行数と受理率で変わります。自社の業務APIでは、速度だけでなく構造化出力の失敗率と再試行回数まで測定します。
対応環境|SM100とAscend 950に絞ったビルド前提
対応アクセラレーターはNVIDIA SM100 GPUとHuawei Ascend 950 NPUです。実行環境はLinux、GCC 13.0以上、Python 3.12が前提で、NVIDIAはCUDA 13、AscendはCANN 9.2を使います。Pythonのバージョンだけ合わせれば動く構成ではありません。
| 項目 | NVIDIA | Huawei Ascend |
|---|---|---|
| 対応アクセラレーター | SM100 GPU | Ascend 950 NPU。 |
| 専用ランタイム | CUDA 13 | CANN 9.2。 |
| バッチ不変推論 | 対応 | READMEでNVIDIAのみ。 |
| 決定的サンプリング | 対応 | READMEでNVIDIAのみ。 |
ビルド時はDEEPINFER_ACCELERATOR=nvidia、AscendではDEEPINFER_ACCELERATOR=ascendを指定します。アクセラレーターをまたいだ移植性を期待する場合も、出力の再現性を同じ条件で扱えるとは限りません。特にバッチ構成が変わっても結果をそろえたい業務では、ハードウェアごとの挙動を分けて評価する必要があります。
この前提は、一般的なGPUクラウドの空きインスタンスへ載せるだけの導入とは異なります。既存のGPU資産を使うなら、SM100に該当するか、CUDA 13まで更新できるか、ドライバーや周辺カーネルを含む検証環境を確保できるかが確認事項です。
ポイント
DeepInferはSM100またはAscend 950を軸にした基盤です。モデル要件だけでなく、CUDA 13/CANN 9.2を含むビルド環境を調達計画へ入れます。
自社ホスティングの壁|KVキャッシュと分離基盤が別途必要
DeepInferの導入判断で見落としやすいのは、推論エンジンの外側です。
READMEは、完全な推論サービスに必要なKVキャッシュシステム、Vision Encoder/Prefill/Decodeの分離、データ並列レプリカ間の負荷分散が公開版に含まれないと説明しています。
公式Q&Aの参照アーキテクチャでは、PrefillはEP2–8/DP2–8、DecodeはEP64–128/DP64–128です。1P + 1Dはデプロイ可能ですが、推奨Decode構成がEP64以上のため、効率的な最小構成はPrefill 64 GPUとDecode 64 GPUになります。
KVキャッシュもメモリ上の一機能ではありません。DeepSeekの大規模サービス設計では、Paged block KV cacheを専用の3FSストレージクラスターへ置き、オンラインGPU 1台あたり論理サイズで約14.4 TBを目安にしています。エージェントのTTLは3日、チャットボットは7日です。
これはDeepInfer単体の必要容量を示す数字ではなく、DeepSeekが説明する大規模サービス側の設計です。自社で同じ構成を採るか、別のキャッシュ基盤へ置き換えるかを決める際の比較軸になります。ネットワーク帯域、ストレージの障害復旧、キャッシュの削除方針まで含めて設計しないと、GPUだけ増やしても効果を再現できません。
ポイント
DeepInferのOSSコードだけでは本番サービスの構成要素がそろいません。KVキャッシュ、分離配置、負荷分散を誰が担うかを決めてから、GPU台数と費用を見積もります。
導入手順|オフライン推論から分散PoCへ段階的に測る
自社ホスティングを検討する場合は、いきなり本番相当のクラスターを組まず、評価を段階に分ける進め方です。DeepInferのExamplesには、モデルをローカルディレクトリから読むオフライン推論、構造化出力のチェック、PrefillとDecodeを分けたベンチマークが用意されています。
- 前提確認:Apache 2.0のエンジン、MITのモデル重み、利用するハードウェアとランタイムの条件を分けて整理します。
- 単体評価:ローカルモデルで正常終了、出力品質、JSON Schema・正規表現・EBNFの形式遵守が測定対象です。
- 再現性評価:NVIDIA環境でバッチ構成を変えたときの結果、固定
seq_seedを使った決定的サンプリングが比較対象です。 - 分散評価:同時実行数、長文入力、キャッシュヒット、TTFT、出力トークン数、障害時の再ルーティングを測ります。
費用はGPUの時間単価だけで決めません。推論向けクラウド支出が拡大する背景は、AI推論向けクラウド支出の見方で整理できます。
入力・出力・キャッシュを分ける生成AIの従量課金の考え方を使い、GPU、ストレージ、ネットワーク、監視、更新の費用を別々に積み上げます。
同じ品質をより少ない計算資源で実現できる可能性も比較項目です。小型モデルでAIアプリの採算を合わせる考え方と同じく、モデルの大きさより、業務の正答率・出力形式・レイテンシ・運用コストを一つの評価表にそろえることが判断を早めます。
ポイント
最初に測るのはモデルの順位ではなく、自社タスクの合否条件です。オフライン推論、形式遵守、再現性、分散時の性能と障害対応を順番に評価します。
よくある質問
Q. DeepInferが対応するモデルは何ですか?
対応モデルはDeepSeek-V4.1-Flashの1モデルです。デフォルトのチェックポイントはdeepseek-ai/DeepSeek-V4.1-Flash-1017と指定されています。
Q. DeepInferは一般的なGPUサーバーで動かせますか?
NVIDIA SM100 GPUまたはHuawei Ascend 950 NPUが対応ハードウェアです。Linux、GCC 13.0以上、Python 3.12に加え、NVIDIAはCUDA 13、AscendはCANN 9.2を使います。
Q. DeepInferだけで本番の推論APIを構築できますか?
KVキャッシュ、Vision Encoder/Prefill/Decodeの分離、レプリカ間の負荷分散は公開版に含まれません。これらの基盤を別途用意する必要があります。
Q. DeepInferのライセンスは何ですか?
DeepInferはApache License 2.0です。DeepSeek-V4.1-Flash-1017のモデルリポジトリはMIT Licenseと表示されているため、エンジンとモデル重みを分けて利用条件を確認します。
まとめ
DeepInferは、DeepSeek-V4.1-Flashの大規模推論に使う実行基盤をApache 2.0で公開したものです。SM100とAscend 950を対象に、DSpark、SWA bounded replay、非同期スケジューリング、構造化出力などを提供します。
自社ホスティングでは、対応ハードウェアとランタイムに加えて、KVキャッシュ、PrefillとDecodeの分離、負荷分散を用意する必要があります。まずはオフライン推論と構造化出力を測り、その後に分散環境で性能・費用・障害対応を評価する進め方が現実的です。
ポイント
DeepInferの評価単位はOSSリポジトリではなく、モデル、アクセラレーター、キャッシュ、ネットワーク、運用を含む推論サービス全体です。
関連記事
- DeepSeek V4を解説|Pro・Flashの仕様とAPI料金、企業導入のポイント
- Mistral Large 4を解説|1兆パラメータのオープンウェイトモデルと自社運用の選択肢
- 小型モデルで十分な時代を解説|低価格モデルでAIアプリの採算が合う理由
- AI推論向けクラウド支出96%増予測を解説|学習から推論への投資シフト
- 生成AIの従量課金・推論モードを解説|コスト管理のポイント
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。