
Calvin French-Owen氏は2026年8月26日、小型モデルGPT-5.6 Lunaを数週間使った体験を紹介しました。コードベースやメール、ナレッジベースを扱う速度は約100 tokens/秒で、個人向けニュースサイトを作る実験では平均API費用が約0.10ドル(約15円)だったとしています。
これは個人の実験結果ですが、AIアプリの推論費用が採算を左右するという問題を端的に示します。リクエストを受けるたびに高価なモデルを呼び出すと、利用者が増えるほど原価が膨らむ構造です。
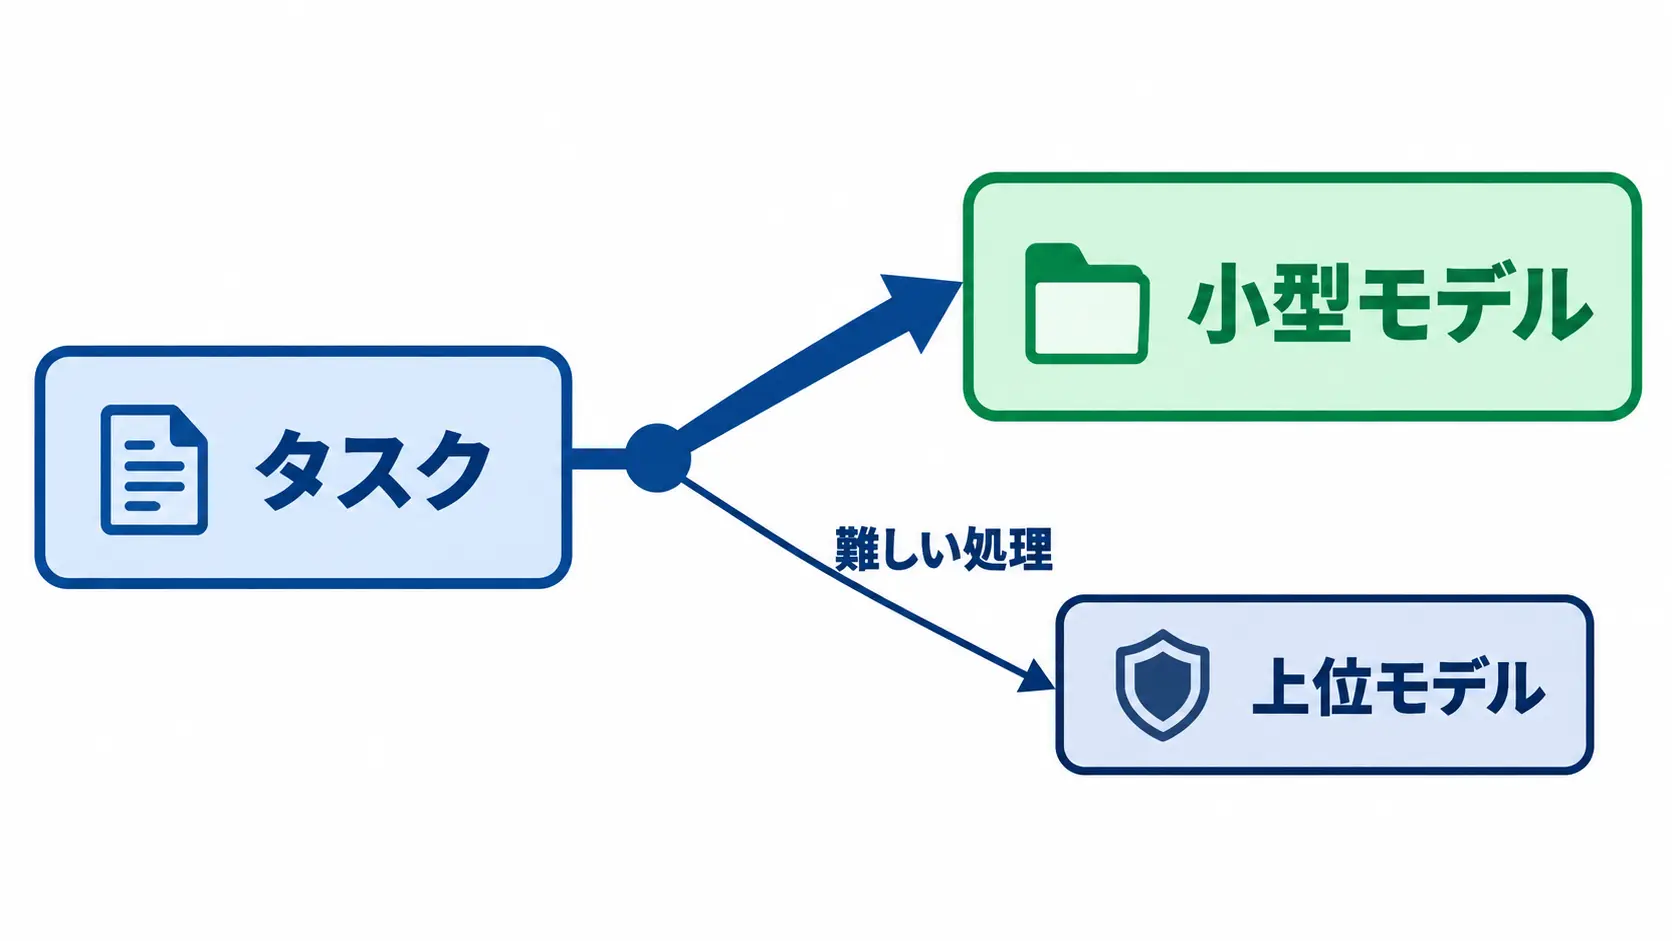
OpenAI、Anthropic、Googleはいずれも、低価格モデルを高頻度・大量処理向けに位置づけています。Anthropicは要約・分類・ルーティングのような範囲を絞った処理も用途に挙げています。小型モデルへの一括置換はしません。品質基準を満たせる工程だけを切り出し、難しい判断は上位モデルや人間へ回します。
※本記事は2026年10月14日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
小型モデルが注目される理由|速度と単価がAIアプリの前提を変える
GPT-5.6 Lunaの体験談が注目されたのは、単価だけでなく、応答回数を増やせる速度が示されたからです。起点記事では、数千件のメール検索でもAPI費用は数十セント(数十円程度)に収まったと紹介されています。
個人向けニュースサイトの実験では、従来のSonnetクラスが平均約1ドル(約150円)、Lunaが平均約0.10ドル(約15円)だったと紹介されました。
この金額は著者自身の実験結果です。自社の原価に置き換えるときは、入力と出力のトークン数、会話履歴の長さ、再試行、外部ツールの呼び出しを分けて記録してください。
OpenAIはGPT-5.6 Lunaをコストに敏感な大量処理向けと位置づけ、関数呼び出し、構造化出力、Web検索、ファイル検索、コードインタープリターなどをサポート対象にしています。低価格でも、単純な一問一答に限らず、設計したワークフローの一部を担える構成です。
価格改定を含むGPT-5.6の位置づけは、GPT-5.6の料金改定と法人の選び方で整理しています。単価が下がったからといって全工程を移すのではなく、処理ごとに品質と費用を測ることが出発点です。
ポイント
小型モデルの価格と速度は、バックグラウンド処理や大量リクエストを試しやすくします。ただし、起点記事の費用は個人の実験値です。導入前に自社の1タスク原価を測ってください。
価格表で見る小型モデル|GPT・Claude・Geminiの役割と料金
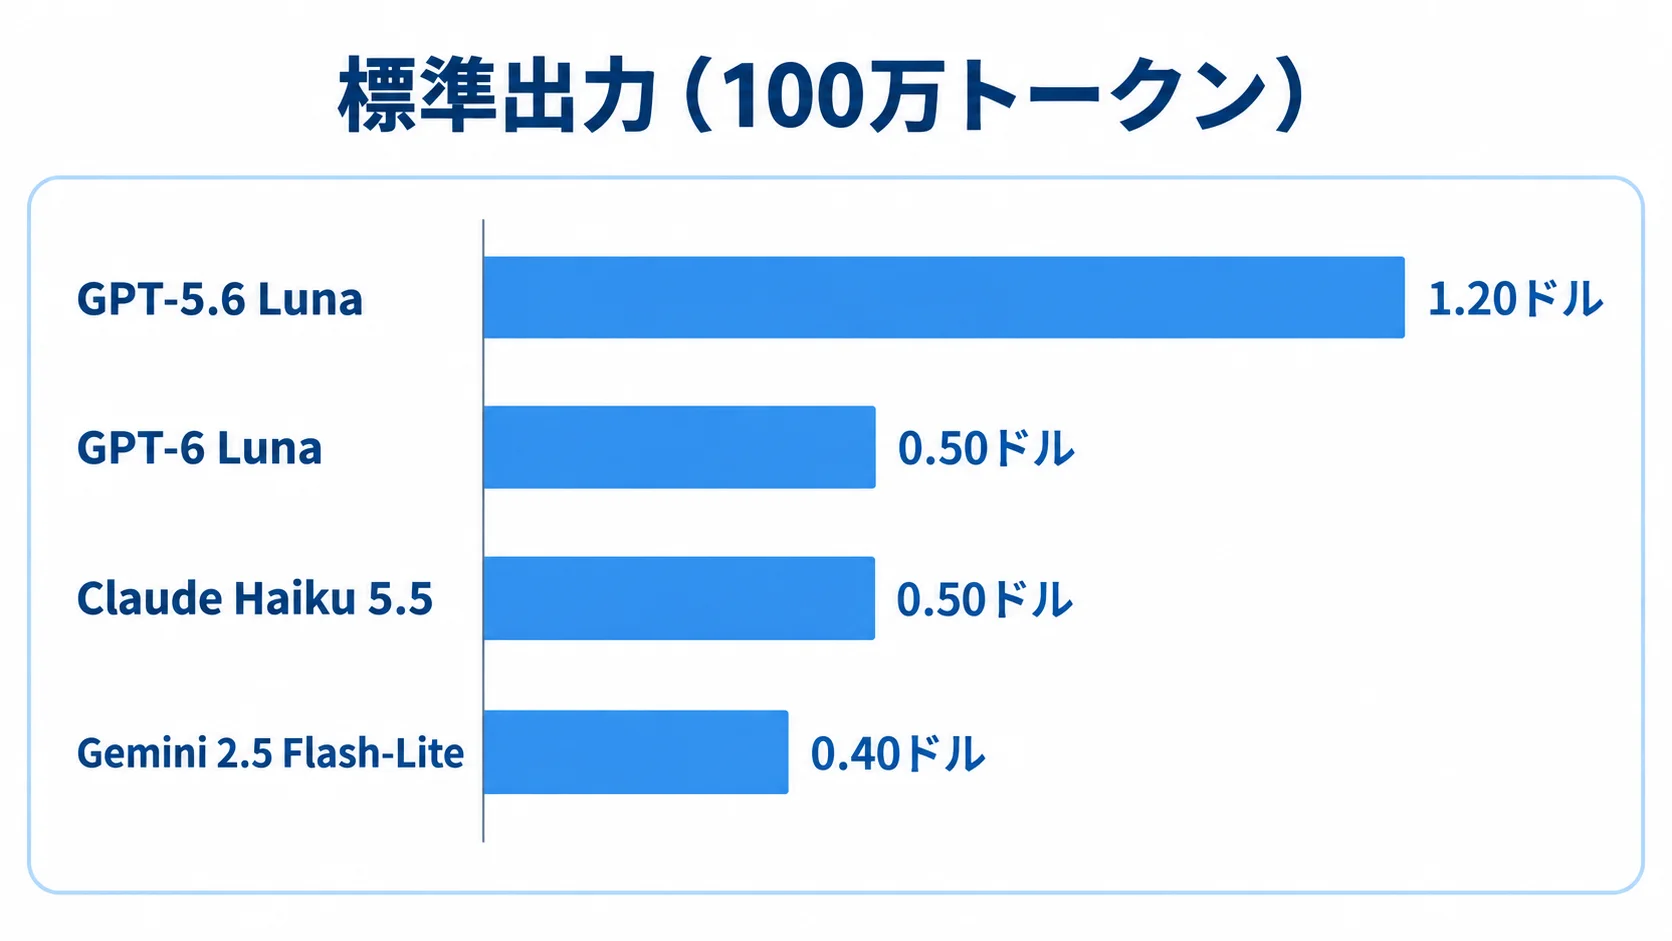
小型モデルの比較では、同じ世代かどうかをそろえて見る必要があります。2026年10月14日時点の公式ページでは、GPT-5.6 LunaとGPT-6 Lunaが併存しています。以下は標準料金を並べたもので、プロンプト長、キャッシュ、Batch、ツールの条件は別に確認してください。
| モデル | 標準入力(100万トークン) | 標準出力(100万トークン) | 公式の位置づけ・注意点 |
|---|---|---|---|
| GPT-5.6 Luna | 0.20ドル(約30円) | 1.20ドル(約180円) | コストに敏感な大量処理。入力272,000トークン超は長文料金。 |
| GPT-6 Luna | 0.10ドル(約15円) | 0.50ドル(約75円) | GPT-5.6 Lunaの後継世代。APIではgpt-6-luna。 |
| Claude Haiku 5.5 | 0.10ドル(約15円) ※100,000トークン以下。 | 0.50ドル(約75円) ※100,000トークン以下 | 超過時は入力0.50ドル(約75円)・出力2.50ドル(約375円)。 |
| Gemini 2.5 Flash-Lite | 0.10ドル(約15円) Batch 0.05ドル(約7.5円) | 0.40ドル(約60円) Batch 0.20ドル(約30円) | 大規模利用向け。検索・地図グラウンディングは別条件。 |
※1ドル=150円で換算。料金は各社の公式ページに基づく2026年10月14日時点の情報で、為替や料金改定によって変わります。Anthropicはプロンプトが100,000トークンを超えると単価が上がり、Googleはキャッシュやグラウンディングにも料金・上限があります。数字の小ささだけで採用モデルを決めると、実際の請求額とずれる点に注意が必要です。
GPT-5.6 Lunaでは、入力が272,000トークンを超えるリクエスト全体に入力2倍・出力1.5倍の料金が適用され、キャッシュ書き込みは通常入力の1.25倍です。長い会話や大量文書を一度に渡す設計では、短い入力の単価をそのまま当てはめられません。
同一指示で複数モデルを比べたAIモデル11種の実験とコスト差が示すように、価格表は候補を絞る材料です。本番で使う処理の入力長と出力形式を固定し、同じ評価セットで品質・速度・費用を測ってください。
ポイント
比較表は世代の異なるモデルを含みます。プロンプト長の閾値、キャッシュ、Batch、外部ツールの料金を加えた条件で、同一タスクの実測値を比較してください。
小型モデルで十分な処理|要約・分類・ルーティングから切り出す
小型モデルに向くのは、正解の形を決めやすく、失敗時に検出や再試行ができる処理です。AnthropicはClaude Haiku 5.5の用途として、要約、分類、ルーティング、コンパクション、サブエージェントを挙げています。GoogleはGemini 2.5 Flash-Liteを大規模利用向け、OpenAIはLunaをコストに敏感な大量処理向けと説明しています。
- 出力形式を固定できる:構造化出力や分類ラベルのように、合否を自動判定しやすい。
- 失敗を戻せる:再試行や人間確認を挟んでも、顧客への影響を抑えられる。
- 大量処理が価値になる:応答速度や処理件数が、単発の深い推論より重要になる。
反対に、曖昧な判断、長い計画、高い失敗コスト、不可逆な操作は小型モデルへ一律に寄せません。Anthropicも、複雑なエージェント型コーディングではSonnet 5.5やOpus 5.5がより適すると説明しています。
実装では、最初に受け付けた仕事を「分類」「検索」「要約」「回答生成」「外部操作」のようなタスクへ分けます。分類や要約を小型モデルに送り、信頼度が低いもの、条件に合わないもの、操作を伴うものだけを上位モデルや人間へ昇格させる構成です。処理ごとの推論設定と従量課金の見方は、生成AIの従量課金・推論モードの解説も参考にしてください。
ポイント
小型モデルの候補は、出力形式、誤りの検出方法、再試行の可否、失敗コスト、大量処理の価値で絞ります。複雑な計画や不可逆な操作は、上位モデルや人間確認を残してください。
AIアプリの採算が合う仕組み|モデル単価ではなく1タスクの総原価で見る
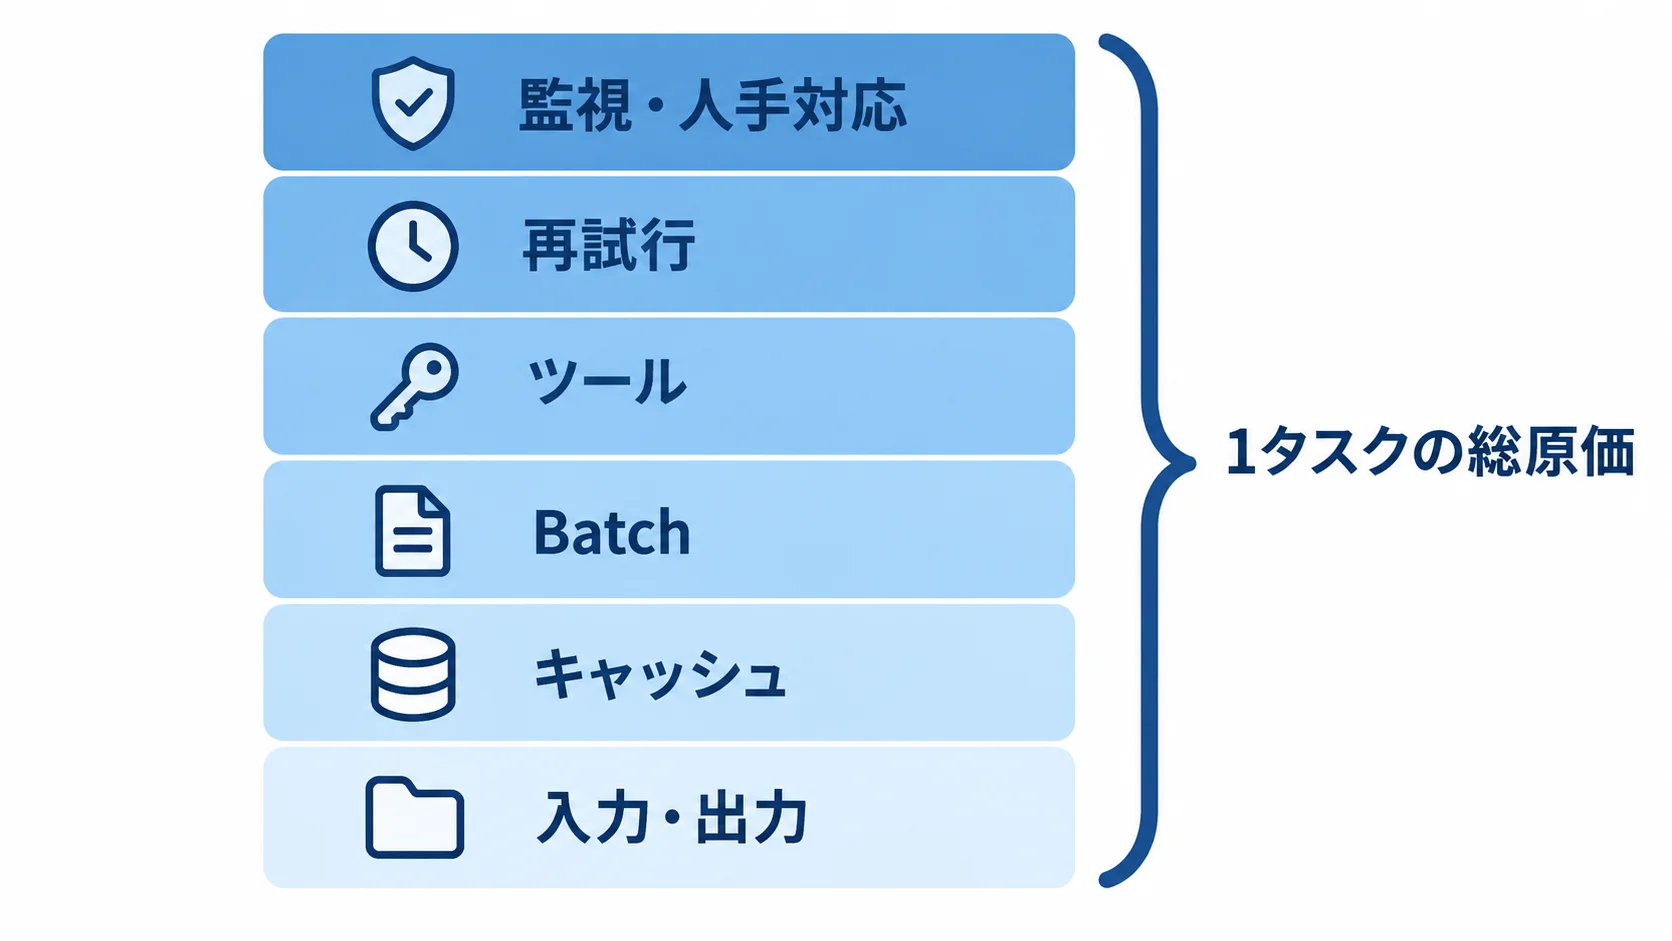
AIアプリの採算は、モデルの入力単価と出力単価だけでは決まりません。1タスクについて、入力・出力トークン、キャッシュ、Batchの可否、検索などのツール、再試行、監視・人手対応を合計し、ユーザー単価や継続率と並べて判断します。
たとえば小型モデルで出力を短くできても、誤りが多く再試行が増えれば原価は下がりません。外部検索や地図グラウンディングを多用する処理も、モデル単価とは別の費用が発生します。Googleの料金表がキャッシュやツール、データ利用条件を分けているのはそのためです。
OpenAIは、成果に必要な知能、エラーのコスト、緊急度、規模のバランスが工程ごとに変わると説明しています。評価によって追加の知能が結果を改善する工程と、低価格処理で同じ品質を出せる工程を分ける考え方です。すべてを最安モデルに寄せるのではなく、粗利に効く工程から測定する設計です。
費用の上限と異常検知も先に置きます。リクエスト単位・顧客単位・日次の上限、長大な入力の拒否、再試行回数の制限、モデル障害時のフォールバックを決めておくと、利用増加で請求だけが膨らむ事態を抑えられます。AIエージェントの予算管理はコスト暴走の実例と対策にも共通する論点です。
ポイント
採算の単位を「1回のAPI呼び出し」から「1タスクの完了」に変えます。品質不足による再試行、ツール料金、監視、人手対応まで含めた総原価と、顧客から得る価値を並べてください。
本番導入の設計|小型モデルを標準にして難しい処理だけ昇格させる
本番導入では、モデル名から始めず、アプリの仕事をタスク単位へ分解します。各タスクに品質・失敗率・レイテンシー・1タスク原価の基準を置き、代表的な入力を評価セットにします。小型モデルを初期ルートにして、基準を満たさない処理だけを上位モデルへ送る順序です。
- タスクを分解する:要約、分類、検索、回答、外部操作を分け、入力と出力を記録する。
- 評価セットを作る:正解率、許容失敗率、レイテンシー、再試行率、総原価を測る。
- 昇格条件を決める:不確実性、高リスク、長い推論、不可逆操作は上位モデルか人間へ回す。
- 運用を固定する:予算上限、ログ、フォールバック、価格改定とモデル廃止の確認日を置く。
モデルIDを固定しても、価格や提供状況は変わります。OpenAIでは旧モデルの廃止予定と推奨移行先が公開されており、価格表だけでなく、モデルの提供期限も定期確認が必要です。GPT-6 Lunaのような新世代へ移す場合も、同じ評価セットで品質と総原価を取り直してください。
監視対象には、成功率だけでなく、入力トークン、出力トークン、キャッシュ率、ツール呼び出し、再試行回数、上位モデルへの昇格率を含めます。評価とコストの変化を追う運用も欠かせません。
ポイント
導入の基本は、小型モデルを標準ルートにして、評価基準を満たさない処理だけを昇格させることです。モデルID、料金、廃止予定、フォールバックを運用表に残し、定期的に同じ評価セットで見直します。
よくある質問
Q. 小型モデルなら、どのような処理でも十分ですか?
十分とは限りません。要約・分類・ルーティングなど評価基準を作りやすい処理から候補にし、複雑な計画、エージェント型コーディング、高い失敗コストの処理は上位モデルや人間確認へ回します。
Q. GPT-5.6 LunaのAPI料金はいくらですか?
10月14日現在、100万トークンあたり入力0.20ドル(約30円)、キャッシュ0.02ドル(約3円)、出力1.20ドル(約180円)です。入力が272,000トークンを超える場合は長文料金が適用されます。
Q. AIアプリの原価はモデルのトークン単価だけで決まりますか?
決まりません。入力・出力、キャッシュ、Batch、検索などのツール、再試行、監視・人手対応を含む1タスク総原価で計算します。ユーザー単価や継続率と並べれば、モデル変更の影響は採算表で確認可能です。
Q. 小型モデルを本番導入するとき、何を先に測るべきですか?
正解率・許容失敗率、レイテンシー、入力と出力のトークン量、再試行率、ツール費用、1タスク原価を評価セットで測ります。基準未達時に上位モデルや人間へ昇格させる条件も先に決めておきます。
まとめ
小型モデルは、要約・分類・ルーティングのような範囲を絞った大量処理で、AIアプリの応答速度と原価を見直す選択肢です。GPT-6 Luna、GPT-5.6 Luna、Claude Haiku 5.5、Gemini 2.5 Flash-Liteは、いずれも公式に低価格・高頻度の用途が示されています。
採算を合わせる方法は、全工程を最安モデルへ寄せることではありません。タスクを分解し、品質・失敗率・レイテンシー・1タスク総原価を測り、基準を満たさない処理だけを上位モデルや人間へ昇格させます。価格、モデルID、廃止予定、フォールバックも運用に組み込んでください。
ポイント
「小型モデルで十分か」はモデル名で決めず、処理ごとの評価セットと総原価で判定します。低リスク・高頻度の処理から始め、難しい判断には昇格ルールを残すことが本番導入の条件です。
関連記事
- AIエージェント導入を解説|過度な期待を避けるROI評価のポイント
- AgentOpsを解説|AIエージェントの可観測性・評価・監視のポイント
- GPT-6 Sol・Lunaを解説|Astra級の学習手法で価格を下げた2モデルの使い分け
- DeepSeek V4を解説|Pro・Flashの仕様とAPI料金、企業導入のポイント
- AIエージェント実験の失敗事例を解説|丸投げを防ぐ監督体制のポイント
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。