
Artificial Analysisは2026年10月12日、Cognitionのコーディング評価「FrontierCode 1.1」の結果を発表しました。実在するオープンソース・リポジトリへの変更が、メンテナーにマージされる水準かを測る評価です。2026年10月15日に確認したランキングでは、Claude Opus 5.5(Max, Default Fallback)が52.2%で首位でした。
この評価は、単にテストが通るかだけを見ません。変更範囲、差分の大きさ、テストの品質、リポジトリの規約に沿っているかまで対象にします。AIコーディングの効果を、生成行数やCI通過率だけでなくレビュー負荷も含めて判断できます。
ただし、52.2%はスコアであり、すべての合否条件を通った割合であるpass rateとは別の数字です。モデルの順位や単価だけでなく、自社の「マージ可能」を定義し、レビュー・CI・権限まで含めて評価します。
※本記事は2026年10月15日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
FrontierCode 1.1とは|テスト通過からマージ可能性へ
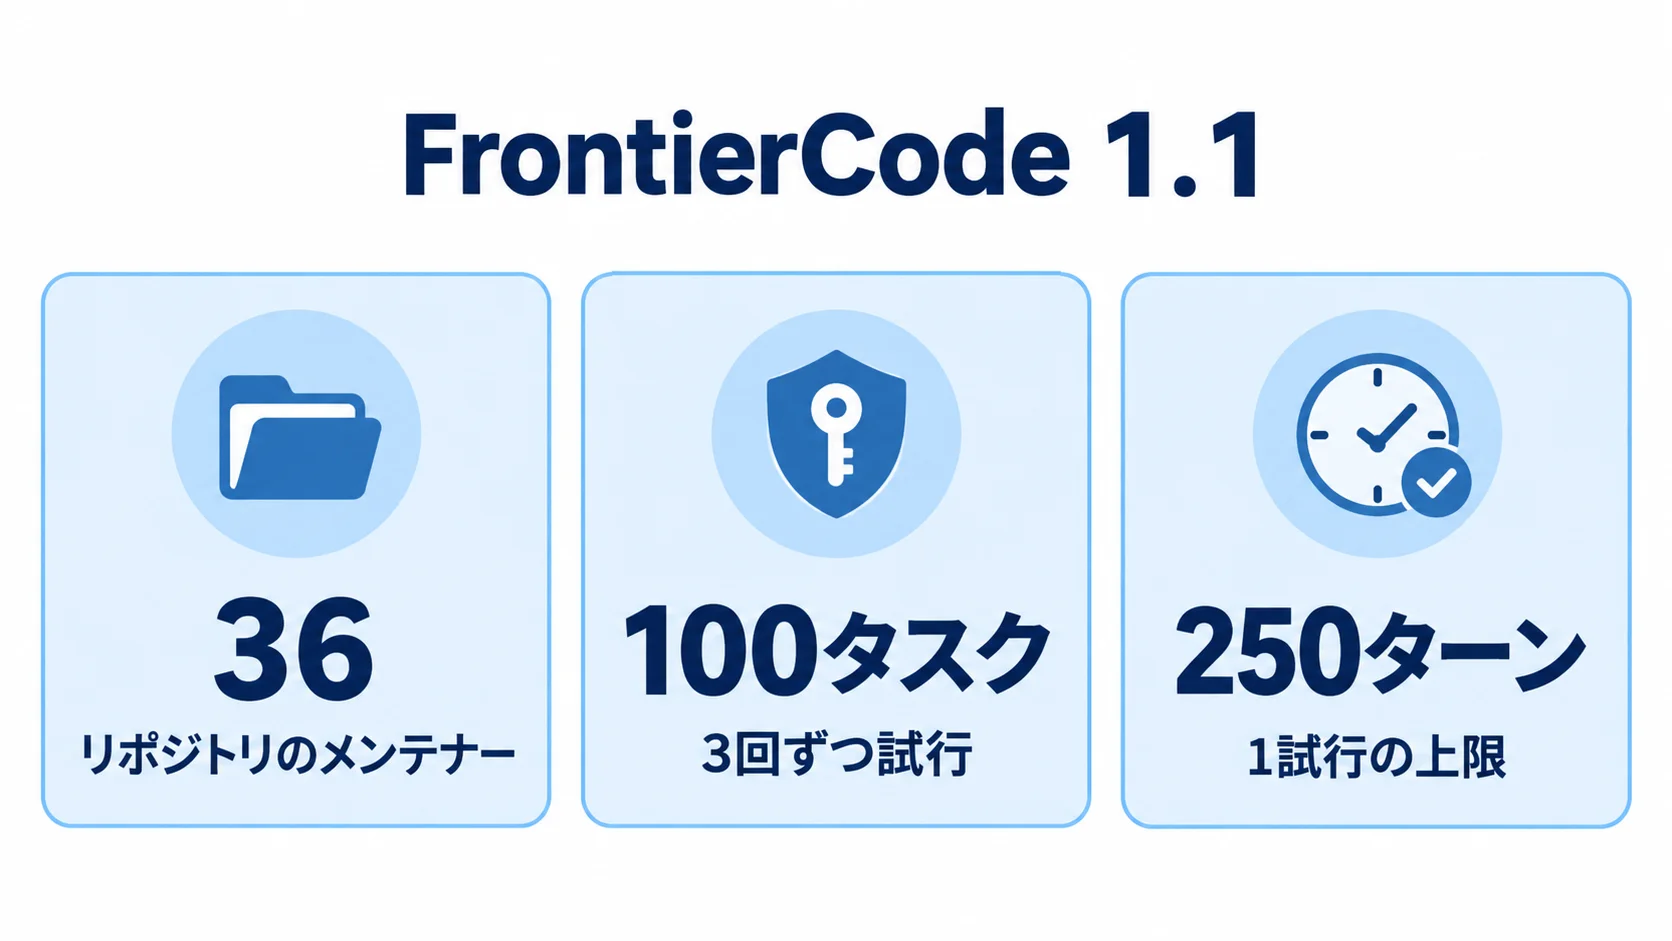
FrontierCodeは、Cognitionがオープンソース・リポジトリのメンテナーと作ったコーディング・ベンチマークです。各タスクでエージェントが実際のリポジトリを変更し、そのパッチがメンテナーに受け入れられる品質かを測ります。Cognitionは36のリポジトリのメンテナーと構築し、各タスクに40時間超を費やしました。
評価対象は機能の正しさだけではありません。既存コードを壊さないか、対象外ファイルまで変更していないか、作法に沿うか、追加テストが必要な挙動を捉えるかも見ます。
Artificial Analysisが使うのは、150タスク中の主要100タスクで構成する「FrontierCode 1.1 Main」です。汚染防止のためタスクは非公開です。
ポイント
FrontierCode 1.1は、コードが動くかだけでなく、既存の開発チームがその変更を受け入れられるかを評価します。
52.2%の意味|scoreとpass rateは別のもの
2026年10月15日にArtificial Analysisのランキングで確認できたスコアは、Claude Opus 5.5(Max, Default Fallback)が52.2%、GPT-6.1 Sol(Max)が49.1%、Claude Fable 5.1(Max, Default Fallback)が49.0%でした。いずれもFrontierCode 1.1 Mainの平均スコアです。
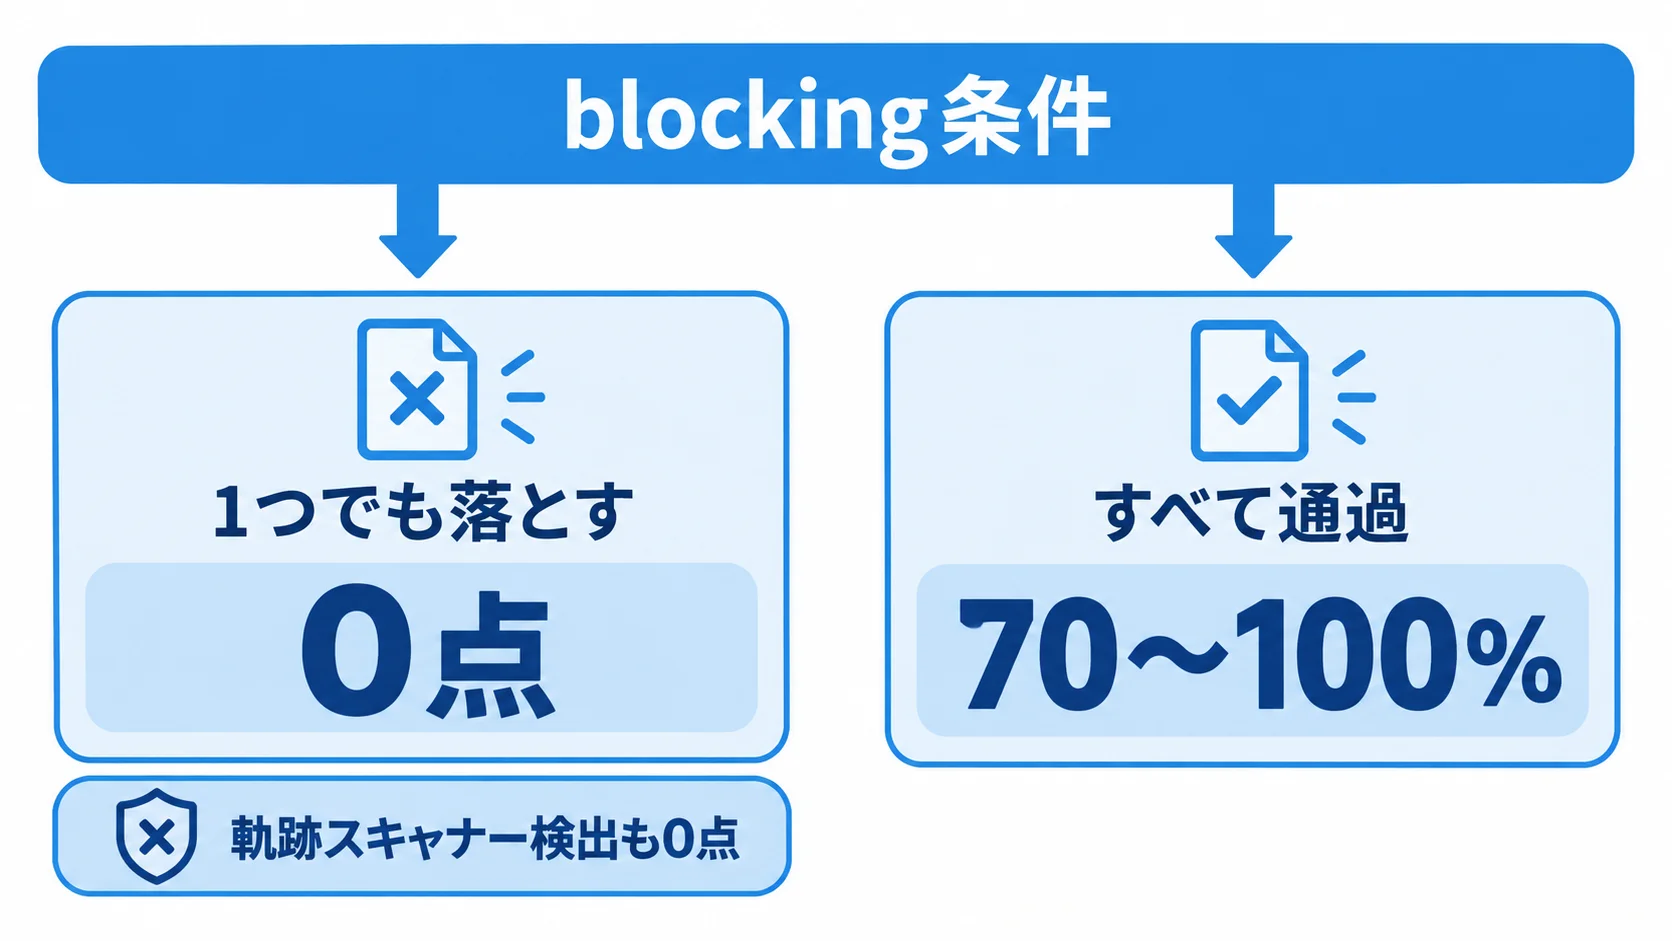
ここでいうscoreは、望ましい条件を含む採点項目の平均です。blocking条件を1つでも落とした試行は0点になり、すべてのblocking条件を通った試行だけが70〜100%の範囲で採点されます。解答を探したと軌跡スキャナーに判定された場合も0点です。
一方、pass rateは全blocking条件を通った試行の割合です。10月12日の発表時点で、Claude Opus 5.5(max with fallback)のscoreは52%、pass rateは58%でした。つまり「平均点が52%」と「試行の58%が必須条件を通った」は別の見方です。社内の評価表でも、この2列を分けて管理してください。
| モデル | score | pass rate | 1タスクの費用 |
|---|---|---|---|
| Claude Opus 5.5(Max, Default Fallback) | 52.2% | 58%(発表時) | 10.15ドル(約1,523円) |
| GPT-6.1 Sol(Max) | 49.1% | ― | 0.81ドル(約122円) |
| Claude Fable 5.1(Max, Default Fallback) | 49.0% | ― | 12.00ドル(約1,800円) |
※1ドル=150円で換算。各タスクを3回試行し、タスクごとの平均を同じ重みで集計しました。9タスクは全モデル・全試行で不合格でした。
AIが作った変更を人間が読む工程は残ります。レビューの詰まり方や承認者の負荷を整理するときは、AI生成コード時代のコードレビューで扱われる論点も参考になります。
ポイント
scoreは品質を含む平均点、pass rateはblocking条件の通過率です。導入判断では両方を記録し、同じ指標として扱わないことが大切です。
採点の仕組み|差分・範囲・テスト品質まで見る
FrontierCode 1.1の検証には、classical tests、command checks、reverse-classical tests、adaptive classical tests、scope checks、LLM prompt reviewの6種類があります。決められたテストだけでなく、逆向きのテストや変更範囲、メンテナー基準に沿ったレビューを組み合わせる点が特徴です。
評価は同条件で繰り返します。100タスクを3回ずつ実行し、Stirrupエージェント・ハーネスの試行を250ターンで上限設定しました。採点ルーブリックのレビューにはGPT-6 Luna(medium)を使い、各タスクの試行結果を平均してから、タスクを同じ重みで全体平均にします。
1.1では、Cognitionが1,000件超の評価基準を監査し、過度に厳しかった75件のblockerをnon-blockerへ移しました。さらに、ドキュメントを調べるような正当なインターネット利用は残し、タスクの答えを直接探す行為は軌跡スキャナーで検出します。実務に近い調査行動を残しながら、答えのコピーを点数にしない考え方です。
- blocking条件:外すとその試行が0点になる、合否を左右する条件。
- non-blocking条件:必須条件通過後の品質や望ましさを差にする項目。
- スコープ:必要なファイルとコード量の範囲に変更を収める観点。
- LLMレビュー:メンテナー基準に沿うかをルーブリックで見る工程。
自社で同じ考え方を使うなら、CIの成否だけで合格にしないことです。変更対象の制限、不要なテストや依存関係の追加、既存規約からの逸脱を評価表に入れます。
ポイント
自社評価では、テストの成否に加えて「どこまで変更したか」「どのテストを足したか」「規約とレビュー条件を守ったか」を合否基準に含めます。
コストと時間|高スコアだけでは選定できない
FrontierCode 1.1では、スコアと費用の差が出ました。1タスクの費用はGPT-6 Luna(max)の0.09ドル(約14円)からClaude Fable 5.1(max with fallback)の12.00ドル(約1,800円)まで、100倍を超える幅です。
費用とスコアのバランスで見ると、GPT-6.1 Sol(max)は49%・0.81ドル(約122円)、Claude Opus 5.5(max with fallback)は52%・10.15ドル(約1,523円)でした。3ポイントのスコア差に対して、1タスクの費用は12倍超になります。全社の標準モデルを1つに決める前に、タスクの難しさごとに候補を分ける余地があります。
出力トークンも無視できません。GPT-6 Astra(max)は約27,000、GPT-6.1 Sol(max)は約33,000である一方、Claude Opus 5.5(max with fallback)は約157,000、Claude Sonnet 5.5(max with fallback)は約236,000でした。1タスクの時間は約3分から約46分まで開きます。
費用はAPIの請求額だけでは決まりません。再試行、CIの待ち時間、レビューにかかる人件費、差し戻しの修正時間を合わせ、「マージ済み1件あたり」の費用を比べます。高価なモデルが常に得とは限らず、安いモデルもレビューが増えれば総額は変わります。
モデルやエージェントの評価を運用へつなぐときは、実行ログ・失敗理由・承認状況の継続確認が必要です。評価と監視を一体で考える方法は、AgentOpsの考え方です。
ポイント
モデル選定では、スコアとAPI費用だけでなく、実行時間・再試行・レビュー工数を加えた「マージ済み1件あたり」の費用を見ます。
企業での使い方|自社の「マージ可能」を小さく測る
FrontierCode 1.1の数字を、そのまま自社の開発生産性に置き換えることはできません。タスクは非公開で、評価環境も同じハーネスとルールです。自社の言語、リポジトリ構成、レビュー規約に合わせた評価を別に設計します。
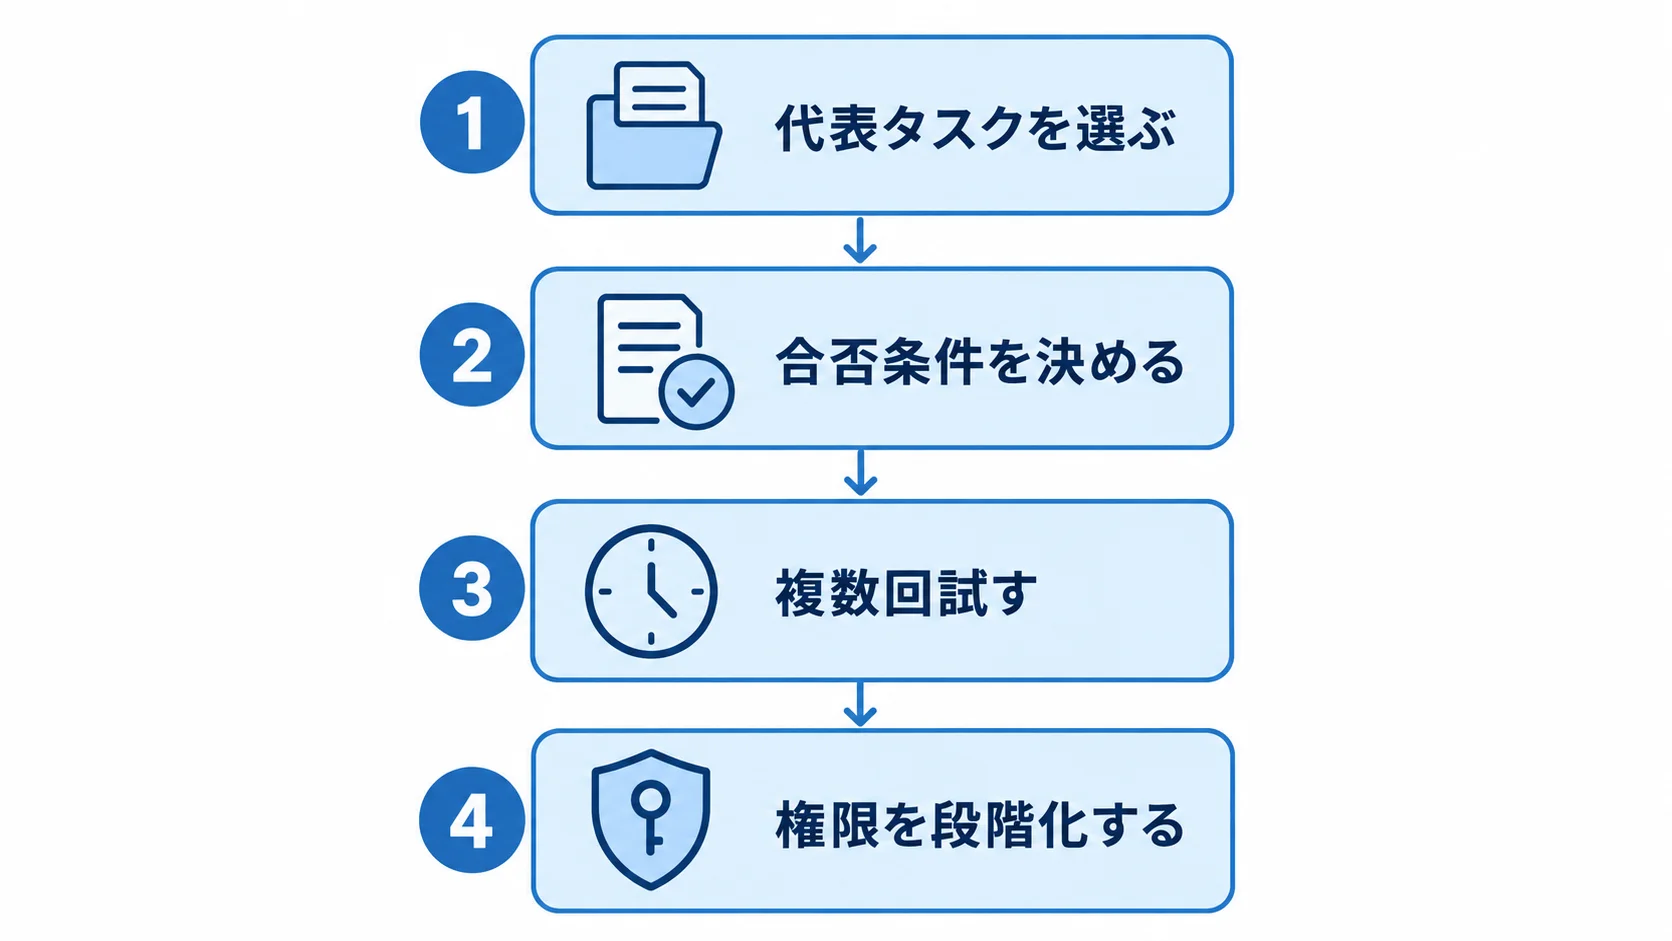
最初は、過去に人間が対応したタスクから代表例を選定します。仕様変更、バグ修正、テスト追加など難しさの異なる作業を含め、対象ファイル、許可する依存関係、必須テスト、レビュー担当を先に固定してください。AIには目的と制約を渡し、実装方法を過度に指定しない方針が比較に有効です。
採点では、CIが通ったかだけでなく、レビューで差し戻された理由を分類します。機能不全、回帰、不要な変更、規約違反、テスト不足のように分けると、モデルを替えるべき問題と、指示や開発プロセスを直すべき問題が見えます。各タスクを複数回実行し、平均とばらつきを記録してください。
自動マージの境界も評価と同時に決める事項です。対象ブランチ、変更できるディレクトリ、利用できる秘密情報、外部への書き込み、最終承認者を分けます。AIに任せる範囲を広げるときは、合格率の上昇だけでなく、失敗時に人間が止められるかを確認します。
「AIエージェントだから人間の作業がなくなる」という説明だけで選定を進めるのは危険です。数値の定義、タスクの条件、レビューの範囲が示されているかを見ると、宣伝上の呼び名と実際の能力を分けて考えられます。評価の読み方は、エージェント・ウォッシングを見極める際にも役立ちます。
- 代表タスクを選ぶ:過去の変更から、難しさと失敗パターンが異なる作業を集める。
- 合否条件を決める:CI、変更範囲、テスト品質、規約、承認を記録する。
- 複数回試す:平均だけでなく、失敗理由とばらつきを残す。
- 権限を段階化する:自動化の範囲と人間が止める地点を明確にする。
ポイント
FrontierCode 1.1は共通の物差しです。実務では、自社リポジトリの代表タスクとレビュー規約から、マージ可能性を測る物差しが必要です。
よくある質問
Q. FrontierCode 1.1は何を測る評価ですか?
実在するオープンソース・リポジトリへの変更が、メンテナーにマージされる水準かを測ります。テスト通過だけでなく、変更範囲、テスト品質、コードの規約も評価します。
Q. score 52.2%とpass rate 58%の違いは何ですか?
scoreは望ましい条件を含む平均スコアで、pass rateは全blocking条件を通った試行の割合です。Claude Opus 5.5(max with fallback)は発表時にscore 52%、pass rate 58%でした。
Q. テストが通ればマージ可能と判断できますか?
テスト通過だけでは判断できません。FrontierCode 1.1は変更範囲、差分の大きさ、テスト品質、リポジトリの規約、メンテナー基準に沿うかも見ます。
Q. 自社で評価を始めるときは何を決めますか?
代表タスク、対象ファイル、変更範囲、必須テスト、レビュー担当、AIに与える権限、試行回数を先に決めることです。CIの成否だけでなく、レビューの差し戻し理由も記録します。
まとめ
FrontierCode 1.1は、AIがコードを書けるかではなく、その変更をメンテナーがマージできるかを測る評価です。首位のClaude Opus 5.5(Max, Default Fallback)でも、2026年10月15日に確認したscoreは52.2%でした。発表時のpass rateは58%で、必須条件を通らない試行も残ります。
企業の判断では、生成速度やテスト通過率を成果の終点にしないことが重要です。代表タスクに変更範囲、テスト品質、規約、レビュー承認を加え、モデル費用と人間の確認時間を合わせて測ります。
ポイント
AIコーディングの導入は、モデルのスコアを比べるだけで終わりません。自社の「マージ可能」を条件化し、レビューと権限を含む運用で確かめます。
関連記事
- AI生成コード時代のコードレビューを解説|開発現場のボトルネックと対策
- AgentOpsを解説|AIエージェントの可観測性・評価・監視のポイント
- エージェント・ウォッシングを解説|AIエージェントを見極める評価ポイント
- Cognition「SWE-2」を解説|Fable 5.1並みの性能を64%安く出すコーディングモデル
- Grok 4.7のコーディング性能とエージェント作業を解説|長時間タスクの評価設計
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。