
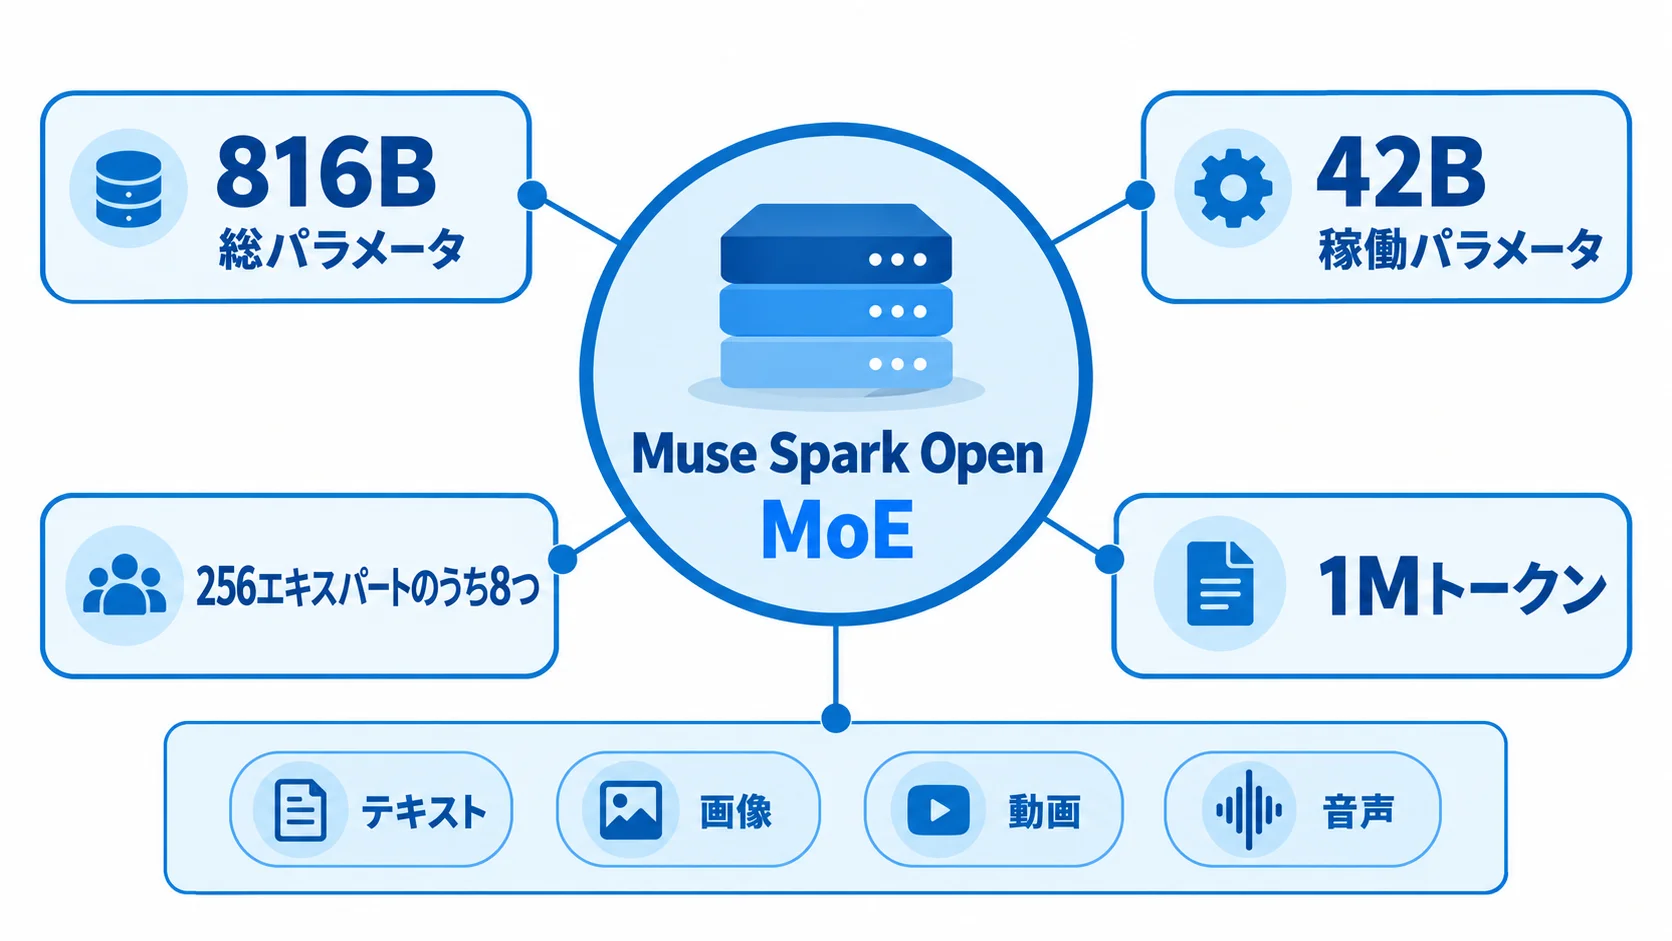
Metaは2026年10月15日、オープンウェイトモデル「Muse Spark Open」を公開しました。総816B、稼働42BのMixture-of-Experts(MoE)モデルで、最大1Mトークンのコンテキストと、テキスト・画像・動画・音声の入力に対応します。
Muse Spark Openが想定する主な用途は、コードの作成・デバッグ、複数ファイルをまたぐ編集、長時間のエージェント作業です。ツール呼び出しにも対応するため、開発支援や画面を見ながら進める業務を自社環境で評価できます。
ただし、稼働パラメータが42Bだからといって、一般的なGPUで動かせるわけではありません。全エキスパートをメモリーに保持する設計のため、導入ではGPU、ノード間通信、推論ランタイム、ライセンスをまとめて確認する必要があります。
※本記事は2026年10月19日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
Muse Spark Openとは|816B総パラメータ・42B稼働のMoE
Muse Spark Openは、Metaが公開した大規模なオープンウェイトモデルです。モデルカード上の仕様は816B total / 42B activeで、1トークンの処理時には256エキスパートのうち8つを選びます。計算に使う部分を絞ることで、全パラメータを毎回計算する構成より効率を高めています。
ここで注意したいのは、「42B稼働」と「42B分のメモリーで配置できる」は同じ意味ではないことです。選択されないエキスパートもモデル内に保持するため、推論基盤には816B規模の重みを載せる必要があります。MoEの稼働パラメータは処理量の目安であり、GPUの必要量を直接示す数字ではありません。
入力はテキストだけではありません。画像、動画、音声を受け取り、出力はテキストです。長いコードベースやログを扱う用途では1Mトークンのコンテキストが候補になりますが、実際の提供上限は推論サーバーの設定とGPUメモリーで決まります。
ポイント
816Bはモデル全体の規模、42Bは1トークンで稼働する規模です。自社運用の可否は、全エキスパートを保持するメモリーと推論構成で判断します。
コーディングとエージェント向け|マルチモーダル入力とツール呼び出し
MetaとHugging Faceは、Muse Spark Openを長いコーディング作業やエージェント型の開発作業向けに説明しています。複数ファイルの編集、デバッグ、長いタスクの計画と実行、失敗後の再試行を扱う設計です。単発の文章生成より、状態を持つ作業フローで評価するモデルです。
画像・動画・音声を同じモデルに渡せる点も、開発現場では使い道があります。画面のスクリーンショット、操作の録画、音声メモ、コードやログを一つのエージェントに渡し、次の操作を選ばせる構成です。入力を増やすほど、誤認識時の停止条件と人間の承認点を先に決めてください。
ツール呼び出しは、モデルが自動的に安全な操作を保証する機能ではありません。ファイル書き込み、シェル実行、ブラウザー操作、社内APIの呼び出しを個別の権限に分け、実行前後のログを残す設計が必要です。エージェントの連携方式を整理するときは、Agent Plugins 1.0のような拡張規格の記事も参考になります。
自社の開発支援で試すなら、まずコードの読み取りと提案だけを許可し、書き込みやデプロイは承認制にします。画面入力や音声入力を使う場合は、入力データに個人情報や秘密情報が混ざったときのマスキングも評価項目に含めます。
ポイント
評価の中心はベンチマークだけではありません。実際のコード、画面、音声を入力し、どのツールをどの権限で呼べるかまで含めて測定します。
自社運用の条件|BF16は4ノード、NVFP4はBlackwell系
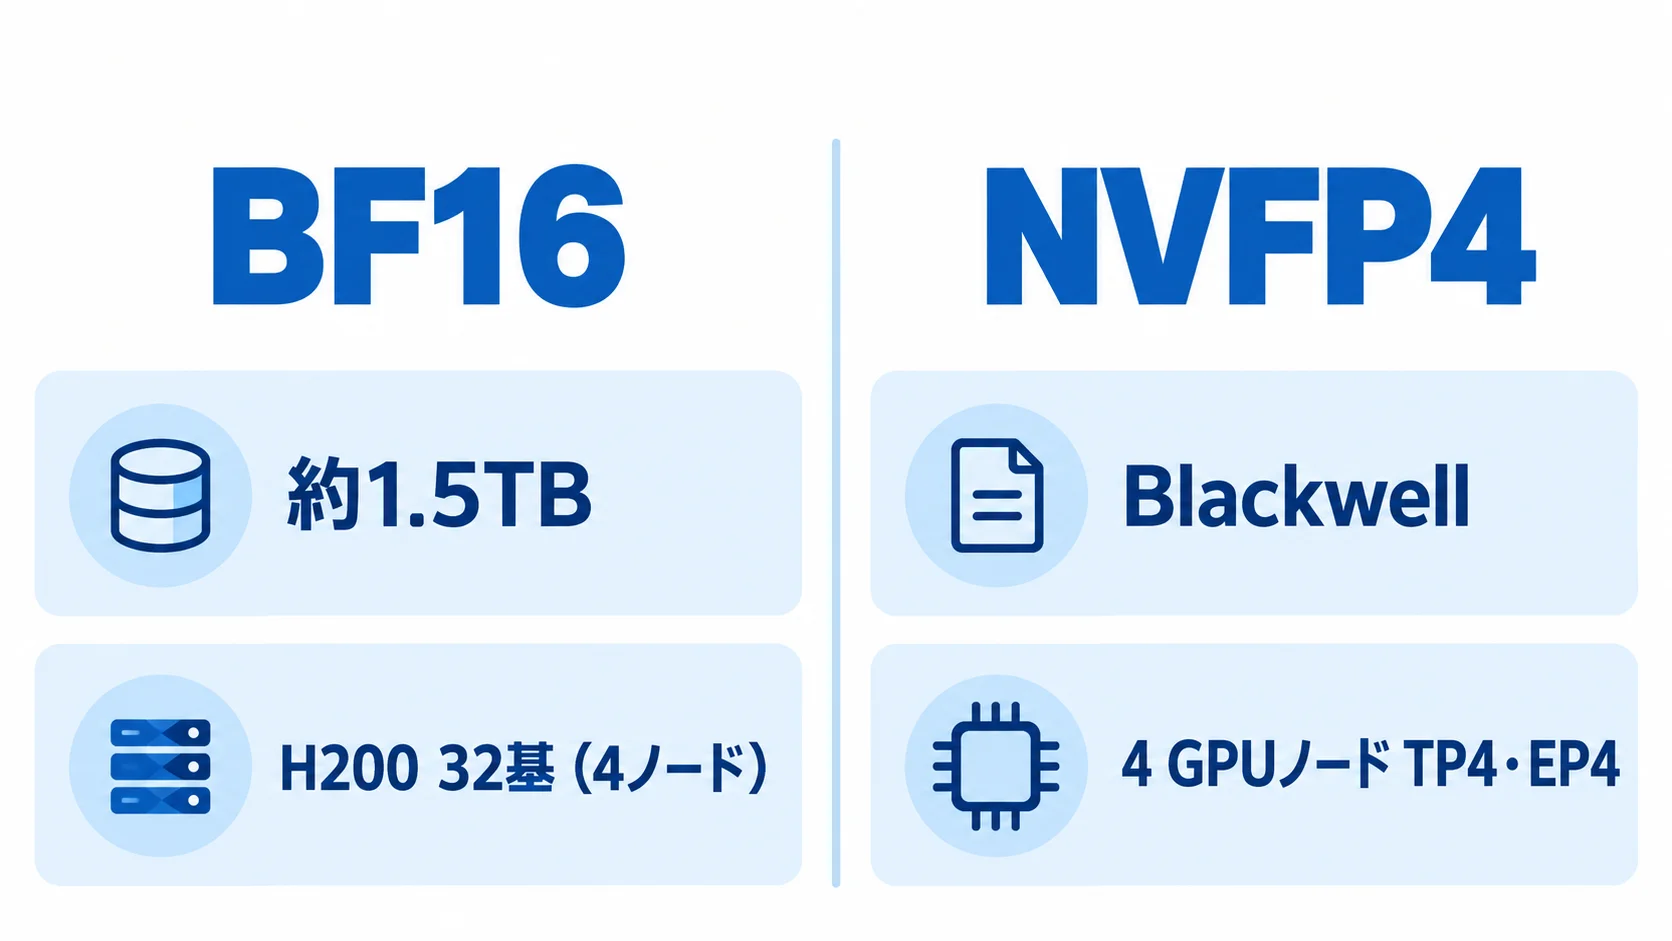
公開されたチェックポイントはBF16とNVFP4の2種類です。公式記事では、BF16のsafetensorsは約1.5TBです。Transformersの構成は、8基のH200 GPUを搭載した4ノード(合計32基)で実行します。
NVFP4は4ビット精度でNVIDIA Blackwell GPU向けです。単一のB200ノードで実行する構成が示されています。
Metaのハードウェア文書では、NVFP4を単一のBlackwell 4 GPUノードに載せ、TP4とEP4で並列化する構成も案内されています。モデルカードの目安は、NVFP4で少なくとも700GB、BF16で2TBのGPU VRAMです。これは重みだけでなく、KVキャッシュやランタイムの領域も考える必要があることを示します。
| 選択肢 | 公開されている条件 | 向いている段階 |
|---|---|---|
| BF16 | 約1.5TB、8基のH200を搭載した4ノード(合計32基) | 精度を優先する検証・運用 |
| NVFP4 | Blackwell系、単一4 GPUノードの構成 | 自己運用の性能・コスト検証 |
| ホスト型API | 第三者推論プロバイダー経由で利用 | データ境界と用途の初期評価 |
自社でGPUを持たない場合は、第三者の推論プロバイダーやInference Endpointsを入口にできます。自己運用と比べて導入は早い一方、入力データの保存・処理場所、APIの提供モダリティ、最大コンテキスト、障害時の責任分界を契約と設定で確かめます。
GPUの台数だけでなく、ノード間通信、ストレージ、推論ソフトの対応版、モデル更新時の再検証まで見積もることが大切です。Metaの公式文書にはSGLang、vLLM、TensorRT-LLMなど複数の構成が示されていますが、すべてのランタイムが同じコンテキスト長や入力形式を提供するとは限りません。
ポイント
自己運用の比較軸はGPU価格だけではありません。チェックポイントの形式、並列化、通信、推論ランタイム、保守を一つの構成として見積もります。
1Mトークンをどう使うか|公開上限と本番設定を分ける
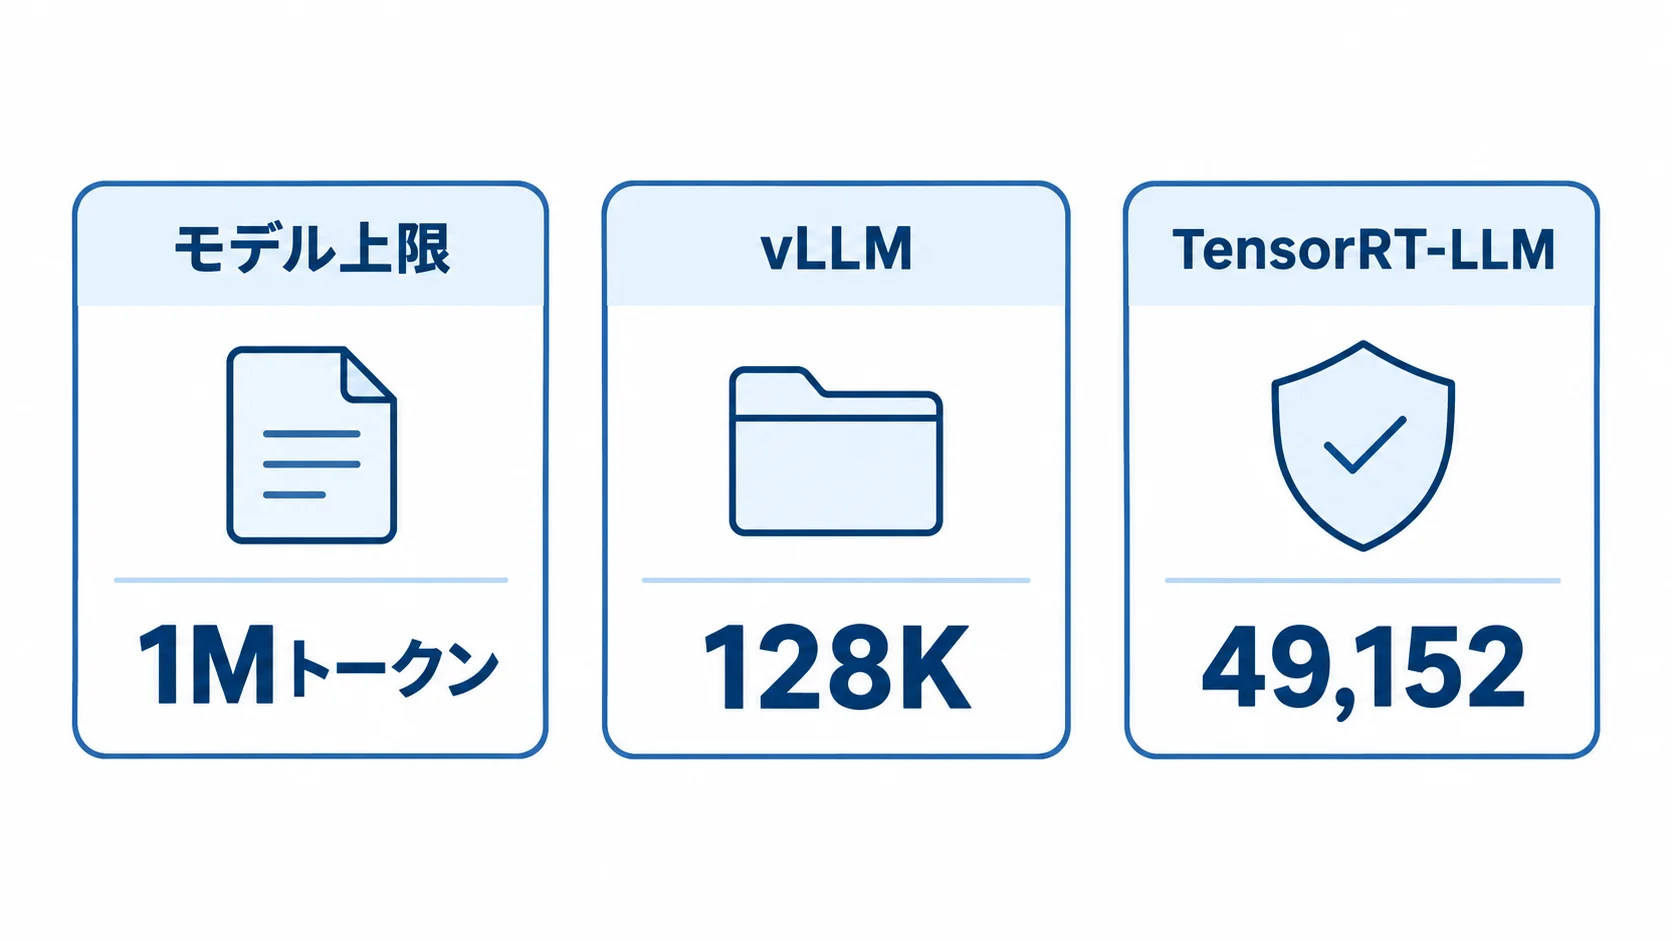
Muse Spark Openのコンテキスト長は最大1,048,576トークンです。ただし、これはモデルが持つ公開上限であり、1Mトークンを投入した本番環境の性能を保証する数字ではありません。長い入力では、前処理、KVキャッシュ、応答時間、同時実行数が変わります。
Metaの設定文書によると、62層のうち46層は直近2,048トークンを見るスライディングウィンドウ注意、16層はフル注意です。フル注意の層は全コンテキストのKVキャッシュを保持するため、入力を伸ばすほどメモリーの見積もりが変わります。最大長を大きく設定するだけでは運用設計になりません。
実運用では、業務ごとに必要な長さを決めます。コードレビューなら変更差分と関連ファイル、問い合わせ対応なら履歴と参照文書を上限にし、1Mトークンを使うケースは別に測定します。TensorRT-LLMの検証済み設定はmax_seq_lenが49,152、vLLMの公式例は128Kであり、モデルの公開上限と提供設定には差があります。
- 品質:長い入力で必要な情報を拾えるか、業務データで測る。
- 性能:入力長ごとの初回応答時間と生成速度を測る。
- 容量:同時実行数とKVキャッシュを含めてGPUを見積もる。
長文対応を売りにするなら、最大値ではなく業務で再現できる設定をサービス仕様にします。プロンプトの分割、要約、検索を組み合わせ、必要なときだけ長いコンテキストを使う設計も候補になります。
ポイント
1Mトークンはモデルの上限です。本番の最大値は、業務データで品質・レイテンシー・同時実行数を測ったうえで設定します。
導入前に確認すること|ライセンスとガードレール
Muse Spark Openは、一般的な無条件のオープンソースライセンスではなく、Muse Model Licenseで提供されています。自社製品やサービスで使う場合、UI、付属文書、Webサイト、設定メニューのいずれかに「Built with Muse Spark Open」と表示する義務があります。
第三者がモデルの出力を受け取るAPIなどを提供するModel as a Serviceでは、条件があります。ライセンシーと関係会社の12か月連続期間の総売上が2,000万ドル(約30億円)を超える場合、Metaへの通知と別途の書面契約が必要です。※1ドル=150円で換算しています。
一方、社内利用、研究、Model as a Serviceに該当しない自社製品の機能は、この条項の適用対象外とされています。
導入前に法務が確認するのは、モデルの呼び出し方だけではありません。自社サービスが第三者へ出力を提供するか、関係会社の売上をどう集計するか、表示義務をどこに置くかを整理します。金額の判定は、契約の原文と自社の提供形態を照らして行います。
モデルカードは、特定用途に合わせた追加のガードレールを備えた、より大きなAIシステムの一部としてのデプロイを推奨しています。実装では、ツールの許可リスト、読み書き可能な領域、実行時間、停止条件、監査ログ、人間の承認を先に決めます。機密データを扱う構成では、クローズドAIエージェントの考え方も比較対象です。
なお、Muse Spark Openを自社の開発環境に組み込む前に、公開ウェイトを社内ネットワークへ置けるか、ログや入力が外部に出ないかを確認します。ホスト型APIから始める場合も、検証用データを分離して、実運用データとの境界を明確にしてください。AIエージェントの権限管理は、MCPサーバーのセキュリティで扱われる公開範囲や認証の論点とも重なります。
ポイント
商用利用では、Muse Model Licenseの表示義務とModel as a Service条項を法務が確認します。技術側は、ツール権限・監査ログ・人間の承認点をPoCの合否条件にします。
よくある質問
Q. Muse Spark Openは何Bモデルですか?
総パラメータは816Bで、1トークンあたりの稼働パラメータは42Bです。
Q. Muse Spark Openを自社で動かすにはどれくらいのGPUが必要ですか?
公式記事では、BF16は8基のH200を搭載した4ノード(合計32基)です。NVFP4は単一のB200ノードです。
Q. 1Mトークンを本番ですぐ使えますか?
1Mトークンはモデルの公開上限であり、本番では推論ランタイムの設定とGPUメモリーを測って最大長を決めます。
Q. 商用サービスに組み込むとき、ライセンスで確認することは何ですか?
「Built with Muse Spark Open」の表示が必要です。Model as a Serviceで総売上が2,000万ドル(約30億円)を超える場合は、通知と書面契約も確認します。
まとめ
Muse Spark Openは、816Bのモデル全体を保持しながら42Bを稼働させるMoEモデルです。コーディング、長時間のエージェント作業、画像・動画・音声を含む入力を一つのモデルで扱える点が特徴ですが、導入負荷は稼働パラメータ数だけでは決まりません。
自社で動かす場合は、BF16とNVFP4のハードウェア条件、推論ランタイム、実際に必要なコンテキスト長を先に絞り込みます。初期評価ではホスト型APIと自己運用を比較し、データ境界、レイテンシー、同時実行数、ツール権限を同じテストケースで測ると判断しやすくなります。
最後に、Muse Model Licenseの表示義務とModel as a Service条項を法務と確認します。モデルの性能だけで採用を決めず、GPUの調達・運用費、監査可能性、失敗時に止められる仕組みまで含めてPoCの合否を決めることが、企業導入の出発点です。
ポイント
導入判断は「動くか」だけで終わりません。用途、データ境界、ハードウェア、コンテキスト長、権限管理、ライセンスを一つの評価表にまとめてから進めます。
関連記事
- OpenAI Agents APIを解説|マネージドなエージェント実行基盤で何が楽になるか
- クローズドAIエージェントを解説|機密データを外に出さないAI活用の仕組みと導入ポイント
- Muse Codeを解説|MetaのAI開発ツールと活用ポイント
- Agent Plugins 1.0を解説|主要ベンダー横断のAIエージェント拡張規格と選定ポイント
- MCPサーバーのセキュリティ実態を解説|21000台超が露出・92%認証なしの点検ポイント
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。