NVIDIAは2026年10月21日、企業のメタデータからセマンティックなグラフ型推論レイヤーを作るOSS「Auto Ontology」を公式ブログで紹介しました。自然言語の質問をSQLに変換し、業務上の定義やデータ系譜を使ってクエリを検証し、回答の出所を返すPythonフレームワークです。
AIエージェントに社内データを読ませるとき、問題はSQLを生成できるかだけではありません。「売上」「顧客」「注文」といった言葉がシステムごとに違う意味で使われていれば、速く返ってきた数字も判断材料にならないからです。Auto Ontologyは、データの場所と意味をエージェントに渡す層を既存のデータソース上に置きます。
技術責任者が見るべきなのは、導入すれば回答精度が自動的に上がるかではなく、意味の定義、利用者の権限、SQLの検証、運用主体を自社で管理できるかです。MCP・CLI・APIで接続する前に、どの業務指標を対象にするかを決める必要があります。
※本記事は2026年11月4日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
Auto Ontologyとは|企業データに共通の意味を与える層
Auto Ontologyが扱うのは、データベースのテーブルを単に検索する仕組みではありません。NVIDIAのREADMEでは、データがどこにあり、何を意味し、どう使い、どこから来たかをエージェントに伝えるコンテキスト層として説明されています。
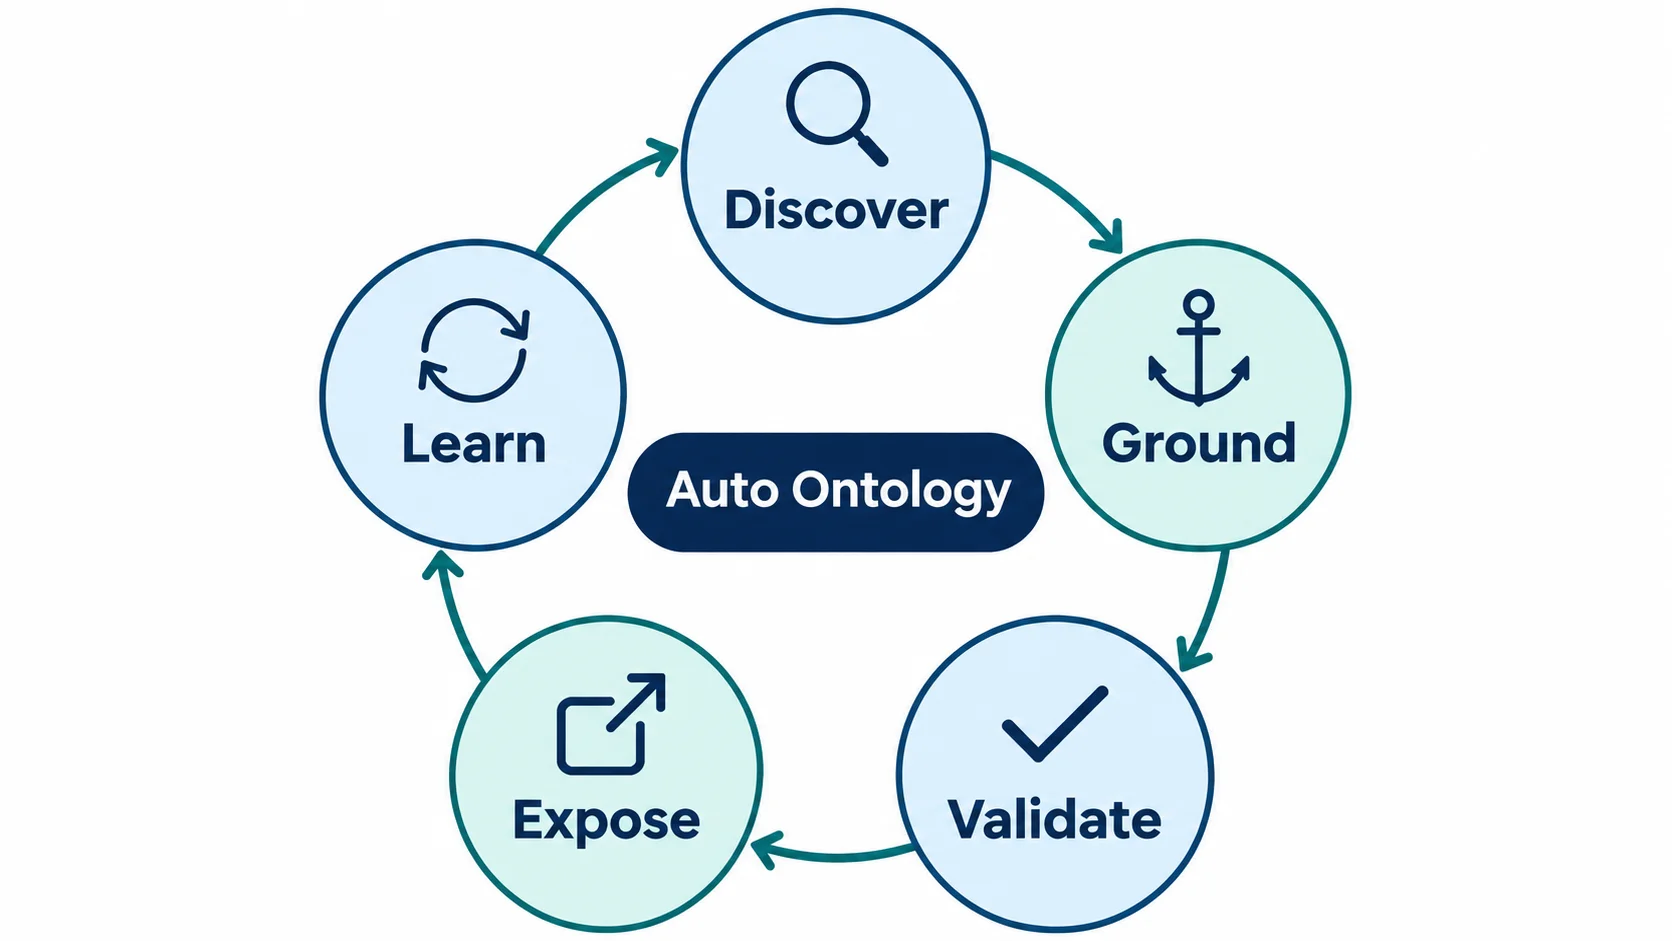
この層は、Discover・Ground・Validate・Expose・Learnの5段階で整える仕組みです。
たとえば、販売管理では「注文日」、会計では「売上計上日」が使われることがあります。エージェントが列名だけを見て判断すると、同じ「月次売上」でも集計条件が変わるためです。定義と関係を共有できれば、質問を受けたときに、どの指標をどのデータへ結び付けるかを先に揃えられます。
- Discover:メタデータから企業オントロジーを生成し、既存のモデルも接続する。
- Ground:指標・エンティティ・関係に業務上の意味を与える。
- Validate:認定済みの定義とデータ系譜で生成クエリを確認する。
- Expose:MCP・CLI・APIでエージェントへコンテキストを渡す。
- Learn:認定済みの修正や利用を反映する。
ポイント
Auto Ontologyの中心はチャット画面ではなく、業務用語・関係・出所をエージェントへ渡す意味層です。まず自社で定義が揺れている指標を一つ選び、その定義を管理できるかを確認します。
自然言語からSQLへ|意味を付けて生成クエリを検証
Auto Ontologyは、構造化データへの自然言語の質問をSQLへ変換し、接続されたデータベースで実行する仕組みです。処理にはNVIDIA NIMのエンドポイントを使え、ホスト型のNVIDIA API CatalogとセルフホストNIMのどちらを選ぶかを環境変数で設定できます。
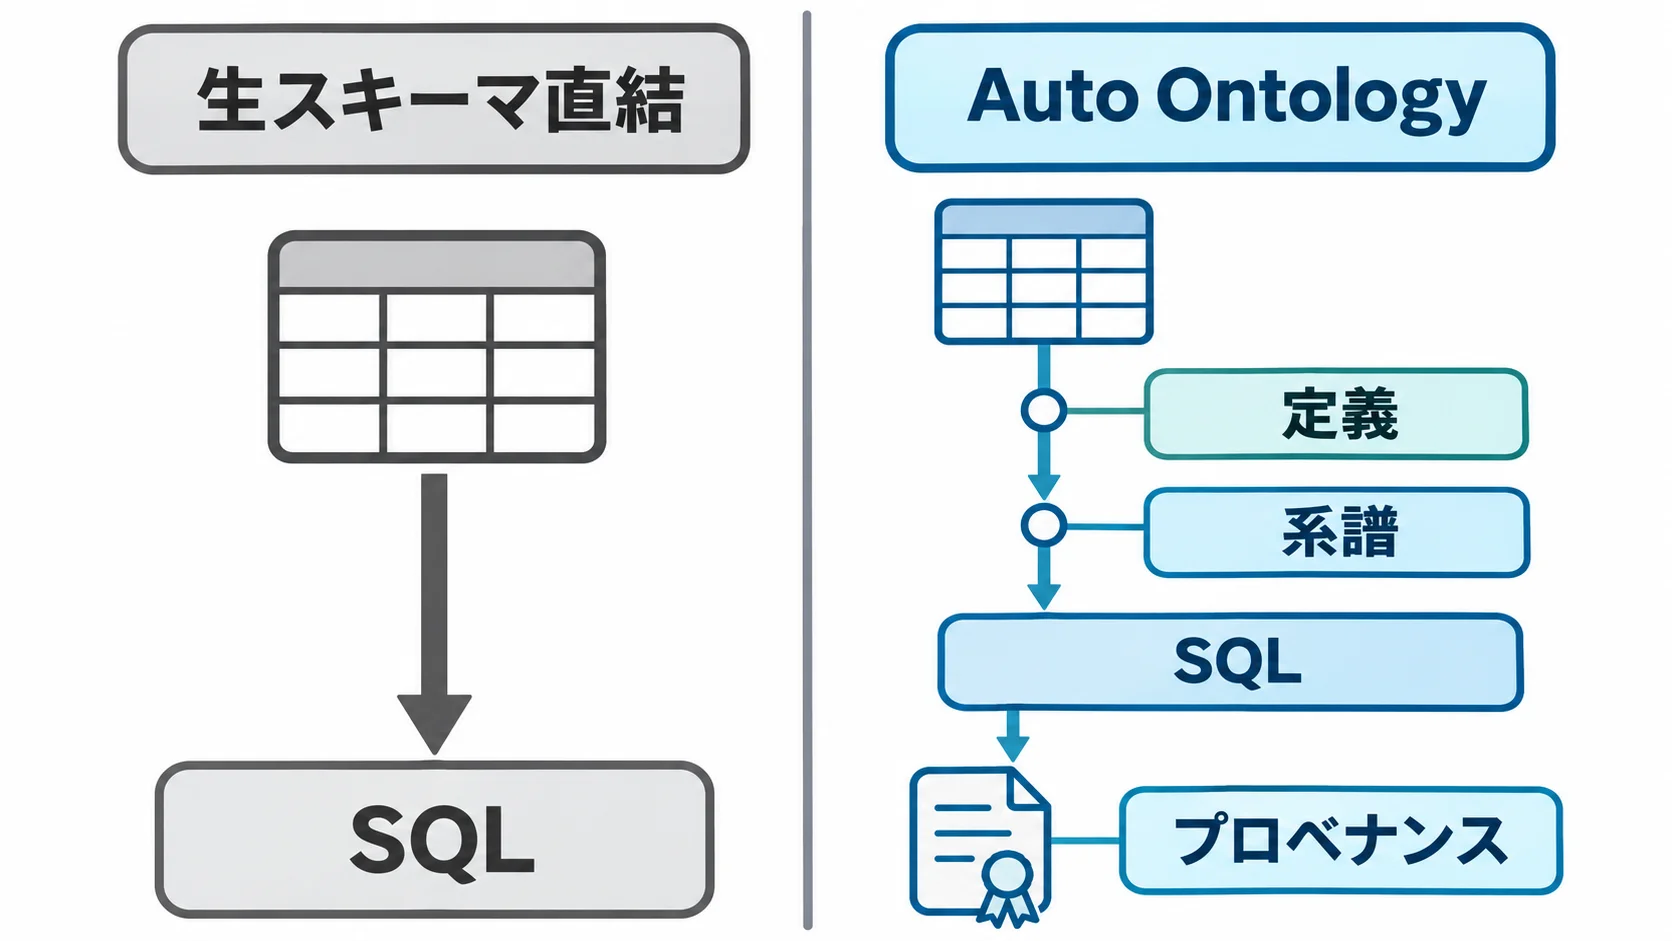
重要なのは、生成したSQLをそのまま実行する設計ではないことです。Auto Ontologyは、認定済みの定義とデータ系譜を使ってクエリを検証し、回答にプロベナンスを返します。AIが「売上」という言葉から選んだテーブルや列を、後から人が追える形にするための機能です。
| 方式 | エージェントが参照する情報 | 回答前に確認するもの |
|---|---|---|
| 生スキーマ直結 | テーブル名・列名。 | 生成されたSQL。 |
| 既存セマンティックモデル | 定義・指標・関係。 | モデル側のルール。 |
| Auto Ontology | メタデータから作るオントロジー、認定定義、系譜。 | 生成クエリと回答の出所。 |
この整理から、既存のデータカタログやセマンティックモデルを置き換える製品と決めつける必要はありません。READMEは、顧客がすでに持つセマンティックモデルを補完し、既存のオントロジーやモデルを接続できると説明しています。採用判断では、今ある定義を移行できるか、二重管理にならないかを確認します。
なお、NVIDIAが示すのは機能の構成です。処理時間や精度の改善率を示す一次情報はないため、導入効果は自社の代表的な質問で測る必要があります。回答の正しさだけでなく、SQL、参照した定義、データの出所を担当者が確認できるかを評価項目にします。
ポイント
評価の単位はチャットの印象ではなく、業務質問・生成SQL・参照定義・回答の出所です。既存モデルを接続できるかと、二重管理を防げるかを先に確認します。
MCP・CLI・APIで公開|エージェントの質問経路を制御する
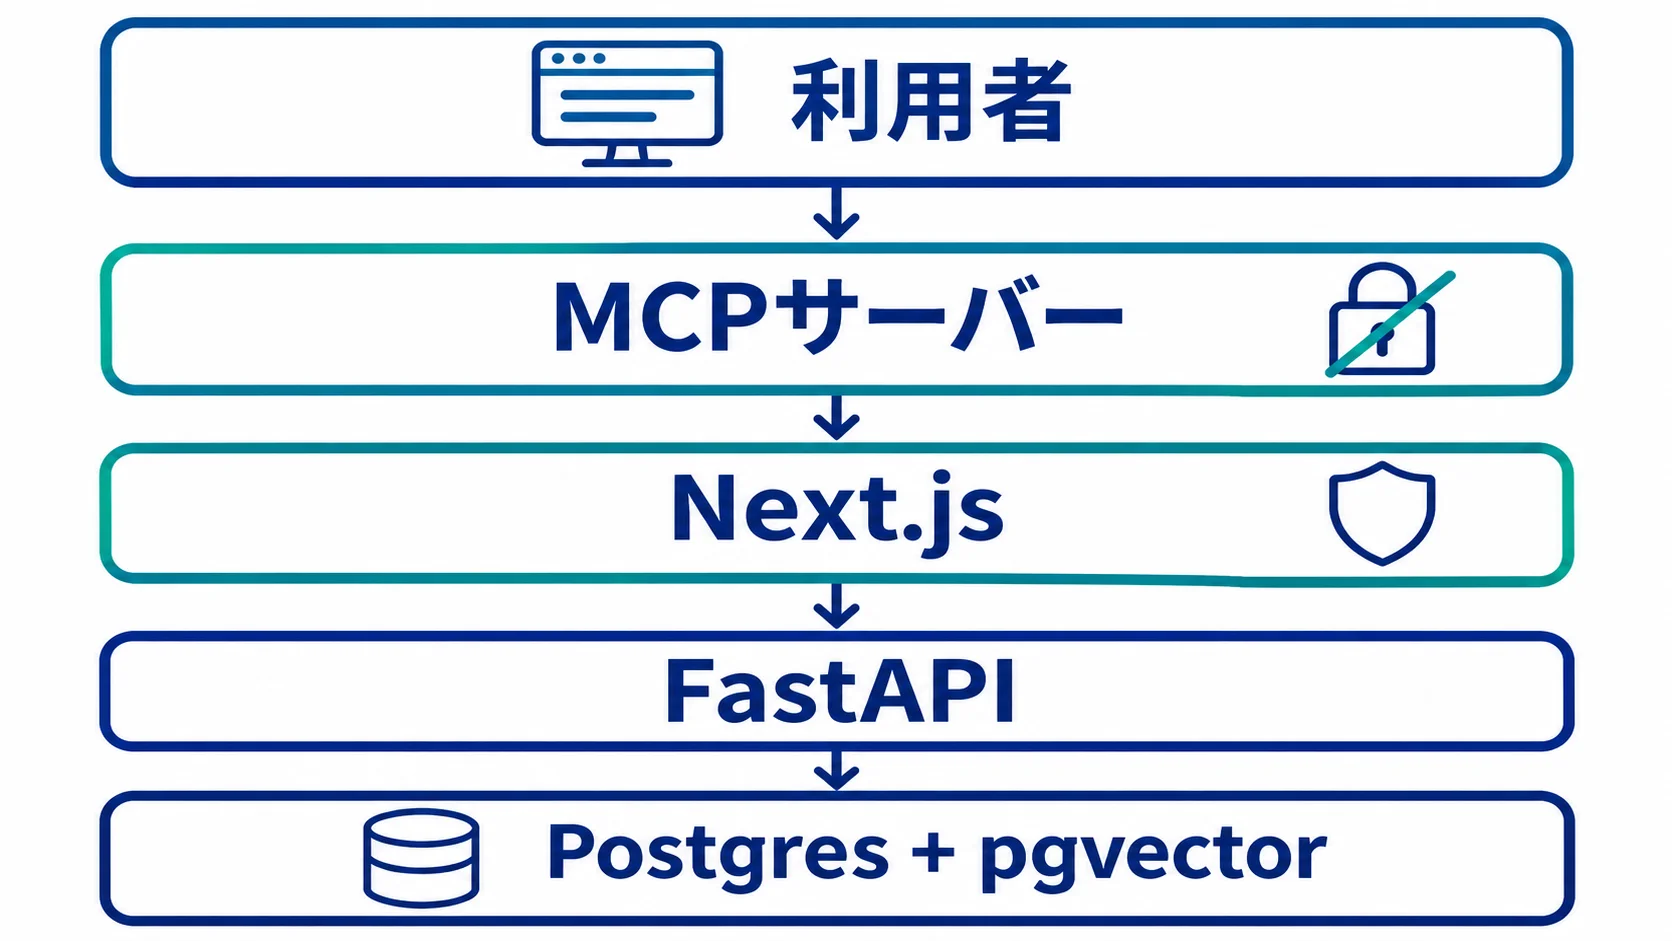
Auto Ontologyは、作った意味層を特定のエージェント製品に閉じ込めず、MCP・CLI・APIで公開します。MCPサーバーはAuto Ontology APIのHTTPクライアントであり、データベース資格情報やモデル設定を持ちません。認証と権限確認はAuto OntologyのNext.js層に任せる構成です。
MCPサーバーには、自然言語で質問して回答・SQL・行データを受け取るask_questionがあります。質問を意味層がカバーできるか判定するcheck_answerableと、デプロイが質問に答えられる状態か調べるcheck_readinessも提供します。用語検索や、用語と物理列の対応を調べるツールも利用対象です。
この順序なら、エージェントがいきなりSQLを実行する流れを先回りして制御可能です。まず準備状態を確認し、質問に対応する用語を探し、回答可能性を判定してから質問します。MCP仕様改定の動きと合わせて、接続方式だけでなく、許可するツールと順番も設計対象です。
MCP仕様改定では、エージェントとツールをつなぐプロトコルの変化を整理しています。Auto OntologyのMCP連携を検討するときは、クライアントの認証、セッション、エンドポイント管理を併せて確認してください。
MCPドキュメントは、提供ツールが用語集、カタログ、基盤データベースを変更しない読み取り専用であると説明しています。分析の自動化を始める段階で、エージェントに書き込み権限を与えず、回答の根拠を返すところから試せる点は、導入範囲を小さくする材料になります。
非人間IDの管理も、MCP接続の設計と切り離せません。利用者の権限を引き継ぐのか、共有サービスアカウントで動かすのかで、監査ログと停止手順が変わります。
ポイント
MCPは接続先を増やすだけの機能ではありません。check_readiness、check_answerable、ask_questionの順序と、読み取り専用の境界を運用ルールにします。
導入前の確認事項|構成・権限・データ移動を切り分ける
Auto Ontologyは、ローカルではDocker Compose、KubernetesではHelmチャートで展開できます。構成は4つです。Web UIと認証・APIゲートウェイを担うNext.jsフロントエンドと、チャットや自然言語からSQLへの変換を担うFastAPIバックエンドがあります。データを取り込むワーカーを置き、カタログとオントロジーをPostgres + pgvectorに保存する構成です。
認証とRBACにはBetter Authを使います。MCPサーバー側に専用のデータベース資格情報を置かず、サインインした利用者の権限で呼び出す設計なので、閲覧者には閲覧者の回答が返ります。ロール変更や利用停止が反映される範囲を、実際の接続経路で確認してください。
NVIDIA NIMは、ホスト型のNVIDIA API Catalogまたはセルフホストを選べます。LLM、埋め込み、リランキングのモデルを環境変数で指定するため、モデルの配置、APIキーの保管、推論データがどこを通るかを社内のデータ管理基準に合わせて決めます。
- 意味の責任者:指標・エンティティ・関係の定義を認定する担当を決める。
- 接続の境界:MCP、API、データベースそれぞれの認証と権限を分けて確認する。
- データの経路:取り込み・埋め込み・推論で社外サービスを通る情報を整理する。
- 回答の監査:質問、SQL、参照定義、行データ、出所を追えるか確かめる。
MCPサーバーのセキュリティ実態を踏まえると、公開エンドポイントの認証と到達範囲も確認が必要です。Auto OntologyのMCPドキュメントが説明する権限継承は、公開範囲を適切に絞って初めて安全側に働きます。
ポイント
導入判断はOSSのコードを動かせるかだけでは決まりません。定義の責任者、データの経路、MCPの公開範囲、NIMの配置、回答の監査方法を一つの設計として確認します。
OSS採用の判断|ライセンスと運用の持続性を分けて見る
Auto OntologyはApache License 2.0で配布されています。ライセンス面では利用・改変・再配布の条件を確認できますが、社内の分析基盤に組み込むなら、更新を誰が追うか、障害時にどこまで自社で直すかも決めなければなりません。
READMEは、現時点で外部からのコントリビューションを受け付けていないと説明しています。これは機能の良し悪しとは別の情報です。採用時は公開Issueやリリース、依存コンポーネントの更新を自社で点検する前提です。MCPサーバーはPyPI公開前で、導入にはGitHub認証付きの取得方法が案内されています。
一方、Kubernetes向けにはバックエンド・取り込み、フロントエンド、MCPサーバーのコンテナイメージとHelmチャートがNVIDIA NGCに用意されています。配布経路があることと、社内で継続運用できることは別です。PoCでは、更新、権限変更、意味定義の修正、接続障害の4つを実際に試します。
AgentOpsで扱う可観測性や評価の考え方も、意味層を導入する段階から必要です。正答率の集計だけで終わらせず、どの定義を使い、どんなSQLを生成し、誰が認定した回答かを記録できる形にします。
ポイント
Apache 2.0は採用の入口です。PoCでは、定義の認定、依存更新、権限変更、データベース障害、MCPの配布経路まで含めて自社の運用責任を確認します。
よくある質問
Q. NVIDIA Auto Ontologyは何ですか?
NVIDIA Auto Ontologyは、企業メタデータからセマンティックなグラフ型推論レイヤーを作るPythonフレームワークです。業務上の意味をAIエージェントへ渡し、Apache License 2.0で配布されています。
Q. Auto OntologyのMCPサーバーはデータベースを変更しますか?
MCPサーバーが提供するツールは読み取り専用で、用語集、カタログ、基盤データベースを変更しません。
Q. Auto Ontologyは利用者ごとの権限を引き継げますか?
引き継げます。MCPサーバーは認証と権限確認をAuto OntologyのNext.js層に任せ、サインインした利用者の権限で回答します。
Q. Auto Ontologyを導入するとき最初に何を確認しますか?
対象にする業務指標の定義、利用者の権限、データと推論の経路、回答のSQLと出所を監査できるかの4点です。
まとめ
NVIDIA Auto Ontologyは、企業データを業務概念と関係に整理し、自然言語からSQLを生成するエージェントに意味と出所を渡すOSSです。MCP・CLI・APIで公開でき、読み取り専用のMCPツールで質問経路を制御できます。
導入時は、既存のセマンティックモデルとの役割分担、NVIDIA NIMとデータベースの接続、利用者権限、定義の認定、回答の監査を分けて確認します。最初から全社データを対象にせず、一つの指標で定義からSQL、出所まで追えるかを試すのが現実的です。
ポイント
Auto Ontologyを評価するときは、AIの回答だけでなく、業務定義・権限・SQL・データの出所を一つの流れで説明できるかを見ます。意味層を運用できる体制が、エージェント導入の前提です。
関連記事
- MCP仕様改定を解説|ステートレス化とAIエージェント連携のポイント
- 非人間IDを解説|AIエージェントの権限管理と監視のポイント
- AgentOpsを解説|AIエージェントの可観測性・評価・監視のポイント
- RAGのプロンプトインジェクションを解説|社内DB参照で必要な防御策
- AIエージェント導入を解説|過度な期待を避けるROI評価のポイント
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
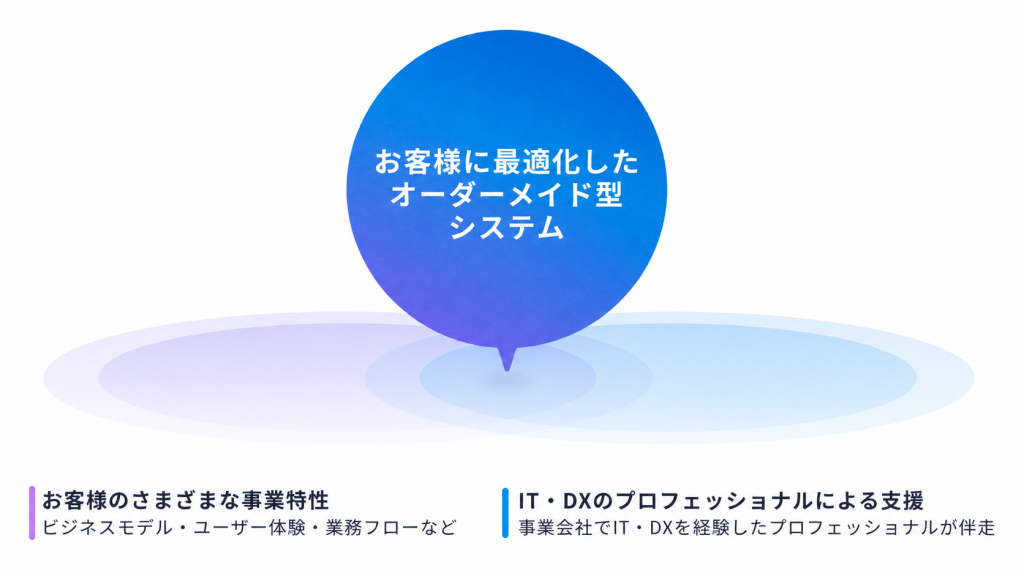
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。
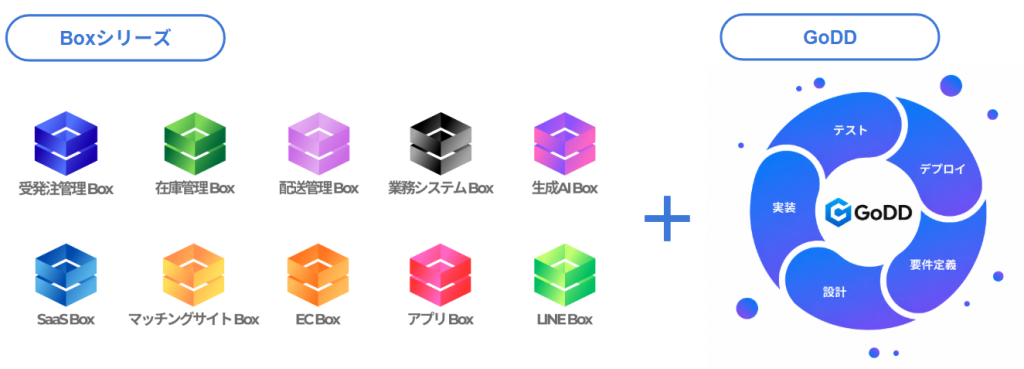
また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。
もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>
株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。