
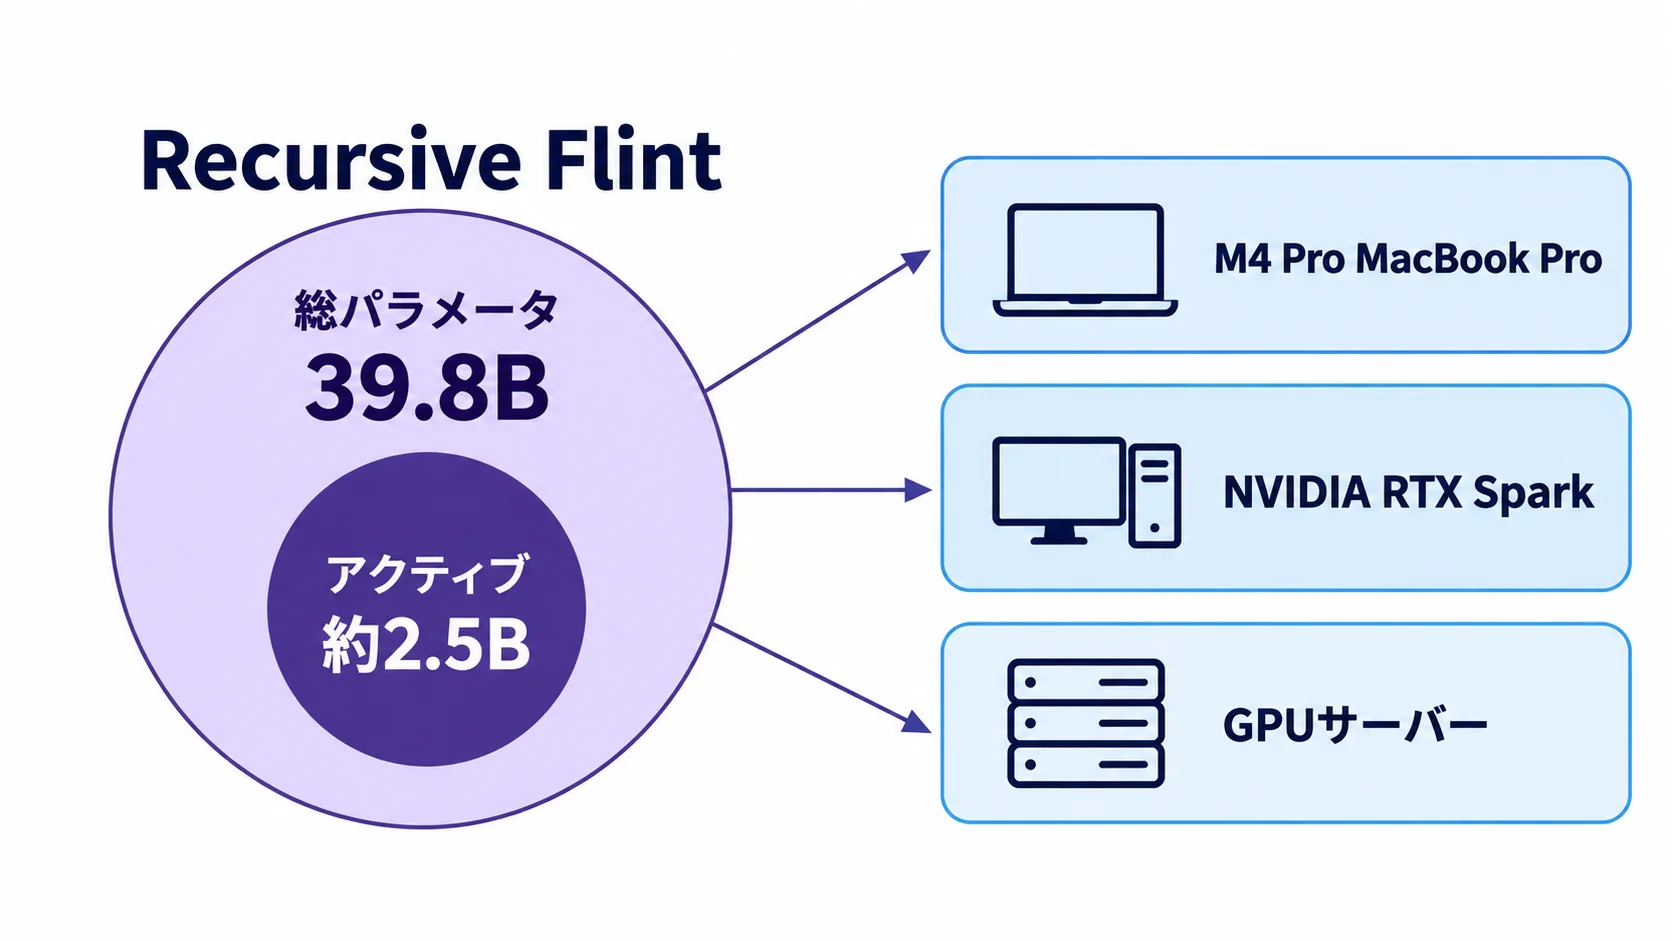
Recursiveは2026年10月21日、ローカルハードウェアでエージェント型コーディングを実行する混合専門家(MoE)モデル「Recursive Flint」を発表しました。総パラメータ数は39.8 billion、1トークンあたりのアクティブパラメータは約2.5 billionで、重みはApache 2.0で公開されています。
同社の発表では、最適化済み推論エンジンを使うとM4 Pro MacBook Proで毎秒125トークン超を生成します。コードを外部サーバーへ送らず、手元の開発機で動かせる選択肢が、40B級モデルにも広がりました。
企業が見るべき点は、数字の大きさだけではありません。ベンチマークの測定条件、量子化版と推論ランタイム、必要なメモリ、エージェントに与える権限を分けて、自社の開発環境で評価する必要があります。
※本記事は2026年10月23日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
Flintとは|40B総パラメータ・約2.5BアクティブのMoE
Flintは、コードベースの調査、バグ修正、機能実装、テスト作成を想定したdecoder-only MoE Transformerです。モデルカードの表記は総パラメータ39.8B、約2.5Bアクティブ/トークン。発表資料での「40B-A2.5B」は、この値を丸めた呼び方です。
MoEは、すべてのパラメータを毎回同じように計算する方式ではありません。Flintは49層のうち2層がdense、47層がMoEで、各MoE層では256のrouted expertsから6つを選び、常時有効なshared expertも使います。総量の大きさと、1トークンごとの計算量を切り分ける設計です。
発表ページは最大512kトークンのコンテキストウィンドウに対応し、コーディングでは256kトークン以内を推奨しています。一方、モデルカードのdocumented context configurationは、プロンプトと生成出力を含む262,144 tokensです。導入時の上限は、使うチェックポイントとランタイムの設定値に合わせて決めます。
ポイント
Flintの「40B」は保存するモデル全体の規模で、「約2.5B」は1トークンごとにアクティブになる規模です。ローカルでの速度とメモリを判断するときは、総量、量子化方式、コンテキスト長を一緒に見ます。
ベンチマークと速度|125 tokens/s超は測定条件とセットで読む
Flintのモデルカードは、Terminal-Bench 2.1で54.9%、SWE-bench Pro v2で89.7%、SWE-bench Verifiedで74.2%を報告しています。エージェント型スコアは少なくとも5回の平均pass@1で、Terminal-BenchはTerminus 2、SWE-benchはmini-swe-agentを使った値です。
| 項目 | 公式に示された値・条件 | 自社評価で見る点 |
|---|---|---|
| 総パラメータ/アクティブ | 39.8B/約2.5B | 量子化版と必要メモリ |
| Terminal-Bench 2.1 | 54.9%、Terminus 2 | 取得経路と評価回数 |
| SWE-bench Pro v2 | 89.7%、mini-swe-agent | リポジトリ・実行環境の差 |
| M4 Pro MacBook Pro | 毎秒125トークン超、短いコンテキスト | コンテキスト長とprefill |
| 64GB NVIDIA RTX Spark | 毎秒150トークン超、短いコンテキスト | GPU・ランタイム・同時実行数 |
毎秒125トークン超という速度は、M4 Pro MacBook Proでの短いコンテキストにおける値です。発表ページは速度を128kトークンのセッション中の平均tokens/sと説明し、prefillを含めていません。大きなリポジトリを最初に読み込む時間や、長い推論の待ち時間まで含めた体感とは区別します。
低コストな推論を選ぶときの見方は、小型モデルの採算を検討する場合と共通します。1回の応答速度だけでなく、コンテキストの読み込み、失敗時の再実行、同時利用者数を含めた処理単位で評価します。
ポイント
Flintの速度とベンチマークは、ハードウェア、コンテキスト長、prefill、エージェント実行環境を含む条件付きの値です。導入判断では同じ条件を再現し、処理全体の時間と成功率を測ります。
自社で動かす条件|Apple SiliconとGPUサーバーを使い分ける
FlintにはBF16チェックポイントと、NVIDIA・Apple Silicon向けに別途用意された量子化版があります。BF16リポジトリには設定、tokenizer、chat template、SGLang serving kitが含まれますが、Transformersのmodeling codeはまだ含まれていません。どの形式を使うかで、必要なハードウェアと起動手順が変わります。
モデルカードのSGLang kitでは、1レプリカあたりB300またはH200の1 GPUで動作し、モデルのダウンロードは約80GBです。これは社内共有サーバー向けの構成に近く、個人のノートPCにBF16版をそのまま置く前提ではありません。
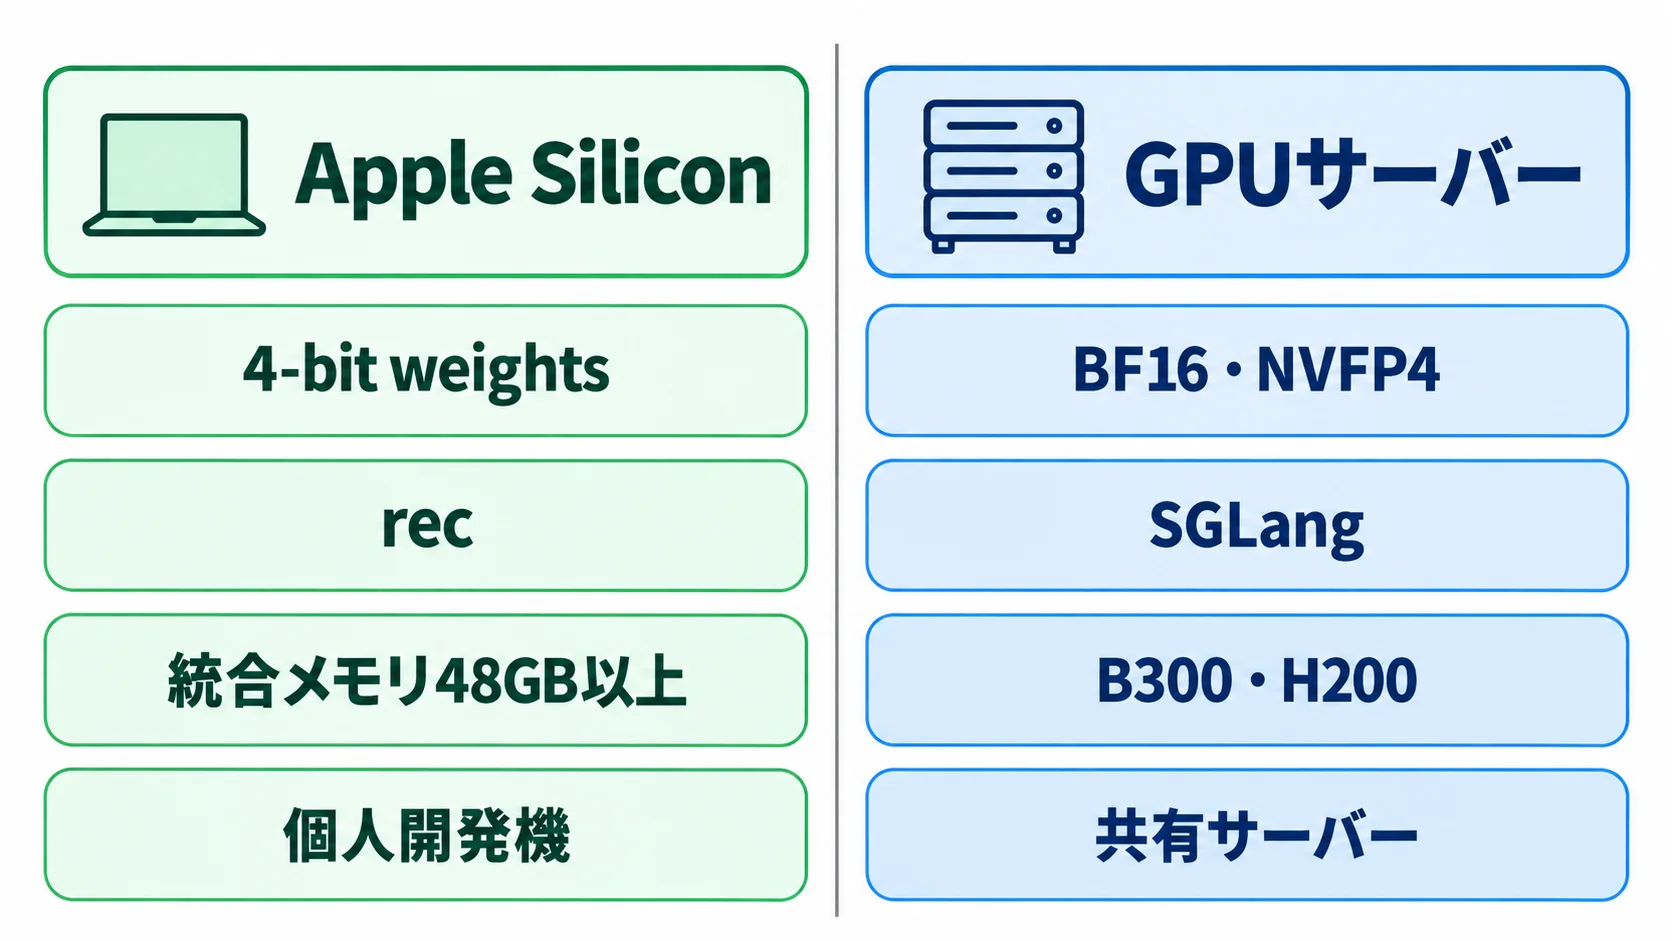
Apple Siliconでは、Recursiveの推論エンジン「rec」が候補になります。公式READMEの要件はM4 Pro、M5 Pro、M5 Maxのいずれか、統合メモリ48GB以上、空きディスク約30GBです。M4 Proで4-bit weightsを使った測定では、コンテキスト長に応じてllama.cpp比1.4〜2.6倍のtoken throughputと説明されています。
- 個人開発機:M4 Pro・M5 Pro・M5 Maxと48GB以上の統合メモリを基準にする。
- 共有サーバー:BF16・NVFP4、GPUメモリ、同時実行数、SGLangの運用を分けて設計する。
- 評価手順:短い応答だけでなく、長いコードベースの読み込みと失敗時の再実行を測る。
- 更新管理:チェックポイント、量子化版、ランタイムの組み合わせを記録する。
オープンウェイトの自社運用では、モデルの規模と配備方式を切り分けることが欠かせません。Mistral Large 4の自社運用を検討するときと同じく、重みを取得できることと、安定した推論サービスを運用できることは別の条件です。
ポイント
Flintの実行先は、M4 Proなどの個人開発機と、B300・H200などの共有GPUサーバーで条件が異なります。チェックポイント、量子化版、ランタイム、同時実行数を一つの配備表にまとめてから試験します。
Apache 2.0とツール連携|重みの自由度と運用責任を分ける
Flintの重みはApache 2.0で公開されています。Recursiveはllama.cpp、Ollama、Unsloth、LM Studio、vLLM、SGLangとの連携を案内し、recではOpenAI互換のchat-completions APIをローカルに提供しています。既存の開発ツールから呼び出す道筋を選びやすい構成です。
ただし、Apache 2.0は重みのライセンスです。モデルカードは、ホスト型APIの規約とデータ取り扱いは重みのライセンスとは別だと明記しています。自社サーバーで重みを動かす場合も、依存するランタイム、量子化版の配布条件、ログや生成物の社内保管を個別に整理します。
エージェントの実行ログや再現性まで扱うなら、AgentOpsの可観測性・評価・監視をモデル選定と同時に設計します。Flintをローカルで動かせても、権限の発行・失効、異常停止、成果物のレビューがなければ、開発工程に安全に組み込めません。
ポイント
Apache 2.0で得られるのは、重みを自社環境で扱う選択肢です。データの保管、ランタイムの構成、ツール権限、ログ、生成コードのレビューは、導入企業が別に設計します。
Eureka Machineと安全策|自動化された開発成果を利用側で評価する
Flintの開発には、Recursiveの自動研究システム「Eureka Machine」が使われました。このシステムはアイデアを提案し、実装し、テストし、結果を次の試行に反映するループを自動化します。Flintではデータ、学習レシピ、インフラ、推論最適化など、モデル構築スタックのほぼ全体に貢献したと説明されています。
技術上の工夫は、推論速度にもつながっています。Eureka Machineは、35B総パラメータ・3Bアクティブのベースラインから専門家構成と幅を探索しました。出力層のlm_headを4 bit量子化し、16 bitモデルを教師とするオフライン蒸留を加え、Apple SiliconとNVIDIA RTX Spark向けに専用カーネルも最適化しています。
自動化された研究で作られたモデルでも、導入側の責任は自動にはなりません。モデルカードは、誤ったコードや不適切なツール呼び出しが起こり得るため、生成コードをテストし、影響の大きい変更を適用する前にレビューするよう求めています。ツール利用アプリケーションには、独自の権限と実行境界も必要です。
最初は読み取り専用のリポジトリ、限定されたテスト環境、変更の人手承認を組み合わせます。AI生成コードのレビューで整理されているように、生成量が増えるほど、レビュー対象の優先順位とテストの自動化がボトルネックになります。
ポイント
Eureka Machineがモデル開発を自動化しても、企業側には生成コードのテスト、変更レビュー、ツール権限、実行境界の設計が残ります。まずは権限を絞った開発環境で、速度と品質を同時に測ります。
よくある質問
Q. Recursive Flintはどのようなモデルですか?
コードベースの調査、バグ修正、機能実装、テスト作成を想定したdecoder-only MoE Transformerです。総パラメータは39.8B、1トークンあたりのアクティブパラメータは約2.5Bです。
Q. M4 Pro MacBook Proでどの程度の速度が出ますか?
Recursiveは、最適化済み推論エンジンを使った短いコンテキストで、M4 Pro MacBook Proが毎秒125トークン超と説明しています。速度は128kトークンのセッション中の平均値で、prefillは含みません。
Q. Flintを自社のPCやサーバーで動かす条件は何ですか?
Apple SiliconではM4 Pro・M5 Pro・M5 Max、統合メモリ48GB以上、空きディスク約30GBがrecの要件です。BF16版をSGLangで動かす場合は、1レプリカあたりB300またはH200の1 GPUと、約80GBのダウンロードが案内されています。
Q. Apache 2.0なら企業がそのまま利用できますか?
Flintの重みはApache 2.0で公開されています。ただし、ホスト型APIの規約・データ取り扱いは重みのライセンスとは別で、企業は推論ランタイム、データ保管、ツール権限、生成コードのレビューを個別に設計します。
まとめ
Recursive Flintは、総パラメータ39.8B、約2.5Bアクティブ/トークンのMoEコーディングモデルです。Apache 2.0の重みをローカルで使え、RecursiveはM4 Pro MacBook Proで毎秒125トークン超、RTX Sparkで毎秒150トークン超という速度を示しています。
自社導入では、速度の数字をそのまま採用基準にしません。チェックポイントと量子化方式、コンテキスト長、推論ランタイム、同時実行数を揃えて測り、入力データの置き場所とエージェント権限を決めます。生成コードのテストと人手レビューまで含めて、開発工程へ組み込めるかを判断します。
ポイント
FlintはローカルAIコーディングの候補になりますが、採用の単位はモデル名ではなく運用構成です。まずは権限を限定した環境で、自社コードの読み込み時間、成功率、レビュー負荷、ログの扱いを測定してください。
関連記事
- Mistral Large 4を解説|1兆パラメータのオープンウェイトモデルと自社運用の選択肢
- 小型モデルで十分な時代を解説|低価格モデルでAIアプリの採算が合う理由
- AI生成コード時代のコードレビューを解説|開発現場のボトルネックと対策
- AgentOpsを解説|AIエージェントの可観測性・評価・監視のポイント
- IPA「AIセキュリティ短信」を解説|AIコーディングエージェントが開発工程の攻撃面になる
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。