
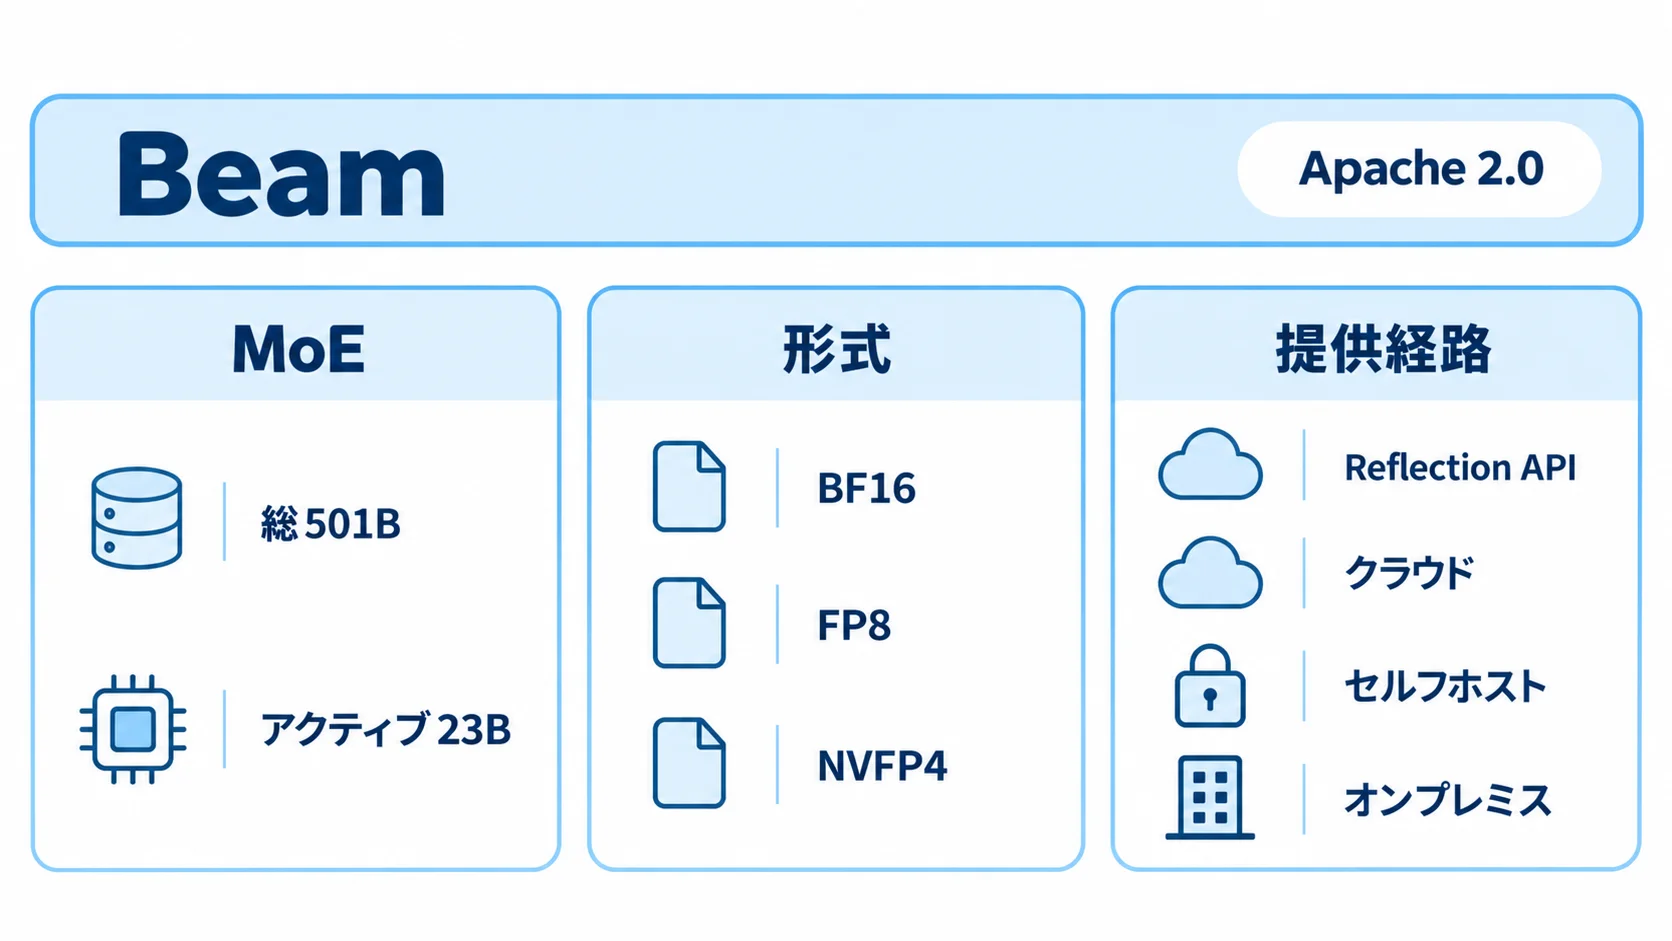
Reflectionは2026年10月16日、初のオープンウェイトモデル「Beam」のウェイトをHugging FaceでApache 2.0ライセンスのもと公開しました。Beamは総501B、アクティブ23BのスパースMoEモデルで、コーディング、推論、長時間のエージェント作業を対象にします。
企業はBeamの利用経路を分けて検討できます。Reflection API、公式発表に列挙されたパートナープラットフォーム、Hugging Face経由のセルフホスト、DellとHPEによるオンプレミスやエアギャップ環境が候補です。Reflectionが示す40超は提供先の数ではなく、パートナーと統合の数です。BF16、FP8、NVFP4の数値形式と1Mトークンのコンテキスト長も、用途と設備に合わせた選定材料です。
オープンウェイトとApache 2.0だけで導入を決めるのは早いでしょう。自社のコードやツールを使い、品質、GPUメモリ、レイテンシ、データ境界、安全評価、モデル更新時の再検証まで一つの導入テストで確かめる必要があります。
※本記事は2026年10月19日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
Beam公開の概要|Apache 2.0と40超のパートナー・統合
Beamの公開は、モデルのファイルを配布しただけではありません。Reflectionはウェイトとドキュメントに加えて、推論、量子化、ファインチューニング、強化学習、エージェントハーネス、評価、可観測性を支えるパートナーと統合を始めました。
公開記事はAmazon Web Services、Google Cloud、Microsoft Foundry、Oracle、Databricks、Cloudflare、CoreWeaveなどを提供先に挙げています。オンプレミス、主権環境、エアギャップ環境ではDellとHPEがファイアウォール内でBeamを提供します。
選択肢が多いほど、比較の軸を先にそろえる必要があります。DeepSeek V4のモデル選定でも、性能だけでなくAPI、料金、運用条件を分けて見ることが導入判断につながります。
BeamはReflection APIの公開ベータで試せるほか、Hugging Faceからウェイトを取得してセルフホストできます。企業はまずAPIで業務タスクを評価し、データを社外に出せない処理だけを自社環境へ移す段階的な進め方も選べます。
ポイント
Apache 2.0は利用権の判断材料です。実行場所、データ処理、可用性、監査、更新責任は、API・パートナー・セルフホストの経路ごとに確認します。
501B MoEの仕様|総パラメータと稼働パラメータを分けて読む
BeamはMoEのため、モデル全体の重みを持ちながら、各トークンでは一部のエキスパートを使います。公式モデルカードの詳細値は総パラメータ501.3B、アクティブパラメータ23.4Bです。公開記事の501B/23Bという表記は、このモデルの規模を端的に示しています。
構成は52層で、denseが3層、MoEが49層です。エキスパートは256、Gated GQAとSliding Window Attentionを採用し、コンテキスト長は1M、語彙サイズは152kです。入力と出力はテキストで、主に英語向けに開発されています。
| 確認項目 | Beamの仕様 | 導入時に見ること |
|---|---|---|
| モデル構成 | 501.3B総パラメータ/23.4Bアクティブ | GPUメモリと同時実行数 |
| コンテキスト | 1Mトークン | 長文処理時の実測レイテンシ |
| 入出力 | テキスト | 画像・音声を別処理にする設計 |
| 言語 | 主に英語向け | 日本語業務の成功率 |
総パラメータ数だけを見て「巨大だから自社では無理」と判断するのも、「アクティブ数が小さいから小型」と判断するのも正しくありません。重みを配置するメモリ、量子化形式、コンテキスト長、同時実行数を組み合わせて、実際の推論構成を見積もります。
ポイント
501Bはモデル全体の規模で、1トークンごとに計算するアクティブパラメータとは別の数字です。設備判断は501.3B/23.4B、数値形式、コンテキスト長を同じテストで測ります。
BF16・FP8・NVFP4と公式評価|品質だけでなく運用条件で選ぶ
公開された命令調整済みモデルにはBF16、FP8、NVFP4の3形式があります。Reflectionは投機的デコーディング用のdrafter modelも公開し、サービング設定やfused kernelsをパートナーと最適化して、メモリ要件と生成速度の改善を狙っています。
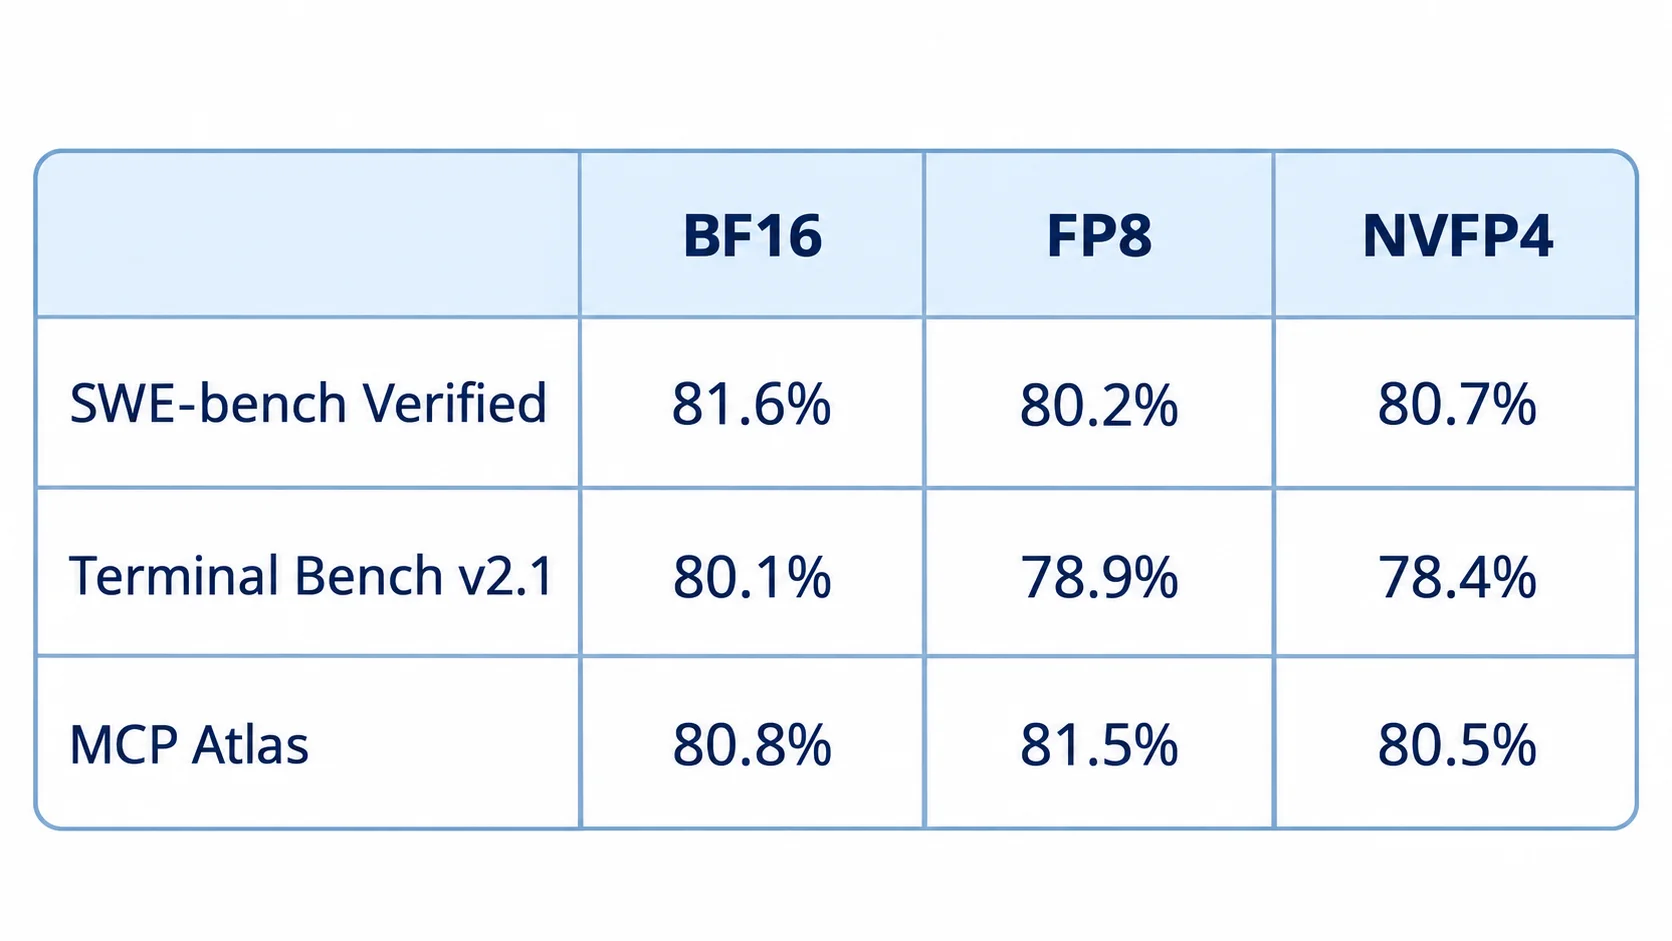
モデルカードの評価条件は温度0.7、top_p=0.99です。SWE-bench VerifiedはBF16 81.6%、FP8 80.2%、NVFP4 80.7%、Terminal Bench v2.1は80.1%、78.9%、78.4%でした。MCP Atlasは80.8%、81.5%、80.5%です。形式ごとの差はタスクで変わります。
安全性も形式別に測定されています。Iris Safety Evaluations(全ハーム領域合算)では、害のある要求への拒否・転換率がBF16 88.9%、FP8 89.7%、NVFP4 88.5%。害のない要求への応答率は81.5%、81.6%、82.1%でした。
これらの数字は候補を絞るための材料です。日本語の社内コード、独自のツール、権限付きの検索を組み合わせたときに、同じ品質になるとは限りません。AgentOpsの評価・監視を用意し、タスク成功率、ツール呼び出しの正確さ、拒否すべき処理の停止率を形式ごとに記録します。
コード生成を組み込む場合は、生成速度だけでなくレビュー負荷も測ります。AI生成コード時代のコードレビューで扱うように、テスト、差分確認、承認者の役割まで含めて本番の合否条件に置きます。
ポイント
BF16・FP8・NVFP4は公式評価の差だけで決めません。品質、GPUメモリ、レイテンシ、安全性、レビュー負荷を自社タスクで同時に測り、形式を選びます。
提供経路とエージェント統合|セルフホストからMirror CLIまで
BeamはTransformers、vLLM、SGLang、Unsloth、Axolotl、TokenSpeed、Dynamoに対応します。ウェイト取得後も、推論サーバーや量子化、評価、エージェントの実行基盤は必要です。対応済みの組み合わせは立ち上げ時の負担を減らします。
ReflectionのMirror CLIは、ターミナルからチェックポイントやエンドポイントを切り替え、ツール呼び出しを承認しながらエージェントを動かすハーネスです。会話の再開、別worktreeでの並列エージェント、プロジェクト指示、スキル、MCP接続、Python拡張にも対応します。
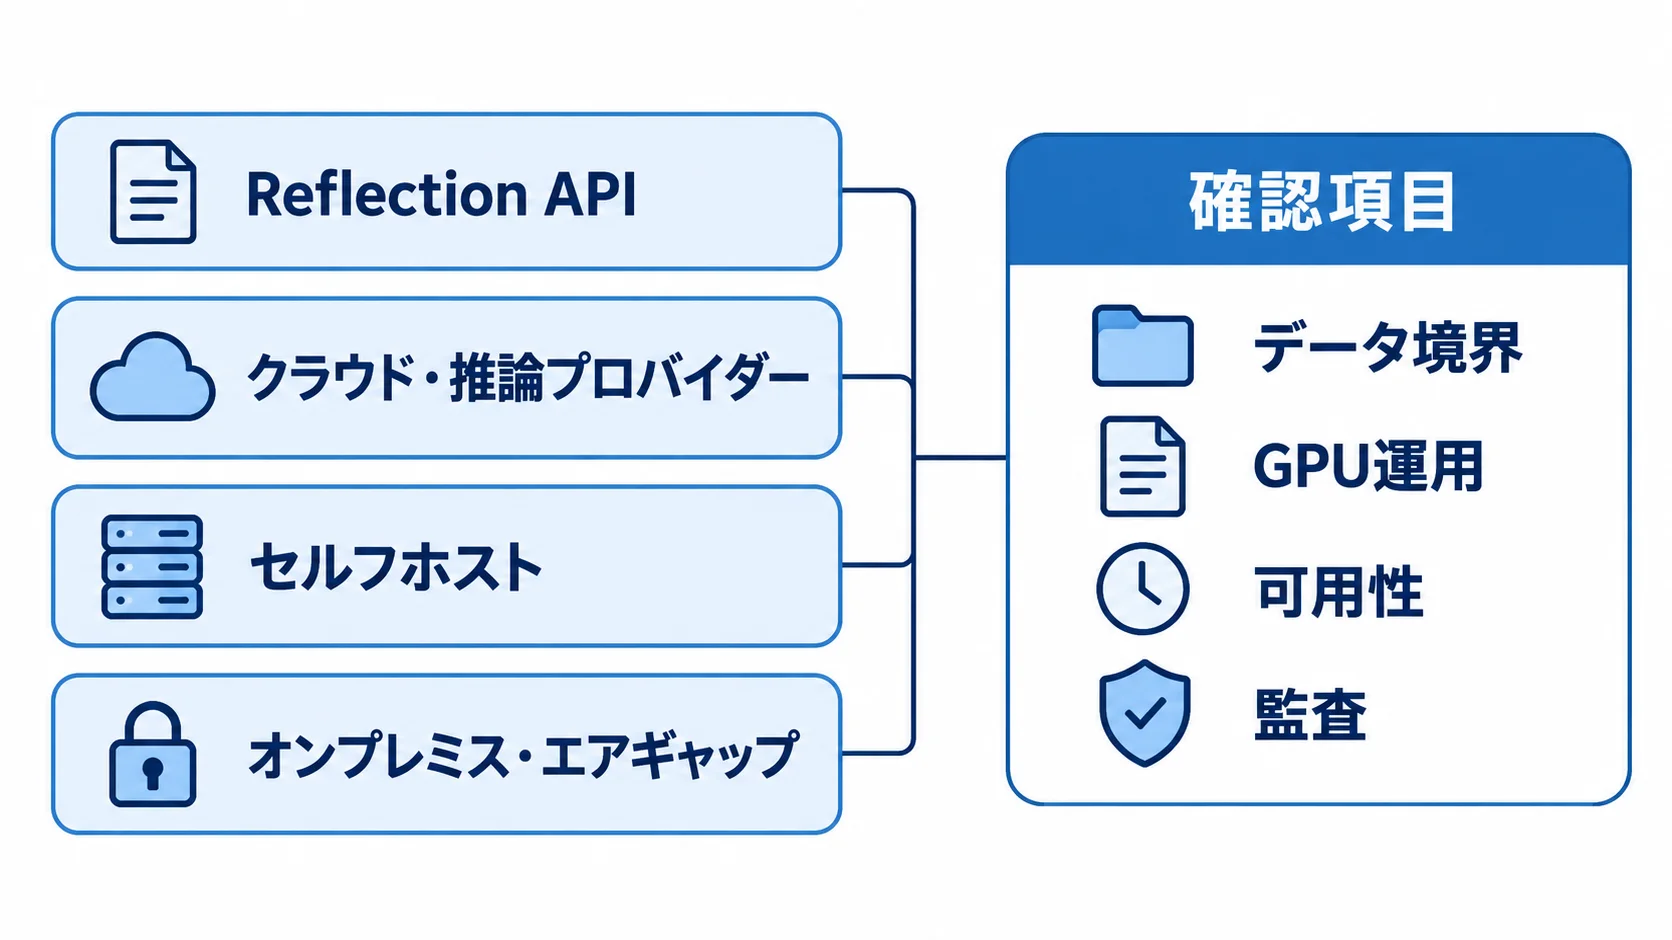
エージェントが社内リポジトリや業務システムへ触れる場合、モデルとハーネスを分けて設計します。モデルをセルフホストしても、ツールの認証情報やMCPサーバーの権限が無制限なら、データ境界は守れません。ツールごとの許可、実行ログ、停止手順、人の承認点を先に決めます。
クラウドや推論プロバイダーを選ぶときは、データ処理条件、リージョン、保存期間、障害時の切り替えを確認します。セルフホストでは、GPUの調達と更新、監視、脆弱性対応、モデル再配布の担当が自社側に移ります。Reflectionが示す40超は提供経路の数ではなく、推論・量子化・評価などを含むパートナーと統合の数です。責任分界は、Reflection API、列挙されたパートナープラットフォーム、セルフホスト、DellとHPEの環境ごとに比較します。
ポイント
提供経路は価格の比較だけでなく、データ境界、GPU運用、可用性、監査、ツール権限の責任分界で選びます。
導入前に確認すべき5項目|自社データとツールで再評価する
BeamをPoCに入れるときは、モデルの性能を測るテストと運用の受入条件を分けません。Apache 2.0の利用条件、主に英語向けという前提、公式評価の測定条件を踏まえ、次の5項目を合否基準にします。
- 用途と言語:日本語、社内用語、コード、長文文書で業務の成功率を測る。
- 品質と安全:正答率、ツール利用、拒否すべき処理の停止、人の承認率を確認する。
- 設備と費用:BF16・FP8・NVFP4のメモリ、レイテンシ、同時実行数を実測する。
- データと法務:入力データの保存、リージョン、ライセンス、プライバシー、輸出管理を確認する。
- 更新と監査:モデル・推論サーバー・ハーネスの変更を記録し、再評価とロールバックを可能にする。
商用利用が可能でも、業務システムへ接続する責任が消えるわけではありません。モデルカードは利用時に関連する法的要件を確認するよう求めています。導入審査では、ライセンス担当、情報システム、セキュリティ、現場の評価担当を同じテスト計画に入れます。
モデルの知識カットオフは2026年6月30日です。最新情報を扱う業務では、検索や社内データを接続したときの引用精度と更新手順を別に検証します。1Mコンテキストを使えることは、入力を増やせば正確になることを意味しません。
最初のPoCは、代表的な業務タスクを少数に絞り、成功・失敗・人の介入を記録します。数値形式や提供経路を変えたときも同じテストを再実行し、品質と運用コストのどちらを優先するかを決めます。
ポイント
公式ベンチマークは候補を絞る材料です。本番可否は、自社の言語・コード・データ・ツール・権限を含む再現テストと、更新時の再評価で決めます。
よくある質問
Q. Beamはどのライセンスで公開されていますか?
BeamのモデルウェイトはApache 2.0ライセンスでHugging Faceに公開されています。
Q. Beamは総パラメータ数501Bをそのまま常時稼働させるモデルですか?
BeamはMoEモデルです。公式モデルカードの総パラメータは501.3B、アクティブパラメータは23.4Bで、総数とトークンごとの計算量は分けて読みます。
Q. Beamはどこで利用できますか?
Reflection API、公式発表に列挙されたAmazon Web ServicesやGoogle Cloudなどのパートナープラットフォームで利用できます。Hugging Faceからのセルフホスト、DellとHPEによるオンプレミス・主権・エアギャップ環境も選べます。なお、40超は提供先の数ではありません。パートナーと統合の数です。
Q. Beamを企業導入するとき、最初に何を検証すべきですか?
自社の言語・コード・データ・ツール・権限を使い、品質、安全性、GPUメモリ、レイテンシを検証します。データ境界と更新時の再評価も、同じPoCに含めます。
まとめ
ReflectionのBeamは、Apache 2.0で公開された総501.3B・アクティブ23.4BのMoEモデルです。BF16、FP8、NVFP4、1Mコンテキスト、コーディングやツール利用への対応を備え、API、クラウド、セルフホスト、オンプレミスという複数の導入経路を持ちます。
企業が見るべきなのは、モデルの大きさやベンチマークの順位だけではありません。自社タスクでの成功率、数値形式ごとの推論コスト、入力データの境界、エージェントの権限、モデル更新時の再評価を一つの運用として設計し、PoCから本番へ進む条件を明確にします。
ポイント
Beamは選択肢を広げるモデルです。導入の合否は、オープンウェイトの利用権ではなく、自社の品質・費用・安全・責任分界を実測して決めます。
関連記事
- Muse Codeを解説|MetaのAI開発ツールと活用ポイント
- Claude Opus 5を解説|性能・料金とモデル選定のポイント
- 中国製オープンウェイトAIを解説|特徴とモデル選定のポイント
- AgentOpsを解説|AIエージェントの可観測性・評価・監視のポイント
- AI推論向けクラウド支出96%増予測を解説|学習から推論への投資シフト
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。