
ITシステムの不具合は、品質管理を徹底しても完全にゼロにはできません。そこで、事象確認、影響範囲の切り分け、トリアージ、対応・クローズの4ステップで、発生後の動き方を決めておきます。
場当たりで対応を続けると、対応が属人化して特定の担当者に負担が偏り、同じ不具合が再発します。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム不具合対応の全体像と基本的な考え方
不具合対応の進め方を理解するうえでは、「事象(インシデント)」と「不具合の原因」を切り分けて考えることが出発点になります。不具合対応の目的は、目の前の事象を早く沈静化させ、利用者への影響を最小限に抑えることで、原因の究明や恒久的な再発防止は、その後に取り組む別のフェーズです。この整理を最初に持っておくと、対応中に判断がぶれにくくなります。
「事象への対応」と「原因の究明」の分け方
不具合対応でつまずきやすいのは、事象が続いている最中に原因究明へ深く入り込んでしまうケースです。利用者が機能を使えない状況で、エンジニアがログ解析に没頭して復旧が後回しになると、ビジネスへの被害は時間とともに拡大します。そのため、まずは「いま起きていることを止める・回避する」ことを最優先し、暫定対応で事象を沈静化させてから、落ち着いて原因究明と恒久対策に取り組みます。
迅速な復旧と根本原因の特定・再発防止は、目的も時間の流れも異なります。前者はスピード勝負の即応活動、後者は腰を据えた分析活動で、両者を同じ流れで混ぜると、どちらも中途半端になります。そのため、対応は事象の切り分けとトリアージから始め、原因究明は対応後の別のステップとして分けます。
不具合対応の核心は「切り分け」と「トリアージ」
不具合は次々と報告され、内容も深刻度もばらばらなので、すべてを同時に同じ熱量で対応しようとすれば、限られた人員はすぐにパンクします。そこで欠かせないのが「切り分け」と「トリアージ」という考え方です。切り分けとは、報告された事象が「どこで」「どの範囲に」「どれくらい」影響しているのかを特定する作業を指します。
トリアージとは、医療現場の用語を借りたもので、限られた資源を最大の効果が出る対象へ配分するために、対応の優先順位を決めることです。深刻で影響範囲の広い不具合から先に手を付け、軽微なものは後回しにするか、あえて対応しないという判断まで含めて、合理的に資源を配分するのが不具合対応の核心です。
不具合対応の進め方|4つのステップ
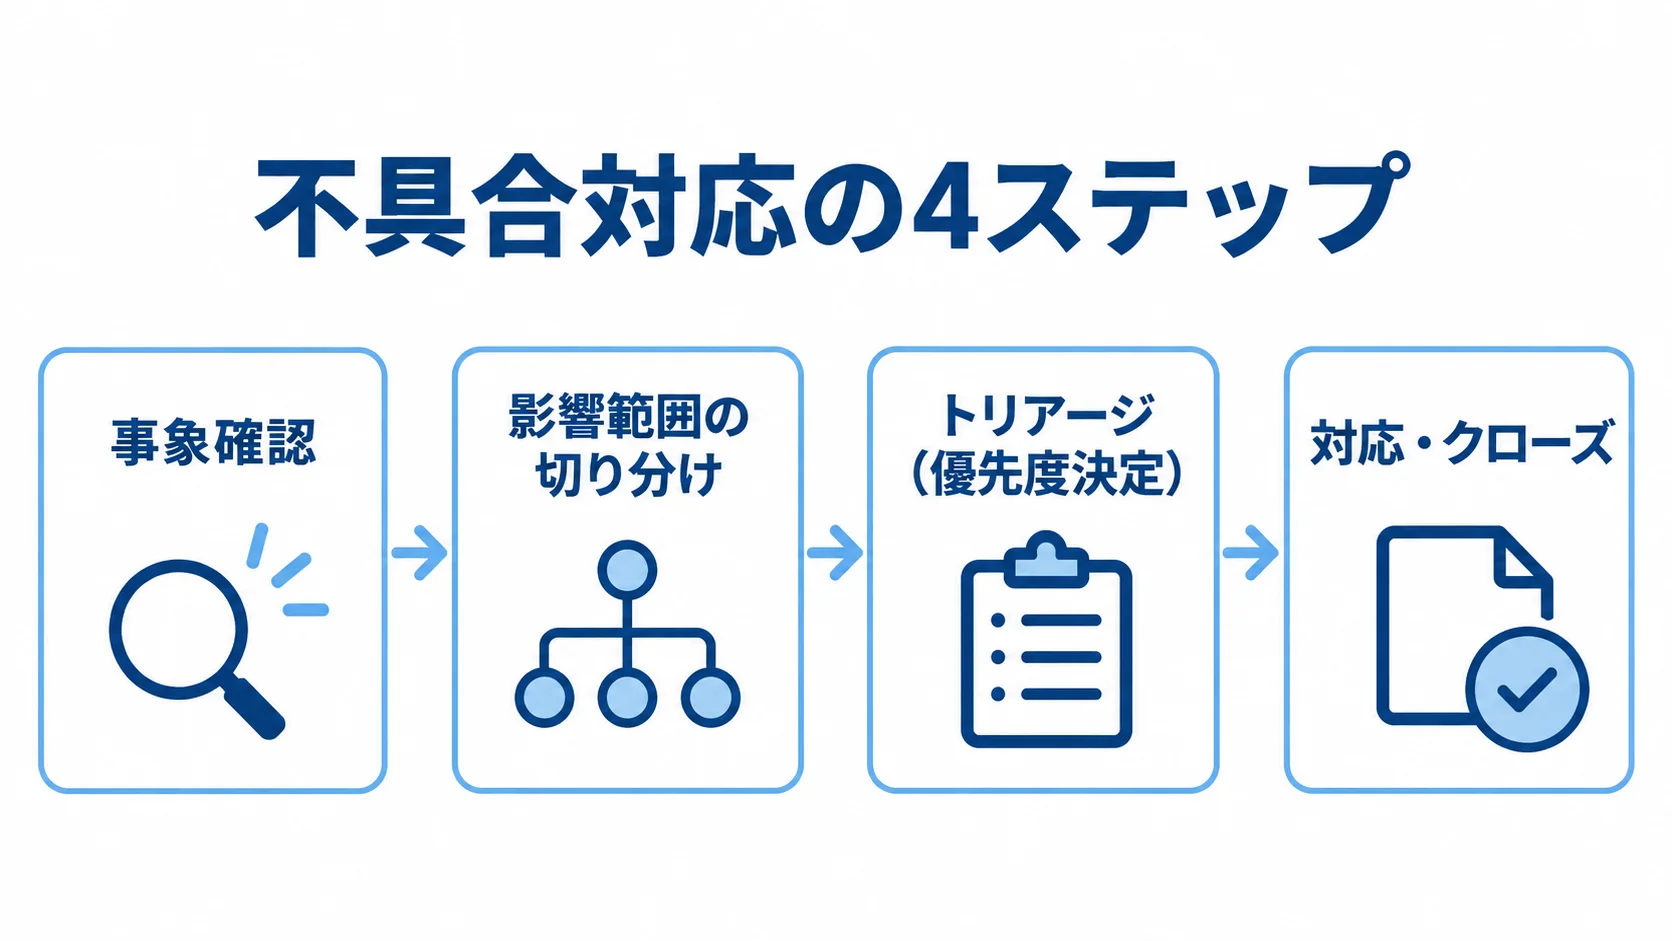
不具合対応の進め方は、「事象確認」「影響範囲の切り分け」「トリアージ(優先度決定)」「対応・クローズ」の4つのステップに整理できます。この流れをチーム全体の共通言語にしておけば、誰が一次受けをしても同じ品質で対応を進められ、属人化の解消につながります。
ステップ1:事象確認(一次受けと再現確認)
最初のステップは、報告された不具合が本当に不具合なのか、どのような操作や条件で起きるのかを確認する一次受けの工程です。利用者からの問い合わせは、操作ミスや仕様の誤解であることも少なくありません。そのため、報告を受けたら、発生日時、利用環境、操作手順、エラーメッセージといった事実情報を整理し、再現性を確認します。
この段階で「いつ」「誰が」「何をしたら」「どうなったか」を5W1Hで記録しておくと、後の切り分けや原因究明がスムーズに進みます。曖昧な報告のまま対応に入ると、再現できずに時間を浪費したり、誤った箇所を直してしまったりします。特に最初の情報整理は、不具合対応全体の品質を左右する重要な工程です。
ステップ2:影響範囲の切り分け
事象が確認できたら、その不具合がどこまで波及しているかを切り分けます。特定の利用者だけなのか全利用者なのか、特定の機能だけなのか業務全体が止まっているのか、特定の環境(ブラウザ・端末・回線)に依存するのかといった観点で、影響範囲を絞り込みます。この切り分けの精度が、次のトリアージでの優先度判断の根拠になります。
切り分けでは、フロントエンド、アプリケーション、データベース、インフラ、外部連携サービスといったレイヤーのどこに問題があるかを、順に確認していくと効率的です。たとえば、一部の画面だけで起きるのか、データ更新を伴う操作でだけ起きるのかを切り分けると、原因の所在を絞り込めます。さらに、後述する外部サービス起因の切り分けも、このステップで見極めておくと対応方針が大きく変わります。
ステップ3〜4:トリアージと対応・クローズ
影響範囲が見えたら、トリアージで優先度を決めます。深刻で広範囲な不具合は即時対応へ、軽微で限定的なものは計画的な対応へと振り分け、暫定対応で止められるものはまず止めます。優先度の付け方は、次章で詳しく見ていきます。
最後のクローズでは、対応内容と結果を記録し、利用者へ完了を連絡します。暫定対応にとどまった場合は、恒久対策を別のタスクとして必ず起票し、未完了のまま放置されないようにします。「直ったように見えるが原因は未解明」という状態を曖昧に終わらせないことが再発防止の第一歩であり、対応記録を残す習慣は後の品質改善にも役立ちます。
トリアージの肝|重要度×緊急度による優先順位付け
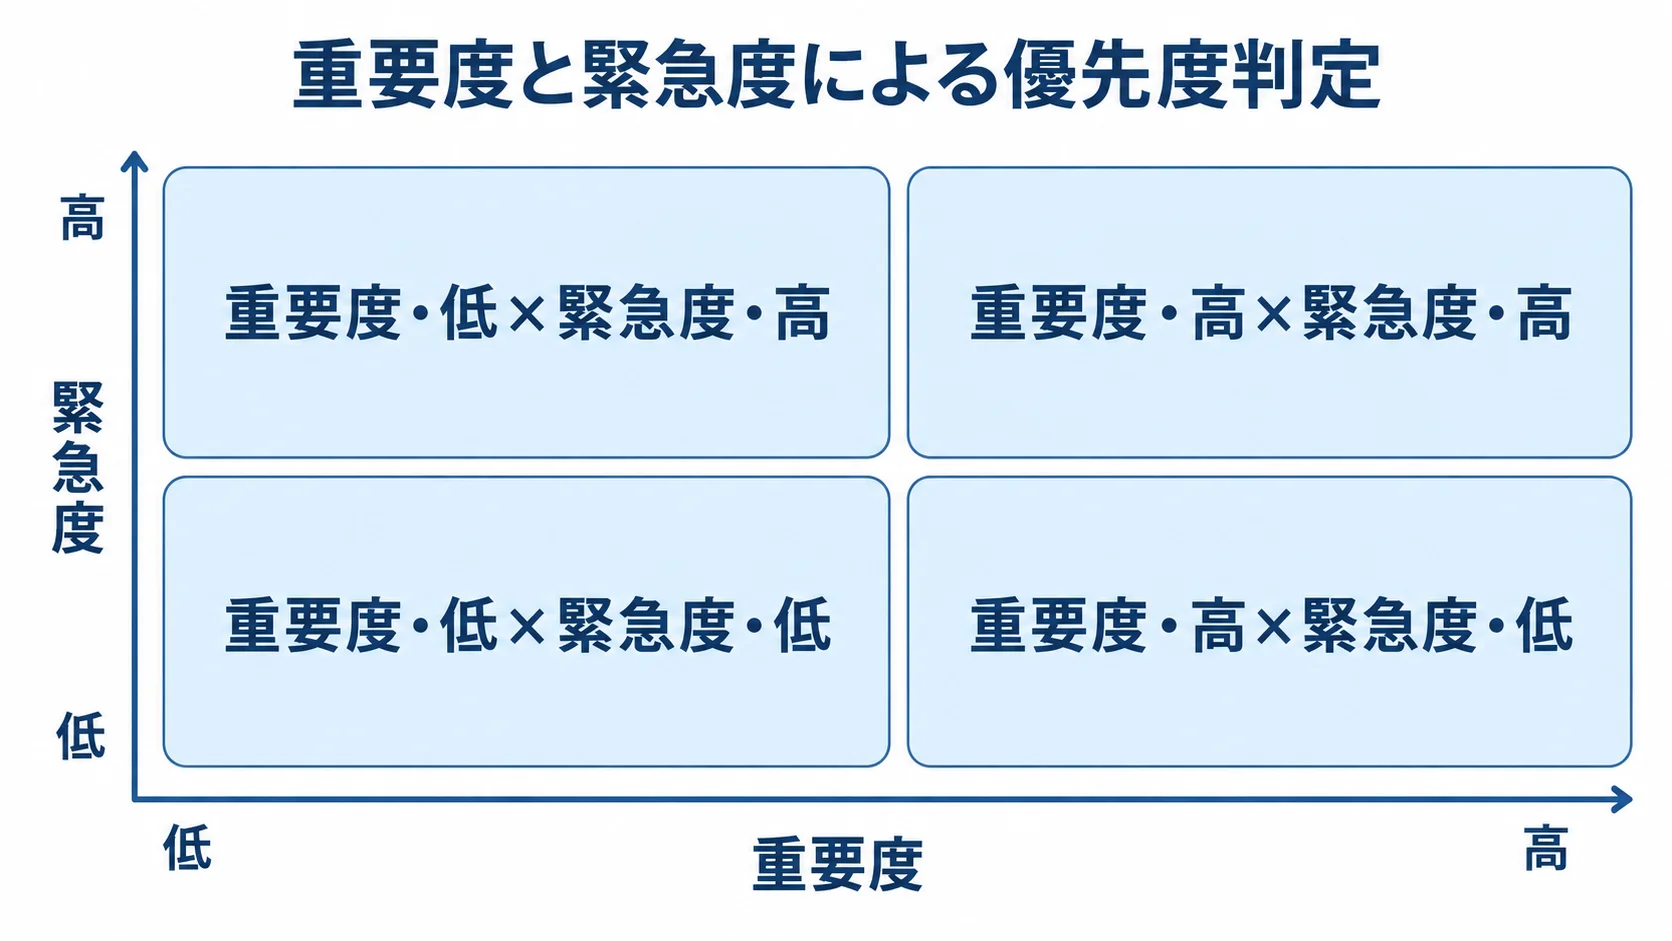
不具合対応の成否を分けるのは、トリアージの精度です。優先順位を感覚で決めていると、声の大きい人の案件や、たまたま目に付いた不具合ばかりが先に処理され、本当に重大な問題が後回しになりがちです。そこで、優先順位を客観的に決めるために「重要度×緊急度」のマトリクスを使い、優先度を歪める落とし穴も避けます。
重要度と緊急度のマトリクスによる判定
優先度は、「重要度」と「緊急度」を掛け合わせて、高・中・低に分類します。重要度は、ビジネスやシステムへの影響の大きさを指し、売上に直結する機能の停止やデータ消失のリスクの有無で測ります。緊急度は、対応までに許される時間の短さを指し、いま止めなければ被害が拡大し続けるか、しばらく猶予があるかで測ります。
具体的には、次の4つの区分で整理します。
- 重要度・高×緊急度・高:全利用者に影響する基幹機能の停止やデータ破損です。最優先で即時に対応します。
- 重要度・高×緊急度・低:影響は大きいものの回避策があり、当面は業務を継続できるものです。恒久対応は計画的に進めます。
- 重要度・低×緊急度・高:影響は軽微でも、放置すると拡大するものです。暫定対応で食い止めます。
- 重要度・低×緊急度・低:軽微な表示崩れなどです。バックログに積み、まとめて対応します。
こうした判定基準を一覧にし、Critical・High・Middle・Lowの区分ごとに「目標の初動時間」と「目標の対応完了時間」をあらかじめ決めておくと、対応のばらつきを抑えられます。たとえば、Criticalは検知から15分以内に初動の連絡をし、1時間以内の暫定復旧を目指します。Highは30分以内にエスカレーションするといった具体的な目標値を設けておくと、現場の判断が早まります。
「検出者バイアス」を防ぐ仕組み
優先度付けで陥りがちな失敗が「検出者バイアス」で、不具合を見つけた担当者や問い合わせを受けた担当者が、自分の視点だけで優先度を高く設定してしまう現象を指します。「とりあえず早く見てもらいたいから」と多くの案件が高優先度に積み上がると、本当に重大な不具合が埋もれ、優先度という仕組みそのものが形骸化します。
これを防ぐには、発見者は事実と影響を正確に報告し、優先度の決定は全体を見渡せる立場の人に委ねる分業が有効です。残課題やリリースの予定、他の案件との兼ね合いを把握しているプロダクトマネージャーやプロダクトオーナーが、最終的な優先度を判断すべきです。この分業が、トリアージの公平性を保ちます。
朝会ではなく「不具合判定会議」での合意
優先度を毎朝のスタンドアップミーティングでその場の勢いで決めると、解析が不十分なまま判断することになり、かえって時間をロスしがちです。短時間の朝会では一件ごとに深く検討できず、そのため後から「やはり優先度が違った」と手戻りが生じます。これは多くの現場が経験する典型的な失敗です。
おすすめは、週に1回など定例で「不具合判定会議」を設け、未対応の不具合一覧を関係者で見ながら、優先度について合意していく進め方です。発生件数の推移を示すバグ曲線や、機能ごとの不具合の偏りを見るゾーン分析といった俯瞰データをもとに議論すれば、個別案件の印象論に流されず、スケジュール全体を見据えた合理的な優先度付けができます。
判定会議で決まった優先度はチーム共通の合意事項となるため、後の蒸し返しも減ります。
属人化を防ぐ対応体制と、人員が少ない現場の進め方
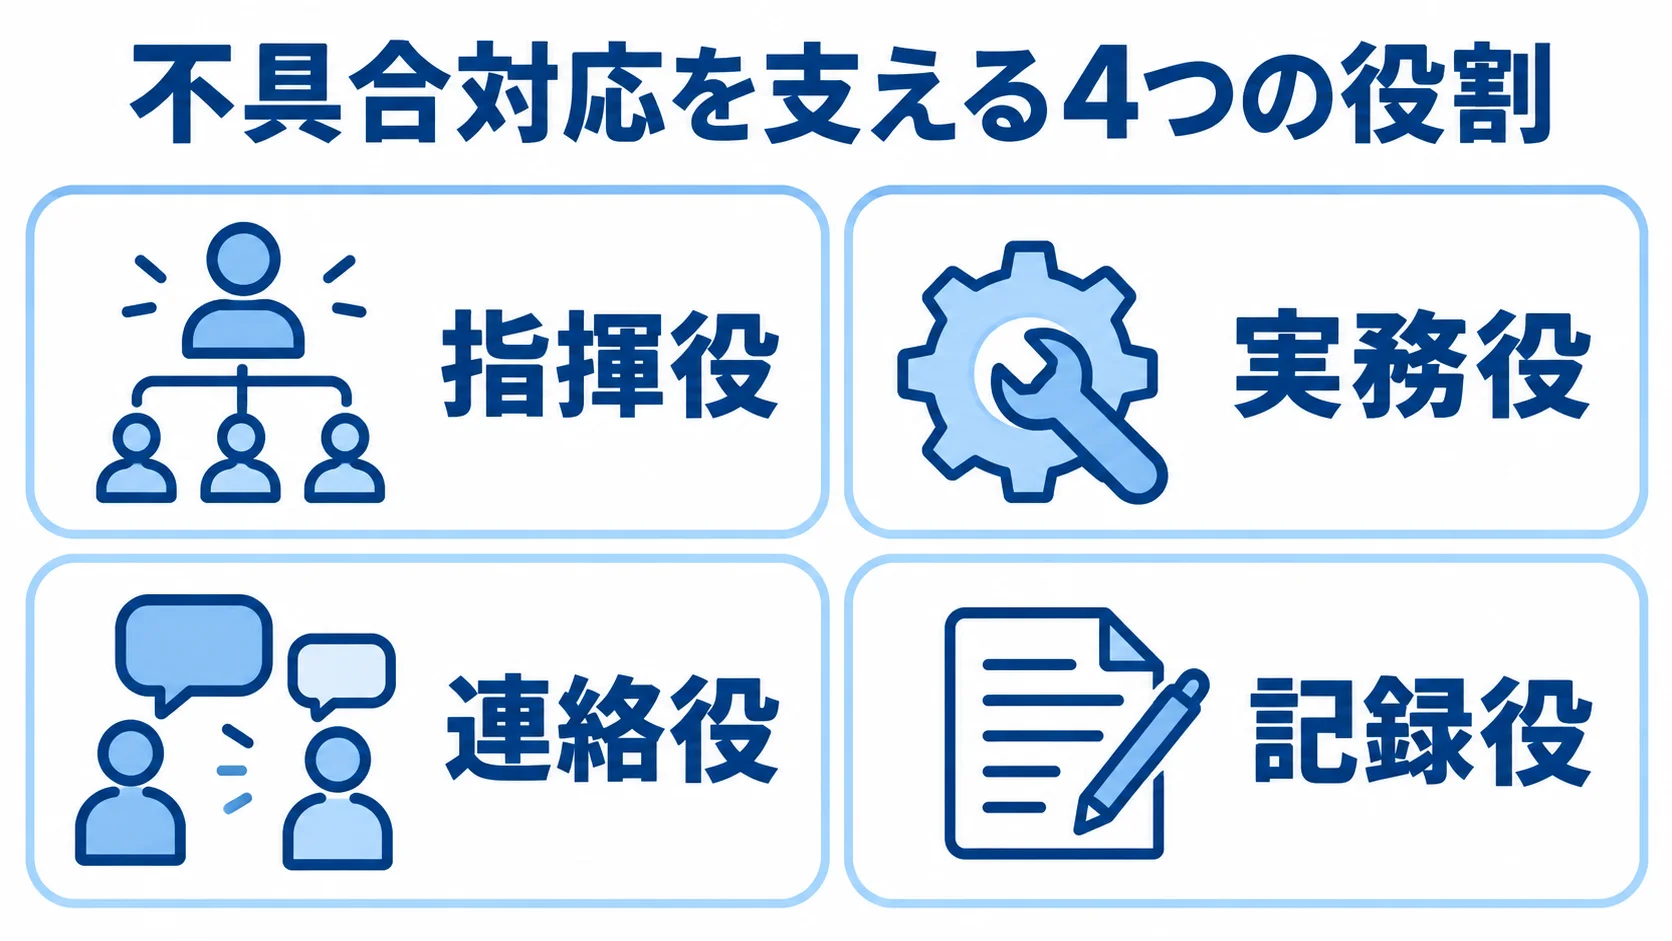
どれだけ進め方が整っていても、対応する人の役割が曖昧だと現場は混乱します。特に重大な不具合では、複数人が同じ作業を重複したり、誰も対外連絡をしていなかったりといった事態が起きがちです。役割分担の基本に加えて、人員が揃わない小規模チームでも回せる「縮退運転」の考え方も押さえておきます。
指揮・実務・連絡・記録の4役割
重大な不具合対応では、役割をあらかじめ分けておくと混乱を防げます。全体を指揮して意思決定する指揮役、実際に調査や修正を行う実務役、利用者や経営層へ状況を伝える連絡役、対応の経緯を時系列で残す記録役が基本の4つです。一人がすべてを抱え込むと、作業に集中している間に連絡が滞り、後から「いつ何をしたか分からない」という事態になります。
特に連絡役は、明確に立てておくことが大切です。原因が未確定の段階でも、「現在調査中」と不確定な点を正直に伝えながら経営層や顧客へ報告する役割を分けておけば、実務役のエンジニアが外部対応に追われて手を止めずに済みます。さらに、役割を決めておくこと自体が、対応の属人化を解消し、誰が初動を担っても一定の品質を保つことにつながります。
1〜2名でも回る「縮退運転」の役割兼務ロジック
役割分担が理想とはいえ、中小企業やスタートアップの夜間対応では、そもそも4人も揃わないのが現実です。そこで役立つのが、人数に応じて役割を統合する「縮退運転」の考え方です。人がいないことを前提に、限られた人員でどう兼務するかをあらかじめ決めておけば、初動で慌てずに済みます。
具体的には、人数別の兼務ルールを次のとおり用意しておくと、現実的に機能します。
- 1名のとき:全役割を一人で兼務しつつ、まず応援を呼ぶことを最優先の行動とします。
- 2名のとき:「対応ライン(指揮兼実務)」と「連絡ライン(連絡兼記録)」の2系統に完全に分け、作業者が外部連絡に時間を取られないようにします。
- 3名以上のとき:指揮役を意思決定に専念させ、別のメンバーへ作業を依頼する本来の体制へ移行します。
2名の場合は、作業と連絡を分けることがポイントです。一人で作業しながら片手間に顧客対応をすると、どちらも中途半端になり、復旧が遅れます。少人数だからこそ、誰が手を動かし、誰が外部とやり取りするかを最初に決めてから動くことで、限られた人員を最大限に活かせます。
オンコール負担の定量化とバーンアウトの防止
不具合対応の体制で見落とされがちなのが、対応者の負担です。深夜や休日のオンコール(待機)対応が特定の担当者に偏り続けると、疲弊や離職につながり、結果として対応力そのものが失われます。属人化の解消は、品質の安定だけでなく、担当者のメンタルヘルスを守るうえでも欠かせません。
対策としては、誰がどれだけ夜間や休日の対応を担ったかを定量的に記録します。負担が偏っていれば、交代の枠を見直したり、待機に対するインセンティブを設けたりすることが有効です。「気合いで乗り切る」前提の体制は長続きしないため、負担を組織として支える仕組みを持つことが、持続可能な不具合対応体制の条件になります。
外部要因の切り分けと「対応しないバグ」の判断
不具合の原因は、自社システムの内側だけにあるとは限りません。外部のSaaSやベンダーが提供するサービスが原因のこともあり、その場合は対応の進め方が大きく変わります。さらに、すべての不具合を必ず直す必要はなく、ビジネス視点で「対応しない」と決める判断も、進め方の一部です。
外部サービス起因の不具合への対応
切り分けの過程で、原因が外部の決済サービスやクラウド基盤、連携APIといった自社の管理外にあると分かることがあります。この場合、自社でコードを直すことはできず、ベンダー側の復旧を待つ局面に入ります。ただし、待つだけでは利用者への説明責任を果たせないため、ベンダーに詳細な情報開示や復旧の見込みを能動的に求める姿勢が必要です。
復旧後には、ベンダーから提出される障害報告書(原因分析の報告)の内容が妥当かを評価します。説明が不十分であれば差し戻し、再提出を求めることも、実務として欠かせません。サービス品質保証(SLA)の違反があれば契約に基づいて協議するなど、外部起因だからと諦めず、ベンダーを適切にコントロールすることも不具合対応の一部です。
「対応しないバグ」を決める視点
見つけたバグはすべて直すのが当然と思われがちですが、ビジネスの視点では、あえて修正しないほうが合理的なケースもあります。修正にかかる工数やリスクを、それによって得られる効果と天秤にかけて判断します。たとえば、発生頻度が極めて低く影響も軽微なバグを、リスクの高い修正で直そうとすれば、かえってデグレ(修正による別の不具合)を招きかねません。
極端な例では、利用者が得をするタイプの不具合をあえて修正せず運営を続けることが、運営側と利用者の双方にとって利益になる場合もあります。大切なのは、すべてのバグを機械的に直すのではなく、ビジネスへの影響も含めて優先度を設計することです。「直さない」という選択肢を明示的に持っておくと、限られた人員を本当に重要な不具合へ集中させられます。
再発防止と記録の残し方|学習資産としての活用
不具合対応は、事象を沈静化させて終わりではありません。対応のたびに教訓を蓄積し、同じ不具合を起こさない仕組みにまとめてこそ、組織の対応力は高まっていきます。そのためには、再発防止につながる記録の残し方と、振り返りの文化が欠かせません。
不具合管理票による経緯の記録
切り分けからトリアージ、対応、クローズまでの経緯は、不具合管理票にまとめて記録します。項目を定型にしておけば、対応の抜け漏れを防げ、同じような不具合が起きたときの参照資料にもなります。中心になるのは、発生日時、再現手順、影響範囲です。ほかに、次の項目も記録します。
- 報告者と担当者
- 優先度
- 暫定対応の内容
- 恒久対策の状況
- ステータス
記録の形式をそろえることは、属人化の解消にも直結します。
特に大切なのは、暫定対応で事象を止めただけの案件を「完了」にしないことです。恒久対策が未着手であれば、その旨を管理票に明記し、別のタスクとして必ず残します。恒久対策は新機能開発のタスクに押し出されて埋もれがちですが、放置すれば同じ不具合が繰り返されるため、管理票で計画的に消化していく運用が再発防止の要になります。
「非難なき文化」による再発防止の精度向上
再発防止策を実のあるものにするには、不具合の振り返りを「犯人探し」にしないことが欠かせません。個人のミスを責める雰囲気があると、担当者は事実を隠したり報告をためらったりするようになり、本当の原因にたどり着けなくなります。ミスを誘発した仕組みやプロセスの欠陥に目を向ける「非難なき文化」を育てることが、精度の高い再発防止につながり、不具合対応を組織の学習資産に変えます。
たとえば、「花瓶の水を換えようとして落として割ってしまった」という失敗があったとします。これを「不注意な個人の責任」と見るより、「水場までの移動経路が悪かった」「割れやすい材質だった」という環境や仕組みに根本原因を見いだすのが、非難なき文化の発想です。
振り返りの場では、「なぜ(あなたが)ミスをしたのか」と個人を問うより、「どのようにして事象が起きたのか」と仕組みに目を向けるだけで、議論の質が大きく変わります。
関連記事と外部委託という選択肢
不具合対応の進め方を整えても、24時間365日の監視や、専門性の高い切り分けを自社だけで賄うのは難しい場合があります。そうしたときは、運用監視やインシデント対応を専門会社へ委託することも現実的な選択肢です。関連するテーマと、外部委託を検討するときの考え方も、あわせて見ていきます。
あわせて読みたい関連記事
ここまでは、不具合対応の進め方を切り分けとトリアージを中心に解説してきました。費用感や会社選び、発注方法など、それぞれのテーマをさらに詳しく知りたい方は、次の関連記事もあわせてご覧ください。
・ITシステム不具合対応でおすすめの開発会社/ベンダー6選と選び方
・ITシステム不具合対応の見積相場や費用/コスト/値段について
・ITシステム不具合対応の発注/外注/依頼/委託方法について
・ITシステム不具合対応の完全ガイド
外部委託を検討すべきケース
自社のエンジニアが本来注力すべき開発業務に集中できるよう、不具合の一次受けや夜間監視を外部へ委託するのは合理的な判断です。特に、オンコール負担の偏りが深刻な場合や、専門的な切り分けの知見が不足している場合は、運用代行やインシデント管理のサービスが役立ちます。これらを使うことで、対応品質を一定水準に保ちながら、社内の負荷を下げられます。
委託する際は、どこまでの範囲を任せるのか、目標とする初動時間や復旧時間をどう設定するのか、エスカレーションの基準をどう取り決めるのかを明確にしておきます。ここまで解説したトリアージの考え方や役割分担を委託先と共有し、自社の判断基準を持ったうえで連携することで、外部委託は最大の効果を発揮します。
まとめ
ITシステム不具合対応の進め方は、「事象確認」「影響範囲の切り分け」「トリアージ」「対応・クローズ」の4ステップを、チーム共通の言葉として浸透させることから始まります。なかでも中心になるのが、重要度と緊急度のマトリクスで優先度を客観的に判定するトリアージです。検出者バイアスを防ぎ、週次の不具合判定会議で合意形成する運用を持てば、声の大きさや印象に流されない優先順位付けが実現します。
体制面では、指揮・実務・連絡・記録の4役割を明確にし、人員が揃わない現場では人数に応じた縮退運転で兼務できるようにしておくことが、属人化とバーンアウトの両方を防ぎます。さらに、外部サービス起因の切り分けやベンダーへの対応、あえて「直さない」と決める判断、非難なき文化による記録と再発防止までを一連で設計できれば、場当たり的な対応から組織の学習資産へと変わります。
まずは自社の不具合管理票とトリアージ基準を整えるところから始めてみてください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。