
ITシステム保守構築の進め方は、現状の棚卸しと監視対象の選定から始め、ツール選定としきい値設計、ダッシュボードと運用ルールの整備へと進みます。
- 監視基盤:監視対象と通知条件の設計
- 運用ルール:アラートへの対応手順の整備
- 改善:導入後の運用負荷の見直し
監視ツールを導入するだけで終わらせず、監視対象、通知条件、対応者まで作り込んで、はじめて「落ちないシステム」が実現します。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム保守構築の全体像
ITシステム保守構築とは、システムを安定して動かし続けるための「監視・対応の仕組み」を設計し、実際に動く状態まで作り上げる工程です。
障害対応そのものより、その対応を支える基盤づくりに焦点が当たるのが特徴です。ここを丁寧に作り込めるかどうかで、リリース後の運用負荷は大きく変わります。
保守構築は、監視基盤の構築(仕組みづくり)と運用ルールの整備(人の動き方の設計)を一体で進めるものです。どれだけ高機能な監視ツールを入れても、誰がどのアラートにどう対応するかが決まっていなければ機能しません。逆に、運用ルールだけ整えても、それを支える監視の仕組みがなければ絵に描いた餅になります。
保守構築と運用・保守の違い
「保守構築」と「運用保守」は混同されがちですが、フェーズが異なります。運用保守はシステムが稼働している間の日々の運用(監視・障害対応・問い合わせ対応など)を指すのに対し、保守構築は、その運用保守を成り立たせる土台を作る初期フェーズを指します。
家にたとえるなら、運用保守は日々の暮らしや掃除にあたり、保守構築は配線や水道、防犯設備を設計して敷設する工事に相当します。この区別が重要なのは、保守構築の品質がその後何年もの運用コストを左右するからです。最初の構築に投資する価値は、こうした運用フェーズでの効果に表れます。
たとえば、監視対象や通知ルールの設計が雑だと、運用が始まってから「アラートが鳴りやまない」「重要な障害だけ埋もれる」といった問題が慢性化し、担当者が疲弊します。一方で、しきい値や監視設計を最適化した中小企業では、ネットワーク監視ツールの導入と異常検知・原因切り分けの自動化により、トラブル対応工数を最大約8割削減した導入事例も報告されています。
保守構築を構成する主な要素
保守構築では、どのサーバー・サービス・指標を見るかといった監視対象を定め、監視ツールを選んで導入し、しきい値と通知条件を設計します。さらに、アラートの重要度レベルを定め、ダッシュボードやレポートを整えて、エスカレーションを含む運用ルールを文書にまとめます。
これらが揃ってはじめて、障害発生時に「検知から対応まで」が淀みなく流れる状態になります。特に見落とされやすいのは、ツール導入に偏って運用ルールの文書化が後回しになるパターンです。役割分担が曖昧なまま稼働すると、障害時に「誰が判断するのか」で時間を浪費します。
監視やアラートの運用設計をより深く知りたい方は、ITシステム保守監視の進め方やITシステムアラート対応の進め方もあわせてご覧ください。
ITシステム保守構築の進め方とフェーズ
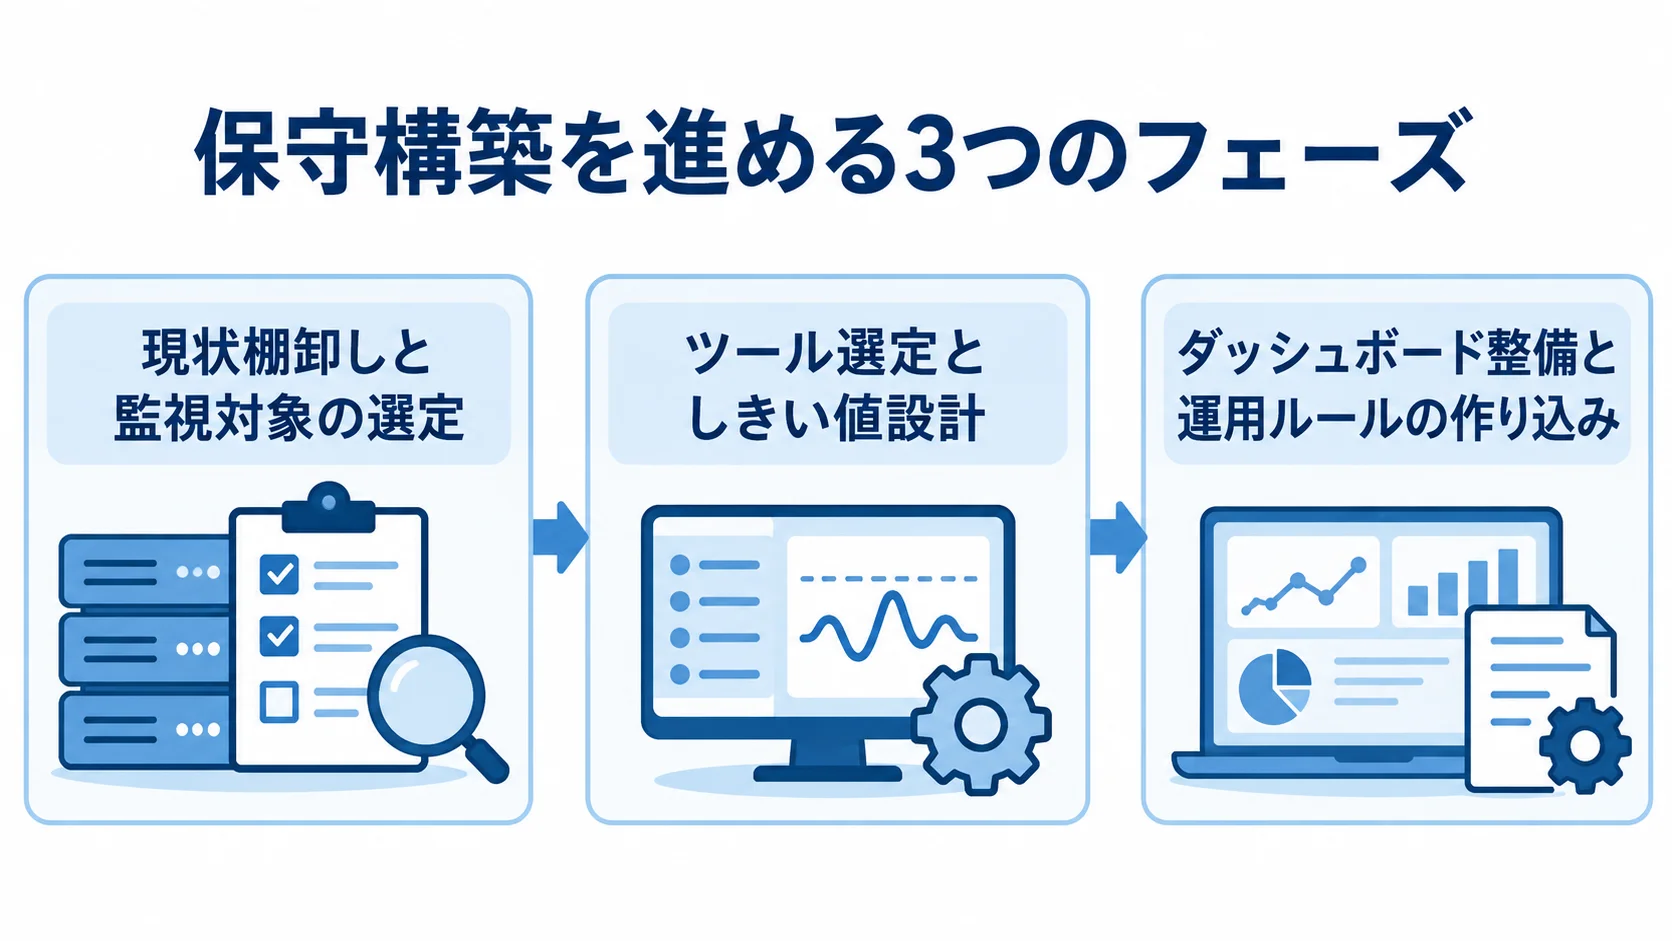
ITシステム保守構築は、思いつきでツールを入れるのではなく、明確なフェーズに沿って進めることで失敗を防げます。
作業は「現状棚卸しと監視対象の選定」「ツール選定としきい値設計」「ダッシュボード整備と運用ルールの作り込み」の3つのフェーズに分かれます。
フェーズ1:現状棚卸しと監視対象の選定
最初に、守るべきシステムの現状を洗い出します。稼働中の機器やアプリケーション、クラウドサービスなどを挙げ、それぞれがビジネス上どれだけ重要かを確認します。ここで「すべてを監視しよう」と欲張ると、アラートが増えすぎるため、ビジネスインパクトの大きいものから優先順位を付けるのが鉄則です。
監視対象の選定では、システムの「正常な状態」も定めておきます。CPU使用率やメモリ、ディスク残量といった指標に加え、レスポンスタイムやエラー率についても、平常時の値を把握しておく必要があります。平常時の値がなければ、何を「異常」とみなすかを決められません。
この段階で各システムのオーナーや責任者を明確にしておくと、後のエスカレーション設計がスムーズになります。監視対象一覧(システム名・重要度・正常値の範囲・責任者)を一枚の表にまとめておくと、ツール選定や運用ルール設計のすべての土台になります。外部ベンダーへ委託する場合も、この一覧の有無で見積もりの精度や立ち上げの速さが大きく変わります。
フェーズ2:監視ツール選定としきい値設計
監視対象が定まったら監視ツールを選びますが、「とりあえず高機能だから」と統合ツールを選ぶと、使いこなせず費用だけがかさみがちです。監視ツールは、大きく高機能なものと手軽なものの2種類に分かれます。
- 高機能ツール:Datadogのように、高速でセキュリティも強力ですが、使いこなすには相応の知識が必要で、価格も高めです。
- 手軽なツール:Site24x7のように、安価でもカバー範囲は控えめです。
自社の規模やスキルに合わないツールは、構築フェーズで挫折する原因になります。高機能と手軽さのどちらが今の自社に必要かを冷静に見極めることが、構築の成否を分けます。そのため、自社に合うツールを選び、スモールスタートできるSaaS型から始めるのが近年の主流です。
ツール選定で最も技術的に重要なのは、しきい値(通知の条件)の設計です。デフォルト設定のままCPU使用率80%で通知すると、一瞬のスパイクでもアラートが鳴る「アラート地獄」に陥ります。これを避けるには、瞬間値ではなく継続時間を条件に加え、「CPU80%が5分間継続したら通知」と設計して、ノイズを大幅に減らします。構築段階で、自動で捌けるものと人が見るものを切り分けると運用負荷が下がります。
あわせて、アラートの重要度レベル(緊急・警告・情報など)を定め、レベルごとに通知先や通知手段を変えます。すべてを同じ強さで通知すると、本当に重要な障害が埋もれてしまうため、この区分が欠かせません。先進的な現場では、アイレットのcloudpackがアラートの約80%を社内システムで自動処理し、人が対応するのは残り20%に絞っています。
フェーズ3:ダッシュボード整備と運用ルールの作り込み
監視とアラートの仕組みができたら、状況を一目で把握できるダッシュボードを整えます。経営層と運用担当、開発担当とでは見たい情報が異なるため、利用者ごとに必要な指標を整理して画面を設計します。日々の稼働率やインシデント件数を定期レポートで可視化しておくと、SLAやKPIの達成状況を客観的に追えるようになり、改善のPDCAが回り始めます。
保守構築の総仕上げは、運用ルールの作り込みです。アラートを受けた担当者の動きを定めた「プレイブック(対応手順書)」を用意し、一次対応の担当と、解決できない場合のエスカレーション先を明文化します。ここで役立つのが、L1/L2/L3の階層設計とRACI(実行責任・説明責任・相談先・報告先)による責任分界で、これがないと障害時に判断が止まり、復旧が遅れます。
運用ルールは一度作って終わりではなく、稼働後も「鳴りすぎるアラート」「鳴らなすぎる箇所」を継続的にチューニングする前提で設計します。ある運用代行サービスでは、再発防止フローの徹底と二次運用チームによる恒久改善(半期で30件以上)を続けた結果、アラートの正常対応率99.99%を達成し、対応時間を累計1万時間以上削減した実績もあります。
失敗しない監視基盤設計のポイント
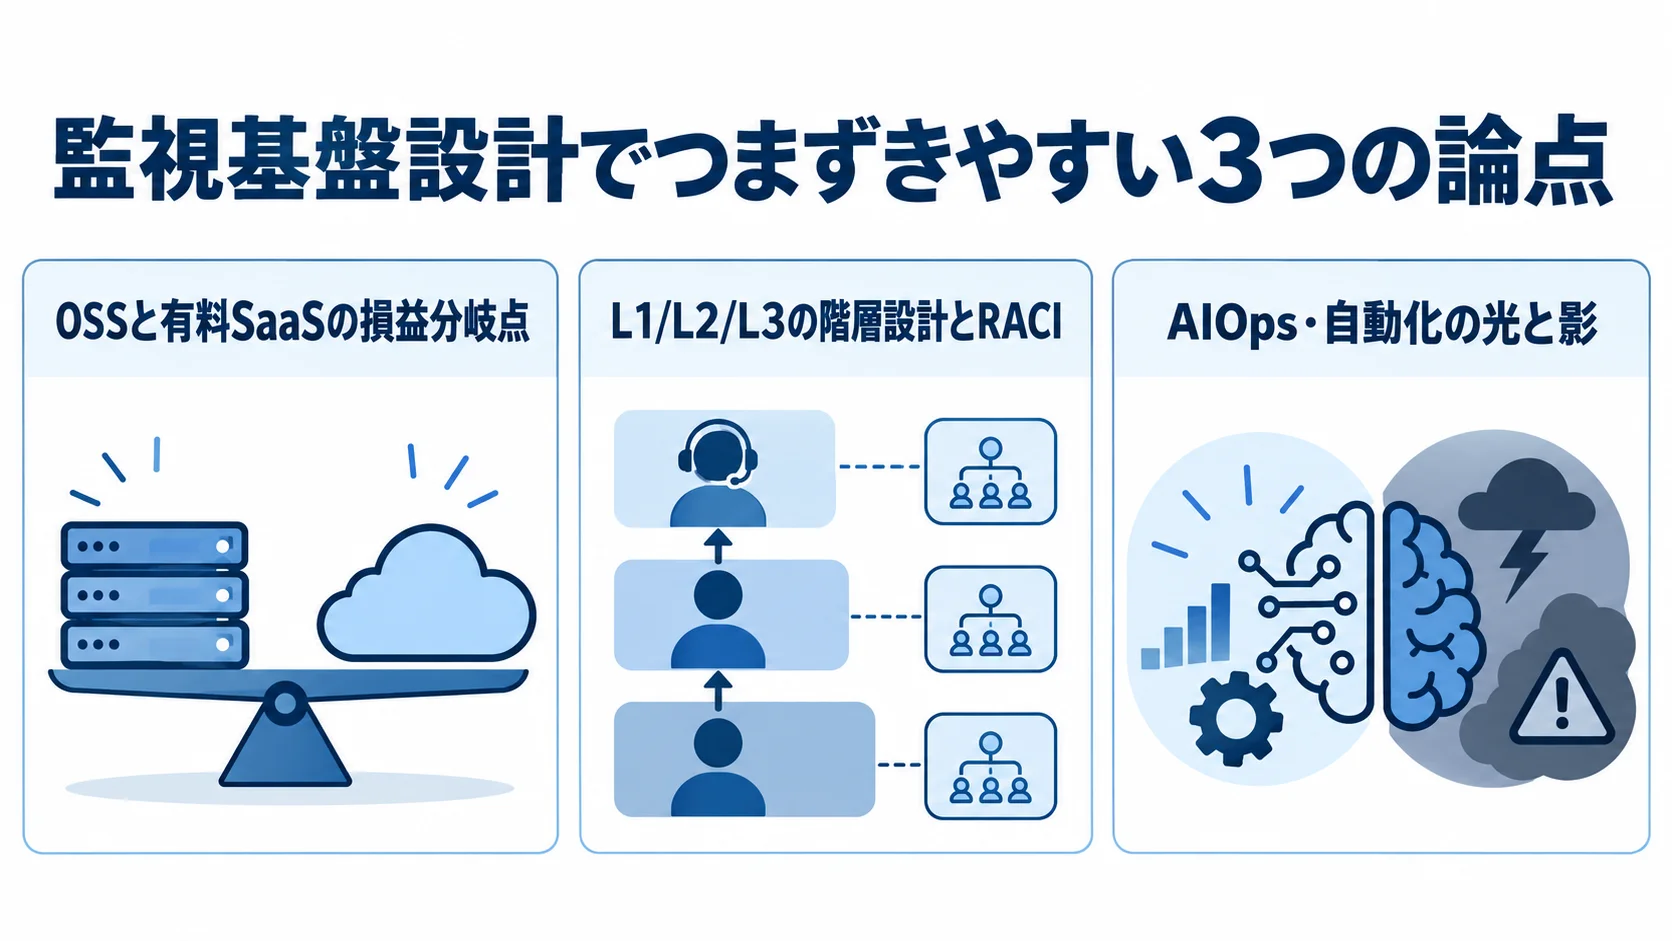
構築段階で特につまずきやすいのは、ツール選びの損益分岐点、L1/L2/L3の階層設計、AIOpsなどの自動化の3点です。
OSSと有料SaaSの損益分岐点
ZabbixやPrometheusなどのOSS(オープンソース)を使えば、ライセンス費用を抑えられます。サーバー台数が少なく、構築・運用できる技術者が社内にいる初期フェーズでは、OSSは有力な選択肢です。
ただし、台数が増えて設定やバージョンアップの維持に人手がかかるようになると、人件費という「隠れコスト」が膨らみ、有料SaaSへ切り替えたほうが結果的に安くなる損益分岐点が訪れます。判断の目安は、サーバー台数、運用にかかる工数、障害がビジネスに与える影響度の3点です。
たとえば、OSSの保守に担当者の工数が月に何十時間も割かれている、あるいは監視の不備による障害で売上影響が出始めた、という状況なら、有料SaaSへの移行を検討すべきタイミングです。構築の初期段階で「将来どこまで台数が増えそうか」を見積もり、移行のシナリオまで描いておくと、後の作り直しを避けられます。
L1/L2/L3の階層設計とRACI
運用ルールの中核は、構築段階で設計するサポート体制の階層化で、障害の難易度に応じた人材配置を可能にします。L1(一次対応)はアラート検知やプレイブックに沿ったトリアージ、定型作業を担い、L2(二次対応)は詳細なログ分析や一時復旧、しきい値のチューニングを行います。L3(三次対応)はアーキテクチャ変更や根本原因の解決といった高度な領域を担当します。
ここで意識したいのが「80/20ルール」です。問題の約80%は特権アクセスを必要としない定型対応であり、L1で処理できます。残りのうち約80%をL2が処理するため、最終的にL3が対応するのは全体の20%以下に絞られ、高コストなL3人材を本当に必要な場面に集中させられます。
階層設計と並んで重要なのが、RACIマトリクスによる責任分界の明文化です。各対応について、実行責任、説明責任、相談先・報告先を表で整理しますが、マルチベンダー環境では、障害時に「基盤障害なのか設定ミスなのか不具合なのか」で責任の押し付け合いが起きがちです。構築段階でRACIとSLAのグレーゾーンの扱いを取り決めておくと、こうした混乱を防げます。
AIOps・自動化の光と影
近年の保守構築では、AIOps(機械学習による異常検知・予測)や生成AIによる原因分析の導入が注目されています。実際、自動化を進めた現場ではアラートの8割を自動処理し、人間の対応工数を大幅に削減した成果が出ています。トヨタ自動車も、アジャイル開発で増えたAWS環境の運用監視を外部委託し、開発メンバーを本来業務に集中させています。
一方で、AIによる異常検知は、ハルシネーション(誤検知・過剰検知)のリスクを抱えています。AIが未知の障害を「正常」と誤認し、重大障害を見落とす可能性もゼロではありません。また、AIに運用ルールを学習させるには、過去のアラートやインシデントのデータを地道に整備する泥臭い手間がかかり、「導入すれば自動で賢くなる」という期待だけで進めると失敗します。
さらに見落とされがちなのが、AIの誤検知で重大障害を見逃した場合の責任の所在です。自動化システムが障害を正常と誤認したとき、責任がツールベンダー、委託先、自社のどこにあるのかは、契約で事前に取り決めておかないと有事に揉める論点です。自動化を組み込むなら、こうした責任範囲の合意までセットで設計することが、安心して任せられる仕組みづくりにつながります。
保守構築の費用相場とコストの内訳
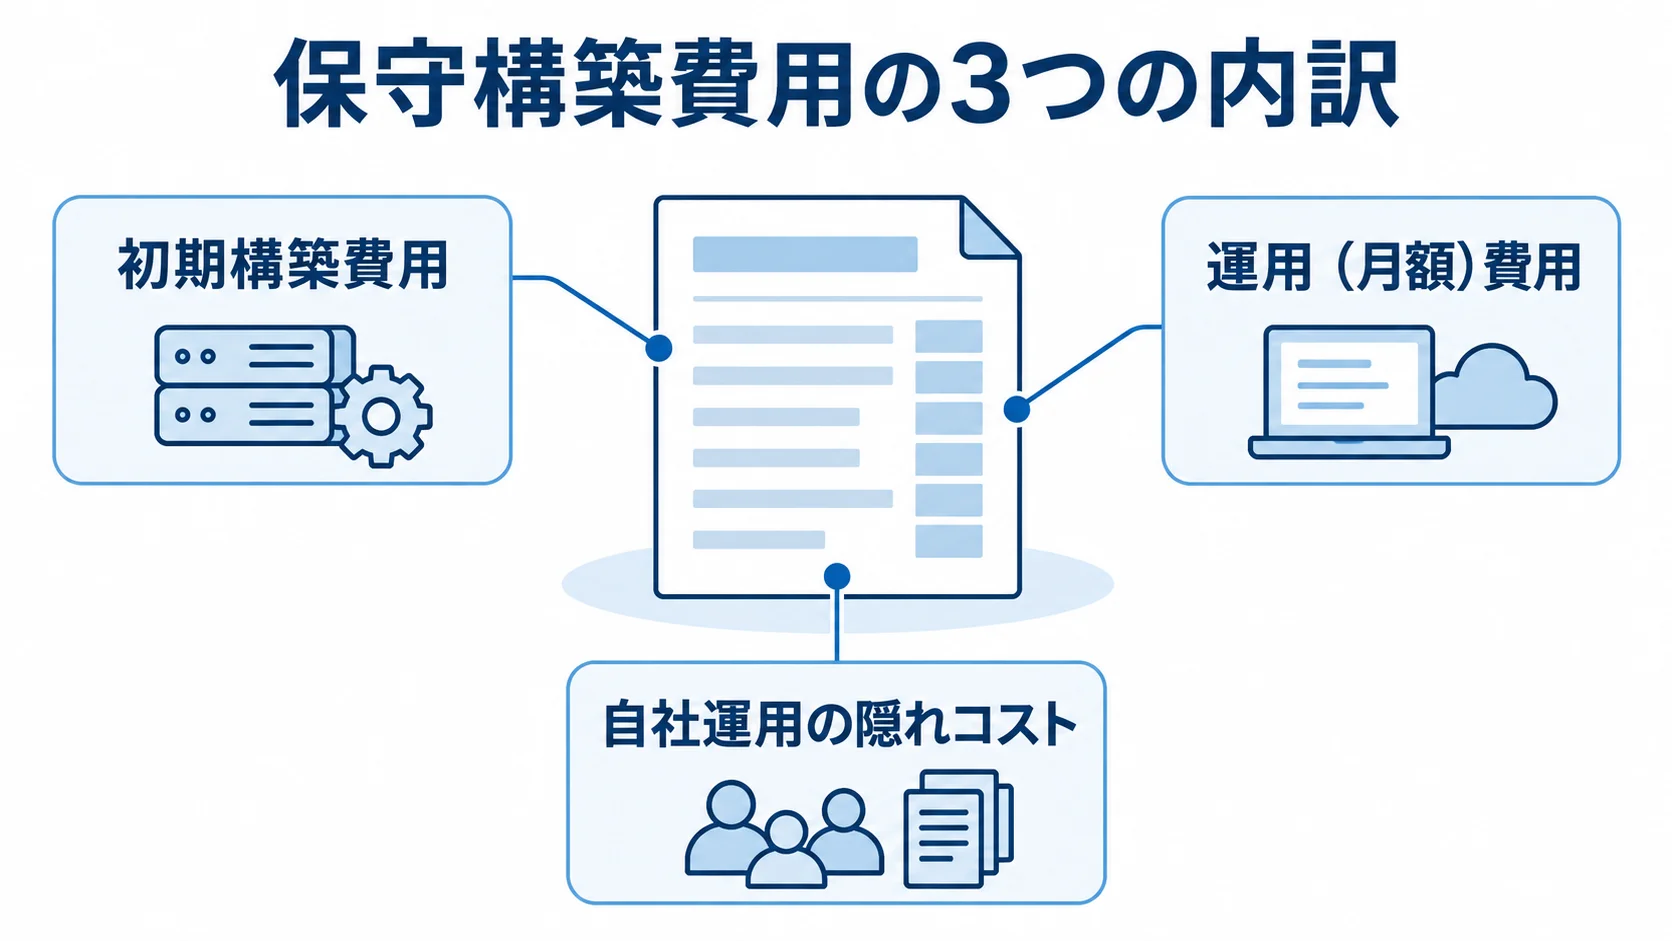
保守構築の費用は、「構築(初期)費用」と「運用(月額)費用」を分けて捉えます。初期費用と運用費用は性質が異なり、見積もりの段階で混同すると予算計画が崩れます。
初期構築費用と運用費用の分離
初期構築費用には、監視対象の設計やツールの導入、しきい値の設計にかかる工数に加え、ダッシュボードの作成や運用ルールの文書化の工数も含まれます。これは主に人月単価で算出され、対象システムの規模や複雑さによって大きく変動します。シンプルな構成なら数十万円規模、クラウドやマルチベンダーが絡む複雑な構成では数百万円規模になることもあります。
運用(月額)費用には、監視ツールのライセンス費と委託の月額料金が含まれます。ライセンス費は、サーバー台数や監視項目数に応じた従量制が一般的で、SaaS型では1台あたり月額数百円から数千円程度が目安です。委託費用は、対応範囲(一次対応のみか、復旧までか)や対応時間帯(平日日中か24時間365日か)で大きく変わり、詳細な相場はITシステム保守構築の費用相場で解説しています。
自社運用の隠れコストとの比較
「外注は高い」と感じても、自社運用の隠れコストを正しく算入すると印象が変わります。自社で24時間365日の監視体制を組むには、シフト勤務を回せる人員の確保や、夜勤・オンコールに伴う人件費がかかります。さらに、ツールの維持管理工数や、担当者が疲弊して離職するリスクも考える必要があり、これらは見積書には載らないものの確実に発生するコストです。
背景には、深刻なIT人材不足があります。経済産業省の試算では、2030年に最大約79万人のIT人材が不足するとされ、限られた人員を既存システムの運用保守に割き続けることは、企業のDX推進の足かせになります。保守構築の仕組みを整え、自動化や委託で運用負荷を下げることは、貴重な人材を「攻めのIT」へ振り向けるための投資でもあります。
稟議の際は、目に見える委託費だけでなく、自社運用の総コストとの比較で説明すると説得力が高まります。
保守構築を発注・見積もりする際のポイント
保守構築を外部に委託する場合、見積もりや発注の進め方を誤ると、追加費用やオーバースペックといった失敗につながります。要件を明確にし、複数社を比べ、内製化への巻き戻しまで見据えることが、発注時に押さえるべき要点です。
要件定義の明確化とオーバースペック回避
見積もりのブレや追加費用の最大の原因は、要件定義の曖昧さです。「何を監視し、どのレベルまで対応してほしいのか」が不明確なまま発注すると、後から「それは契約範囲外です」と追加費用を請求されるトラブルが起きます。フェーズ1の監視対象一覧をもとに、監視範囲、対応レベル、対応時間帯、求めるSLAを明文化して発注することが、適正な見積もりを引き出す前提になります。
同時に、オーバースペックも避けたいところで、すべてを24時間365日・最高レベルで監視する必要はありません。手厚い提案ほど高額になりがちで、過剰な監視項目や対応レベルは費用の無駄です。ビジネスインパクトに応じてメリハリを付け、複数社から見積もりを取って比べると、自社に最適な水準を見極められます。
発注の具体的な進め方はITシステム保守構築の発注・外注方法で詳しく解説しています。
ブラックボックス化と内製化巻き戻しへの備え
保守構築を外部に丸投げすると、運用がブラックボックス化し、社内にノウハウが残らないリスクがあります。将来、委託先を乗り換えたり内製へ巻き戻したり(リパトリエーション)したくなったときに、必要な情報がベンダー側にしかなければ身動きが取れません。
発注時には、監視設定・運用手順・障害履歴を自社にも残してもらう取り決めを盛り込みます。内製化への巻き戻しを見据えるなら、ベンダーから社内へのナレッジ逆移管の手順や、3〜6ヶ月程度の並走期間(ハイパーケア)を契約に組み込んでおくと安全です。「ハズレのベンダー」を引いた場合に備え、契約解除の条件や引き継ぎ方法も事前に確認しておくと、業務を止めずに別の体制へ移れます。
保守構築は「任せて終わり」にせず、いつでも自社で握り直せる状態を保つ設計が、長期的な安心につながります。委託先の選定基準や具体的な比較は、ITシステム保守構築でおすすめの開発会社・ベンダーで詳しく紹介しています。保守構築の全体像を体系的に把握したい方は、ITシステム保守構築の完全ガイドもあわせてご覧ください。
まとめ
ITシステム保守構築は、障害対応そのものより、それを成り立たせる「監視・運用の仕組み」を作るフェーズです。現状の棚卸しと監視対象の選定から始め、自社の規模に合ったツールとしきい値を設計し、ダッシュボードと運用ルールを作り込む3つのフェーズを丁寧に進めることが、落ちないシステムへの近道です。
デフォルト設定をそのまま使わない、80/20ルールで体制を組む、RACIで責任分界を明文化するといった現場の知見を取り入れることで、構築品質は大きく高まります。費用面では、初期構築費用と運用費用を分けて捉え、自社運用の隠れコストまで含めて比較することが、適切な意思決定につながります。
発注時には要件を明確にしてオーバースペックを避け、ブラックボックス化を防ぐためにドキュメントの自社保管や内製化への巻き戻しまで見据えましょう。深刻なIT人材不足が続くなか、保守構築の仕組みを整えて運用負荷を下げることは、限られた人材を攻めのITへ振り向けるための重要な投資です。
本記事を出発点に、自社に最適な保守構築の第一歩を踏み出していただければ幸いです。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。