
Cerebrasは2026年10月22日、multi-trillion parameter modelsをWSE-3T wafersへ分割する技術解説を公開しました。展開方法について1,000〜2,000+ tokens per secondを主張しています。Kimi K3は約3兆パラメータ級の構成計算例です。
単一のwaferに3兆パラメータを載せる話ではありません。4-bit weightsで層を分け、重みをオンチップメモリに置いたまま、推論中はactivationだけを次へ渡すpipelineが中心です。
企業が見るべき点は、パラメータ数や最高速度の数字だけではありません。入力長、KV cache、同時リクエスト、電力あたりの出力をそろえ、自社の応答時間と処理量に合うかを確かめる必要があります。
※本記事は2026年10月27日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
Cerebrasが示す59枚構成の試算|1層約16 GBを積み上げる
Cerebrasの技術解説では、単一のWSE-3T waferに44 GBのオンチップメモリがあると説明しています。trillion-parameter級モデルでは、重みだけでテラバイトが必要です。Kimi K3は公式には2.8T-parameter modelですが、同社の計算例では約3 trillion parametersとして扱います。
計算の前提は4-bit weight quantizationです。3兆パラメータを4 bitsで保存すると、3 trillion × 4 bits ÷ 8 bits per byteで1.5 terabytesになります。Kimi K3の93 layersで割ると、1層あたり約16 GBです。
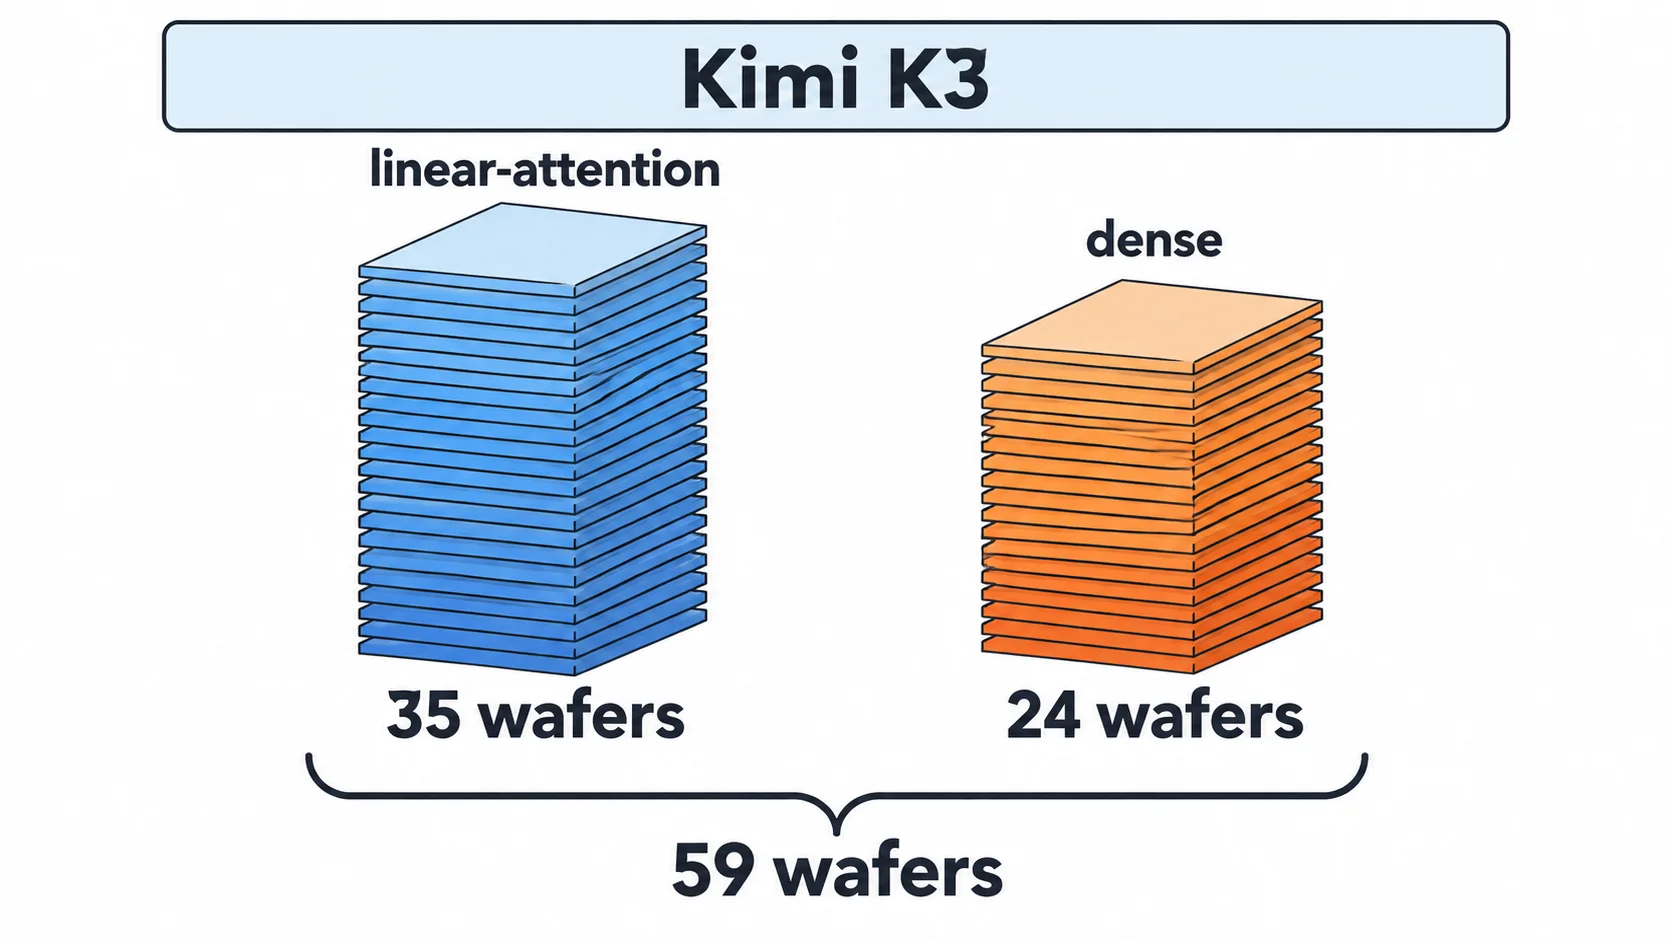
層の種類でwaferへの置き方が変わります。linear-attention layersはリクエストごとに文脈全体のキーと値を保存せず、小さな固定サイズの状態を持つため、1枚に2層を配置します。69層を2で割って切り上げると35 wafersです。
dense layersは各リクエストのKV cacheを必要とするため、1枚に1層を置き、残りのメモリをcacheに残します。24層で24 wafersです。35と24を足した59 wafersが、この計算例の構成になります。
| 計算要素 | 前提・結果 | 意味 |
|---|---|---|
| モデル。 | Kimi K3、93 layers。 | 約3Tとして計算。公式モデルカードは2.8T。 |
| 重み。 | 4-bit、1.5 TB。 | 93層で割ると1層約16 GB。 |
| linear-attention。 | 69層、2層/wafer。 | 35 wafers。 |
| dense。 | 24層、1層/wafer。 | KV cache用の余白を確保して24 wafers。 |
| 合計。 | 35 + 24 = 59 wafers。 | WSE-3Tを層のstageとして使う。 |
ポイント
59 wafersは、約3T・4-bit・93層という前提から出した設計例です。モデルの量子化や層構成が変われば、必要なwafer数も変わります。
速さの理由|重みを固定しactivationだけを渡す
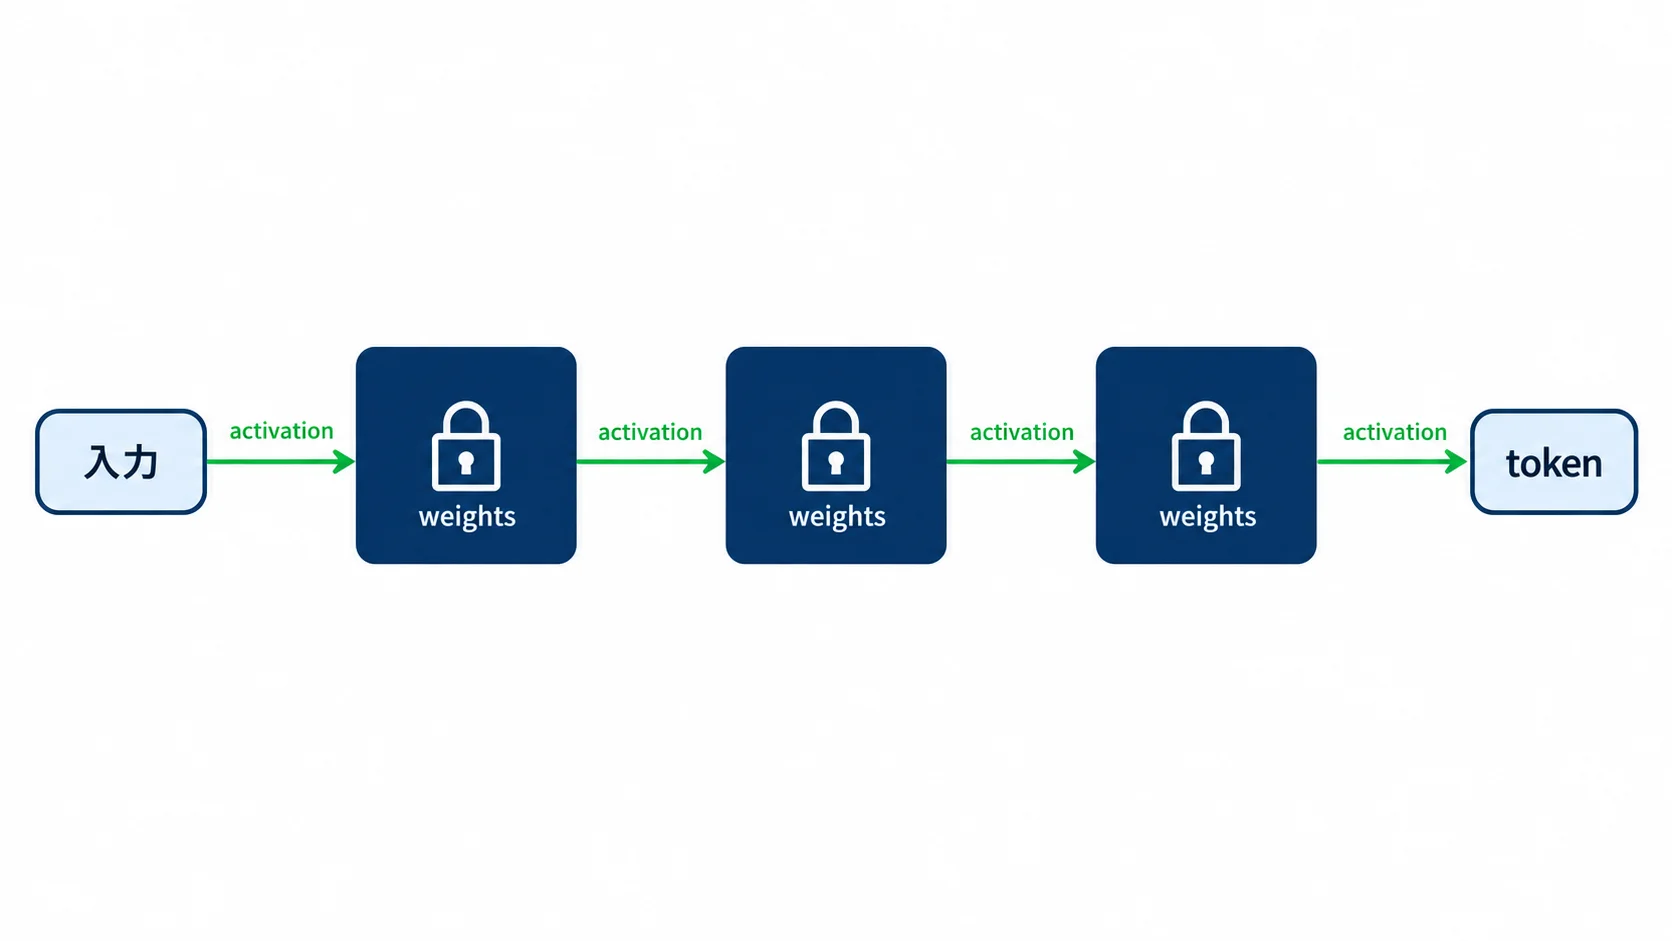
59枚を直列につないだだけなら、先頭から最後までデータを運ぶコストが問題になります。Cerebrasの説明では、コンパイラがモデルの層をwaferの領域に割り当て、ランタイムがtokenの経路を作る設計です。
各waferがモデルの一部の重みをオンチップSRAMに保持します。1枚目がlayers 1–2、2枚目がlayers 3–4を処理するように、リクエストの中間結果だけを次のstageへ渡す構成です。重みを毎回外部メモリから読み直す構成とは、データ移動の位置が異なります。
wafer間の通信にはRDMA over Ethernetを使い、1 hopあたりroughly 2 microsecondsです。全体の応答時間は通信だけで決まりませんが、モデル層をwafer内に収め、activationの受け渡しに絞ることがdecodeを速くする考え方です。
この仕組みを利用する業務として、出力を待ちながら人が次の操作を決めるコーディングエージェントや、会話の間を短くしたい音声・対話処理が考えられます。これはCerebrasが示す低遅延の構成から導ける用途です。導入時には実際の入力と出力で体験を測ります。
推論基盤全体の投資動向を把握するには、AI推論向けクラウド支出の増加を扱った記事も参考になります。学習用の計算資源と、利用者へ毎回返答する推論基盤は、同じ指標で選ばないことが大切です。
ポイント
Cerebrasの構成は、重みを動かす回数を減らし、activationをstage間で流す設計です。速度の評価では、入力を処理するprefillと、出力を生成するdecodeを分けて測ります。
多数のリクエストを同時処理|速さと総量を分ける
1つのリクエストが59枚を順に通るなら、途中のwaferが待機するように見えるでしょう。Cerebrasは、pipelineを複数のリクエストで満たすと説明しています。stage 3がリクエストAを処理するとき、stage 2はB、stage 1はCを処理するイメージです。
本番では、説明用の層より細かいstageに分け、各stageが小さなmicro-batchも処理します。in-flight requestsはおおむねstage数とmicro-batch sizeの積です。1件の応答を速くするなら小さい単位、全体の処理量を増やすなら大きい単位が有利になるトレードオフです。
モデル自体の選択肢も広がりました。たとえば1兆パラメータのオープンウェイトモデルを自社運用する場合も、モデルの容量だけでなく、量子化、入力長、同時実行、運用できる推論エンジンの確認が必要です。
ポイント
個別リクエストの速度と、システム全体の総スループットは別の指標です。業務ごとに同時実行数を変え、p50・p95の応答時間と総出力を記録します。
約190同時リクエスト|KV cacheから逆算する
同時数は、waferの枚数だけでは決まりません。Cerebrasの計算例では、dense layerを1層置いた44 GB waferについて、残りの44 GB − 16 GB = 28 GBをKV cacheに使います。linear-attention layerのwaferではなく、dense-layer waferのcacheが上限を決める考え方です。
平均リクエストサイズを256k、KV cacheを8-bitとする同じ前提で、1リクエストのcacheは576 bytes × 256,000 ≈ 147 MBです。28 GBを147 MBで割ると、約190 concurrent requestsになります。
ここで注意したいのは、約190がサービス全体の固定的な上限ではないことです。入力長が短いほどcacheは小さく、長いほど大きくなる関係です。層の配置、量子化、リクエストの分布、運用上の余裕も結果に影響します。
したがって、導入前は自社の代表的な入力長と出力長を集め、少数のリクエストから同時数を段階的に増やす計画です。KV cacheの使用量、初回応答、出力速度、エラー率を記録し、単一の最大値ではなく、業務SLAを満たす同時数を決めます。
ポイント
約190 concurrent requestsは、256k request、8-bit KV cache、dense layerの残り28 GBという前提の計算値です。自社の同時数は、実際の入力長とSLAから測り直します。
導入判断の軸|tokens/sと電力を同じ条件で比べる
1,000〜2,000+ tokens per secondという速度をCerebrasは主張しています。対象はmulti-trillion parameter modelsの展開方法です。Kimi K3の59枚構成を実機で測った値として記載されたものではありません。モデル、入力長、量子化、出力長、同時数が違えば、数字も同じにはなりません。Cerebrasの価格ページも、performanceはmodelとconfigurationで変わると明記しています。
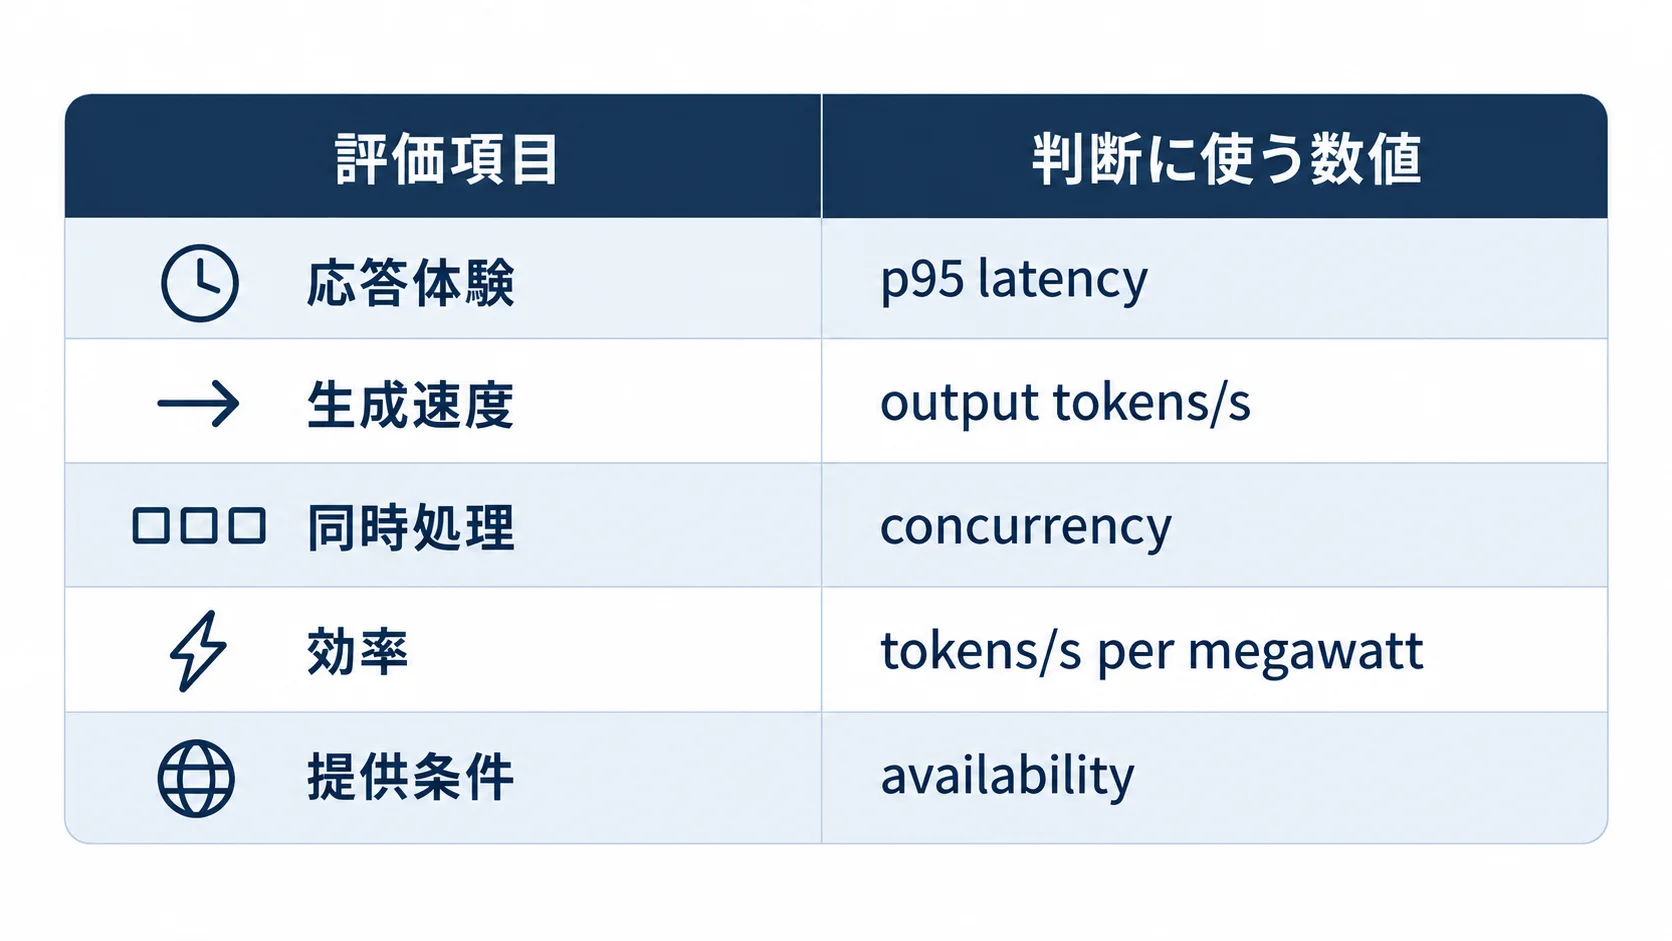
Cerebras自身は、concurrencyやbatch sizeだけでは効率を表しにくいと説明しています。同じoutput generation speedで測るなら、total token throughput per unit of powerが有用な指標です。企業の比較表には、速度と電力、処理量を並べるのが基本です。
| 評価項目 | 確認する条件 | 判断に使う数値 |
|---|---|---|
| 応答体験。 | 代表的な入力長・出力長を固定。 | 初回応答、p50/p95 latency。 |
| 生成速度。 | 同じモデルと量子化で比較。 | output tokens/s。 |
| 同時処理。 | 同時数を段階的に増やす。 | エラー率、SLAを満たすconcurrency。 |
| 効率。 | 同じoutput generation speedで測定。 | tokens/s per megawatt。 |
| 提供条件。 | API、モデル、容量、地域、契約を確認。 | availability、制限、運用費。 |
また、Kimi K3のような大規模オープンモデルを自社基盤で動かす場合は、モデルの重みを置けるかだけで終わりません。推論エンジン、モデル更新、障害時の切り替え、データの扱い、監視担当を含む運用設計も必要です。毎秒1,000トークン超を掲げる別方式の推論モデルと比べるときは、方式ではなく同じ業務データで比べます。
この考え方は、3Tを超えるモデルにも拡張可能です。追加のwaferでcomputeとオンチップメモリは増えますが、必要な電力、通信、冷却、運用容量も増えます。導入を検討する企業は、代表的な一つの業務を選び、速度と品質、コストと電力を同時に測るのが現実的です。
ポイント
推論基盤の比較では、最高値より自社のSLAを満たす実効値を見ます。入力長・出力長・同時数・電力・モデル提供条件を固定し、同じ業務で比較してください。
よくある質問
Q. Cerebrasは本当にKimi K3を59枚のウェハで動かしたのですか?
一次情報では、Kimi K3を59枚で実際に動かした運用・実測の報告はありません。59枚は、約3T・4-bit weights・93 layersという前提でCerebrasが示した構成計算です。
Q. 約190同時リクエストはどのような前提で計算されていますか?
前提は、dense layer後の空き28 GB、256k request、8-bit KV cacheです。1件約147 MBとして、約190件を算出します。実サービスの固定上限ではありません。
Q. 1,000〜2,000+ tokens/sは実サービスで保証される速度ですか?
この数字はCerebrasが技術解説で示す速度です。実際の性能はモデル、入力長、量子化、同時数、構成で変わるため、自社の条件で測定します。
Q. Cerebrasの推論基盤を選ぶとき、何を比較すべきですか?
比較するのは、p50・p95の応答時間とoutput tokens/sです。SLAを満たす同時数、同じ出力速度でのtokens/s per megawatt、モデルと容量の提供条件も比べます。
まとめ
Cerebrasが示した59-wafer構成の試算は、約3T級モデルを層ごとに分割し、重みをオンチップSRAMへ固定します。4-bit weightsでは1層約16 GBです。69 linear-attention layersを35 wafers、24 dense layersを24 wafersに配置します。
速さを生むのは、wafer間で重みを動かさずactivationだけを流すpipelineです。複数リクエストをstageへ同時投入します。約190 concurrent requestsは前提つきの計算値で、企業の導入時は実データで測り直します。
候補に入れるなら、最高のtokens/sだけを追いません。p95 latency、SLAを満たす同時数、tokens/s per megawatt、モデルと容量の提供条件を同じ業務で比べ、速さが売上や作業時間を改善するか判断します。
ポイント
Cerebrasの発表から得られる実務上の教訓は、巨大モデルの推論をメモリ配置・通信・同時実行・電力の組み合わせとして評価することです。
関連記事
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。