
Inceptionは2026年10月19日、拡散ベースの大規模言語モデル「Mercury 3」を発表しました。NVIDIA GPU上で毎秒1,068トークン、100万トークンのコンテキストを掲げるモデルです。
Mercury 3は、テキストを1トークンずつ生成する自己回帰型とは異なり、複数のトークンを並列に生成して精錬します。OpenAI互換API、ツール呼び出し、構造化出力に対応し、検索やエージェントの待ち時間を短くする選択肢になりました。
ただし、毎秒1,000トークン超という数字だけで導入を決めるべきではありません。通常料金、キャッシュ、入力形式、データ保持、実際のツール実行を含めた業務単位で評価する必要があります。
※本記事は2026年10月21日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
Mercury 3は何を発表したか|1,068トークン/秒と100万トークン文脈
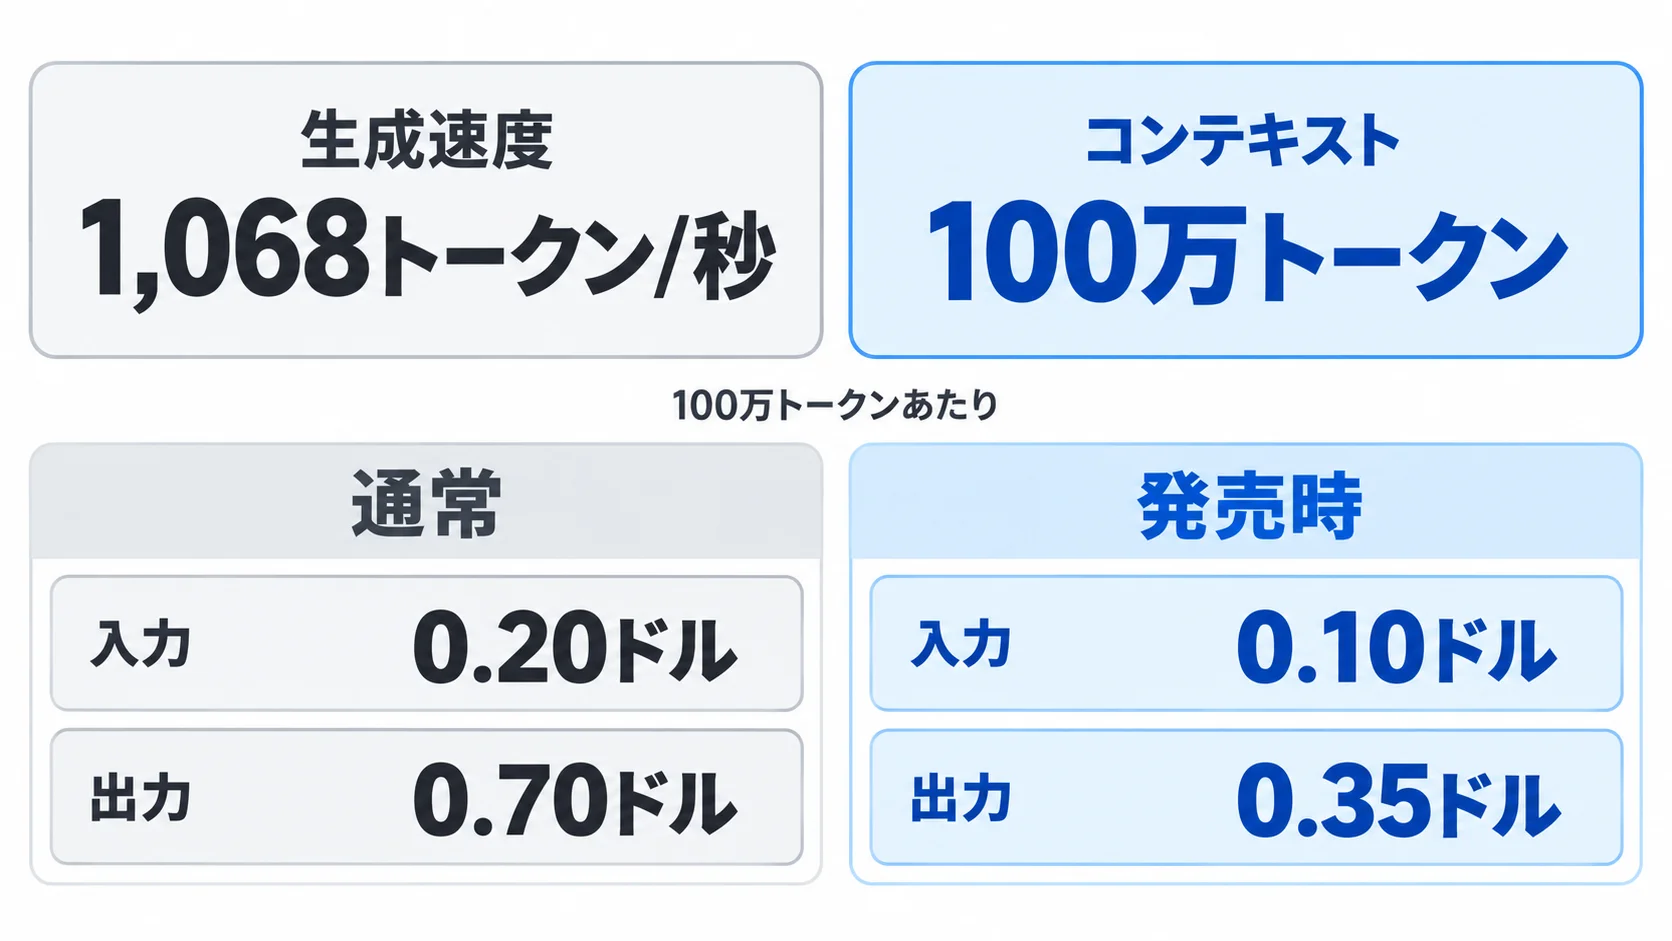
Mercury 3の発表で目を引くのは、速度とコンテキスト長の組み合わせです。Inceptionの公式発表によると、NVIDIA GPU上の生成速度は毎秒1,068トークン。コンテキスト長は100万トークンで、前世代のMercury 2.5が持つ26万トークンから広がりました。
料金は入力100万トークンあたり通常0.20ドル、出力100万トークンあたり0.70ドルです。発売時は50%引きで、入力0.10ドル、出力0.35ドル。キャッシュ済みトークンは入力料金の90%引きという設定です。
円換算は、1ドル=150円で計算します。通常料金は入力約30円・出力約105円、発売時料金は入力約15円・出力約52.5円です。出力の割合が多いエージェントでは、入力単価だけを見た比較は実コストの差を捉えにくい点に注意が必要です。
| 項目 | 通常・仕様 | 発売時 |
|---|---|---|
| 入力(100万トークン) | 0.20ドル(約30円) | 0.10ドル(約15円) |
| 出力(100万トークン) | 0.70ドル(約105円) | 0.35ドル(約52.5円) |
| キャッシュ済み入力 | 入力料金の90%引き | 0.01ドル(約1.5円) |
| コンテキスト | 100万トークン | |
| 最大出力 | 131,072トークン | |
1Mコンテキストは、長い議事録や仕様書を一度に扱える可能性を広げます。ただし、長文を毎回投入すれば料金と処理時間が増えます。検索で必要な箇所を絞る設計と、繰り返し使う前提部分をキャッシュする設計を分けて検討することが実務上の要点です。
ポイント
Mercury 3は速度、100万トークン文脈、低い発売時料金を組み合わせたモデルです。比較では出力トークンと通常料金まで含めてください。
拡散型LLMは自己回帰型と何が違うか|複数トークンを並列に精錬
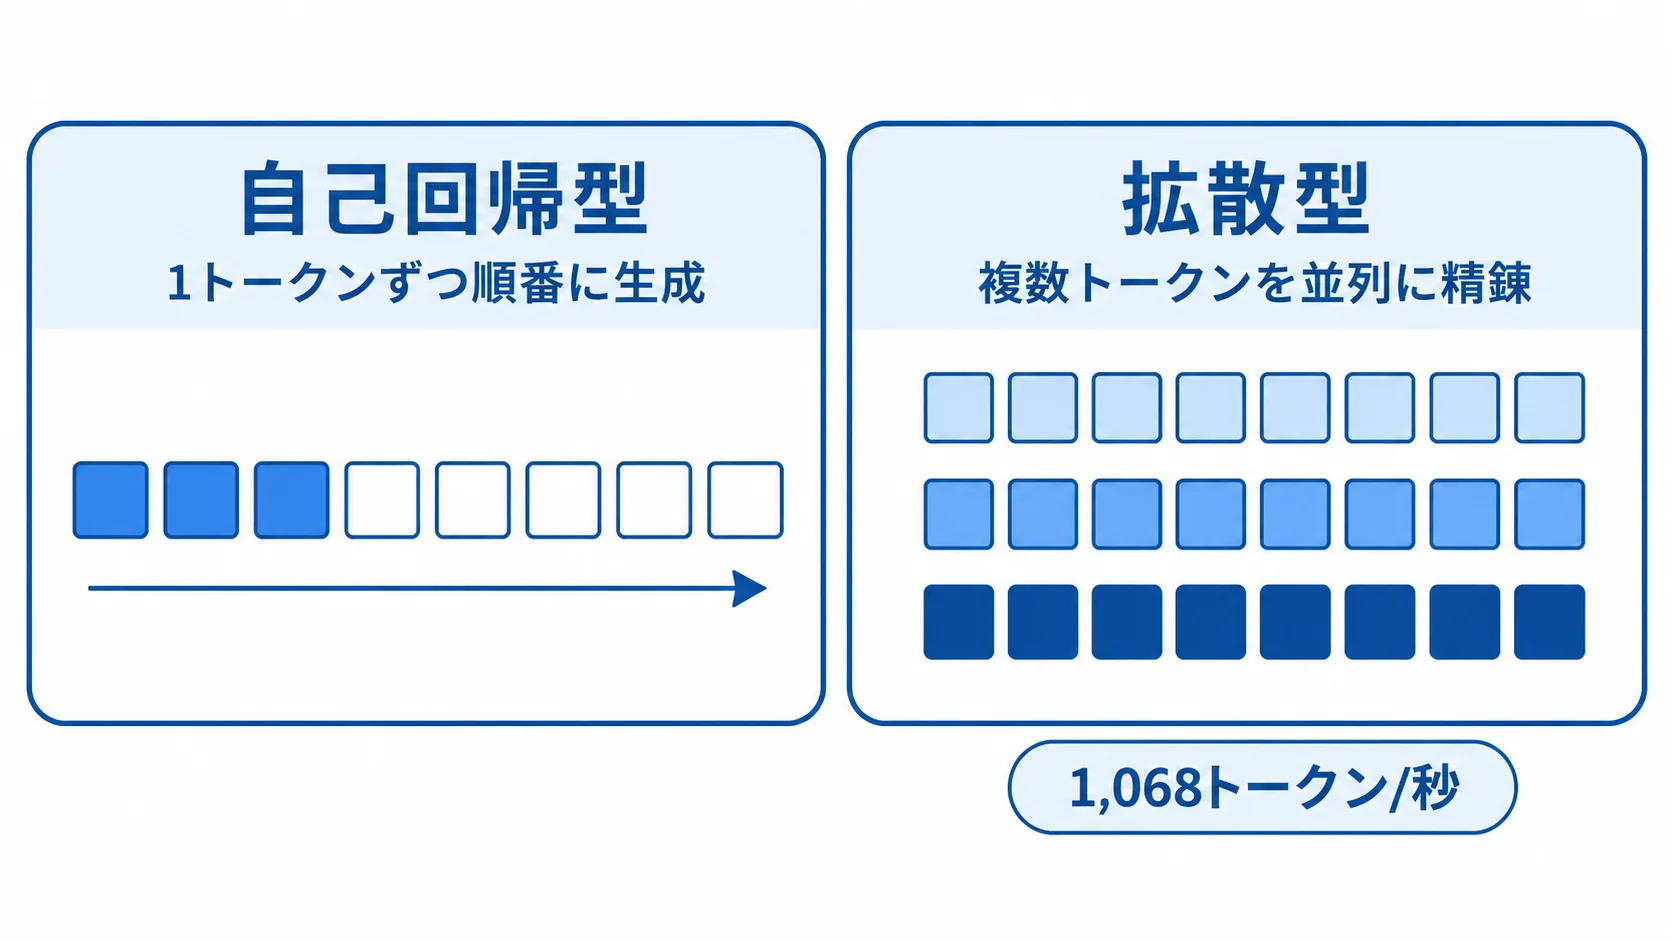
一般的な自己回帰型LLMは、前のトークンを生成してから次のトークンへ進みます。文章の先頭から末尾へ順番に進むため、出力が長いほど生成時間も積み上がる仕組みです。
拡散型LLMは、最初から完成文を一方向に書き切るのではなく、複数の位置をまとめて予測し、全体を段階的に精錬する方式です。Inceptionの技術報告は、拡散型モデルを複数トークンを並列予測するTransformerとして説明しています。Mercury 3は、この生成方式を大規模モデルへ広げた点が特徴です。
APIの見え方も少し違います。通常のストリーミングでは、1トークンずつではなくモデルが精錬したテキストのブロックを返します。diffusingを有効にすると、ノイズのある出力が完成文へ変わる中間過程も表示可能です。
この違いは「どのモデルより速いか」だけでは測れません。音声対話なら最初の返答までの時間、検索なら検索結果を受け取って回答するまでの時間、エージェントなら複数ステップの合計時間を測ります。生成速度が高くても、ツールの待ち時間やアプリ側の処理が長ければ体験は変わりません。
ポイント
拡散型の評価では、トークン/秒に加えて、ブロックの表示、ツール実行、検索を含むエンドツーエンドの待ち時間を測定します。
APIと機能|既存のOpenAI互換スタックに組み込める
Mercury 3のモデルIDはmercury-3、チャット補完のエンドポイントは/v1/chat/completionsです。Inception API Platformのほか、OpenRouter、Baseten、Vercelから提供され、既存のOpenAI互換クライアントを使った検証を始めやすい構成になっています。
主な機能は、ストリーミング、Tool Calling、Structured Outputsです。ツール呼び出しでは、モデルがJSON引数付きの関数呼び出しを返し、アプリケーションが関数を実行して結果をモデルへ戻します。複数のツールを並列に呼び出せるため、検索や業務システム参照を組み込むエージェントで有効です。
推論強度はinstant、low、medium、highから選択可能です。軽い問い合わせは低い設定、複数ステップの処理は高い設定という切り分けを、品質とレイテンシーの実測で決めます。API互換でも、モデルの出力傾向やツール失敗時の挙動まで同じとは限りません。
Mercury 3の入力形式はテキストのみです。画像を扱う業務では、画像理解を別モデルに任せるか、テキスト化した結果をMercury 3へ渡す構成を組みます。導入テストでは、現在のモデルと同じプロンプトを移すだけでなく、入力の前処理と出力のスキーマ検証まで含めた試験が必要です。
モデルの料金改定を比較するときは、GPT-5.6の料金改定のように単価だけでなく、入力と出力の配分を見る設計が必要です。複数モデルに同じ条件を与えるAIモデル11種の比較実験の考え方も、Mercury 3の検証に応用できます。
ポイント
OpenAI互換APIは移行の入口を狭くしますが、品質・ツール呼び出し・構造化出力の検証はモデルごとに必要です。
向く用途|待ち時間が積み重なる検索・音声・エージェント
Mercury 3を検討しやすいのは、モデルの応答を待つ回数が多い業務です。Inceptionは、ブラウザ操作エージェント、対話型教育、リアルタイム検索エージェント、カスタマーサポートを初期の用途として挙げています。
- 検索エージェント:複数資料の検索・要約を繰り返す処理で、各ステップの待ち時間を抑える。
- 音声・チャット応対:会話の間を短くし、ツール参照を挟む応答を連続させる。
- ブラウザ操作:画面を読む、操作する、結果を確認するループの合計時間を測る。
- データ処理:構造化出力で分類や抽出を行い、後段のシステムへ渡す。
逆に、画像入力が必須の業務や、1回の回答品質を最優先する業務では、Mercury 3単体で置き換えられない可能性があります。候補にするなら、処理を「速さが効く部分」と「別モデルが必要な部分」に分解してください。
100万トークンの文脈も、社内文書を無差別に詰め込むための機能ではありません。検索対象を絞り、参照箇所と回答根拠を記録し、長い入力が正答率と料金にどう影響するかを測ります。100万トークン級のコンテキストを持つモデルの使い所を比較するときも、文脈長と業務設計を分けて見ることが大切です。
ポイント
向き不向きは、毎秒の生成速度ではなく、検索・音声・ツール実行を含む業務フロー全体の待ち時間で判断します。
導入前の確認点|発売時価格と1M文脈だけで決めない
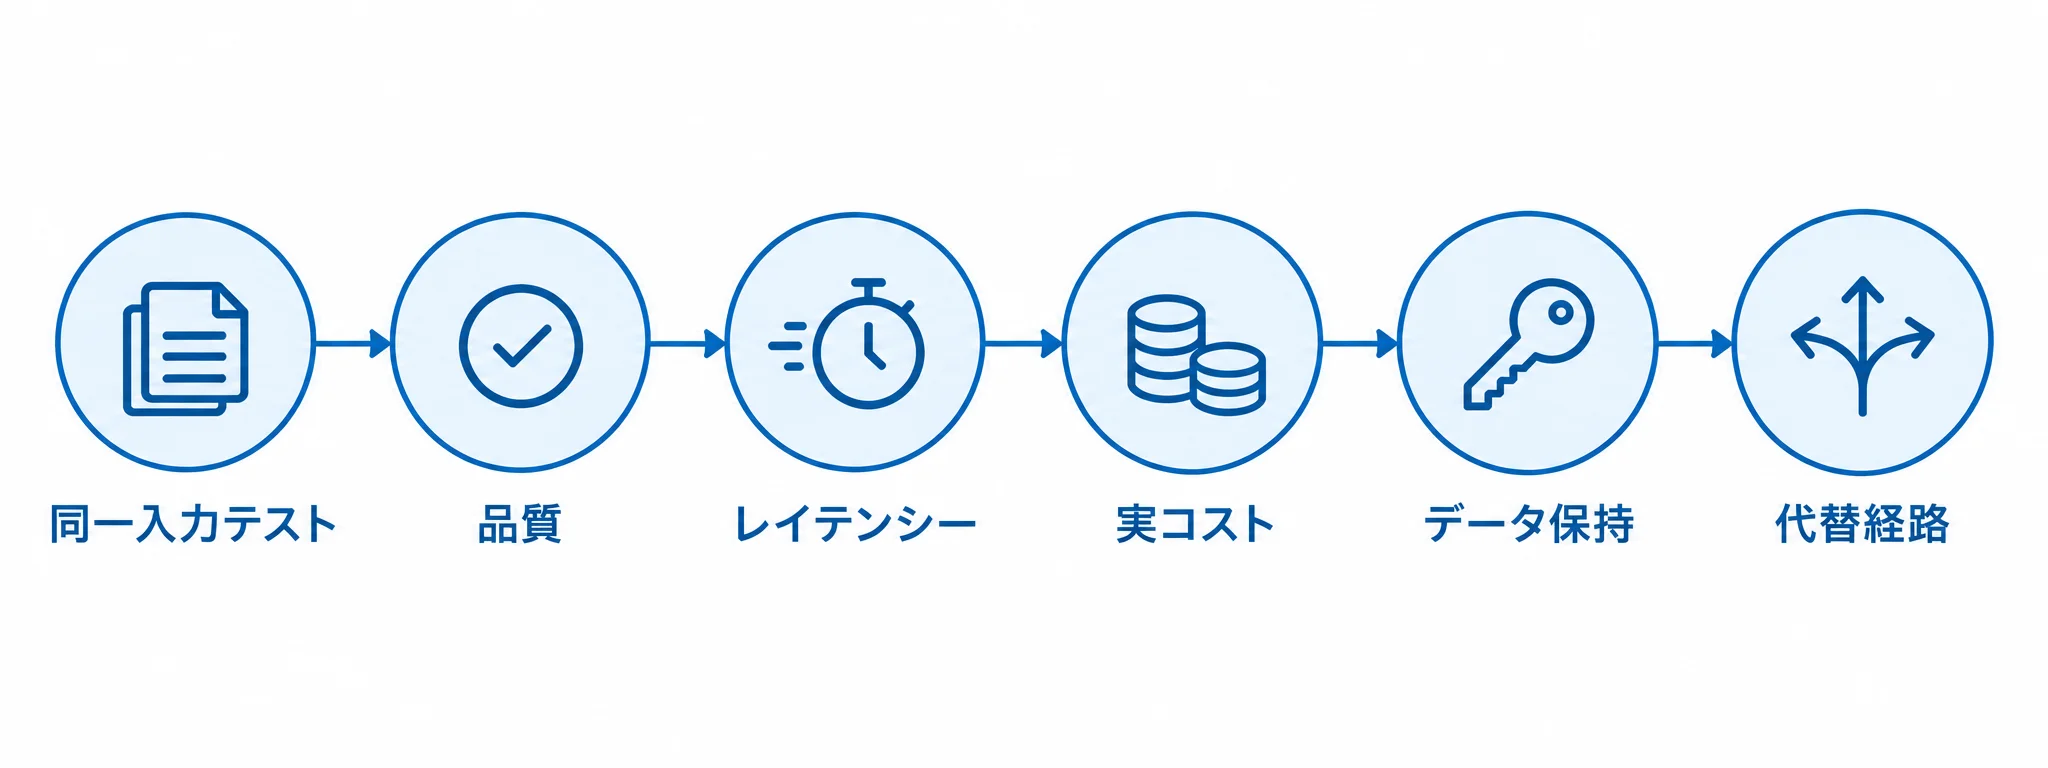
最初は本番の一部処理を切り出し、現行モデルとMercury 3へ同じ入力を流します。評価するのは回答文だけではありません。正答率、ツールの引数、構造化出力のパース成功率、最初の表示までの時間、完了までの時間を同じ条件で記録しましょう。
費用は、入力・出力・キャッシュに分けて集計が必要です。発売時料金は魅力的ですが、通常料金に戻った場合も継続性を確認しましょう。長文入力が多い業務では、コンテキスト長よりもキャッシュヒット率と出力トークンの削減が請求額を左右します。
企業利用では、専用容量、オートスケーリング、コンプライアンス制御、設定可能なデータ保持が自社の要件を満たすかを確認します。提供経路によって契約、障害時の連絡先、ログの扱いが変わるため、Inception API、OpenRouter、Baseten、Vercelを同じサービスとして扱わないことも必要です。
検証後は、Mercury 3が失敗したときに別モデルへ切り替える経路を用意してください。モデルIDだけを設定ファイルで切り替えられるようにし、プロンプト、ツール仕様、出力スキーマを分離しておけば、API互換性を活用しながら運用上の依存を抑えられます。
ポイント
導入判断は、発売時単価ではなく、品質・レイテンシー・実コスト・データ取り扱い・代替経路を同じ検証表で比較してください。
よくある質問
Q. Mercury 3は何が新しいLLMですか?
拡散ベースのLLMで、NVIDIA GPU上で毎秒1,068トークン、100万トークンのコンテキストを掲げています。
Q. Mercury 3の料金はいくらですか?
通常は入力100万トークンあたり0.20ドル、出力100万トークンあたり0.70ドルで、発売時はそれぞれ0.10ドルと0.35ドルです。
Q. Mercury 3は既存のOpenAI API向けアプリで使えますか?
OpenAI互換APIで、モデルIDをmercury-3にして利用できます。
Q. Mercury 3はどのような用途に向いていますか?
ブラウザ操作、対話型教育、リアルタイム検索、カスタマーサポートなど、待ち時間が積み重なる処理に向いています。
まとめ
Mercury 3は、拡散型の並列生成、毎秒1,068トークン、100万トークンのコンテキスト、OpenAI互換APIを組み合わせたモデルです。検索や音声、エージェントのように待ち時間が何度も発生する処理で、検証する価値があります。
導入時は、まず既存モデルとの同一入力テストから始めます。品質・ツール実行・レイテンシー・料金・データ保持を測り、発売時価格が終わっても続けられるかを確認してください。
ポイント
Mercury 3は「速いから全面移行する」モデルではなく、待ち時間が事業価値に直結する処理から小さく評価するモデルです。
関連記事
- Claude Opus 5を解説|性能・料金とモデル選定のポイント
- 小型モデルで十分な時代を解説|低価格モデルでAIアプリの採算が合う理由
- Jevの仕組みを解説|RLCDと並列サンプラーが意思決定モデルをどう変えるか
- DeepSeek V4を解説|Pro・Flashの仕様とAPI料金、企業導入のポイント
- Gemini 4 Argonを解説|一般提供開始で変わる料金・100万トークンと使いどころ
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。